· 99 min read
论文解读:LightGlue,让稀疏特征匹配随难度自适应地快
TL;DR LightGlue 是 ETH Zürich 与 Microsoft Mixed Reality & AI Lab 的 Lindenberger、Sarlin、Pollefeys 在 ICCV 2023 提出的稀疏局部特征匹配器[1]。它保留 SuperGlue 的「自注意力 + 交叉注意力」骨架,但把三个最贵的部件换掉:自注意力用旋转相对位置编码,交叉注意力只算一次相似度、双向共用,匹配头用「可匹配性 sigmoid × 双 softmax」替代 Sinkhorn 与 dustbin;同时每一层都输出匹配和置信度,于是简单图像对可以在第 3 层退出,低匹配概率的点在中间层被剪掉。MegaDepth-1500 上 SuperPoint+LightGlue 的 LO-RANSAC AUC@5° 为 66.7、匹配耗时 44.2 ms,SuperGlue 为 65.8、70.0 ms;开启自适应后为 66.3、31.4 ms。Aachen Day-Night 夜间召回 87.8 / 93.9 / 100,吞吐 17.2 对/秒(优化版 26.1),SuperGlue 为 86.7 / 92.9 / 100、6.5 对/秒。代码、权重与训练库以 Apache-2.0 开源(SuperPoint 权重例外)。
- 论文:LightGlue: Local Feature Matching at Light Speed,Philipp Lindenberger、Paul-Edouard Sarlin、Marc Pollefeys,ETH Zürich / Microsoft Mixed Reality & AI Lab,ICCV 2023。
- 代码:github.com/cvg/LightGlue(推理与权重);训练、评测与数据加载在 github.com/cvg/glue-factory。
- 前作 / 后继:SuperGlue、SuperPoint、LoFTR、LoMa;后续的 FlexGlue 把这条稀疏匹配路线推向稀疏到稠密;特征侧可看 ALIKED、XFeat。
一、动机:SuperGlue 的精度,是用固定算力换来的
SuperGlue 在 2020 年把稀疏特征匹配变成了一个端到端可学习的图神经网络:两张图的特征互相注意,再用最优传输(optimal transport)解一个部分分配问题[2]。它学到的先验很强,跨视角、跨光照都稳,之后几年一直是稀疏匹配的默认答案。但它的代价也很清楚:注意力对关键点数二次增长,Sinkhorn 要迭代很多次,而且无论一对图是相邻视频帧还是昼夜跨视角,网络都跑满固定的 9 层。
这在部署时会变成两个具体问题。第一,平均算力被最难的图像对拖住。SLAM、视频重建、大规模 SfM 里大量图像对其实很容易匹配,视觉重叠大、外观变化小,前几层已经能给出稳定答案,后面几层是在重复计算。第二,很多关键点根本不参与匹配。遮挡、非重复纹理、视场外,这些点在另一张图里没有对应点,让它们继续参与注意力只会增加开销。SuperGlue 对这两种情况一视同仁。
在 LightGlue 之前,已经有两类效率改进。SGMNet 用种子匹配限制注意力范围,ClusterGNN 把关键点聚类后分簇计算[3, 4];它们能降低大输入下的计算量,但标准输入尺寸收益有限,而且在最难的条件上往往追不回 SuperGlue 的精度。另一条路是 LoFTR 代表的稠密匹配器,在稠密网格上做 Transformer,鲁棒性很好,但元素数量多、分辨率受限、推理慢,MatchFormer、ASpanFormer 也在这个权衡里[5, 6, 7]。LightGlue 没有选「把网络整体做小」或「换成稠密网格」,而是选了一个更直接的目标:让网络根据每一对图的难度,自己决定算多深、算多宽。
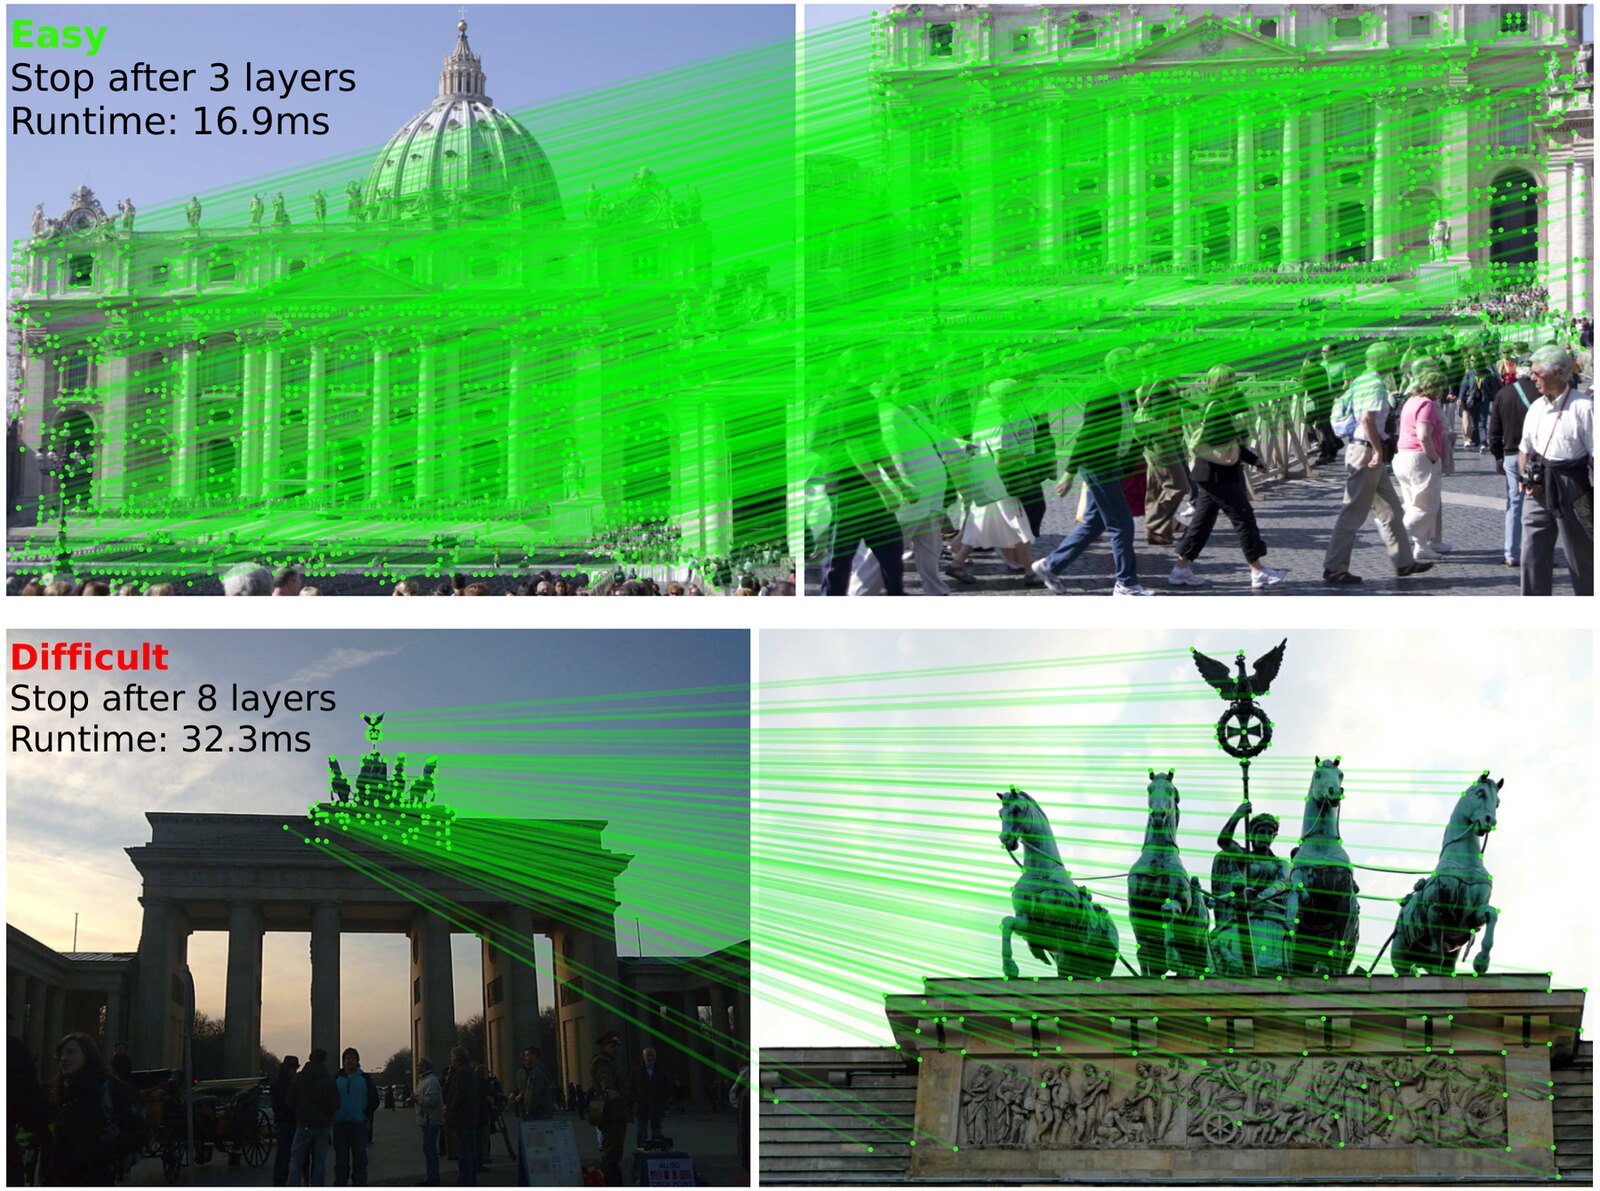
这个目标建立在两个观察上。其一,匹配难度差异很大:简单对在前几层就已经收敛,难对才需要更深的上下文。其二,逐层预测可以很便宜:如果把匹配头做得足够轻,每一层都能给出一个分配矩阵,那么「现在是否已经够好」就可以由网络自己判断。Figure 2 是论文的开场例子:简单对停在第 3 层,16.9 ms;困难对停在第 8 层,32.3 ms。同一个网络,计算量随难度变化。
把论文的贡献拆开,是四件事,后面几节按这个顺序讲:
- 更快的注意力:自注意力只编码相对位置,交叉注意力只算一次相似度、双向共用。
- 更轻的匹配头:把「两个点像不像」和「这个点是否可匹配」拆成两个输出,用双 softmax 代替 Sinkhorn。
- 自适应推理:逐层置信度决定何时停(depth),逐层 matchability 决定哪些点不再参与(width)。
- 更容易训练:每一层都直接监督,浅层不再是「只为最后一层服务」的中间状态。
二、核心方法
2.1 总体架构:每一层都回答一次「谁和谁匹配」
输入是两张图各自的一组稀疏局部特征。每个特征 由归一化到 的坐标 和描述子 组成;网络为每个点维护一个状态 ,初始化为 。一层由一次自注意力(self-attention)和一次交叉注意力(cross-attention)组成,每次注意力的输出通过一个 MLP 更新状态:
其中 是从源图像 聚合来的消息, 表示拼接。自注意力里 ,交叉注意力里 是另一张图。MLP 是一个隐藏层、LayerNorm、GELU、线性投影的残差结构;默认 层、4 个头、。
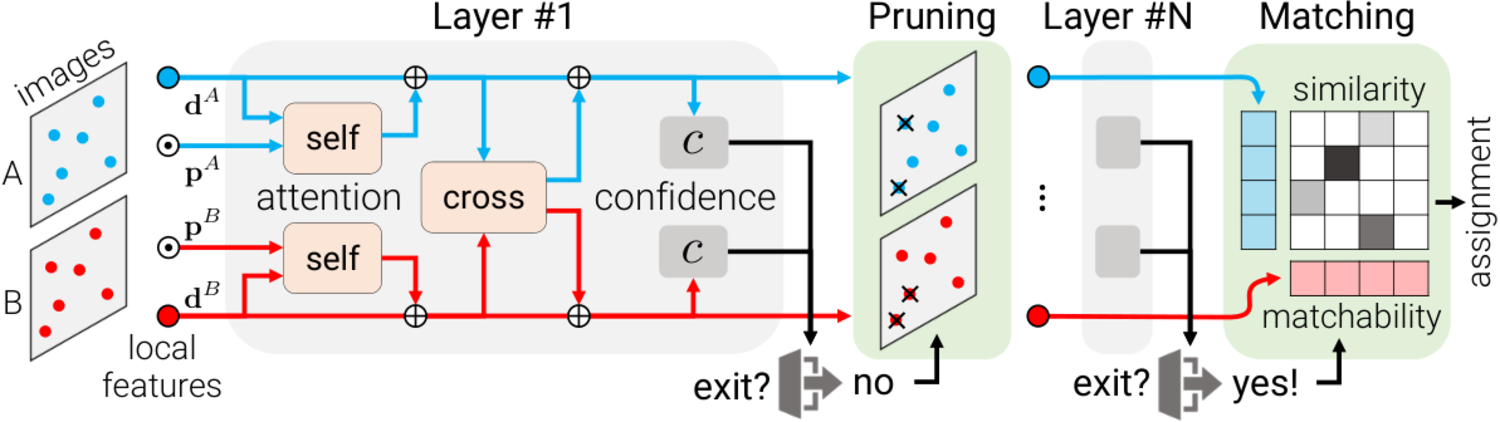
关键设计是:匹配头不只在最后一层出现。每一层结束后,网络都可以用当前状态算一个分配矩阵,并额外算每个点的置信度。轻量匹配头是后面所有自适应机制的前提:没有逐层预测,就无从判断「现在是否已经够好」;没有逐层监督,浅层预测也不可信。论文用深监督把这两件事绑在一起,2.5 节会展开。
2.2 自注意力:只编码相对位置,而且只旋转 q、k
SuperGlue 在输入端给每个描述子加一个学到的绝对位置编码,之后所有层共享。LightGlue 改成在每一次自注意力里注入相对位置,用的是 RoFormer 提出的旋转位置编码(rotary position embedding, RoPE)[8]。对点 和 ,注意力分数写成:
其中 是状态经线性变换得到的 query/key, 是相对位置 的旋转矩阵。具体做法是把 维空间分成 个二维子空间,每个子空间用一个学到的二维基 把相对位置投影成一个角度,再旋转:
图 3 中的 就是这一步:位置编码不进入 value,只旋转 query 和 key;编码对所有层相同,因此只算一次并缓存。
这个设计有三个直接后果:
- 只依赖相对位置。 在图像整体平移时不变,这正是投影几何里希望的性质;绝对坐标在不同相机、不同裁剪之间不可比。
- 不引入二次的 positional bias 矩阵。RoPE 通过旋转 实现相对性,不需要为每对点存一个偏置,复杂度仍是 的注意力本身。
- 不在交叉注意力里加位置。两张图的相对位置没有几何意义;跨图的空间关系应该由特征内容和自注意力聚合出的上下文来学,而不是靠坐标差。
消融很干净:把旋转相对编码换成绝对位置编码,合成单应测试集上的 precision/recall 从 86.8/96.3 降到 84.2/94.7,耗时只从 19.4 ms 降到 18.7 ms(表 4)。也就是说,相对编码几乎不付时间代价,却换来 +2.6 precision、+1.6 recall。
代码:自注意力块(官方 lightglue/lightglue.py,原文照录)
class SelfBlock(nn.Module):
    def __init__(
        self, embed_dim: int, num_heads: int, flash: bool = False, bias: bool = True
    ) -> None:
        super().__init__()
        self.embed_dim = embed_dim
        self.num_heads = num_heads
        assert self.embed_dim % num_heads == 0
        self.head_dim = self.embed_dim // num_heads
        self.Wqkv = nn.Linear(embed_dim, 3 * embed_dim, bias=bias)
        self.inner_attn = Attention(flash)
        self.out_proj = nn.Linear(embed_dim, embed_dim, bias=bias)
        self.ffn = nn.Sequential(
            nn.Linear(2 * embed_dim, 2 * embed_dim),
            nn.LayerNorm(2 * embed_dim, elementwise_affine=True),
            nn.GELU(),
            nn.Linear(2 * embed_dim, embed_dim),
        )

    def forward(
        self,
        x: torch.Tensor,
        encoding: torch.Tensor,
        mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:
        qkv = self.Wqkv(x)
        qkv = qkv.unflatten(-1, (self.num_heads, -1, 3)).transpose(1, 2)
        q, k, v = qkv[..., 0], qkv[..., 1], qkv[..., 2]
        q = apply_cached_rotary_emb(encoding, q)
        k = apply_cached_rotary_emb(encoding, k)
        context = self.inner_attn(q, k, v, mask=mask)
        message = self.out_proj(context.transpose(1, 2).flatten(start_dim=-2))
        return x + self.ffn(torch.cat([x, message], -1))
2.3 交叉注意力:相似度只算一次,双向共用
交叉注意力是另一个大开销。标准做法是分别算 和 两个方向的注意力,每个方向都要一套 query/key/value 和一份相似度矩阵。LightGlue 注意到,交叉注意力里其实不需要 query:每个点只需要一个 key,方向 的分数和反方向是同一个内积:
于是只算一次 的相似度矩阵,行 softmax 给 ,列 softmax 给 ,消息分别聚合。论文把这种结构叫双向交叉注意力(bidirectional cross-attention)。复杂度仍是 ,但常数减半;在表 4 的消融里,完整交叉注意力是 86.6/96.1、22.8 ms,双向版是 86.8/96.3、19.4 ms,精度不降、耗时少约 15%。论文正文说节省 20%,差异来自测量口径。
更重要的是它和后面的匹配头配合:交叉注意力只需要一组 key,说明「哪些点值得和另一张图比较」可以由同一组表示同时服务两个方向。剪枝一个点,两个方向都省。
代码:双向交叉注意力(官方 lightglue/lightglue.py,原文节选:forward)
    def forward(
        self, x0: torch.Tensor, x1: torch.Tensor, mask: Optional[torch.Tensor] = None
    ) -> List[torch.Tensor]:
        qk0, qk1 = self.map_(self.to_qk, x0, x1)
        v0, v1 = self.map_(self.to_v, x0, x1)
        qk0, qk1, v0, v1 = map(
            lambda t: t.unflatten(-1, (self.heads, -1)).transpose(1, 2),
            (qk0, qk1, v0, v1),
        )
        if self.flash is not None and qk0.device.type == "cuda":
            m0 = self.flash(qk0, qk1, v1, mask)
            m1 = self.flash(
                qk1, qk0, v0, mask.transpose(-1, -2) if mask is not None else None
            )
        else:
            qk0, qk1 = qk0 * self.scale**0.5, qk1 * self.scale**0.5
            sim = torch.einsum("bhid, bhjd -> bhij", qk0, qk1)
            if mask is not None:
                sim = sim.masked_fill(~mask, -float("inf"))
            attn01 = F.softmax(sim, dim=-1)
            attn10 = F.softmax(sim.transpose(-2, -1).contiguous(), dim=-1)
            m0 = torch.einsum("bhij, bhjd -> bhid", attn01, v1)
            m1 = torch.einsum("bhji, bhjd -> bhid", attn10.transpose(-2, -1), v0)
            if mask is not None:
                m0, m1 = m0.nan_to_num(), m1.nan_to_num()
        m0, m1 = self.map_(lambda t: t.transpose(1, 2).flatten(start_dim=-2), m0, m1)
        m0, m1 = self.map_(self.to_out, m0, m1)
        x0 = x0 + self.ffn(torch.cat([x0, m0], -1))
        x1 = x1 + self.ffn(torch.cat([x1, m1], -1))
        return x0, x1
2.4 匹配头:把「相似」和「可匹配」拆开
SuperGlue 的匹配头把相似度和 dustbin 一起送进 Sinkhorn,迭代出一张双随机矩阵。Sinkhorn 在训练时需要约 100 次迭代才能稳定,既费计算也费显存;dustbin 还会把所有点的相似度耦合在一起,梯度不够干净。LightGlue 换成一个没有迭代的闭式头。
先算 pairwise 相似度。每个点的状态经一个线性投影,然后做内积:
再给每个点算一个 可匹配性(matchability),表示「这个点在另一张图里到底有没有对应点」:
最后把两者合成分配矩阵:
这就是论文说的双 softmax:先沿列做一次 softmax,再沿行做一次 softmax。它等价于一个可微的互最近邻(mutual nearest neighbor)松弛:只有当 在 中相对 的所有点足够突出,且 在 中相对 的所有点也足够突出时, 才会大。推理时再取双向 argmax,并要求分数大于阈值 ,得到最终匹配。
这个头的关键不是「双 softmax 比 Sinkhorn 更准」,而是它把两种信息解耦了:
- 相似度矩阵负责「谁看起来像谁」,它会产生很多候选,包括重复纹理造成的错误候选;
- matchability 是一个 unary 项,只由每个点自己的状态决定,负责把「在另一张图里根本不可见」的点整体压暗。
SuperGlue 的 dustbin 把这两件事混在一个归一化里,LightGlue 则让它们各司其职。代码里仍然保留 dustbin 行/列,但那些分数只来自 的 log sigmoid,不再由 pairwise 相似度共同决定;因此梯度不会被所有点纠缠。
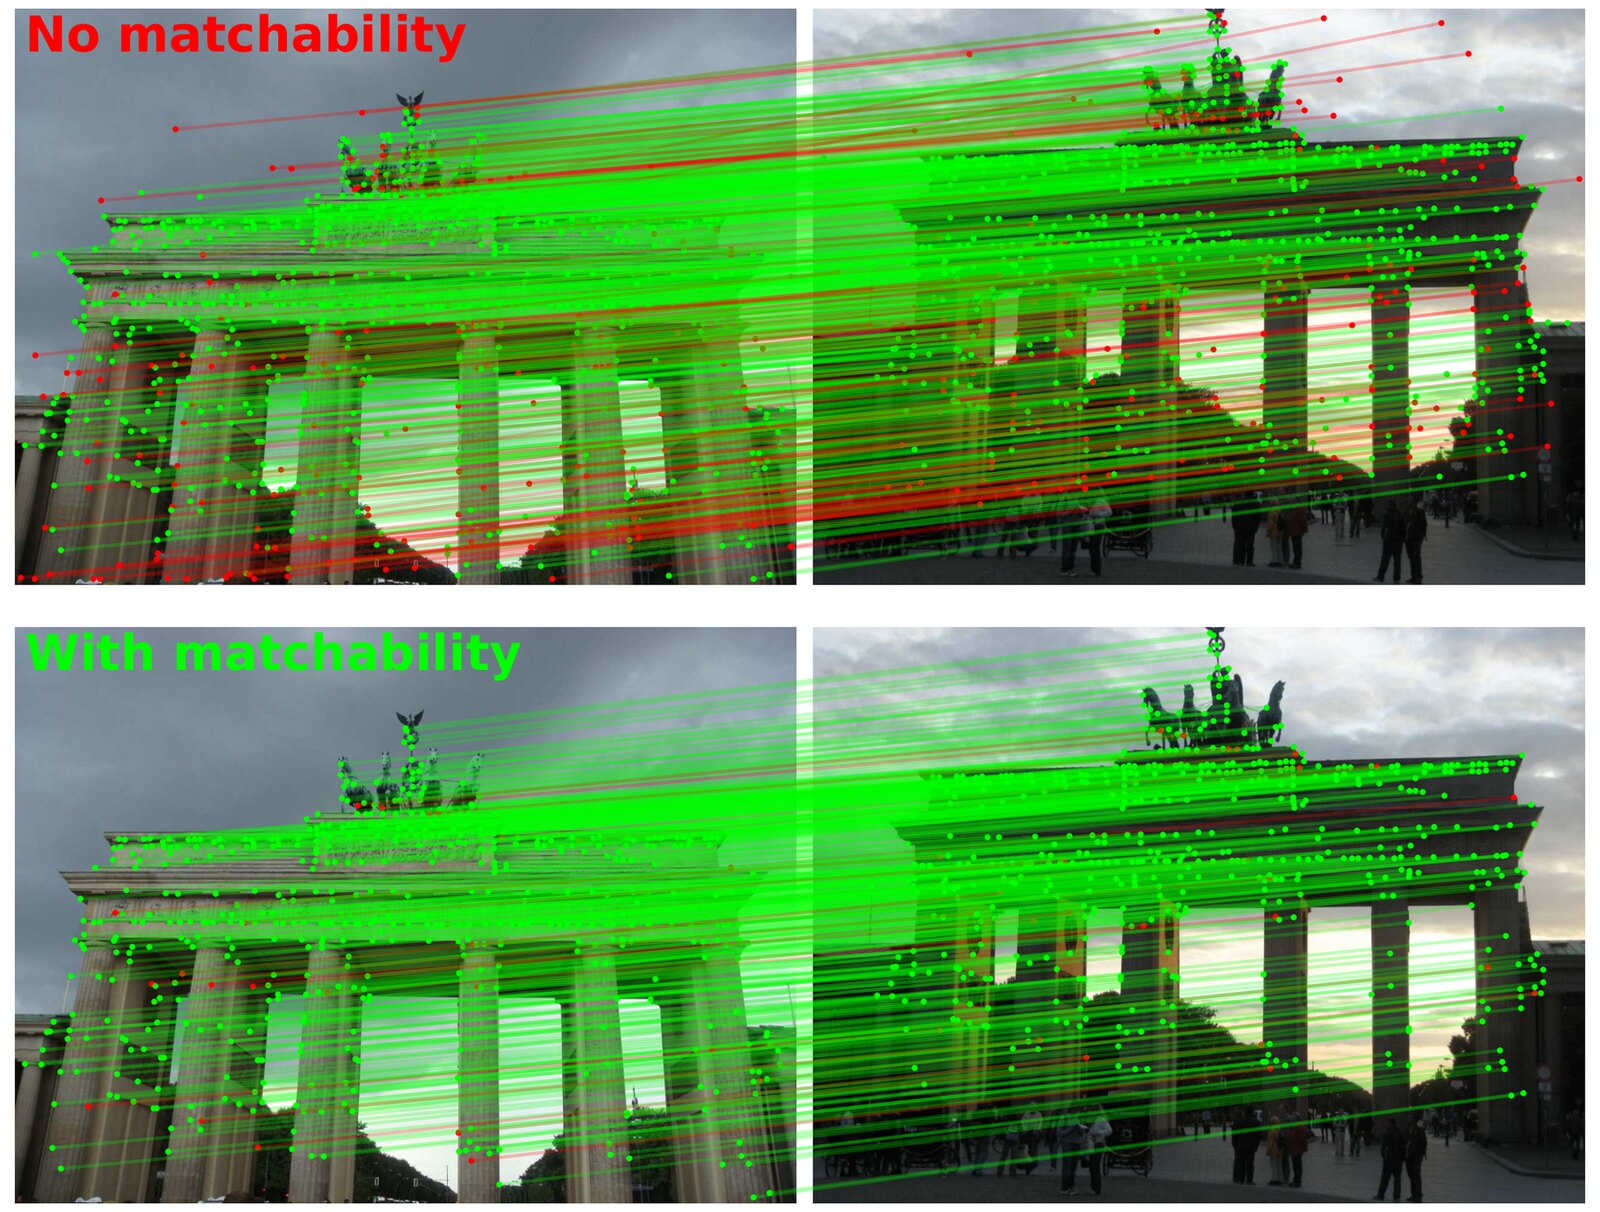
消融的结果是全文最大的单项差距:去掉 matchability,precision 从 86.8 掉到 67.4,recall 反而从 96.3 升到 97.0,耗时 18.9 ms(表 4)。换句话说,没有 matchability,网络会给出更多匹配,但其中大量是错的;matchability 把「多」换成了「准」。Figure 6 是定性的例子:关闭 matchability 时,勃兰登堡门上出现大量红色错误连线;打开后,大部分重复结构和背景误匹配被压掉。
代码:双 softmax 与 matchability 匹配头(官方 lightglue/lightglue.py,原文照录)
def sigmoid_log_double_softmax(
    sim: torch.Tensor, z0: torch.Tensor, z1: torch.Tensor
) -> torch.Tensor:
    """create the log assignment matrix from logits and similarity"""
    b, m, n = sim.shape
    certainties = F.logsigmoid(z0) + F.logsigmoid(z1).transpose(1, 2)
    scores0 = F.log_softmax(sim, 2)
    scores1 = F.log_softmax(sim.transpose(-1, -2).contiguous(), 2).transpose(-1, -2)
    scores = sim.new_full((b, m + 1, n + 1), 0)
    scores[:, :m, :n] = scores0 + scores1 + certainties
    scores[:, :-1, -1] = F.logsigmoid(-z0.squeeze(-1))
    scores[:, -1, :-1] = F.logsigmoid(-z1.squeeze(-1))
    return scores


class MatchAssignment(nn.Module):
    def __init__(self, dim: int) -> None:
        super().__init__()
        self.dim = dim
        self.matchability = nn.Linear(dim, 1, bias=True)
        self.final_proj = nn.Linear(dim, dim, bias=True)

    def forward(self, desc0: torch.Tensor, desc1: torch.Tensor):
        """build assignment matrix from descriptors"""
        mdesc0, mdesc1 = self.final_proj(desc0), self.final_proj(desc1)
        _, _, d = mdesc0.shape
        mdesc0, mdesc1 = mdesc0 / d**0.25, mdesc1 / d**0.25
        sim = torch.einsum("bmd,bnd->bmn", mdesc0, mdesc1)
        z0 = self.matchability(desc0)
        z1 = self.matchability(desc1)
        scores = sigmoid_log_double_softmax(sim, z0, z1)
        return scores, sim

    def get_matchability(self, desc: torch.Tensor):
        return torch.sigmoid(self.matchability(desc)).squeeze(-1)
2.5 逐层监督:让浅层预测变成可用的预测
光有轻量匹配头还不够。如果只在最后一层监督,前面的层会退化成「为最后一层提供特征」的中间状态,早停拿到的预测不可信。LightGlue 的做法是每一层都算 loss:对每一层 ,用该层自己的匹配头预测分配矩阵,然后对所有 ground-truth 匹配 最大化其对数似然,同时对标注为不可匹配的点 最大化「不被匹配」的概率:
ground truth 来自单应或「深度 + 相对位姿」的重投影:重投影误差小于阈值、且互为最近邻的点是正样本;找不到对应点、或最近邻误差过大的点是负样本。每一项都在 log 空间里算,数值上等价于 balanced NLL;代码里正负样本的权重由 nll_balancing: 0.5 控制。
置信度分类器是第二阶段单独训练的。它是一个线性层加 sigmoid,输入是当前层的状态(detach 后,梯度不回传到匹配特征),监督信号不是 ground truth,而是当前层的 argmax 是否与最后一层的 argmax 一致。也就是说,它学的是「我的答案会不会被后面的层改掉」,而不是「我的答案对不对」。这个目标更接近早停真正需要的判断:如果当前预测已经和最终预测一致,再算下去大概率不会改变结果。论文附录特别说明,分类器的梯度不回传到状态,避免它干扰匹配精度。
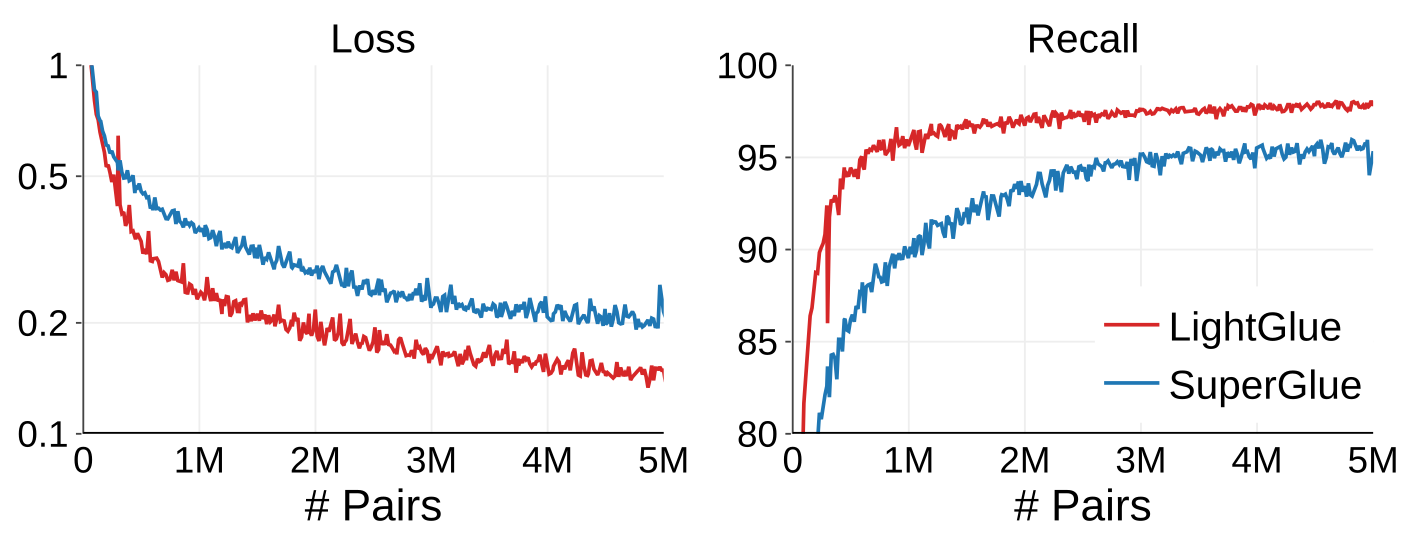
这一步是 LightGlue 和 SuperGlue 训练上最本质的差别。SuperGlue 的 Sinkhorn 太贵,无法在每层都预测并监督,只能监督最后一层;LightGlue 的闭式头让每层都能输出,于是深监督成为可能。收益不只是「早停可用」:论文报告在合成单应预训练上,LightGlue 用 5M 对、约 2 个 GPU 天达到的损失比 SuperGlue 低 33%,召回高 4%;SuperGlue 需要 7 天以上才能接近同样的精度(Figure 5)。这也是论文标题里「更容易训练」的来源。
浅层到底有多可用?表 4 的消融给了一个直接的答案:只用第 5/9 层的预测,precision/recall 是 78.1/92.7,耗时 11.9 ms;完整 9 层是 86.8/96.3,19.4 ms。第 5 层已经是一个「能用的粗匹配器」,但还不是「和最终答案一样好」;自适应机制要做的,是在简单对上用第 5 层,在难对上继续算,而不是永远固定在第 5 层。
代码:逐层监督与置信度损失(官方 glue-factory,原文照录:LightGlue.loss)
    def loss(self, pred, data):
        def loss_params(pred, i):
            la, _ = self.log_assignment[i](
                pred["ref_descriptors0"][:, i], pred["ref_descriptors1"][:, i]
            )
            return {
                "log_assignment": la,
            }

        sum_weights = 1.0
        nll, gt_weights, loss_metrics = self.loss_fn(loss_params(pred, -1), data)
        N = pred["ref_descriptors0"].shape[1]
        losses = {"total": nll, "last": nll.clone().detach(), **loss_metrics}

        if self.training:
            losses["confidence"] = 0.0

        # B = pred['log_assignment'].shape[0]
        losses["row_norm"] = pred["log_assignment"].exp()[:, :-1].sum(2).mean(1)
        for i in range(N - 1):
            params_i = loss_params(pred, i)
            nll, _, _ = self.loss_fn(params_i, data, weights=gt_weights)

            if self.conf.loss.gamma > 0.0:
                weight = self.conf.loss.gamma ** (N - i - 1)
            else:
                weight = i + 1
            sum_weights += weight
            losses["total"] = losses["total"] + nll * weight

            losses["confidence"] += self.token_confidence[i].loss(
                pred["ref_descriptors0"][:, i],
                pred["ref_descriptors1"][:, i],
                params_i["log_assignment"],
                pred["log_assignment"],
            ) / (N - 1)

            del params_i
        losses["total"] /= sum_weights

        # confidences
        if self.training:
            losses["total"] = losses["total"] + losses["confidence"]

        if not self.training:
            # add metrics
            metrics = matcher_metrics(pred, data)
        else:
            metrics = {}
        return losses, metrics
逐层预测到底长什么样?下面的部件用一个 36×36 的示意矩阵把它画出来:15 个真匹配在对角线上,7 个重复结构诱饵在非对角线上,其余点不可匹配。拖动层数可以看到对角线逐渐变亮、诱饵逐渐变暗;取消 matchability 则诱饵重新出现。矩阵是手工构造的示意,不是真实网络输出,但趋势对应表 4 和 Figure 6。
2.6 自适应深度:置信度够了就走
每一层结束后(最后一层除外),网络为每个点算一个置信度:
如果所有点中「置信度超过阈值 」的比例超过 ,就停止推理,直接把当前层的预测作为输出:
这里 是用户可调的早停置信度,默认 0.95; 是逐层阈值,按下面的指数形式衰减:
阈值在浅层更高( 时约 0.864, 时约 0.802),意思是「早期层要更自信才允许退出」。原因是分类器本身在浅层更不准,如果用一个统一的低阈值,网络会在还没看清时就跑掉。这个衰减曲线是在验证集上按每层分类器的准确率拟合的。
直接控制速度-精度权衡。表 11 在 MegaDepth 上给出了一组很清楚的数:
表 11:MegaDepth 上早停设置的消融。匹配数、precision 和 AUC 是相对位姿估计的结果,“相对耗时”以固定 9 层为 100%。
| 设置 | 匹配数 | precision | AUC@5° | AUC@10° | AUC@20° | 耗时 |
|---|---|---|---|---|---|---|
| 完整 9 层 | 613 | 96.2 | 66.7 | 79.3 | 87.9 | 100% |
| 固定 7 层 | 705 | 96.0 | 66.2 | 79.1 | 88.0 | 82.4% |
| 固定 5 层 | 702 | 94.5 | 65.0 | 77.8 | 87.0 | 60.0% |
| 固定 3 层 | 687 | 90.0 | 64.0 | 76.7 | 85.8 | 41.9% |
| 置信度 98% | 610 | 96.2 | 66.6 | 79.3 | 88.0 | 80.5% |
| 置信度 95% | 608 | 95.4 | 66.3 | 79.0 | 87.9 | 70.6% |
| 置信度 90% | 607 | 94.5 | 65.9 | 78.5 | 87.2 | 61.5% |
| 置信度 80% | 605 | 92.6 | 65.2 | 77.8 | 86.7 | 48.4% |
注意两件事。第一,自适应早停比「固定砍到同样层数」更好:95% 置信度用 70.6% 的时间拿到 66.3,而固定第 5 层用 60.0% 的时间只有 65.0;98% 置信度用 80.5% 的时间拿到 66.6,接近完整模型的 66.7。第二,早停主要牺牲 precision,recall 和 AUC 掉得慢;这也是为什么在 SLAM 这类对匹配数量不敏感、对精度敏感的任务里,95% 是一个好默认值。
Figure 2 是同一机制的直观版本:简单对在第 3 层退出,16.9 ms;困难对在第 8 层退出,32.3 ms。分类器本身只增加约 2% 的推理时间,但大多数时候省下的远不止 2%。
早停不是 LightGlue 首创。BranchyNet 在 CNN 上做过类似的 early exiting,Anytime Dense Prediction 把置信度自适应用在稠密预测上[9, 10];LightGlue 的新意是把早停和「每层都能输出匹配」的轻量头、以及后面的点剪枝组合在同一个匹配器里。没有逐层监督,置信度分类器没有可靠的训练信号;没有轻量头,逐层预测本身就会把省下的时间吃回去。
代码:早停阈值与退出判定(官方 lightglue/lightglue.py,原文照录)
    def confidence_threshold(self, layer_index: int) -> float:
        """scaled confidence threshold"""
        threshold = 0.8 + 0.1 * np.exp(-4.0 * layer_index / self.conf.n_layers)
        return np.clip(threshold, 0, 1)

    def get_pruning_mask(
        self, confidences: torch.Tensor, scores: torch.Tensor, layer_index: int
    ) -> torch.Tensor:
        """mask points which should be removed"""
        keep = scores > (1 - self.conf.width_confidence)
        if confidences is not None:  # Low-confidence points are never pruned.
            keep |= confidences <= self.confidence_thresholds[layer_index]
        return keep

    def check_if_stop(
        self,
        confidences0: torch.Tensor,
        confidences1: torch.Tensor,
        layer_index: int,
        num_points: int,
    ) -> torch.Tensor:
        """evaluate stopping condition"""
        confidences = torch.cat([confidences0, confidences1], -1)
        threshold = self.confidence_thresholds[layer_index]
        ratio_confident = 1.0 - (confidences < threshold).float().sum() / num_points
        return ratio_confident > self.conf.depth_confidence
这段代码把
get_pruning_mask也放在了一起,因为早停和剪枝共用同一个confidence_thresholds表;2.7 节会单独讲剪枝的判定。
2.7 自适应宽度:低匹配概率的点不再参与后续层
早停决定「算到第几层」,点剪枝决定「每层算多少个点」。后者的依据是 matchability:如果一个点被网络自信地判定为不可匹配,它在后续层里大概率不会变成可匹配,继续让它参与注意力只是浪费。判定写成:
其中 是 matchability 阈值。两个条件缺一不可:只看 低就剪,会误删那些「当前层还没看清、但后面可能匹配上」的点;加上「置信度高」这个条件,只剪「已经看清了,确实不可匹配」的点。代码里的 width_confidence=0.99 对应 ,keep = scores > 1 - width_confidence;keep |= confidences <= threshold 又把低置信度的点强制保留,和公式完全一致。
剪枝在每个中间层结束后做,最后一层不做。原因是最后一层没有再「后续」可言,剪了也不会省计算。每次剪枝用 index_select 把保留下来的描述子和位置编码取出来,同时用 prune0/prune1 记录每个原始点是在第几层被剪掉的,最后再把匹配索引映射回原始关键点。这个 gather/scatter 本身有开销,所以代码只在点数足够多时才启用:FlashAttention 下阈值是 1536,普通 CUDA 是 1024,CPU 和 MPS 直接关掉(pruning_keypoint_thresholds)。这也是一个很实际的工程取舍:小输入上剪枝省下的注意力还不够补偿索引操作。
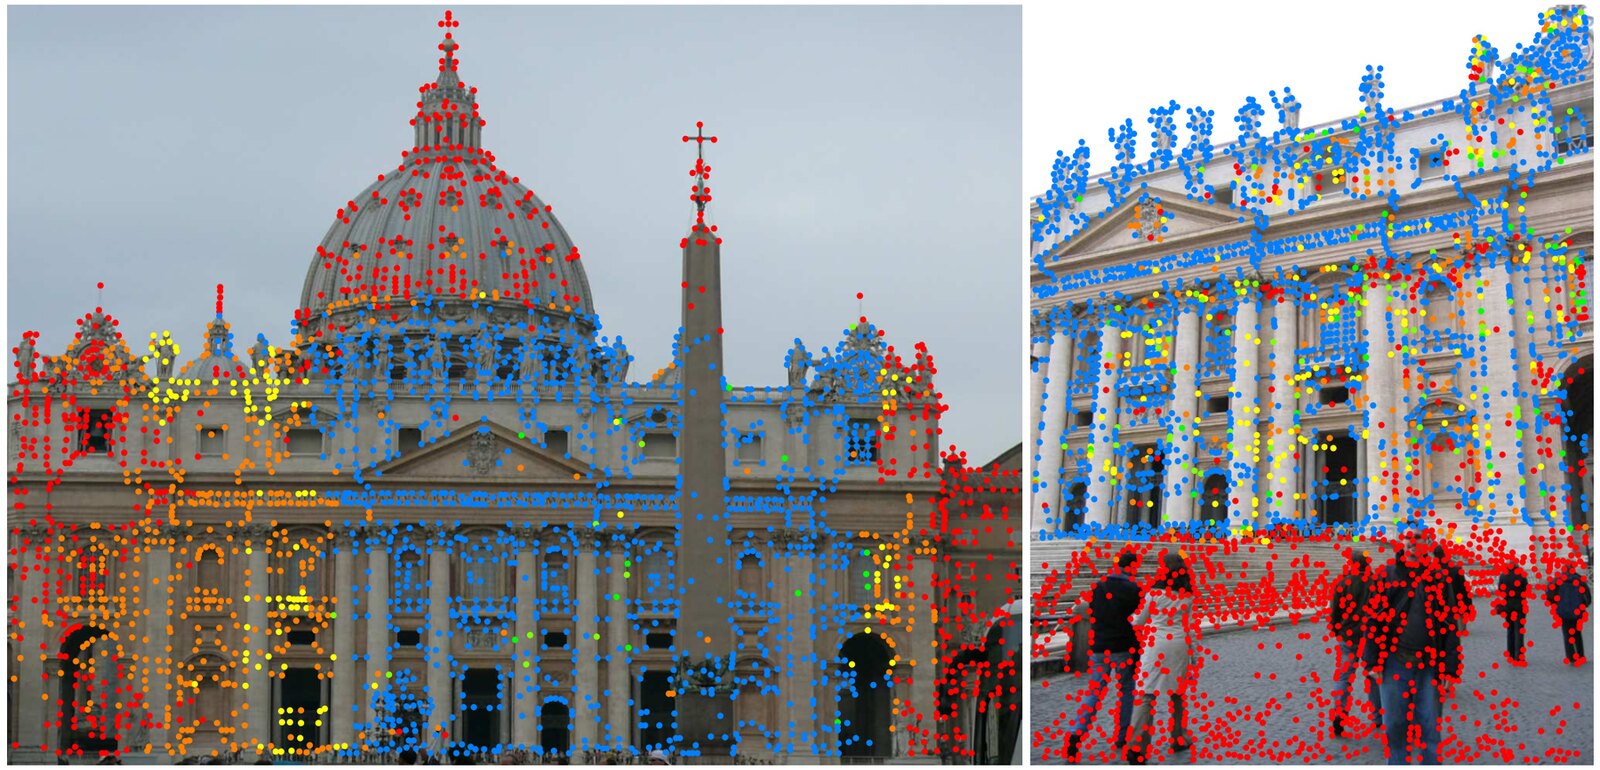
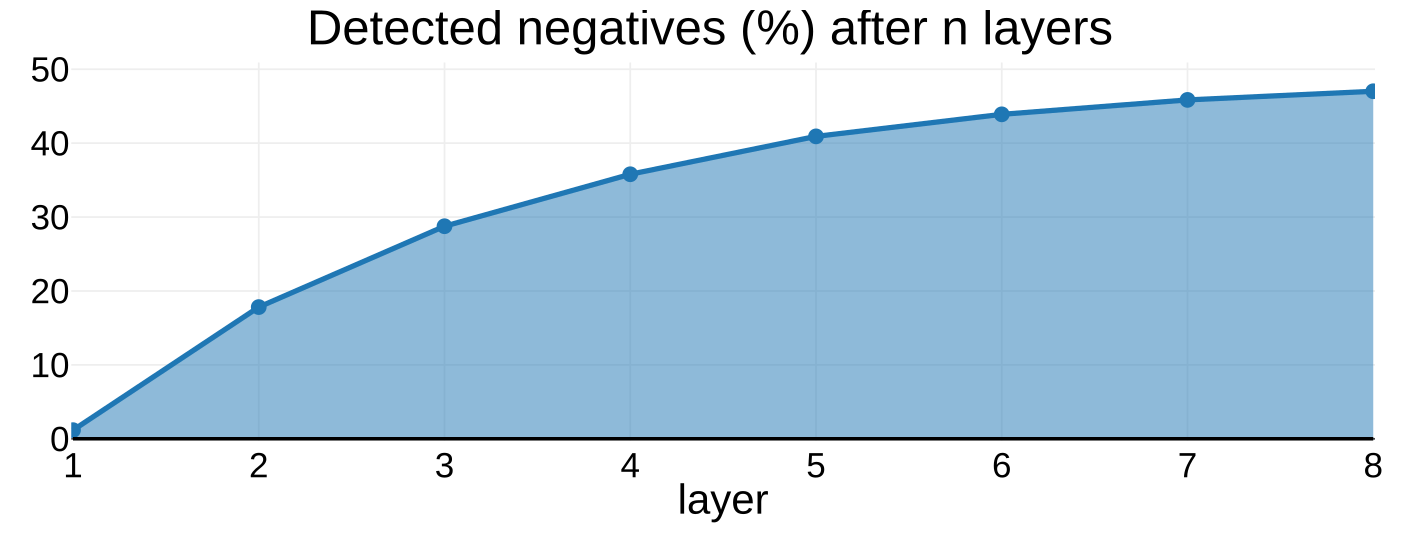
表 5 把深度和宽度的收益放在一起:
表 5:自适应深度与宽度在 MegaDepth 不同重叠度图像对上的效果。停止层数相对 9 层,“不可匹配点比例”是剪掉的点的平均比例,加速相对非自适应版。
| 难度 | 平均停止层数 | 不可匹配点比例 | 相对非自适应加速 |
|---|---|---|---|
| 简单 | 4.7 / 9 | 19.8% | 1.86× |
| 中等 | 5.5 / 9 | 23.4% | 1.33× |
| 困难 | 6.9 / 9 | 27.9% | 1.16× |
| 平均 | 5.7 / 9 | 23.7% | 1.45× |
这张表有一个反直觉的地方:难对的剪枝率更高,但加速反而更小。原因是难对需要更多层,深度的收益被抵消了;简单对虽然只剪掉约 20% 的点,但它在第 5 层左右就退出,深度和宽度同时省,所以加速最大。论文报告整体运行时间降低 33%,并特别指出自适应机制对简单对最有效,这和表 5 的 1.86× 一致。
代码:点剪枝的推理循环(官方 lightglue/lightglue.py,原文节选)
        for i in range(self.conf.n_layers):
            if desc0.shape[1] == 0 or desc1.shape[1] == 0:  # no keypoints
                break
            desc0, desc1 = self.transformers[i](
                desc0, desc1, encoding0, encoding1, mask0=mask0, mask1=mask1
            )
            if i == self.conf.n_layers - 1:
                continue  # no early stopping or adaptive width at last layer

            if do_early_stop:
                token0, token1 = self.token_confidence[i](desc0, desc1)
                if self.check_if_stop(token0[..., :m], token1[..., :n], i, m + n):
                    break
            if do_point_pruning and desc0.shape[-2] > pruning_th:
                scores0 = self.log_assignment[i].get_matchability(desc0)
                prunemask0 = self.get_pruning_mask(token0, scores0, i)
                keep0 = torch.where(prunemask0)[1]
                ind0 = ind0.index_select(1, keep0)
                desc0 = desc0.index_select(1, keep0)
                encoding0 = encoding0.index_select(-2, keep0)
                prune0[:, ind0] += 1
            if do_point_pruning and desc1.shape[-2] > pruning_th:
                scores1 = self.log_assignment[i].get_matchability(desc1)
                prunemask1 = self.get_pruning_mask(token1, scores1, i)
                keep1 = torch.where(prunemask1)[1]
                ind1 = ind1.index_select(1, keep1)
                desc1 = desc1.index_select(1, keep1)
                encoding1 = encoding1.index_select(-2, keep1)
                prune1[:, ind1] += 1
2.8 两个旋钮合起来:一笔算力预算
把 和 width_confidence 放在一起,就能看到 LightGlue 的实际工作方式:每层结束后先看置信度,够自信就整对退出;不够自信就继续,但把「自信地不可匹配」的点从下一层的输入里删掉。前者省层数,后者省每层的宽度;两者都依赖同一个 matchability/confidence 头。
下面的部件把这两个旋钮做成可拖动的模拟器。默认是简单对、、宽度置信度 0.99,对应论文表 5 的 easy 行:4.7 层、剪掉 19.8%、1.86× 加速、AUC@5° 66.3。把 拉低,层数和耗时下降,AUC 也跟着掉;把宽度置信度拉低,剪枝更激进,难对的加速更明显。数值是按表 5 的三个难度基准和表 11 的 -AUC 曲线插值出来的示意模型,真实网络每对图的层数由置信度逐层决定,不会正好落在这些小数上。
拖一拖会发现两个不对称。第一, 主要影响简单对:简单对在 时约 5.0 层,降到 0.80 后只剩 3.5 层;困难对从 7.2 层只降到 5.7 层,仍有大半计算要付。第二,宽度旋钮对难对更有效:简单对本来就只剪 20% 左右,再激进也省不了多少;难对的不可匹配点更多,把宽度置信度从 0.99 拉到 0.95,剪枝率能从 27.9% 升到 39.8%,加速从 1.16× 升到 1.66×。这也解释了为什么论文的整体 33% 是深度和宽度共同贡献的,单独看任何一个都会低估。
2.9 与 SuperGlue 的逐项差别
把前面的改动汇总成一张表,能更清楚地看到 LightGlue 不是「SuperGlue 加一个早停开关」,而是从位置编码到匹配头都重做了一遍:
| 组件 | SuperGlue | LightGlue |
|---|---|---|
| 位置编码 | 输入端加学到的绝对位置编码,所有层共享 | 每次自注意力用旋转相对位置编码;交叉注意力不加位置 |
| 交叉注意力 | 两个方向分别算 query/key/value 和相似度 | 只算 key,一次相似度双向复用 |
| 匹配头 | Sinkhorn + dustbin,多次迭代 | 双 softmax + unary matchability,无迭代 |
| 逐层预测 | 只有最后一层 | 每层都有 assignment 和 confidence |
| 推理 | 固定 层 | 置信度早停 + matchability 点剪枝 |
| 训练 | 只监督最后一层 | 每层深监督;置信度分类器单独训练 |
| MegaDepth-1500 | 65.8 AUC@5°、70.0 ms | 66.7 AUC@5°、44.2 ms(自适应 66.3、31.4 ms) |
| HPatches precision | 87.4% | 88.9% |
最后两行不是「架构差别」,但把它们放在同一张表里,能直观看到改动累积后的结果。接下来进入实验细节。
三、实验结果
3.1 训练与评测设置
先澄清两个容易混淆的基准:这篇论文没有在 ScanNet-1500 上评测,也没有 IMC 2022 的结果。它的完整评测集是 HPatches[11]、MegaDepth-1500/1800[12]、Aachen Day-Night(含 v1.1)[13]、InLoc[14]、IMC 2020/2021[15],以及 IMC 2023 的排行榜[16]。ScanNet 的室内匹配数字通常来自 LoFTR、DKM 这类稠密匹配论文;IMC 2022 是另一届比赛。把那些数字安到 LightGlue 头上会误导,所以本文只报告论文真正跑过的基准。
训练分两阶段。第一阶段在 Oxford-Paris 的 17 万张图上生成合成单应做预训练:图像缩放到 640×480,SuperPoint/SIFT/DISK 分别取 512/1024/1024 个关键点,batch 64,初始学习率 ,20 个 epoch 后每 epoch 乘 0.8,总共 40 个 epoch(约 6M 图像对),2 张 RTX 3090 训练 2 天。论文报告验证/测试集上 recall > 99%、precision > 90%。第二阶段在 MegaDepth 上微调:368/5/24 个场景做训练/验证/测试,图像长边 1024、零填充到 1024×1024,每图取 top-2048 个关键点,batch 32,学习率 ,10 个 epoch 后每 epoch 乘 0.95,训练 50 个 epoch(2 天,2 张 3090)。缓存检测子和描述子约占 200 GB 磁盘;训练时用梯度检查点(gradient checkpointing)和混合精度,把 32 对图像塞进单张 24 GB 显卡。
MegaDepth 的 ground truth 由「深度 + 相对位姿」重投影得到:重投影误差小于 3 px 且互为最近邻的点是正样本;最近邻误差大于 5 px、没有深度、或 Sampson 误差大于 3 px 的点是负样本。这个标注策略和 SuperGlue 类似,但 LightGlue 用了 2k 个关键点而不是 1k,论文说这对精度有直接帮助。
评测口径也要注意:HPatches 用最长边 480 px、每图 1024 个 SuperPoint 特征;MegaDepth-1500 用 2048 个特征、长边 1600 px;Aachen 用最多 4096 个特征,接 hloc 的 NetVLAD 检索 + PnP RANSAC;IMC 用各自的 SfM 流程。时间数字只算匹配网络,不含特征提取和鲁棒估计;Aachen 的「对/秒」是匹配阶段的吞吐。这些口径决定了表里的数字不能和端到端 SLAM 的帧率直接等同。
3.2 HPatches:匹配质量与 DLT
HPatches 是平面场景的单应估计基准,包含光照和视角变化。表 1 同时看两件事:原始匹配的召回/精度(3 px 重投影误差),以及用 RANSAC 或加权 DLT 估计单应后的 AUC。
| 方法 | R (%) | P (%) | RANSAC AUC@1px | RANSAC AUC@5px | DLT AUC@1px | DLT AUC@5px |
|---|---|---|---|---|---|---|
| SuperPoint NN+mutual | 72.7 | 67.2 | 35.0 | 75.3 | 0.0 | 2.0 |
| SuperPoint + SuperGlue | 94.9 | 87.4 | 38.3 | 79.3 | 33.8 | 76.7 |
| SuperPoint + SGMNet | 95.5 | 83.0 | 38.6 | 79.0 | 31.7 | 76.0 |
| SuperPoint + LightGlue | 94.3 | 88.9 | 38.3 | 79.6 | 35.9 | 78.6 |
| LoFTR(1024 匹配) | - | 92.7 | 41.5 | 78.8 | 38.5 | 70.6 |
表 1:HPatches 单应估计。R/P 是原始匹配在 3 px 下的召回/精度;后四列是单应估计的 AUC。LightGlue 在稀疏匹配器中 precision 最高,DLT 的 AUC@5px 也高于 SuperGlue。
LightGlue 的原始召回略低于 SuperGlue(94.3 vs 94.9),但精度更高(88.9 vs 87.4)。这个「少一点、准一点」的取舍在 DLT 上体现得最明显:LightGlue 的 DLT AUC@5px 是 78.6,SuperGlue 是 76.7;DLT 这种不带鲁棒估计的最小二乘解法,最怕外点,匹配精度提高后它就能接近 RANSAC 的效果。论文因此说 LightGlue 让 DLT 这种简单解法足以和更贵、更慢的 MAGSAC 竞争[17]。和稠密匹配器比,LoFTR 的 RANSAC AUC@1px 更高(41.5),但 DLT 明显更差(70.6),说明稠密匹配的对应点数量多、粗精度好,但外点比例不一定更低。
3.3 MegaDepth-1500:精度、速度与「自适应」的代价
MegaDepth-1500 是论文的主战场:1500 对来自 St. Peter’s Square 和 Reichstag 的图像,按视觉重叠平衡难度,评相对位姿的 AUC@5°/10°/20°。表 2 是主结果。
| 方法 | RANSAC AUC@5/10/20 | LO-RANSAC AUC@5/10/20 | 时间 (ms) |
|---|---|---|---|
| SuperPoint + SuperGlue | 49.7 / 67.1 / 80.6 | 65.8 / 78.7 / 87.5 | 70.0 |
| SuperPoint + SGMNet | 43.2 / 61.6 / 75.6 | 59.8 / 74.1 / 83.9 | 73.8 |
| SuperPoint + LightGlue | 49.9 / 67.0 / 80.1 | 66.7 / 79.3 / 87.9 | 44.2 |
| LightGlue-adaptive | 49.4 / 67.2 / 80.1 | 66.3 / 79.0 / 87.9 | 31.4 |
| LoFTR | 52.8 / 69.2 / 81.2 | 66.4 / 78.6 / 86.5 | 181 |
| MatchFormer | 53.3 / 69.7 / 81.8 | 66.5 / 78.9 / 87.5 | 388 |
| ASpanFormer | 55.3 / 71.5 / 83.1 | 69.4 / 81.1 / 88.9 | 369 |
| DISK + LightGlue | 43.5 / 61.0 / 75.3 | 61.3 / 74.3 / 83.8 | 44.5 |
表 2:MegaDepth-1500 相对位姿估计。2048 个特征,图像长边 1600 px;时间为匹配阶段,不含特征提取和 RANSAC。
几个要点。第一,在稀疏匹配器内部,LightGlue 比 SuperGlue 高 0.9 AUC@5°(66.7 vs 65.8),耗时少 37%(44.2 vs 70.0 ms);SGMNet 在这个基准上既慢又低。第二,自适应版只掉 0.4 AUC@5°(66.3),却把时间压到 31.4 ms,比 SuperGlue 快 2.2 倍;这就是「用一点点精度换大量延迟」的典型。第三,稠密匹配器在精度上仍然强:ASpanFormer 69.4 最高,LoFTR 和 MatchFormer 在 LO-RANSAC 下是 66.4/66.5,和 LightGlue 的 66.7 基本同档;但它们的耗时是 181–388 ms,LightGlue 是 44.2 ms。论文的结论是 Pareto 最优:在「精度-速度」平面上,LightGlue 没有被任何一个稠密匹配器同时支配。
DISK + LightGlue 值得单独看。DISK 的描述子更强、检测更可重复,但如果没有好的匹配器,DISK + 最近邻 + ratio 只有 38.1/55.4/69.6(RANSAC@5/10/20),57.2/69.5/78.6(LO-RANSAC),7.4 ms;接上 LightGlue 后变成 43.5/61.0/75.3、61.3/74.3/83.8,耗时 44.5 ms。精度提升很大,代价是匹配时间变长;这说明 LightGlue 的收益不只对 SuperPoint 成立,换一套局部特征仍然有效。
关于 DKM:它不在论文的对比表里。DKM 是 CVPR 2023 的稠密匹配器,不做稀疏关键点的图匹配,而是在稠密特征图上用高斯过程回归出 warp,再用深度一致性监督置信度[18]。把 DKM 在 ScanNet/MegaDepth 上的数字和 LightGlue 的 MegaDepth-1500 数字并排,会因为输入分辨率、特征、鲁棒估计和计时口径不同而不可比;这里只把它作为「稠密 warp vs 稀疏图匹配」的路线对照,不强行排名。
显存方面,论文没有给出 VRAM 表,只给了训练配置:单张 24 GB 卡装 32 对 1024×1024,靠梯度检查点和混合精度;推理侧能确定的是注意力复杂度 、双向交叉注意力把相似度计算减半、点剪枝减少 ,以及 FlashAttention 对 IO 和显存的优化[19]。除此之外的具体显存数字,本文没有报告,也不应该替它编。
3.4 Aachen Day-Night 与 InLoc:视觉定位
Aachen Day-Night 是长期视觉定位基准:白天参考图、昼夜查询图,用 hloc 检索 50 张参考图,匹配后 PnP + RANSAC,报告不同阈值下的位姿召回。表 3 是主结果。
| 方法 | 白天 0.25/0.5/1.0m | 夜晚 0.25/0.5/1.0m | 对/秒 |
|---|---|---|---|
| SuperPoint + SuperGlue | 88.2 / 95.5 / 98.7 | 86.7 / 92.9 / 100 | 6.5 |
| SuperPoint + SGMNet | 86.8 / 94.2 / 97.7 | 83.7 / 91.8 / 99.0 | 10.2 |
| SuperPoint + ClusterGNN | 89.4 / 95.5 / 98.5 | 81.6 / 93.9 / 100 | 13† |
| SuperPoint + LightGlue | 89.2 / 95.4 / 98.5 | 87.8 / 93.9 / 100 | 17.2 / 26.1 |
表 3:Aachen Day-Night 视觉定位。指标是满足 (0.25 m,2°)、(0.5 m,5°)、(1.0 m,10°) 的查询比例;吞吐是匹配阶段,LightGlue 的两个数分别是默认版和 FlashAttention 版。ClusterGNN 的 13† 是原作者估计的时间,代码未公开。
LightGlue 的白天精度和 SuperGlue 基本持平(89.2 vs 88.2 在 0.25 m),夜晚 0.25 m 高 1.1 个点(87.8 vs 86.7),0.5 m 高 1.0 个点,1.0 m 都是 100。真正大的差别在吞吐:17.2 对/秒 vs 6.5 对/秒,2.6 倍;用 FlashAttention 优化后到 26.1 对/秒,正好 4 倍。ClusterGNN 的白天 0.25 m 略高(89.4),但夜晚掉到 81.6,而且它的时间只是估计值;在昼夜定位这种场景里,LightGlue 的稳定性更重要。
Aachen v1.1 的补充结果(表 9)是同一趋势:SuperGlue 白天 89.8/96.1/99.4、夜晚 77.0/90.6/100、6.4 对/秒;LightGlue 白天 90.2/96.0/99.4、夜晚 77.0/91.1/100、17.3 对/秒。两个版本的差异在 1% 以内,但吞吐差 2.7 倍。
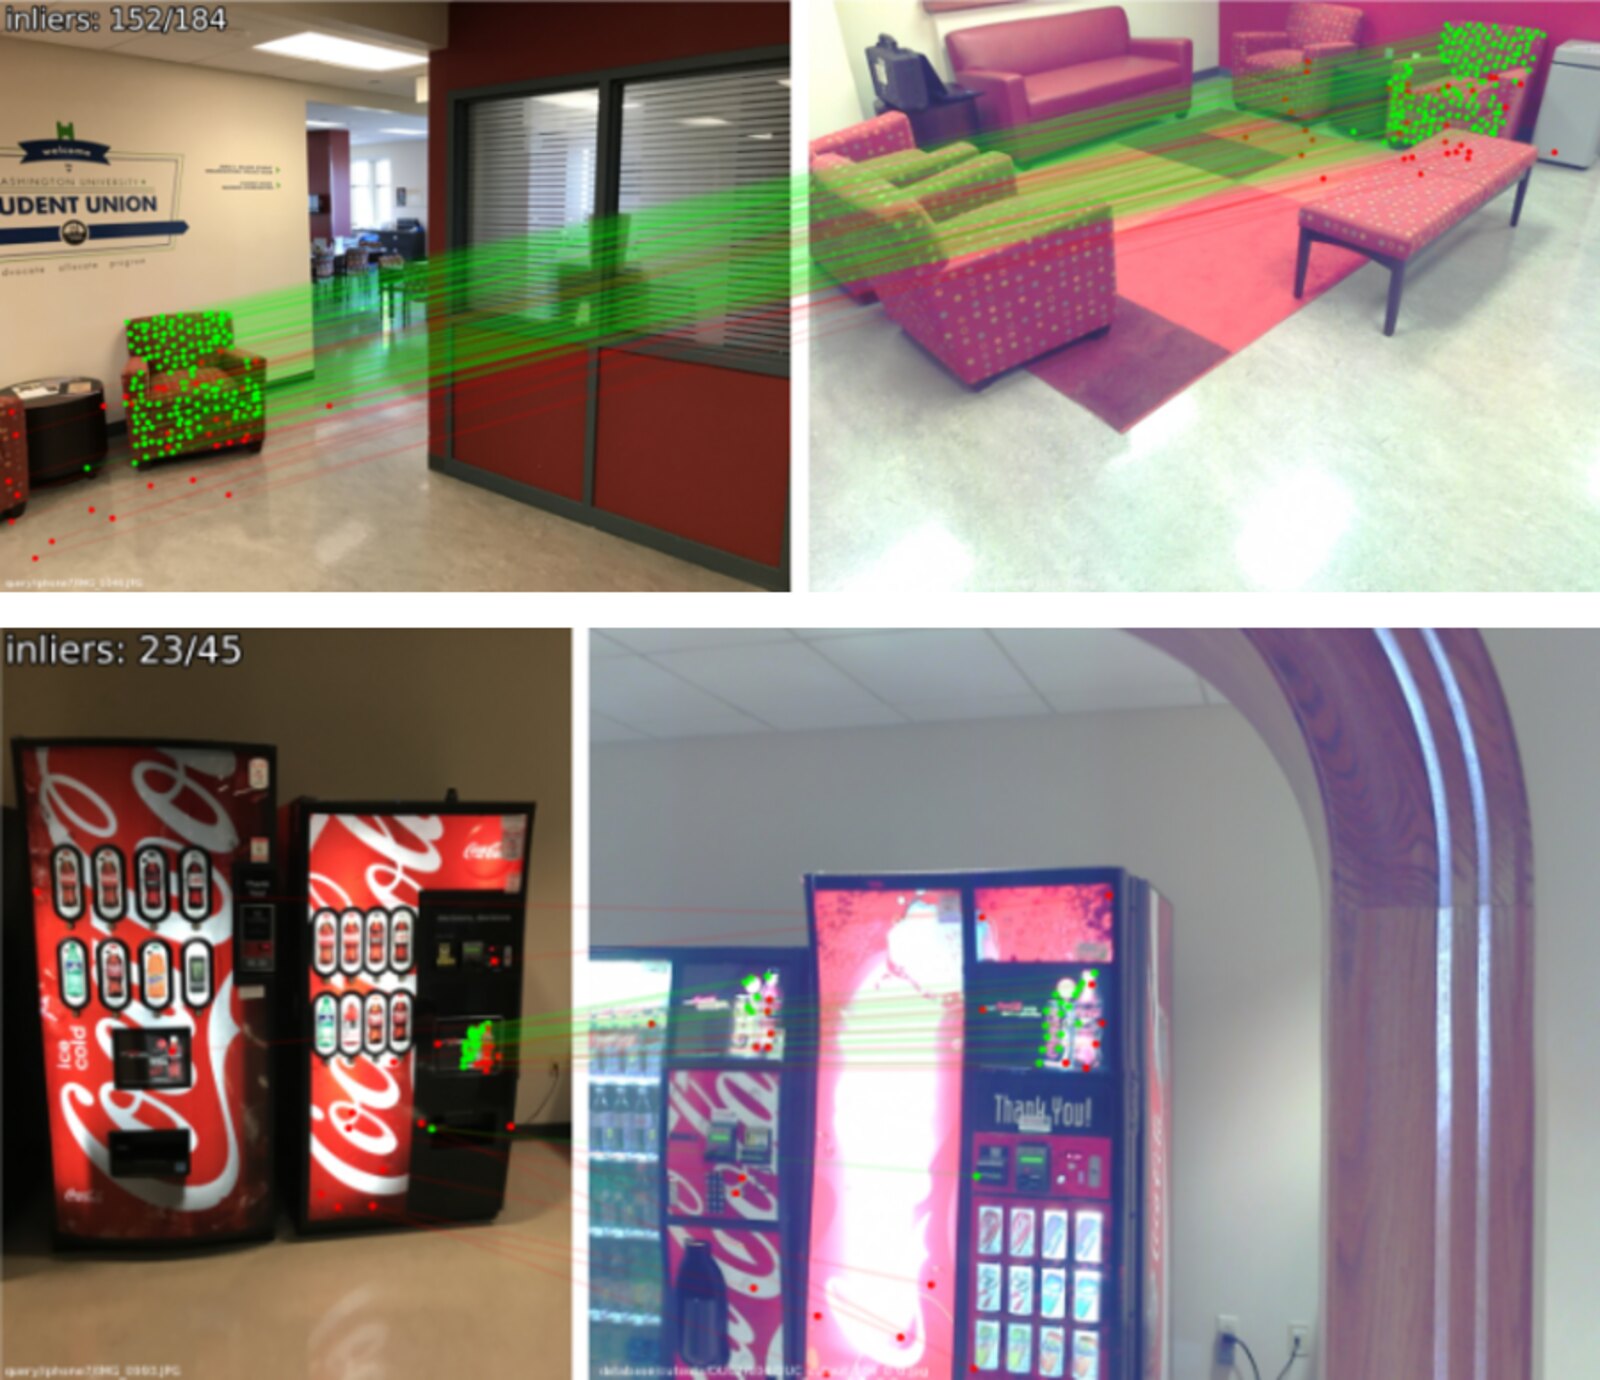
InLoc 是室内定位,用 DUC1/DUC2 两个子集,阈值是 (0.25 m,10°)、(0.5 m,10°)、(1.0 m,10°)。SuperPoint+SuperGlue 在 DUC1 是 47.0/69.2/79.8,DUC2 是 53.4/77.1/80.9;LightGlue 是 49.0/68.2/79.3 和 55.0/74.8/79.4。差异都在 2% 以内,论文说在数据集本身的波动范围内:DUC1/DUC2 分别只有 205/151 个查询,1.5% 的差异约等于 3 个查询。LightGlue 在 0.25 m 的严格阈值上略好,在 0.5 m/1.0 m 上略差;这不是一个能下强结论的基准。
3.5 IMC 2020/2021/2023 与 SfM
IMC(Image Matching Challenge)评的是端到端 SfM,而不只是匹配精度。IMC 2020 的 PhotoTourism 数据分 stereo 和 multiview 两条赛道,表 6 报告 AUC 和匹配吞吐:
| 方法 | Stereo AUC@5/10 | Multiview AUC@5/10/25 | 对/秒 |
|---|---|---|---|
| SuperPoint + SuperGlue | 58.64 / 71.07 | 61.88 / 78.97 / 86.75 | 16.2 |
| SuperPoint + LightGlue | 59.03 / 71.13 | 62.87 / 79.36 / 86.98 | 43.4 |
| DISK + NN + ratio | 57.76 / 68.73 | 59.91 / 78.95 / 87.54 | 196.7 |
| DISK + LightGlue | 67.02 / 77.82 | 67.91 / 80.58 / 88.35 | 44.5 |
表 6:IMC 2020 的 SfM 结果。Stereo 赛道用 AUC@5°/10°,Multiview 用 AUC@5°/10°/25°;吞吐是匹配阶段。
SuperPoint+LightGlue 相对 SuperGlue 的提升不大(stereo +0.4,multiview +1.0 左右),但速度快 2.7 倍。真正的跃迁来自 DISK+LightGlue:stereo AUC@5° 67.02,比 DISK+NN+ratio 高 9.3 个点,比 SuperPoint+LightGlue 高 8.0 个点;multiview AUC@5° 67.91,也全面领先。论文的解释是 DISK 的检测更可重复、描述子更强,LightGlue 把这个优势兑现成了匹配质量。这个结果也说明「匹配器 + 局部特征」是一个整体,不能只看匹配器本身。
IMC 2021 的 PhotoTourism 子集更强调跨场景泛化。表 7 的关键数字:SuperPoint+LightGlue stereo 36.7/50.7、multiview 63.6/74.4、平均 50.2/62.6;SuperPoint+SuperGlue 是 36.5/50.5、63.3/73.8、49.9/62.2;DISK+LightGlue 是 43.1/56.6、66.2/76.2、54.7/66.4;DISK(8K)+LightGlue 是 48.7/61.8、68.9/78.2、58.8/70.0。最后一行的 8K 关键点版本甚至超过了带 test-time augmentation 的 DISK(8K)+NN+ratio(44.6/56.2、65.0/74.4、54.8/65.3)和 SP+SuperGlue*(44.6/58.6、66.8/77.1、55.7/67.9)。论文强调 LightGlue 没有用 TTA,只是把关键点加多;这说明在 SfM 场景里,「更多关键点 + 更好的匹配器」仍然是最直接的 scaling 轴。
IMC 2023 是端到端 SfM 排行榜:SuperPoint+SuperGlue 在 public/private 上是 36.1/43.8,SuperPoint+LightGlue 是 38.4/46.1,提升 2.3 个点。这个提升幅度没有 MegaDepth 上那么夸张,因为 IMC 2023 的场景更多样、检索和重建流程的方差更大;论文取 3 次运行的平均来降低随机性。
3.6 运行时间、消融与「为什么快」
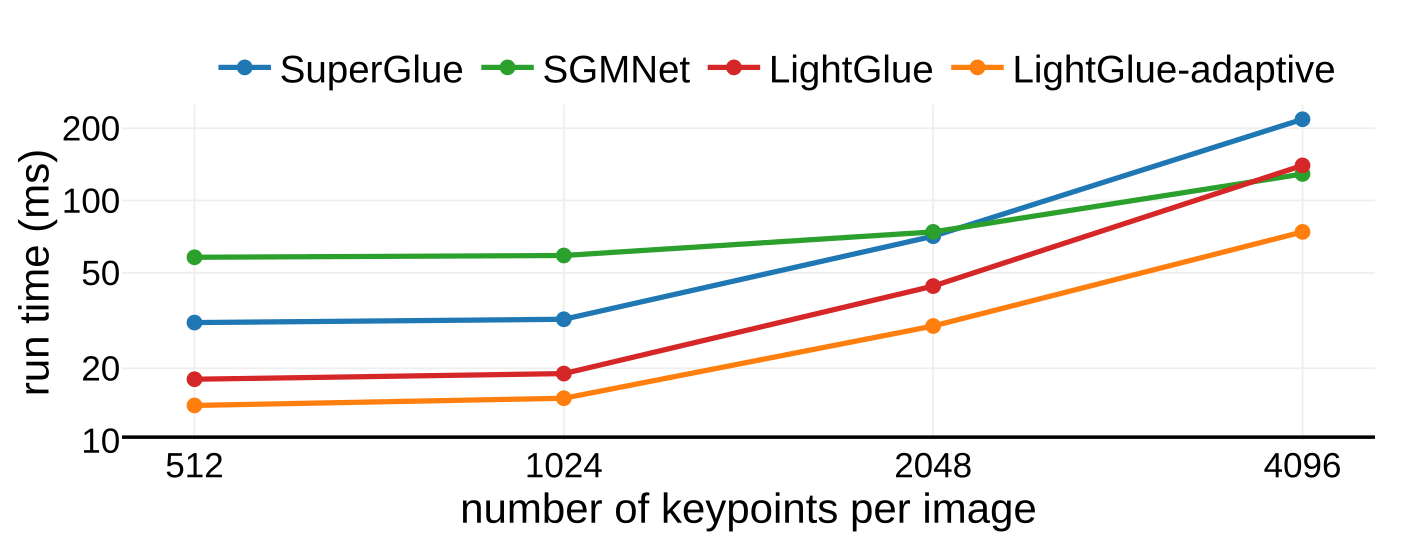
Figure 7 给出运行时间随关键点数的变化:在 1024 个点时,LightGlue 约 18 ms、SuperGlue 约 30 ms;2048 个点时 44 ms 对 70 ms;4096 个点时自适应版约 80 ms,SuperGlue 超过 200 ms。SGMNet 在 512/1024 时反而比 LightGlue 慢,因为它需要先构造种子图;到 4k 才与 LightGlue 接近,但仍远慢于自适应版。
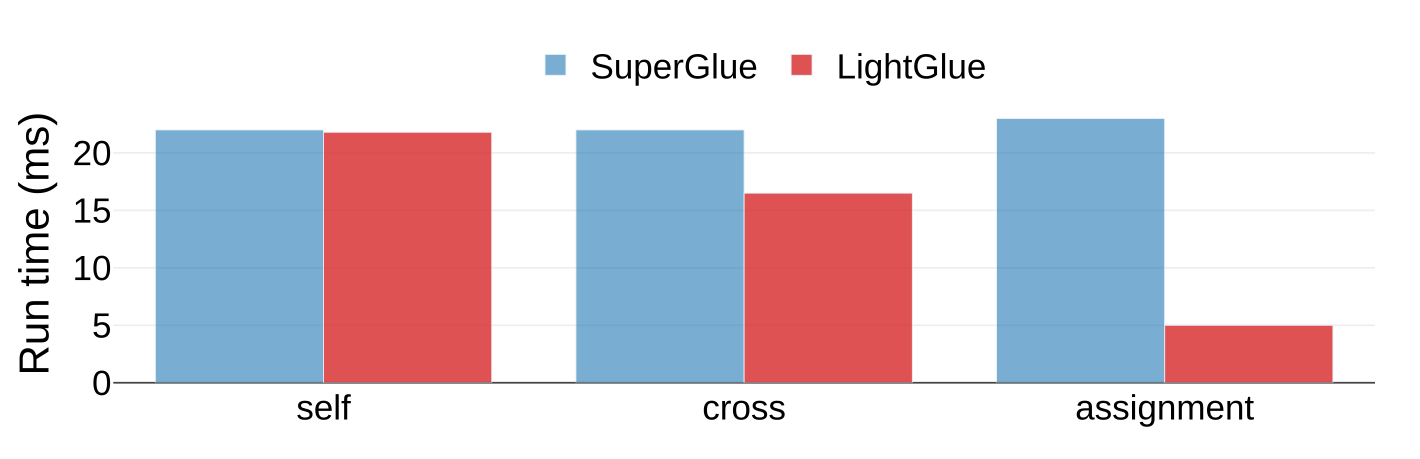
表 4 的消融把每个设计的贡献拆开(合成单应测试集,SuperPoint,512 个关键点,5M 训练样本):
| 变体 | precision | recall | 时间 (ms) |
|---|---|---|---|
| SuperGlue | 74.6 | 90.5 | 29.1 |
| LightGlue 完整 | 86.8 | 96.3 | 19.4 |
| 去掉 matchability | 67.4 | 97.0 | 18.9 |
| 换成绝对位置编码 | 84.2 | 94.7 | 18.7 |
| 完整交叉注意力 | 86.6 | 96.1 | 22.8 |
| 只用第 5/9 层 | 78.1 | 92.7 | 11.9 |
表 4:合成单应消融。matchability 是精度贡献最大的单项;相对位置编码几乎不花时间;双向交叉注意力省时间不降精度;浅层预测已经有用,但不如完整模型。
从这张表能读出三件事。第一,matchability 是精度的主要来源:去掉它 precision 掉 19.4 个点,recall 反而升 0.7,典型的「匹配变多但变脏」。第二,相对位置编码的收益/成本比极高:+2.6 precision、+1.6 recall,只多 0.7 ms。第三,双向交叉注意力是纯赚:-3.4 ms,精度在噪声范围内。浅层预测的 78.1/92.7 则说明深监督确实让第 5 层「可用」,但完整模型仍然明显更好;自适应机制的价值在于按需使用,而不是永远停在浅层。
Figure 11 补充了剪枝的动态:前几层不可匹配点的比例上升最快,到第 8 层累计约 47%。表 5 则按难度拆分:简单对平均剪掉 19.8%,困难对 27.9%,难对的剪枝率更高、但加速更小;难对的深度收益被更难收敛抵消了。
3.7 定性结果与跨特征通用性
Figure 9 是同一套 LightGlue 结构接三种局部特征的匹配结果,从上到下依次是 SIFT+LightGlue、SuperPoint+LightGlue、DISK+LightGlue。三组都能给出密集且几何一致的匹配,但细节不同:SIFT 的匹配更集中在角点和斑点,SuperPoint 更均匀,DISK 在弱纹理和大视角下更稳。论文用这张图想说明的是:LightGlue 不是绑死在 SuperPoint 上的后处理,它是一个可以接不同局部特征的匹配器。
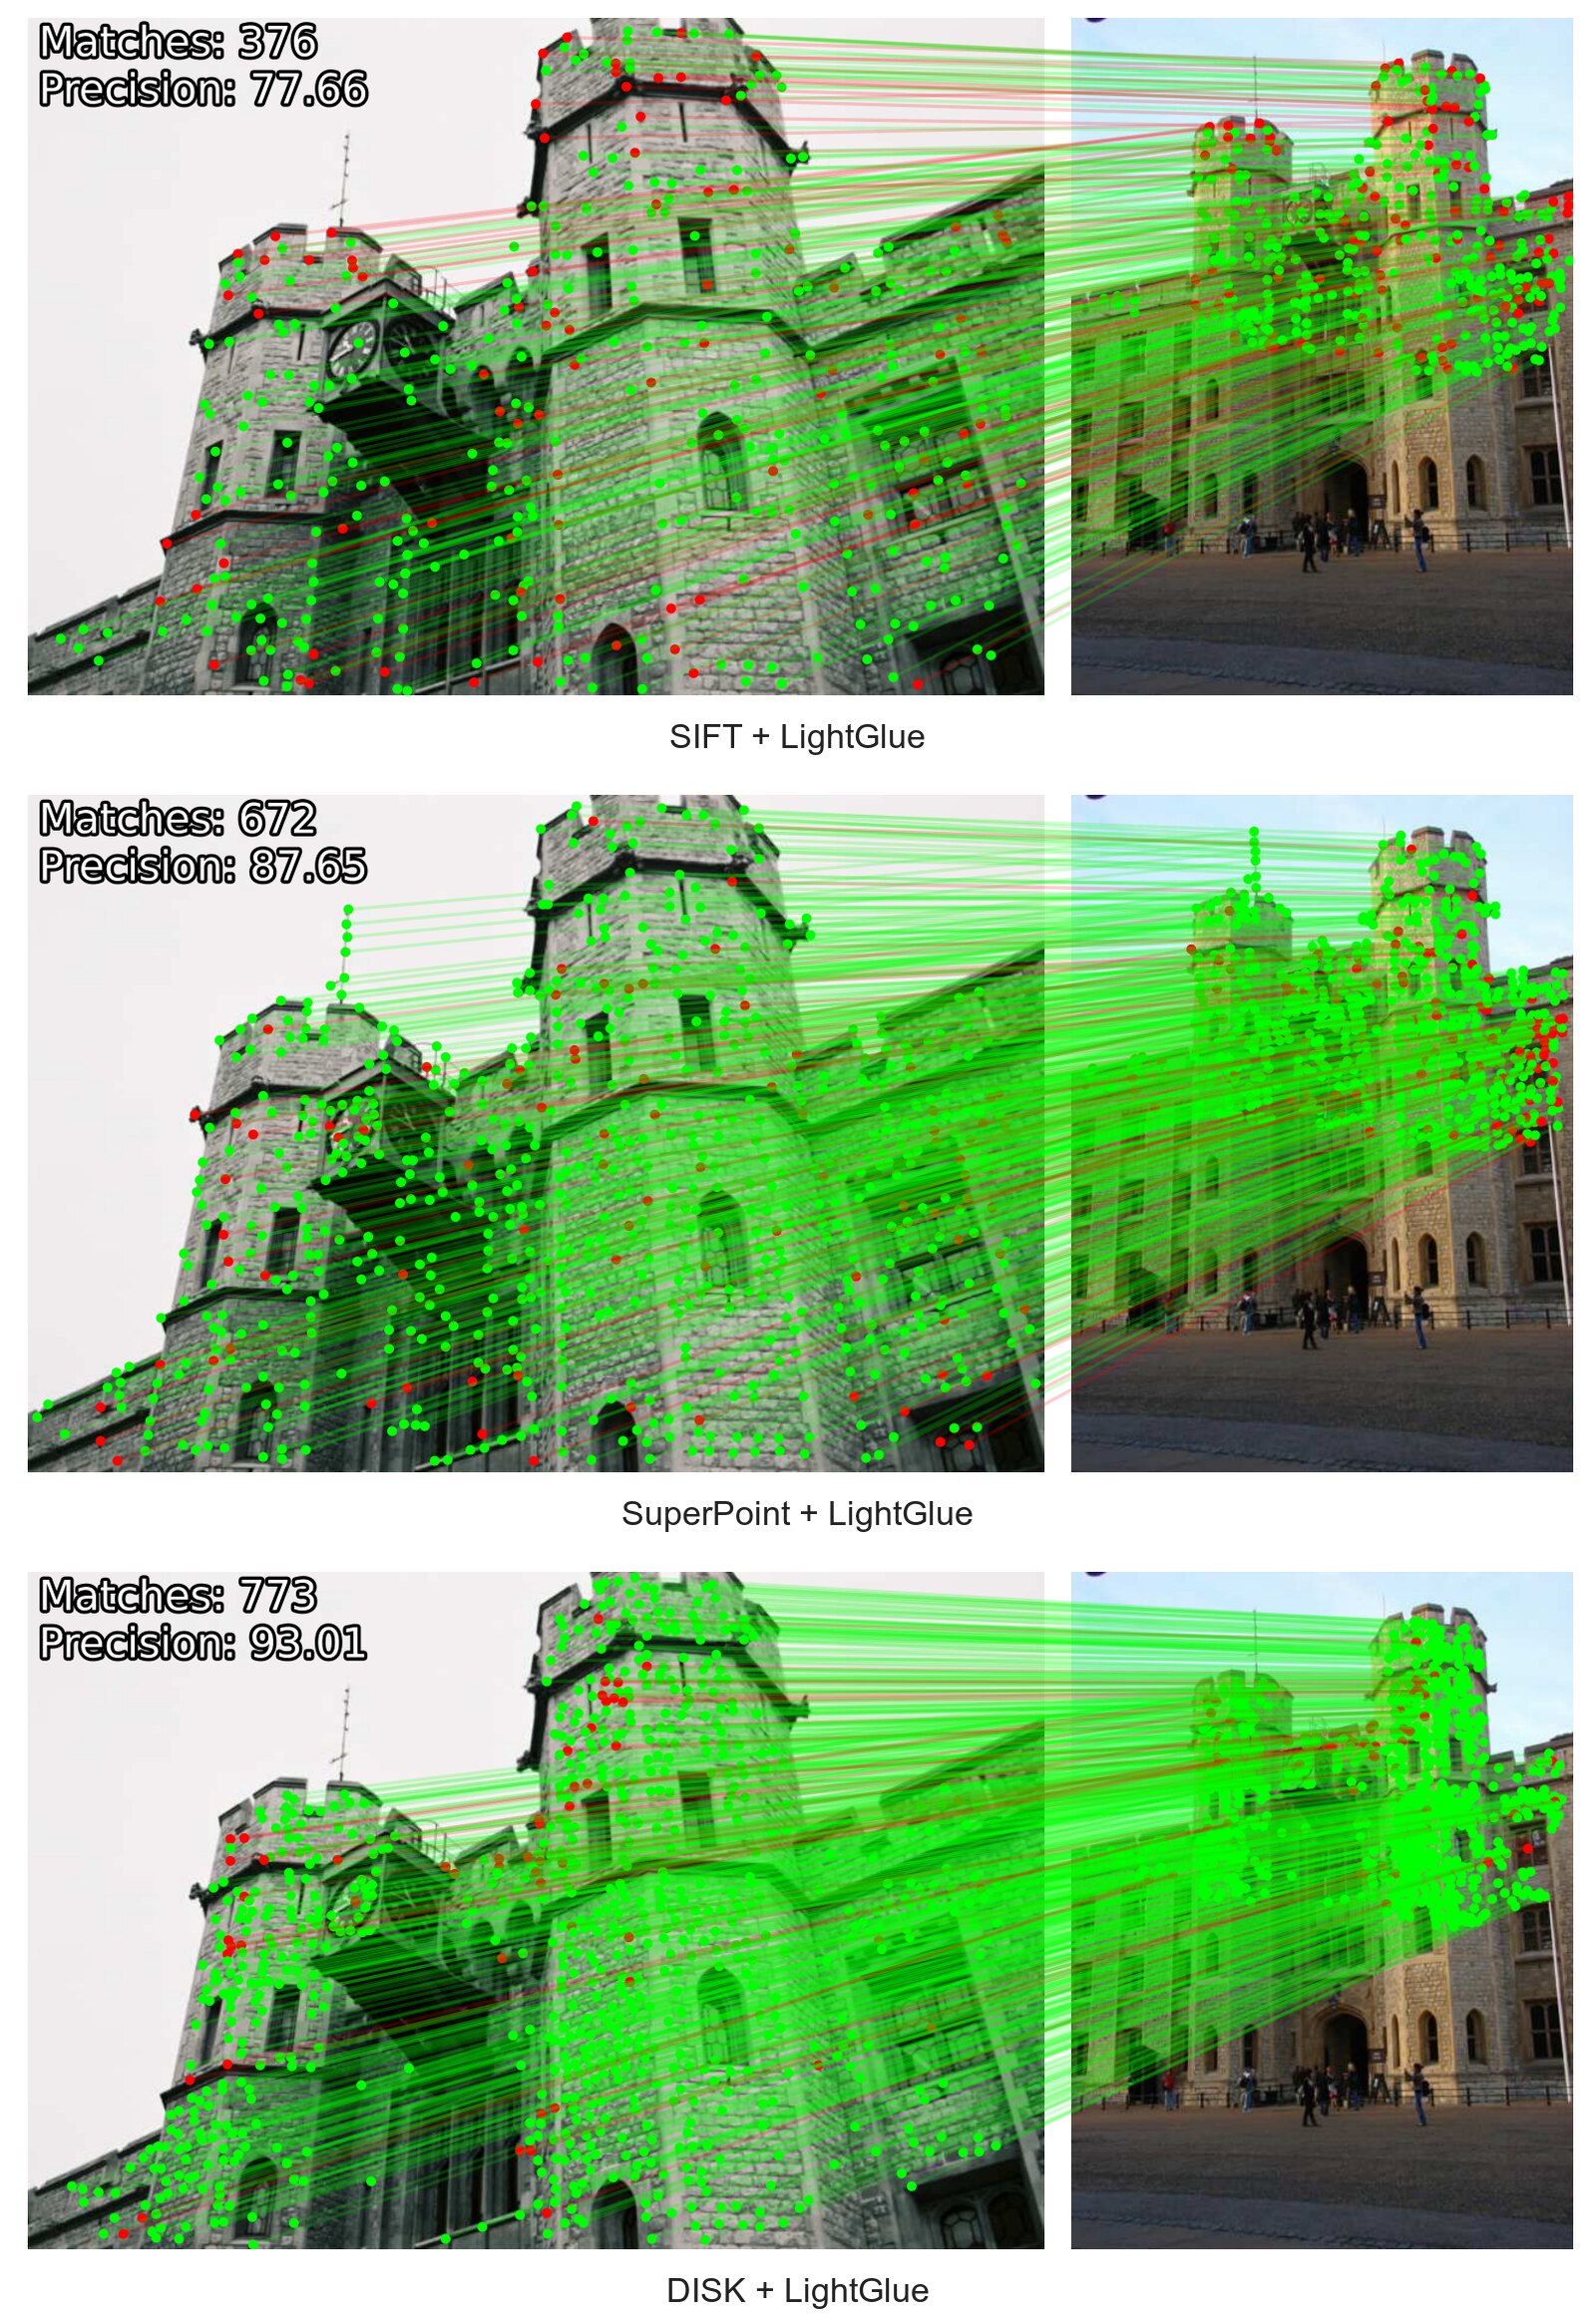
论文正式训练和评测了 SuperPoint、SIFT、DISK 三种特征[20, 21]。表 8 的 MegaDepth-1800 结果里,SIFT+LightGlue 有 383 个匹配、precision 84.1、AUC@5/10/20 为 57.0/71.3/81.8、44.3 ms;SIFT+NN+ratio 是 160 个匹配、82.3、48.3/62.2/73.2、5.7 ms;SIFT+SGMNet 是 405 个匹配、82.5、50.7/66.6/76.5、71.7 ms。LightGlue 让 SIFT 的 AUC@5° 提高 8.7 个点,代价是匹配时间从 5.7 ms 涨到 44.3 ms。这说明「更好的匹配器」对传统特征同样有效,不只是对学习到的描述子。
ALIKED 的情况要单独说明。论文正文和表格只覆盖 SuperPoint/SIFT/DISK,没有报告 ALIKED 的 LightGlue 数字;但官方仓库在论文之后加入了 aliked 权重和 ALIKED 提取器,输入维度是 128,通过 input_proj 对齐到 256[22]。所以「LightGlue 能接 ALIKED」有官方代码支持,但「ALIKED+LightGlue 在某个基准上是多少」不能从这篇论文里找。XFeat 也是同一类可替换的局部特征[23],但更轻量,适合和 LightGlue 组合做端侧实验;这属于后续工程选择,不是论文的实验结论。
四、局限性
论文没有单独的 Limitations 一节,结论甚至用了「drop-in replacement with only benefits」这样的说法。这句话是作者对自家方法的总结,不是严格的实验结论;把正文和附录里散落的证据拼起来,能看到几条明确的边界。
论文承认或数据直接显示的:
- 稠密匹配器在最高精度上仍略胜一筹。MegaDepth-1800 上,ASpanFormer 68.0、LoFTR 66.4,LightGlue 65.5(LO-RANSAC AUC@5°);论文原话说 detector-free 方法领先 “by a mere 2% AUC@5°“。LightGlue 的优势是速度,不是绝对精度上限。
- 早停牺牲 precision。表 11 里,置信度从 98% 降到 80%,precision 从 96.2 掉到 92.6,AUC@5° 从 66.6 掉到 65.2,时间从 80.5% 降到 48.4%。这是一条明确的权衡曲线,不是一个「无损加速」。
- 难对的加速有限。表 5 里困难对只有 1.16×,因为需要更多层;自适应机制对简单对最有效,对低重叠、大视角变化的图像对收益小。
- 重复纹理会导致定位失败。InLoc 上 LightGlue 有时匹配垃圾桶等重复物体,而不是几何结构;在检索较弱时,更多匹配反而可能把位姿带偏。论文报告 6/356 张图在 1 m 阈值上比 SuperGlue 差,差异约 1.5%(3 个查询)。
- 置信度分类器有固定开销。最坏情况下增加约 2% 的推理时间;它靠省下的层数回本,如果输入总是很难、几乎不早停,这 2% 就是净成本。
- 阈值是全局超参数。、宽度 0.99、 都是在验证集上选的,不是按图像对或特征类型自适应;换数据集、换特征、换分辨率时可能需要重调。
我补充的、论文没有展开的:
- 它仍然依赖稀疏检测器。LightGlue 只匹配给定的关键点,不解决「关键点本身不可重复」的问题;在弱纹理、极端视角、严重遮挡下,检测器没检测到的点,匹配器再强也变不出来。这也是 LoFTR/ASpanFormer 这类 detector-free 方法仍然有市场的原因。
- 训练域偏户外。预训练是 Oxford-Paris 的合成单应,微调是 MegaDepth 的户外地标;Aachen 和 InLoc 也是户外/室内定位基准,但 InLoc 的提升并不稳定。论文没有给出室内 SfM 或跨域的大规模验证,不能把 MegaDepth 的结论直接外推到室内。
- 剪枝是贪心的。当前层「自信地不可匹配」不等于后面一定不可匹配;置信度条件降低了误剪概率,但没有理论保证。被剪掉的点不会复活,错误剪枝会直接变成 recall 损失。
- 宽度自适应在 CPU/MPS 上默认关闭。代码的
pruning_keypoint_thresholds对 CPU/MPS 设成 -1,原因是 gather/scatter 开销划不来;所以在这些设备上只有深度自适应,没有宽度自适应。这是一个工程限制,不是模型限制。 - 端到端收益会被其他环节稀释。论文的时间只算匹配网络,不含特征提取、检索、RANSAC/PnP。在完整 SLAM/SfM 系统里,LightGlue 省下的几十毫秒可能只是总时间的一部分;它的价值在匹配成为瓶颈时最大。
- 没有 ScanNet-1500 / IMC 2022 的验证。如 3.1 节所说,这两个基准不在论文里;如果关心室内 SfM,应该看 LoFTR/DKM 等论文的原始数字,或自己在新数据上重跑,而不是引用这篇论文。
这些局限不影响 LightGlue 的核心命题——「计算量应该随难度变化」——但决定了它适合放在什么位置:延迟敏感的稀疏匹配、SLAM/定位的 front-end、以及需要和不同局部特征组合的系统;不适合期待它单独解决所有室内弱纹理匹配的场景。
五、结论与展望
LightGlue 的核心贡献不是某个单点技巧,而是把匹配器从「固定深度的回归器」变成了「可以中途交卷的迭代推理器」。三个架构改动——旋转相对位置、双向交叉注意力、双 softmax + matchability——共同把「每层预测」的成本降到可接受;深监督让每层预测变得可信;置信度早停和点剪枝则把这种可信度变成实际的算力节省。四件事缺一不可:没有轻量头,逐层预测太贵;没有深监督,浅层预测不可信;没有置信度,网络不知道何时停;没有 matchability,剪枝会误删。
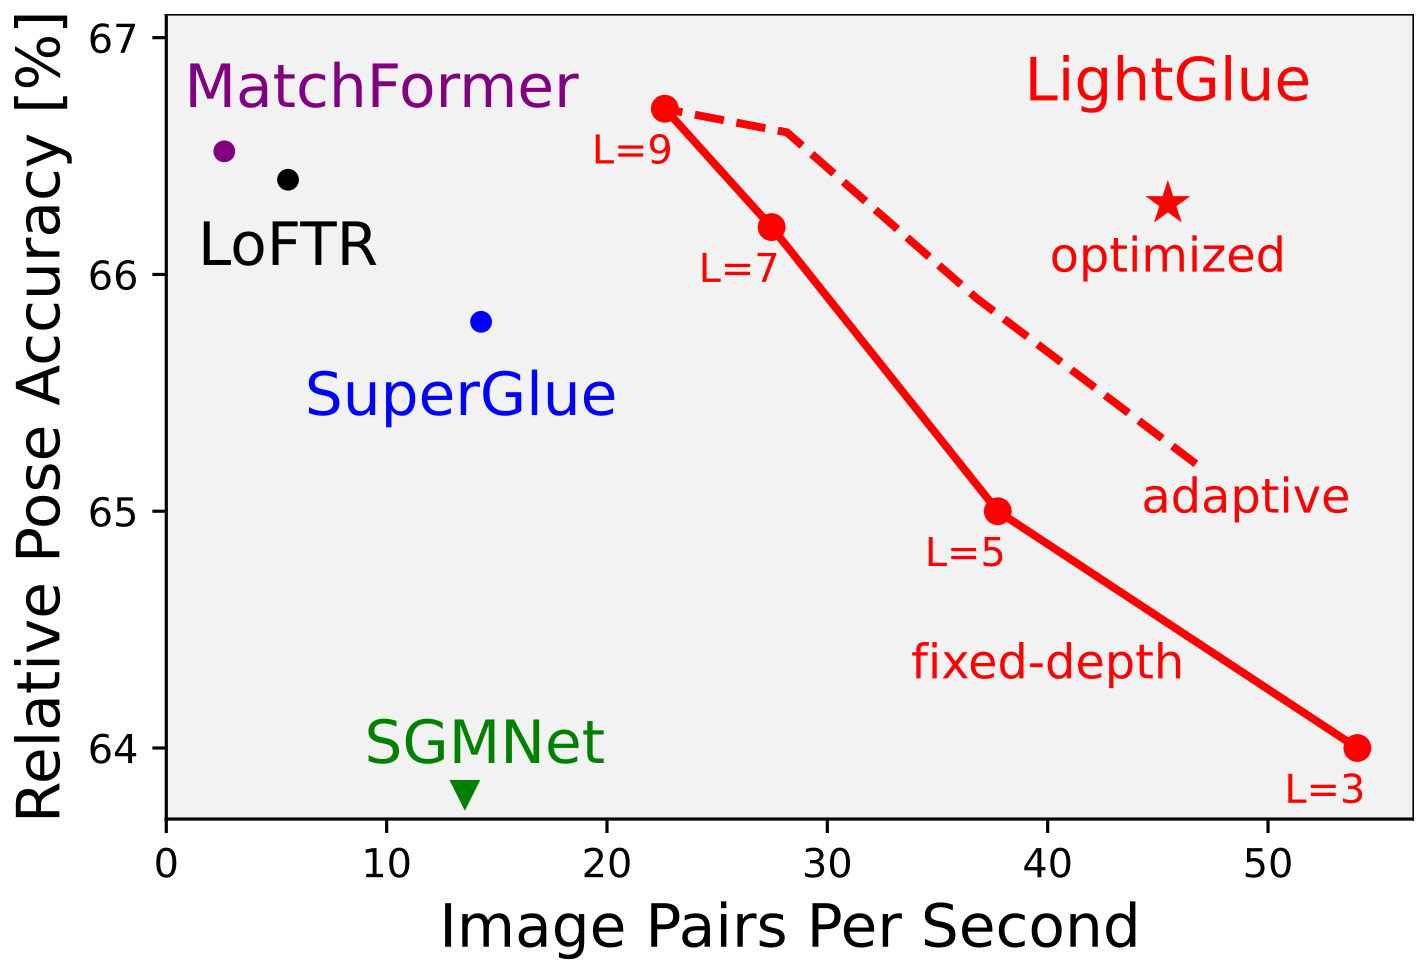
从工程角度看,LightGlue 的默认配置已经很稳:SuperPoint + LightGlue、2048 个关键点、depth_confidence=0.95、width_confidence=0.99、filter_threshold=0.1。如果延迟是关键,可以把 depth_confidence 降到 0.90 左右,或减少关键点;如果精度是关键,把两个 confidence 设成 -1、关闭自适应,并把关键点加到 4096。论文的 Figure 1 已经给出了这条曲线:固定层数的 L=3/5/7/9 是一条条离散的点,自适应版则把这条曲线连了起来。
往后看,至少有三条自然的方向。第一,更细粒度的自适应:现在早停是整对图像共用一个退出决策,剪枝是逐点但只基于当前层的 matchability;如果能让每个点自己决定「我还要不要继续被算」,或者让网络预测「再算一层能带来多少收益」,预算分配会更精确。第二,和稀疏图方法结合:LightGlue 的注意力仍是 ,在 8K/16K 关键点下,SGMNet/ClusterGNN 式的图稀疏化仍然有价值;把「按难度自适应」和「按图结构稀疏化」结合,可能比单独任何一条路线都好。第三,和稠密/混合匹配器融合:FlexGlue 已经把稀疏查询送到稠密网格里,LoMa、DKM 走的是稠密 warp 路线[18];LightGlue 的逐层置信度和 matchability 可以作为这些方法的「何时停、哪里停」的控制器,而不是只能用于稀疏匹配。
对读者来说,最实用的结论可能很简单:如果你已经在用 SuperGlue,LightGlue 是一个可以直接替换的升级——同样的输入输出、同样的特征,精度略好、速度快 1.6–2.5 倍,而且代码和权重都开源;如果你在做延迟敏感的 SLAM 或大规模 SfM,自适应版值得作为默认起点。但如果你追求的是稠密、弱纹理、室内场景的极限精度,LoFTR/ASpanFormer/DKM 仍然是更合适的路线,LightGlue 的贡献是让稀疏匹配在「够用」的场景里不再成为瓶颈。
六、上手
官方仓库提供推理、预训练权重和 Colab demo;训练与评测在 glue-factory。下面的安装和推理命令取自 LightGlue README,训练与评测命令取自 glue-factory README,都折叠起来,避免长代码淹没正文。
安装 LightGlue(可编辑安装)
git clone https://github.com/cvg/LightGlue.git && cd LightGlue
python -m pip install -e .
最小匹配示例(SuperPoint + LightGlue)
from lightglue import LightGlue, SuperPoint, DISK, SIFT, ALIKED, DoGHardNet
from lightglue.utils import load_image, rbd

# SuperPoint+LightGlue
extractor = SuperPoint(max_num_keypoints=2048).eval().cuda()  # load the extractor
matcher = LightGlue(features='superpoint').eval().cuda()  # load the matcher

# or DISK+LightGlue, ALIKED+LightGlue or SIFT+LightGlue
extractor = DISK(max_num_keypoints=2048).eval().cuda()  # load the extractor
matcher = LightGlue(features='disk').eval().cuda()  # load the matcher

# load each image as a torch.Tensor on GPU with shape (3,H,W), normalized in [0,1]
image0 = load_image('path/to/image_0.jpg').cuda()
image1 = load_image('path/to/image_1.jpg').cuda()

# extract local features
feats0 = extractor.extract(image0)  # auto-resize the image, disable with resize=None
feats1 = extractor.extract(image1)

# match the features
matches01 = matcher({'image0': feats0, 'image1': feats1})
feats0, feats1, matches01 = [rbd(x) for x in [feats0, feats1, matches01]]  # remove batch dimension
matches = matches01['matches']  # indices with shape (K,2)
points0 = feats0['keypoints'][matches[..., 0]]  # coordinates in image #0, shape (K,2)
points1 = feats1['keypoints'][matches[..., 1]]  # coordinates in image #1, shape (K,2)
LightGlue(features=...) 会自动加载对应权重,可选的 features 包括 superpoint、disk、aliked、sift、doghardnet 和 raco-aliked。输入描述子的维度不是 256 时(例如 DISK/ALIKED 的 128 维),网络会自动加一个 input_proj;SIFT 需要额外的尺度和方向,仓库会自动处理。默认参数是 n_layers=9、flash=True、mp=False、depth_confidence=0.95、width_confidence=0.99、filter_threshold=0.1。
常用参数与关闭自适应的写法(官方 README 示例)
# 最大化精度:保留全部关键点,关闭早停和剪枝
extractor = SuperPoint(max_num_keypoints=None)
matcher = LightGlue(features='superpoint', depth_confidence=-1, width_confidence=-1)
训练和评测在 glue-factory。训练会下载 Oxford-Paris 和 MegaDepth,磁盘需求约 450 GB + 420 GB,默认 batch size 128 面向 2 张 24 GB 的 RTX 3090。
训练 LightGlue(合成单应预训练 + MegaDepth 微调)
git clone https://github.com/cvg/glue-factory
cd glue-factory
python3 -m pip install -e .

# 1) 合成单应预训练
python -m gluefactory.train sp+lg_homography \
    --conf gluefactory/configs/superpoint+lightglue_homography.yaml

# 2) MegaDepth 微调
python -m gluefactory.train sp+lg_megadepth \
    --conf gluefactory/configs/superpoint+lightglue_megadepth.yaml \
    train.load_experiment=sp+lg_homography

# 可选:先缓存 MegaDepth 的局部特征,加速训练(约 150 GB)
python -m gluefactory.scripts.export_megadepth --method sp --num_workers 8
python -m gluefactory.train sp+lg_megadepth \
    --conf gluefactory/configs/superpoint+lightglue_megadepth.yaml \
    train.load_experiment=sp+lg_homography \
    data.load_features.do=True
在 MegaDepth-1500 上评测(含自适应版)
python -m gluefactory.eval.megadepth1500 --conf superpoint+lightglue-official

# 自适应版:depth/width confidence 都设成 0.95
python -m gluefactory.eval.megadepth1500 --conf superpoint+lightglue-official \
    model.matcher.{depth_confidence=0.95,width_confidence=0.95}
两个实操提醒。第一,论文的数字使用 1600 px、2048 个特征、逐方法调过的 RANSAC 阈值;直接跑官方 eval 可能因版本、阈值和硬件不同而略有差异,比较时先对齐口径。第二,许可证不是一刀切:LightGlue 的代码和权重是 Apache-2.0,ALIKED 是 BSD-3-Clause,DISK 随仓库使用 Apache-2.0,但 SuperPoint 的原版权重和推理文件是另一套限制性许可证(lightglue/superpoint.py 也受其约束)。商用前要分别确认。
参考
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Chen, Luo, Zhang, Zhou, Bai, Hu, Tai, Quan. Learning to Match Features with Seeded Graph Matching Network. ICCV 2021. arXiv
- Shi, Cai, Shavit, Mu, Feng, Zhang. ClusterGNN: Cluster-based Coarse-to-fine Graph Neural Network for Efficient Feature Matching. CVPR 2022. arXiv
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Wang, Zhang, Yang, Peng, Stiefelhagen. MatchFormer: Interleaving Attention in Transformers for Feature Matching. ACCV 2022. arXiv
- Chen, Luo, Zhou, Tian, Zhen, Fang, McKinnon, Tsin, Quan. ASpanFormer: Detector-Free Image Matching with Adaptive Span Transformer. ECCV 2022. arXiv
- Su, Lu, Pan, Wen, Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. arXiv 2021. arXiv
- Teerapittayanon, McDanel, Kung. BranchyNet: Fast Inference via Early Exiting from Deep Neural Networks. ICPR 2016. arXiv
- Liu, Xu, Wang, Darrell, Shelhamer. Anytime Dense Prediction with Confidence Adaptivity. ICLR 2022. arXiv · 代码
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv · 基准
- Taira, Okutomi, Sattler, Cimpoi, Pollefeys, Sivic, Pajdla, Torii. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. CVPR 2018. arXiv
- Jin, Mishkin, Mishchuk, Matas, Fua, Yi, Trulls. Image Matching across Wide Baselines: From Paper to Practice. IJCV 2021. arXiv · 代码
- CVPR 2023 Image Matching Challenge. Image Matching Challenge 2023. Kaggle competition, 2023. 比赛页面
- Barath, Matas, Noskova. MAGSAC: Marginalizing Sample Consensus. CVPR 2019. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Dao, Fu, Ermon, Rudra, Ré. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Transactions on Instrumentation and Measurement, 2023. arXiv · 代码
- Potje, Cadar, Araujo, Martins, Nascimento. XFeat: Accelerated Features for Lightweight Image Matching. CVPR 2024. arXiv · 代码