· 78 min read
论文解读:LoMa,局部特征匹配的「数据与容量」回归
TL;DR LoMa 是 Chalmers、Linköping、阿姆斯特丹和隆德几所大学对稀疏局部特征匹配的一次「回到数据」的重做[1]。它没有发明新网络:检测器用 DaD,描述子用 DeDoDe,匹配器沿用 LightGlue 的 9 层 self/cross attention;真正的改动是把训练数据扩到 17 个 3D 数据集、把匹配器嵌入维度从 256 扩到 1024、把训练从 50K 步拉到 250K 步。作者同时发布 HardMatch:1000 对人工标注对应点的极难图像对,覆盖 9 个挑战分组,人类基线约 88% PCK@10px。结果是 LoMa-G 在 HardMatch 上达到 54.3 mAA@10px,比 ALIKED+LightGlue 高 18.6;WxBS 73.4,以 0.8 分超过 RoMa 的 72.6;RUBIK 比 ALIKED+LightGlue 高 24.2 AUC@10°、IMC 2022 高 12.4 mAA。但要诚实:MegaDepth / ScanNet 的相对位姿上 RoMa v2 仍然领先(AUC@5° 62.8 对 56.5),「回归」主要发生在难基准和视觉定位上。推理代码与权重已开源(整体 MIT,匹配器继承 LightGlue 的 Apache-2.0);训练代码在官方
train-dev分支,尚未并入 main,作者也注明训练复现尚未验证。
- 论文:LoMa: Local Feature Matching Revisited,David Nordström*、Johan Edstedt* 等,Chalmers / Linköping / University of Amsterdam / Lund,ECCV 2026 Oral,arXiv 2026 年 4 月(v2 2026 年 7 月 6 日)。
- 代码:github.com/davnords/loma(推理);训练代码:
train-dev分支。权重在初始化时自动下载。HardMatch 数据:github.com/davnords/HardMatch。 - 前作/预备知识:站内的 FlexGlue 解读 讲了稀疏到稠密匹配的另一条路线;DaD 是本文使用的检测器;LightGlue 是匹配器的骨架。
一、动机:被判死刑的稀疏匹配器
过去五年,图像匹配的叙事基本是这样的:稀疏匹配(SuperGlue、LightGlue[2, 3])先检测关键点、再在两组关键点之间学一个分配,快、可解释、天然给出多视图轨迹,但「检测器决定了上限」;无检测器的稠密匹配(LoFTR、RoMa、RoMa v2、UFM[4, 5, 6, 7])直接为像素或网格单元估计对应,鲁棒、亚像素,代价是慢;前馈重建模型(MASt3R、VGGT[8, 9])用海量数据直接回归点图(point map)和相机,把「匹配」当成 3D 理解的副产品。后两条路线都建立在同一个判断上:稀疏匹配器训练数据少、容量小、上限低,已经不值得再投入。
LoMa 的作者偏要反问一句:关于局部特征匹配器之死的报道,是不是大大言过其实了? 他们的观察很朴素:过去几年稀疏匹配器的训练几乎都停留在 MegaDepth[10] 上,模型容量停在 LightGlue 时代,训练步数只有几万;而稠密匹配和前馈重建的进步,很大一部分来自数据规模、模型容量和算力的同步放大。如果把这些轴给稀疏匹配器也加上,它会不会重新有竞争力?
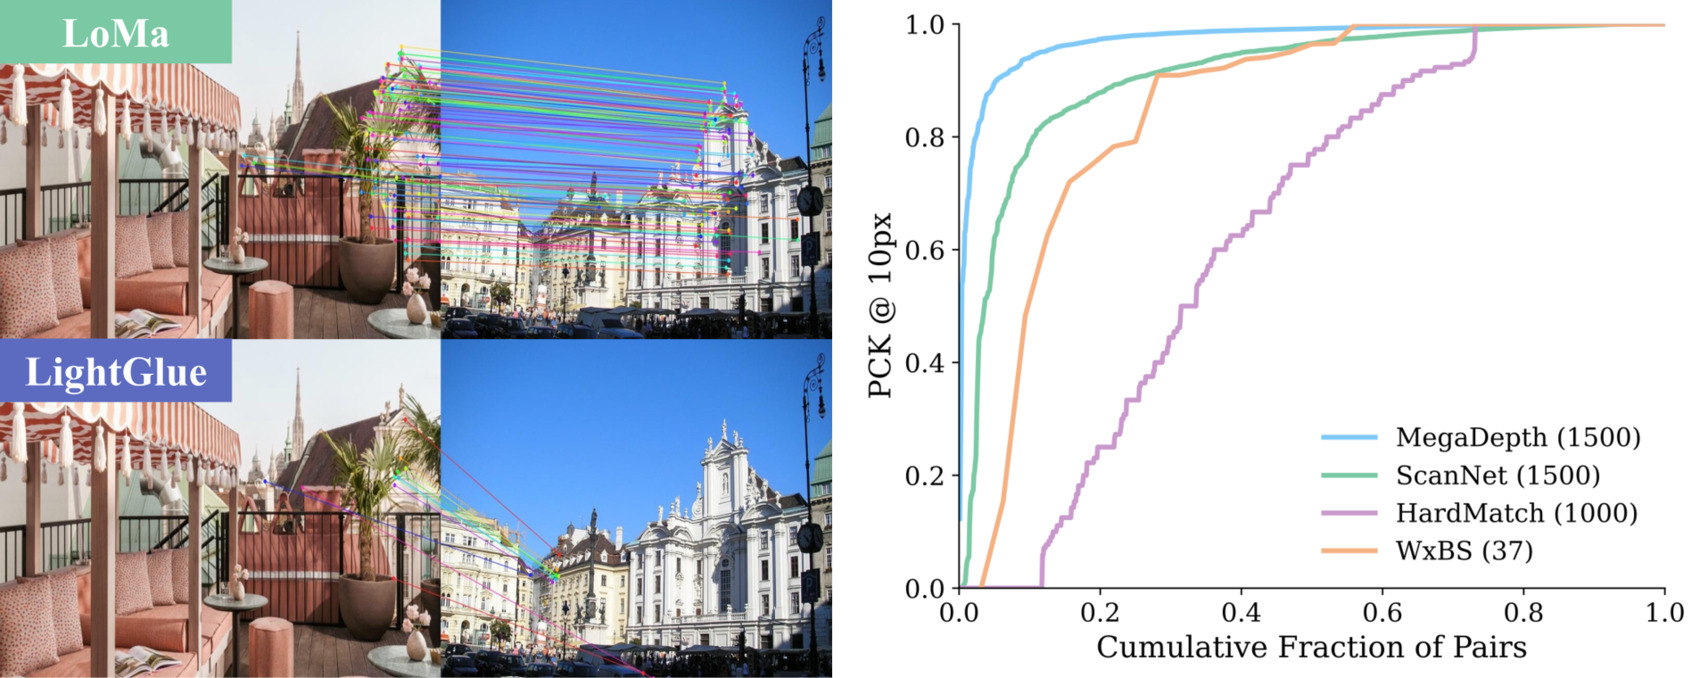
这个判断也得到了基准现状的支持。MegaDepth-1500 和 ScanNet-1500[11] 来自成功的三维重建,图像对本身是「可解的」,SOTA 匹配器在很大一部分对上已经接近满分;WxBS[12] 只有 37 对,统计噪声大,而且论文发现它也开始饱和。于是作者做了两件事:造一个更难的基准(HardMatch),以及用数据、容量和算力把稀疏匹配器重新训练一遍(LoMa)。
论文把贡献列为三条:
- 从数据驱动的角度重做稀疏局部特征匹配,引入用 MVS 重新生成真值的大规模训练数据与训练配方;
- 发布 HardMatch:1000 对人工标注对应点的图像对,9 个挑战分组,并提供独立标注者估计的人类基线;
- 发布 LoMa 家族模型,在 HardMatch 上比 LightGlue 高 18.6 mAA,并在十余个既有基准上取得强结果;后续工作还把 LoMa 扩展到旋转不变(LoMa-R)。
二、核心方法
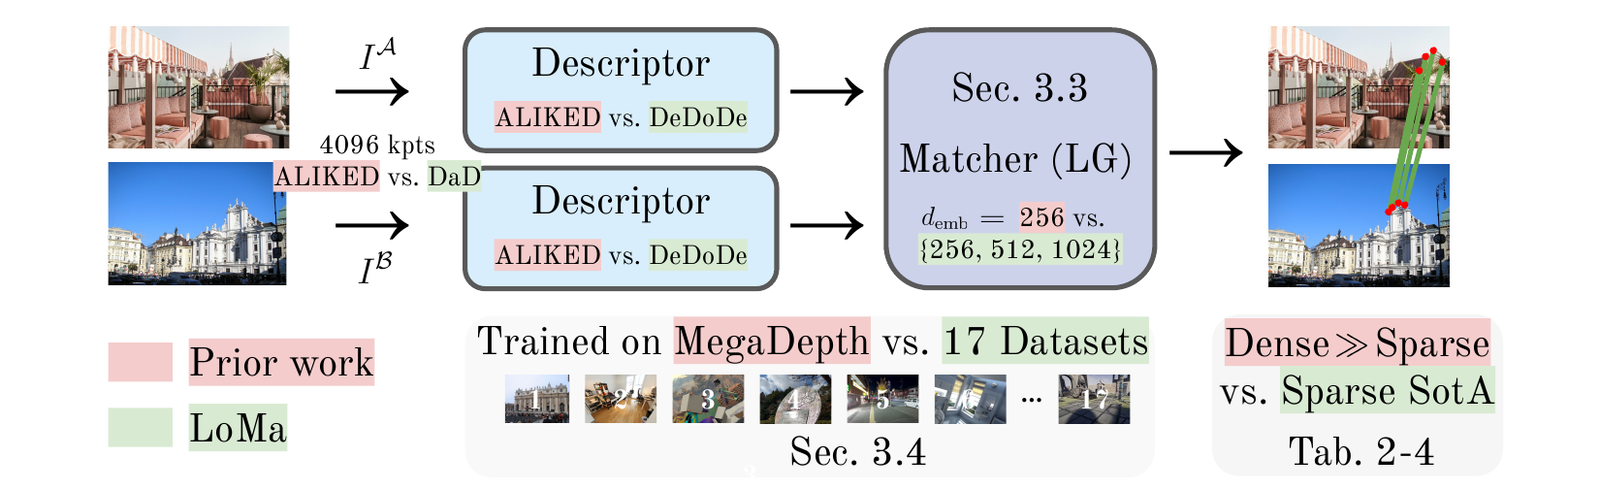
2.1 一张图看懂 LoMa
LoMa 的流程和 LightGlue 几乎一样,换的是三个部件:
- 检测器:DaD[13],冻结,不训练。训练时每张图 2048 个关键点,评测时 4096 个。
- 描述子:DeDoDe[14],先单独训练 50K 步,之后冻结,给匹配器提供初始特征。
- 匹配器:LightGlue 式结构,9 层 self/cross attention,逐层精化描述子;B / L / G 三个尺寸的嵌入维度分别是 256 / 512 / 1024,头维度统一 64。
2.2 描述子损失:dual-softmax 与互唯一约束
给定两张图的关键点特征 ,先算相似度矩阵
描述子的训练目标是让真值匹配 在行和列两个方向上都成为最大。为此,DeDoDe 使用 dual-softmax 损失[14]:
其中 是逆温度。对应的软分配矩阵是
也就是「行 softmax × 列 softmax」的逐元素乘积。它和普通行 softmax 的区别很关键:一个格子要高,必须同时是所在行和所在列的最大值——这正是互最近邻(mutual nearest neighbor)的软版本。推理时,LoMa 也只保留行列双向都是最大、且 的匹配。
下面这个部件把公式拆开给你看。左边是 6×6 的相似度矩阵 ,右边是概率矩阵 ;红框是真值匹配。拖动温度 和描述子噪声 ,切换「双 softmax / 仅行 softmax」,注意损失、平均 和最大列和怎么变。
怎么读这个部件:默认参数(、)下,双 softmax 的平均 约 0.6、互唯一 6/6;切到「仅行 softmax」,损失从 0.58 降到 0.28,但最大列和从 0.96 涨到 1.22。也就是说,行 softmax 更容易「优化」,但它不保证互唯一;dual-softmax 把「一个 B 只能被一个 A 认领」变成了损失的一部分。真实训练中 是固定超参,这里让你拖动是为了看清它的作用。
论文的实现把这些都放在 MatchAssignment 和 log_double_softmax 里。注意训练时分数矩阵会多出一个 dustbin 行和列,用来吸收「这个点没有匹配」的情况;推理时则退化成干净的双 softmax。
代码:双 softmax 与 dustbin(官方 src/loma/loma.py,原文照录)
def log_double_softmax(
    sim: torch.Tensor, z0: torch.Tensor, z1: torch.Tensor
) -> torch.Tensor:
    b, m, n = sim.shape
    scores0 = F.log_softmax(sim, 2)
    scores1 = F.log_softmax(sim.transpose(-1, -2).contiguous(), 2).transpose(-1, -2)
    scores = sim.new_full((b, m + 1, n + 1), 0)
    scores[:, :m, :n] = scores0 + scores1
    scores[:, :-1, -1] = z0.squeeze(-1)
    scores[:, -1, :-1] = z1.squeeze(-1)
    return scores


class MatchAssignment(nn.Module):
    def __init__(self, dim: int) -> None:
        super().__init__()
        self.dim = dim
        self.matchability = nn.Linear(dim, 1, bias=True)
        self.final_proj = nn.Linear(dim, dim, bias=True)

    def forward(self, desc0: torch.Tensor, desc1: torch.Tensor):
        mdesc0, mdesc1 = self.final_proj(desc0), self.final_proj(desc1)
        _, _, d = mdesc0.shape
        mdesc0, mdesc1 = mdesc0 / d**0.25, mdesc1 / d**0.25
        sim = torch.einsum("bmd,bnd->bmn", mdesc0, mdesc1)
        # For training we supervise matchability but for inference we don't use it
        # NOTE: This operation, double softmax, takes a lot of current inference time.
        if self.training:
            z0 = self.matchability(desc0)
            z1 = self.matchability(desc1)
            scores = log_double_softmax(sim, z0, z1)
        else:
            scores = F.softmax(sim, dim=2) * F.softmax(sim, dim=1)
        return scores, sim
所以呢:dual-softmax 不是 LoMa 的新发明,但它解释了一个容易被忽略的细节——匹配器的监督信号本身就是「互唯一」的。后面第 2.4 节的逐层损失,是在每一层上重复这件事,并额外加一个「这个点是否可匹配」的二分类。
2.3 训练数据:17 个数据集,三份重做的 3D 真值
这篇论文最重的工程量在数据。表 1 是训练混合:14 个三维/多视图数据集加 3 个光流数据集,权重从 1 到 0.01,明显借鉴了 RoMa v2 和 UFM 的配方。
| 数据集 | 类型 / GT 来源 | 权重 |
|---|---|---|
| ScanNet++ v2 | Indoor / Mesh | 1 |
| BlendMVS | Aerial / Mesh | 1 |
| Map-Free[15] | Object-centric / MVS | 1 |
| Hypersim | Indoor / Graphics | 1 |
| MegaScenes | Outdoor / MVS | 1 |
| MegaDepth | Outdoor / MVS | 1 |
| MegaDepth (Re-MVS) | Outdoor / MVS | 1 |
| AerialMD | Aerial / MVS | 1 |
| TartanAir v2 | Outdoor / Graphics | 1 |
| Mapillary Planet-scale | Driving / MVS | 1 |
| Aria Synthetic Environments | Indoor / Graphics | 0.1 |
| CO3Dv2 | Object-centric / MVS | 0.1 |
| MegaSynth | Indoor / Graphics | 0.1 |
| SpatialVID | Forward-motion / MVS | 0.01 |
| FlyingThings3D | Outdoor / Graphics | 0.5 |
| UnrealStereo4k | Outdoor / Graphics | 0.01 |
| Virtual KITTI 2 | Outdoor / Graphics | 0.01 |
其中三份数据是作者自己重做的真值:
- MegaDepth (Re-MVS):用 COLMAP[16] 的 MVS 在全部场景上重跑(光度 + 几何,默认设置),把原版 MegaDepth 只保留第一个稀疏模型时漏掉的场景补回来;
- MegaScenes:原数据集里很多场景质量不够,作者筛出 303 个相机和三维点足够多的场景,再跑 COLMAP MVS;
- SpatialVID:原始三维标注精度不够,作者选 59 个场景,用 SIFT + DaD 关键点、RoMa v2 对应和共享内参跑 COLMAP SfM;因为大多数场景是前向运动,不按常规过滤初始对,最后用一个简单的 PyTorch PatchMatch 算深度图。
此外还加入了 FlyingThings3D、UnrealStereo4k、Virtual KITTI 2 这些光流/合成数据——它们提供大位移和稠密对应,弥补真实 SfM 数据里视差不足的样本。
2.4 匹配器:9 层 self/cross attention 与逐层监督
匹配器 接收两组关键点和描述子,输出每对关键点的精化描述子:
结构上就是 9 层交替的 self-attention 和 cross-attention[3]:self-attention 让同一张图里的点互相聚合上下文,cross-attention 让两张图的点交换信息。两个细节值得记住:
- self-attention 里用 RoPE[17],注意力分数只依赖两点的相对位置 ,而不是绝对坐标;
- cross-attention 里不用位置编码,因为匹配本身不应该依赖两张图各自的绝对坐标系。
这两条都是从 LightGlue / RoMa v2 继承来的设计,论文没有单独做消融;如果读者想复现,直接照抄这两个 block 即可。
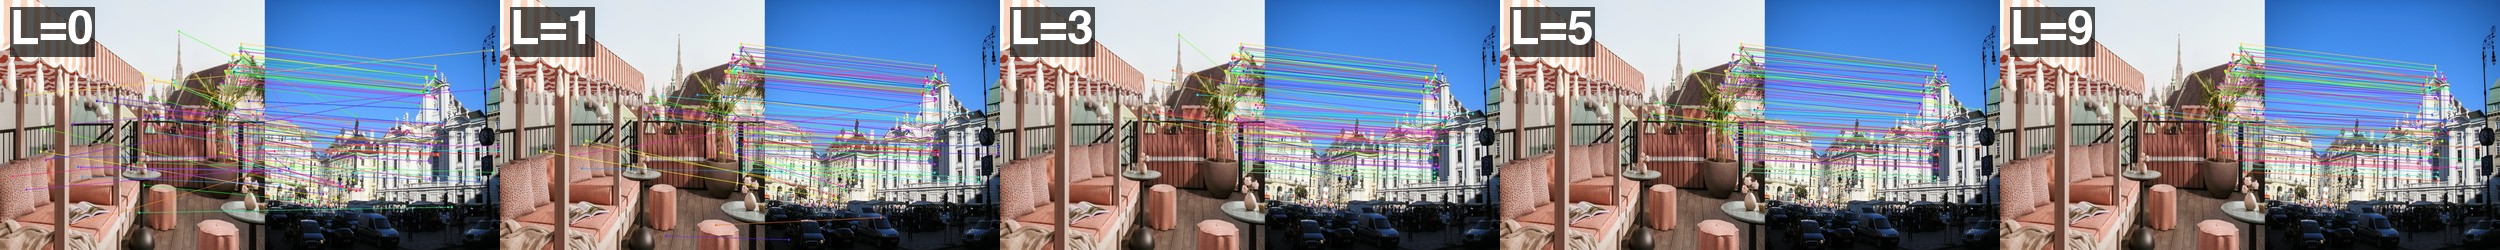
逐层监督是 LightGlue 的核心技巧:每一层都接一个 MatchAssignment 头,输出该层的分配矩阵,并对每一层算损失。推理时可以选择在第 层停下,用该层的分配矩阵做匹配——精度换速度。论文的层数固定为 9,但评测时会比较 。
每一层的损失由两部分组成:
- 条件损失:真值匹配处的负对数概率 ;
- 可匹配性损失:一个额外的线性头预测每个关键点「在另一张图里是否有匹配」,用二元交叉熵监督;实现上就是分数矩阵的 dustbin 行/列。
代码:逐层损失(官方 src/loma/loss.py,原文节选)
        # Compute loss over all layers (intermediate supervision)
        total_loss = 0.0
        n_layers = len(all_scores)
        for scores in all_scores:
            # scores shape: [B, M+1, N+1] - log assignment matrix
            # mnn shape: [num_matches, 3] - (batch_idx, idx_A, idx_B)
            M, N = scores.shape[1] - 1, scores.shape[2] - 1
            matchable_A = torch.zeros(
                (scores.shape[0], M), dtype=torch.float32, device=scores.device
            )
            matchable_A[mnn[:, 0], mnn[:, 1]] = 1.0
            matchable_B = torch.zeros(
                (scores.shape[0], N), dtype=torch.float32, device=scores.device
            )
            matchable_B[mnn[:, 0], mnn[:, 2]] = 1.0
            layer_loss_conditional = -scores[mnn[:, 0], mnn[:, 1], mnn[:, 2]].mean()

            layer_loss_matchability_A = F.binary_cross_entropy_with_logits(
                scores[:, :-1, -1], matchable_A
            )
            layer_loss_matchability_B = F.binary_cross_entropy_with_logits(
                scores[:, -1, :-1], matchable_B
            )

            layer_loss_matchability = (
                layer_loss_matchability_A + layer_loss_matchability_B
            )
            total_loss = (
                total_loss
                + (layer_loss_conditional + layer_loss_matchability)
                * self.cfg.layer_loss_weight
            )

        # Average over layers
        total_loss = total_loss / n_layers

        return total_loss, None
代码:匹配器的两种 block(官方 src/loma/loma.py,原文节选)
TransformerLayer 把两种 block 串起来:
class TransformerLayer(nn.Module):
    def __init__(self, *args, **kwargs):
        super().__init__()
        self.self_attn = SelfBlock(*args, **kwargs)
        self.cross_attn = CrossBlock(*args, **kwargs)

    def forward(self, desc0, desc1, encoding0, encoding1):
        desc0 = self.self_attn(desc0, encoding0)
        desc1 = self.self_attn(desc1, encoding1)
        return self.cross_attn(desc0, desc1)
SelfBlock.forward 在 q/k 上加 RoPE 后做注意力:
    def forward(self, x: torch.Tensor, encoding: torch.Tensor) -> torch.Tensor:
        qkv = self.Wqkv(x)
        qkv = qkv.unflatten(-1, (self.num_heads, -1, 3)).transpose(1, 2)
        q, k, v = qkv[..., 0], qkv[..., 1], qkv[..., 2]
        # v is a strided view (last-dim stride 3): SDPA would fall back to the math kernel
        v = v.contiguous()
        # if encoding is not None:
        q = apply_cached_rotary_emb(encoding, q)
        k = apply_cached_rotary_emb(encoding, k)
        context = F.scaled_dot_product_attention(q, k, v)
        message = self.out_proj(context.transpose(1, 2).flatten(start_dim=-2))
        return x + self.ffn(torch.cat([x, message], -1))
CrossBlock.forward 没有位置编码,两张图互为 key/value:
    def forward(
        self, x0: torch.Tensor, x1: torch.Tensor
    ) -> tuple[torch.Tensor, torch.Tensor]:
        qk0, qk1 = self.map_(self.to_qk, x0, x1)
        v0, v1 = self.map_(self.to_v, x0, x1)
        qk0, qk1, v0, v1 = map(
            lambda t: t.unflatten(-1, (self.heads, -1)).transpose(1, 2),
            (qk0, qk1, v0, v1),
        )
        m0 = F.scaled_dot_product_attention(qk0, qk1, v1)
        m1 = F.scaled_dot_product_attention(qk1, qk0, v0)
        m0, m1 = self.map_(lambda t: t.transpose(1, 2).flatten(start_dim=-2), m0, m1)
        m0, m1 = self.map_(self.to_out, m0, m1)
        x0 = x0 + self.ffn(torch.cat([x0, m0], -1))
        x1 = x1 + self.ffn(torch.cat([x1, m1], -1))
        return x0, x1
下面这个部件把「层」和「速度-精度」放在一起。点按钮切换 ,上面高亮用到的 block 数,下面换成论文附录里同一对图的匹配结果。默认停在 :这是论文 Pareto 曲线里性价比最高的点。
2.5 训练配方
论文的训练超参没什么魔法,关键是舍得算:
- 分辨率 560×560,AdamW,余弦退火,峰值学习率 ,全局 batch 64,权重衰减 ,EMA 衰减 0.999;
- 描述子先训 50K 步,约 1 天(8×A100-40GB);
- 匹配器再训 250K 步,B/L 约 2 天(8×A100-40GB),G 用 16×A100;
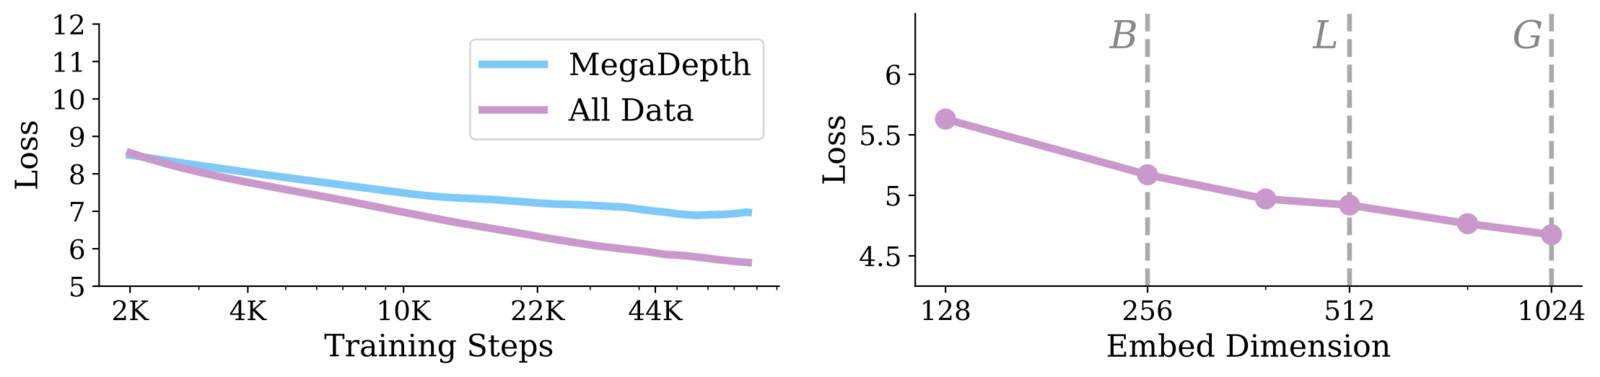
- 描述子训练在约 50K 步后验证损失不再下降、甚至缓慢上升(附录图 10a),所以作者把描述子限制在 50K 步,把算力留给匹配器。
对比一下:LightGlue 的训练规模是几万步、单卡到几卡;LoMa 的匹配器是 250K 步、8 到 16 张 A100。这些数字本身就是论文论点的一部分——稀疏匹配器的「上限低」,可能只是因为它从来没被这样训练过。
三、HardMatch:一把更难的尺子
3.1 为什么需要新基准
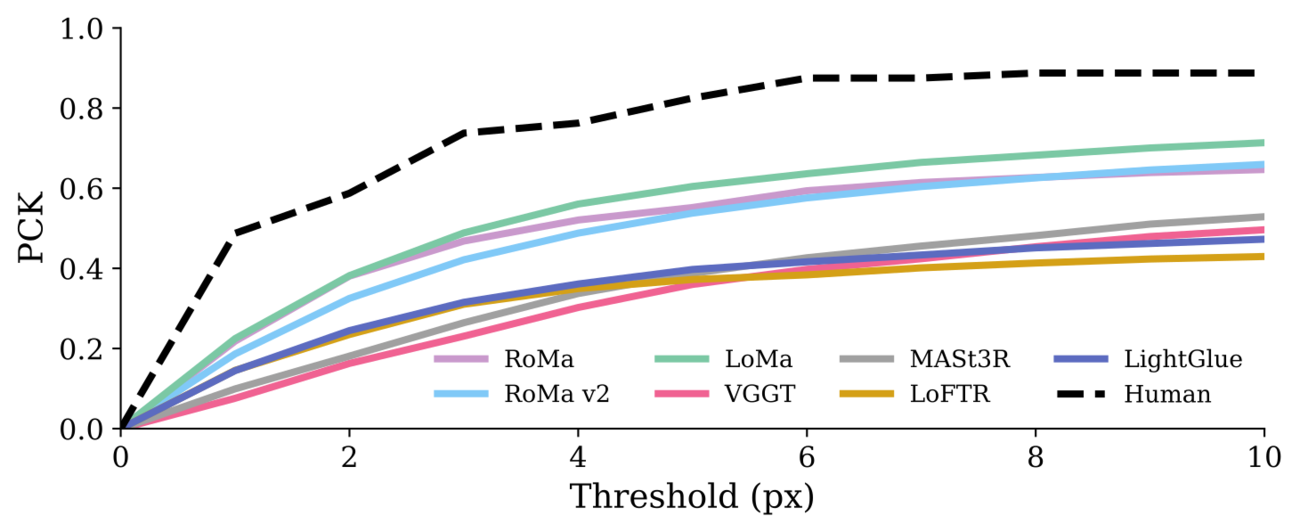
MegaDepth-1500 和 ScanNet-1500 的图像对来自成功的三维重建,能重建就说明匹配大体可解;WxBS 虽然难,但只有 37 对。图 1 右侧的累积分布把问题说得很清楚:在 PCK@10px 上,MegaDepth/ScanNet 的曲线在很小的累计比例处就到了 1,HardMatch 的曲线则一路拖到最右。基准饱和的直接后果是改进不可见:模型在鲁棒性上的真实提升,会被「大部分对本来就对」稀释掉。
HardMatch 的构造流程分三步:
- 找图:从 Wikimedia Commons 的 100 个类别里抓取许可宽松的图片,类别覆盖建筑、自然、天体、手绘、航拍等;
- 挑难对:每个类别随机采样 100 对,用 RoMa v2 的置信度图筛出「不确定」的对——最大置信度落在 0.3 到 0.9 之间,既保证难、又保留一点重叠;再人工检查,标成可匹配或不可匹配,直到每个类别凑够 10 对;
- 标关键点:每对人工标注 8 到 28 个对应点。类别随机划分为 10 个验证类和 90 个测试类。
最终是 1000 对图像、100 个类别、9 个挑战分组。每组的大小在图 4 左侧的括号里:视角变化 210 对、时间跨度 144、光照 138、自然 135、航拍 86、天体 51、季节 48、Doppelgänger 37、手绘 35。最小的组和 WxBS 差不多大。
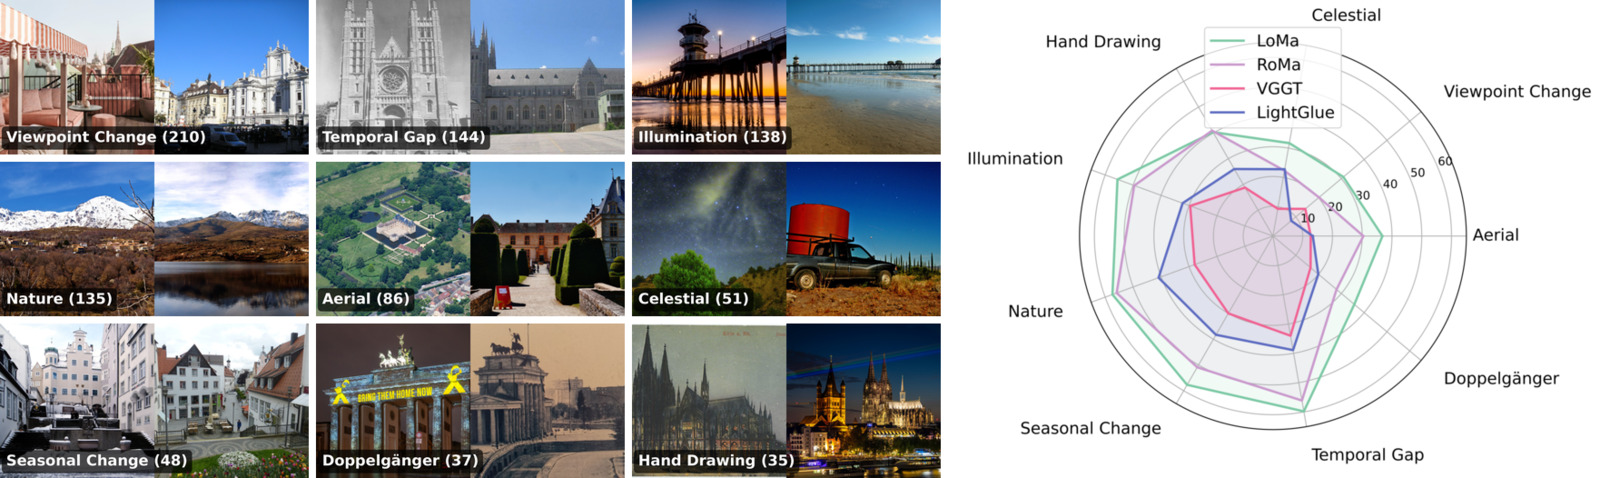
为了验证标注质量,作者请了 8 位独立标注者,每人 20 对:给定第一张图里的一个随机关键点,在第二张图里标出对应位置,记录像素误差分布,得到图 1 之外的人类基线(论文图 4 的黑色虚线)。在 10px 阈值下人类大约 0.88 PCK;LoMa-G 在 HardMatch 上的 mAA@10px 是 54.3。注意这两个数不可直接比较:人类是直接评在标注对应点上,匹配器则是先用匹配估计基础矩阵 、再算 PCK, 的鲁棒估计会吸收一部分匹配误差。
3.2 评测协议
主协议跟 WxBS 一致:每个方法在图像对上找匹配,用 OpenCV 的 MAGSAC 估计基础矩阵(内点阈值 0.25px),然后计算真值对应点在估计 下的极线误差,得到不同像素阈值下的 PCK。每对图像等权,不按关键点数加权;约 20 对动态场景不参与评测。
附录还给了一个替代协议(表 12):绕过 ,直接把真值对应点接到检测到的关键点上,算直接匹配误差。这个协议对稠密匹配器更友好(可以 warp 任意位置),也更适合动态场景和非透视相机。两种协议下 LoMa 都是最好的稀疏方法:直接对应评测里 LoMa-G 的 PCK@10px 是 74.0,RoMa v2 是 64.5,RoMa 是 60.9。
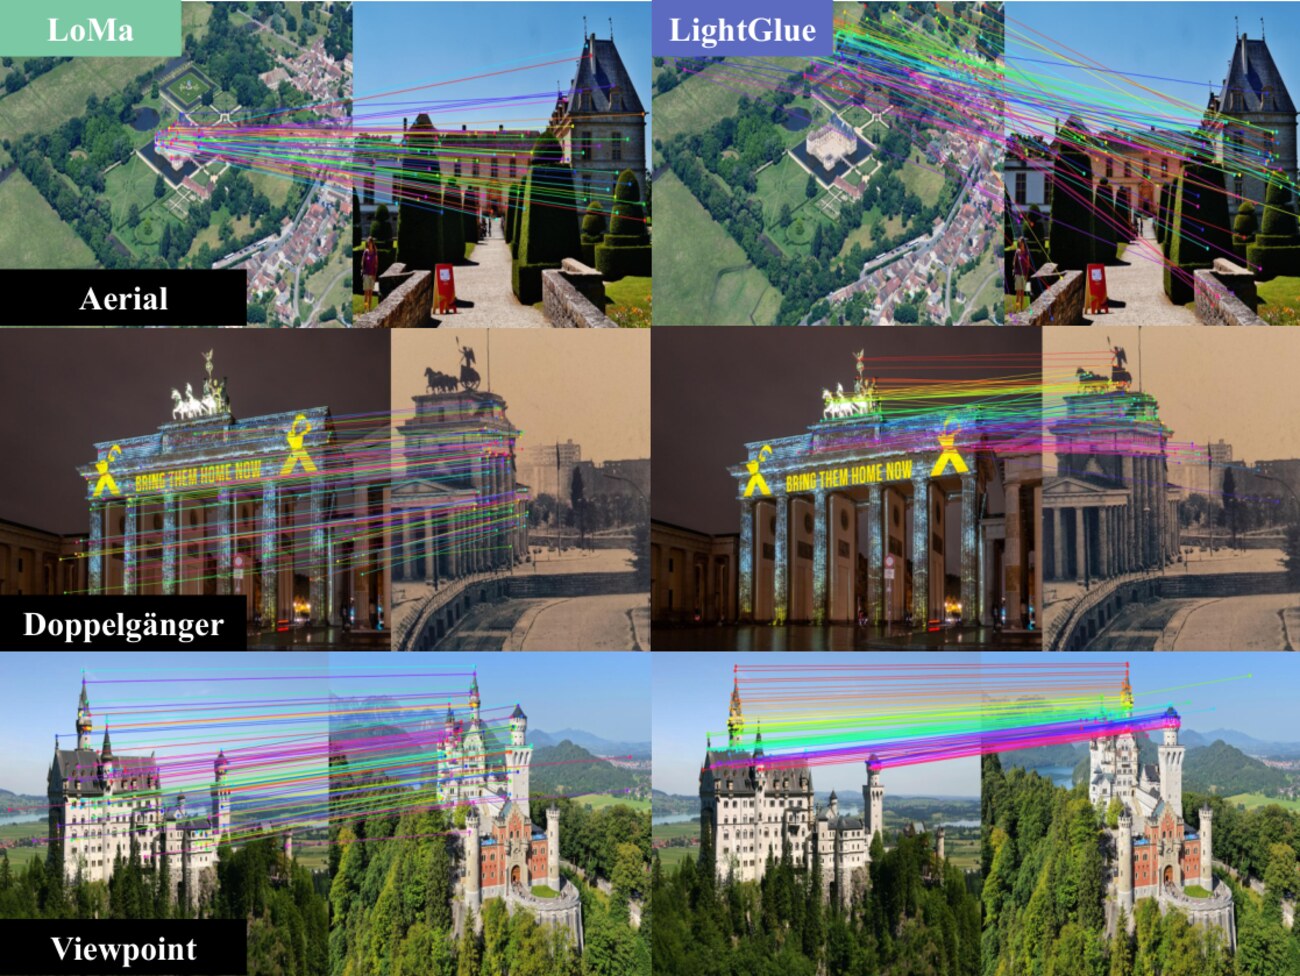
HardMatch 里最难的三类样本长这样:
3.3 官方代码:拿 HardMatch 跑自己的匹配器
HardMatch 不只是数据:作者把它做成了一个 pip 包(hardmatch,代码 MIT,图像各自沿用 Wikimedia 上的许可),自带下载、评测和两个示例匹配器(SuperPoint+LightGlue、LoMa)。默认评测 900 对测试图像(另有 100 对验证),第一次运行自动下载 660MB 数据;也可以在在线查看器里按分组筛选全部 1000 对。
评测协议在代码里写得很清楚:匹配器返回原图像素坐标下的对应点对,包内用 cv2.USAC_MAGSAC(阈值 0.25px、10 万次迭代)估计基础矩阵,再算真值对应点的极线误差;动态场景对不参与 评测。接入只需要实现一个 BenchmarkMatcher 协议——一个 offset 属性加一个 match 方法。安装用 uv add hardmatch(或 pip install hardmatch)。
代码:HardMatch 安装、协议与示例(官方 README / demo.py 原文)
uv add hardmatchfrom hardmatch import HardMatchBenchmark
matcher = YourFancyMatcher()
result = HardMatchBenchmark().benchmark(matcher)class YourFancyMatcher:
offset = 0.0 # pixel offset subtracted from returned keypoints before scoring
def match(self, img_A_path: str, img_B_path: str) -> tuple[np.ndarray, np.ndarray]:
"""Return (kpts_A, kpts_B): corresponding (N, 2) keypoints in pixel
coordinates of the original image files, one row per match."""
...
return kpts_A, kpts_Buv sync --extra baselines
uv run demo.py --matcher loma
# Expected result: mAA_10px: 0.5061官方 demo 用 LoMa-B、4096 个关键点,预期 mAA@10px 是 0.5061,比论文表里的 51.1 略低:README 说明投稿后因许可问题改了约 10 对图像,所以复现数字会和论文有细微出入。想做消融或换匹配器,这个包比自己写评测脚本省事,也保证了和论文同一套协议。
四、实验结果
4.1 评测设置
所有 LoMa 评测都用内部 784×784 分辨率、4096 个 DaD 关键点、9 层匹配器。相对位姿按 LoFTR 的 AUC 协议;WxBS 和 HardMatch 用 mAA@10px;视觉定位用 HLoc[18] 流程;IMC 2022 用官方 Kaggle 隐藏测试集、20 万次 MAGSAC 迭代、内点阈值 0.2。
4.2 相对位姿与匹配:稠密仍领先,但差距在缩小
表 2 的关键数字(完整数据见下面的部件):
- MegaDepth-1500 AUC@5°:RoMa v2 62.8、RoMa 62.6,仍是前两名;LoMa-L 56.5 是最强稀疏匹配器,比 ALIKED+LightGlue 的 48.1 高 8.4,但离稠密还差 6.3。
- ScanNet-1500 AUC@5°:RoMa v2 33.6,LoMa-L 29.3;不过 LoMa 把稀疏基线从 ALIKED+LightGlue 的 14.5 拉到了 29.3,翻了一倍。
- WxBS mAA@10px:LoMa-G 73.4,以 0.8 分超过 RoMa 的 72.6;ALIKED+LightGlue 只有 43.9。
- HardMatch mAA@10px:LoMa-G 54.3,ALIKED+LightGlue 35.7,RoMa v2 46.5。+18.6 的差距就是摘要里最醒目的数字。
下面这个部件把论文表 2–4 的数据放在一起。选基准、选指标,条形按该基准的最大值归一,橙色是 LoMa 家族。
所以呢:这张表最重要的信息不是「LoMa 全面赢了」,而是赢在哪里。在 MegaDepth/ScanNet 这种「图像对来自成功重建、大部分可解」的基准上,稠密方法靠亚像素精度仍然领先 4 到 6 个 AUC@5°;在 WxBS、HardMatch、RUBIK、IMC 这些难基准和视觉定位上,LoMa 的优势才显现出来。这也解释了作者为什么要先造 HardMatch:旧基准已经分不出高下了。
4.3 视觉定位
视觉定位对匹配器的要求和 SfM 略有不同:查询图与数据库图之间往往只有很小的重叠,匹配错了会直接导致 PnP 失败。LoMa 在这里的提升比相对位姿更明显:
- Map-free(无地图重定位):用 DA3 的单目度量深度,按官方协议算 VCRE<90px 的精度与 AUC。LoMa-G 68.9% / 90.3,比 ALIKED+LightGlue 的 47.2% / 79.5 高 21.7 / 10.8;LoMa-B 65.6% / 89.0。
- InLoc(室内):HLoc 流程,DUC1/DUC2 在 (0.25m, 2°) 下,LoMa-B/L 分别是 57.1 / 59.1(DUC1),71.0 / 71.0(DUC2);LoMa-G 的 DUC2 是 73.3,比第二名 SP+SG 的 52.7 高 20.6。但在 DUC1 最严阈值上 LoMa-G 反而低于 B/L——这是我在表 3 里注意到的一个反例。
- Oxford Day-and-Night(昼夜):HLoc + NetVLAD-50 检索,夜间查询。LoMa-G 在 (0.25m, 2°) 下是 58.9,比最好的稀疏基线 SP+SG 的 44.3 高 14.6;在 (1m, 10°) 下是 69.7,比 ALIKED+LightGlue 的 58.9 高 10.8。
4.4 RUBIK 与 IMC 2022
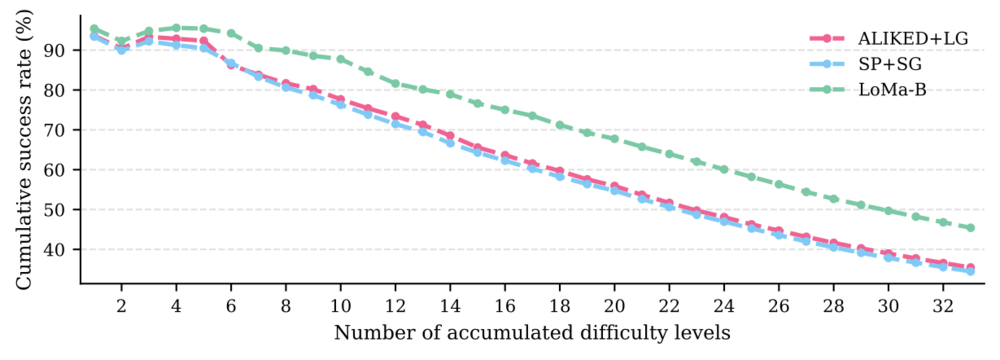
- RUBIK[19]:按重叠度、尺度比、视角把 1.65 万对图像分成 33 个难度等级。LoMa-G 的 AUC@10°/20° 是 73.2 / 79.9,比 ALIKED+LightGlue 的 49.0 / 55.2 高 24.2 / 24.7。图 7 的累积成功率曲线显示,随着难度等级累加,LoMa-B 的曲线始终高于 ALIKED+LightGlue 和 SuperGlue,而且差距在中等难度处最大。
- IMC 2022[20]:官方隐藏测试集,LoMa-G 89.3 mAA,LoMa-L 89.0、LoMa-B 87.4;2022 年的冠军集成(LoFTR + DKM + SuperGlue)是 86.3,RoMa 是 88.0。LoMa 不仅超过单个方法,也超过了那年的冠军集成。需要提醒的是,IMC 的评测允许任何重建方法、hyperparameter 空间很大,论文自己也说这个比赛「less standardized」,所以 89.3 这个数字的说服力不如 HardMatch 的 54.3。
4.5 消融:收益主要来自数据和表示,不是结构
表 5 在 HardMatch 验证集上逐步加料,是全文最值得看的一张表:
| 步骤 | 改动 | HM mAA@10px |
|---|---|---|
| I | ALIKED + LightGlue(基线) | 36.3 |
| II | DaD + DeDoDe + LightGlue,仍只训 MegaDepth | 42.0(+5.7) |
| III | 匹配器训练数据 → 全部 17 个数据集 | 48.9(+6.9) |
| IV | 描述子也训练在全量数据上 | 51.1(+2.2) |
| V | 匹配器训练 50K → 250K 步 | 51.5(+0.4) |
| VI | 嵌入维度 256 → 512(LoMa-L) | 52.8(+1.3) |
| VII | 嵌入维度 → 1024(LoMa-G) | 52.9(+0.1) |
把 II 到 IV 合起来看:只换检测器和描述子、仍然只训 MegaDepth,能涨 5.7;把数据扩到 17 个数据集,再涨 9.1;而把匹配器训练步数翻五倍只涨 0.4,把嵌入维度翻四倍只涨 1.4。 这不是一篇「架构论文」,而是一篇「数据 + 表示质量」的论文。作者自己在正文里也是这么说的:数据收集带来接近 10 个点的 HardMatch 提升。
另外两个消融值得记:
- 检测器(表 6):DaD 单检测器 51.3,ALIKED 49.0、DeDoDe v2 47.3、DISK 45.3。DaD 最好,而且「专门为一个检测器训练匹配器」比「多个检测器混合训练」略好(51.3 对 51.0)。
- 关键点数(表 7):从 512 增到 4096,LoMa-B 在 MegaDepth-1500 的 AUC@20 从 80.3 升到 83.6,在 ScanNet-1500 从 58.3 升到 68.2;2048 到 4096 的提升不大,但低于 2048 会明显退化。
数据规模和模型容量的作用也可以从训练曲线直接看到:
4.6 吞吐与提前退出
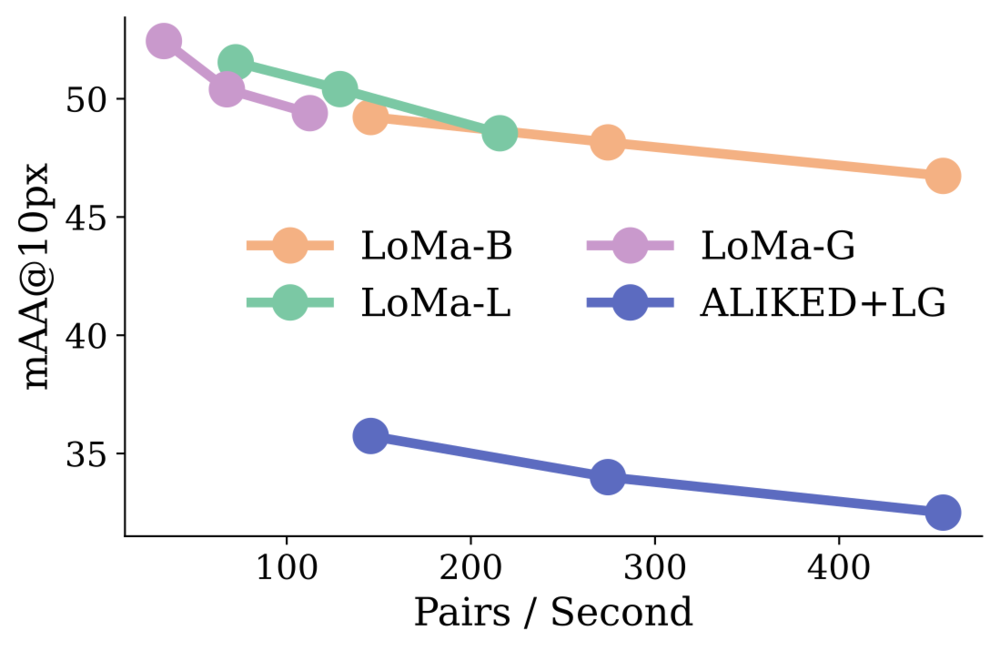
匹配是 SfM / 视觉定位的主瓶颈:检测和描述每张图只做一次,匹配每对图都要做。LoMa 的逐层监督让匹配器可以在任意一层停下,因此速度-精度是一条曲线而不是一个点:
- 在 A100、2048 个关键点、batch 16 的设置下,LoMa-B 的匹配器可以跑到每秒几百对;
- 单对图像、batch 1 时,LoMa-B 在 下接近 300 pairs/s;
- 论文说 LoMa-B 在 时的运行时间与 LightGlue 相同,但匹配明显更准——这是「同样的推理成本,更好的特征」的最直接证据。
4.7 定性结果
除了图 3 的逐层演化,论文附录还给了一组 HardMatch 的匹配可视化(图 13):24 对图像上 LoMa-G 的匹配,绿色是 5px 阈值下的内点、红色是外点。可以看到在航拍、夜景、季节变化这些对里,LoMa 的匹配线大多仍然平行;但在 Doppelgänger 和极端视角变化上,错误匹配依然存在——这两类正是下一节要说的局限。
五、局限性
先列论文自己承认的:
- 描述子大规模训练会过拟合:HardMatch 验证损失在约 50K 步后不再下降甚至缓慢上升(附录图 10a),所以描述子只训 50K 步,算力主要给匹配器。这说明「数据 + 容量」不是无脑堆就有效,描述子这一侧还有正则化/数据质量的问题。
- Doppelgänger 和极端视角仍然很难:HardMatch 上所有方法在 Doppelgänger 组的 mAA 都很低(图 4 右侧雷达图),大视角变化也是;论文的定性图 12 里,Doppelgänger 对全部方法失败。
- HardMatch 依赖人工标注:虽然用 估计缓解了标注噪声,但协议要求静态场景和透视相机,动态场景和非透视相机需要另一个协议(附录表 12 的直接对应评测就是为此准备的)。
- 地理和时间偏差:HardMatch 的图像主要来自欧洲、时间集中在 21 世纪,附录图 11 的分布图显示得很清楚;这不代表全球所有场景的难度分布。
- 没有面内旋转不变性:LoMa 本身不做旋转增强或等变设计,所以在 SatAst 这种大面内旋转的数据上虽然比基线好(LoMa-G 22.9 对 ALIKED+LightGlue 的 12.1),但绝对水平仍然低。作者在后续工作里用数据增强 + 架构设计做了 LoMa-R(旋转不变版本,CVPRW 2026)。
我自己再补几条:
- 架构上的新意有限:DaD 检测、DeDoDe 描述、LightGlue 匹配器都是已有工作,RoPE + 无位置编码 cross-attention 也是 LightGlue/RoMa v2 的设计。这篇论文的价值在数据和基准,而不是新模块;读的时候不要把「Revisited」误解成「新架构」。
- 「更大」不是单调更好:表 3 里 LoMa-G 在 InLoc DUC1 的最严阈值上(55.6)反而低于 LoMa-B(57.1)和 LoMa-L(59.1)。容量提升在平均意义上有效,但在具体基准上会有波动;部署时 B 往往是最稳的默认值。
- 基准的统计噪声:HardMatch 有 1000 对,但 Doppelgänger 只有 37 对、手绘 35 对;分组结论的方差不小。WxBS 只有 37 对,LoMa-G 对 RoMa 的 0.8 分优势不应被过度解读。
- 训练代码在
train-dev分支,且作者注明复现未经验证:main 分支只有推理代码和loss.py参考实现;训练入口(train/descriptor.py、train/matcher.py)在官方train-dev分支。README 顶部写着「Training reproduction has not been validated but the code closely follows the original training code」——代码接近原训练实现,但作者没有保证能复现论文数字。想从头训练的人可以用,但要预期到调参和踩坑。 - 协议差异会影响结论:HardMatch 的 mAA 是通过估计 再算 PCK, 的鲁棒估计会吸收一部分匹配误差;附录表 12 的直接对应评测里,LoMa-G 的 PCK@10px 是 74.0,RoMa v2 是 64.5,差距比 mAA 口径下的 54.3 对 46.5 更大。两种口径都支持 LoMa 更好,但具体数字不要混用。
六、结论与展望
LoMa 的故事线其实很简单:当一条路线被认为「到顶了」,先检查它是不是只是没被 scale 过。 稀疏匹配器的训练长期停留在 MegaDepth + 几万步 + 256 维,而稠密匹配和前馈重建已经在用几十个数据集、几十万步和上千维。LoMa 把这三根轴补上,再配一个足够难的基准,稀疏匹配器就重新有了竞争力——在 HardMatch 上 +18.6 mAA,在 WxBS 上超过 RoMa,在 RUBIK/IMC 上大幅领先。
但它也没有推翻稠密匹配:MegaDepth/ScanNet 的相对位姿上,RoMa v2 仍然领先 4 到 6 个 AUC@5°。更准确的结论是:稀疏匹配在「难匹配 + 视觉定位」场景下重新成为首选,在「经典相对位姿」场景下仍是稠密方法的追赶者。 两条路线会继续共存,而不是一条取代另一条。
对实践者的几条建议:
- 如果你在 HLoc / SfM 流程里用 LightGlue,LoMa-B 是最直接的 drop-in:同样的量级、自动下载权重、有 HLoc fork;难场景再考虑 LoMa-G。
- 评测匹配器时,除了 MegaDepth/ScanNet,至少加一个 HardMatch 或 RUBIK 的难基准;旧基准已经分不出方法的高下。
- 如果关心旋转不变的场景(航拍、卫星),等 LoMa-R 或自己做旋转增强;原版 LoMa 在 SatAst 上仍然吃力。
- 读这篇论文时,把注意力放在表 5 的加料顺序上:数据(+9.1)> 检测器/描述子(+5.7)> 容量(+1.4)> 训练步数(+0.4)。这比任何单个 SOTA 数字都更有迁移价值。
七、上手
官方仓库提供了推理代码、五个模型(B、B128、L、G、R)和自动下载的权重;训练代码在 train-dev 分支,未并入 main。本文所有代码与命令都摘自官方仓库:davnords/loma 的 main README、demo.py、src/loma/loma.py、src/loma/loss.py,train-dev 分支的 README 和 train/*.py,以及 davnords/HardMatch 的 README 和 demo.py。没有使用第三方复现,也没有改写命令。
在 clone 下来的仓库目录里安装(README 另外给了 uv sync 作为替代):
安装命令(官方 README,Linux + Python 3.12,uv)
uv pip install -e .最小示例:匹配两图并估计基础矩阵(官方 README 原文)
import cv2
from loma import LoMa, LoMaB

# load pretrained model
model = LoMa(LoMaB())  # also available: LoMaB128, LoMaL, LoMaG, LoMaR
# Define image paths, e.g.
img_A_path, img_B_path = "assets/0015_A.jpg", "assets/0015_B.jpg"
# Extract matching keypoints in image coordinates
kptsA, kptsB = model.match(img_A_path, img_B_path)

# Find a fundamental matrix (or anything else of interest)
F, mask = cv2.findFundamentalMat(
    kptsA, kptsB, ransacReprojThreshold=0.2, method=cv2.USAC_MAGSAC, confidence=0.999999, maxIters=10000
)
scripts/eval_prep.sh 只用于下载 MegaDepth1500 / ScanNet1500,已有数据可跳过;评测前还要装 --extra eval 依赖。
跑 demo 与评测(官方 README 命令)
uv run demo.py matcher:loma-b

source scripts/eval_prep.sh
uv sync --extra eval
uv run eval.py matcher:loma-b --benchmark wxbs
uv run eval.py --help
训练代码不在 main,而在官方 train-dev 分支。切到该分支后,README 给的两阶段命令如下。README 顶部注明「Training reproduction has not been validated but the code closely follows the original training code」:代码接近原实现,但不保证复现论文数字。数据沿用 RoMa / DKM 的 MegaDepth 预处理,放在 data/(或软链过去);README 的 Training 一节列了完整模型的 16 个数据集链接,表 1 的 MegaDepth (Re-MVS) 是同一数据集的重跑,不另列。训练分两阶段:先描述子,再匹配器;只微调匹配器时跳过第一阶段。
训练命令(官方 train-dev 分支 README 原文)
uv run torchrun --nproc_per_node=8 train/descriptor.py --name loma-descuv run torchrun --nproc_per_node=8 train/matcher.py --name loma-match --model.descriptor_run_path <path to your descriptor run>- 训练 LoMa-R:在匹配器命令上加
--transform.rot360。 - 换 LoMa-B/L/G:改嵌入维度和头数;头维度固定 64,嵌入维度分别是 256 / 512 / 1024。
- 单卡也能跑(
uv run train/matcher.py),但 README 明说不能复现论文结果;默认超参对应 LoMa-B。
几个和论文概念的对应关系:
- 模型尺寸:
LoMaB用 DeDoDe-G 描述子、嵌入 256;LoMaB128用 DeDoDe-B、输入 128、嵌入 256;LoMaL嵌入 512、8 头;LoMaG嵌入 1024、16 头;LoMaR是旋转不变版本。所有变体都是 9 层、头维度 64。 - 阈值:推理默认
filter_threshold=0.1,对应论文的 。 - 关键点数:默认
num_keypoints=2048;论文评测用 4096,调用model.match(..., num_keypoints=4096)即可。 - 权重协议:初始化时自动从 GitHub Releases 下载;整体 MIT,匹配器部分继承 LightGlue 的 Apache-2.0。README 只声明了代码协议,没有单独声明权重的协议。
- 集成:作者提供了 HLoc fork(
davnords/Hierarchical-Localization)和 vismatch PR #63;如果你在用 HLoc,直接把匹配器换掉即可。
参考
- Nordström, Edstedt, Bökman, Astermark, Heyden, Larsson, Wadenbäck, Felsberg, Kahl. LoMa: Local Feature Matching Revisited. ECCV 2026 (Oral). arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Nordström, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Zhang, Keetha, et al. UFM: A Simple Path towards Unified Dense Correspondence with Flow. NeurIPS 2025. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Dai, Chang, Savva, Halber, Funkhouser, Nießner. ScanNet: Richly-annotated 3D Reconstructions of Indoor Scenes. CVPR 2017. arXiv · 代码
- Mishkin, Matas, Perdoch, Lenc. WxBS: Wide Baseline Stereo Generalizations. BMVC 2015. arXiv
- Edstedt, Bökman, Wadenbäck, Felsberg. DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection. arXiv 2503.07347, 2025. arXiv · 代码
- Edstedt, Bökman, Wadenbäck, Felsberg. DeDoDe: Detect, Don't Describe — Describe, Don't Detect for Local Feature Matching. WACV 2024. arXiv · 代码
- Arnold, Wynn, Vicente, Garcia-Hernando, Monszpart, Prisacariu, Turmukhambetov, Brachmann. Map-free Visual Relocalization: Metric Pose Relative to a Single Image. ECCV 2022. arXiv
- Schönberger, Frahm. Structure-from-Motion Revisited (COLMAP). CVPR 2016. 项目页 · 代码
- Su, Lu, Pan, Wen, Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 2024. arXiv
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale (hloc). CVPR 2019. arXiv · 代码
- Loiseau, Bourmaud. RUBIK: A Structured Benchmark for Image Matching across Geometric Challenges. CVPR 2025. arXiv
- Howard, Trulls, Yi, Mishkin, Dane, Jin. Image Matching Challenge 2022. Kaggle, 2022. 比赛页