· 81 min read
论文解读:FlexGlue,稀疏到稠密特征匹配与视觉消歧的统一
TL;DR FlexGlue 是 LightGlue 作者团队的新匹配器[1]。它不在两张图的关键点之间做匹配,而是把一张图上的任意查询点,送到另一张图的稠密 token 网格里找亚像素对应点:既摆脱了稀疏匹配「两边都得检测到」的可重复性瓶颈,又避免了稠密匹配为每个像素预测和精化的开销。更关键的是,它把「这两张图到底是不是同一个地方」(视觉消歧,visual disambiguation)作为同一个网络的输出联合训练,并在每一层都给出判断,于是非共视的 doppelganger 图像对可以在前几层就提前退出。结果是:ETH3D 上端到端 SfM 的位姿 AUC@3° 从 LoMa-B + DG++ 的 81.2 提高到 86.8,吞吐却是后者的 7.5 倍;IMC2025 用 10k 个关键点超过榜首 8 分;室内视觉定位 InLoc 在 6 个阈值中的 5 个取得最好成绩。同时作者发布了首个室内 doppelganger 基准 LaMAR-DG。代码与权重已开源,MIT 协议(backbone 权重受 DINOv3 协议约束)。
- 论文:FlexGlue: Sparse-to-Dense Feature Matching and Visual Disambiguation,Philipp Lindenberger、Paul-Edouard Sarlin、Ondrej Miksik、Marc Pollefeys,ETH Zurich / Google / Microsoft Spatial AI Lab,2026 年 10 月 23 日。
- 代码:github.com/cvg/flexglue
- 前作:SuperGlue、LightGlue;本文假定读者对 SuperPoint 这一类局部特征和 视觉定位 的流程有基本了解。
一、动机:匹配器的两个老问题和一个盲区
图像匹配是三维视觉的地基:SfM、SLAM、视觉定位都要先在两张图之间找到对应点。过去几年这个方向沿着两条路走:
稀疏匹配(SuperGlue、LightGlue、LoMa)[2, 3, 4]先在每张图上独立检测关键点,再在两组关键点之间学一个分配。它的优点是快,而且天然给出多视图所需的离散轨迹(track);缺点是上限被检测器卡死:一个 3D 点只有在两张图里都被检测到才可能匹配,检测的定位噪声也会原封不动传给对应点。在纹理弱、结构重复的室内场景,这个问题尤其严重。
稠密匹配(DKM、RoMa、RoMa v2、MASt3R、UFM)[5, 6, 7, 8, 9]直接为每个像素估计对应点,不依赖检测器,对大视角和外观变化非常鲁棒,还能做到亚像素精度。代价是要在 coarse-to-fine 的流程里为全图每个像素预测并精化对应,分辨率受限、训练昂贵,而下游通常只用得到其中稀疏的一小部分。多视图应用还得把稠密对应「吸附」到离散关键点上,徒增启发式。半稠密方法(LoFTR、EDM)[10, 11]在粗网格上匹配再精化全部对应,便宜一些,但对应点锚定在网格单元上。
稀疏到稠密的路线其实早有人走:S2DNet 和 CAPS 把它当成[12, 13]稀疏查询在 CNN 超列特征上的稠密分类,但只有局部感受野;COTR 有全局上下文[14],却要靠缓慢的递归缩放逐点精化;RCM 沿用半稠密匹配器的设计[15],只是把一侧的粗网格换成稀疏关键点,于是那一侧的上下文被限制在关键点上。FlexGlue 则在两张图的完整稠密网格上聚合上下文。
下面这个部件画出三种范式的区别。点按钮切换,留意「哪些位置可以成为对应点」以及「代价随什么增长」。
两条路之外还有一个共同的盲区:它们都只在共视(covisible)的图像对上训练。真实的 SfM 和 SLAM 必须拒绝那些拍的是不同地方的图像对,而学出来的匹配器会在视觉上相似的结构之间(最典型的是对称建筑的两个立面)自信地给出大量匹配,导致重建场景整体坍缩。有意思的是,这种时候 SIFT 这种老方法反而常常更好[16],因为它不会「脑补」。近期的 Doppelgangers 和 DG++[17, 18] 为此在匹配之后额外接一个专门的共视性分类器,但这是架构和计算上的冗余:局部匹配和全局消歧本质上是同一件事,都是在找两张图之间有重叠的上下文。
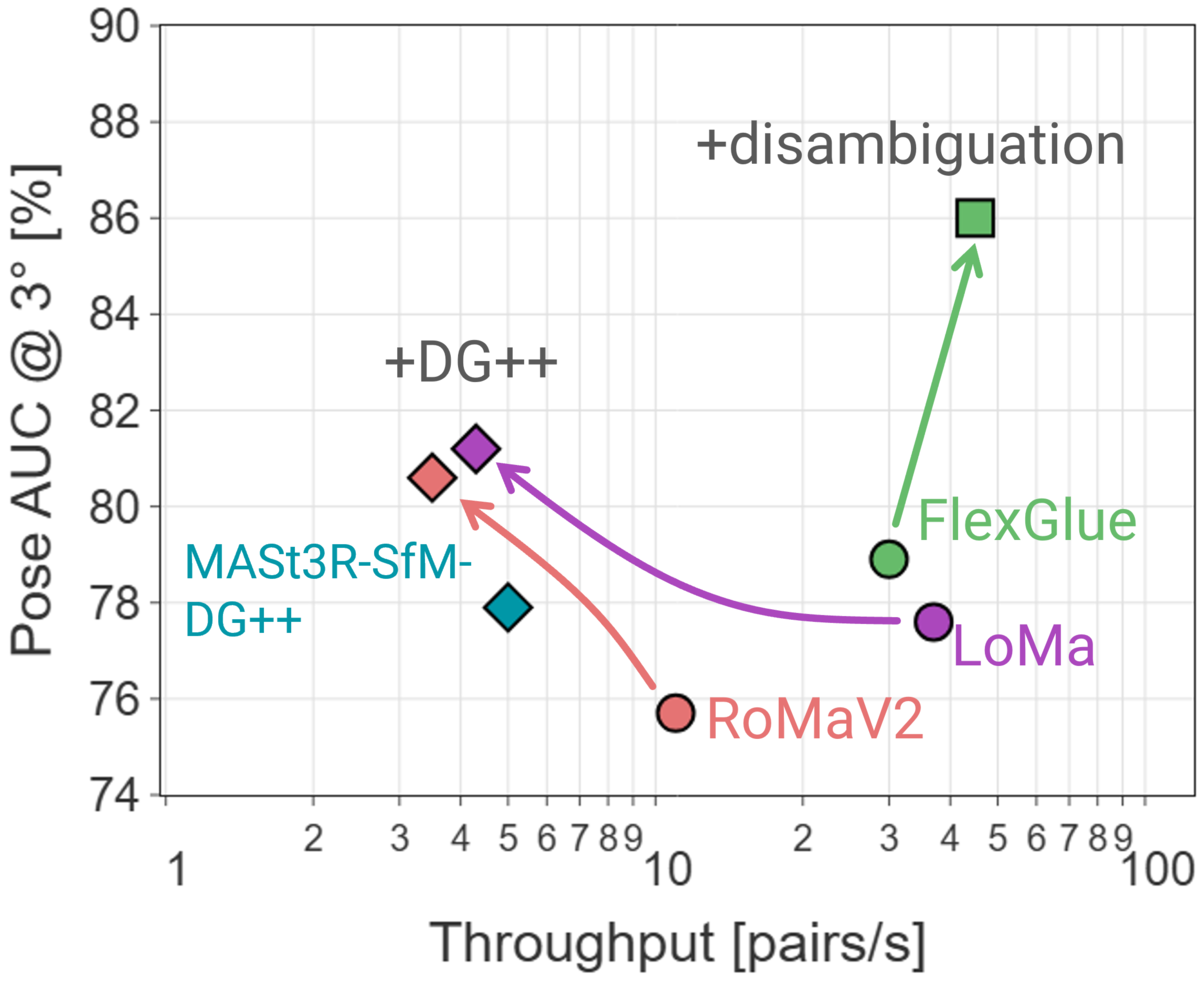 图 1 左:ETH3D 上端到端 SfM 的位姿 AUC@3° 与吞吐。FlexGlue 本身已优于 LoMa 和 RoMa v2,加上自带的消歧后精度跳到 86%,而给别的匹配器接 DG++ 消歧会让吞吐掉到 4 到 5 pairs/s。
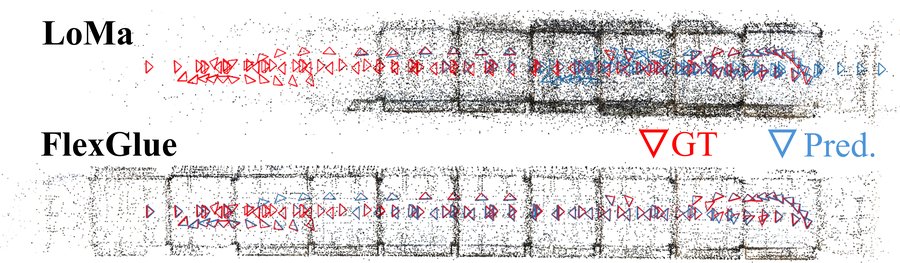 图 1 右上:同一组图像的 SfM 结果。LoMa 把两个相似立面叠在了一起(红色 GT 与蓝色预测错开),FlexGlue 的轨迹与 GT 重合。
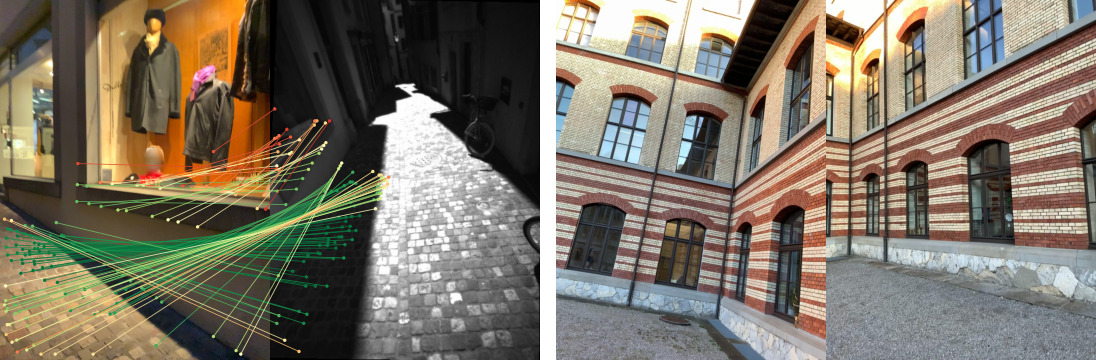 图 1 右下:左边是真实共视的一对,右边是看起来几乎一样但其实是同一栋楼不同角落的 doppelganger,FlexGlue 以 98% 的置信度拒绝它。
于是论文的目标很明确:一个网络,同时解决「稀疏 vs 稠密」的取舍和「匹配 vs 拒绝」的盲区。作者把贡献归纳为三点:
- 高效的稀疏到稠密匹配:简单的架构,兼具稀疏匹配的效率和稠密匹配的鲁棒性与精度,在若干两视图估计和室内视觉定位基准上达到 SOTA。
- 匹配与消歧联合建模:联合公式比专用消歧模型准确,吞吐高 4 倍,而且在不可匹配的图像对上提前退出;显著提升 ETH3D 与 CVPR 2025 图像匹配挑战赛上 SfM 的鲁棒性。
- 室内 doppelganger 基准 LaMAR-DG:首个室内、跨设备的视觉消歧基准,来自 LaMAR 数据集的难负样本挖掘[19]。现有方法在这里都掉得很厉害。
二、核心方法
2.1 问题定义与总体架构
给定两张图 和各自的关键点坐标 、,FlexGlue 对 中的每个关键点预测它在 中的 2D 坐标 ,反方向同理。它还为每个点预测一个可匹配性(matchability,该点在另一张图里是否可见),并为整个图像对预测一个共视得分(两张图是否看到同一场景)。稀疏到稀疏的匹配是从这些对应点按图像距离推导出来的,而不是直接学一个分配矩阵。
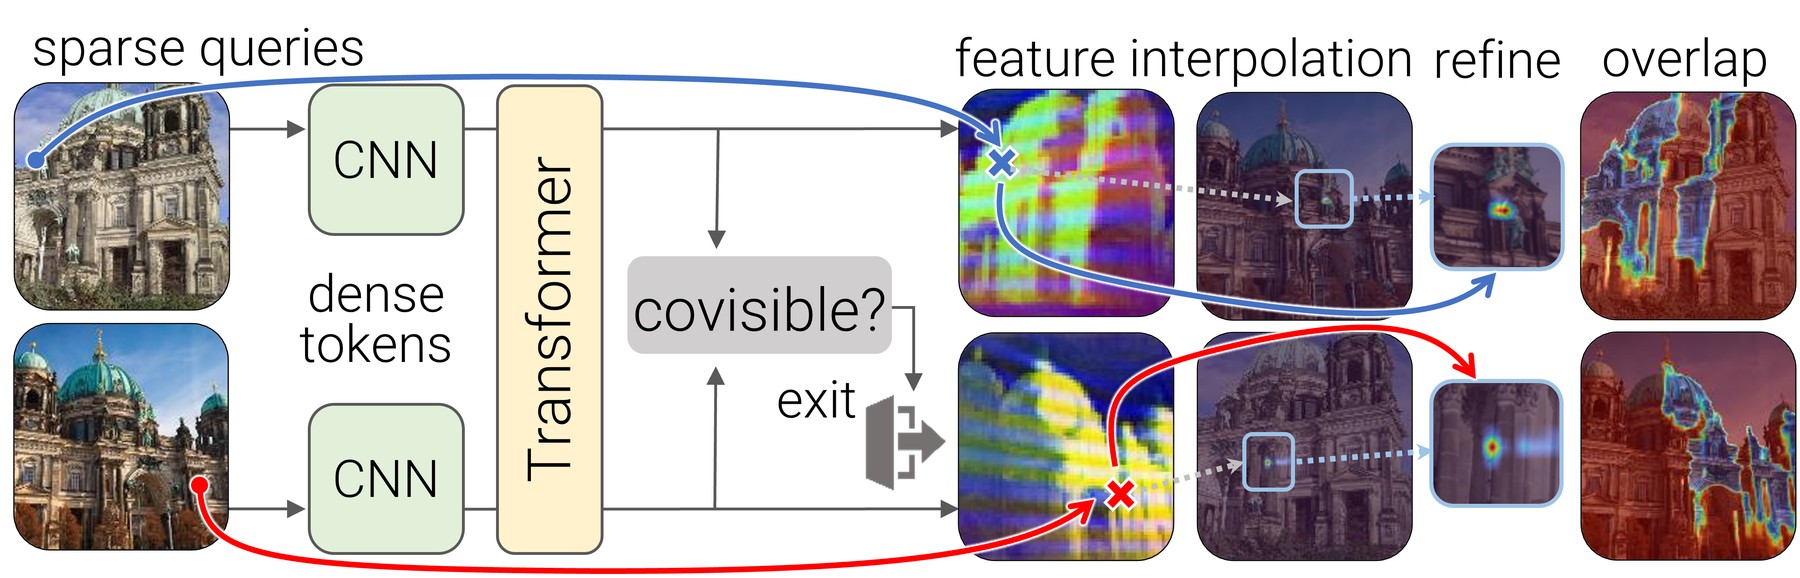 图 2:两张图各自经过 CNN 得到稠密 token,Transformer 融合两图上下文并在每层判断是否共视;非共视则直接退出。否则,查询点通过特征插值、稠密相关和局部精化得到另一张图中的亚像素坐标。
整个流程分四步:
- 特征提取:冻结的预训练 CNN 提取稠密特征,多层融合为 stride 8 的粗 token 网格。
- 上下文聚合: 层相同的 Transformer,自注意力 + 交叉注意力更新两张图的 token;每层附带一个共视头,非共视对提前停止。
- 对应点读出:对每个查询点,插值取出它的 token,和另一张图所有 token 做相关,用窗口化的 soft-argmax 读出亚像素坐标 、置信度 和可匹配性 。
- 局部精化:一个小 MLP 预测亚格偏移。
下面逐一展开。
2.2 粗匹配:在固定网格上聚合上下文
骨干网络用 ConvNeXt-B,权重来自 DINOv3 的蒸馏版本[20, 21],训练全程冻结。作者引用 RoMa 的观察:冻结的基础模型特征能减少对训练数据的过拟合、提升鲁棒性,同时训练更便宜。四个 stage 的特征都重采样到 stride 8,线性投影成初始 token 网格 ,其中 ,每个 token 对应一个归一化坐标 。
Transformer 共 层,内部维度 512。每层先做图内自注意力,再做跨图交叉注意力:
- 自注意力用 token 坐标的旋转位置编码(RoPE)[22]编码相对位置,和 LightGlue 一样;
- 交叉注意力不加位置编码,这样匹配对两张图之间的任意几何变换都是等变的。
对比 LightGlue 这类稀疏匹配器:它们只在关键点位置上聚合上下文,即便像 OmniGlue 那样引入基础模型特征[23],在无纹理或重复区域仍然缺少全局理解。FlexGlue 在一个与关键点无关的均匀网格上聚合,关键点只是读出时的查询。这是它在 ScanNet 这类室内场景上大幅领先的直接原因。
2.3 对应点读出:窗口化的 soft-argmax
这是方法里最值得细看的一步。对查询关键点 ,从最后一层的 token 网格里插值出它的特征,再用一个线性层 降维到 64 维得到描述子 。 在两张图之间共享,既降低稠密相关的计算量,也保持匹配是对称的。接着算它与另一张图所有 token 的余弦相似度 ,取最近邻格子 ,然后:
其中 是 的 邻域, 是格子中心, 是每层独立学习的温度。也就是说:先在全图做 softmax,再只在最近邻的 窗口里重新归一化取期望。两个极端都不好:
- 全局期望(像 soft-argmax 那样对全图加权平均)在深度不连续处会把两个竞争峰平均成一个落在中间的点;
- 硬最近邻则把对应点量化到格子中心,精度只有 stride 8。
窗口化期望是两者之间几乎零成本的折中。训练时让 逼近真值对应点在周围四个格子上的双线性权重,这样网络学会从上下文里「插值」,期望恰好能还原亚格精度。
实践中 softmax 换成了 1.5-entmax[24, 25],交叉熵换成对应的 entmax 损失。entmax 会给不太可能的格子精确地分配零概率,消融(表 7)显示这是对鲁棒性影响最大的一项:换回 softmax,HardMatch 的 mAA 从 56.4 掉到 48.6。
下面的部件模拟这一步:一个 的 token 网格,相似度由一个真值峰和一个可调的干扰峰组成。拖动真值位置和温度,切换 softmax / entmax,看窗口化期望(实心点)和全局期望(空心点)离真值(十字)各有多远。网格一格对应原图 8 px。
实心圆:3×3 窗口内归一化的期望;空心圆:全图期望;十字:真值。颜色深浅是每个格子的概率 Pij,虚线框是最近邻格子的窗口。
把温度调大、干扰峰调强,再切到 softmax,全局期望会明显被拉偏,而窗口化期望几乎不受影响,这就是论文说的「在深度不连续处避免全局期望在竞争候选间取平均」。注意这个玩具里相似度是高斯形状,不是训练出来的双线性权重,所以即使没有干扰,窗口化期望也有零点几像素的误差;真实网络是直接用双线性权重监督的,理论上可以精确还原。
可匹配性:每个查询插值出的 token 再过一个线性分类头,得到该点在另一张图里是否可见的得分 ,覆盖遮挡和出视野的情况。对应点的置信度定义为 ,即可匹配性乘以窗口内的概率质量。和稀疏匹配器相比,均匀的 token 网格不受局部特征密度的偏置,也不需要学「可重复性」这个检测器带来的副产物。
2.4 局部精化
粗读出已经把 80% 以上的查询放到了真值 2 px 以内,剩下的误差是局部的。作者没有像稠密匹配器那样再加一个细尺度 CNN,而是沿用 EDM 的做法[11]:把当前层在 和 两处插值出的 token 拼起来,送进一个小 MLP 预测亚格偏移 。MLP 把每个轴上 格的范围分成 16 个 bin 做分类,取期望得到偏移,。这只需要两次插值和一个 MLP,代价随查询数线性增长。精化时对粗坐标 stop-gradient,用鲁棒损失监督精化后的位置。实测它平均只把对应点移动 0.6 px,说明它修正的是残余的亚像素误差,不会推翻粗匹配。
2.5 视觉消歧:每层投票,尽早退出
机制非常轻:一个线性层 加 sigmoid,把 和 的每个 token 映射成一票共视性 ,整对图像的得分是所有票的平均
逐 token 投票而不是先池化再分类,能提供稠密的监督信号,也要求所有 token 对这对图像的标签达成一致。这个得分在每一层都有监督,于是推理时可以在第 层之后就停下来,只要
其中 是图像对阈值, 是衰减系数:越浅的层阈值越低,只在非常确定的非共视对上提前退出。默认 ,。这和 LightGlue 的自适应深度正好相反[3]:LightGlue 在容易的共视对上提前退出,在不可匹配的对上反而要跑完整个网络;FlexGlue 在不可匹配的对上最早退出,而这恰恰是 SfM 里穷举配对时数量最多的一类。
下面的部件画出 9 层的退出阈值曲线和三条典型的得分轨迹。拖动 和 ,看每条轨迹在第几层退出。把 拉到 1,你会看到为什么必须要衰减。
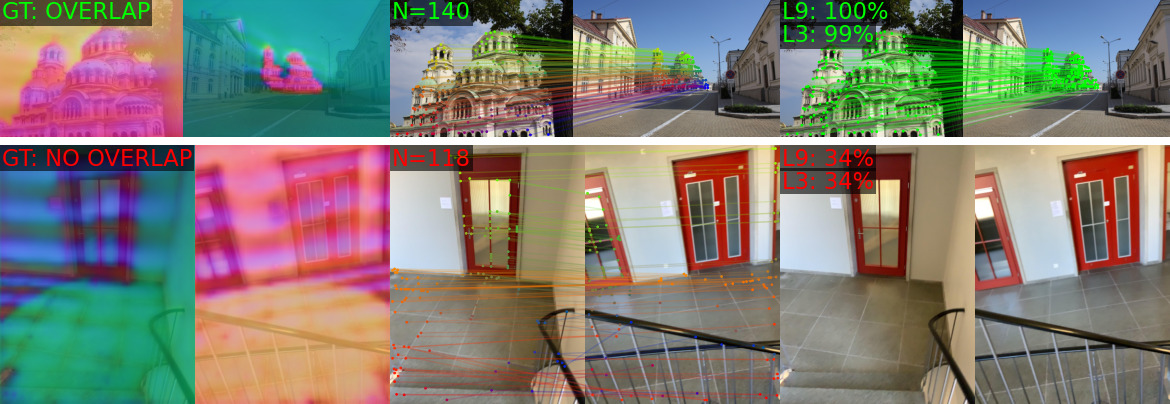 图 3:左为学到的特征的 PCA 可视化,中为过滤前的对应点,右上角是第 3 层和第 9 层的共视得分。上:共视对,两层分别给出 99% 和 100%;下:doppelganger,早在第 3 层就被判定为非共视并停止匹配。注意上排 PCA 图里共视区域被清晰地高亮出来。
论文强调这一设计的协同效应:稠密的上下文聚合已经建立了对整个图像对的全局理解,所以一个线性层的共视头就足以超过专用的消歧模型;反过来,消融(表 8)显示去掉匹配损失、只训练共视性,AUROC 最多掉 9.3 分,说明匹配监督也在帮消歧泛化。
2.6 监督
训练时不用检测器:在每个 的格子里随机采一个带随机亚格偏移的查询点。这样网络从不绑定某个特定检测器,测试时可以随意换(附录表 9 里 SuperPoint、DaD、RaCo 三种关键点[26, 27, 28]在两视图匹配上表现相当,RaCo 在 SfM 上最好)。
四项损失:
- : 对真值对应点周围四个格子双线性权重 的交叉熵,实际用 1.5-entmax 对应的 Fenchel–Young 损失,最优解都是 ,此时公式 (1) 精确还原真值。作者特别提到不能在 log 空间里插值(即最小化 ),那样会把所有质量压到最近的一个格子上,丢掉亚格监督。
- :精化偏移的广义 Charbonnier 损失[29](, px),只对真值落在 格范围内的查询生效。
- :可匹配性的平衡二分类交叉熵,标签是该点在另一张图里是否可见。
- :逐 token 共视投票的平衡二分类交叉熵,标签是图像对级别的。
每层的总损失是 , 层全部做深度监督(这正是提前退出的前提)。前两项只作用于在另一张图里可见的查询,非共视对上自然为零。
2.7 三种匹配模式
推理时根据查询不同,同一个模型有三种用法。所有模式都丢弃置信度 的对应,以及循环误差超过 3 px 的对应(把 反向查回去,落点离 超过 3 px)。
-
稀疏到稠密:每个查询关键点配上它预测的对应点。两边都有关键点时,把两个方向的对应拼起来。
-
稀疏(稀疏到稀疏):SfM 需要关键点之间的离散分配。定义对称距离
取 上的互最近邻且 px、 高于阈值的关键点对。
-
稠密:没有关键点时,从两张图的稠密预测里按置信度采最多 5k 个对应。
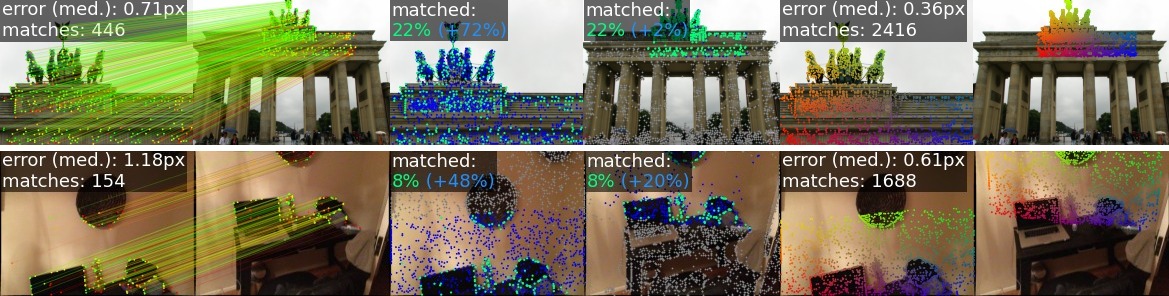 图 8:左:稀疏到稀疏的匹配,按对极误差着色(绿色 < 1 px);中:关键点按「能否稀疏到稀疏地匹配上」着色,绿色能,蓝色只能稀疏到稠密地匹配,直观展示了可重复性问题;右:稀疏到稠密的对应。大尺度变化和弱纹理区域下,稀疏到稠密能给出多得多且更准的对应(上排 446 → 2416 个匹配,中位误差 0.71 → 0.36 px)。
2.8 LaMAR-DG:室内 doppelganger 基准
现有消歧基准(Doppelgangers、ViSym)[17, 18]全是室外。室内有自己的难点:同一栋楼的不同楼层或走廊往往几乎一样,视觉多样性低、纹理重复、光照难、场景深度小,可用的线索更少。作者在 LaMAR 的 CAB、HGE、LIN 三个大场景上构建基准:用 mesh 渲染深度,按真值位姿重投影算每对图像的重叠率,双向重叠在 10% 到 80% 之间为正样本,为零则为负。负样本用 MegaLoc 检索挖掘[30]:在 50 个最近邻里选相似度最高且不重叠的那个(相似度 > 0.3),这模拟了真实 SfM 流程中「先检索再匹配」的候选对。每个场景 1000 对,正负各半,正样本里既有高相似度的也有重叠很低的,后者对回环闭合至关重要。
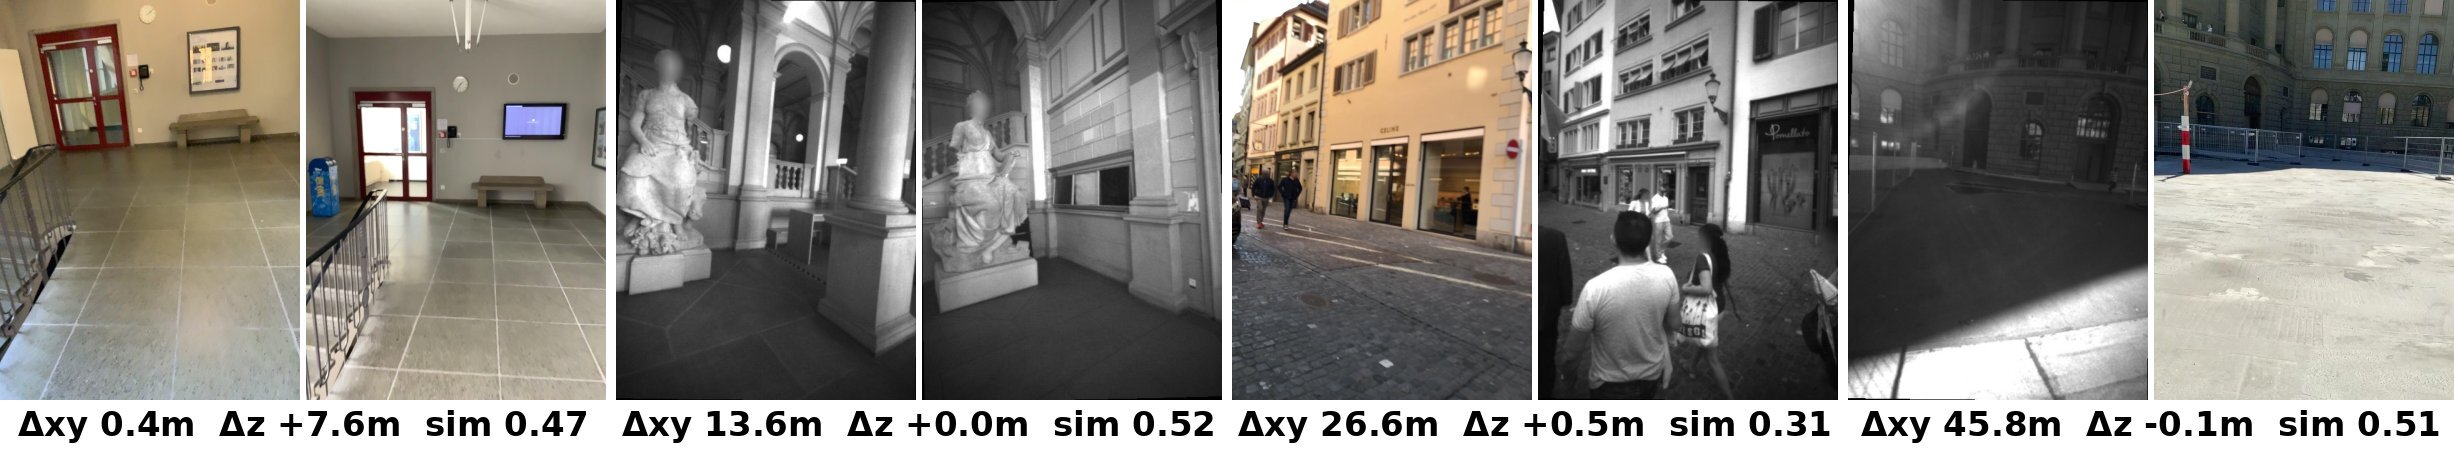 图 4:LaMAR-DG 的难负样本,从左到右为不同楼层(CAB)、室内(HGE)、室外(HGE)和跨设备(LIN)。它们检索相似度都很高,但没有任何重叠。Δxy 和 Δz 是两个相机的水平和垂直距离。
室内难负样本难以大规模收集(没有 GPS 可以用来找「相似但不同的地方」),所以所有方法都是零样本评测。
三、实验结果
3.1 训练设置
八个数据集联合训练:MegaDepth、AerialMegaDepth、BlendedMVS、ScanNet++、Hypersim、Map-free、DL3DV 和 TartanAir(MapAnything 划分)[31],按场景平衡采样,图像对的重叠率在 。图像缩放到 ,每轮 15 万样本,50 轮,4 张 H200 约 4 GPU-day(开梯度检查点可以在 4 张 RTX 4090 上 1.5 天训完)。学习率 保持 5 轮后衰减到 。最后 10 轮微调加入连续旋转和透视增强,并混入 Doppelgangers 数据(正负各半)和翻转增强生成的难负样本:把一对里的一张水平翻转,就得到一个结构相似但不可匹配的负样本,完全不需要标注。
3.2 相对位姿估计
标准设定:MegaDepth-1500(室外)、ScanNet-1500(室内),加上 HardMatch(极端外观变化)[32]。三类方法分别比较:稀疏(4096 个关键点)、稠密(无关键点)、稀疏到稠密(2048 个关键点)。
下面的部件把论文里表 1、3、4、6 的数据做成可以切换的横向条形图,FlexGlue 的条用主题色标出。
几个值得注意的结论:
- 稀疏设定下 FlexGlue 和 LoMa 相当,但在 ScanNet 上明显领先,证明在网格上聚合上下文比在关键点上聚合更有效,尤其是室内。
- 稀疏到稠密设定下和 RoMa v2 竞争,但快得多(匹配 28.7 ms 对 63.2 ms,提取 31 ms 对 53 ms)。
- 稠密对应在相对位姿上总是优于稀疏到稀疏,但在 HardMatch 上不够鲁棒;稀疏到稠密取了中间地带,FlexGlue 在 HardMatch 上最好。
3.3 跨域两视图估计
七个不同领域的基准,用各方法的默认设置。FlexGlue 用 2048 个 DaD 关键点做稀疏到稠密匹配[27],稀疏基线是 ALIKED + LightGlue[33, 3]。
| 方法 | HPatches 3px | 5px | 10px | WxBS mAA@10px | RUBIK 10° | 20° | succ. | IMC22 mAA | TerraSky3D 10° | 20° | EarthMatch % loc. | SatAst 10px |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ALIKED + LG | 66.2 | 76.9 | 86.3 | 43.9 | 52.8 | 59.1 | 39.0 | 79.2 | 25.3 | 29.4 | 84.0 | 18.4 |
| LoMa-G | 66.4 | 77.5 | 87.3 | 73.4 | 73.1 | 79.8 | 47.6 | 89.8 | 53.4 | 61.6 | 98.0 | 24.4 |
| LoMa-R | 66.8 | 77.9 | 87.7 | 65.5 | 68.6 | 75.9 | 45.1 | 86.3 | 44.2 | 51.7 | 99.6 | 48.3 |
| RoMa v2 | 72.2 | 81.2 | 89.2 | 64.8 | 78.4 | 86.2 | 59.5 | 84.7 | 53.9 | 62.9 | 92.2 | 38.1 |
| FlexGlue | 72.9 | 81.9 | 89.8 | 72.6 | 81.9 | 88.3 | 58.7 | 87.0 | 56.9 | 67.7 | 99.2 | 48.8 |
| FlexGlue (640 px) | 72.9 | 82.0 | 89.9 | 73.7 | 83.2 | 89.2 | 59.5 | 88.5 | 62.0 | 72.4 | 99.6 | 60.8 |
除 IMC22 外全部最好,航拍(TerraSky3D 地面对无人机、EarthMatch / SatAst 航天员照片对卫星图)上提升最大,甚至超过了旋转不变的 LoMa-R。把输入分辨率从 512 提到 640 px 还能稳定涨点;再接 RoMa v2 精化,SatAst 到 67.3、TerraSky3D 到 66.6。
3.4 视觉消歧
三个基准:Doppelgangers(训练分布内)、ViSym-F 和 LaMAR-DG。上面的部件里可以切到表 3。核心结论:在分布内 FlexGlue 和 DG++ 持平;在域外两个基准上大幅领先,LaMAR 上 AUROC 高出 10 分以上,速度快 4 倍。完全不用人工标注的 doppelganger 对(只用匹配数据加翻转增强)就已经超过 DG++,说明匹配数据本身已经提供了消歧所需的大部分监督。
ViSym-F 值得多说一句:作者发现 ViSym 由 GPS 推导的标签噪声很大,常常把共视对标成负样本,在 ViSym 上训练反而让 DG++ 在 LaMAR 上从 78.6 掉到 73.3。他们手工重新标注了全部 3180 个测试对,改了 475 个标签,其中 418 个是负改正。
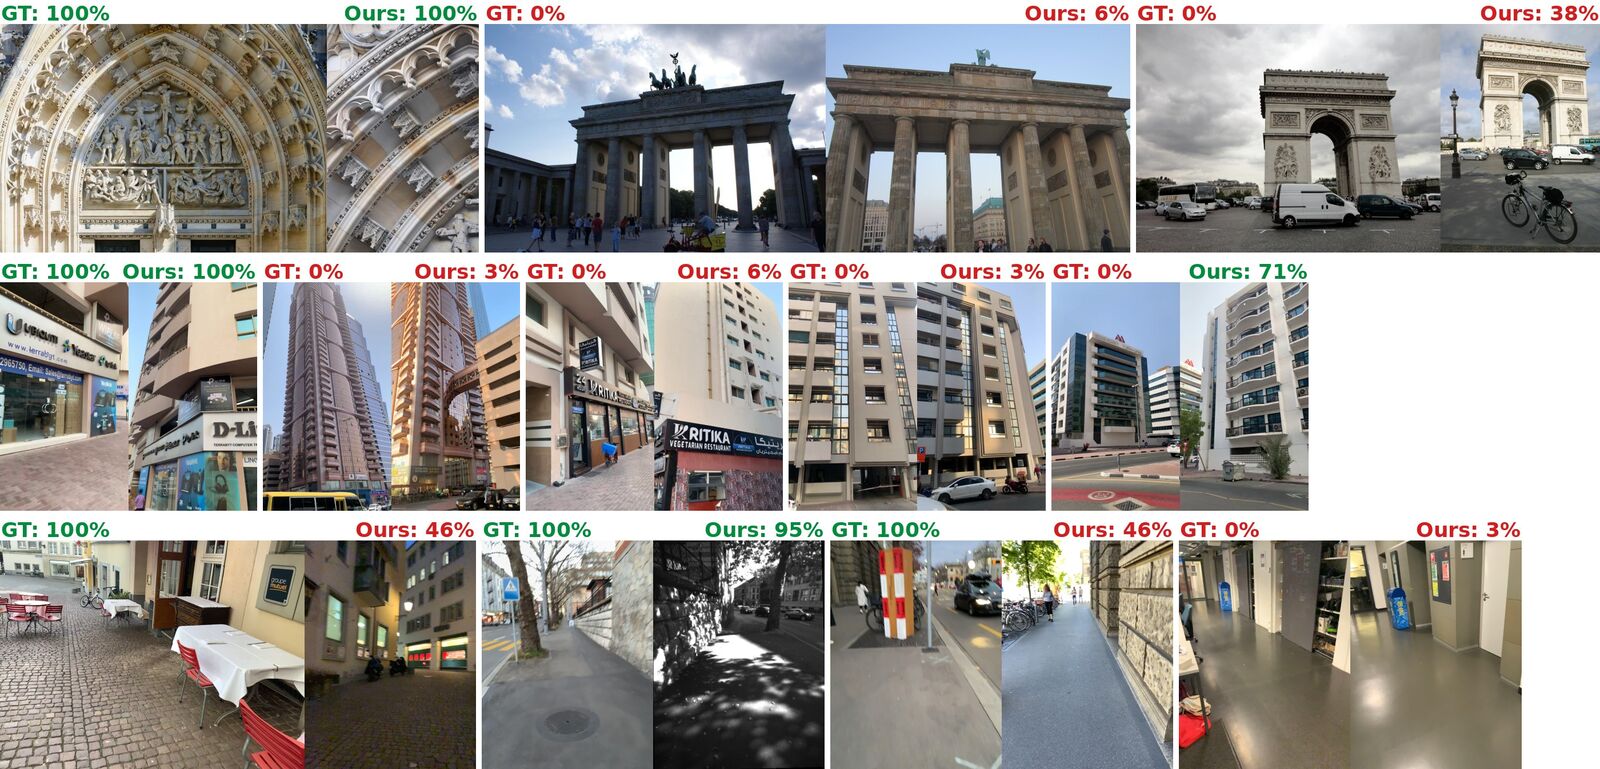 图 13:三个基准上的消歧示例,左上角是真值,右上角是 FlexGlue 的共视得分。它能分开布兰登堡门和凯旋门这类极难的对,也会在极端视角变化或缺少上下文时出错(中排最后一例把错误的立面判为 71%)。
3.5 多视图重建
ETH3D 25 个场景,hloc 穷举配对跑 COLMAP[34, 35, 36]。即使不做消歧,SuperPoint + FlexGlue 已经是最好的(AUC@3° 78.9 对 LoMa-B 的 77.6),所有深度匹配器在对称场景下都会崩;加上消歧后 FlexGlue 到 86.8,比 LoMa-B + DG++ 的 81.2 高 5.6 分,吞吐 30 对 4 pairs/s。早停把吞吐进一步提到 45,精度只损失不到 1 分。
IMC2025(CVPR 2025 图像匹配挑战赛)[37]要求从随机混杂的图像集合里聚类并重建多个场景,是匹配和消歧的联合考验。只用 4096 个 DaD 关键点,FlexGlue 的私榜 61.74 就超过了重度调参的 MASt3R 冠军方案(56.00);加上消歧到 66.04;换 10k 个关键点后在持续榜上拿到 74.07,比榜首高 8 分,而 LoMa 在同样预算下已经超出 Kaggle 的时间限制。
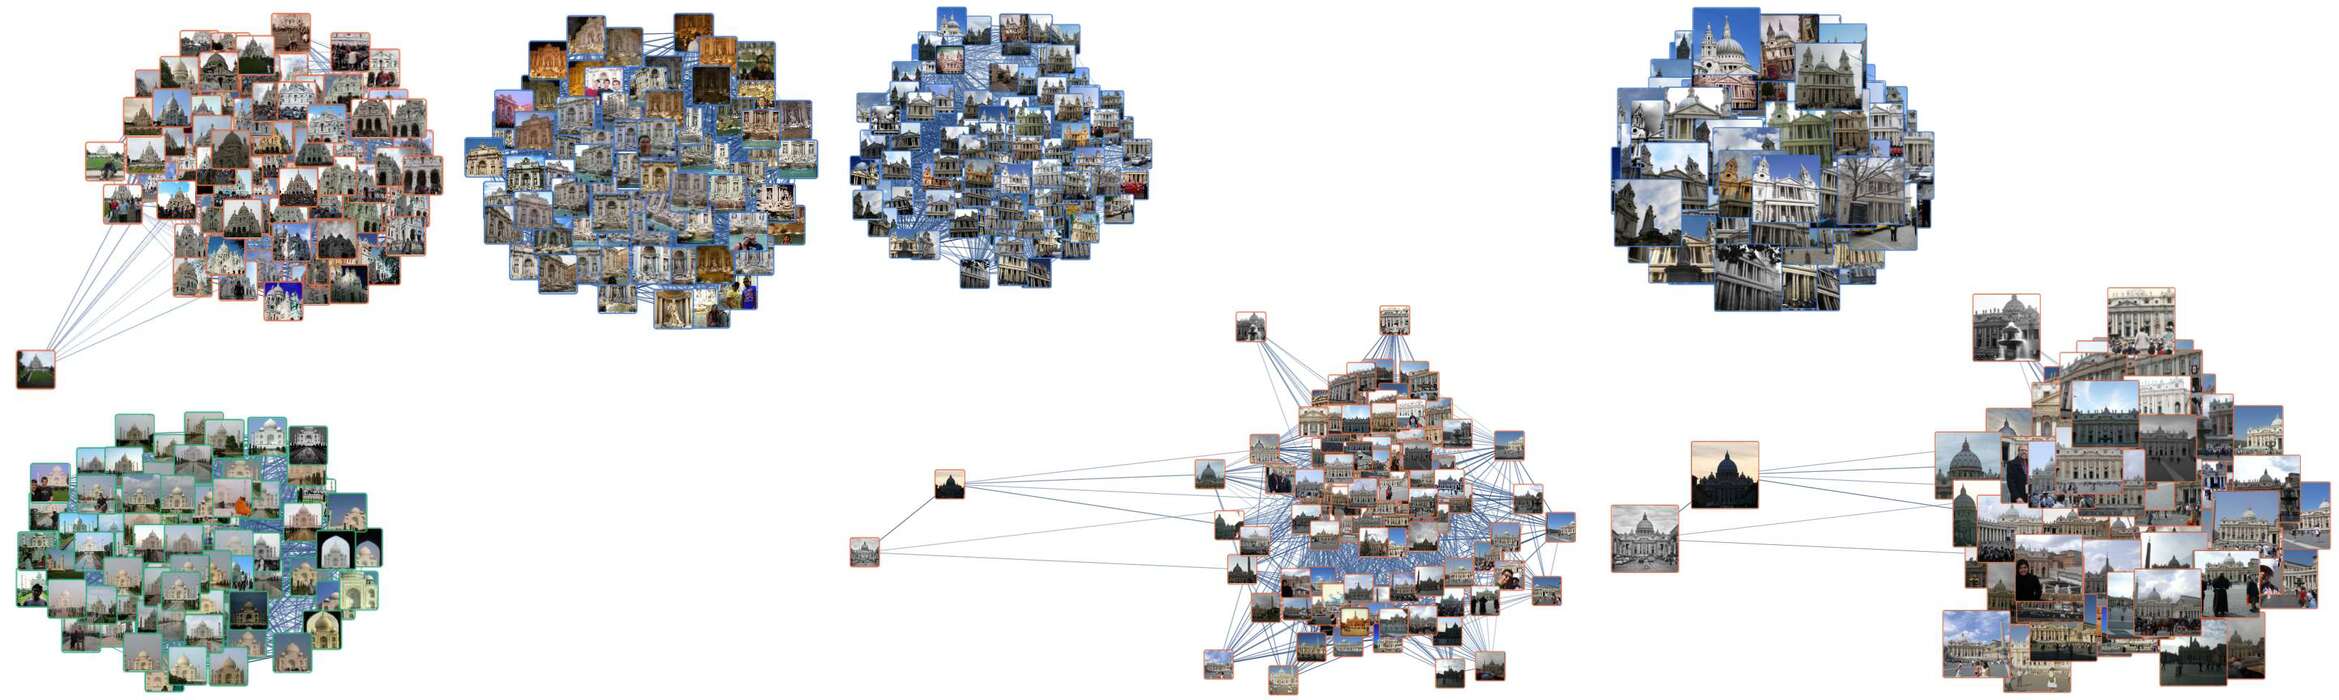 图 10:只用 FlexGlue 的共视得分恢复出的 IMC2025 图像图,颜色是预测的簇,边是保留的图像对。地标被分成干净的簇。
3.6 室内视觉定位
InLoc 按 hloc 协议[38]:检索 top-40 数据库图像,建立 2D-2D 对应,用数据库深度提升到 2D-3D,PnP 求绝对位姿。FlexGlue 用 stride 8 的网格点做查询。稠密方法历来在 InLoc 上优于稀疏方法(受关键点可重复性影响小),FlexGlue 在 6 个阈值里 5 个最好(DUC2 @0.25m 77.9 对 RoMa v2 的 73.3),吞吐 32 pairs/s 对 RoMa v2 的 8。
3.7 消融与运行时间
匹配消融(表 7,SuperPoint 查询):
| 变体 | HardMatch mAA@10px | PCK@1px | 匹配 ms |
|---|---|---|---|
| 完整模型 | 56.4 | 61.0 | 28.7 |
| 只用 3 层 | 49.9 | 39.3 | 16.6 |
| 去掉精化头 | 55.5 | 53.8 | 27.0 |
| 去掉窗口化 soft-argmax | 52.8 | 59.1 | 26.8 |
| 不做消歧微调 | 54.8 | 62.0 | 28.7 |
| softmax 代替 entmax | 48.6 | 55.5 | 27.6 |
| 加 RoMa v2 精化 | 57.2 | 64.0 | 46.8 |
| RoMa v2 | 49.0 | 65.6 | 63.2 |
| RoMa v2 去掉精化 | 41.6 | 26.3 | 39.1 |
entmax 对鲁棒性最重要,窗口化读出主要提升鲁棒性,精化头主要提升亚像素精度(PCK@1px 从 53.8 到 61.0)而几乎不花时间。最有意思的是最后两行:RoMa v2 去掉稠密精化后 PCK@1px 只有 26.3,它的粗匹配本身是不准的;FlexGlue 的粗读出已经有 53.8,所以可以用一个很轻的精化头。
消歧消融(表 8):只用 3 层 AUROC 几乎不掉(ViSym-F 93.4 对 95.9),不加匹配损失 LaMAR 从 88.8 掉到 79.5,去掉 DG 数据只掉零点几,加 NaverLabs 挖掘的室内负样本则到 97.4 / 92.3。
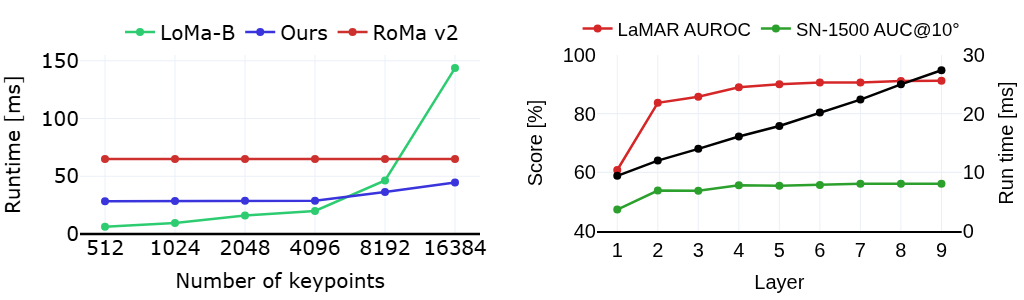 图 5:左:RTX 4090 上匹配时间随关键点数的变化。RoMa v2 与关键点数无关但开销大,LoMa 很快但随关键点数平方增长,FlexGlue 线性增长。右:匹配精度(ScanNet AUC@10°)和消歧精度(LaMAR AUROC)随层数的变化,运行时间(黑线)随层数线性增长。消歧很早就学好了,匹配精度持续到第 9 层。
下面这个部件按图 5 粗略拟合了三条曲线。拖动关键点数,看三种方法的代价怎么变。SfM 里为了重建完整通常会用 4k 到 10k 个关键点,这正是曲线分开的区间。
显存方面,FlexGlue 提取加匹配约 1.2 GB(只匹配 0.7 GB),LoMa-B 2.4 GB,LoMa-G 3.8 GB。
3.8 定性结果
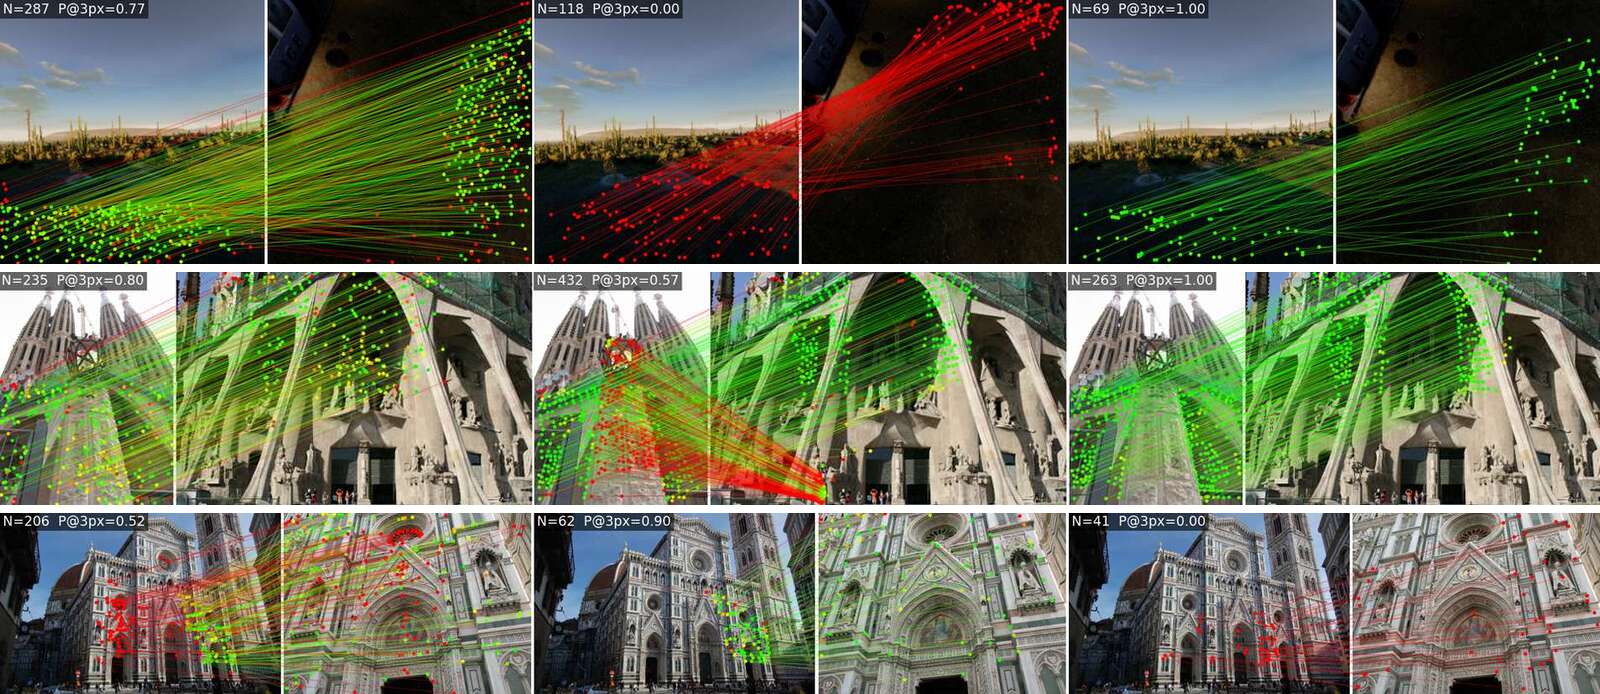 图 14 节选:从上到下为 TartanAir、MegaDepth 和一个失败案例。每行三组分别是 LoMa-G、SuperPoint + RoMa v2、SuperPoint + FlexGlue,按重投影误差着色(绿色 < 3 px)。TartanAir 的树林里 RoMa v2 几乎全错,FlexGlue 几乎全对;最后一行的重复立面上 FlexGlue 匹配到了错误的实例,RoMa v2 反而对了。
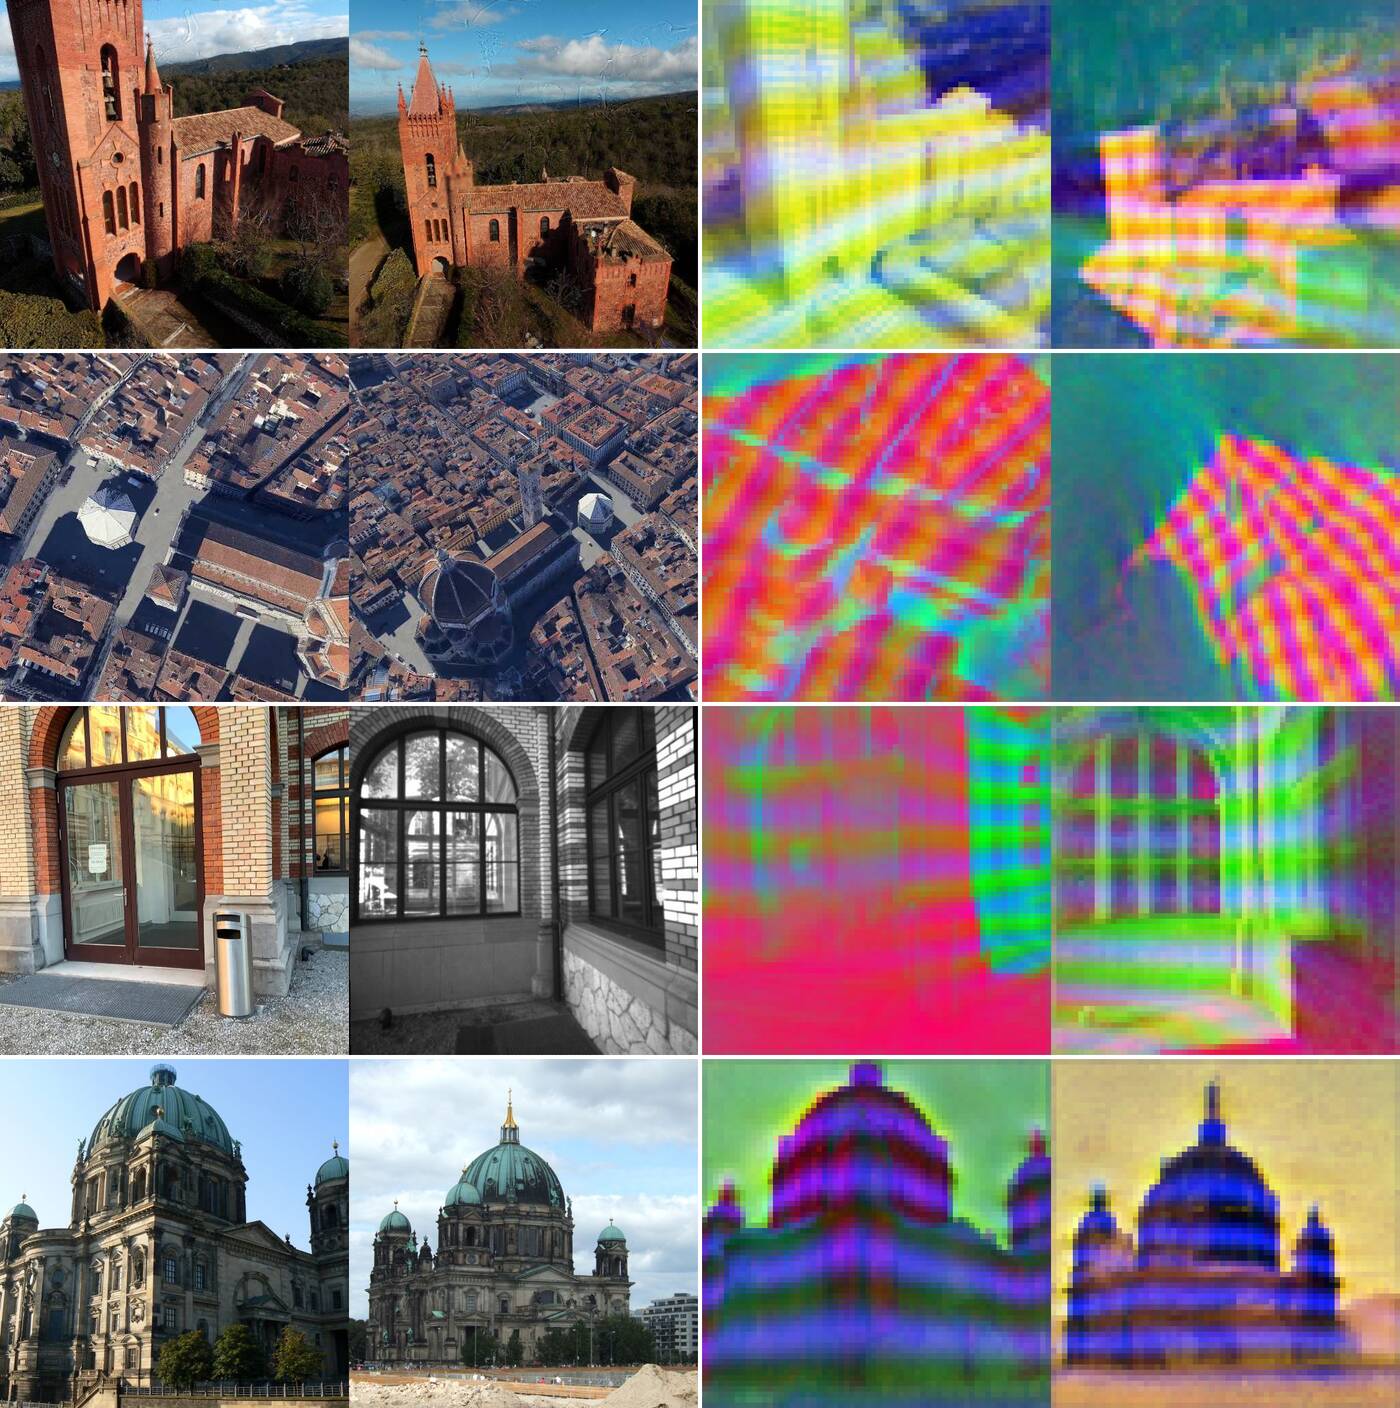 图 9 节选:第 9 层 token 前三个主成分映射为 RGB。网络学到了水平和垂直线、透视、平面性这些结构先验,并且清楚地高亮出共视区域(第三行左图的室内无法与右图的室外对应,颜色完全不同)。
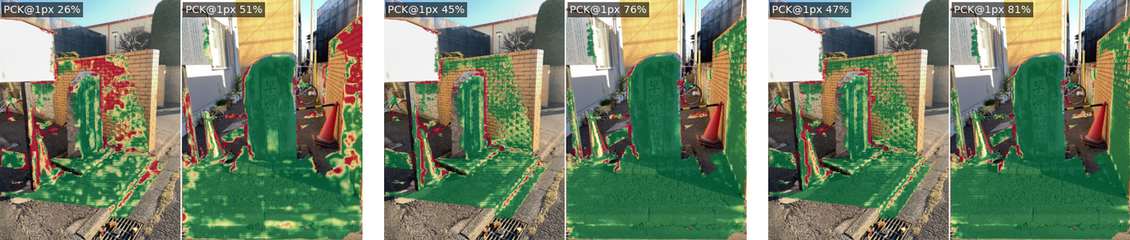 图 12 节选:3、6、9 层后未经过滤的稠密对应,按误差着色。尽管只用稀疏查询监督,FlexGlue 也能给出相当准确的稠密对应;更深的层主要在修正深度不连续处的错误。
四、局限性
作者在附录里列了四条,都挺坦诚:
- 误差相关:不同查询的误差是相关的,因为它们都来自同一个粗网格上学出来的插值。精度虽高,但相对位姿估计假设各点误差独立,相关的误差会损害位姿精度。而且大部分误差沿着对极线(验证集 PCK@1px 61.0,但对极精度 @1px 有 88.4),说明网络学到了某种对极几何先验,而这个先验可能有噪声。
- 精细精度:在简单的图像对上 RoMa v2 的稠密精化器仍然更准。更强的精化模型,或者一个用更细特征的专用稀疏到稠密精化器,应该还有提升空间。
- 交叉注意力在深层变得局部:粗注意力在后面几层改善不多,交叉注意力的范围在深处非常局部。这也许意味着层数可以进一步压缩,或者后面几层应该换成别的结构。
- 深度不连续处精度下降:网络被迫插值,在深度跳变处 PCK@5px 从 90% 以上掉到 75% 左右。原因是双峰分布(落到不连续的错误一侧),查询侧粗特征的插值也会把对应点带到错误一侧。窗口化读出在目标侧部分缓解了这个问题,查询侧仍需更细的特征。
我自己再补几条:
- 消歧的失败模式(图 13 中排):缺少上下文、或者极端视角变化时,共视得分可能给出 40% 到 70% 这种模棱两可的数值,SfM 流程里怎么设阈值仍然需要经验。
- 多视图一致性:消歧是逐对判断的,图 10 底部那个漏网的错误对说明单对判断最终还是要配合视图图层面的推理(比如 VidMap 那种时序约束[39],或者传统的 view-graph 过滤)。
- 骨干网络协议:代码 MIT,但 DINOv3 ConvNeXt-B 的权重受 DINOv3 协议约束,商用前需要看清楚。
- 训练代码未放出(计划放进 glue-factory)[40],COLMAP 和 hloc 的集成也还在待办列表里。
五、结论与展望
FlexGlue 的故事线其实很清楚:LightGlue 把稀疏匹配做到了极致的快,但检测器的可重复性和定位噪声是它的天花板;RoMa 系列用稠密匹配突破了天花板,但代价是为每个像素买单。FlexGlue 的答案是把两者的分工拆开[1]:上下文聚合在固定的粗网格上做,花固定的钱;对应点读出只在需要的查询上做,花线性的钱。再加上「匹配和消歧本来就是一件事」的观察,一个线性层的共视头就同时解决了 SfM 最头疼的 doppelganger 问题,还顺带把最常见的非共视对变成了最便宜的那一类。
从结果看,它在 ETH3D、IMC2025 两个多视图基准、所有消歧基准(尤其是新的室内 LaMAR-DG)、InLoc 和 HardMatch 上都是最好的,同时保持了接近稀疏匹配器的效率。对实践者来说,有几个很实用的点:
- 关键点只是查询,训练时不绑定检测器,推理时可以换任意检测器甚至直接用网格点。
min_covisibility和early_stop_decay两个参数就能在 SfM 的穷举配对里省掉大部分计算。- 分辨率从 512 提到 640 稳定涨点,预算够的时候值得开。
refine=True会接上 RoMa v2 的精化器,在简单场景里换取更高的亚像素精度。
往后看,论文留下的几个方向都挺自然:更细特征的精化器修复深度不连续处的误差;把逐对的共视判断扩展到多视图的视图图推理;既然交叉注意力在深层已经很局部,也许还能继续压缩层数。另一个值得期待的是它和 MASt3R / MapAnything 这一类前馈 3D 重建模型的关系:FlexGlue 用 MapAnything 的 TartanAir 划分训练,而 IMC2025 上它又超过了 MASt3R-SfM 的冠军方案,匹配器和前馈重建器之间的边界会怎么演变,是接下来一两年最有意思的问题之一。
六、上手
git clone https://github.com/cvg/FlexGlue.git && cd FlexGlue
python -m pip install -e .
检测器沿用 LightGlue 仓库里的实现,注意 FlexGlue 要求关键点使用角点坐标系(origin="corner"):
from lightglue import ALIKED
from flexglue import FlexGlue
from flexglue.utils import load_image, pack_matches, rbd

image0 = load_image("assets/berlin1.jpg").cuda()
image1 = load_image("assets/berlin2.jpg").cuda()
inputs0, inputs1 = {"image": image0[None]}, {"image": image1[None]}

detector = ALIKED(origin="corner", max_num_keypoints=2048).eval().cuda()  # 可选
inputs0.update(detector.extract(image0))
inputs1.update(detector.extract(image1))

matcher = FlexGlue().eval().cuda()
matches01 = rbd(pack_matches(matcher.match(inputs0, inputs1)))
matches = matches01["matches"]
points0 = matches01["keypoints0"][matches[..., 0]]
points1 = matches01["keypoints1"][matches[..., 1]]几个开关对应论文里的模式:不传关键点就是稠密模式;只有一边有关键点就是稀疏到稠密;两边都有时默认拼接两个方向,sparse=True 返回互最近邻;match_dense 返回稠密对应网格;refine=True 接 RoMa v2 精化器;describe_resize=640 提高分辨率;min_covisibility 和 early_stop_decay 对应 和 ;n_layers 可以牺牲精度换速度。支持 batch 推理、torch.compile 和 torch.hub 加载。权重 flexglue.pth 会自动下载,其中 DINOv3 骨干受 DINOv3 协议约束,其余部分为 MIT。
参考
- Lindenberger, Sarlin, Miksik, Pollefeys. FlexGlue: Sparse-to-Dense Feature Matching and Visual Disambiguation. arXiv 2610.32976, 2026. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Nordström, Edstedt, et al. LoMa: Local Feature Matching Revisited. ECCV 2026. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Nordström, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Zhang, Keetha, et al. UFM: A Simple Path towards Unified Dense Correspondence with Flow. NeurIPS 2025. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Li, Rao, Pan. EDM: Efficient Deep Feature Matching. ICCV 2025. arXiv · 代码
- Germain, Bourmaud, Lepetit. S2DNet: Learning Accurate Correspondences for Sparse-to-Dense Feature Matching. ECCV 2020. arXiv
- Wang, Zhou, Hariharan, Snavely. Learning Feature Descriptors using Camera Pose Supervision (CAPS). ECCV 2020. arXiv · 代码
- Jiang, Trulls, Hosang, Tagliasacchi, Yi. COTR: Correspondence Transformer for Matching Across Images. ICCV 2021. arXiv · 代码
- Lu, Du. Raising the Ceiling: Conflict-Free Local Feature Matching with Dynamic View Switching (RCM). ECCV 2024. arXiv
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints (SIFT). IJCV 2004. DOI
- Cai, Tung, Wang, Averbuch-Elor, Hariharan, Snavely. Doppelgangers: Learning to Disambiguate Images of Similar Structures. ICCV 2023. arXiv · 代码
- Xiangli, Cai, Chen, Byrne, Snavely. Doppelgangers++: Improved Visual Disambiguation with Geometric 3D Features (含 ViSym 数据集). CVPR 2025. arXiv
- Sarlin, Dusmanu, Schönberger, et al. LaMAR: Benchmarking Localization and Mapping for Augmented Reality. ECCV 2022. arXiv · 代码
- Liu, Mao, Wu, Feichtenhofer, Darrell, Xie. A ConvNet for the 2020s (ConvNeXt). CVPR 2022. arXiv · 代码
- Siméoni, Vo, Seitzer, et al. DINOv3. arXiv 2508.10104, 2025. arXiv · 代码
- Su, Lu, Pan, Wen, Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 2024. arXiv
- Jiang, Karpur, Cao, Huang, Araujo. OmniGlue: Generalizable Feature Matching with Foundation Model Guidance. CVPR 2024. arXiv · 代码
- Peters, Niculae, Martins. Sparse Sequence-to-Sequence Models (α-entmax). ACL 2019. arXiv · 代码
- Blondel, Martins, Niculae. Learning with Fenchel-Young Losses. JMLR 2020. arXiv
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPRW 2018. arXiv · 代码
- Edstedt, Bökman, Wadenbäck, Felsberg. DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection. arXiv 2503.07347, 2025. arXiv · 代码
- Shenoi, Lindenberger, Sarlin, Pollefeys. RaCo: Ranking and Covariance for Practical Learned Keypoints. 3DV 2026. arXiv · 代码
- Barron. A General and Adaptive Robust Loss Function. CVPR 2019. arXiv
- Berton, Masone. MegaLoc: One Retrieval to Place Them All. CVPRW 2025. arXiv · 代码
- Keetha, Müller, Schönberger, et al. MapAnything: Universal Feed-Forward Metric 3D Reconstruction. 3DV 2026. arXiv · 代码
- Nordström, Edstedt, Kahl, Bökman. Who Handles Orientation? Investigating Invariance in Feature Matching (HardMatch 基准). CVPRW 2026. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE TIM 2023. arXiv · 代码
- Schöps, Schönberger, Galliani, et al. A Multi-view Stereo Benchmark with High-Resolution Images and Multi-camera Videos (ETH3D). CVPR 2017. 项目页
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale (hloc). CVPR 2019. arXiv · 代码
- Schönberger, Frahm. Structure-from-Motion Revisited (COLMAP). CVPR 2016. 项目页 · 代码
- Bellavia, Matas, Mishkin, et al. Image Matching Challenge 2025. Kaggle / CVPR 2025. 比赛页 · 持续榜
- Taira, Okutomi, Sattler, et al. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. CVPR 2018 / TPAMI 2019. arXiv
- Pataki, Sarlin, Pollefeys. VidMap: Exploiting Temporal Structure for Video-Based Structure-from-Motion. ECCV 2026. arXiv · 代码
- CVG, ETH Zurich. glue-factory: 局部特征匹配的训练与评测框架. GitHub. 代码