· 96 min read
论文解读:LoFTR,无检测器的 Transformer 半稠密匹配
TL;DR LoFTR 是无检测器匹配这条线上最有代表性的工作之一:它把「检测器」从匹配流程里彻底拿掉,还能在低纹理场景稳定工作[1]。它用 CNN 金字塔在 1/8 分辨率上提取粗特征,交给交替的 self/cross attention 做全局上下文交换,直接在两幅图的全部网格之间建立稠密匹配;再把高置信度的粗匹配送到 1/2 分辨率的 5×5 窗口里,用相关热图的期望值做亚像素细化。线性注意力把全局注意力的复杂度从 O(N²) 降到 O(N),让 640×480 的图像对能在 116 ms 内跑完。HPatches 单应估计 AUC@5px 75.6(SuperGlue 68.3),MegaDepth-1500 位姿 AUC@5° 52.8(SuperGlue 42.18),ScanNet-1500 22.06(SuperGlue 16.16)。代码 Apache 2.0 开源,四个预训练权重分别对应室内/室外与 dual-softmax/最优传输。
- 论文:LoFTR: Detector-Free Local Feature Matching with Transformers,Jiaming Sun、Zehong Shen、Yuang Wang、Hujun Bao、Xiaowei Zhou,浙江大学 CAD&CG 国家重点实验室 / 商汤科技,CVPR 2021。
- 代码:github.com/zju3dv/LoFTR,Apache 2.0;OT 分支依赖的 Sinkhorn 实现在 SuperGlue 仓库里,需要按 README 单独下载。
- 前作 / 预备知识:SuperPoint(检测器)、SuperGlue(本文的直接对照,也是 OT 损失的来源);后续对照:DKM、LightGlue、FlexGlue、LoMa。
一、动机:检测器本身就是瓶颈
局部特征匹配的经典流程是「检测—描述—匹配」三段式:先在两张图上各检测一批可重复的角点,再为每个点提取描述子,最后做最近邻或更复杂的匹配。检测器的作用是缩小搜索空间,让后续匹配只需要在几百到几千个点之间进行。大多数 3D 视觉任务也确实只需要稀疏对应,所以这套流程统治了很多年[2, 3]。
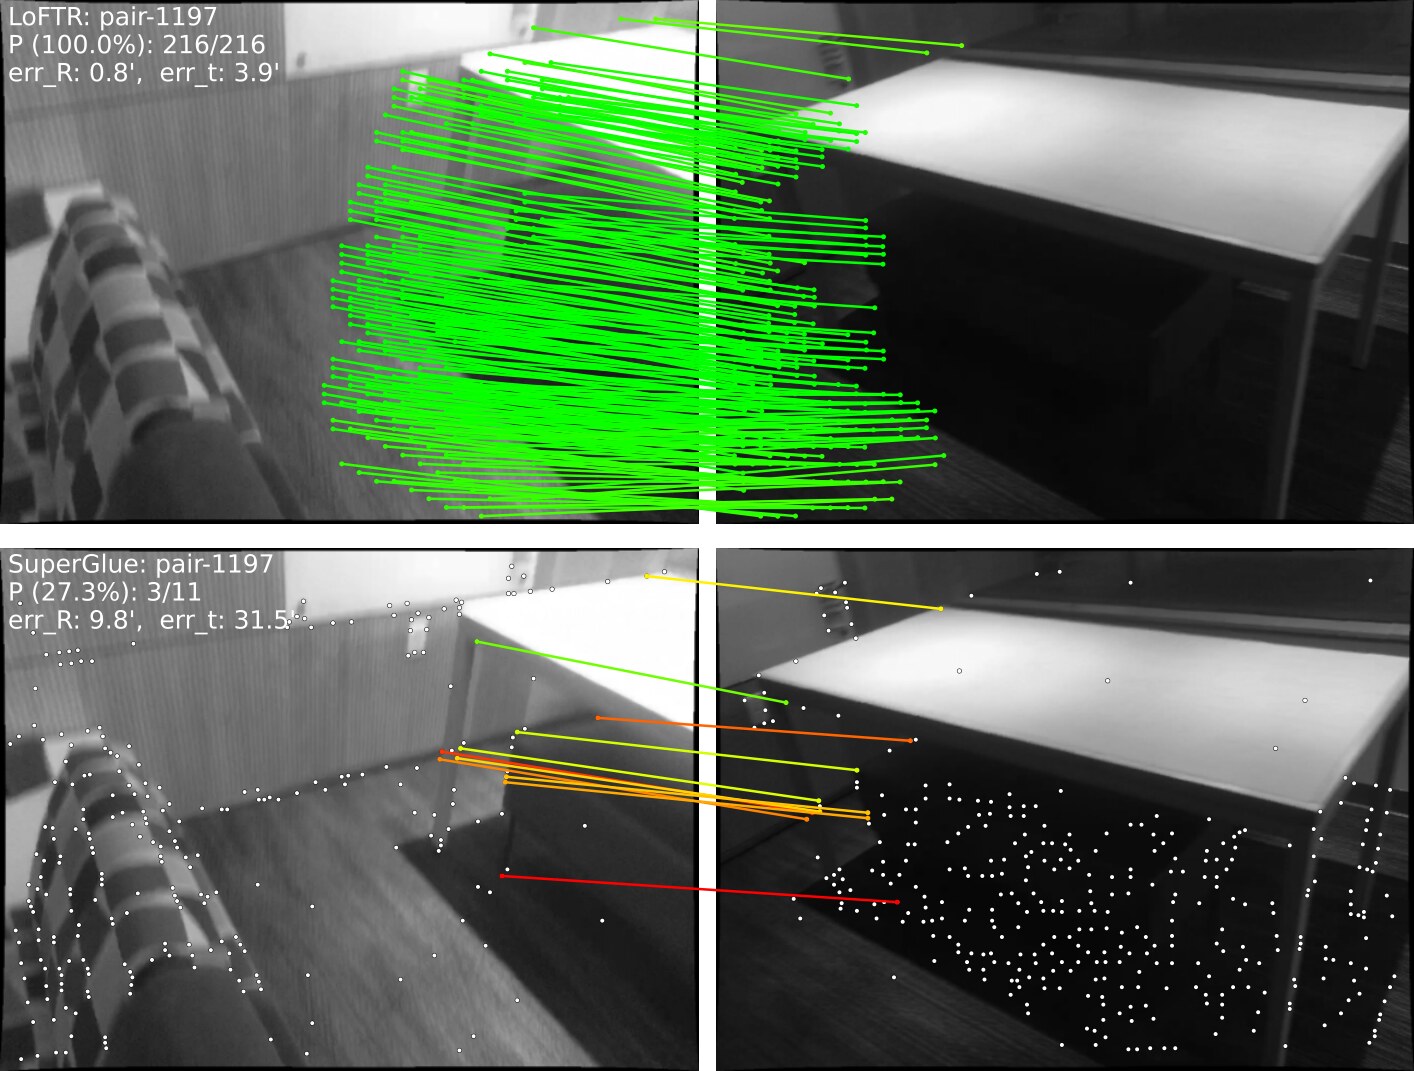
问题在于,检测器是整条链路里最脆弱的一环。低纹理的墙面、地板、天空,重复的窗格、瓷砖,剧烈的视角或光照变化,都会让检测器找不到跨图可重复的兴趣点;一旦检测不到,后面的描述子再好也无济于事。论文开篇的图 1 就是极端例子:同一间屋子里,SuperGlue 只给出 11 对匹配,其中只有 3 对正确;LoFTR 则在墙面和地板上给出 216 对,且全部是内点。
另一条路线是「无检测器」的稠密匹配。NCNet 用 4D 代价卷枚举所有像素对,再用 4D 卷积做邻域共识;Sparse-NCNet 用稀疏卷积降低开销;DRC-Net 进一步做由粗到细的稠密匹配[4, 5]。这些方法确实绕开了检测器,但它们的特征仍然来自局部 CNN,感受野有限。低纹理区域之所以难,不是因为没有纹理,而是因为判断这个点该匹配到哪里,需要比局部邻域更大的上下文:墙上的一个点,只有结合它和墙角、桌沿的相对位置才能确定身份。CNN 堆几层也覆盖不了整张图,4D 代价卷的邻域共识同样只在一个局部窗口里做。
LoFTR 的出发点就是把「全局上下文」这件事交给 Transformer。它保留 CNN 提取稠密特征,但用 self-attention 和 cross-attention 让每个位置都能看到另一张图的所有位置;然后在低分辨率(1/8)上建立稠密匹配,再把高置信度的匹配细化到 1/2 分辨率的亚像素。这样既不需要检测器,也不需要全分辨率的全局代价卷。论文把它叫作 detector-free local feature matching,但更准确的说法是半稠密匹配(semi-dense matching):粗层是稠密网格,最终输出的是经过置信度筛选的稀疏匹配。补充材料里作者提到,审稿人建议改名为 semi-dense,他们最终保留了 LoFTR 这个名字。
二、核心方法
2.1 总体架构:四步流水线
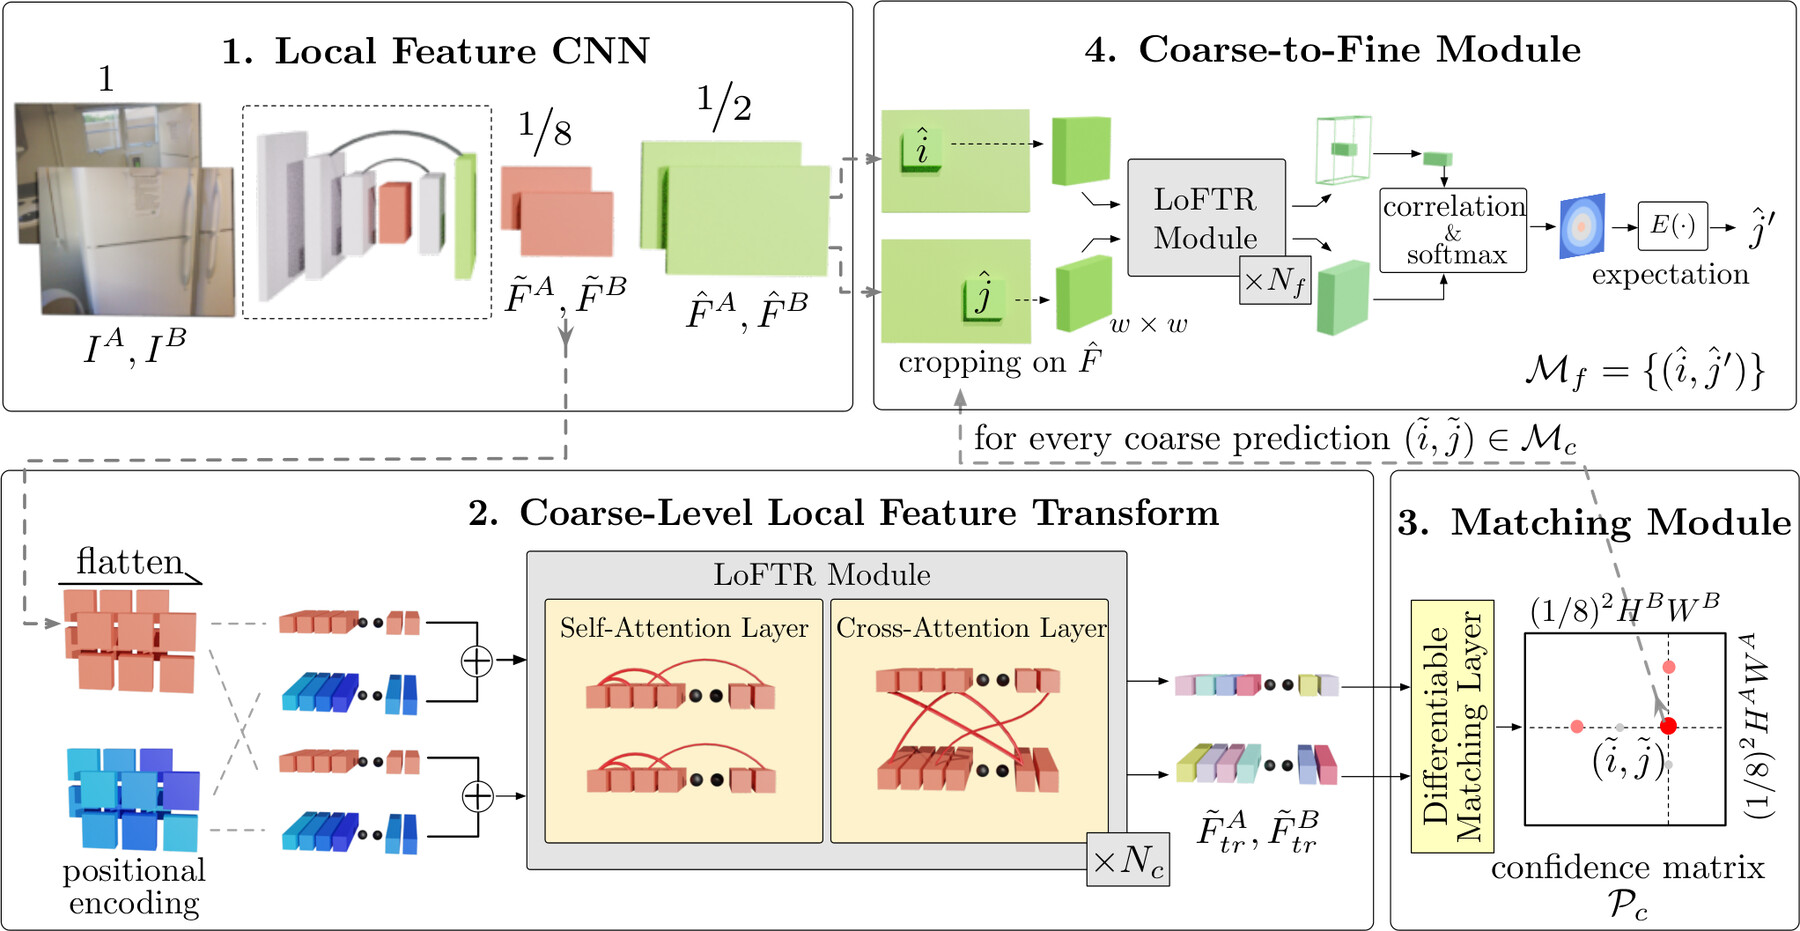
整个流程可以写成四步:
- 特征金字塔:修改版 ResNet-18 + FPN,输出 1/8 分辨率的粗特征 和 1/2 分辨率的细特征 。粗特征 256 通道,细特征 128 通道;FPN 的 P3 层给粗匹配,P1 层给细匹配。
- 粗层 Transformer:把粗特征展平成序列,加一次 2D 正弦位置编码,送入 层交替的 self-attention / cross-attention。每层 8 个头,使用线性注意力。
- 粗匹配:在两组变换后的特征之间算 的置信度矩阵,用 dual-softmax 或最优传输得到软分配,再按阈值 0.2、互最近邻和边界裁剪选出粗匹配。
- 由粗到细:对每个粗匹配,在两张图的 1/2 特征图上各裁一个 窗口,用一层 fine LoFTR 交换窗口内的信息;然后拿左图窗口中心向量和右图 25 个向量做相关,softmax 后取空间期望,得到亚像素偏移。
官方实现把这四步串在 LoFTR.forward 里,顺序非常直白:
代码:LoFTR 前向流水线(官方 src/loftr/loftr.py,原文节选)
        # 2. coarse-level loftr module
        # add featmap with positional encoding, then flatten it to sequence [N, HW, C]
        feat_c0 = rearrange(self.pos_encoding(feat_c0), 'n c h w -> n (h w) c')
        feat_c1 = rearrange(self.pos_encoding(feat_c1), 'n c h w -> n (h w) c')

        mask_c0 = mask_c1 = None  # mask is useful in training
        if 'mask0' in data:
            mask_c0, mask_c1 = data['mask0'].flatten(-2), data['mask1'].flatten(-2)
        feat_c0, feat_c1 = self.loftr_coarse(feat_c0, feat_c1, mask_c0, mask_c1)

        # 3. match coarse-level
        self.coarse_matching(feat_c0, feat_c1, data, mask_c0=mask_c0, mask_c1=mask_c1)

        # 4. fine-level refinement
        feat_f0_unfold, feat_f1_unfold = self.fine_preprocess(feat_f0, feat_f1, feat_c0, feat_c1, data)
        if feat_f0_unfold.size(0) != 0:  # at least one coarse level predicted
            feat_f0_unfold, feat_f1_unfold = self.loftr_fine(feat_f0_unfold, feat_f1_unfold)

        # 5. match fine-level
        self.fine_matching(feat_f0_unfold, feat_f1_unfold, data)
一个容易被忽略的实现细节是输入:官方数据读取和 demo 都把图像转成灰度,backbone 第一层也是单通道卷积。论文正文没有强调这一点,但颜色信息确实没有被利用。输入的高和宽需要能被 8 整除,否则 1/8 的粗网格会对不齐。
2.2 位置编码:加一次,而不是每层都加
Transformer 本身对位置是置换不变的,而匹配恰恰需要位置信息。LoFTR 采用 DETR 式的 2D 正弦位置编码[6],对每个粗网格中心 生成 维向量,四个通道为一组:
和 DETR 不同的是,LoFTR 只在 backbone 输出后加一次,之后 4 层 Transformer 共享这份位置编码,而不是每层重新注入。这个选择不是省事,而是有消融支撑的:在 ScanNet 上用 OT 训练,把位置编码改成每层都加,AUC@5°/10°/20° 从 20.06/40.8/57.62 降到 18.02/35.64/52.77,三项都退化。论文只说「noticeably declined」,没有解释原因;我的猜测是,重复注入会不断把特征拉回固定的正弦基,削弱 attention 学到的内容相关变换。
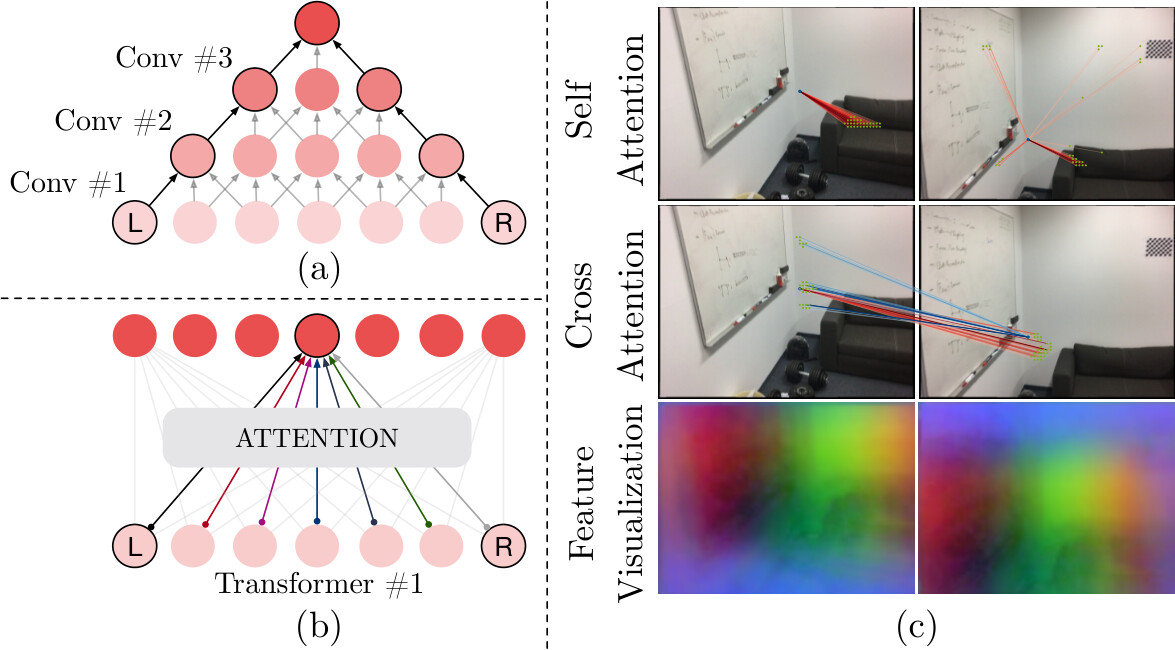
位置编码的作用在低纹理区域最明显。图 3(c) 的 PCA 可视化里,白墙在 RGB 上几乎是常数,但变换后的粗特征呈现出平滑的彩色渐变——每个位置都带上了独一无二的坐标信息,匹配才有依据。图 5 的 self/cross attention 可视化也说明,墙角的查询点会主动去看桌沿、墙角这些有结构的位置,而不是困在局部窗口里。
2.3 线性注意力:让全局注意力算得起
标准注意力是
计算和显存都随序列长度 平方增长。640×480 的图像在 1/8 分辨率下有 个 token;单头注意力矩阵就是 个元素,8 个头、4 层、self 和 cross 各一遍,开销不可忽略。
LoFTR 采用 Katharopoulos 等人的线性 Transformer[7],把 softmax 核换成 ,利用矩阵乘法的结合律先算 :
分子分母都是 的矩阵乘法,复杂度降到 。官方实现里还把 value 先除以序列长度、最后再乘回来,目的是防止 fp16 溢出;数学上等价。
代码:线性注意力(官方 src/loftr/loftr_module/linear_attention.py,原文节选)
    def forward(self, queries, keys, values, q_mask=None, kv_mask=None):
        """ Multi-Head linear attention proposed in "Transformers are RNNs"
        Args:
            queries: [N, L, H, D]
            keys: [N, S, H, D]
            values: [N, S, H, D]
            q_mask: [N, L]
            kv_mask: [N, S]
        Returns:
            queried_values: (N, L, H, D)
        """
        Q = self.feature_map(queries)
        K = self.feature_map(keys)

        # set padded position to zero
        if q_mask is not None:
            Q = Q * q_mask[:, :, None, None]
        if kv_mask is not None:
            K = K * kv_mask[:, :, None, None]
            values = values * kv_mask[:, :, None, None]

        v_length = values.size(1)
        values = values / v_length  # prevent fp16 overflow
        KV = torch.einsum("nshd,nshv->nhdv", K, values)  # (S,D)' @ S,V
        Z = 1 / (torch.einsum("nlhd,nhd->nlh", Q, K.sum(dim=1)) + self.eps)
        queried_values = torch.einsum("nlhd,nhdv,nlh->nlhv", Q, KV, Z) * v_length

        return queried_values.contiguous()
多头注意力的组织方式在 LocalFeatureTransformer 里:每隔一层做 self-attention,下一层做 cross-attention,共重复 次。self 层让同一张图内的位置互相交换信息,cross 层让 A 图的每个位置查询 B 图的所有位置,反之亦然。
代码:self/cross 交替(官方 src/loftr/loftr_module/transformer.py,原文节选)
        for layer, name in zip(self.layers, self.layer_names):
            if name == 'self':
                feat0 = layer(feat0, feat0, mask0, mask0)
                feat1 = layer(feat1, feat1, mask1, mask1)
            elif name == 'cross':
                feat0 = layer(feat0, feat1, mask0, mask1)
                feat1 = layer(feat1, feat0, mask1, mask0)
            else:
                raise KeyError
论文没有单独消融「线性注意力 vs 全注意力」,只做了「用卷积替换整个 LoFTR 模块」的对照:ScanNet 上 AUC@5°/10°/20° 从 20.06/40.8/57.62 掉到 14.98/32.04/49.92。这个对照说明全局注意力本身是主要收益来源,但没法把线性近似的损失单独拆出来。换句话说,线性注意力是为了让设计可行,而不是论文宣称的精度贡献点。
2.4 粗匹配:dual-softmax 与最优传输
粗层 Transformer 输出两组特征 、。先算相似度矩阵
其中 是温度,官方默认 0.1。然后有两种可微匹配方式。
Dual-softmax 在行、列两个方向分别做 softmax,再逐元素相乘:
这个乘积不是联合概率,而是一个「软互最近邻」分数:一个格子要高,必须同时是所在行的最大值和所在列的最大值。它没有显式的「不匹配」选项,所有点都被迫参与竞争;但推理时配合置信度阈值和互最近邻,可以把大部分错误匹配滤掉。
最优传输(OT) 把匹配看成部分分配问题:把 当成本矩阵,在得分矩阵右侧和下侧各加一行/列 dustbin,允许点被分配到「不匹配」。然后用 Sinkhorn 迭代在行、列边缘约束下归一化。dustbin 的分数 是可学习参数,官方初值 1.0,迭代 3 次。和 dual-softmax 相比,OT 显式建模了「这个点没有对应」,并且通过全局边缘约束带来一种全局共识;代价是 matching 阶段更慢。
两种方式在实验里的差距很小,而且方向不一致:HPatches 只报了 dual-softmax;MegaDepth 上 DS 的 AUC@5° 是 52.8,OT 是 50.31;ScanNet 上 DS 22.06、OT 21.51,但 AUC@20° 是 OT 57.96、DS 57.62。视觉定位里作者两套都跑、报告更好的那个;InLoc 最终用 OT(DUC1 47.5/72.2/84.8),论文把它的优势归因于 OT 的全局共识。论文没有解释为什么 DS 在 MegaDepth 更好;我的猜测是,OT 的均匀边缘假设和 dustbin 成本会改变匹配数量,而 DS 的软互最近邻更直接地对应「一行一列只留一个」的评测协议。
下面这个部件把两种分配放在同一个 5×5 得分矩阵上。默认是 dual-softmax、:真匹配 (A0,B0)、(A1,B1)、(A2,B2) 的置信度都接近 1,但 A3–B4 也有 0.36,而且它是 A3 这一行的最大值、也是 B4 这一列的最大值,所以阈值 0.2 + 互最近邻删不掉它——最终输出 5 对,其中 2 对是假的。切到 OT,把 dustbin 分数调到 2.5,A3 和 B4 分别被 dustbin 以 0.81、0.80 的质量吸收,A3–B4 只剩 0.15,输出变成 3 对,全部正确。
怎么读这个部件:默认参数下,dual-softmax 的 5 对匹配里有 2 对是假的,而且假匹配的置信度 0.36 并不低——它之所以活下来,是因为 A3 这一行没有更强的候选、B4 这一列也没有更强的候选,行、列 softmax 都会把它放大。OT 的不同不在于「分数更高」,而在于它允许 A3、B4 把质量放到 dustbin 上,于是 A3–B4 自然掉到阈值以下。代价是 matching 模块从 12.0 ms 涨到 21.0 ms(640×480,RTX 2080Ti);在 MegaDepth 这种重复纹理多、真正可匹配点比例不低的场景里,这个代价不一定划算,所以 DS 仍然是默认配置。
官方代码把两种分配写在同一个 CoarseMatching.forward 里。注意 OT 分支在训练时还会把带 dustbin 的完整分配矩阵存进 conf_matrix_with_bin,供 sparse supervision 使用;推理时只取左上角的 子矩阵。
代码:粗匹配的 dual-softmax 与 Sinkhorn(官方 src/loftr/utils/coarse_matching.py,原文照录)
    def forward(self, feat_c0, feat_c1, data, mask_c0=None, mask_c1=None):
        """
        Args:
            feat0 (torch.Tensor): [N, L, C]
            feat1 (torch.Tensor): [N, S, C]
            data (dict)
            mask_c0 (torch.Tensor): [N, L] (optional)
            mask_c1 (torch.Tensor): [N, S] (optional)
        Update:
            data (dict): {
                'b_ids' (torch.Tensor): [M'],
                'i_ids' (torch.Tensor): [M'],
                'j_ids' (torch.Tensor): [M'],
                'gt_mask' (torch.Tensor): [M'],
                'mkpts0_c' (torch.Tensor): [M, 2],
                'mkpts1_c' (torch.Tensor): [M, 2],
                'mconf' (torch.Tensor): [M]}
            NOTE: M' != M during training.
        """
        N, L, S, C = feat_c0.size(0), feat_c0.size(1), feat_c1.size(1), feat_c0.size(2)

        # normalize
        feat_c0, feat_c1 = map(lambda feat: feat / feat.shape[-1]**.5,
                               [feat_c0, feat_c1])

        if self.match_type == 'dual_softmax':
            sim_matrix = torch.einsum("nlc,nsc->nls", feat_c0,
                                      feat_c1) / self.temperature
            if mask_c0 is not None:
                sim_matrix.masked_fill_(
                    ~(mask_c0[..., None] * mask_c1[:, None]).bool(),
                    -INF)
            conf_matrix = F.softmax(sim_matrix, 1) * F.softmax(sim_matrix, 2)

        elif self.match_type == 'sinkhorn':
            # sinkhorn, dustbin included
            sim_matrix = torch.einsum("nlc,nsc->nls", feat_c0, feat_c1)
            if mask_c0 is not None:
                sim_matrix[:, :L, :S].masked_fill_(
                    ~(mask_c0[..., None] * mask_c1[:, None]).bool(),
                    -INF)

            # build uniform prior & use sinkhorn
            log_assign_matrix = self.log_optimal_transport(
                sim_matrix, self.bin_score, self.skh_iters)
            assign_matrix = log_assign_matrix.exp()
            conf_matrix = assign_matrix[:, :-1, :-1]

            # filter prediction with dustbin score (only in evaluation mode)
            if not self.training and self.skh_prefilter:
                filter0 = (assign_matrix.max(dim=2)[1] == S)[:, :-1]  # [N, L]
                filter1 = (assign_matrix.max(dim=1)[1] == L)[:, :-1]  # [N, S]
                conf_matrix[filter0[..., None].repeat(1, 1, S)] = 0
                conf_matrix[filter1[:, None].repeat(1, L, 1)] = 0

            if self.config['sparse_spvs']:
                data.update({'conf_matrix_with_bin': assign_matrix.clone()})

        data.update({'conf_matrix': conf_matrix})

        # predict coarse matches from conf_matrix
        data.update(**self.get_coarse_match(conf_matrix, data))
选出粗匹配的三步在 get_coarse_match 里:先按 0.2 阈值筛,再把粗网格最外圈两格置零(border_rm=2,避免边界上不完整的感受野),最后要求行、列互为最大值。这三步都不参与梯度,只是推理时的后处理。
代码:粗匹配筛选(官方 src/loftr/utils/coarse_matching.py,原文节选)
        _device = conf_matrix.device
        # 1. confidence thresholding
        mask = conf_matrix > self.thr
        mask = rearrange(mask, 'b (h0c w0c) (h1c w1c) -> b h0c w0c h1c w1c',
                         **axes_lengths)
        if 'mask0' not in data:
            mask_border(mask, self.border_rm, False)
        else:
            mask_border_with_padding(mask, self.border_rm, False,
                                     data['mask0'], data['mask1'])
        mask = rearrange(mask, 'b h0c w0c h1c w1c -> b (h0c w0c) (h1c w1c)',
                         **axes_lengths)

        # 2. mutual nearest
        mask = mask \
            * (conf_matrix == conf_matrix.max(dim=2, keepdim=True)[0]) \
            * (conf_matrix == conf_matrix.max(dim=1, keepdim=True)[0])

        # 3. find all valid coarse matches
        # this only works when at most one `True` in each row
        mask_v, all_j_ids = mask.max(dim=2)
        b_ids, i_ids = torch.where(mask_v)
        j_ids = all_j_ids[b_ids, i_ids]
        mconf = conf_matrix[b_ids, i_ids, j_ids]
OT 分支用的就是 SuperGlue 的 log-domain Sinkhorn。LoFTR 仓库没有直接分发这段代码(SuperGlue 的 LICENSE 不允许),README 要求用户自己 wget 到 src/loftr/utils/superglue.py。下面是官方依赖里的两个函数,原文照录:
代码:log-domain Sinkhorn 与最优传输(官方依赖 SuperGluePretrainedNetwork/models/superglue.py,原文照录)
def log_sinkhorn_iterations(Z: torch.Tensor, log_mu: torch.Tensor, log_nu: torch.Tensor, iters: int) -> torch.Tensor:
    """ Perform Sinkhorn Normalization in Log-space for stability"""
    u, v = torch.zeros_like(log_mu), torch.zeros_like(log_nu)
    for _ in range(iters):
        u = log_mu - torch.logsumexp(Z + v.unsqueeze(1), dim=2)
        v = log_nu - torch.logsumexp(Z + u.unsqueeze(2), dim=1)
    return Z + u.unsqueeze(2) + v.unsqueeze(1)


def log_optimal_transport(scores: torch.Tensor, alpha: torch.Tensor, iters: int) -> torch.Tensor:
    """ Perform Differentiable Optimal Transport in Log-space for stability"""
    b, m, n = scores.shape
    one = scores.new_tensor(1)
    ms, ns = (m*one).to(scores), (n*one).to(scores)

    bins0 = alpha.expand(b, m, 1)
    bins1 = alpha.expand(b, 1, n)
    alpha = alpha.expand(b, 1, 1)

    couplings = torch.cat([torch.cat([scores, bins0], -1),
                           torch.cat([bins1, alpha], -1)], 1)

    norm = - (ms + ns).log()
    log_mu = torch.cat([norm.expand(m), ns.log()[None] + norm])
    log_nu = torch.cat([norm.expand(n), ms.log()[None] + norm])
    log_mu, log_nu = log_mu[None].expand(b, -1), log_nu[None].expand(b, -1)

    Z = log_sinkhorn_iterations(couplings, log_mu, log_nu, iters)
    Z = Z - norm  # multiply probabilities by M+N
    return Z
2.5 由粗到细:5×5 窗口与亚像素期望
粗匹配只给出 1/8 网格中心,误差最多可能有半个粗格,也就是原图 4 px。细化的目标是在这个局部邻域里找到精确位置。
对每个粗匹配 ,先把它映射到 1/2 特征图上的位置 ,然后以 为中心在 B 图上裁 的窗口。窗口里的特征先经过一层 fine LoFTR(同样是 self/cross attention,,8 头,128 通道),让窗口内的点互相交换信息;然后拿 A 图窗口中心向量与 B 图窗口里全部 25 个向量做点积,得到相关热图。对热图做 softmax,logits 乘以 (,约 0.088),再取空间期望:
这里的 是窗口内相对中心的偏移,单位是 1/2 分辨率的 fine cell。因为一个 fine cell 对应原图 2 px,最后把 乘回 2 就得到原图坐标。期望而不是 argmax,是为了拿到亚像素:argmax 只能落在整数格子上,期望则可以利用相邻格子的概率做插值。
同时还能算出热图的方差,作为这次细化的不确定性:
方差越大,说明热图越平,细化位置越不可靠。训练时用 给每个 fine 匹配加权,让网络优先优化确定性高的点;推理时标准差只作为内部量,不输出给下游。
为什么不在全分辨率上做全局匹配?640×480 的图像在 1/2 分辨率下有 个 token,全局相关矩阵是 个元素,显存直接爆炸;即使只算一次,也没有必要——粗层已经用全局上下文确定了大致位置,细层只需要在局部消除量化误差。5×5 窗口的半径是 2 个 fine cell,正好对应 1/8 粗格中心 ±4 px 的量化范围;再大就是浪费,再小则可能把真值排除在外。
下面这个部件把窗口大小、温度和估计方式做成旋钮。红色叉是真实对应,灰色十字是粗匹配中心,方框是 argmax,圆点是 soft-argmax。默认 、、soft-argmax:真值偏移是 (1.3, −0.7) 个 fine cell,soft-argmax 的误差约 0.23 个原图像素,argmax 约 0.85 px。把窗口缩到 3,真值落到窗口外,soft-argmax 被边缘拖偏,误差从 0.23 涨到 0.66 px;再把温度调到 0.2,误差就超过 argmax 的 0.85 px。把窗口加到 7 或 9,精度没有明显提升,只是多算。把温度调高,热图变平,期望会被窗口中心拉回去,误差迅速变大。
怎么读这个部件:默认的 、 下,soft-argmax 的误差约 0.23 px,argmax 约 0.85 px——亚像素精度不是玄学,就是把相邻格子的概率拿来加权。把窗口调到 3,真值 (1.3, −0.7) 落在窗口外,soft-argmax 会被边界拉向中心,误差从 0.23 涨到 0.66 px;温度调到 0.2 时进一步涨到 1.01 px,已经超过 argmax 的 0.85 px。这说明 不是随便选的,它对应 1/8 粗格的 ±4 px 量化范围。把窗口调到 7 或 9,精度基本不变,但相关计算量按 增长。温度调到 0.5 以上,热图变平,期望会被窗口中心拉回去,误差迅速变大;官方把 logits 乘以 ,就是让热图保持尖锐。
需要说明的是,这个玩具用高斯相关面模拟热图;真实 LoFTR 的相关值来自学习到的 128 维特征,热图不一定高斯,也不一定以真值为中心。部件只演示窗口覆盖、softmax 温度和空间期望三者的几何关系,不代表真实模型的误差分布。
官方实现里,窗口裁剪用 F.unfold 一次完成:kernel 5、stride 4(1/2 与 1/8 的比值)、padding 2,然后按粗匹配的 b_ids/i_ids/j_ids 选出对应的窗口。可选地把上采样的粗特征与细特征拼接,给细层更多上下文。
代码:细层窗口裁剪(官方 src/loftr/loftr_module/fine_preprocess.py,原文照录)
    def forward(self, feat_f0, feat_f1, feat_c0, feat_c1, data):
        W = self.W
        stride = data['hw0_f'][0] // data['hw0_c'][0]

        data.update({'W': W})
        if data['b_ids'].shape[0] == 0:
            feat0 = torch.empty(0, self.W**2, self.d_model_f, device=feat_f0.device)
            feat1 = torch.empty(0, self.W**2, self.d_model_f, device=feat_f0.device)
            return feat0, feat1

        # 1. unfold(crop) all local windows
        feat_f0_unfold = F.unfold(feat_f0, kernel_size=(W, W), stride=stride, padding=W//2)
        feat_f0_unfold = rearrange(feat_f0_unfold, 'n (c ww) l -> n l ww c', ww=W**2)
        feat_f1_unfold = F.unfold(feat_f1, kernel_size=(W, W), stride=stride, padding=W//2)
        feat_f1_unfold = rearrange(feat_f1_unfold, 'n (c ww) l -> n l ww c', ww=W**2)

        # 2. select only the predicted matches
        feat_f0_unfold = feat_f0_unfold[data['b_ids'], data['i_ids']]  # [n, ww, cf]
        feat_f1_unfold = feat_f1_unfold[data['b_ids'], data['j_ids']]

        # option: use coarse-level loftr feature as context: concat and linear
        if self.cat_c_feat:
            feat_c_win = self.down_proj(torch.cat([feat_c0[data['b_ids'], data['i_ids']],
                                                   feat_c1[data['b_ids'], data['j_ids']]], 0))  # [2n, c]
            feat_cf_win = self.merge_feat(torch.cat([
                torch.cat([feat_f0_unfold, feat_f1_unfold], 0),  # [2n, ww, cf]
                repeat(feat_c_win, 'n c -> n ww c', ww=W**2),  # [2n, ww, cf]
            ], -1))
            feat_f0_unfold, feat_f1_unfold = torch.chunk(feat_cf_win, 2, dim=0)

        return feat_f0_unfold, feat_f1_unfold
细匹配的前向更短:取左窗口中心向量,与右窗口所有向量做点积,softmax 成热图,dsnt.spatial_expectation2d 算期望,再算标准差。get_fine_match 把归一化坐标乘回 W//2 * scale,得到原图偏移。
代码:细匹配与空间期望(官方 src/loftr/utils/fine_matching.py,原文照录)
    def forward(self, feat_f0, feat_f1, data):
        """
        Args:
            feat0 (torch.Tensor): [M, WW, C]
            feat1 (torch.Tensor): [M, WW, C]
            data (dict)
        Update:
            data (dict):{
                'expec_f' (torch.Tensor): [M, 3],
                'mkpts0_f' (torch.Tensor): [M, 2],
                'mkpts1_f' (torch.Tensor): [M, 2]}
        """
        M, WW, C = feat_f0.shape
        W = int(math.sqrt(WW))
        scale = data['hw0_i'][0] / data['hw0_f'][0]
        self.M, self.W, self.WW, self.C, self.scale = M, W, WW, C, scale

        # corner case: if no coarse matches found
        if M == 0:
            assert self.training == False, "M is always >0, when training, see coarse_matching.py"
            # logger.warning('No matches found in coarse-level.')
            data.update({
                'expec_f': torch.empty(0, 3, device=feat_f0.device),
                'mkpts0_f': data['mkpts0_c'],
                'mkpts1_f': data['mkpts1_c'],
            })
            return

        feat_f0_picked = feat_f0_picked = feat_f0[:, WW//2, :]
        sim_matrix = torch.einsum('mc,mrc->mr', feat_f0_picked, feat_f1)
        softmax_temp = 1. / C**.5
        heatmap = torch.softmax(softmax_temp * sim_matrix, dim=1).view(-1, W, W)

        # compute coordinates from heatmap
        coords_normalized = dsnt.spatial_expectation2d(heatmap[None], True)[0]  # [M, 2]
        grid_normalized = create_meshgrid(W, W, True, heatmap.device).reshape(1, -1, 2)  # [1, WW, 2]

        # compute std over <x, y>
        var = torch.sum(grid_normalized**2 * heatmap.view(-1, WW, 1), dim=1) - coords_normalized**2  # [M, 2]
        std = torch.sum(torch.sqrt(torch.clamp(var, min=1e-10)), -1)  # [M]  clamp needed for numerical stability

        # for fine-level supervision
        data.update({'expec_f': torch.cat([coords_normalized, std.unsqueeze(1)], -1)})

        # compute absolute kpt coords
        self.get_fine_match(coords_normalized, data)

    @torch.no_grad()
    def get_fine_match(self, coords_normed, data):
        W, WW, C, scale = self.W, self.WW, self.C, self.scale

        # mkpts0_f and mkpts1_f
        mkpts0_f = data['mkpts0_c']
        scale1 = scale * data['scale1'][data['b_ids']] if 'scale0' in data else scale
        mkpts1_f = data['mkpts1_c'] + (coords_normed * (W // 2) * scale1)[:len(data['mconf'])]

        data.update({
            "mkpts0_f": mkpts0_f,
            "mkpts1_f": mkpts1_f
        })
2.6 监督:粗层用互最近邻,细层用方差加权
最终损失是粗、细两部分之和:。
粗层监督。真值不是逐像素的完整对应矩阵,而是两组 1/8 网格中心之间的互最近邻:把左图每个网格中心按位姿和深度投影到右图,找投影距离最近的右图网格中心;反过来也找一遍,只有双向都最近的网格对才算真值。作者在补充材料里明确说,这一步没有额外的深度一致性检查,也没有重投影距离阈值——因为 1/8 网格本身已经很粗,互最近邻已经足够稳定。真值集合记作 ,损失是负对数似然:
用 OT 时,作者说沿用 SuperGlue 的损失形式,也就是在带 dustbin 的完整分配矩阵上做同样的监督。
细层监督。把左图细层的查询点按位姿和深度投影到右图,得到真值偏移 ;如果投影落在右图窗口外,就忽略这个点。损失是方差加权的 L2:
方差大的点权重小,网络不会为了几个不确定的匹配牺牲整体;梯度不经过 ,否则网络可以把方差调大来偷懒。
代码:粗层交叉熵与细层方差加权 L2(官方 src/losses/loftr_loss.py,原文节选)
        if self.loss_config['coarse_type'] == 'cross_entropy':
            assert not self.sparse_spvs, 'Sparse Supervision for cross-entropy not implemented!'
            conf = torch.clamp(conf, 1e-6, 1-1e-6)
            loss_pos = - torch.log(conf[pos_mask])
            loss_neg = - torch.log(1 - conf[neg_mask])
            if weight is not None:
                loss_pos = loss_pos * weight[pos_mask]
                loss_neg = loss_neg * weight[neg_mask]
            return c_pos_w * loss_pos.mean() + c_neg_w * loss_neg.mean()
def _compute_fine_loss_l2_std(self, expec_f, expec_f_gt):
"""
Args:
expec_f (torch.Tensor): [M, 3] <x, y, std>
expec_f_gt (torch.Tensor): [M, 2] <x, y>
"""
# correct_mask tells you which pair to compute fine-loss
correct_mask = torch.linalg.norm(expec_f_gt, ord=float('inf'), dim=1) < self.correct_thr
# use std as weight that measures uncertainty
std = expec_f[:, 2]
inverse_std = 1. / torch.clamp(std, min=1e-10)
weight = (inverse_std / torch.mean(inverse_std)).detach() # avoid minizing loss through increase std
# corner case: no correct coarse match found
if not correct_mask.any():
if self.training: # this seldomly happen during training, since we pad prediction with gt
# sometimes there is not coarse-level gt at all.
logger.warning("assign a false supervision to avoid ddp deadlock")
correct_mask[0] = True
weight[0] = 0.
else:
return None
# l2 loss with std
offset_l2 = ((expec_f_gt[correct_mask] - expec_f[correct_mask, :2]) ** 2).sum(-1)
loss = (offset_l2 * weight[correct_mask]).mean()
return loss这里有两个论文与代码的差异,值得明确记下来:
- 粗层损失:论文写的是 NLL,官方发布的默认配置却是 focal loss + 稠密监督(
SPARSE_SPVS=True),对整个置信度矩阵的每个格子做正/负样本监督。docs/TRAINING.md说得很清楚:要复现论文的稀疏 NLL,需要把_CN.LOFTR.MATCH_COARSE.SPARSE_SPVS设为False。默认配置是作者后来调整的训练策略,不是论文里的配方。 - 细层权重:论文写 ,代码用的是归一化的 (
inverse_std,再除以均值并 detach)。相对权重的形状不同,但目的相同;代码还顺手避免了「通过网络放大 std 来降低 loss」的退化。
2.7 训练设置:两天两套数据
论文训练了两个模型:室内用 ScanNet,室外用 MegaDepth。两套数据的规模、采样和优化器设置如下(数字来自补充材料;主文只给了简版)。
| MegaDepth(室外) | ScanNet(室内) | |
|---|---|---|
| 规模 | 196 场景 / 368 sub-scene | 1613 序列;1513 场景训练 |
| 每 epoch | 36,800 对(每 sub-scene 100 对) | 302,400 对(每场景约 200 对) |
| epoch 数 | 30 | 30 |
| batch | 8 | 64 |
| 初始 LR | (主文写 ) | |
| warmup | 3 个 epoch,从 0.1× 线性升到 1× | 4800 次迭代 |
| LR 衰减 | 从第 8 个 epoch 起每 8 个 epoch 乘 0.5 | 从第 3 个 epoch 起每 3 个 epoch 乘 0.5 |
| 硬件 | 16 张 V100,约 1 天 | 64 张 1080Ti,约 1 天 |
两套数据共用 AdamW、weight decay 0.1、梯度裁剪 0.5,不用 dropout。MegaDepth 的训练图像长边缩放到 840,验证 1200;ScanNet 统一到 640×480。ScanNet 整个训练约 9M 个样本,而 SuperGlue 约 360M,这是论文强调的「训练效率」优势。
这里有两个需要读者注意的不一致:
- ScanNet 初始学习率:主文写 Adam、,补充材料写 ,并给了 4800 次 warmup。两者只能信一个;从官方配置和补充材料的细节看, 更可能是实际用的值,主文大概率是笔误。
- MegaDepth 训练分辨率:论文写长边 840,但官方
scripts/reproduce_train/outdoor_ds.sh默认TRAIN_IMG_SIZE=640,脚本里注释说「to reproduced the results in our paper, please use: TRAIN_IMG_SIZE=840」。也就是说,直接跑默认脚本得到的不是论文配置。官方docs/TRAINING.md也提醒,发布的训练脚本用 4 张 GPU、640 分辨率,不保证复现论文数字。
另外,为了控制显存,细层训练只取粗匹配候选的 30%(TRAIN_COARSE_PERCENT),并且保证至少有 200 个真值粗匹配;不够就用真值填充。这是训练技巧,不影响推理。
三、实验结果
3.1 HPatches:单应估计
HPatches 有 52 个光照变化序列和 56 个视角变化序列。评测时每条序列取一张参考图,与其余 5 张配对;图像短边缩放到 480,用 MegaDepth 训练的 LoFTR 提取最多 1K 个匹配,OpenCV RANSAC 估计单应,报告角点误差的 AUC@3/5/10 px[8]。
| 方法 | 类型 | AUC@3px | AUC@5px | AUC@10px |
|---|---|---|---|---|
| D2-Net + NN | 检测器 | 23.2 | 35.9 | 53.6 |
| ORB + GMS | 检测器 | 5.21 | 13.65 | 25.36 |
| R2D2 + NN | 检测器 | 50.6 | 63.9 | 76.8 |
| DISK + NN | 检测器 | 52.3 | 64.9 | 78.9 |
| SuperPoint + SuperGlue | 检测器 + 匹配器 | 53.9 | 68.3 | 81.7 |
| Sparse-NCNet | 无检测器 | 48.9 | 54.2 | 67.1 |
| DRC-Net | 无检测器 | 50.6 | 56.2 | 68.3 |
| LoFTR-DS | 无检测器 | 65.9 | 75.6 | 84.6 |
LoFTR-DS 在三个阈值上都领先,而且阈值越严格优势越大:相对 SuperGlue,@3px 高 12.0,@5px 高 7.3,@10px 高 2.9。这个趋势和论文的整体论证一致:无检测器设计提供了更多的候选匹配,Transformer 的全局感受野让低纹理区域的候选也可区分;粗到细模块再把位置细化到亚像素,所以严格阈值下的收益更明显。
3.2 ScanNet:室内相对位姿
ScanNet 有 1613 个单目序列,训练对重叠度在 0.4–0.8 之间,共约 230M 对;评测用 SuperGlue 划分的 1500 对测试集,图像统一到 640×480。这个数据集的特点是宽基线和大量无纹理区域,正好打检测器的软肋。
| 方法 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| ContextDesc + Ratio | 6.64 | 15.01 | 25.75 |
| SuperPoint + NN | 9.43 | 21.53 | 36.40 |
| SuperPoint + PointCN | 11.40 | 25.47 | 41.41 |
| SuperPoint + OANet | 11.76 | 26.90 | 43.85 |
| SuperPoint + SuperGlue | 16.16 | 33.81 | 51.84 |
| DRC-Net†(MegaDepth 训练) | 7.69 | 17.93 | 30.49 |
| LoFTR-OT†(MegaDepth 训练) | 16.88 | 33.62 | 50.62 |
| LoFTR-OT | 21.51 | 40.39 | 57.96 |
| LoFTR-DS | 22.06 | 40.8 | 57.62 |
LoFTR-DS 比 SuperGlue 高 5.90/6.99/5.78。更有说服力的是 † 行:同样是 MegaDepth 训练、直接跨数据集测试,LoFTR-OT† 的 16.88 远高于 DRC-Net† 的 7.69(@5°),说明收益不是靠 ScanNet 数据量堆出来的,而是架构本身带来的跨域泛化。DS 和 OT 在 ScanNet 上几乎打平:DS 的 @5°、@10° 略高,OT 的 @20° 略高。
3.3 MegaDepth:室外相对位姿
MegaDepth 有 196 个室外场景、约 1M 张互联网图像;验证集取 Sacre Coeur 和 St. Peter’s Square 两个场景的 1500 对,训练时长边 840、验证 1200。室外的主要挑战是剧烈的视角变化和重复结构。
| 方法 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| SuperPoint + SuperGlue | 42.18 | 61.16 | 75.96 |
| DRC-Net | 27.01 | 42.96 | 58.31 |
| LoFTR-OT | 50.31 | 67.14 | 79.93 |
| LoFTR-DS | 52.8 | 69.19 | 81.18 |
LoFTR-DS 比 SuperGlue 高 10.62/8.03/5.22;相对 DRC-Net,@10° 从 42.96 提到 69.19,论文说这是 61% 的相对提升。注意这里 DS 明显好于 OT(52.8 对 50.31),和 ScanNet 上两者打平不同。论文没有解释原因,只说「LoFTR-DS performs better than LoFTR-OT on MegaDepth」。
把后来的方法放进来做参照(这些数字来自 DKM 论文,不是 LoFTR 论文)[9]:DKM 在 MegaDepth-1500 上 60.4/74.9/85.1,ScanNet-1500 上 29.4/50.7/68.3,HPatches 上 71.3/80.6/88.5;对应 LoFTR 是 52.8/69.2/81.2、22.1/40.8/57.6、65.9/75.6/84.6。两年后的 DKM 在三个基准上都更高,说明 LoFTR 是这条线的起点而不是终点;但 LoFTR 把「无检测器 + 粗到细 + Transformer」这套骨架立住了,后面的工作大多是在此之上换特征、换匹配头、换训练数据。
3.4 视觉定位:InLoc 与 Aachen
视觉定位比相对位姿更苛刻:查询图和数据库图的重叠往往很小,匹配错了就直接导致 PnP 失败。论文用 HLoc 流程[10],把 LoFTR 当作局部特征匹配器,分别跑室内的 InLoc[11] 和室外的 Aachen Day-Night v1.1[12]。
InLoc 的 DUC1/DUC2 结果(阈值从 0.25m,10° 到 1.0m,10°):
| 方法 | DUC1 | DUC2 |
|---|---|---|
| ISRF | 39.4 / 58.1 / 70.2 | 41.2 / 61.1 / 69.5 |
| KAPTURE + R2D2 | 41.4 / 60.1 / 73.7 | 47.3 / 67.2 / 73.3 |
| HLoc + SuperPoint + SuperGlue | 49.0 / 68.7 / 80.8 | 53.4 / 77.1 / 82.4 |
| HLoc + LoFTR-OT | 47.5 / 72.2 / 84.8 | 54.2 / 74.8 / 85.5 |
LoFTR 在 6 个数字里的 4 个最好,但不是全面胜利:DUC1 最严格的 (0.25m,10°) 上,SuperGlue 的 49.0 仍高于 LoFTR 的 47.5;DUC2 的三个阈值里 LoFTR 赢两个、输一个。论文说 LoFTR-OT 在 InLoc 上「outperforms all published methods」,严格说只在较宽松的阈值上成立。这也符合直觉:InLoc 有大量无纹理区域,LoFTR 的全局上下文有优势;但最严格的定位精度还取决于匹配的局部精度和 RANSAC,SuperGlue 的稀疏匹配并不差。
Aachen Day-Night v1.1 分两条 track。局部特征 track 只评匹配器本身,夜间查询的结果:
| 方法 | (0.25m,2°) | (0.5m,5°) | (1.0m,10°) |
|---|---|---|---|
| R2D2 + NN | 71.2 | 86.9 | 98.9 |
| LISRD + SP + AdaLam | 73.3 | 86.9 | 97.9 |
| ISRF + NN | 69.1 | 87.4 | 98.4 |
| SuperPoint + SuperGlue | 73.3 | 88.0 | 98.4 |
| LoFTR-DS | 72.8 | 88.5 | 99.0 |
两者几乎打平:最严阈值 SuperGlue 高 0.5,中间阈值 LoFTR 高 0.5,最宽阈值 LoFTR 高 0.6。完整定位流程(HLoc)的结果:
| 方法 | Day (0.25/0.5/1.0) | Night (0.25/0.5/1.0) |
|---|---|---|
| SuperPoint + SuperGlue | 89.8 / 96.1 / 99.4 | 77.0 / 90.6 / 100.0 |
| LoFTR-OT | 88.7 / 95.6 / 99.0 | 78.5 / 90.6 / 99.0 |
白天 SuperGlue 略好,夜间 LoFTR 在最严阈值高 1.5,但两家在最严阈值上的日夜差距都还在 10 个点以上(SuperGlue 12.8、LoFTR 10.2)。论文自己说 LoFTR-OT 在夜间「on par」、白天「slightly worse」;这个评价是准确的。昼夜外观变化不是靠全局注意力就能解决的,补充材料里作者也把「severe seasonal changes」列为未来工作。
3.5 消融与运行时间
论文在 ScanNet 上用 OT 训练了 5 个变体,结果如下:
| 变体 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| 用卷积替换 LoFTR 模块 | 14.98 | 32.04 | 49.92 |
| 1/16 粗 + 1/4 细 | 16.75 | 34.82 | 54.0 |
| 每层都加位置编码 | 18.02 | 35.64 | 52.77 |
| 更大模型(Nc=8, Nf=2) | 20.87 | 40.23 | 57.56 |
| 完整模型(Nc=4, Nf=1) | 20.06 | 40.8 | 57.62 |
四个结论:
- 全局注意力是主要收益。换成参数量相近的卷积,@5° 掉 5.08,三项都大幅退化。
- 1/8 + 1/2 的分辨率组合是划算的。改成 1/16 + 1/4,@5° 掉 3.31,论文说运行速度快约 20%;精度换速度,但论文选择精度。
- 位置编码加一次比每层都加好。@5° 掉 2.04,说明重复注入反而有害。
- 更大模型不划算。Nc=8、Nf=2 的 @5° 高 0.81,但 @10°、@20° 反而略低,参数量和运行时间都明显增加,所以最终用 Nc=4、Nf=1。
运行时间的官方分解(640×480,RTX 2080Ti,100 对 ScanNet 图像平均):
| 阶段 | LoFTR-OT | LoFTR-DS |
|---|---|---|
| Local Feature CNN | 48.2 | 48.2 |
| 粗层 LoFTR | 33.6 | 33.6 |
| 匹配模块 | 21.0 | 12.0 |
| 由粗到细 | 17.2 | 19.7 |
| 总计 | 121 | 116 |
CNN 占了约 40%,粗层 Transformer 约 28%,两者合计三分之二;匹配模块只占 10%–17%。所以这篇论文的「快」主要来自把全局匹配放在 1/8 分辨率、并且用线性注意力;真正的瓶颈是 backbone。补充材料也承认 FPN 的宽度设计有缺陷(stem 和第一阶段都是 128 宽),导致 CNN 偏慢,作者说会在后续模型里修。
这里有一处主文与补充材料的数字冲突:主文写 OT 130 ms、DS 116 ms,补充材料的表 1 写 OT 121 ms、DS 116 ms。DS 两边一致,OT 差 9 ms。论文没有解释,可能是测量批次或模型版本不同。引用时建议以「DS 116 ms、OT 约 121–130 ms」表述,不要只写一个数。
3.6 定性结果
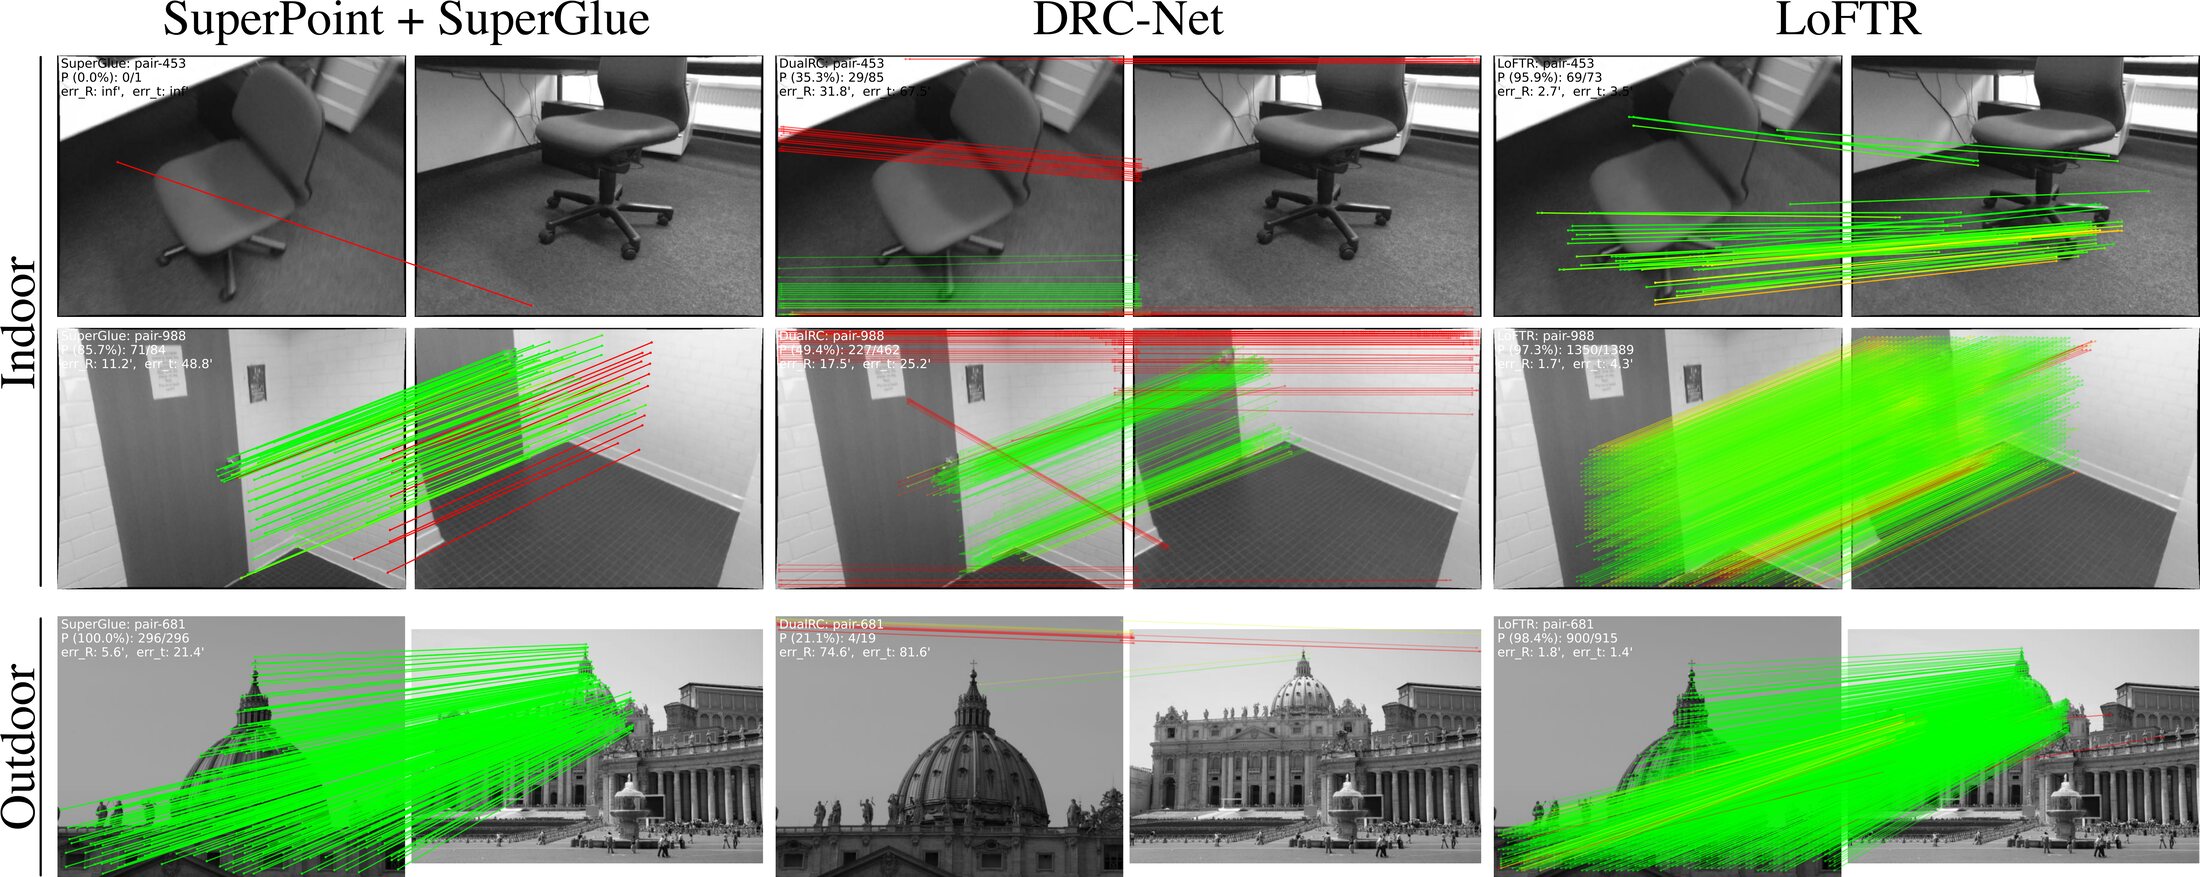
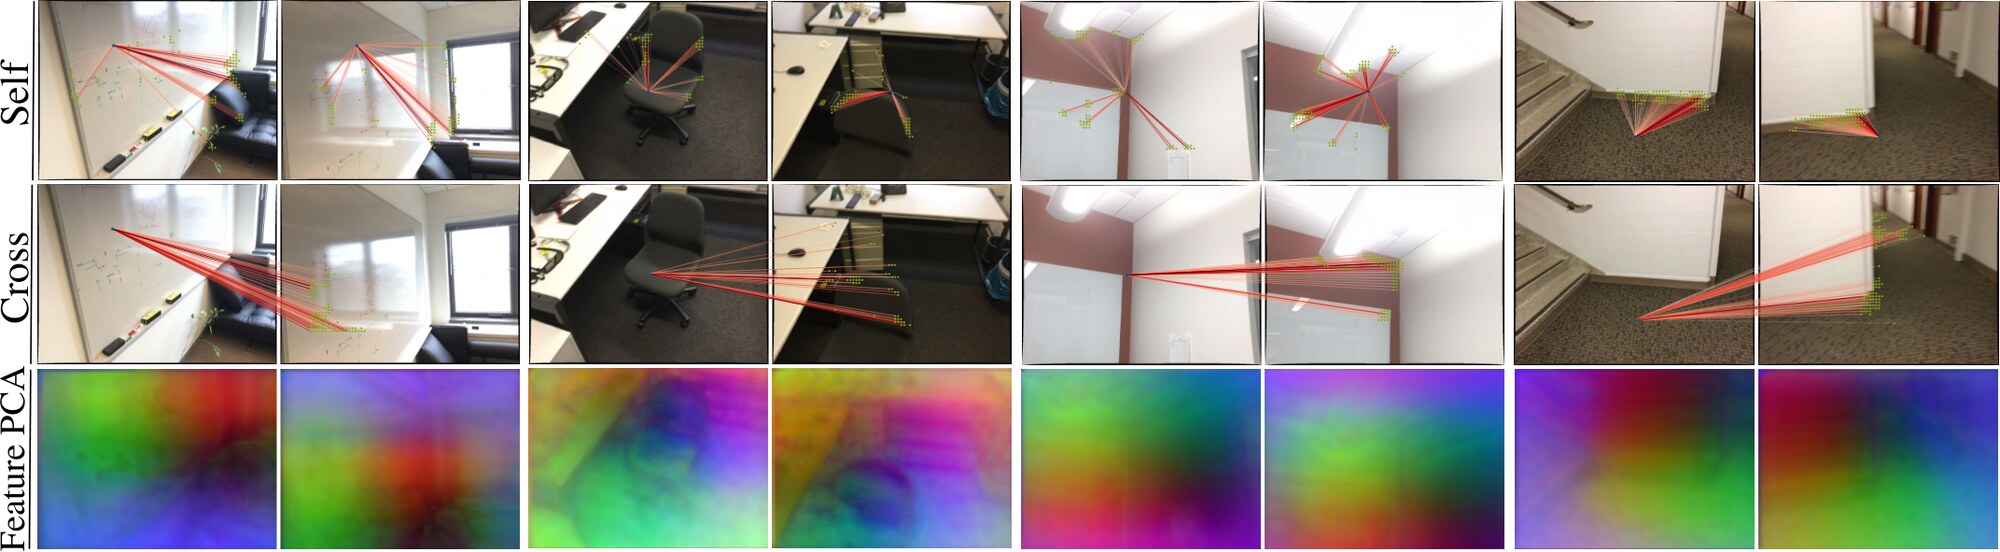
图 4 的信息量比数字更直接:LoFTR 的优势不是「匹配数更多」本身,而是在检测器完全失效的区域还能给出正确匹配。室内椅子那一对,SuperGlue 只给出 1 对匹配,而且是错的;DRC-Net 有 85 个候选,但大量是红色的错误匹配;LoFTR 给出 39 对,全部是内点。室外圣彼得那一对,SuperGlue 的 296 对全对,说明在纹理丰富、视角变化不大的场景里检测器仍然很强;DRC-Net 只有 4 对正确,LoFTR 则有 900 对。换句话说,LoFTR 不是在所有场景都碾压 SuperGlue,而是在 SuperGlue 的盲区里补位。
四、局限性
4.1 论文承认的
这篇论文没有单独的 Limitations 章节。结论里唯一明确的未来工作是「matching images with severe seasonal changes」,也就是说,季节变化没有被评测,作者认为这是下一步。补充材料里还承认了一个实现层面的问题:FPN 的宽度设计有缺陷,导致 Local Feature CNN 偏慢,作者说会在后续模型里修。除此之外,论文没有系统讨论失败模式。
4.2 我自己再补几条
- 它是半稠密,不是稠密。粗层虽然在全部 1/8 网格上算匹配,但最终只输出通过阈值和互最近邻的匹配;一个区域如果在粗层没有高置信度匹配,细层根本不会去看它。所以「无检测器」不等于「每个像素都有对应」,LoFTR 仍然可能漏掉小物体、细结构和低对比区域。
- 细层只能在粗匹配的局部窗口里修正。5×5 窗口在 1/2 分辨率下覆盖 ±4 px,刚好对应 1/8 粗格的量化误差;如果粗匹配本身偏了超过 4 px(大尺度变化、重复纹理、严重遮挡),细层无法把它拉回来,因为真值不在窗口里。窗口是局部的,也没有第二次全局校验。
- 相关矩阵的显存是 O(N²)。线性注意力只降低了 Transformer 的复杂度,粗层相关矩阵仍然是 :640×480 时 ,约 23M 个元素;1200×840 时 ,约 248M 个元素,fp32 下接近 1 GB。高分辨率图像对要么降采样,要么分块,不能直接端到端跑。
- dual-softmax 没有 dustbin。如部件所示,当一个点真的没有对应时,DS 仍会把它推到某个行/列最大值上;阈值 0.2 和互最近邻只是启发式后处理,不能保证拒绝。官方代码的 focal + sparse supervision 分支里也注明,dual-softmax 没有 dustbin,因此不可匹配的 patch 不参与监督——这等于把「拒绝匹配」这件事留给了后处理。
- 颜色信息没有被利用。官方数据和 demo 都读灰度图,backbone 第一层是单通道。对于颜色是主要线索的场景(彩色纹理、光照变化下的色偏),这是一个信息损失;论文没有讨论。
- 域外泛化有限。训练只有 ScanNet(室内)和 MegaDepth(室外),Aachen 夜间在最严阈值只比 SuperGlue 高 1.5 个点,两家在该阈值上的日夜差距仍有 10 个点以上。严重季节变化、跨模态(热红外/可见光)、水下等场景不在评测范围内;后来的 XoFTR 专门做跨模态扩展,也说明 LoFTR 的原始设定不够。
- 复现细节有坑。主文与补充材料的 ScanNet 学习率不一致( vs ),OT 运行时间不一致(130 vs 121 ms),训练脚本默认 640 而论文用 840,代码默认 focal + 稠密监督而论文用 NLL。这些都不影响方法本身,但会让「照着论文复现」的人多走弯路。
五、结论与展望
LoFTR 的核心贡献不是某一个模块,而是把匹配的粒度从「检测到的点」换成「整张图的粗网格」。一旦不再依赖检测器,低纹理和重复结构就不再是「检测不到」的问题,而是「特征够不够有区分度」的问题;Transformer 的全局注意力正好提供了区分度。粗到细则把全局匹配的粗粒度用局部相关补回来,兼顾了速度和亚像素精度。这个组合后来成了无检测器匹配的默认骨架:DKM 换掉了相关计算和匹配头,RoMa/FlexGlue 把稠密匹配做得更彻底,XoFTR 把它搬到跨模态,DUSt3R 干脆绕过匹配直接回归点图[9, 13, 14, 15, 16]。
给实践者的几条建议:
- 默认用 dual-softmax。它更快(matching 12 ms vs 21 ms),在 MegaDepth 上更准,在 ScanNet 上与 OT 打平;只有在需要显式拒绝无匹配点、或者像 InLoc 这样重复结构多的场景里,才值得上 OT。
- 保持训练时的分辨率尺度。室内模型在 640×480 上训练,室外模型在长边 840 上训练;推理时把图像缩放到相近尺度,别直接喂 4K。输入高宽要能被 8 整除。
- 把它当匹配器,不要当定位系统。视觉定位需要 HLoc 这样的完整流程:检索、局部特征、PnP、RANSAC。LoFTR 只负责中间的匹配,且它的输出仍然需要几何验证。
- 高分辨率场景要分块。相关矩阵是 O(N²),不是线性注意力能救的;宁可把大图切成重叠的 tile,也不要把整张图塞进 1/8 网格。
- 需要跨模态、跨季节、稠密点图时,看后续工作。LoFTR 的原始设定是同日同时段的室内/室外图像对;XoFTR、DKM、RoMa、DUSt3R 分别在不同方向上补了它的短板。
六、上手
官方仓库提供了四个预训练权重:indoor_ds、indoor_ot、outdoor_ds、outdoor_ot,每个约 45 MB,放在 README 的 Google Drive 链接里。DS 和 OT 是两套不同的匹配头,权重不能混用;室内权重在 ScanNet 上训练,室外权重在 MegaDepth 上训练。
6.1 安装
完整训练环境用 conda;只跑匹配器的话,装四个包就够。
安装命令(完整环境或仅匹配器)
# 完整环境(PyTorch Lightning 训练器)
conda env create -f environment.yaml
conda activate loftr

# 仅 LoFTR 匹配器
pip install torch einops yacs kornia
如果要跑 OT 分支,还需要把 SuperGlue 的 superglue.py 下载到 src/loftr/utils/。LoFTR 仓库不能直接分发这段代码,原因写在 README 里。
下载 OT 依赖(SuperGlue LICENSE 限制)
cd src/loftr/utils
wget https://raw.githubusercontent.com/magicleap/SuperGluePretrainedNetwork/master/models/superglue.py
6.2 最小推理示例
官方 README 和 demo notebook 的用法如下。注意输入是灰度图、形状 [1, 1, H, W]、数值除以 255,且 H、W 要能被 8 整除;demo 里室内图直接 resize 到 640×480,室外图则把长宽向下取整到 8 的倍数。
用预训练权重跑一对图像
import cv2
import torch
import numpy as np
from src.loftr import LoFTR, default_cfg

matcher = LoFTR(config=default_cfg)
matcher.load_state_dict(torch.load("weights/indoor_ds.ckpt")['state_dict'])
matcher = matcher.eval().cuda()

img0_raw = cv2.imread("assets/scannet_sample_images/scene0711_00_frame-001680.jpg", cv2.IMREAD_GRAYSCALE)
img1_raw = cv2.imread("assets/scannet_sample_images/scene0711_00_frame-001995.jpg", cv2.IMREAD_GRAYSCALE)
img0_raw = cv2.resize(img0_raw, (640, 480))
img1_raw = cv2.resize(img1_raw, (640, 480))

img0 = torch.from_numpy(img0_raw)[None][None].cuda() / 255.
img1 = torch.from_numpy(img1_raw)[None][None].cuda() / 255.
batch = {'image0': img0, 'image1': img1}

with torch.no_grad():
    matcher(batch)
    mkpts0 = batch['mkpts0_f'].cpu().numpy()
    mkpts1 = batch['mkpts1_f'].cpu().numpy()
    mconf = batch['mconf'].cpu().numpy()
6.3 参数与论文概念的对应
default_cfg 里的关键项:
| 配置 | 默认值 | 对应论文 |
|---|---|---|
LOFTR.RESOLUTION | (8, 2) | 粗层 1/8、细层 1/2 |
LOFTR.FINE_WINDOW_SIZE | 5 | |
LOFTR.COARSE.D_MODEL | 256 | 粗特征 256 通道 |
LOFTR.FINE.D_MODEL | 128 | 细特征 128 通道 |
LOFTR.COARSE.LAYER_NAMES | ['self','cross'] * 4 | |
LOFTR.FINE.LAYER_NAMES | ['self','cross'] * 1 | |
MATCH_COARSE.MATCH_TYPE | dual_softmax | 默认 DS |
MATCH_COARSE.DSMAX_TEMPERATURE | 0.1 | 相似度温度 |
MATCH_COARSE.THR | 0.2 | |
MATCH_COARSE.BORDER_RM | 2 | 粗网格边界裁剪 |
MATCH_COARSE.SKH_ITERS | 3 | OT 的 Sinkhorn 迭代次数 |
MATCH_COARSE.SKH_INIT_BIN_SCORE | 1.0 | dustbin 分数初值 |
MATCH_COARSE.SPARSE_SPVS | True | 发布版用 focal + 稠密监督;设 False 回到论文的 NLL |
还有两个容易踩的细节:
COARSE.TEMP_BUG_FIX=True是对早期位置编码实现的一个修正;旧权重需要设成False,否则精度会掉。demo notebook 里专门注释了这一点。MATCH_COARSE.SKH_PREFILTER=False是默认值。打开后推理时会先用 dustbin 的最大值过滤一遍,可能改变匹配数;论文没有用这个开关。
6.4 评测与训练
评测需要先下载 ScanNet-1500 和 MegaDepth-1500 测试集,按 README 建软链接,然后跑 test.py。训练脚本默认 4 张 GPU、batch size 1/GPU、640 分辨率;要复现论文的室外结果,把 TRAIN_IMG_SIZE 改成 840。
评测命令(ScanNet-1500,DS 权重)
ln -s /path/to/scannet-1500-testset/* /path/to/LoFTR/data/scannet/test
ln -s /path/to/megadepth-1500-testset/* /path/to/LoFTR/data/megadepth/test

conda activate loftr
python test.py configs/data/scannet_test_1500.py configs/loftr/loftr_ds.py \
  --ckpt_path weights/indoor_ds.ckpt --profiler_name inference \
  --gpus=1 --accelerator="ddp"
训练命令(MegaDepth 室外 DS,默认 640;论文用 840)
# scripts/reproduce_train/outdoor_ds.sh 里默认:
TRAIN_IMG_SIZE=640
# 复现论文结果改成:
# TRAIN_IMG_SIZE=840

bash scripts/reproduce_train/outdoor_ds.sh
如果不想装完整仓库,LoFTR 已经集成进 kornia(0.5.11 起),可以直接 from kornia.feature import LoFTR。但 kornia 版本的默认配置和权重加载方式与官方仓库略有不同,做论文复现时仍建议用官方代码。
参考
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Rocco, Arandjelović, Sivic. Efficient Neighbourhood Consensus Networks via Submanifold Sparse Convolutions. ECCV 2020. arXiv
- Li, Han, Li, Prisacariu. Dual-Resolution Correspondence Networks. NeurIPS 2020. arXiv
- Carion, Massa, Synnaeve, Usunier, Kirillov, Zagoruyko. End-to-End Object Detection with Transformers. ECCV 2020. arXiv
- Katharopoulos, Vyas, Pappas, Fleuret. Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. ICML 2020. arXiv
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. CVPR 2019. arXiv
- Taira, Okutomi, Sattler, Cimpoi, Pollefeys, Sivic, Pajdla, Torii. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. CVPR 2018. arXiv
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Tuzcuoğlu, Köksal, Sofu, Kalkan, Alatan. XoFTR: Cross-modal Feature Matching Transformer. CVPR Workshops 2024. arXiv
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Lindenberger, Sarlin, Miksik, Pollefeys. FlexGlue: Sparse-to-Dense Feature Matching and Visual Disambiguation. arXiv 2610.32976, 2026. arXiv · 代码