· 98 min read
论文解读:ALIKED,在稀疏关键点上做可变形描述
TL;DR ALIKED 是 ALIKE 的「减法」版本[1]:它不再先算一张稠密的描述子图(DMH)再在关键点处采样,而是把描述子头换成 SDDH——对每个关键点,从 特征块预测 个采样位置,双线性采样后聚合。这样描述子的计算量只与关键点数 成正比,而不是与像素数 成正比;Tiny 版只有 0.192M 参数、1.37 GFLOPs,在 640×480、1K 关键点、RTX 2060 上达到 125.87 FPS,HPatches MHA@3 78.70,是所有对比方法中最高的(MMA@3 72.99,最高的是 DISK 的 77.59)。更关键的是,SDDH 只产出稀疏描述子,作者顺势把 NRE 损失从稠密概率图松弛成关键点上的稀疏分类,训练显存从 11.1 GB 降到 3.2 GB(480²、batch 1),这才允许他们在 800² 分辨率上继续训练。推理代码和权重已开源(BSD-3-Clause);训练代码官方明确不公开,只能参考 ALIKE 的训练代码。
- 论文:ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation,Xiaoming Zhao、Xingming Wu、Weihai Chen、Peter C. Y. Chen、Qingsong Xu、Zhengguo Li,IEEE Transactions on Instrumentation and Measurement 72:1–16, 2023,DOI:10.1109/TIM.2023.3271000。
- 代码:github.com/Shiaoming/ALIKED(BSD-3-Clause,仓库自带
aliked-t16/aliked-n16/aliked-n16rot/aliked-n32四个权重;只含推理,训练代码不公开)。 - 前作/生态:ALIKE 是本文的直接前作,SuperPoint 是 map-based 方法的代表,LightGlue 是常见的下游匹配器。
一、动机:描述子为什么需要「可变形」
过去几年主流的联合关键点/描述子网络,基本都可以归为 map-based:网络有两个头,一个分数图头(Score Map Head, SMH)和一个描述子图头(Descriptor Map Head, DMH),先算出一张稠密的分数图和一张稠密的描述子图,再在分数图上检测关键点,在描述子图的对应位置采样出描述子[2, 3, 4, 5, 6]。SuperPoint、D2-Net、R2D2、DISK、ALIKE 都是这个范式。它的问题是:描述子图要在每个像素上做卷积,而绝大多数像素并不会成为关键点,这些计算是冗余的;反过来,为了省算力而把描述子图降采样或做轻量卷积,又会削弱描述子的表达能力。
ALIKE 已经把这条路线做得很轻:它的检测器可微,描述子头也很省,但描述子仍然是从稠密描述子图的单个位置采样出来的。单个位置的感受野由骨干网络决定,遇到旋转、尺度、视角变化时,同一个三维点在两幅图里可能落在不同的局部结构上,单点采样没有额外的自由度去对齐这些结构。换句话说,ALIKE 的「轻」是靠压缩描述子图换来的,代价是描述子的几何不变性。
另一条思路是显式建模几何变换。SIFT 估计关键点的尺度和方向,AffNet、LF-Net、GIFT 等方法估计局部仿射参数,再对图像块做变换[7]。仿射变换可以写成
其中 、。它只有 6 个自由度,能描述旋转、缩放、剪切,但描述子局部形状的变化往往比仿射更复杂。更一般的写法是给每个像素一个偏移:
式 (2) 的自由度等于像素数,因而可以表达任意局部形变。可变形卷积(Deformable Convolution, DCN)就是把这件事学出来:在每个卷积采样位置 上再加一个可学习的偏移 ,
其中 是卷积权重[8]。DCN 能提升几何不变性,ASLFeat 已经在稠密特征提取里用了它[9];但如果在稠密描述子图上用 DCN,偏移估计和可变形卷积都要在 个位置上做,计算量会进一步膨胀。
ALIKED 的观察很直接:既然只需要 个关键点的描述子,为什么要在 个像素上算可变形描述子? 关键点数通常远小于像素数,如果能把 DCN 的「偏移 + 采样 + 聚合」搬到每个关键点的局部块上,就能在很小的计算预算里获得可变形能力。这就是 SDDH(Sparse Deformable Descriptor Head)的出发点。论文把贡献列为三条:
- 提出 SDDH,只在稀疏关键点上提取可变形描述子,减少冗余计算,并能建模任意几何变换;
- 用 SDDH 构建 ALIKED,并把 NRE 损失从稠密松弛到稀疏,使稀疏描述子也能用 NRE 训练,同时降低训练时的冗余计算和显存;
- 在图像匹配、三维重建、视觉重定位等视觉测量任务上验证有效性。
二、核心方法
2.1 总体架构:编码、聚合、检测、描述
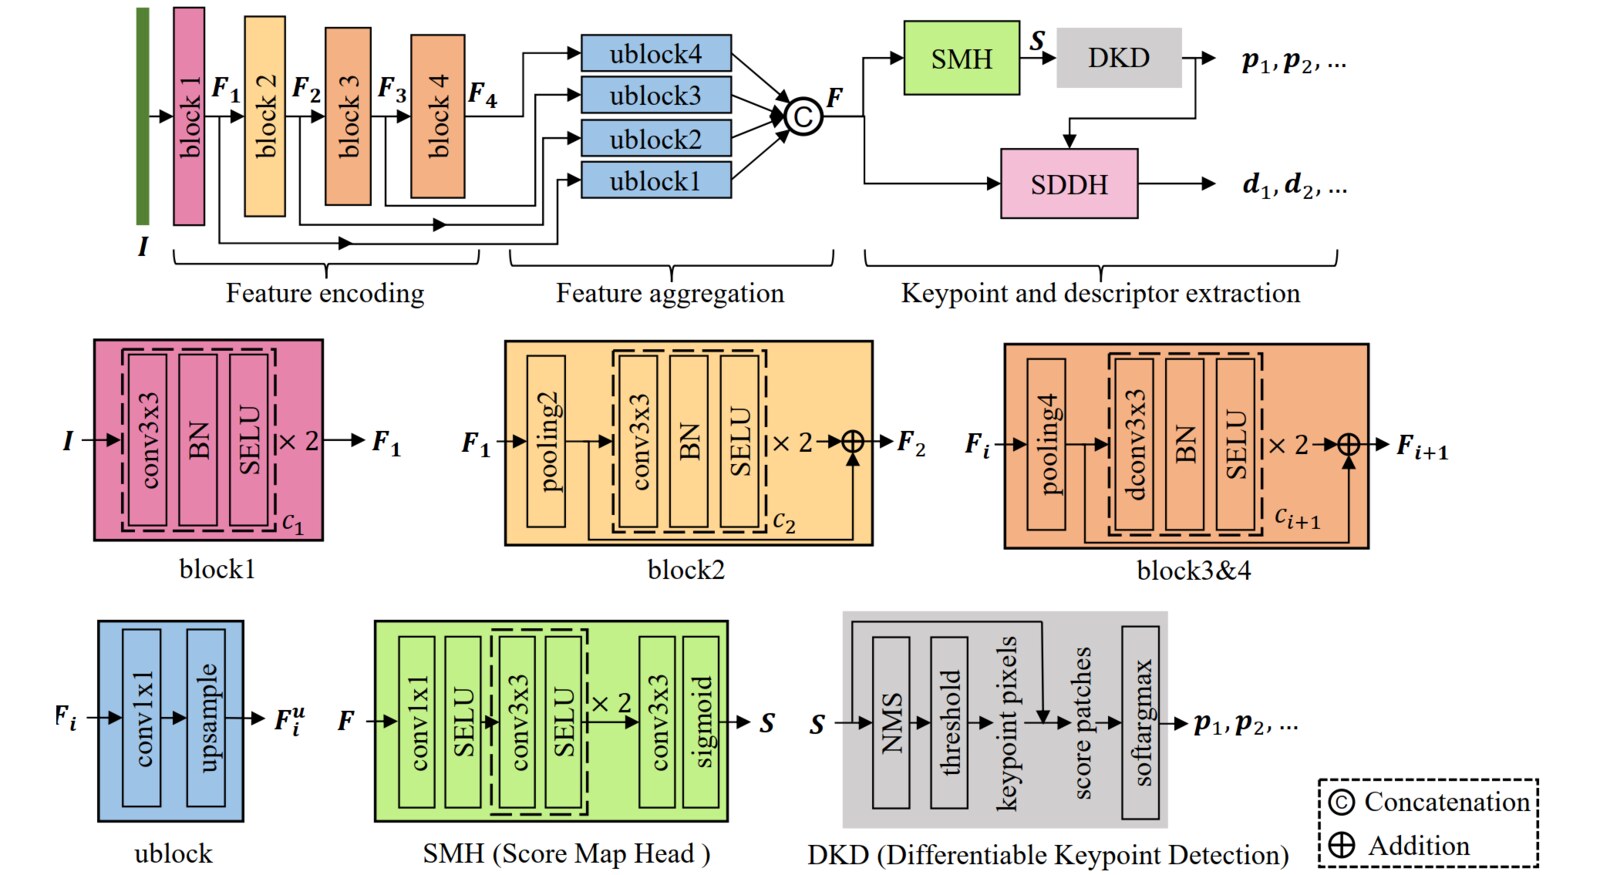
特征编码。 输入图像 经过四个 block:
- block1 是两个 卷积 + BN + SELU,输出 ,通道数 ,分辨率 ;
- block2 先做 平均池化,再经过一个 ResBlock(两个 卷积 + BN,残差连接),输出 ,通道 ,分辨率 ;
- block3 先做 平均池化,再经过一个 ResBlock,但两个 卷积换成 DCN,输出 ,通道 ,分辨率 ;
- block4 同样先 平均池化,再经过一个带 DCN 的 ResBlock,输出 ,通道 ,分辨率 。
这里有两个设计选择值得注意。第一,激活函数用 SELU 而不是 ReLU[10]:SELU 自归一化,配合 BN 能让训练更稳;论文的消融里,把 max-pooling 换成 average-pooling、ReLU 换成 SELU,IMW 的 mAA@10° 提升了 3.43%,但其他指标提升有限。第二,DCN 只放在 block3 和 block4:前两个 block 的分辨率高,放 DCN 计算代价太大;而且前两个 block 主要负责低层特征,可变形建模的收益不如后两个 block。
特征聚合。 四个尺度的特征先各自经过一个 卷积压到 通道,再用双线性上采样对齐到 ,最后拼接成 通道的 。拼接后的 一路送进 SMH 预测分数图,另一路送进 SDDH 提取描述子。SMH 的结构是 、SELU、、SELU、、SELU、、sigmoid;比 ALIKE 的单个 分数头更深,因为 ALIKED 不再需要稠密描述子图,省下来的算力可以分给检测器。
关键点检测。 DKD(Differentiable Keypoint Detection)先在分数图上做 NMS(半径 2),再按阈值或 top-k 选出关键点;然后在一个 的分数块上做 soft-argmax,把关键点细化到亚像素,并计算 dispersity。关键点坐标最终归一化到 ,方便后续 grid_sample。DKD 的细节和代码放在本节末尾。
模型配置。 论文表 II 给出 Tiny / Normal / Large 三档通道宽度;实际发布的是四个配置,其中 aliked-t16 / aliked-n16 / aliked-n16rot 的 ,aliked-n32 的 。参数量、GFLOPs、FPS 来自论文表 IV(640×480、1K 关键点、RTX 2060):
| 模型 | / / / | dim | 参数量 | GFLOPs | FPS | ||
|---|---|---|---|---|---|---|---|
| ALIKED-T(16) | 8 / 16 / 32 / 64 | 64 | 3 | 16 | 0.192M | 1.37 | 125.87 |
| ALIKED-N(16) | 16 / 32 / 64 / 128 | 128 | 3 | 16 | 0.677M | 4.05 | 77.40 |
| ALIKED-N(32) | 16 / 32 / 64 / 128 | 128 | 3 | 32 | 0.980M | 4.62 | 75.64 |
aliked-n16rot 的结构和 aliked-n16 相同,只是训练时加了旋转增强,用来提升旋转不变性;论文没有单独报告它的参数量和 FPS。
下面这段是官方仓库 nets/soft_detect.py 中 DKD 的核心实现,包含 NMS 后的亚像素 soft-argmax、分数采样和 dispersity 计算。注意 max_v 被 detach() 了:soft-argmax 的权重来自分数块,但最大值本身不回传梯度,避免在关键点位置和分数图之间形成不希望的循环。
代码:DKD 的亚像素关键点检测(官方 nets/soft_detect.py,原文节选)
        wh = torch.tensor([w - 1, h - 1],device=scores_nograd.device)

        keypoints = []
        scoredispersitys = []
        kptscores = []
        if sub_pixel:
            # detect soft keypoints with grad backpropagation
            patches = self.unfold(scores_map)  # B x (kernel**2) x (H*W)
            self.hw_grid = self.hw_grid.to(scores_map)  # to device
            for b_idx in range(b):
                patch = patches[b_idx].t()  # (H*W) x (kernel**2)
                indices_kpt = indices_keypoints[b_idx]  # one dimension vector, say its size is M
                patch_scores = patch[indices_kpt]  # M x (kernel**2)
                keypoints_xy_nms = torch.stack(
                    [indices_kpt % w,
                     torch.div(indices_kpt, w, rounding_mode='trunc')],
                    dim=1)  # Mx2

                # max is detached to prevent undesired backprop loops in the graph
                max_v = patch_scores.max(dim=1).values.detach()[:, None]
                x_exp = ((patch_scores - max_v) / self.temperature).exp()  # M * (kernel**2), in [0, 1]

                # \frac{ \sum{(i,j) \times \exp(x/T)} }{ \sum{\exp(x/T)} }
                xy_residual = x_exp @ self.hw_grid / x_exp.sum(dim=1)[:, None]  # Soft-argmax, Mx2

                hw_grid_dist2 = torch.norm((self.hw_grid[None, :, :] - xy_residual[:, None, :]) / self.radius,
                                           dim=-1) ** 2
                scoredispersity = (x_exp * hw_grid_dist2).sum(dim=1) / x_exp.sum(dim=1)

                # compute result keypoints
                keypoints_xy = keypoints_xy_nms + xy_residual
                keypoints_xy = keypoints_xy / wh * 2 - 1  # (w,h) -> (-1~1,-1~1)

                kptscore = torch.nn.functional.grid_sample(scores_map[b_idx].unsqueeze(0),
                                                           keypoints_xy.view(1, 1, -1, 2),
                                                           mode='bilinear', align_corners=True)[0, 0, 0, :]  # CxN

                keypoints.append(keypoints_xy)
                scoredispersitys.append(scoredispersity)
                kptscores.append(kptscore)
        else:
            for b_idx in range(b):
                indices_kpt = indices_keypoints[b_idx]  # one dimension vector, say its size is M
                # To avoid warning: UserWarning: __floordiv__ is deprecated
                keypoints_xy_nms = torch.stack(
                    [indices_kpt % w,
                     torch.div(indices_kpt, w, rounding_mode='trunc')],
                    dim=1)  # Mx2
                keypoints_xy = keypoints_xy_nms / wh * 2 - 1  # (w,h) -> (-1~1,-1~1)
                kptscore = torch.nn.functional.grid_sample(scores_map[b_idx].unsqueeze(0),
                                                           keypoints_xy.view(1, 1, -1, 2),
                                                           mode='bilinear', align_corners=True)[0, 0, 0, :]  # CxN
                keypoints.append(keypoints_xy)
                scoredispersitys.append(kptscore)  # for jit.script compatability
                kptscores.append(kptscore)

        return keypoints, scoredispersitys, kptscores
2.2 SDDH:把描述子头从「稠密图」改成「每个关键点的 M 个采样」
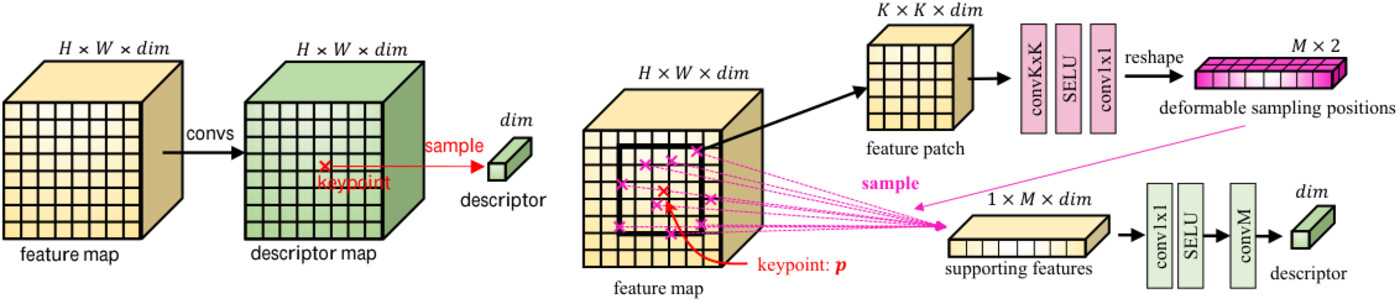
convK×K → SELU → conv1×1 预测 个采样位置,在特征图上双线性采样 个支撑特征,再用 1×1 conv + SELU + convM 聚合描述子。从仿射到可变形。 前面式 (1) 的仿射变换只有 6 个自由度,式 (2) 的可变形变换自由度等于像素数,能描述更一般的局部形变。DCN 用式 (3) 在固定 网格上学习每个采样位置的偏移,但它是在稠密特征图上做的:偏移估计和可变形卷积都随 增长。SDDH 把这件事限制在每个关键点的局部块上,并且不再使用固定的 采样网格,而是学习 个任意位置。
偏移预测。 对关键点 ,先从特征图 取出一个 的特征块 ,然后
其中 。实现上,convK×K 没有 padding,输出 个通道;conv1×1 也是 ,最后 reshape 成 个二维偏移。 和 都是超参: 控制取块大小, 控制采样位置的数量; 可以是任意正整数,不受 限制,这是 SDDH 比 DCN 更灵活的地方。
采样与聚合。 对第 个采样位置,在 处做双线性采样,得到支撑特征,再经过一个 卷积和 SELU:
最后对 做 L2 归一化。论文把 写成聚合权重,代码里它其实是每个采样位置一个 的矩阵(agg_weights,形状 ),用 einsum('ncp,pcd->nd', features, agg_weights) 实现。也就是说,SDDH 不是简单地把 个特征加权平均,而是让每个采样位置先经过自己的线性变换再相加,表达能力比标量加权更强。
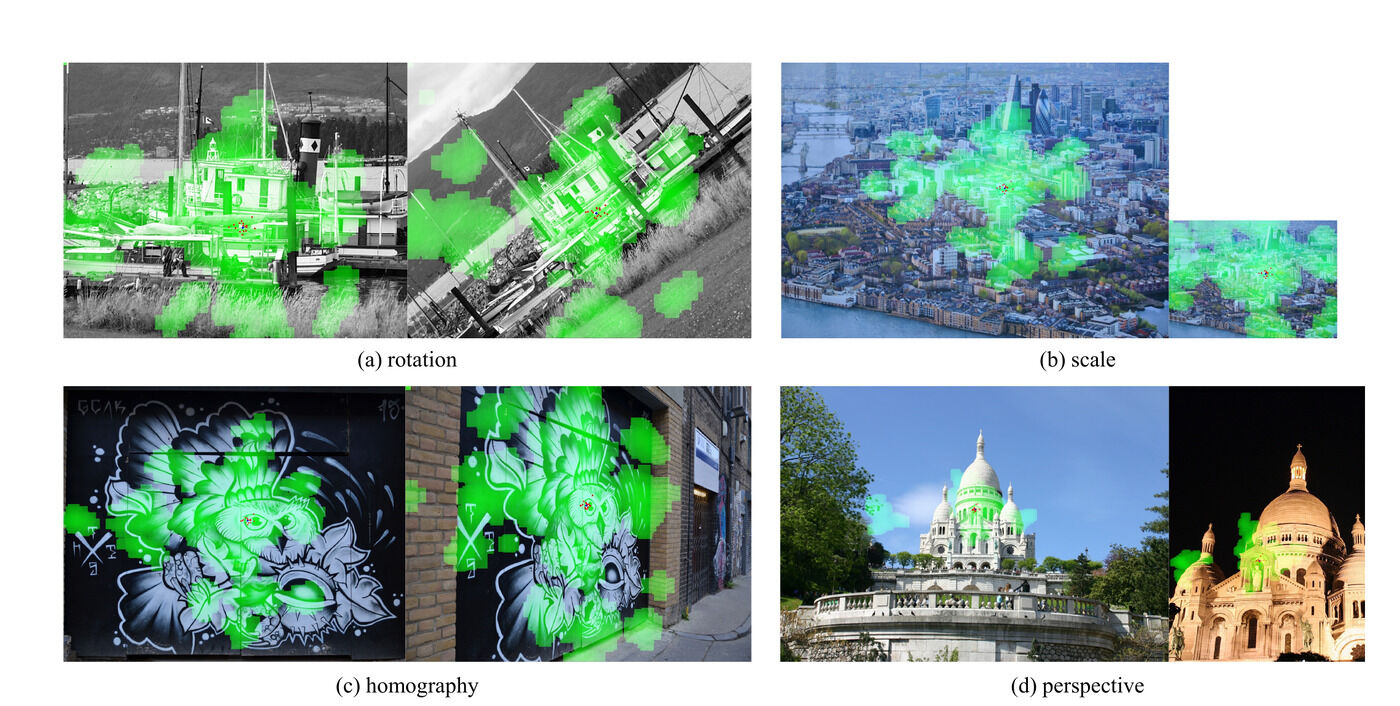
偏移怎么监督? 论文没有给偏移任何显式监督,也没有偏移正则项;偏移网络和描述子头一起端到端训练,梯度来自描述子损失(稀疏 NRE、reliable loss 等)。代码里唯一的约束是 offset.clamp(-max_offset, max_offset),其中 max_offset = max(h, w) / 4,防止偏移在训练早期跑到特征图外面。论文图 7 的可视化显示,训练后的采样位置会跟着旋转、尺度、单应、视角变化移动,说明描述子损失确实能把偏移“推”到有用的位置;但这也意味着偏移质量依赖训练数据和损失,论文没有分析偏移分布或失败模式。
和 DCN 的区别。 可以概括为四点:
- 作用对象不同:DCN 在稠密特征图上做可变形卷积;SDDH 只在稀疏关键点上采样,计算量与关键点数 成正比,而不是与像素数 成正比。
- 采样网格不同:DCN 的采样位置是固定的 网格加偏移;SDDH 是 个任意位置, 可以和 无关。
- 聚合方式不同:DCN 用卷积权重聚合;SDDH 先对每个采样特征做 变换,再用每个位置独立的 矩阵聚合。
- 监督方式不同:DCN 的偏移由任务损失端到端学习;SDDH 的偏移也由描述子损失端到端学习,但没有显式偏移监督,只有 clamp 约束。
SDDH 的完整实现如下,核心是三步:offset_conv 从 特征块预测 个偏移,grid_sample 在偏移位置双线性采样,einsum 用每个位置独立的 矩阵聚合。
代码:稀疏可变形描述子头 SDDH(官方 nets/blocks.py,原文照录)
class SDDH(nn.Module):

    def __init__(self, dims: int, kernel_size: int=3, n_pos: int=8, gate=nn.ReLU(), conv2D=False, mask=False):

        super(SDDH, self).__init__()
        self.kernel_size = kernel_size
        self.n_pos = n_pos
        self.conv2D = conv2D
        self.mask = mask

        self.get_patches_func = get_patches.apply if with_compiled_get_patches else get_patches_lg

        # estimate offsets
        self.channel_num = 3 * n_pos if mask else 2 * n_pos
        self.offset_conv = nn.Sequential(
            nn.Conv2d(dims, self.channel_num, kernel_size=kernel_size, stride=1, padding=0, bias=True), gate,
            nn.Conv2d(self.channel_num, self.channel_num, kernel_size=1, stride=1, padding=0, bias=True))

        # sampled feature conv
        self.sf_conv = nn.Conv2d(dims, dims, kernel_size=1, stride=1, padding=0, bias=False)

        # convM
        if not conv2D:
            # deformable desc weights
            agg_weights = torch.nn.Parameter(torch.rand(n_pos, dims, dims))
            self.register_parameter('agg_weights', agg_weights)
        else:
            self.convM = nn.Conv2d(dims*n_pos, dims, kernel_size=1, stride=1, padding=0, bias=False)


    def forward(self, x, keypoints):
        # x: [B,C,H,W]
        # keypoints: list, [[N_kpts,2], ...] (w,h)
        b, c, h, w = x.shape
        wh = torch.tensor([[w - 1, h - 1]], device=x.device)
        max_offset = max(h, w) / 4.

        offsets = []
        descriptors = []
        # get offsets for each keypoint
        for ib in range(b):
            xi, kptsi = x[ib], keypoints[ib]
            kptsi_wh = (kptsi / 2 + 0.5) * wh
            N_kpts = len(kptsi)

            if self.kernel_size>1:
                patch = self.get_patches_func(xi, kptsi_wh.long(), self.kernel_size)  # [N_kpts, C, K, K]
            else:
                kptsi_wh_long = kptsi_wh.long()
                patch = xi[:, kptsi_wh_long[:, 1], kptsi_wh_long[:, 0]].permute(1,0).reshape(N_kpts,c,1,1)

            offset = self.offset_conv(patch).clamp(-max_offset, max_offset)  # [N_kpts, 2*n_pos, 1, 1]
            if self.mask:
                offset = offset[:, :, 0, 0].view(N_kpts, 3, self.n_pos).permute(0, 2, 1)  # [N_kpts, n_pos, 3]
                offset = offset[:,:,:-1]  # [N_kpts, n_pos, 2]
                mask_weight = torch.sigmoid(offset[:,:,-1]) # [N_kpts, n_pos]
            else:
                offset = offset[:, :, 0, 0].view(N_kpts, 2, self.n_pos).permute(0, 2, 1)  # [N_kpts, n_pos, 2]
            offsets.append(offset)  # for visualization

            # get sample positions
            pos = kptsi_wh.unsqueeze(1) + offset  # [N_kpts, n_pos, 2]
            pos = 2.0 * pos / wh[None] - 1
            pos = pos.reshape(1, N_kpts * self.n_pos, 1, 2)

            # sample features
            features = F.grid_sample(xi.unsqueeze(0), pos, mode='bilinear',
                                     align_corners=True)  # [1,C,(N_kpts*n_pos),1]
            features = features.reshape(c, N_kpts, self.n_pos, 1).permute(1, 0, 2, 3)  # [N_kpts, C, n_pos, 1]
            if self.mask:
                features = torch.einsum('ncpo,np->ncpo', features, mask_weight)

            features = torch.selu_(self.sf_conv(features)).squeeze(-1)  # [N_kpts, C, n_pos]
            # convM
            if not self.conv2D:
                descs = torch.einsum('ncp,pcd->nd', features, self.agg_weights)  # [N_kpts, C]
            else:
                features = features.reshape(N_kpts, -1)[:,:,None,None]  # [N_kpts, C*n_pos, 1, 1]
                descs = self.convM(features).squeeze() # [N_kpts, C]

            # normalize
            descs = F.normalize(descs, p=2., dim=1)
            descriptors.append(descs)

        return descriptors, offsets
官方仓库里的 DCN 实现很简短,可以和 SDDH 对照着看:它用 offset_conv 预测 个偏移,clamp 后直接调用 torchvision.ops.deform_conv2d,聚合仍然是一次稠密卷积。
代码:主干里的可变形卷积(官方 nets/blocks.py,原文节选)
    def forward(self, x):
        h, w = x.shape[2:]
        max_offset = max(h, w) / 4.

        out = self.offset_conv(x)
        if self.mask:
            o1, o2, mask = torch.chunk(out, 3, dim=1)
            offset = torch.cat((o1, o2), dim=1)
            mask = torch.sigmoid(mask)
        else:
            offset = out
            mask = None
        offset = offset.clamp(-max_offset, max_offset)
        x = torchvision.ops.deform_conv2d(input=x,
                                          offset=offset,
                                          weight=self.regular_conv.weight,
                                          bias=self.regular_conv.bias,
                                          padding=self.padding,
                                          mask=mask)
        return x
效率。 论文表 III 在 的特征图上比较了 DMH 和 SDDH。DMH 的卷积复杂度是 ,采样是 ;SDDH 的偏移估计是 ,采样是 ,描述子提取是 。直观地说,DMH 的卷积随像素数增长,SDDH 的所有项都随关键点数 增长。
| 方法 | 配置 | 偏移/卷积 | 采样 | 描述子 | 总时间 |
|---|---|---|---|---|---|
| DMH | 130.86G, 50.79ms | 2.56M, 1.06ms | — | 51.85ms | |
| SDDH | 812.50M, 3.42ms | 64.00M, 1.56ms | 4096.00M, 2.62ms | 7.60ms | |
| DMH | 50.33G, 14.42ms | 2.56M, 0.28ms | — | 14.70ms | |
| SDDH | 21.06M, 0.58ms | 4.61M, 0.30ms | 294.91M, 0.37ms | 1.25ms |
表 III 的重新排版:GFLOPs 与运行时间按阶段列出,最后一列是相加后的总时间。 时 SDDH 比 DMH 快约 6.8 倍, 时快约 11.8 倍;FLOPs 的差距更大(约 26 倍和 157 倍),说明实际加速受内存访问和 kernel 开销限制。
注意,表 III 为了让 DMH 和 SDDH 可比,令 SDDH 的 ;实际模型的 或 , 比 大,采样点更多,但由于 远小于 ,总计算量仍然很低。另一个容易被忽略的点是:SDDH 的参数量并不一定比 ALIKE 少。ALIKED-N16 有 0.677M 参数,ALIKE-N 只有 0.318M;ALIKED 的“轻”主要体现在 GFLOPs 和运行时间,Tiny 版才是参数和计算都小。
下面这个部件把 SDDH 的支撑区域做成可拖动的玩具模型。拖动 和偏移半径,看凸包从一个点扩张成一片区域;切换“限制在 内”和“允许越出”,可以对比普通局部描述子和 SDDH 的差别。真实网络的偏移由每个关键点的 特征块预测,方向不是均匀随机的;这里的随机采样只是为了把“支撑区域随 和偏移范围变化”这件事可视化。
怎么读这个部件:默认 、偏移半径 2.2 格,凸包明显大于 的 patch,说明 SDDH 的支撑区域不是固定的局部网格。把 拉到 1 或把半径拉到 0,支撑区域退化为一个点,描述子只能看一个位置;把 M 拉到 32、半径拉大,凸包覆盖更多结构,但真实模型不会无限加大: 越多,描述子头的计算和显存越高,论文最终选 (N16)或 (N32)是精度和速度的折中。切到“限制在 K×K 内”,凸包被压回 patch,这时它更接近普通局部描述子;SDDH 的收益来自允许采样位置越出这个固定网格。
2.3 损失函数:稀疏 NRE 是全文最值得读的「松弛」
ALIKED 的总体损失是四项加权和:
其中 、、、。 的权重小,是因为 dispersity loss 只作用在一维分数图上,容易优化; 的权重大,是因为描述子匹配是高维问题,需要更强的信号。
重投影损失。 给定图像对 ,把 中的关键点 用深度 、旋转 、平移 投影到 :
其中 是三维点到图像平面的投影。在 中找距离 最近、且小于 像素的关键点 作为匹配点;再反过来把 投影回 ,得到 。重投影损失是双向 L1:
这一项直接训练关键点位置,是 DKD 可微设计存在的理由。
Dispersity 峰值损失。 对关键点 取一个 的分数块 ,用 softmax 把分数变成权重,再算权重到关键点中心的平均距离:
其中 , 是块内坐标。这个损失希望分数峰值尽量集中在关键点中心,而不是在一片区域里摊平;它只作用于分数图,所以权重可以小一些。
稀疏 NRE。 这是 ALIKED 相对 ALIKE 最关键的变化。先回顾 NRE:如果把描述子匹配看成一个分类问题,重投影概率 是“哪个位置是匹配点”的目标分布,匹配概率 是网络预测的分布,NRE 用交叉熵让两者接近[11]。ALIKE 在稠密描述子图上做这件事: 是通过双线性插值得到的、覆盖整张图的概率图, 是对整张描述子图的 softmax;好处是每个像素都参与,监督信号密集;坏处是要保留描述子图、计算整张匹配概率图,显存和计算都很重。
ALIKED 的 SDDH 只产出 个稀疏描述子,根本没有描述子图可用。作者的做法是把概率图从稠密“松弛”到稀疏:设 中关键点 的描述子为 , 中所有关键点的描述子矩阵为 ,先算相似度向量
再把它变成匹配概率向量:
其中 控制分布的尖锐程度。重投影概率 则退化成一个二值向量:在 的关键点集合里,匹配点那一项为 1,其余为 0。于是稀疏 NRE 就是这两个向量的交叉熵:
其中 是匹配关键点的描述子。对两个方向的关键点取平均,就得到总的 。
这里有几个值得停下来想的细节:
- 为什么可以这样松弛? 因为分类的候选集合从“所有像素”变成了“所有检测到的关键点”。 不再需要双线性插值出四个邻居的权重,也不需要为背景像素准备一个 outlier 项;它就是一个 one-hot 向量。代价是负样本变少了:稠密 NRE 会压低整张图上所有非匹配像素的相似度,稀疏 NRE 只压低其他关键点的相似度。
- 式 (10) 里的减 1 是常数偏移。 因为所有候选项都减同一个 1,softmax 的排序和概率完全不变;它的作用主要是把“完美匹配的相似度 = 1”平移到 0,方便数值上的理解。真正影响分布的是温度 。
- 和 ALIKE 的 NRE 差在哪? ALIKE 的 是稠密概率图, 是稠密描述子图上的 softmax;ALIKED 的 是稀疏 one-hot, 是 个关键点上的 softmax。两者都是交叉熵,但候选集合和梯度覆盖范围完全不同。
- 和 SuperPoint 的描述子损失差在哪? SuperPoint 用合成单应生成描述子单元对,对正/负对做 hinge loss:,其中 、、[2]。它是成对度量学习,对每个描述子单元对都算损失;ALIKED 的稀疏 NRE 是对关键点集合的 softmax 分类,目标来自重投影,不是合成单应。两者都能拉近匹配描述子、推远非匹配描述子,但监督的构造方式不同。
- 为什么只优化选中的点? 因为描述子只在关键点上存在;密集像素的描述子既没有被提取,也没有参与匹配。把损失限制在关键点上,既符合 SDDH 的输出形式,也避免了在无关键点区域做无用功。
Reliable 损失。 分数图给出“这个像素像不像关键点”,但低纹理区域的点即使分数高也不可靠。R2D2 已经提出可靠性建模,ALIKED 用一个基于匹配相似度的可靠性权重来约束分数:
其中 , 是所有关键点分数之和。严格说,式 (12) 输出的是 上每个关键点的匹配概率向量,式 (13) 里的 实际取的是其中与 对应的那个分量;论文没有显式写出这一步。直观理解:如果 在 中很容易找到相似描述子( 高),那么它的分数 应该高;如果 低,分数应该低。和 ALIKE 不同,ALIKED 只用 约束 ,因为它只建模 侧的可靠性。这个损失让分数图倾向于选择那些“描述子确实可匹配”的点,而不是纹理丰富但重复性差的点。
稀疏 NRE 的代价:表 VIII 的诚实读法。 论文在表 VIII 里直接比较了稠密 NRE 和稀疏 NRE。在相同 480²、只用 MegaDepth 的设置下:
| 训练设置 | NRE | 显存 | HPatches MMA@3 | MHA@3 | MS@3 | IMW mAA@10° | MS@3 |
|---|---|---|---|---|---|---|---|
| 480², MegaDepth | 稠密 | 11.1 GB | 64.87 | 74.26 | 36.56 | 60.62 | 86.19 |
| 480², MegaDepth | 稀疏 | 3.2 GB | 63.55 | 72.78 | 32.63 | 56.51 | 83.60 |
| 800², MegaDepth | 稀疏 | 7.2 GB | 61.77 | 71.67 | 31.98 | 60.19 | 86.47 |
| 800², MegaDepth + 单应 | 稀疏 | 9.6 GB | 70.72 | 75.93 | 44.24 | 54.43 | 83.51 |
表 VIII 的重新排版。注意最后两行不是“稀疏 NRE 更好”,而是“稀疏 NRE 省下的显存允许换更高分辨率和更多训练数据”。
这张表要这么读:
- 同等分辨率下,稀疏 NRE 确实更差:480² 时 MMA 低 1.32、MHA 低 1.48、MS 低 3.93、IMW mAA@10° 低 4.11、MS 低 2.59。论文也明确说“dense NRE loss is better than the sparse NRE loss”,但 SDDH 只有稀疏描述子,稠密 NRE 用不了。
- 稀疏 NRE 的价值是显存:11.1 GB → 3.2 GB,省下来的显存让作者能把分辨率从 480² 提到 800²(7.2 GB),或者加入单应数据(9.6 GB)。800² + 单应这一行在 HPatches 上大幅提升(70.72/75.93/44.24),但 IMW mAA@10° 反而降到 54.43——论文的解释是基线网络不够强,同时建模单应和透视图像会互相牵制。所以最终模型是一个多目标折中,不能把 70.72 和 64.87 直接当成“稀疏 NRE 比稠密 NRE 强”的证据。
- 显存节省不是线性的:候选数从 230400 降到几百/几千,但显存只从 11.1 GB 降到 3.2 GB,因为骨干网络、特征图和训练中间量仍然占大头。稀疏 NRE 省掉的是描述子图和匹配概率图这部分,不是全部。
下面这个部件把“稠密 vs 稀疏”的梯度覆盖画出来。左边是稠密 NRE:12×12 的每个格子都进入 softmax,真值匹配用红框标出;右边是稀疏 NRE:只有 个关键点进入 softmax,其余格子不参与。拖动 看覆盖范围怎么变;显存数字固定为论文表 VIII 的 11.1 GB / 3.2 GB,它不随这个玩具的 改变。
怎么读这个部件:默认 ,右图只有不到五分之一的格子参与 softmax,左图则是全图参与。把 拉到 4,稀疏 NRE 的负样本非常少,softmax 的分母很小,匹配问题变得更“容易”但也更容易过拟合;把 拉到 144,右图覆盖全图,但真实场景中关键点数仍然远小于像素数。显存数字来自论文表 VIII 的 480² 设置,它不随这个 12×12 玩具的 改变;这个部件想说明的是梯度覆盖范围,不是显存的精确 scaling。
训练代码没有开源。 官方 README 写得很明确:“I am sorry that I am not allowed to publish the training code of ALIKED, you can refer to the training code of ALIKE.” 因此本文不贴稀疏 NRE 的训练实现,也不写伪代码;上面式 (9)–(11) 是论文给出的完整定义,代码层面只能参考 ALIKE 的训练代码。这一点在读论文时很重要:稀疏 NRE 的可复现性没有被官方代码背书,表 VIII 的数字只能按论文的协议理解。
三、实验结果
3.1 训练与评测设置
训练数据来自两部分:
- MegaDepth[12]:135 个场景,每个场景 10K 对图像;用 COLMAP 重建深度和位姿,排除 IMW2020 验证/测试场景。这部分提供透视图像对。
- R2D2 的合成单应数据[4]:Oxford / Paris 检索数据集、Aachen 数据集,以及 Aachen 的风格迁移版本;这部分提供单应图像对。
图像缩放到 ,batch size 2,梯度累积 6 次(等效 batch 12),训练 100K 步,Adam(),按验证集匹配性能选最佳模型。关键点真值:重投影距离小于 5 像素的关键点对视为匹配。DKD 半径 2;训练分数图时取 top 400 个 DKD 关键点,再随机采样 400 个点;归一化温度 、、。
评测覆盖四类任务:
- HPatches[13]:平面场景,指标 MMA@3(平均匹配准确率)、MHA@3(平均单应准确率)、MS@3(匹配分数);
- IMW[14]:立体匹配和多视图重建,指标 Rep(重复率)、MS、mAA@5°/10°、PPC(mAA@10° / GFLOPs);
- FM-Bench[15]:TUM / KITTI / T&T / CPC 四个数据集,指标 %Recall、%Inlier、#Corrs-m;
- Aachen Day-Night[16]:视觉重定位,指标 0.25m2° / 0.5m5° / 5m10° 三档。
所有对比都用 mNN(mutual nearest neighbor)匹配,不使用学习匹配器。论文明确说这是为了聚焦“纯描述子”的能力,学习匹配器留到未来工作。这一点在解读数字时要记住:ALIKED 的分数是 detector + descriptor + mNN 的分数,不是完整 SLAM/SfM 系统的分数。
3.2 HPatches:Tiny 的 MHA 最高,但 MMA 不是
| 方法 | 参数量 | GFLOPs | FPS | MMA@3 | MHA@3 |
|---|---|---|---|---|---|
| SuperPoint | 1.301M | 26.11 | 52.63 | 65.37 | 70.19 |
| R2D2(MS) | 0.484M | 464.55 | 4.10 | 75.77 | 71.48 |
| DISK | 1.092M | 98.97 | 11.81 | 77.59 | 70.56 |
| ALIKE-N | 0.318M | 7.91 | 84.96 | 70.78 | 75.74 |
| ALIKE-L | 0.653M | 19.68 | 56.66 | 70.50 | 76.85 |
| ALIKED-T(16) | 0.192M | 1.37 | 125.87 | 72.99 | 78.70 |
| ALIKED-N(16) | 0.677M | 4.05 | 77.40 | 74.43 | 77.22 |
| ALIKED-N(32) | 0.980M | 4.62 | 75.64 | 75.23 | 74.44 |
表 IV 的节选:640×480、1K 关键点、RTX 2060。FPS 是特征提取的帧率,不含匹配。
这张表有三个读法:
- Tiny 版是真正的“轻”:0.192M 参数、1.37 GFLOPs、125.87 FPS,比 ALIKE-N 少 5.8 倍 GFLOPs、快约 1.5 倍,MHA 还高 2.96 个点。它也是全表 MHA 最高的方法,说明 64 维描述子在单应估计上并不吃亏。
- MMA 的最高分不是 ALIKED:DISK 的 77.59 高于 ALIKED-N32 的 75.23。DISK 的 MHA 只有 70.56,说明它的匹配点更多但单应估计的稳定性不如 ALIKED;两个指标测的不是同一件事。ALIKED-T 的 MMA 72.99 高于 ALIKE-L 的 70.50,但仍低于 DISK 和 R2D2。论文的卖点是 MHA 和效率,不是 MMA 全面领先。
- N16 的 FPS 略低于 ALIKE-N:4.05 GFLOPs < 7.91 GFLOPs,但 77.40 FPS < 84.96 FPS。论文解释是 patch gathering 不是标准算子,当前实现没有充分优化,大约多花 1 ms;这部分可以用底层优化补回来。这个细节很诚实,也提醒我们 GFLOPs 不等于实际速度。
3.3 IMV:稀疏描述子的主战场
| 方法 | 立体 mAA@5° | 立体 mAA@10° | 立体 PPC | 多视图 mAA@5° | 多视图 mAA@10° | 多视图 PPC |
|---|---|---|---|---|---|---|
| DISK | 38.72 | 51.22 | 0.52 | 63.25 | 72.96 | 0.74 |
| ALIKE-N | 35.12 | 47.18 | 5.97 | 59.18 | 69.21 | 8.75 |
| ALIKED-T(16) | 37.95 | 50.38 | 36.77 | 60.31 | 70.88 | 51.74 |
| ALIKED-N(16) | 39.53 | 52.28 | 12.91 | 61.44 | 71.78 | 17.72 |
| ALIKED-N(32) | 39.52 | 52.23 | 11.30 | 61.67 | 72.09 | 15.59 |
表 V 的节选:IMW 测试集,最多 2048 个关键点。PPC = mAA@10° / GFLOPs,越大越划算。
IMV 是 ALIKED 最有说服力的基准:
- 立体匹配:ALIKED-N16 的 mAA@5° 39.53、mAA@10° 52.28,都略高于 DISK(38.72 / 51.22);重复率 46.30 也高于 DISK 的 44.80,匹配分数 85.47 与 DISK 的 85.20 基本持平。N32 和 N16 几乎一样(39.52 / 52.23),说明在立体匹配上把 从 16 加到 32 收益很小。
- 多视图重建:DISK 仍然最好(mAA@5° 63.25、mAA@10° 72.96),ALIKED-N32 是 61.67 / 72.09,N16 是 61.44 / 71.78。差距不大,但 DISK 领先。论文的解释是 DISK 产生更多匹配(NM 526.4 对 ALIKED-N16 的 401.3),给 bundle adjustment 更多约束;两者的轨迹长度其实差不多(TL 5.50 对 5.57)。ALIKED 的匹配更集中,轨迹数量少一些。
- PPC 是 ALIKED 的强项:ALIKED-T 的立体 PPC 36.77、多视图 PPC 51.74,分别是 ALIKE-N(5.97 / 8.75)的 6.2 倍和 5.9 倍。这个指标把精度除以 GFLOPs,天然有利于极轻的网络;它说明 ALIKED-T 在“每单位算力换多少精度”上非常强,但不代表它的绝对精度最高。看 PPC 时一定要同时看 mAA。
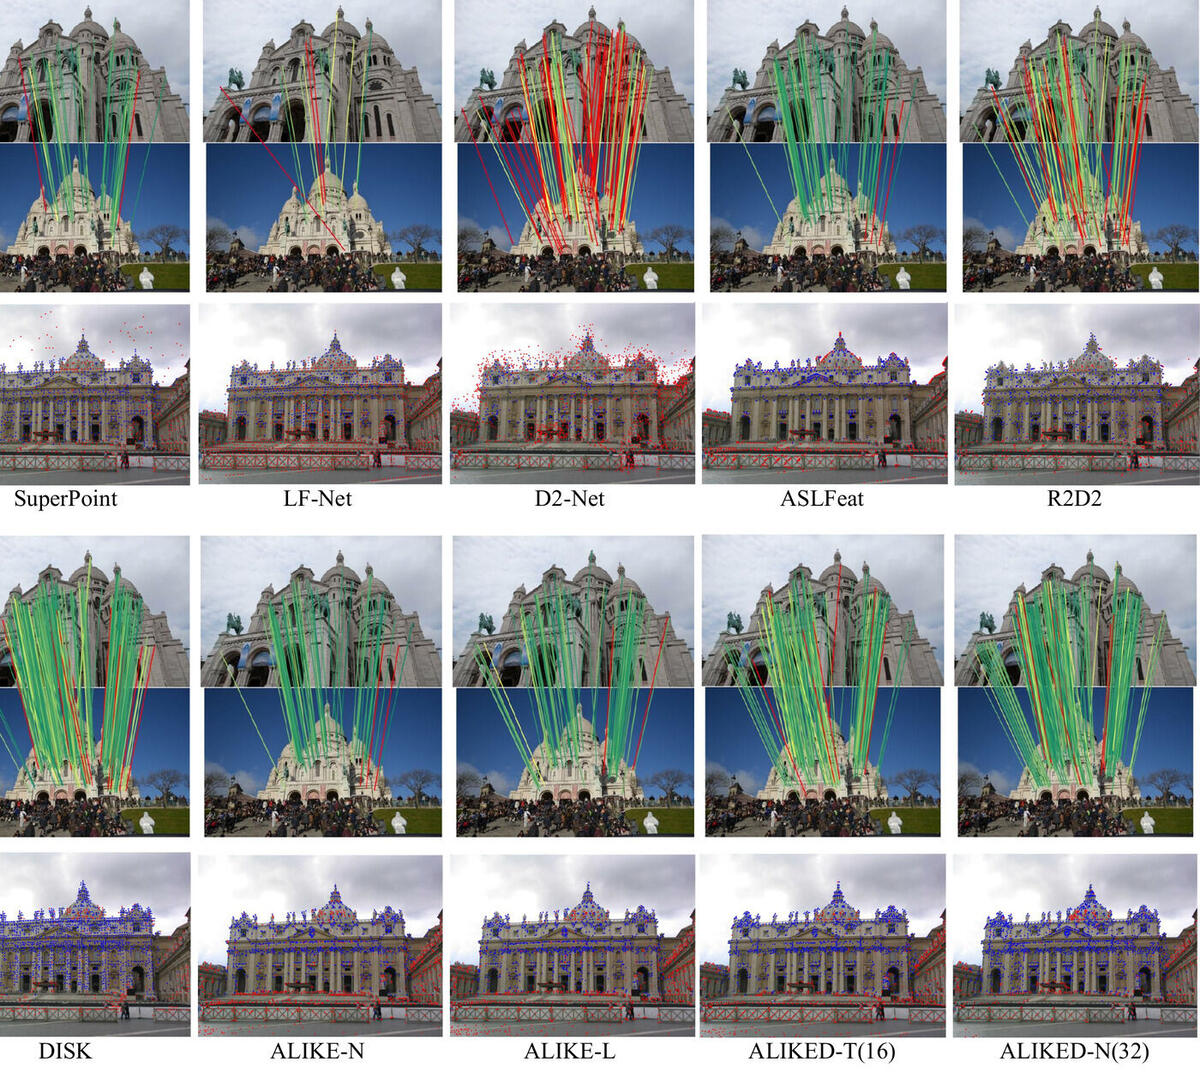
3.4 FM-Bench:TUM 的召回率是亮点
| 方法 | TUM Recall / Inlier | KITTI Recall / Inlier | T&T Recall / Inlier | CPC Recall / Inlier |
|---|---|---|---|---|
| ASLFeat(MS) | 59.90 / 76.72 | 92.20 / 96.16 | 88.70 / 79.74 | 54.40 / 82.76 |
| DISK | 59.70 / 74.85 | 90.20 / 97.34 | 86.60 / 82.73 | 59.10 / 86.30 |
| ALIKE-N | 45.10 / 73.42 | 89.60 / 95.76 | 82.50 / 76.50 | 40.00 / 82.81 |
| ALIKED-T(16) | 59.20 / 75.62 | 92.30 / 95.82 | 89.90 / 80.87 | 56.20 / 84.60 |
| ALIKED-N(16) | 63.60 / 75.58 | 92.10 / 96.12 | 92.10 / 81.55 | 58.00 / 85.99 |
| ALIKED-N(32) | 58.20 / 75.91 | 92.40 / 96.06 | 91.70 / 81.84 | 58.30 / 86.75 |
表 VI 的节选:FM-Bench,%Recall / %Inlier。Recall 是位姿估计成功的比例,Inlier 是 RANSAC 内点比例;#Corrs-m 是 RANSAC 前的匹配数,表中省略。
几个关键结论:
- TUM 室内 SLAM:ALIKED-N16 的召回率 63.60,是表中最高;ALIKED-T 59.20、ASLFeat 59.90、DISK 59.70 接近;ALIKE-N 只有 45.10。TUM 有很多低纹理、重复纹理的室内场景,ALIKED 的稀疏可变形描述子在这里收益明显。
- KITTI 车载:所有方法召回率都在 90% 左右,ALIKED-N32 92.40 最高,但差距很小;内点率 DISK 97.34 最高,ALIKED-N32 96.06。KITTI 的图像质量好、视角变化小,描述子之间的差距被压缩了。
- T&T 宽基线:ALIKED-N16 召回率 92.10,明显高于 DISK 的 86.60 和 ASLFeat 的 88.70;内点率 81.55,略低于 DISK 的 82.73。ALIKED 找到了更多正确匹配,但也有少量外点。
- CPC:DISK 召回率 59.10 最高,ALIKED-N32 58.30 紧随;内点率 ALIKED-N32 86.75 最高。整体是 DISK 和 ALIKED 各有胜负。
- 匹配数量:ALIKED 的 #Corrs-m 通常少于 DISK/ASLFeat。比如 KITTI 上 ALIKED-T 409(1405)、ALIKED-N16 315(981),而 ASLFeat 630(2222)、DISK 506(2527)。ALIKED 走的是“少而准”的路线,这对 RANSAC 是好事,但对需要大量轨迹的 SfM 可能不够。
3.5 Aachen:视觉重定位
| 方法 | 1024: 0.25m2° / 0.5m5° / 5m10° | 2048: 0.25m2° / 0.5m5° / 5m10° |
|---|---|---|
| SuperPoint | 58.2 / 66.3 / 72.4 | 69.4 / 78.6 / 87.8 |
| DISK | 60.2 / 72.4 / 81.6 | 70.4 / 82.7 / 94.9 |
| ALIKE-L | 66.3 / 76.5 / 86.7 | 74.5 / 87.8 / 98.0 |
| ALIKED-T(16) | 70.4 / 87.8 / 98.0 | 78.6 / 87.8 / 98.0 |
| ALIKED-N(16) | 73.5 / 85.7 / 98.0 | 80.6 / 87.8 / 99.0 |
| ALIKED-N(32) | 77.6 / 88.8 / 100.0 | 76.5 / 87.8 / 100.0 |
表 VII 的节选:Aachen Day-Night,最多 1024 / 2048 个关键点,三档阈值。
Aachen 是日夜重定位,白天建图、夜晚查询,对描述子的光照不变性要求很高。ALIKED 在这一基准上整体强于 SuperPoint、DISK、ALIKE-L:
- 1024 个关键点时,ALIKED-N32 的三档指标 77.6 / 88.8 / 100.0 都是第一;N16 73.5 / 85.7 / 98.0,Tiny 70.4 / 87.8 / 98.0。Tiny 的 64 维描述子在三档上都不输 ALIKE-L 的 128 维,说明维度不是瓶颈。
- 2048 个关键点时出现一个有意思的反转:N16 在 0.25m2° 上 80.6,高于 N32 的 76.5;N32 在 5m10° 上满分 100.0。论文说 N32 整体最好,但表上并不是每个格子都最好。一个可能的解释是 N32 的更多采样位置在关键点数量增加时带来了更多方差;论文没有展开分析。
- 从 1024 增到 2048,ALIKED-N32 的 0.25m2° 反而从 77.6 降到 76.5,N16 从 73.5 升到 80.6。说明“更多关键点”不总是更好,关键点的质量和分布比数量更重要。
3.6 旋转与尺度:可变形不是万能
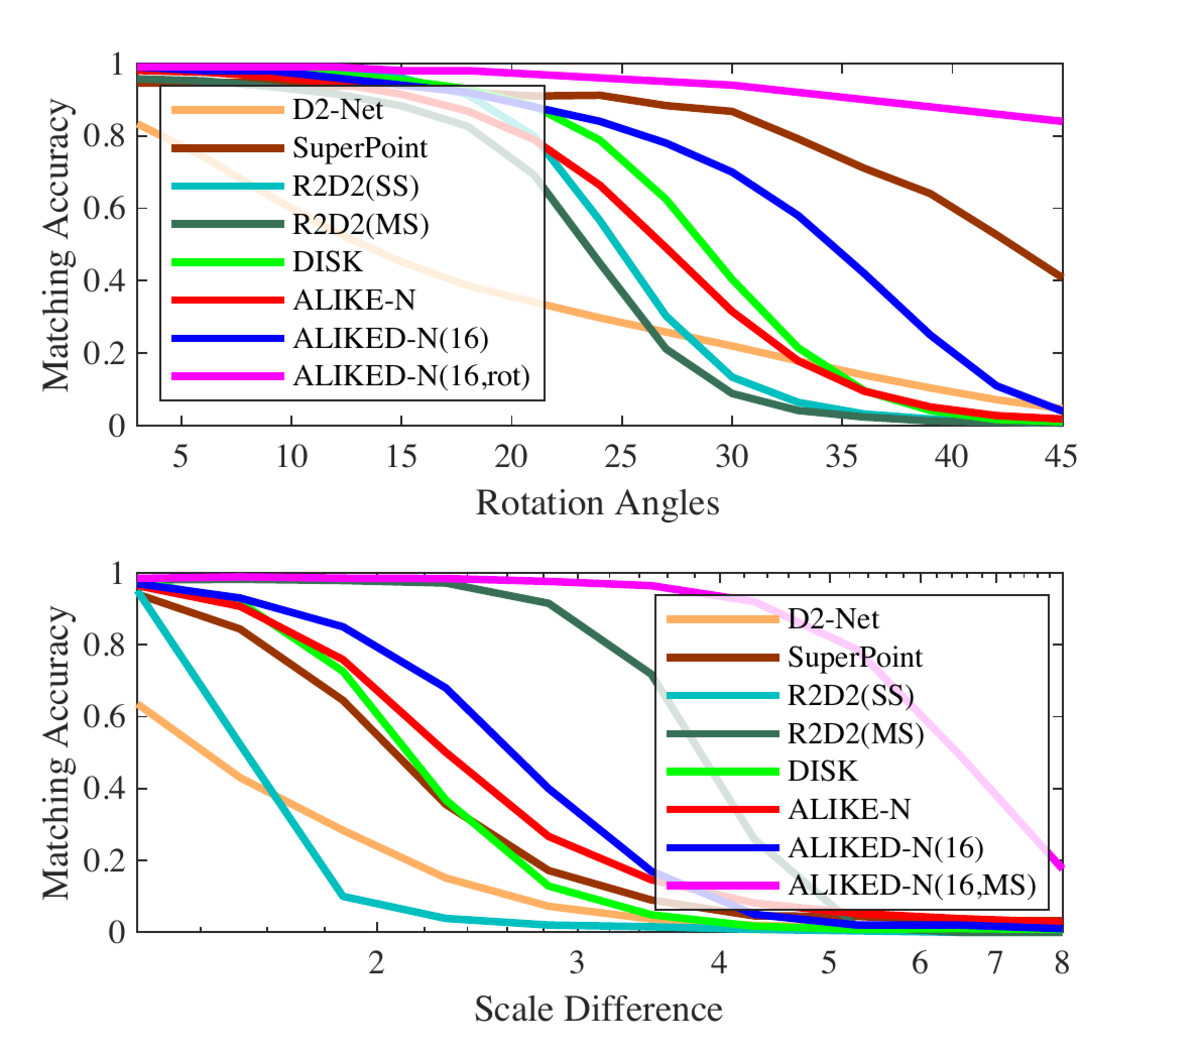
旋转实验的结论:
aliked-n16rot在旋转增强下训练,0°–40° 左右都能保持较高匹配率,45° 才明显下降;它是表中旋转不变性最好的方法。- 不带旋转增强的 ALIKED-N16 在 20° 之后开始下降,但仍然是除 SuperPoint 外最好的非旋转增强方法。SuperPoint 因为 Homographic Adaptation 里包含旋转增强,旋转不变性也很好。
- 论文指出
aliked-n16rot在三维重建上略差于aliked-n16,因为图像方向本身是有用的线索(人类也靠方向感),旋转增强把这条线索削弱了。这是一个很实际的 trade-off:要不要旋转不变,取决于任务。
尺度实验的结论:
- ALIKED-N16 在单尺度方法中匹配率最高,但尺度差超过 4× 后所有单尺度方法都退化到 0。
- 多尺度策略(与 R2D2(MS) 相同的策略)能让 ALIKED-N16(MS) 撑到 8×,明显好于 R2D2(MS);原因是 ALIKED-N16 在小尺度差下本身就有较好的尺度不变性,多尺度匹配更容易找到接近目标尺度的图像。
- 可变形描述子能提供一定的尺度不变性,但不是无限的:SDDH 只有一层偏移估计,采样位置可以移动,但特征本身的尺度没有改变。大尺度差仍然需要多尺度或尺度增强。
3.7 消融:每个设计值多少
论文的架构消融在 10K 步、最后一个 checkpoint 上做,指标是 HPatches 和 IMW 验证集,不是最终 100K 步的模型。因此这些数字适合看趋势和相对收益,不要和表 IV–VII 的最终数字混用。
| 配置 | Stage2 GFLOPs | Desc ms | HPatches MMA | MHA | MS | IMW mAA@10° | MS |
|---|---|---|---|---|---|---|---|
| Baseline | — | 0.22 | 70.72 | 75.93 | 44.24 | 54.43 | 83.51 |
| + AVG + SELU | — | 0.22 | 70.78 | 75.19 | 41.28 | 57.00 | 82.29 |
| SH2 | — | 0.22 | 71.00 | 76.30 | 44.68 | 60.87 | 85.40 |
| SH3 | — | 0.22 | 69.42 | 75.74 | 42.69 | 58.22 | 84.24 |
| 2×DCN + SH3 | — | 0.22 | 70.62 | 75.19 | 45.50 | 63.58 | 87.52 |
| 2×DCN + SH3 + SDH1 | 0.13 | 0.66 | 70.63 | 75.93 | 45.92 | 64.30 | 88.05 |
| 2×DCN + SH3 + SDH3 | 2.95 | 2.43 | 72.60 | 76.11 | 45.97 | 63.68 | 88.10 |
| SDDH K3 M8 | 0.28 | 1.68 | 71.16 | 75.37 | 45.85 | 64.72 | 88.28 |
| SDDH K3 M16 | 0.57 | 1.88 | 72.52 | 76.85 | 46.62 | 65.39 | 88.93 |
| SDDH K3 M24 | 0.86 | 2.03 | 69.86 | 73.52 | 44.71 | 67.59 | 90.29 |
| SDDH K3 M32 | 1.14 | 2.18 | 72.64 | 75.00 | 47.37 | 67.78 | 90.12 |
表 IX 的节选:640×480、1K 关键点、RTX 2060;Stage1 是特征提取 + 关键点检测,Stage2 是描述子提取。Baseline 是 ALIKE-N;SH3 是轻量分数头;SDH1/3 是普通稀疏描述子头;SDDH 是可变形稀疏描述子头。
从这张表可以读出四条设计逻辑:
- AVG + SELU 主要改善 IMW:mAA@10° 从 54.43 提到 57.00(+2.57),但 HPatches MS 从 44.24 掉到 41.28。它不是一个全面提升的改动,而是把网络推向“透视图像匹配更好、单应匹配稍差”的方向。
- DCN 是性价比最高的改动:2×DCN + SH3 相比 SH3,HPatches MS +2.81、IMW mAA@10° +5.36、MS +3.28,代价只有 +0.1 GFLOPs 和 +0.8 ms。DCN 放在后两个 block 是合理的:前两个 block 分辨率高,放 DCN 太贵。
- SDH 把描述子头的计算打下来:从 2×DCN+SH3 到 +SDH1,总 GFLOPs 从 8.51 降到 3.61(Stage2 只有 0.13),运行时间从 12.91 ms 降到 11.70 ms,HPatches 和 IMW 还不降反升。这是“去掉稠密描述子图”的直接收益。
- SDDH 的 和 是精度/速度旋钮: 比 和 更均衡; 从 8 增到 16 提升明显,16 到 24/32 继续提升 IMW 但 HPatches 有波动,计算也增加。论文最终选 作为 N16 的折中,N32 用 。注意 在 IMW mAA@10° 上 67.59,高于 的 65.39,但 HPatches MMA 只有 69.86,低于 的 72.52;这是不同基准之间的 trade-off,不存在一个 全面最优。
关于分数头还有一个细节:论文最终选了 SH3,但表 IX 里 SH2(更深的 头)在 HPatches MHA 76.30、IMW mAA@10° 60.87 上都高于 SH3 的 75.74 / 58.22。SH3 的优势是省 1.06 GFLOPs。作者选 SH3 是预算选择,不是精度选择;如果算力宽松,SH2 可能更合适。论文的表述是“SH3 saves 1.06GFLOPs compared to SH2 with similar matching performance”,但表上的差距并不算小,读的时候要自己核对。
3.8 效率与生态:LightGlue / hloc 里的即插即用
论文本身只评测 mNN,不评测 LightGlue 等学习匹配器。但 ALIKED 在生态里的位置很好:
- LightGlue 官方支持 ALIKED 特征提取器,提供
aliked-t16、aliked-n16、aliked-n16rot、aliked-n32四种配置[17];可以直接用LightGlue(features="aliked-n16")把 ALIKED 的关键点和描述子送进 LightGlue 的注意力匹配器。 - hloc 也有 ALIKED extractor,默认
aliked-n16,可以接进 SfM / 视觉定位流程[18]。 - 后续的 LoMa 仍把
ALIKED + LightGlue作为 HardMatch 上的强基线:LoMa-G 的 54.3 mAA@10px 比它高 18.6,反过来说明 ALIKED+LightGlue 的 35.7 是一个不低的起点[19]。
这些是生态支持,不是论文的实验结论。论文的 FPS 是 640×480、1K 关键点、RTX 2060 上的特征提取帧率;实际 SfM 流程还要加上匹配、RANSAC、BA 的时间。ALIKED 的定位是“轻量、可变形、稀疏前端”,不是端到端匹配器。
四、局限性
先列论文自己承认的:
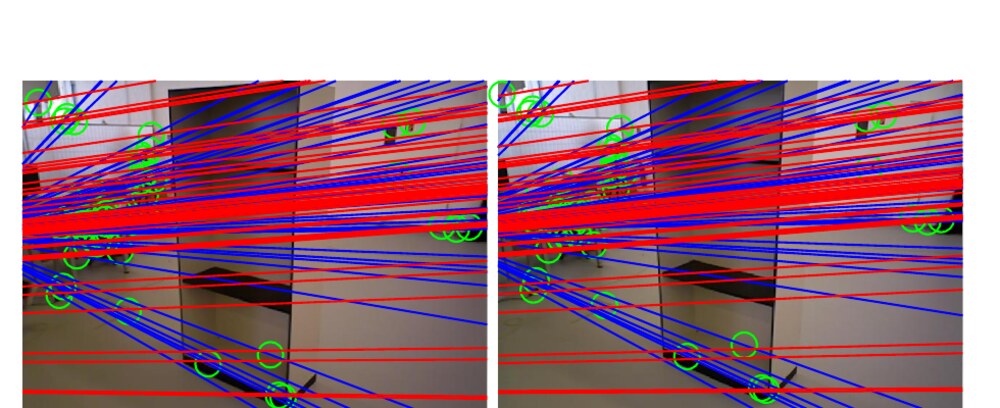
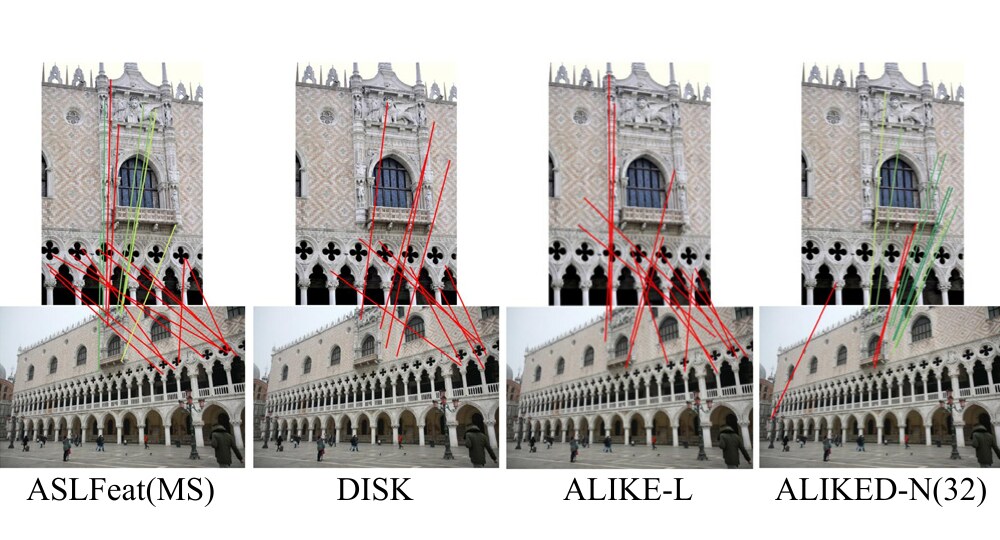
- 大尺度 + 大视角同时变化会失败:图 7 的失败案例不是 ALIKED 独有,ASLFeat、DISK、ALIKE 也会失败;ASLFeat 的多尺度能找回一部分,ALIKED 的可变形描述子也能找回一部分,但没有方法能稳定解决。论文把原因部分归给 SDDH 只有一层可变形位置估计,建模能力有限。
- 用 mNN,而不是学习匹配器:论文聚焦“纯描述子”的能力,没有把 ALIKED 接到 SuperGlue/LightGlue 这类学习匹配器上。学习匹配器可能进一步提升性能,但也可能改变方法之间的相对排名。
- 网格采样和 32 位浮点描述子不适合移动端:论文说 ALIKED 使用 grid-sampling 和 32-bit floating descriptors,对移动设备不友好;未来要做硬件友好的关键点/描述子网络。
- 训练代码不公开:官方 README 明确说不能发布训练代码,只能参考 ALIKE。这不是科学局限,但严重影响可复现性;稀疏 NRE 的实现细节只能按论文理解。
我自己再补几条:
- 稀疏 NRE 不是免费的精度提升:表 VIII 里,480² 同分辨率下稀疏 NRE 的五个指标全都低于稠密 NRE。它的价值是用显存换分辨率/数据,最终模型的 70.72/75.93/44.24 是“800² + 单应数据”的成果,不是“稀疏 NRE 本身更强”。把这两件事混为一谈会高估稀疏 NRE。
- 偏移没有显式监督,也缺少分析:SDDH 的偏移完全由描述子损失端到端学习,代码只做了 的 clamp。论文没有偏移分布、偏移稳定性、重复纹理下偏移是否退化的分析;图 7 是精心挑选的定性例子,不能证明所有关键点的偏移都合理。这是 SDDH 最值得补实验的地方。
- 旋转不变性是配置相关的:基础
aliked-n16在 20° 之后下降,只有aliked-n16rot对旋转更稳;而n16rot在三维重建上还略差于n16。ALIKED 没有架构层面的旋转等变设计,旋转不变性主要靠数据增强。 - 基准集偏旧,匹配器是 mNN:HPatches、IMW、FM-Bench、Aachen 都是 2017–2021 年的基准,没有包含 LoFTR/LightGlue/DeDoDe/LoMa 这类后续方法;mNN 也不是现代 SfM 的默认匹配器。论文的相对排名在“detector + descriptor + mNN”这个子问题里有效,放到完整 pipeline 里未必成立。
- 效率数字的适用条件很窄:FPS 是 640×480、1K 关键点、RTX 2060;分辨率或关键点数上去后,DKD、特征编码、patch gathering 的成本都会变。论文也承认 patch gathering 没优化,N16 的 FPS 被它拖累了约 1 ms。部署前要在自己的分辨率/关键点数上重新测。
- “Lighter”主要指计算,不是参数:ALIKED-N16 的 0.677M 参数比 ALIKE-N 的 0.318M 还多;只有 Tiny 版在参数和计算上都更小。如果目标是最小模型体积,要选 T16,而不是 N16。
- Aachen 的“最好”不是每个格子都最好:2048 个关键点时 N16 在 0.25m2° 上高于 N32;论文的“N32 最好”是整体印象,具体阈值下要逐项看表。论文没有分析这种反转。
- 描述子是浮点,没有二值/量化版本:主流配置 N16/N32 是 128 维,Tiny 是 64 维;对大规模 SfM 或嵌入式部署,128×4 字节的描述子仍然占内存。论文的未来工作提到硬件友好网络,但没有给出量化/二值化的实验结果。
五、结论与展望
ALIKED 的故事可以概括成一句话:把几何不变性从“稠密描述子图”里拿出来,放到“每个关键点的可变形采样”里。 ALIKE 已经证明了轻量检测器 + 稠密描述子头可以很快,但描述子只从一个位置采样,几何变化下不稳定;ALIKED 保留 ALIKE 的检测器和骨干,去掉稠密描述子图,换成 SDDH——每个关键点预测 个采样位置,双线性采样后聚合。这样既保留了可变形能力,又把描述子头的计算量从 降到 。为了让稀疏描述子也能训练,作者又把 NRE 从稠密概率图松弛成关键点上的 softmax 分类,用 3.2 GB 的显存换来了 800² 训练的可能。
它的实验结果也支持这个叙事:Tiny 版 0.192M 参数、1.37 GFLOPs、125.87 FPS,HPatches MHA 78.70 全场最高;N16 在 IMW 立体匹配上略胜 DISK,在多视图重建上接近 DISK;FM-Bench 的 TUM/T&T 召回率明显高于 ALIKE;Aachen 上整体强于 SuperPoint/DISK/ALIKE-L。代价是:大尺度 + 大视角仍然会失败,稀疏 NRE 在同分辨率下不如稠密 NRE,旋转不变性依赖 n16rot,训练代码不公开。
对实践者的几条建议:
- 要极致轻量/实时:选
aliked-t16。64 维描述子、1.37 GFLOPs、125 FPS,HPatches MHA 和 PPC 都很强;适合资源受限的 SLAM/重定位前端。 - 要精度和速度平衡:选
aliked-n16。0.677M 参数、4.05 GFLOPs、77 FPS,IMW 立体匹配和 TUM/T&T 召回率都很好;是大多数场景的默认值。 - 要多视图重建/定位的绝对精度:可以试
aliked-n32,但注意它在 HPatches MHA 和 Aachen 2048 严格阈值上不一定比 N16 好;最好在自己的数据上比较 N16/N32。 - 有旋转的图像对:用
aliked-n16rot;如果做三维重建,先比较n16rot和n16,因为旋转增强可能削弱方向线索。 - 接 SfM/定位流程:用 hloc 的 ALIKED extractor 或 LightGlue 的 ALIKED 配置,把 ALIKED 当稀疏前端;论文没有评测学习匹配器,所以实际收益要在自己的 pipeline 上验证。
- 需要稠密/大视角鲁棒性:ALIKED 不是 LoFTR/LoMa 的替代品。它在稀疏、轻量、可解释这条线上很强;如果场景有大视角、弱纹理、重复纹理,应该和稠密匹配器或 LoMa 这类稀疏匹配器对比[19]。
- 关心端侧速度:可以对比 XFeat 这类后续轻量特征[20];XFeat 走的是更小描述子、硬件友好的路线,和 ALIKED 的“可变形描述子”是不同的设计取向。
未来可以期待的方向:给 SDDH 加多层偏移估计或偏移正则,提升大尺度/大视角的建模能力;把检测、描述、匹配联合训练,而不是只用 mNN;做二值/量化描述子和硬件友好的采样;在更多现代基准(HardMatch、RAB、IMC 2022)上重新评估。ALIKED 本身是一个很干净的“模块替换”式改进,这些方向都可以在它的代码基础上继续做。
六、上手
官方仓库只提供推理代码和四个预训练权重,训练代码明确不公开。许可证是 BSD-3-Clause;权重在 models/ 下,初始化时从仓库本地加载。安装依赖、编译 custom_ops、跑 demo 的命令如下(均摘自官方 README):
安装与编译 custom_ops(官方 README)
pip install -r requirements.txt
cd custom_ops
sh build.sh
custom_ops 是 patch gathering 的 CUDA 扩展;不编译也能跑,代码会回退到 LightGlue 风格的 PyTorch 实现(get_patches_lg),但会慢一些。论文把 ALIKED-N16 比 ALIKE-N 慢约 1 ms 归因于这部分没有充分优化,所以如果你在意 FPS,建议按 README 编译。
跑图像对 / 序列 demo(官方 README)
python demo_pair.py assets/st_pauls_cathedral
python demo_pair.py assets/piazza_san_marco
python demo_seq.py assets/tum
demo_pair.py 默认用 aliked-n16rot,可以用 --model 切换:
切换模型与检测参数(官方 README 的 CLI)
python demo_pair.py assets/st_pauls_cathedral --model aliked-t16
python demo_pair.py assets/st_pauls_cathedral --model aliked-n16 --top_k 2048
python demo_pair.py assets/st_pauls_cathedral --model aliked-n32 --scores_th 0.2 --n_limit 5000
四个模型的结构和用途:
| 模型 | 描述子维度 | / | 适用场景 |
|---|---|---|---|
aliked-t16 | 64 | 3 / 16 | 极致轻量、实时;HPatches MHA 最高 |
aliked-n16 | 128 | 3 / 16 | 默认平衡;IMW 立体匹配、TUM/T&T 召回率好 |
aliked-n16rot | 128 | 3 / 16 | 有旋转的图像对;三维重建可能略逊于 n16 |
aliked-n32 | 128 | 3 / 32 | 更多采样位置;多视图重建/Aachen 更强,但更慢 |
如果你要在 Python 里直接调用,官方 ALIKED 类的 run() 接口最省事;下面这段是按官方 nets/aliked.py 的构造函数和 run() 返回值拼的最小调用,不是 README 原文:
最小 Python 调用(按官方 ALIKED.run() 接口)
import cv2
from nets.aliked import ALIKED

model = ALIKED(
    model_name="aliked-n16",   # aliked-t16 / aliked-n16 / aliked-n16rot / aliked-n32
    device="cuda",
    top_k=-1,                  # -1: threshold mode; >0: top-k mode
    scores_th=0.2,
    n_limit=5000,
)
img = cv2.cvtColor(cv2.imread("your.jpg"), cv2.COLOR_BGR2RGB)
pred = model.run(img)

kpts = pred["keypoints"]       # (N, 2), pixel coordinates
desc = pred["descriptors"]     # (N, D), L2-normalized
scores = pred["scores"]        # (N,)
匹配可以用 demo_pair.py 里的 mNN:先算 desc1 @ desc2.T,把相似度小于 0.75 的置零,再取双向 argmax。这个阈值和 demo_pair.py 的 mnn_mather 一致。注意 run() 内部把图像转成 tensor 后没有做 ImageNet 归一化,只做了 ToTensor();输入用 RGB,和 demo 保持一致。
权重和许可:仓库自带 models/aliked-t16.pth、aliked-n16.pth、aliked-n16rot.pth、aliked-n32.pth;许可证是 BSD-3-Clause,可以商用,但请保留版权声明。引用格式见 README 的 BibTeX。
训练:官方明确不公开。README 的原话是“I am sorry that I am not allowed to publish the training code of ALIKED, you can refer to the training code of ALIKE.” 因此没有官方训练命令、没有稀疏 NRE 的训练实现;想复现表 VIII 只能参考 ALIKE 的训练代码,并自己实现式 (9)–(11)。这也是本文在“上手”里只写推理的原因。
参考
- Zhao, X., Wu, X., Chen, W., Chen, P. C. Y., Xu, Q., Li, Z. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Transactions on Instrumentation and Measurement, 72:1–16, 2023. arXiv · 代码
- DeTone, D., Malisiewicz, T., Rabinovich, A. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Dusmanu, M., Rocco, I., Pajdla, T., Pollefeys, M., Sivic, J., Torii, A., Sattler, T. D2-Net: A Trainable CNN for Joint Description and Detection of Local Features. CVPR 2019. arXiv · 代码
- Revaud, J., Weinzaepfel, P., De Souza, C., Pion, N., Csurka, G., Cabon, Y., Humenberger, M. R2D2: Repeatable and Reliable Detector and Descriptor. NeurIPS 2019. arXiv · 代码
- Tyszkiewicz, M., Fua, P., Trulls, E. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Zhao, X., Wu, X., Miao, J., Chen, W., Chen, P. C. Y., Li, Z. ALIKE: Accurate and Lightweight Keypoint Detection and Descriptor Extraction. IEEE Transactions on Multimedia, 25:3101–3112, 2022. arXiv · 代码
- Lowe, D. G. Distinctive Image Features from Scale-Invariant Keypoints. International Journal of Computer Vision, 60(2):91–110, 2004. DOI
- Dai, J., Qi, H., Xiong, Y., Li, Y., Zhang, G., Hu, H., Wei, Y. Deformable Convolutional Networks. ICCV 2017. arXiv
- Luo, Z., Zhou, L., Bai, X., Chen, H., Zhang, J., Yao, Y., Li, S., Fang, T., Quan, L. ASLFeat: Learning Local Features of Accurate Shape and Localization. CVPR 2020. arXiv · 代码
- Klambauer, G., Unterthiner, T., Mayr, A., Hochreiter, S. Self-Normalizing Neural Networks. NeurIPS 2017. arXiv
- Germain, H., Lepetit, V., Bourmaud, G. Neural Reprojection Error: Merging Feature Learning and Camera Pose Estimation. CVPR 2021. arXiv
- Li, Z., Snavely, N. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Balntas, V., Lenc, K., Vedaldi, A., Mikolajczyk, K. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Jin, Y., Mishkin, D., Mishchuk, A., Matas, J., Fua, P., Yi, K. M., Trulls, E. Image Matching across Wide Baselines: From Paper to Practice. International Journal of Computer Vision, 129:517–547, 2021. arXiv · 代码
- Bian, J.-W., Lin, W.-Y., Matsushita, Y., Yeung, S.-K., Nguyen, T.-D., Cheng, M.-M. An Evaluation of Feature Matchers for Fundamental Matrix Estimation. BMVC 2019. arXiv · 代码
- Sattler, T., Maddern, W., Toft, C., Torii, A., Hesch, J., Pollefeys, M. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Lindenberger, P., Sarlin, P.-E., Pollefeys, M. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sarlin, P.-E., Cadena, C., Siegwart, R., Dymczyk, M. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. CVPR 2019. arXiv · 代码
- Nordström, D., Edstedt, J., et al. LoMa: Local Feature Matching Revisited. ECCV 2026. arXiv · 代码
- Potje, G., Cadar, F., Araujo, A., Martins, R., Nascimento, E. R. XFeat: Accelerated Features for Lightweight Image Matching. CVPR 2024. arXiv · 代码