· 86 min read
论文解读:DKM,把稠密匹配写成高斯过程回归
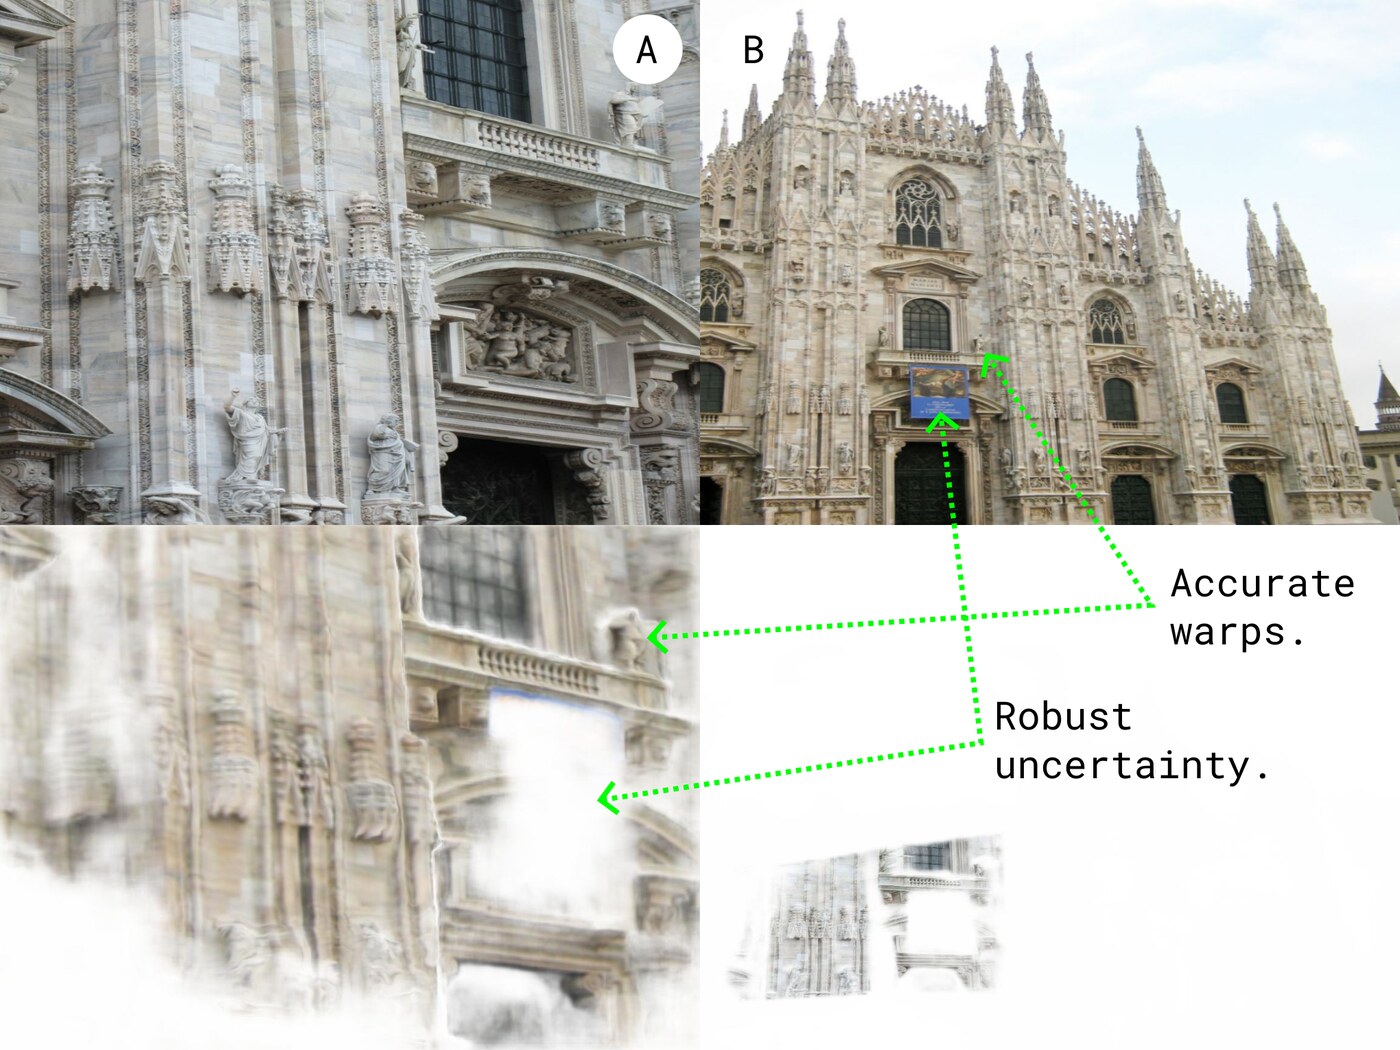
TL;DR DKM 是林雪平大学(Linköping University)在 CVPR 2023 提出的稠密匹配器[1]。它不再把匹配当作在 4D 相关体上做分类或回归,而是把「A 的每个像素对应 B 的哪个坐标」写成高斯过程(Gaussian Process, GP)回归:B 的每个像素都是一个基,核权重由两图深度特征的余弦相似度给出,整张 B 特征图都参与加权;被回归的值是 B 的坐标嵌入,而不是特征本身,余弦嵌入让多峰后验不会塌缩成一个中间坐标。粗 warp 随后经过「堆叠特征图 + 5×5 深度可分离卷积」逐级精化;置信度直接用「深度一致」构造监督,采样时再用 KDE 做场景平衡。结果是:MegaDepth-1500 AUC@5 达 60.4(PDC-Net+ 51.5、ASpanFormer 55.3),ScanNet-1500 达 29.4(ASpanFormer 25.6),HPatches AUC@3px 达 71.3。代码与 MegaDepth 训练的 DKMv3 权重已开源(MIT)。
- 论文:DKM: Dense Kernelized Feature Matching for Geometry Estimation,Johan Edstedt、Ioannis Athanasiadis、Mårten Wadenbäck、Michael Felsberg,Linköping University,CVPR 2023。
- 代码:github.com/Parskatt/DKM。MegaDepth 训练的 DKMv3 权重为 MIT;用合成数据训练的模型因数据协议限制为非商用。
- 前作 / 后继:LoFTR 的 coarse-to-fine 半稠密匹配、LightGlue 的稀疏匹配、RoMa v2 的稠密匹配、DUSt3R 的 3D 重建、FlexGlue 的稀疏到稠密匹配。
一、动机:稠密匹配为什么长期打不过稀疏匹配
两视图几何的流程可以粗分成两步:先在两张图之间找对应点,再用对应点估计单应、基础矩阵或相对位姿。第一步的主流做法一直是稀疏匹配:检测关键点、算描述子、在两组关键点之间做匹配[2, 3]。它的优点是把问题压成几百到几千个点的离散分配,下游估计器直接可用;缺点是上限被检测器卡死——一个三维点必须在两张图里都被重复检测到,才可能成为候选,检测的定位噪声也会原封不动传给对应点。在低纹理、重复结构和大视角下,检测器本身就先失败了[4]。
LoFTR 用半稠密(detector-free)的方式绕开检测器:在粗网格上计算两张图的特征相关,用 dual-softmax 得到匹配分布,取互相最近邻的粗匹配,再在匹配点周围的局部窗口里精化到亚像素[4]。这条路线把「检测」换成了「在网格上匹配」,但粗匹配仍然只是一组稀疏的 argmax,精化也只看每个匹配点周围的局部 patch。
稠密匹配则直接为 A 的每个像素预测它在 B 中的坐标,得到稠密 warp,完全不依赖检测器,还能顺带给出仿射对应。此前的工作大致分成两类:一类在 4D 相关体上回归 warp[5],另一类把匹配看成概率推断,同时预测 warp 与不确定性[5]。它们在光流和稠密对应上很强,但在两视图几何估计上却长期落后于稀疏和半稠密方法。DKM 要回答的就是这个问题:稠密匹配缺的不是分辨率,而是一个足够强的全局匹配器和一套可靠的置信度。
作者把此前稠密方法的弱点归成三种互相纠缠的情形:
- 低纹理:局部窗口里的特征几乎一样,softmax 只能分出一片近似均匀的权重,warp 在窗口内随机漂移。
- 大视角:相关峰被视角变化拉宽、拉偏,局部窗口可能根本覆盖不到真正的对应位置。
- 重复纹理:相似度图上有多个同样强的峰,局部窗口会锁死其中一个,而且没有任何机制表示「还有另一个可能」。
DKM 的选择是把匹配写成回归,而不是分类:不再问「这个像素属于 B 的哪一格」,而是问「给定 A 的特征,B 的坐标期望是多少」。这个期望由一个高斯过程给出,B 的每个像素都是一个基,权重由深度特征的余弦核决定,因此整张特征图都参与加权;坐标用余弦嵌入表示,避免多峰平均成一个不存在的中间点。粗匹配之后,再用堆叠特征图和深度可分离卷积逐级精化 warp;置信度则直接从「深度是否一致」学习,最后用 KDE 做平衡采样。
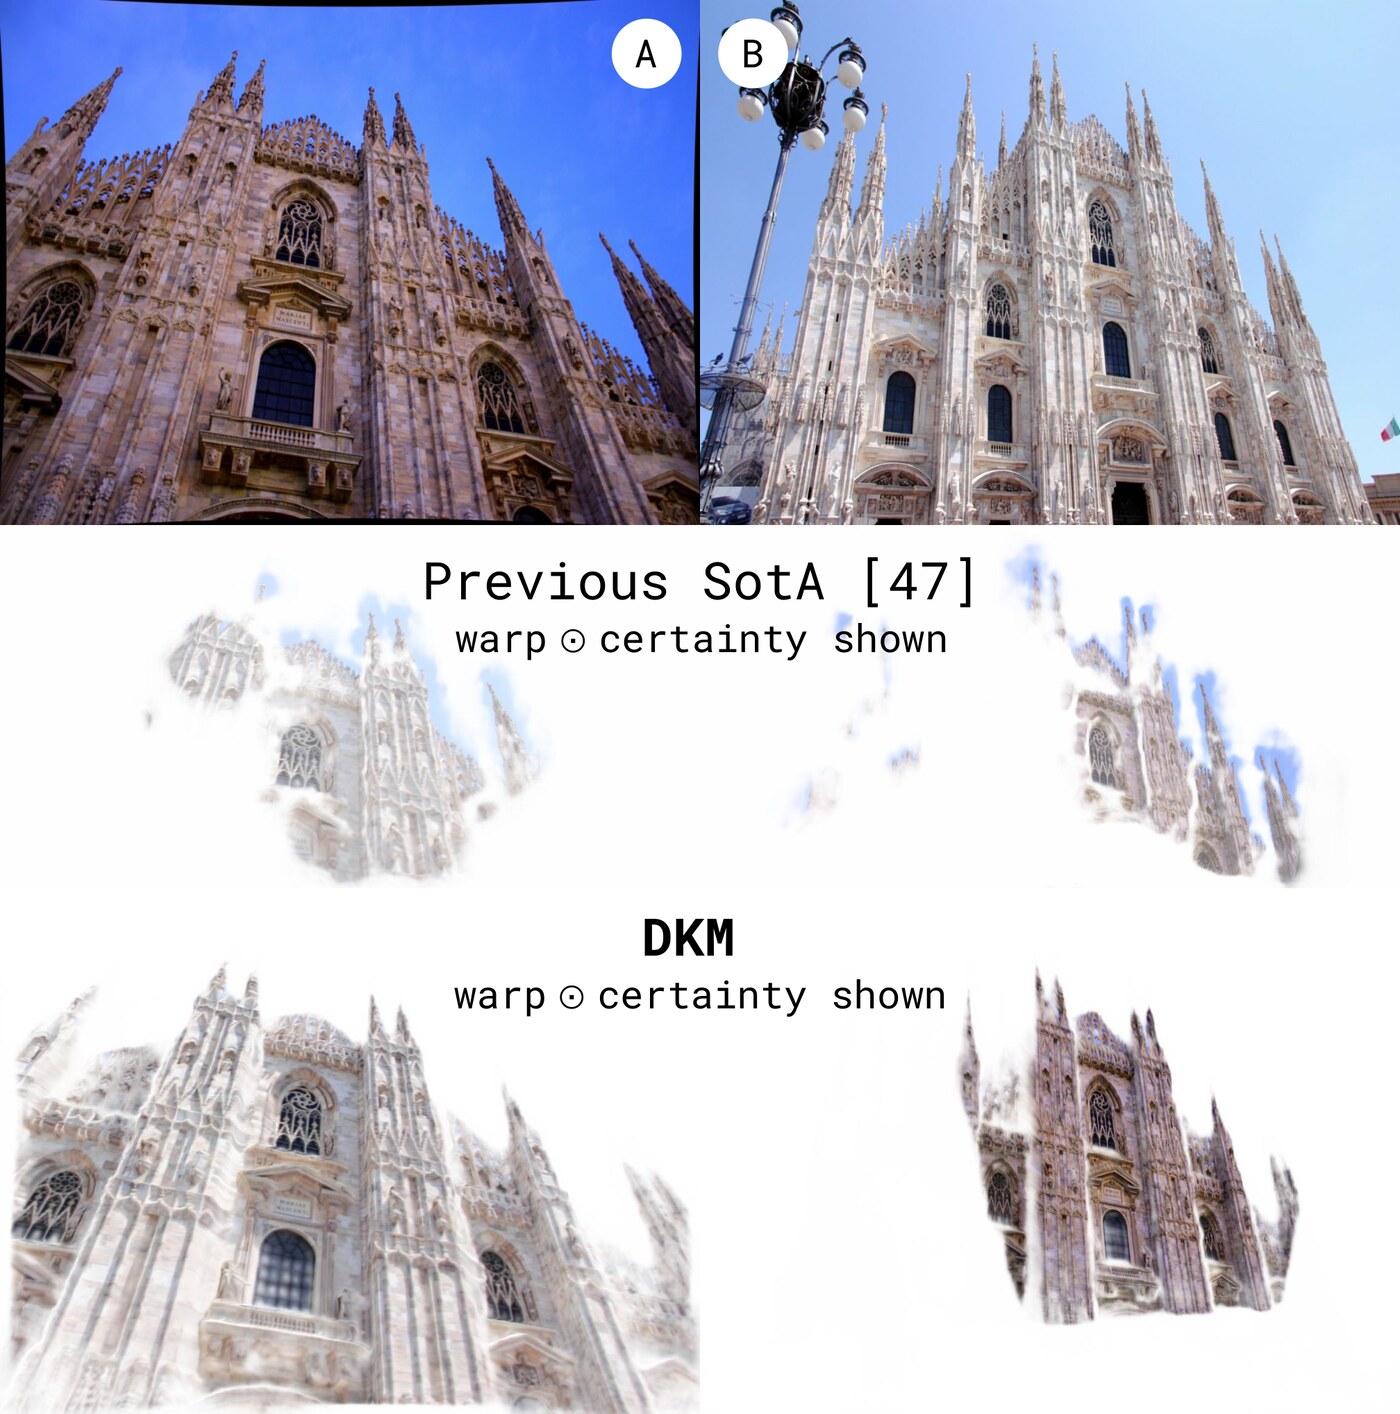
论文列了三条贡献:
- 全局匹配器:把匹配写成嵌入空间的高斯过程回归,配一个 embedding decoder,得到更鲁棒的粗匹配。
- Warp refiners:用堆叠特征图和大的深度可分离卷积核做稠密 warp 精化,替代只在相关体上做局部回归的做法。
- 置信度与采样:用一致的深度构造置信度监督,并提出平衡采样,让进入估计器的匹配在场景中分布得更均匀。
二、核心方法
2.1 总体流程
记两张图为 ,DKM 要预测稠密 warp 和逐像素置信度 。整个流程分五步(图 2):
- 特征金字塔:共享权重的 ResNet50[6] 提取 stride 的特征。其中 stride 32/16 称为粗特征,8/4/2/1 称为细特征。
- 全局匹配:在 stride 32 和 16 上分别跑 GP 全局匹配器和 embedding decoder,得到粗 warp 与 certainty。
- Warp 精化:在 stride 16/8/4/2/1 上逐级 refine,每一级预测残差位移和 certainty 的 logit 增量。
- 置信度与采样:按 certainty 阈值筛选,再做 KDE 平衡采样,得到一组分布更均匀的匹配。
- 几何估计:把采样得到的匹配交给 RANSAC 一类的鲁棒估计器。
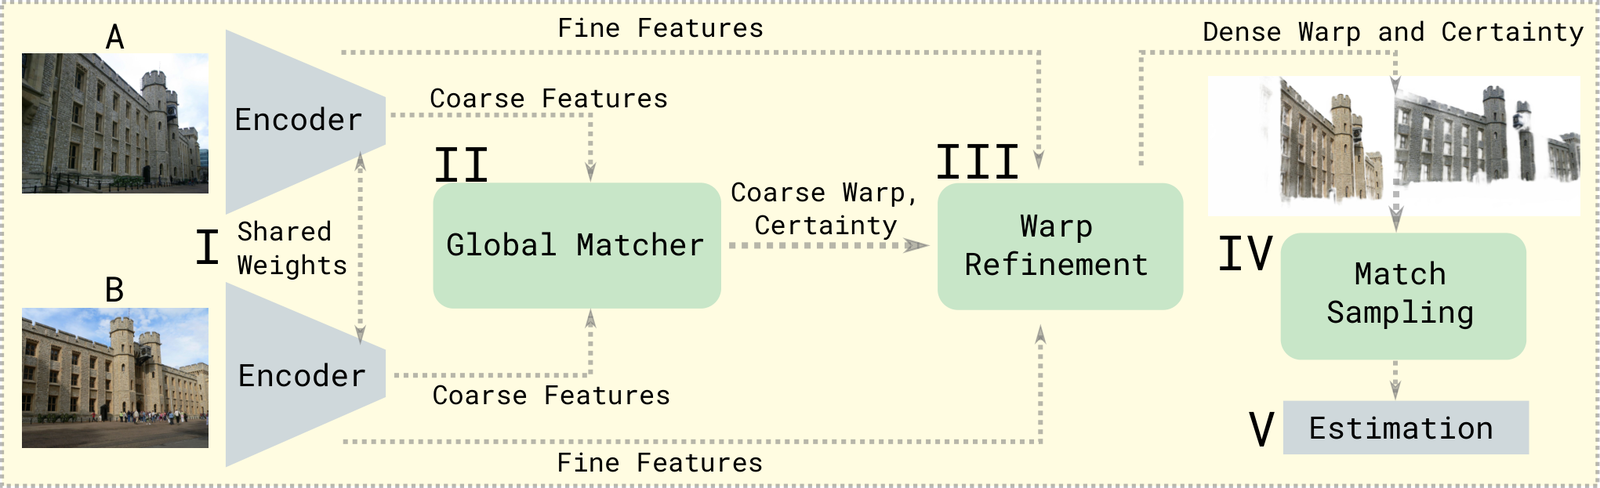
用公式写,stage I 是
stage II 是
stage III 是逐级递归
直到 stride 1。编码器 、全局匹配器 、精化器 都由网络参数化,整个系统端到端训练。
2.2 全局匹配器:把匹配写成高斯过程回归
从分类到回归
传统稠密匹配把问题写成:对 A 的每个像素,在 B 的网格上算一个相似度分布,再取 argmax 或 soft-argmax。DKM 换了一个问法:把 A 的特征 映射到 B 的坐标嵌入 ,
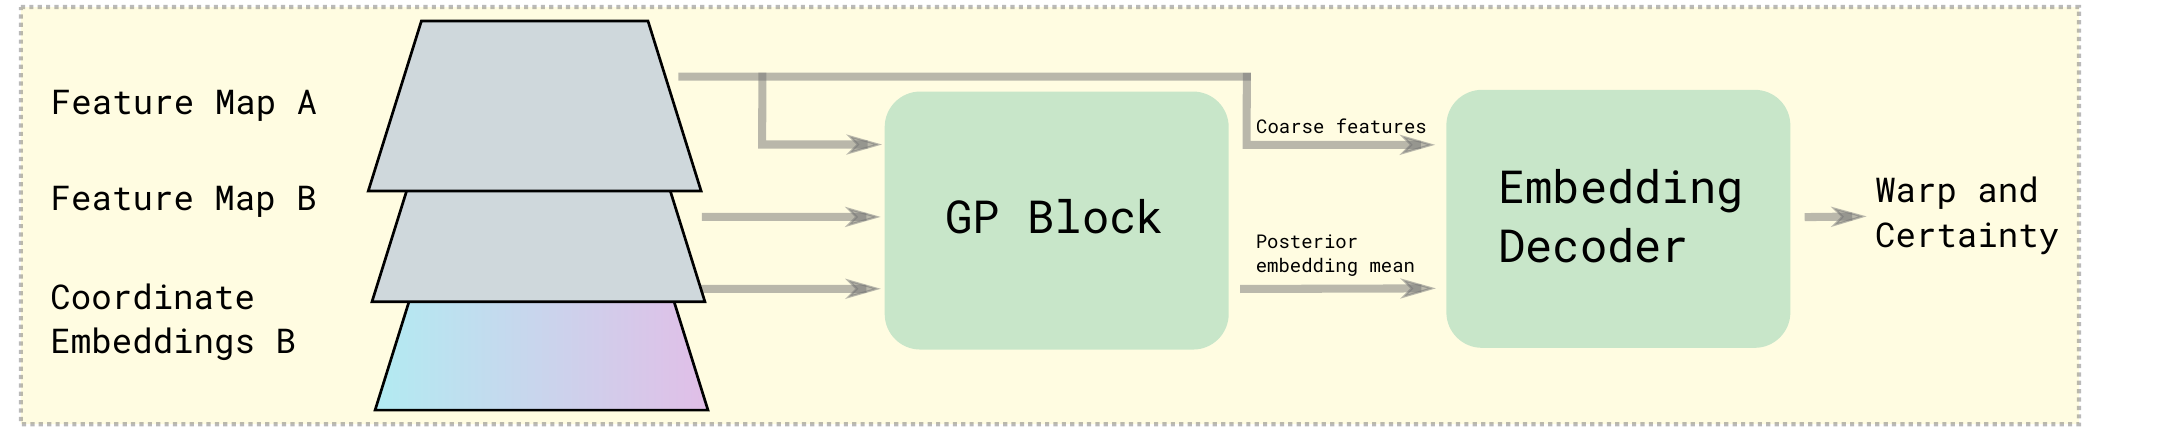
再用高斯过程回归求这个映射的后验。这里的关键是「回归的目标是坐标嵌入,而不是坐标本身」。如果直接回归二维坐标,两个等强的候选匹配会被平均成一个位于它们中间的、根本不存在的点;坐标嵌入把不同的空间位置映射到高维球面上不同的方向,多峰后验在嵌入空间里仍然可以保持区分,最后由 decoder 决定取哪一个模式。
GP 后验
把 B 的每个像素看成一个观测,特征为 ,观测值为它的坐标嵌入 。在零均值、噪声独立同分布的标准假设下,GP 后验均值和协方差为
其中 是观测噪声标准差[7]。, 是 B 内部所有像素两两的核矩阵。每一个 B 像素都是一个基函数, 负责对基之间的相关性做白化, 决定 A 的像素该向哪些基倾斜。因此「整张特征图作为基」的准确含义是:基的位置覆盖 B 的所有像素,基的取值是这些像素的坐标嵌入,核权重则来自深度特征的相似度。
余弦核与温度
论文选的是指数余弦相似度核:
其中 固定,。式中的 是常数,归一化后会消掉,所以真正起作用的只是「余弦相似度除以温度」。代码里把温度写成 ,核为
K = ((c - 1.0) / T).exp()它与论文的 完全等价。 越大,核越尖,后验越接近最近邻; 越小,权重越分散。作者说 都稳健,学温度几乎没有收益,所以固定为 5。
坐标嵌入
坐标嵌入用余弦函数:
其中 是归一化图像坐标,,,。这就是随机傅里叶特征(random Fourier features)[8]:它把低维坐标映射到高维,使得不同位置在嵌入空间里线性可分,同时保留多峰性。论文说嵌入维度 取 256(代码里的 gp_dim)。
一个实现细节:论文写的是随机初始化,代码里的 pos_conv 是一个可学习的 卷积,再取 。也就是说,嵌入的频率和相位是端到端学的,而不是固定的随机特征。这一点在复现时值得注意。
Embedding decoder
GP 输出的是 B 坐标嵌入的后验均值,形状仍是 A 的网格。DKM 把它 reshape 回 ,交给一个 embedding decoder 解码成 A 网格上的 warp 和 certainty logits。decoder 的结构借鉴了 Yu 等人的 DFN[9]:先降维、融合 A 的特征,再经过残差块和通道注意力,最后 卷积输出 3 个通道(2 个坐标 + 1 个 certainty logit)。stride 16 的 decoder 还会接收 stride 32 的上下文,形成粗到细的层级。
和 LoFTR / PDC-Net+ 的区别
- LoFTR 在粗网格上算相关矩阵,做行、列两个方向的 softmax(dual-softmax),再把两个方向的置信度相乘,取互相最近邻的粗匹配,最后在稀疏匹配周围提取局部 patch 精化[4]。它是一个「分类/分配」视角:先得到匹配分布,再取 argmax。DKM 是「回归」视角:对 A 的每个像素直接回归 B 的坐标嵌入,输出的是稠密 warp,不在粗阶段取 mutual nearest neighbour。
- PDC-Net+ 也建模不确定性,但它是在相关体上用一个混合分布头预测 warp 和置信度,精化仍以局部相关为主[5]。DKM 的 GP 是非参数的:B 的所有像素都参与,核由深度特征定义,不需要预设混合成分数。
- SuperGlue 用图神经网络在稀疏关键点之间做最优传输[2];DKM 完全不依赖关键点,连粗匹配也不做离散分配。
消融数字
表 4 把全局匹配器换成一个「强基线相关体回归器」做对比:基线 AUC@5 为 57.0,换成 DKM 的线性坐标回归为 57.9,换成余弦嵌入为 58.1。也就是说,GP 全局匹配器本身带来 +1.1 AUC@5,余弦嵌入比线性嵌入再高 0.2。这个消融是在较小的训练设置下做的,绝对值低于主表的 60.4,但趋势是作者要说明的重点。
代码:余弦核(官方 dkm/models/dkm.py,原文照录)
class CosKernel(nn.Module):  # similar to softmax kernel
    def __init__(self, T, learn_temperature=False):
        super().__init__()
        self.learn_temperature = learn_temperature
        if self.learn_temperature:
            self.T = nn.Parameter(torch.tensor(T))
        else:
            self.T = T

    def __call__(self, x, y, eps=1e-6):
        c = torch.einsum("bnd,bmd->bnm", x, y) / (
            x.norm(dim=-1)[..., None] * y.norm(dim=-1)[:, None] + eps
        )
        if self.learn_temperature:
            T = self.T.abs() + 0.01
        else:
            T = torch.tensor(self.T, device=c.device)
        K = ((c - 1.0) / T).exp()
        return K
代码:GP 后验均值(官方 dkm/models/dkm.py,原文照录)
    def forward(self, x, y, **kwargs):
        b, c, h1, w1 = x.shape
        b, c, h2, w2 = y.shape
        f = self.get_pos_enc(y)
        if self.predict_features:
            f = f + y[:,:self.dim] # Stupid way to predict features
        b, d, h2, w2 = f.shape
        #assert x.shape == y.shape
        x, y, f = self.reshape(x), self.reshape(y), self.reshape(f)
        K_xx = self.K(x, x)
        K_yy = self.K(y, y)
        K_xy = self.K(x, y)
        K_yx = K_xy.permute(0, 2, 1)
        sigma_noise = self.sigma_noise * torch.eye(h2 * w2, device=x.device)[None, :, :]
        # Due to https://github.com/pytorch/pytorch/issues/16963 annoying warnings, remove batch if N large
        if len(K_yy[0]) > 2000:
            K_yy_inv = torch.cat([torch.linalg.inv(K_yy[k:k+1] + sigma_noise[k:k+1]) for k in range(b)])
        else:
            K_yy_inv = torch.linalg.inv(K_yy + sigma_noise)

        mu_x = K_xy.matmul(K_yy_inv.matmul(f))
        mu_x = rearrange(mu_x, "b (h w) d -> b d h w", h=h1, w=w1)
        if not self.no_cov:
            cov_x = K_xx - K_xy.matmul(K_yy_inv.matmul(K_yx))
            cov_x = rearrange(cov_x, "b (h w) (r c) -> b h w r c", h=h1, w=w1, r=h1, c=w1)
            local_cov_x = self.get_local_cov(cov_x)
            local_cov_x = rearrange(local_cov_x, "b h w K -> b K h w")
            gp_feats = torch.cat((mu_x, local_cov_x), dim=1)
        else:
            gp_feats = mu_x
        return gp_feats
代码:余弦坐标嵌入(官方 dkm/models/dkm.py,原文节选)
    def project_to_basis(self, x):
        if self.basis == "fourier":
            return torch.cos(8 * math.pi * self.pos_conv(x))
        elif self.basis == "linear":
            return self.pos_conv(x)
        else:
            raise ValueError(
                "No other bases other than fourier and linear currently supported in public release"
            )

    def get_pos_enc(self, y):
        b, c, h, w = y.shape
        coarse_coords = torch.meshgrid(
            (
                torch.linspace(-1 + 1 / h, 1 - 1 / h, h, device=y.device),
                torch.linspace(-1 + 1 / w, 1 - 1 / w, w, device=y.device),
            )
        )

        coarse_coords = torch.stack((coarse_coords[1], coarse_coords[0]), dim=-1)[
            None
        ].expand(b, h, w, 2)
        coarse_coords = rearrange(coarse_coords, "b h w d -> b d h w")
        coarse_embedded_coords = self.project_to_basis(coarse_coords)
        return coarse_embedded_coords
上面的部件把「全局核权重」和「窗口内 softmax」放在同一张相似度图上对比。拖温度和窗口半径,可以看窗口外的证据如何被全局核利用、又如何被窗口丢掉。
2.3 Warp refinement:用堆叠特征图和深度可分离卷积逐级精化
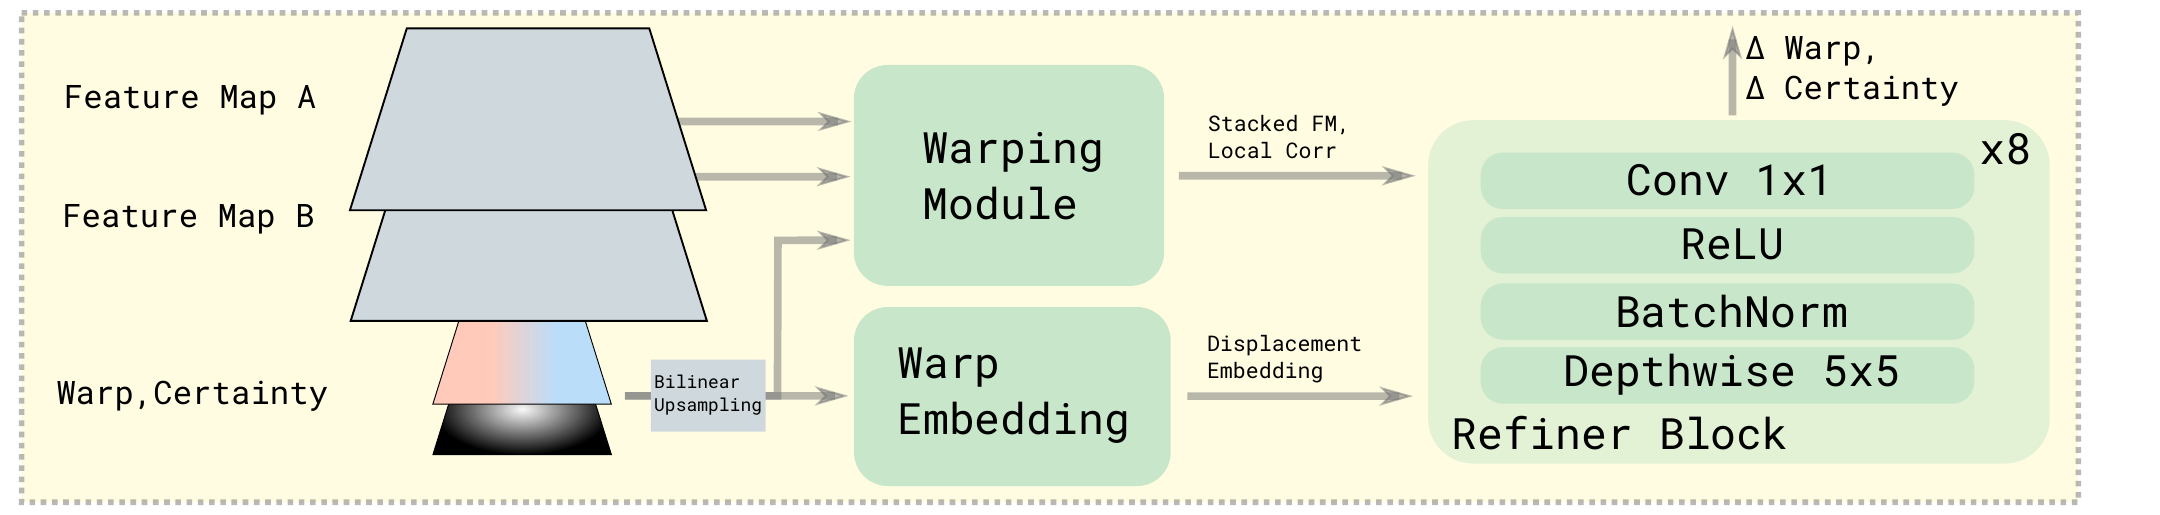
GP 和 decoder 给出的是粗尺度(stride 32/16)的 warp。接下来的精化器要在更细的尺度上把它推到像素级。DKM 的精化器不直接在相关体上回归,而是把「A 的特征」和「用当前 warp 采样得到的 B 特征」堆在一起,再加上位移嵌入和局部相关,送进一组深度可分离卷积 block。
对每一级 ,输入是 A、B 在该 stride 的特征 ,以及上一级上采样得到的 warp 和 certainty 。输出是残差位移 和 certainty 的 logit 增量 :
具体来说,精化器做四件事:
- Warp B 特征到 A 网格:用当前 warp 对 B 的特征做
grid_sample,得到 。这让网络能直接比较 A 和 B 在同一网格位置上的外观。 - 位移嵌入:把 warp 减去恒等网格(即每个像素到自身的坐标),得到位移场,再用一个 卷积嵌入到高维。网络因此知道「当前预测偏了多少」,而不是从零开始回归绝对坐标。
- 局部相关:在 B 上以 warp 目标为中心取一个 的窗口,与 A 的特征算相关。stride 16/8/4 的半径分别是 7/3/2;stride 2/1 不再用局部相关,只靠堆叠特征和位移嵌入。
- 8 个 refiner block:每个 block 是 卷积 → ReLU → BatchNorm → depthwise 卷积。depthwise 卷积把每个通道单独卷积,参数量和计算量都远小于同等感受野的普通卷积; 的核比此前常用的 有更大的感受野,能覆盖更长的结构。最后一个 卷积输出 3 个通道:2 个位移残差 + 1 个 certainty logit。
残差更新在代码里写作
其中 是当前 stride, 是图像宽度;代码把 refiner 输出的位移按 缩放到归一化坐标(纵向用 ),4 是固定的位移缩放系数。certainty 则是把 logit 增量直接相加,最后统一过 sigmoid。
为什么这比直接在相关体上回归更稳? 相关体只保留了「A 的某个特征与 B 的某个特征有多像」这一标量信息,通道维被求和掉;一旦纹理弱或视角大,相关峰就会变平或偏移,后续网络没有别的证据可看。堆叠特征图保留了完整的通道内容,网络可以同时看 A 的外观、B 被 warp 过来的外观、当前位移和局部相关这四类信息;深度可分离卷积用很小的代价扩大感受野,让每个像素能利用周围更大范围的结构。消融(表 5)里,baseline refiner 是 54.9,baseline 输入表示是 56.5,depthwise refiner + 堆叠特征图是 58.1:这一组合计 +3.2 AUC@5,其中输入表示带来 +1.6。论文正文写的是 depthwise +4.8、输入表示 +1.5,与表 5 的数值对不上,引用时以表格为准。
代码:refiner block 与残差预测(官方 dkm/models/dkm.py,原文照录)
    def create_block(
        self,
        in_dim,
        out_dim,
        dw=False,
        kernel_size=5,
    ):
        num_groups = 1 if not dw else in_dim
        if dw:
            assert (
                out_dim % in_dim == 0
            ), "outdim must be divisible by indim for depthwise"
        conv1 = nn.Conv2d(
            in_dim,
            out_dim,
            kernel_size=kernel_size,
            stride=1,
            padding=kernel_size // 2,
            groups=num_groups,
        )
        norm = nn.BatchNorm2d(out_dim)
        relu = nn.ReLU(inplace=True)
        conv2 = nn.Conv2d(out_dim, out_dim, 1, 1, 0)
        return nn.Sequential(conv1, norm, relu, conv2)

    def forward(self, x, y, flow):
        """Computes the relative refining displacement in pixels for a given image x,y and a coarse flow-field between them

        Args:
            x ([type]): [description]
            y ([type]): [description]
            flow ([type]): [description]

        Returns:
            [type]: [description]
        """
        device = x.device
        b,c,hs,ws = x.shape
        with torch.no_grad():
            x_hat = F.grid_sample(y, flow.permute(0, 2, 3, 1), align_corners=False)
        if self.has_displacement_emb:
            query_coords = torch.meshgrid(
            (
                torch.linspace(-1 + 1 / hs, 1 - 1 / hs, hs, device=device),
                torch.linspace(-1 + 1 / ws, 1 - 1 / ws, ws, device=device),
            )
            )
            query_coords = torch.stack((query_coords[1], query_coords[0]))
            query_coords = query_coords[None].expand(b, 2, hs, ws)
            in_displacement = flow-query_coords
            emb_in_displacement = self.disp_emb(in_displacement)
            if self.local_corr_radius:
                #TODO: should corr have gradient?
                if self.corr_in_other:
                    # Corr in other means take a kxk grid around the predicted coordinate in other image
                    local_corr = local_correlation(x,y,local_radius=self.local_corr_radius,flow = flow)
                else:
                    # Otherwise we use the warp to sample in the first image
                    # This is actually different operations, especially for large viewpoint changes
                    local_corr = local_correlation(x, x_hat, local_radius=self.local_corr_radius,)
                if self.no_support_fm:
                    x_hat = torch.zeros_like(x)
                d = torch.cat((x, x_hat, emb_in_displacement, local_corr), dim=1)
            else:
                d = torch.cat((x, x_hat, emb_in_displacement), dim=1)
        else:
            if self.no_support_fm:
                x_hat = torch.zeros_like(x)
            d = torch.cat((x, x_hat), dim=1)
        d = self.block1(d)
        d = self.hidden_blocks(d)
        d = self.out_conv(d)
        certainty, displacement = d[:, :-2], d[:, -2:]
        return certainty, displacement
代码:逐级精化循环(官方 dkm/models/dkm.py,原文节选)
        for new_scale in all_scales:
            ins = int(new_scale)
            f1_s, f2_s = f1[ins], f2[ins]
            if new_scale in self.proj:
                f1_s, f2_s = self.proj[new_scale](f1_s), self.proj[new_scale](f2_s)
            b, c, hs, ws = f1_s.shape
            if ins in coarse_scales:
                old_stuff = F.interpolate(
                    old_stuff, size=sizes[ins], mode="bilinear", align_corners=False
                )
                new_stuff = self.gps[new_scale](f1_s, f2_s, dense_flow=dense_flow)
                dense_flow, dense_certainty, old_stuff = self.embedding_decoder(
                    new_stuff, f1_s, old_stuff, new_scale
                )

            if new_scale in self.conv_refiner:
                delta_certainty, displacement = self.conv_refiner[new_scale](
                    f1_s, f2_s, dense_flow
                )
                dense_flow = torch.stack(
                    (
                        dense_flow[:, 0] + ins * displacement[:, 0] / (4 * w),
                        dense_flow[:, 1] + ins * displacement[:, 1] / (4 * h),
                    ),
                    dim=1,
                )
                dense_certainty = (
                    dense_certainty + delta_certainty
                )  # predict both certainty and displacement

            dense_corresps[ins] = {
                "dense_flow": dense_flow,
                "dense_certainty": dense_certainty,
            }

            if new_scale != "1":
                dense_flow = F.interpolate(
                    dense_flow,
                    size=sizes[ins // 2],
                    align_corners=False,
                    mode="bilinear",
                )

                dense_certainty = F.interpolate(
                    dense_certainty,
                    size=sizes[ins // 2],
                    align_corners=False,
                    mode="bilinear",
                )
                if self.detach:
                    dense_flow = dense_flow.detach()
                    dense_certainty = dense_certainty.detach()
下面的部件把 coarse-to-fine 的过程画出来:A 是参考网格,B 是当前的 warp。拖级数或点播放,看 B 网格如何从只拟合低频的粗 warp,逐级贴上更细的位移;右侧曲线是示意位移场的残差。
2.4 置信度与平衡采样
用「一致的深度」监督 certainty
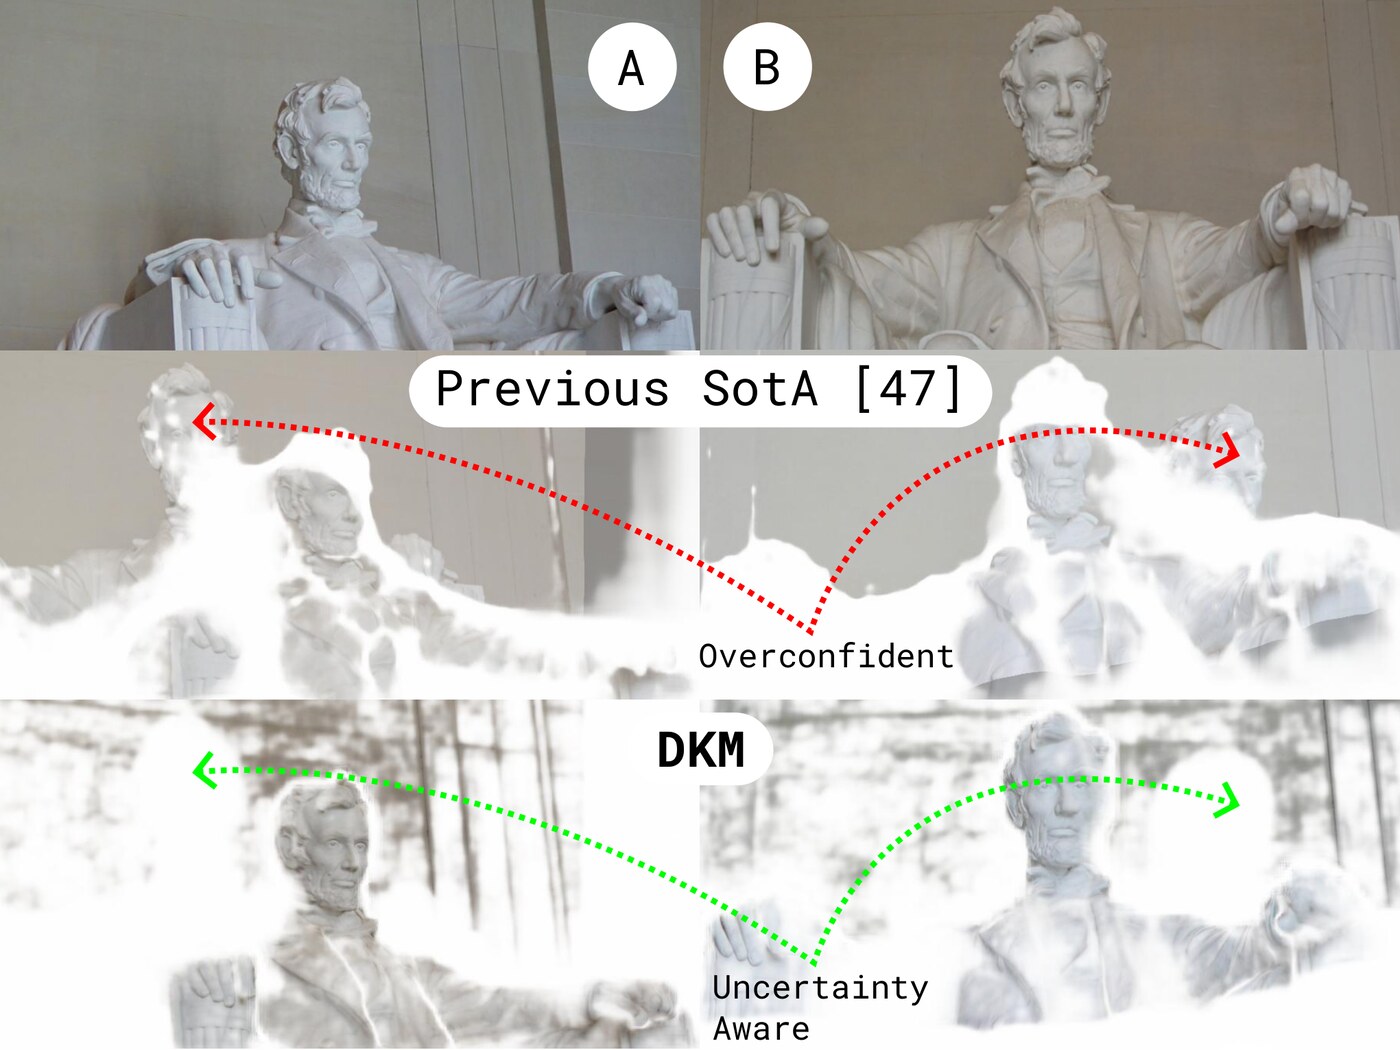
稠密匹配在不可匹配的区域(遮挡、出视野、无纹理)也会给出一个坐标,所以必须同时预测「这个匹配可不可信」。此前 PDC-Net+ 用混合分布头建模不确定性,但作者发现它在不可匹配的区域仍然经常过度自信(图 6)。
DKM 的做法很直接:用 ground-truth 深度和位姿把 A 的像素投影到 B,然后检查 B 处的深度是否一致。对 A 的像素 ,设它投影到 B 后的深度为 ,B 在对应位置的深度为 ,则
这个 就是 certainty 的监督标签:深度一致为 1,否则为 0。损失是逐像素的二元交叉熵(BCE):
总损失为
论文式 (13) 里 BCE 的写法漏了负号,代码用的是 binary_cross_entropy_with_logits,等价于在 logit 上做数值稳定的 BCE。另一个细节是:细尺度的置信度损失只在粗尺度 warp 已经接近真值时生效——代码用上一级的几何误差 做掩码,误差超过阈值的位置不参与细尺度损失,避免「粗匹配错了,细匹配再怎么对也被惩罚」。此外,不同尺度之间会 detach,防止细尺度梯度反过来扰动粗尺度。
平衡采样:让匹配在场景里散开
有了 certainty 之后,最直接的做法是按 certainty 加权采样。但这样会让匹配扎堆在纹理丰富、certainty 高的区域,进入估计器的点空间分布很差。对单应和基础矩阵估计来说,匹配的空间分布和匹配本身的精度同样重要:平面场景是单应的退化情形,标定情形下的五点法也常常病态,分布集中的匹配会让估计器数值不稳。
DKM 的做法是:
- 按 certainty 阈值 过滤:高于阈值的 certainty 置 1,低于的保留原值;从这组权重里无放回采样 目标数量的匹配。
- 在 4 维匹配空间 上做 KDE(高斯核,标准差 0.1),得到每个匹配的局部密度。
- 以 为权重再采样一次;密度低于 10 的区域权重压到 ,相当于要求一个匹配附近至少有约 10 个邻居,避免采到孤立的坏点。
- 最终取 10000 个匹配(论文设置)交给 RANSAC。
为什么放在 RANSAC 之前? certainty 负责「筛掉不可信的匹配」,平衡采样负责「让剩下的匹配在场景里散开」。前者提高内点率,后者改善估计器的条件数。两者都不改变网络本身,只是采样策略,但表 6 显示它们对最终位姿精度的影响非常大:不用 certainty 时 AUC@5 只有 42.9,用 certainty 升到 56.1,再加平衡采样升到 58.1。也就是说,置信度带来 +13.2,平衡采样再带来 +2.0。
代码:深度一致性损失(官方 dkm/losses/depth_match_regression_loss.py,原文节选)
    def dense_depth_loss(self, dense_certainty, prob, gd, scale, eps=1e-8):
        """[summary]

        Args:
            dense_certainty ([type]): [description]
            prob ([type]): [description]
            gd ([type]): [description]
            scale ([type]): [description]
            eps ([type], optional): [description]. Defaults to 1e-8.

        Returns:
            [type]: [description]
        """
        smooth_prob = prob
        ce_loss = F.binary_cross_entropy_with_logits(dense_certainty[:, 0], smooth_prob)
        depth_loss = gd[prob > 0]
        if not torch.any(prob > 0).item():
            depth_loss = (gd * 0.0).mean()  # Prevent issues where prob is 0 everywhere
        return {
            f"ce_loss_{scale}": ce_loss.mean(),
            f"depth_loss_{scale}": depth_loss.mean(),
        }

    def forward(self, dense_corresps, batch):
        """[summary]

        Args:
            out ([type]): [description]
            batch ([type]): [description]

        Returns:
            [type]: [description]
        """
        scales = list(dense_corresps.keys())
        tot_loss = 0.0
        prev_gd = 0.0
        for scale in scales:
            dense_scale_corresps = dense_corresps[scale]
            dense_scale_certainty, dense_scale_coords = (
                dense_scale_corresps["dense_certainty"],
                dense_scale_corresps["dense_flow"],
            )
            dense_scale_coords = rearrange(dense_scale_coords, "b d h w -> b h w d")
            b, h, w, d = dense_scale_coords.shape
            gd, prob = self.geometric_dist(
                batch["query_depth"],
                batch["support_depth"],
                batch["T_1to2"],
                batch["K1"],
                batch["K2"],
                dense_scale_coords,
                scale,
            )
            if (
                scale <= self.local_largest_scale and self.local_loss
            ):  # Thought here is that fine matching loss should not be punished by coarse mistakes, but should identify wrong matching
                prob = prob * (
                    F.interpolate(prev_gd[:, None], size=(h, w), mode="nearest")[:, 0]
                    < (2 / 512) * (self.local_dist * scale)
                )
            depth_losses = self.dense_depth_loss(dense_scale_certainty, prob, gd, scale)
            scale_loss = (
                self.ce_weight * depth_losses[f"ce_loss_{scale}"]
                + depth_losses[f"depth_loss_{scale}"]
            )  # scale ce loss for coarser scales
            if self.scale_normalize:
                scale_loss = scale_loss * 1 / scale
            tot_loss = tot_loss + scale_loss
            prev_gd = gd.detach()
        return tot_loss
代码:阈值 + KDE 平衡采样(官方 dkm/models/dkm.py 与 dkm/utils/kde.py,原文照录)
    def sample(
        self,
        dense_matches,
        dense_certainty,
        num=10000,
    ):
        if "threshold" in self.sample_mode:
            upper_thresh = self.sample_thresh
            dense_certainty = dense_certainty.clone()
            dense_certainty[dense_certainty > upper_thresh] = 1
        elif "pow" in self.sample_mode:
            dense_certainty = dense_certainty**(1/3)
        elif "naive" in self.sample_mode:
            dense_certainty = torch.ones_like(dense_certainty)
        matches, certainty = (
            dense_matches.reshape(-1, 4),
            dense_certainty.reshape(-1),
        )
        expansion_factor = 4 if "balanced" in self.sample_mode else 1
        good_samples = torch.multinomial(certainty,
                          num_samples = min(expansion_factor*num, len(certainty)),
                          replacement=False)
        good_matches, good_certainty = matches[good_samples], certainty[good_samples]
        if "balanced" not in self.sample_mode:
            return good_matches, good_certainty

        from dkm.utils.kde import kde
        density = kde(good_matches, std=0.1)
        p = 1 / (density+1)
        p[density < 10] = 1e-7 # Basically should have at least 10 perfect neighbours, or around 100 ok ones
        balanced_samples = torch.multinomial(p,
                          num_samples = min(num,len(good_certainty)),
                          replacement=False)
        return good_matches[balanced_samples], good_certainty[balanced_samples]
def kde(x, std = 0.1, device=None):
if device is None:
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
if isinstance(x, np.ndarray):
x = torch.from_numpy(x)
# use a gaussian kernel to estimate density
x = x.to(device)
scores = (-torch.cdist(x,x)**2/(2*std**2)).exp()
density = scores.sum(dim=-1)
return density2.5 训练细节
训练目标就是 2.4 节的多尺度损失:每个 stride 都有 warp 回归损失和 certainty 的 BCE,。优化器是 AdamW[10],权重衰减 ;decoder 和 refiner 的学习率 ,backbone 为 (论文按 4 卡设置换算;代码里是每卡乘以卡数)。batch size 32,训练 250k 步,在 166,666 和 225,000 步把学习率乘 0.2。室外模型在 MegaDepth[11] 上训练,分辨率 ;室内模型额外加入 ScanNet[12],分辨率 。作者报告室外训练约 5 天、4 张 A100;作为对比,LoFTR 约 1 天、64 张 1080Ti。
一个实现细节:室内训练时,MegaDepth 分支的 DepthRegressionLoss 用 ce_weight=0.01,ScanNet 分支用 ce_weight=0.00,也就是 ScanNet 只提供 warp 的几何监督,不提供 certainty 的 BCE 监督。室内模型的 certainty 主要仍是从 MegaDepth 学到的。
三、实验结果
3.1 评测协议
DKM 在三个标准基准上评测:HPatches 的单应估计[13]、MegaDepth-1500 的室外相对位姿[11]、ScanNet-1500 的室内相对位姿[12]。室外和室内分别训练、分别评测。位姿指标是 AUC@,即相对旋转误差小于阈值的 pair 比例(同时受平移误差约束),越高越好;HPatches 用 AUC@3/5/10 px。DKM 每次采样最多 5000 个匹配,RANSAC 阈值 0.5,内参按长边 1200 换算。
3.2 HPatches 单应估计
| 方法 | AUC@3px | AUC@5px | AUC@10px |
|---|---|---|---|
| SuperGlue | 53.9 | 68.3 | 81.7 |
| LoFTR | 65.9 | 75.6 | 84.6 |
| ASpanFormer | 67.4 | 76.9 | 85.6 |
| PDC-Net+ | 67.7 | 77.6 | 86.3 |
| DKM | 71.3 | 80.6 | 88.5 |
DKM 比此前最好的 PDC-Net+ 高 +3.6 AUC@3px。值得注意的是 HPatches 是平面场景,而 DKM 是在 MegaDepth 的非平面场景上训练的,没有针对单应做特殊设计,这说明学到的稠密对应本身有不错的泛化性。
3.3 MegaDepth-1500 相对位姿
| 方法 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| SuperGlue | 42.2 | 61.2 | 76.0 |
| LoFTR | 52.8 | 69.2 | 81.2 |
| QuadTree | 54.6 | 70.5 | 82.2 |
| ASpanFormer | 55.3 | 71.5 | 83.1 |
| PDC-Net+ | 51.5 | 67.2 | 78.5 |
| DKM | 60.4 | 74.9 | 85.1 |
这是 DKM 最有说服力的一组结果:比最好的稀疏方法 ASpanFormer[14] 高 +5.1 AUC@5(论文正文写 +4.9,同样是舍入差),比最好的稠密方法 PDC-Net+ 高 +8.9。表中 QuadTree[15] 用四叉树注意力降低全局注意力的成本,是另一类有代表性的半稠密方法。注意这里的「稀疏」包括 ASpanFormer 这种 detector-free 的半稠密方法;DKM 作为稠密方法,第一次在这个基准上同时超过两类方法。
3.4 ScanNet-1500 相对位姿
| 方法 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| SuperGlue | 16.2 | 33.8 | 51.8 |
| LoFTR | 22.1 | 40.8 | 57.6 |
| ASpanFormer | 25.6 | 46.0 | 63.3 |
| PDC-Net+ | 20.3 | 39.4 | 57.1 |
| DKM | 29.4 | 50.7 | 68.3 |
室内场景纹理更弱、视角变化更剧烈,DKM 的优势反而更大:比 ASpanFormer 高 +3.8(论文正文写 +4.0,应该是未舍入数值的差),比 PDC-Net+ 高 +9.1(正文写 +9.3)。这类「正文与表格差 0.1–0.2」的情况在论文里不止一处,引用时以表格为准即可。
3.5 额外基准
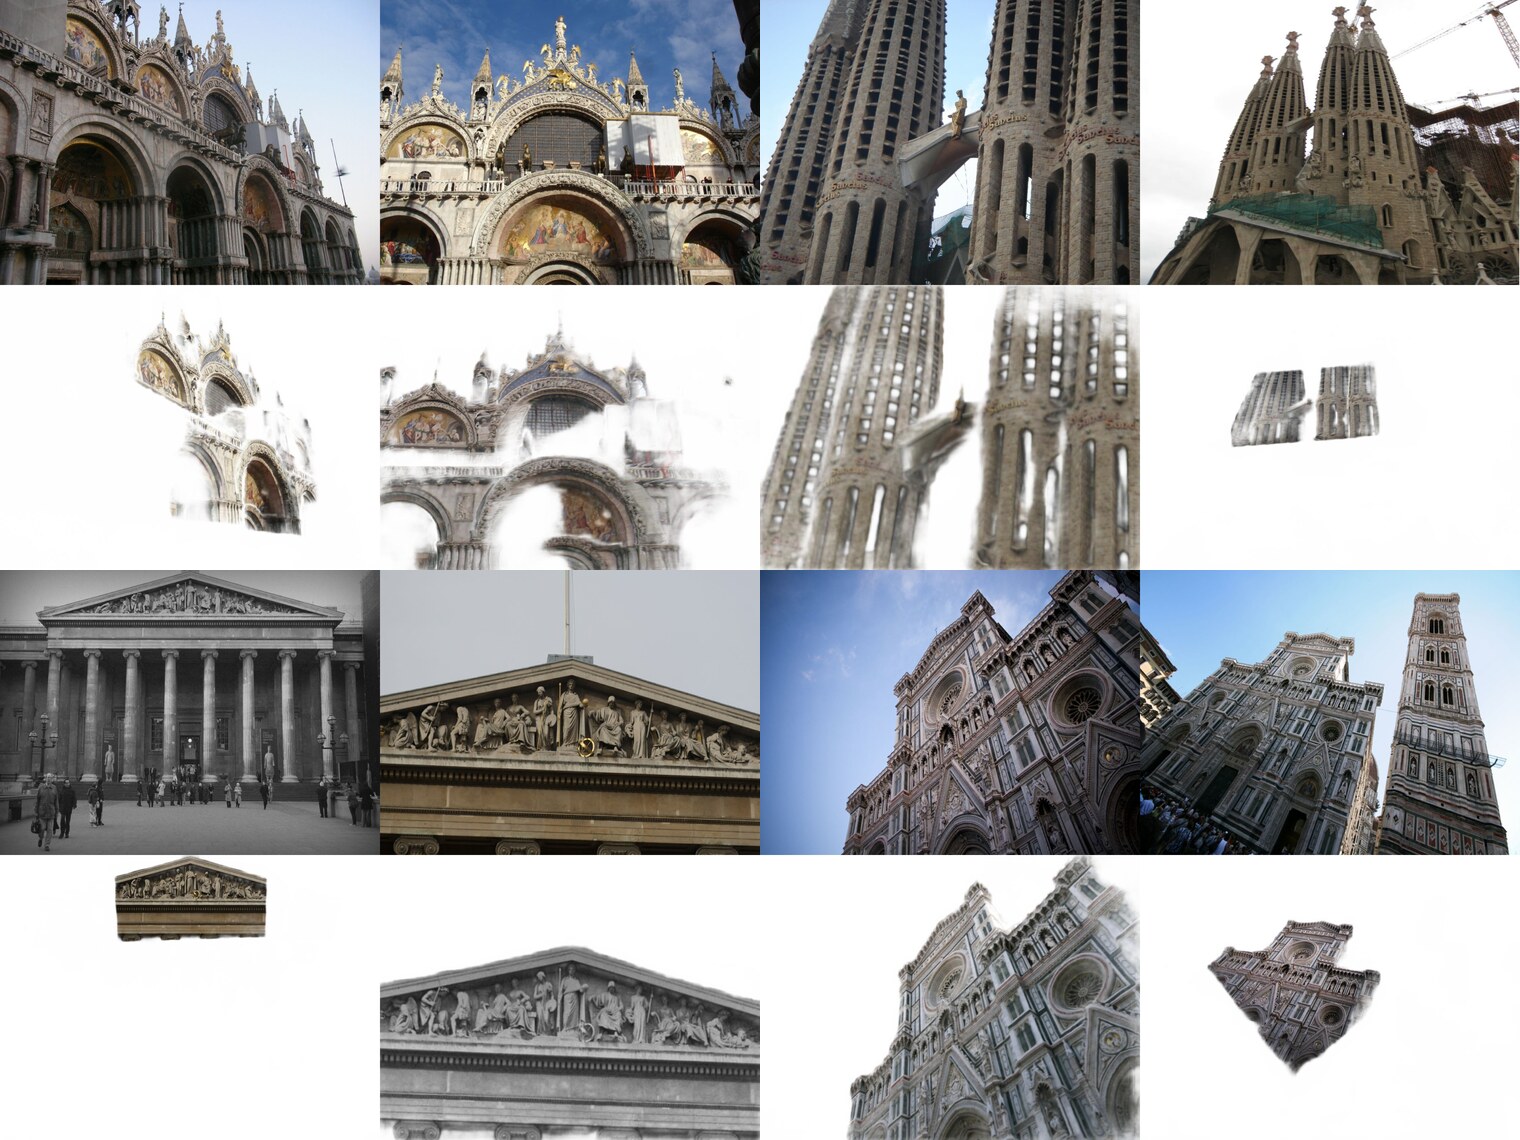
作者还构造了 MegaDepth-8-Scenes:从 8 个不同的 MegaDepth 场景采 1600 对,避免 MegaDepth-1500 只覆盖两个场景带来的偏差。DKM 的 AUC@5/10/20 是 60.5/74.5/84.2,ASpanFormer 是 57.2/72.1/82.9,PDC-Net+ 是 51.8/66.6/77.2,趋势和 MegaDepth-1500 一致。
在 St. Paul’s Cathedral 上,DKM 的 mAA@5°/10° 是 53.3/72.1,COTR 是 44.3/66.0[16],ECO-TR 是 45.3/66.1[17],提升约 +8.0 mAA@5°。
3.6 运行时间与 RANSAC
论文没有报告推理时间,只给了训练成本(约 5 天 / 4×A100,LoFTR 约 1 天 / 64×1080Ti),所以无法从论文直接比较推理吞吐。从实现上看,GP 的主要开销是对 B 的核矩阵求逆:在 输入下,stride 32 的 B 网格约 个点,stride 16 约 个点,后者对应一个 的矩阵求逆;代码在 时按 batch 逐个求逆,说明大分辨率下这是显存和计算的主要瓶颈之一。这是我们的分析,不是论文给出的数字。
另一个容易被忽略的点是 RANSAC 后端。仓库 README 给出:同一组 DKMv3 匹配,标准 RANSAC 的 MegaDepth-1500 AUC@5/10/20 是 60.5/74.9/85.1,换成 Graph-Cut RANSAC[18] 后是 65.5/78.0/86.7。也就是说,后端估计器能把 AUC@5 再抬高 5 个点,比很多网络改动的收益还大。做对比实验时如果后端不一致,结论会被严重混淆。
四、局限性
4.1 论文承认的局限
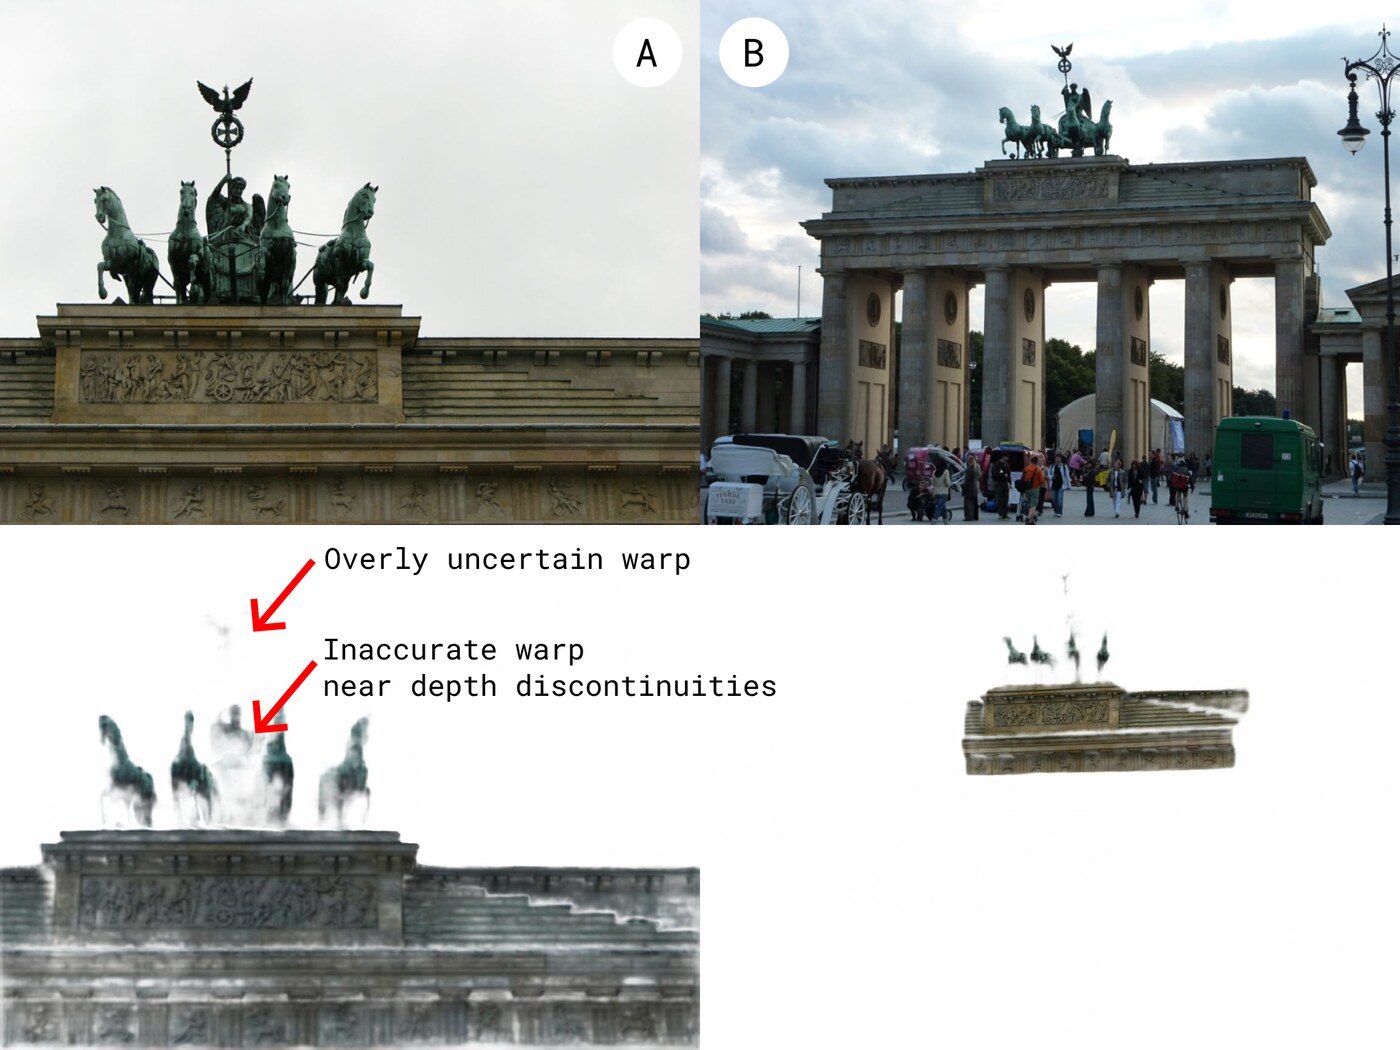
- 精化是单峰的。GP 全局匹配器可以表示多峰后验,但后续的稠密 warp 精化仍是单模态的;在深度不连续处(前景和背景的交界),一个像素的 warp 只能选一边,精化器容易给出介于两者之间的错误位移。图 8 是一个典型失败案例。
- 天空边缘的小物体过度不确定。作者发现 DKM 对紧邻天空的小物体会给出过低的 certainty。他们推测这是因为 certainty 被训练成「分类深度一致性」,而不是像 PDC-Net 那样预测模型不确定性;当深度本身在小物体边缘不可靠时,分类器学到的是一种偏保守的决策边界。
4.2 我们补充的观察
- 分辨率敏感。仓库 README 明确警告 DKM 是在固定分辨率上训练的,换成更高或更低的分辨率可能显著变差。论文表 7 也显示,训练分辨率从 提高到 ,AUC@5 从 58.1 升到 59.4(+1.3)。官方评测脚本在 MegaDepth-1500 上把输入改成 、再上采样到 ,说明「训练分辨率」和「评测分辨率」并不是一回事,复现时要按脚本设置,不能想当然。
- 动态场景没有评测。MegaDepth 和 ScanNet 都是静态场景;DKM 的深度一致性标签依赖静态假设,对运动物体、非刚性形变没有专门处理。这是作者的评测范围之外,不是他们声称解决的问题。
- 重复纹理的多峰只是被「表示」,没有被「解决」。坐标嵌入让 GP 后验可以保留多个模式,但 decoder 和 refiner 最终还是要输出一个单峰 warp;当两个模式同样合理时,网络只能选一个,错误会静默地传下去。图 1 的 certainty 能标出部分不可靠区域,但不能替代多视图几何的一致性检查。
- 置信度监督依赖深度。室外模型用 MegaDepth 的稠密深度,室内 ScanNet 分支的
ce_weight=0.00,意味着 ScanNet 数据不直接监督 certainty。没有可靠深度标签的数据集(例如纯 RGB 的互联网图像)无法直接复制这套监督。 - 推理成本没有公开。论文只给训练成本;GP 的 求逆在 stride 16 上已经不便宜,实际部署时需要考虑分辨率、是否上采样、是否用双向匹配等开关。
五、结论与展望
DKM 的核心贡献不是某个网络模块,而是换了一个建模视角:稠密匹配不必是「在相关体上分类/回归」,而可以是「以整张特征图为基的高斯过程回归」。这个视角带来三个直接好处:核权重是全局的,低纹理时仍能利用远处的显著证据;坐标嵌入保留多峰,不会把两个候选平均成中间点;GP 的后验均值是一个光滑的稠密场,适合后续用 CNN 解码和精化。配合堆叠特征图、深度可分离卷积、深度一致性置信度和 KDE 平衡采样,DKM 在两视图几何估计上第一次让稠密方法同时超过稀疏和半稠密方法。
这条线后来演化出了几条分支。RoMa 延续了「稠密匹配 + 鲁棒特征」的思路,用更强的预训练特征和 transformer 匹配编码器替代 GP,把鲁棒性推到更困难的场景[19];RoMa v2 进一步换成 DINOv3 特征、单头注意力匹配和更快的精化器,并给出逐像素误差协方差[20]。DUSt3R 把稠密匹配当作三维重建的先验,直接用点图回归绕开传统匹配管线[21];FlexGlue 则把稠密匹配的精度和稀疏匹配的速度结合起来,做稀疏到稠密的非对称匹配[22]。DKM 的置信度和平衡采样思想,在这些后继工作里以不同形式反复出现。
对实践者来说,DKM 留下的几条经验比架构本身更耐用:
- 匹配的表示比匹配的头更重要。相关体丢掉了通道信息,堆叠特征图保留了外观;在低纹理和大视角下,这个差别比换一个更深的 transformer 更大。
- 置信度要有一个几何上可验证的定义。「深度一致」比「模型自己觉得有多确定」更容易监督,也更容易解释;但它依赖深度标签,换数据集时要重新设计。
- 采样策略是免费的性能。同样的网络输出,按 certainty 过滤 + KDE 平衡采样,能让 AUC@5 从 42.9 跳到 58.1;很多匹配论文只报告网络指标,忽略了进入估计器的匹配分布。
- 后端估计器要和匹配器一起选。GC-RANSAC 相对标准 RANSAC 的 +5 AUC@5,说明匹配器和估计器的接口值得单独调。
六、上手
官方仓库提供了 DKMv3 的室外/室内权重、两个 demo 和评测脚本。安装只需要 pip install -e .,权重会在第一次调用时自动下载。
安装与 demo(官方仓库,demo 路径按实际目录)
git clone https://github.com/Parskatt/DKM.git
cd DKM
pip install -e .
python demo/demo_match.py
python demo/demo_fundamental.py
最小 API 如下。DKMv3_outdoor() 默认内部推理分辨率是 ,并把预测上采样到 ;DKMv3_indoor() 默认 ,不上采样。match 返回归一化坐标下的 warp 和 certainty(双向模式下两个方向拼在宽度维),sample 按 certainty 采样;需要像素坐标时调用 to_pixel_coordinates(matches, H_A, W_A, H_B, W_B),其中 H/W 是单幅图像的尺寸。
import torch
from dkm import DKMv3_outdoor

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = DKMv3_outdoor(device=device)
warp, certainty = model.match(
    "assets/sacre_coeur_A.jpg", "assets/sacre_coeur_B.jpg", device=device
)
matches, certainty = model.sample(warp, certainty)
几个和论文概念对应的开关:
model.sample_mode = "threshold_balanced":论文用的采样模式;sample_threshold = 0.05是 certainty 阈值。IMC2022 上作者建议把阈值调到 0.2。model.symmetric = True:双向匹配,把两个方向的 warp 拼起来;论文表 8 里双向比单向高 +1.0 AUC@5。model.upsample_preds = True/False:是否在 stride 1 上再跑一次 refiner;室外权重默认开,室内默认关。model.h_resized / w_resized:内部推理分辨率。改动它会影响结果,官方评测脚本在 MegaDepth-1500 上用 输入、 上采样,和训练时的 不同。
评测 MegaDepth-1500(官方脚本)
# 数据:LoFTR 的 MegaDepth-1500 split
# 放到 data/megadepth/Undistorted_SfM/0015 与 0022
python experiments/dkm/test_DKMv3_outdoor.py
评测 ScanNet-1500(官方脚本)
# 数据:SuperGlue/LoFTR 的 ScanNet split,需要先接受 ScanNet 的使用协议
python experiments/dkm/test_DKMv3_indoor.py
训练(官方脚本,需先按 docs/training.md 准备 MegaDepth)
python experiments/dkm/train_DKMv3_outdoor.py --gpus 4
python experiments/dkm/train_DKMv3_indoor.py --gpus 4
需要提醒的是,仓库 docs/training.md 里的命令写的是 experiments/dkmv3/...,实际目录是 experiments/dkm/;按实际路径运行即可。另外,论文表格和 README 的数字有 0.1 左右的出入(例如 MegaDepth-1500 AUC@5,论文表 2 是 60.4,README 标「DKMv3 (paper)」是 60.5,发布权重实测是 60.0),这是多次运行取平均和舍入造成的,不必当成实现错误。
参考
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Truong, Danelljan, Timofte, Van Gool. PDC-Net+: Enhanced Probabilistic Dense Correspondence Network. IEEE TPAMI 2023. arXiv · 代码
- He, Zhang, Ren, Sun. Deep Residual Learning for Image Recognition. CVPR 2016. arXiv
- Rasmussen, Williams. Gaussian Processes for Machine Learning. MIT Press, 2006. 书籍
- Tancik, Srinivasan, Mildenhall, Fridovich-Keil, Raghavan, Singhal, Ramamoorthi, Barron, Ng. Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains. NeurIPS 2020. arXiv
- Yu, Wang, Peng, Gao, Yu, Sang. Learning a Discriminative Feature Network for Semantic Segmentation. CVPR 2018. arXiv
- Loshchilov, Hutter. Decoupled Weight Decay Regularization. ICLR 2019. arXiv
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Dai, Chang, Savva, Halber, Funkhouser, Nießner. ScanNet: Richly-Annotated 3D Reconstructions of Indoor Scenes. CVPR 2017. arXiv
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Chen, Luo, Zhou, Tian, Zhen, Fang, McKinnon, Tsin, Quan. ASpanFormer: Detector-Free Image Matching with Adaptive Span Transformer. ECCV 2022. arXiv · 代码
- Tang, Zhang, Zhu, Tan. QuadTree Attention for Vision Transformers. ICLR 2022. arXiv · 代码
- Jiang, Trulls, Hosang, Tagliasacchi, Yi. COTR: Correspondence Transformer for Matching Across Images. ICCV 2021. arXiv · 代码
- Tan, Liu, Chen, Chen, Zhang, Shen, Ding, Ji. ECO-TR: Efficient Correspondences Finding via Coarse-to-Fine Refinement. ECCV 2022. arXiv
- Barath, Matas. Graph-Cut RANSAC. CVPR 2018. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Nordström, Zhang, Bökman, Astermark, Larsson, Heyden, Kahl, Wadenbäck, Felsberg. RoMa v2: Harder Better Faster Denser Feature Matching. arXiv 2511.15706, 2025. arXiv · 代码
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Lindenberger, Sarlin, Miksik, Pollefeys. FlexGlue: Sparse-to-Dense Feature Matching and Visual Disambiguation. arXiv 2610.32976, 2026. arXiv · 代码