· 88 min read
论文解读:ALIKE,可微分关键点检测与轻量级局部特征
TL;DR ALIKE[1] 保留了「score map + NMS」的骨架,但把 NMS 的格点位置换成一个局部窗口内的 soft-argmax:NMS 仍然负责粗定位,格点内的亚像素偏移则由邻域分数的 softmax 期望给出,于是关键点位置第一次可以被重投影损失直接、端到端地优化。再配合离散度峰值损失(把分数压成尖峰)、NRE 稠密描述子损失、可靠性损失,以及一个只有 0.318M 参数、7.91 GFLOPs 的轻量网络,ALIKE-N 在 640×480 上跑到 95 FPS(Titan X Pascal),HPatches MHA@3 75.74%,比 ASLFeat(MS) 高 2.22 个点而计算量低 5.6 倍。官方推理代码、四个尺度的权重和训练代码(zip)都已开源;ALIKED[2] 是它把稠密描述子改成稀疏可变形描述子后的后继。
- 论文:ALIKE: Accurate and Lightweight Keypoint Detection and Descriptor Extraction,Xiaoming Zhao, Xingming Wu, Jinyu Miao, Weihai Chen, Peter C. Y. Chen, Zhengguo Li,IEEE TMM 2022(DOI 10.1109/TMM.2022.3155927)。
- 代码:github.com/Shiaoming/ALIKE(推理与权重;训练代码在仓库的
assets/ALIKE_code.zip里,不在 git 树中)。 - 前作 / 相关:SuperPoint、D2-Net、R2D2、DISK、ALIKED、XFeat。
一、动机:NMS 选出的位置,本身不可导
2018 到 2021 年,学习型局部特征的主线基本定型:一个共享的 CNN 同时回归 score map 和 descriptor map,检测时在 score map 上做非极大值抑制(non-maximum suppression,NMS)取局部最大,描述子则在同一个位置(或双线性采样)取出。SuperPoint[3] 用自监督的 MagicPoint 加单应性适应训练检测器;D2-Net[4] 把检测分数定义在深层特征图上,用通道最大响应加 NMS 找点;R2D2[5] 显式预测 repeatability 和 reliability 两张图,在 repeatability 上做 NMS;DISK[6] 用策略梯度把关键点采样变成可训练的概率过程;ASLFeat[7] 则用可变形卷积增强特征。它们的共同点是:检测分数是一张稠密图,但最终位置是 argmax。
argmax 有两个硬伤:
- 不可导。NMS 只返回窗口内分数最大的那个像素下标,位置对分数的梯度是零(或未定义)。于是「把关键点往更准确、更可重复的位置挪一挪」这件事无法通过反向传播完成,检测器只能靠间接监督:给 score map 造合成 GT(SuperPoint 的 MagicPoint)、约束局部 patch 的分数相似度,或者干脆只训练描述子、让检测器自己学。KeyNet[8] 虽然在局部用了 softargmax,但它仍用手工滤波器、且在 score map 上训练,而不是直接优化关键点位置。
- 只有像素级精度。下游的单应估计、相机位姿、视觉定位都希望关键点落在亚像素位置;经典 SIFT 用二次拟合做亚像素精化,而大多数学习型检测器输出的是整数坐标,再靠插值描述子「假装」是连续的。
ALIKE 的切入点就是这两点:保留 score map + NMS,但把位置写成「NMS 格点 + 局部可微偏移」。NMS 仍然给出粗定位(整像素),偏移由窗口内分数的 softmax 期望给出,因此位置是分数的连续函数,梯度可以从偏移流回局部 score map。围绕这个可微位置,作者又设计了直接监督位置的重投影损失、让峰更尖的离散度峰值损失、约束稠密描述子的 NRE 损失,以及把分数压向可区分区域的可靠性损失。网络则刻意做小:Normal 版本 0.318M 参数、7.91 GFLOPs,在 640×480 上 95 FPS。
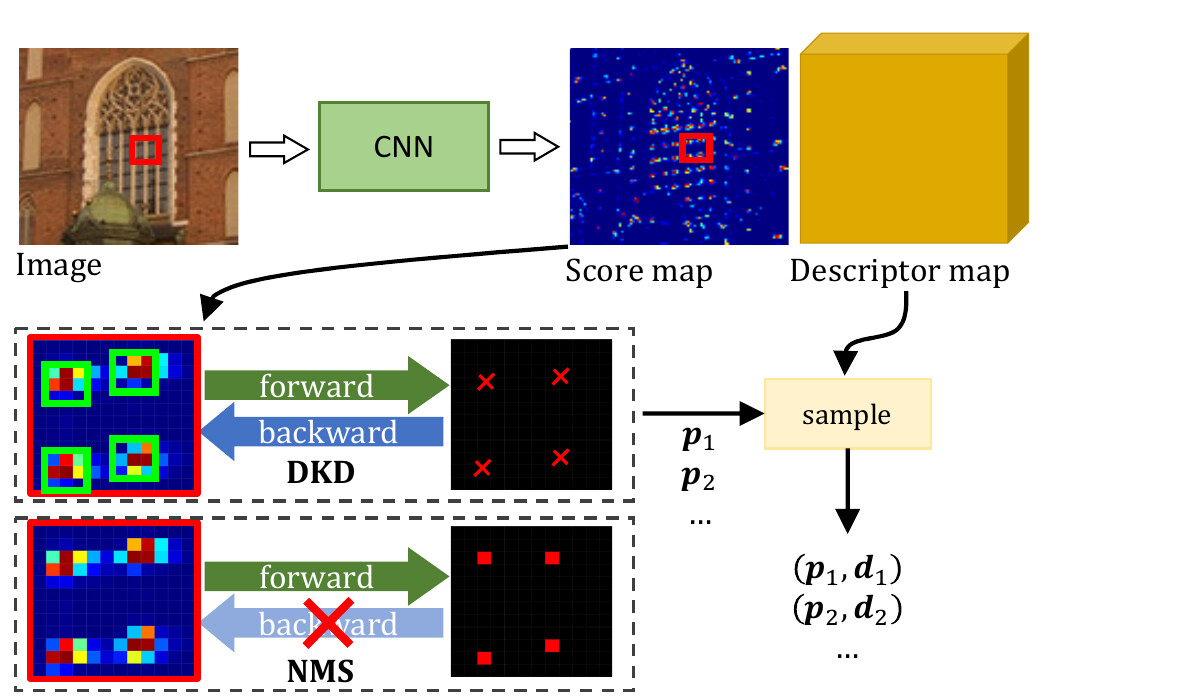
论文把贡献归纳为三条:可微分关键点检测模块 DKD,以及配套的重投影损失和离散度峰值损失;用 NRE 训练稠密描述子、用可靠性损失筛掉低纹理/重复区域的关键点;一个为实时性设计的轻量网络。需要先说明的是,ALIKE 是一个稀疏检测器 + 描述子,不是匹配器;论文的所有比较都停在「检测/描述子 + 最近邻匹配 + 下游几何估计」这一层,没有和 SuperGlue、LoFTR 这类匹配器结合。
二、核心方法
2.1 总体架构:一个编码器、一个 1×1 头
输入是 的 RGB 图像,网络输出两张同样分辨率()的图:score map 和 descriptor map 。结构分三段:
- 编码器:block 1 是两层 卷积 + ReLU(ConvBlock);block 2、3、4 都是先 max-pooling 再接一个 的 basic ResBlock。分辨率依次是 、、、,通道数为 。论文特别指出最大感受野是 ——对 480×480 的训练裁剪来说,这个感受野已经覆盖了相当大的一片上下文。
- 特征聚合:每个尺度的特征先过 卷积压到 通道,再双线性上采样回 ,最后沿通道拼接。这样既有浅层的高分辨率定位信息,也有深层的语义信息。
- 检测/描述头:再一个 卷积输出 通道;前 通道是描述子,逐像素做 L2 归一化;最后一个通道过 sigmoid 得到分数。Normal 及以下只有一个这样的头,Large 多一层 卷积()。
四个配置如下(表 I):
| 模型 | dim | 参数/M | GFLOPs(640×480) | |||||
|---|---|---|---|---|---|---|---|---|
| Tiny | 8 | 16 | 32 | 64 | 64 | 1 | 0.080 | 2.109 |
| Small | 8 | 16 | 48 | 96 | 96 | 1 | 0.142 | 3.893 |
| Normal | 16 | 32 | 64 | 128 | 128 | 1 | 0.318 | 7.909 |
| Large | 32 | 64 | 128 | 128 | 128 | 2 | 0.653 | 19.685 |
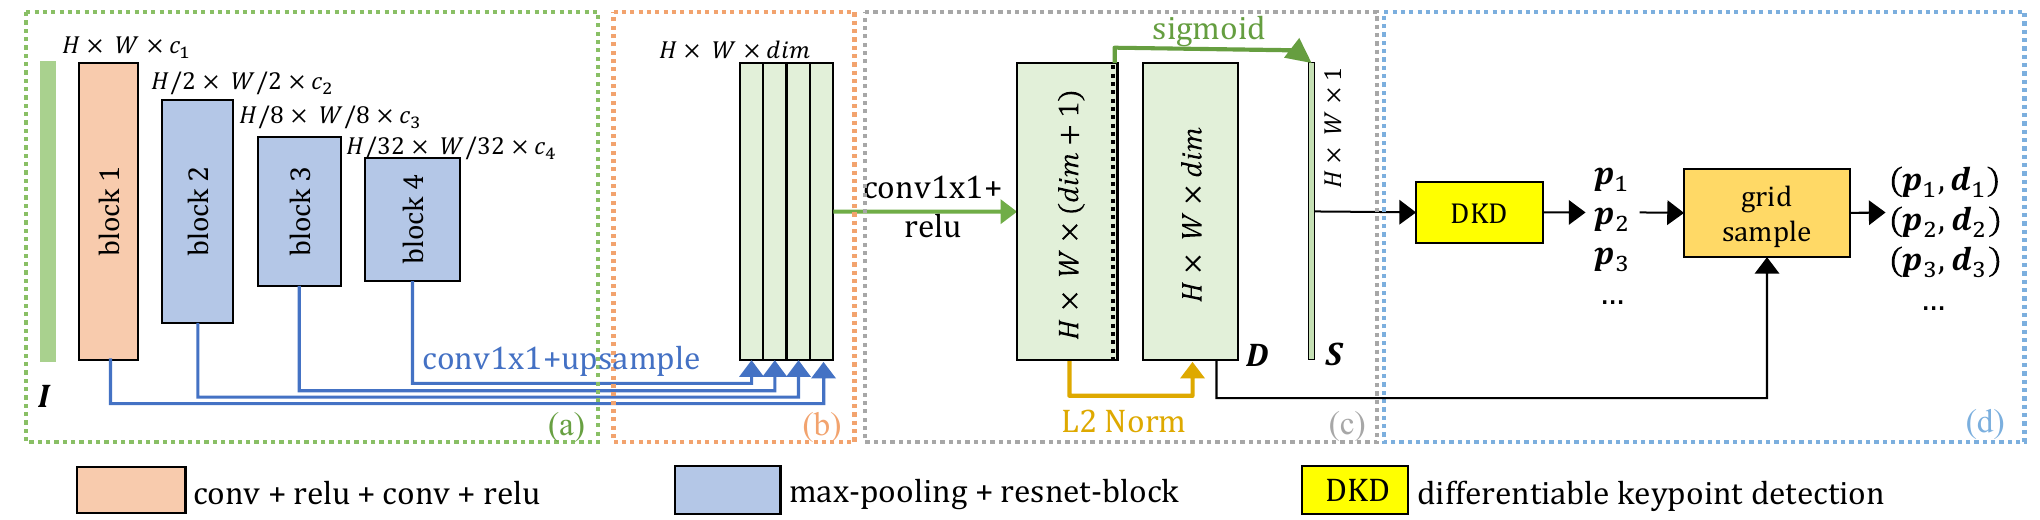
代码:前向传播与多尺度聚合(官方 alnet.py,原文节选)
    def forward(self, image):
        # ================================== feature encoder
        x1 = self.block1(image)  # B x c1 x H x W
        x2 = self.pool2(x1)
        x2 = self.block2(x2)  # B x c2 x H/2 x W/2
        x3 = self.pool4(x2)
        x3 = self.block3(x3)  # B x c3 x H/8 x W/8
        x4 = self.pool4(x3)
        x4 = self.block4(x4)  # B x dim x H/32 x W/32

        # ================================== feature aggregation
        x1 = self.gate(self.conv1(x1))  # B x dim//4 x H x W
        x2 = self.gate(self.conv2(x2))  # B x dim//4 x H//2 x W//2
        x3 = self.gate(self.conv3(x3))  # B x dim//4 x H//8 x W//8
        x4 = self.gate(self.conv4(x4))  # B x dim//4 x H//32 x W//32
        x2_up = self.upsample2(x2)  # B x dim//4 x H x W
        x3_up = self.upsample8(x3)  # B x dim//4 x H x W
        x4_up = self.upsample32(x4)  # B x dim//4 x H x W
        x1234 = torch.cat([x1, x2_up, x3_up, x4_up], dim=1)

        # ================================== detector and descriptor head
        if not self.single_head:
            x1234 = self.gate(self.convhead1(x1234))
        x = self.convhead2(x1234)  # B x dim+1 x H x W

        descriptor_map = x[:, :-1, :, :]
        scores_map = torch.sigmoid(x[:, -1, :, :]).unsqueeze(1)

return scores_map, descriptor_map这里最值得注意的设计取舍是:检测和描述共享同一个骨干、同一个头,且没有解码器。检测需要高分辨率(否则 NMS 的格点太粗),描述需要足够的通道(否则区分力不够),两者都在 上输出,代价主要来自 descriptor map 的 dim 个通道。这也是后来 ALIKED 把稠密描述子改成「只在稀疏关键点上算描述子」的动机。
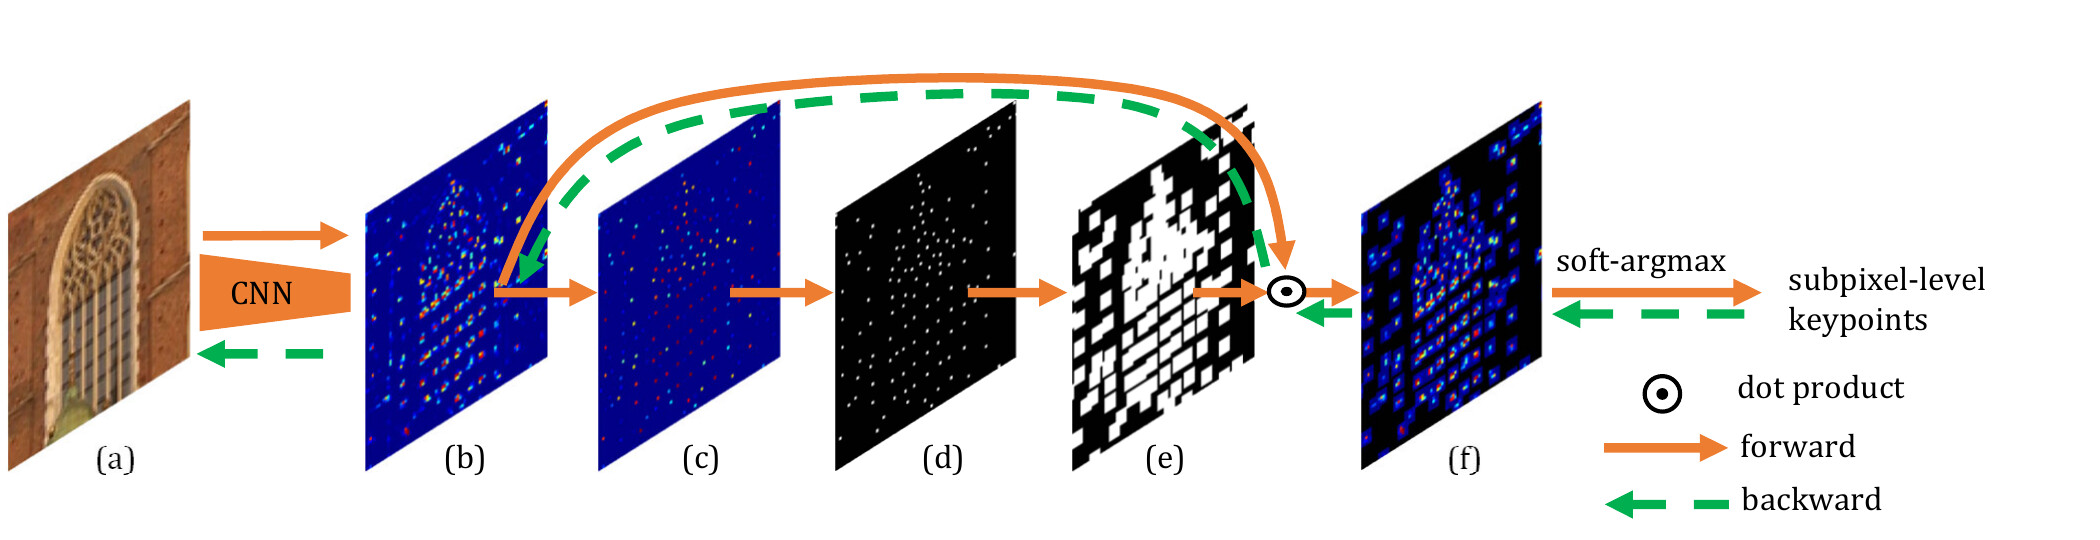
2.2 DKD:把 argmax 换成局部 soft-argmax
设 score map 为 ,NMS 窗口为 。标准做法是
再把窗口内非最大的分数置零,得到一个 NMS 后的 score map(论文 Fig. 3(c))。ALIKE 不在这里停下:它以每个 NMS 关键点为中心,取一个 的局部窗口,对窗口内的分数做带温度的 softmax:
其中 是窗口内的最大分数, 是温度。然后把这个 softmax 分布当作「关键点落在各个格点上的概率」,取期望作为亚像素偏移:
最终关键点是
这里面有两个关键细节:
- NMS 项被 detach。 是整数下标,来自
simple_nms的argmax,不参与求导;可导的只有偏移项 。所以论文称它是「部分可微」(partially differentiable):位置对分数的梯度只在局部窗口内存在,且只通过 softmax 期望回流。这样既避免了 argmax 的梯度问题,又不需要像策略梯度那样采样。 - 减掉窗口最大值再除以温度。
s_max本身也 detach,目的是数值稳定、避免「分数整体平移」影响 softmax;温度 控制分布的尖锐程度。温度越小,softmax 越接近 one-hot,关键点越贴近 NMS 格点;温度越大,邻域投票越多,偏移越平滑,但也会把位置往窗口重心拉。
这个设计比 argmax 好在三点。第一,位置是分数的连续函数,重投影损失可以直接对 求导,从而「教」局部 score map 把峰移到正确位置。第二,输出是亚像素的,描述子可以在连续坐标上双线性采样,下游几何估计直接受益。第三,梯度只在一个 的小窗口里流动,计算和显存开销都很小;如果把 soft-argmax 做成全图期望,远处的大量峰会把位置拉偏,而且代价高得多。
训练时 DKD 的窗口是 ;论文在每张图上用 DKD 检测 400 个关键点,再随机采样 400 个非显著位置的点一起训练。推理时窗口半径默认也是 2(radius=2),NMS 后按分数阈值 0.2 或 top-k 取点,最多 20000 个(demo 里 n_limit=5000)。注意官方推理代码把 NMS 半径写死成 2(simple_nms(scores_nograd, 2)),而 DKD 的 radius 是可配置的;默认二者一致,改 radius 时 NMS 不会自动跟着变。
代码:DKD 的核心计算(官方 soft_detect.py,原文节选)
        if sub_pixel:
            # detect soft keypoints with grad backpropagation
            patches = self.unfold(scores_map)  # B x (kernel**2) x (H*W)
            self.hw_grid = self.hw_grid.to(patches)  # to device
            for b_idx in range(b):
                patch = patches[b_idx].t()  # (H*W) x (kernel**2)
                indices_kpt = indices_keypoints[b_idx]  # one dimension vector, say its size is M
                patch_scores = patch[indices_kpt]  # M x (kernel**2)

                # max is detached to prevent undesired backprop loops in the graph
                max_v = patch_scores.max(dim=1).values.detach()[:, None]
                x_exp = ((patch_scores - max_v) / self.temperature).exp()  # M * (kernel**2), in [0, 1]

                # \frac{ \sum{(i,j) \times \exp(x/T)} }{ \sum{\exp(x/T)} }
                xy_residual = x_exp @ self.hw_grid / x_exp.sum(dim=1)[:, None]  # Soft-argmax, Mx2

                hw_grid_dist2 = torch.norm((self.hw_grid[None, :, :] - xy_residual[:, None, :]) / self.radius,
                                           dim=-1) ** 2
                scoredispersity = (x_exp * hw_grid_dist2).sum(dim=1) / x_exp.sum(dim=1)

                # compute result keypoints
                keypoints_xy_nms = torch.stack([indices_kpt % w, indices_kpt // w], dim=1)  # Mx2
                keypoints_xy = keypoints_xy_nms + xy_residual
                keypoints_xy = keypoints_xy / keypoints_xy.new_tensor(
                    [w - 1, h - 1]) * 2 - 1  # (w,h) -> (-1~1,-1~1)

                kptscore = torch.nn.functional.grid_sample(scores_map[b_idx].unsqueeze(0),
                                                           keypoints_xy.view(1, 1, -1, 2),
                                                           mode='bilinear', align_corners=True)[0, 0, 0, :]  # CxN

                keypoints.append(keypoints_xy)
                scoredispersitys.append(scoredispersity)
                kptscores.append(kptscore)
scoredispersity 就是后面峰值损失的输入:它算的是窗口内每个格点到 soft-argmax 位置的平方距离(按 radius 归一化)在 softmax 分布下的期望——分布越散,值越大;越尖,值越小。论文 Eq. (13) 写的是 ,代码里没有显式的 ,而是除以 softmax 权重之和并用了半径归一化的距离;两者在「尖峰小、散峰大」这个目标上是一致的,但具体数值不能逐项对照。
这个玩具模型说明的是机制,不是精度:真实的亚像素位置是否对准角点,取决于局部 score map 被重投影损失训练成了什么形状。默认 时 softmax 几乎是 one-hot,soft-argmax 只比格点偏约 0.005 px;温度升到 0.3,有效投票格数从 1.0 涨到 2.5,偏移变成 0.07 px,离散度从 0.007 涨到 0.53。论文选 0.1,是在「保留一点可微偏移」和「不要被邻域拉偏」之间取的折中。
2.3 四个损失
DKD 给出了可微的位置,但位置对不对、分数尖不尖、描述子好不好,仍然需要损失来定义。ALIKE 的损失可以分成「位置」和「描述子」两组。
2.3.1 重投影损失:直接监督亚像素位置
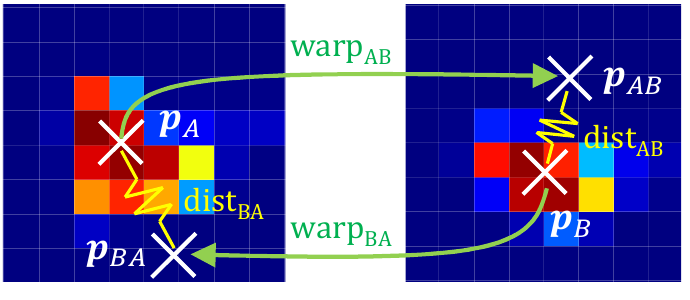
给定一对图像 和已知的几何变换(单应或 3D 投影),把 A 中的关键点 warp 到 B:
在 B 中找距离 最近、且距离小于 像素的检测关键点 ,定义重投影距离
并用对称形式
作为损失。论文取 、;代码里只有两个关键点的分数都大于 0.1 时才计入,避免用低置信度的点监督。
这个损失的意义在于:它不是监督 score map 的某个中间量,而是直接监督 DKD 输出的位置。梯度从 流到 ,再流到局部窗口里的分数;于是「把峰往正确位置挪」变成了一个可优化的目标。作者还指出,这隐式地提升了可重复性:不可重复的位置会产生大的重投影误差,自然被压下去。
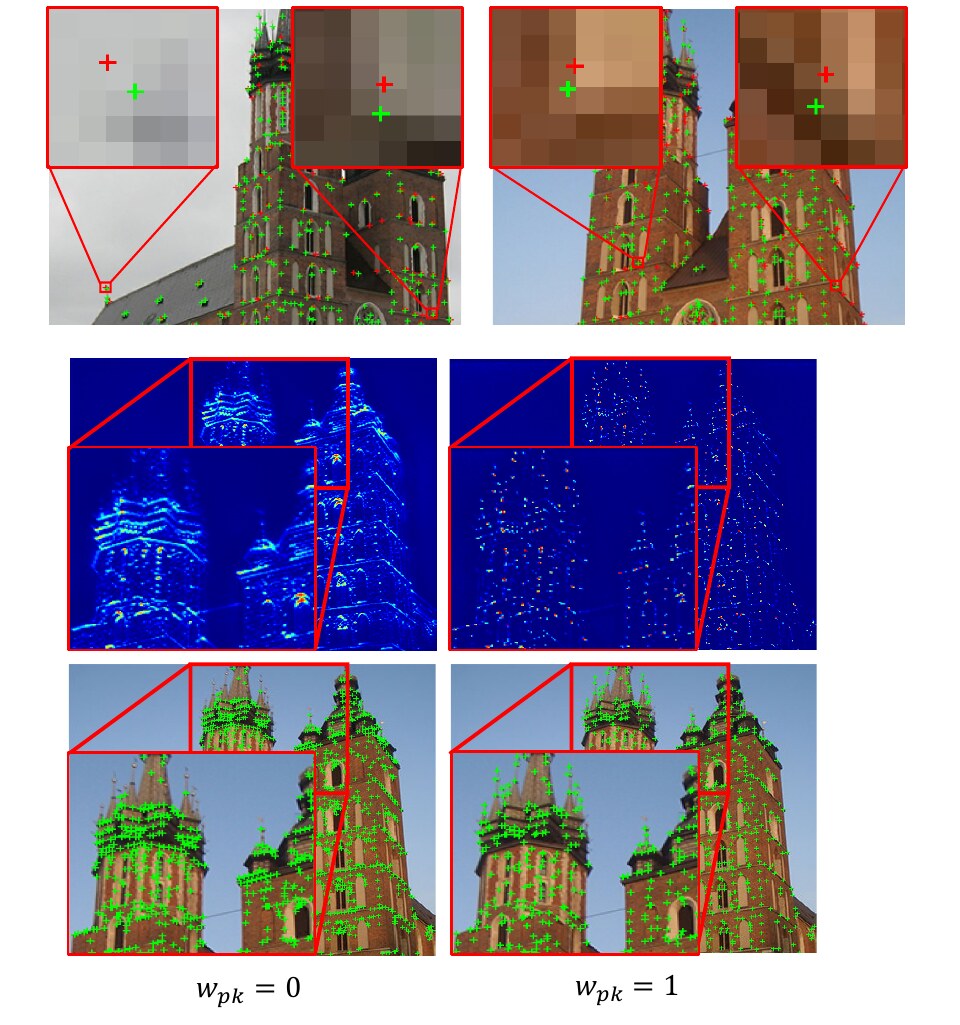
消融上,重投影损失是提升最直接的一项。以「RL+DE」为基线(59.26/34.55/71.83/67.22,依次是 Rep/MS/MMA@3/MHA@3),加上 RP 后变成 65.77/38.12/74.44/70.74:Rep +6.51、MS +3.57、MMA +2.61、MHA +3.52。论文 Fig. 7 的定性对比也支持这一点:带重投影损失的网络(绿色十字)在放大的 patch 里更贴近真正的角点,不带它的(红色十字)会偏到旁边的纹理上。
代码:重投影位置损失(官方训练代码 nets/losses.py,原文照录)
class ReprojectionLocLoss(object):
    """
    Reprojection location errors of keypoints to train repeatable detector.
    """

    def __init__(self, norm: int = 1, scores_th: float = 0.1):
        super().__init__()
        self.norm = norm
        self.scores_th = scores_th

    def __call__(self, pred0, pred1, correspondences):
        b, c, h, w = pred0['scores_map'].shape
        loss_mean = 0
        CNT = 0
        for idx in range(b):
            if correspondences[idx]['correspondence0'] is None:
                continue

            if self.norm == 2:
                dist = correspondences[idx]['dist']
            elif self.norm == 1:
                dist = correspondences[idx]['dist_l1']
            else:
                raise TypeError('No such norm in correspondence.')

            ids0_d = correspondences[idx]['ids0_d']
            ids1_d = correspondences[idx]['ids1_d']

            scores0 = correspondences[idx]['scores0'].detach()[ids0_d]
            scores1 = correspondences[idx]['scores1'].detach()[ids1_d]
            valid = (scores0 > self.scores_th) * (scores1 > self.scores_th)
            reprojection_errors = dist[ids0_d, ids1_d][valid]

            loss_mean = loss_mean + reprojection_errors.sum()
            CNT = CNT + len(reprojection_errors)

        loss_mean = loss_mean / CNT if CNT != 0 else correspondences[0]['dist'].new_tensor(0)

        assert not torch.isnan(loss_mean)
        return loss_mean
代码里的 dist/dist_l1 是 A、B 两组有效关键点之间的交叉距离矩阵,ids0_d/ids1_d 是互为最近邻的下标;valid 把低分点剔掉,最后对所有有效重投影误差取均值。注意它用的是 warp 后坐标与 B 中检测点之间的距离,而不是描述子相似度——这正是「位置损失」和「描述子损失」的分工。
2.3.2 离散度峰值损失:让峰更尖
只有重投影损失还不够。soft-argmax 的位置是窗口内所有分数的加权平均,如果峰很宽、旁边还有一串次高响应,窗口稍微一移,soft-argmax 就会被拉走。已有的「peak loss」通常约束 max - mean,但这是一个一阶统计量:两个 patch 可以有完全相同的最大值和均值,空间分布却完全不同——一个尖,一个散。论文 Fig. 5 的玩具例子就是如此:红色、绿色、棕色三条分布的 max 和 mean 相同,但离散度峰值损失分别是 0.5075、0.0647、0.0995。
作者因此把「分数到 soft 关键点的距离」也纳入损失:
就是 Eq. (3) 的 softmax 分数。直观地说:离 soft 关键点越远的格点,如果还分到不可忽略的权重,就要付代价。优化这个损失会把分数往关键点附近压,使峰更尖;峰尖了,NMS 窗口轻微平移时,soft-argmax 仍然落在同一个位置,关键点更稳定。
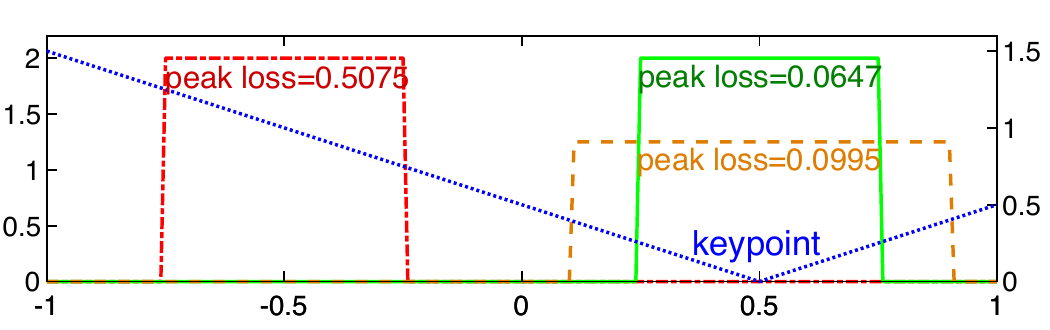
下面这个部件把论文 Fig. 5 的构造做成了可拖动的版本:三条分布的最大值和均值严格相同(2.00 和 0.60,因此 max−mean 都是 1.40),只有空间位置不同。默认 时,B 的平台覆盖关键点、L_pk 最小;A 的平台在最左边、L_pk 最大。把 拖到左边,三者的排序会反过来。
这个部件里 的数值(默认 0.501/0.075/0.125)和论文 Fig. 5 的 0.5075/0.0647/0.0995 在同一量级,差异来自采样密度和平台边界;重要的是排序和「max−mean 无法区分」这个结论。
但离散度峰值损失有一个真实的代价。Table III 里,从「RL+DE」到「PK+RL+DE」,Rep 从 59.26 掉到 48.75、MS 从 34.55 掉到 30.88、MMA 从 71.83 掉到 62.95,MHA 却从 67.22 升到 72.59;从「RP+RL+DE」到「RP+PK+DE」也是同样的方向(Rep 65.77→51.11,MHA 70.74→74.44)。论文的解释是:峰变尖后,关键点更倾向于挤在少数高响应位置,可重复性和匹配数会下降;但位置更确定,单应估计的角点精度(MHA)反而上升。作者认为下游几何估计比中间指标更重要,所以保留了这一项。这是一个很诚实的取舍,也是读这篇论文时最该记住的一点:Table III 里 Rep/MS 最高的配置并不是最终模型。
代码:离散度峰值损失(官方训练代码 nets/losses.py,原文照录)
class PeakyLoss(object):
    """ PeakyLoss to avoid an uniform score map """

    def __init__(self, scores_th: float = 0.1):
        super().__init__()
        self.scores_th = scores_th

    def __call__(self, pred):
        b, c, h, w = pred['scores_map'].shape
        loss_mean = 0
        CNT = 0
        n_original = len(pred['score_dispersity'][0])
        for idx in range(b):
            scores_kpts = pred['scores'][idx][:n_original]
            valid = scores_kpts > self.scores_th
            loss_peaky = pred['score_dispersity'][idx][valid]

            loss_mean = loss_mean + loss_peaky.sum()
            CNT = CNT + len(loss_peaky)

        loss_mean = loss_mean / CNT if CNT != 0 else pred['scores_map'].new_tensor(0)
        assert not torch.isnan(loss_mean)
        return loss_mean
pred['score_dispersity'] 就是 2.2 节 DKD 里算出的那个量,n_original 是 DKD 检测出的原始关键点数(随机采样的 400 个点不算);只对分数大于 0.1 的点计损失。也就是说,峰值损失并不是对整张 score map 做正则,而是对「被检测出来的关键点周围」做局部正则。
2.3.3 NRE 描述子损失:稠密、概率化、稳定
描述子部分,早期做法是 triplet loss:拉近对应描述子、推远最难负样本。但它只约束关键点上的稀疏描述子,稠密 descriptor map 的其余位置完全没有监督;而且难负样本挖掘对超参很敏感。ALIKE 改用 DISK 也用过的 neural reprojection error(NRE)[9]。
对 A 中的关键点 ,取它的描述子 ,与 B 的稠密描述子图 做点积,得到相似度图
再补一个「外点」类别 (相似度固定为 1),把相似度图过 softmax 得到匹配概率图:
其中 是带 的相似度图, 控制分布的锐度。另一方面,由已知的 warp 可以得到「重投影概率图」: 的对应点 落在哪个像素,就给哪个像素(以及双线性插值的四个邻居)相应的权重。NRE 就是两个分布的交叉熵:
总损失对 A、B 两个方向的所有关键点取平均(Eq. 18)。和 triplet 相比,NRE 的监督信号覆盖整张 descriptor map:每个像素都在「竞争」成为正确匹配,外点类别则显式地吸收没有对应的区域。代价是要算并存储「关键点数 × H × W」的相似度图,显存和训练时间都更高;论文也承认这一点。
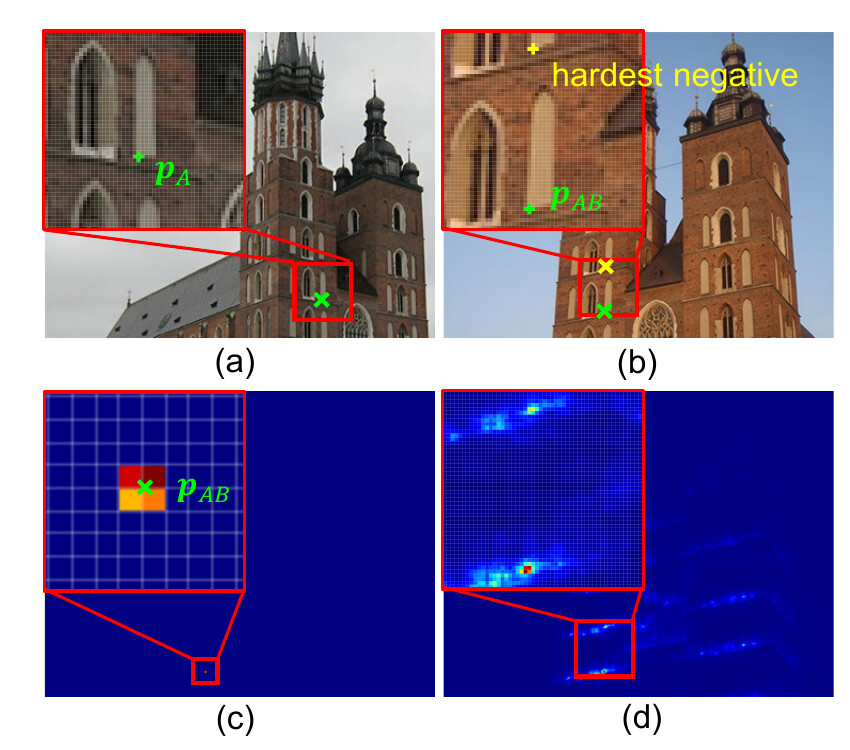
消融很能说明问题:把 NRE 换成 triplet(Table III 最后一行),Rep 还有 57.91,但 MS 从 38.58 崩到 14.13、MMA 从 70.78 崩到 39.38、MHA 从 75.74 掉到 60.74。论文的解释是 triplet 陷入了局部极小:损失逼近 margin 但没有穿过它,所有描述子变得一样(论文 Fig. 9 的训练曲线),匹配分数自然崩溃。NRE 的概率化监督收敛更稳,虽然更吃显存。
代码:NRE 描述子损失(官方训练代码 nets/losses.py,原文照录)
class DescReprojectionLoss(object):
    """ Reprojection loss between warp and descriptor matching """

    def __init__(self, temperature=0.02):
        super().__init__()
        self.inv_temp = 1. / temperature

    def __call__(self, pred0, pred1, correspondences):
        b, c, h, w = pred0['scores_map'].shape
        device = pred0['scores_map'].device
        wh = pred0['keypoints'][0].new_tensor([[w - 1, h - 1]])
        loss_mean = 0
        CNT = 0

        for idx in range(b):
            if correspondences[idx]['correspondence0'] is None:
                continue

            kpts01, kpts10 = correspondences[idx]['kpts01'], correspondences[idx]['kpts10']  # valid warped keypoints

            similarity_map_01 = correspondences[idx]['similarity_map_01']
            similarity_map_10 = correspondences[idx]['similarity_map_10']
            ids0, ids1 = correspondences[idx]['ids0'], correspondences[idx]['ids1']
            ids0_out, ids1_out = correspondences[idx]['ids0_out'], correspondences[idx]['ids1_out']

            # ======================= valid
            similarity_map_01_valid, similarity_map_10_valid = similarity_map_01[ids0], similarity_map_10[ids1]
            similarity_map_01_valid = (similarity_map_01_valid - 1) * self.inv_temp
            similarity_map_10_valid = (similarity_map_10_valid - 1) * self.inv_temp

            # matching probability mass function
            pmf01_valid = torch.softmax(similarity_map_01_valid.view(-1, h * w), dim=1).view(-1, h, w)
            pmf10_valid = torch.softmax(similarity_map_10_valid.view(-1, h * w), dim=1).view(-1, h, w)

            pmf01_kpts_valid = torch.nn.functional.grid_sample(pmf01_valid.unsqueeze(0), kpts01.view(1, 1, -1, 2),
                                                               mode='bilinear', align_corners=True)[0, :, 0, :]
            pmf10_kpts_valid = torch.nn.functional.grid_sample(pmf10_valid.unsqueeze(0), kpts10.view(1, 1, -1, 2),
                                                               mode='bilinear', align_corners=True)[0, :, 0, :]
            # as we use the gt correspondence here, the outlier uniform pmf is ignored
            # C_{Q,N} in NRE
            C01 = torch.diag(pmf01_kpts_valid)
            C10 = torch.diag(pmf10_kpts_valid)

            # ======================= out
            similarity_map_01_out, similarity_map_10_out = similarity_map_01[ids0_out], similarity_map_10[ids1_out]
            out0 = torch.ones(len(similarity_map_01_out), device=device)
            out1 = torch.ones(len(similarity_map_10_out), device=device)
            # cat outside scores to similarity_map, thus similarity_map is (N, H*W +1)
            similarity_map_01_out = torch.cat([similarity_map_01_out.reshape(-1, h * w), out0[:, None]], dim=1)
            similarity_map_10_out = torch.cat([similarity_map_10_out.reshape(-1, h * w), out1[:, None]], dim=1)
            similarity_map_01_out = (similarity_map_01_out - 1) * self.inv_temp
            similarity_map_10_out = (similarity_map_10_out - 1) * self.inv_temp
            pmf01_out = torch.softmax(similarity_map_01_out, dim=1)
            pmf10_out = torch.softmax(similarity_map_10_out, dim=1)
            if len(pmf01_out) > 0:
                C01_out = pmf01_out[:, -1]
            else:
                C01_out = C01.new_tensor([])
            if len(pmf10_out) > 0:
                C10_out = pmf10_out[:, -1]
            else:
                C10_out = C10.new_tensor([])

            # ======================= out
            C = torch.cat([C01, C10, C01_out, C10_out])  # C
            C_widetilde = -C.log()  # \widetilde{C}

            loss_mean = loss_mean + C_widetilde.sum()
            CNT = CNT + len(C_widetilde)

        loss_mean = loss_mean / CNT if CNT != 0 else wh.new_tensor(0)
        assert not torch.isnan(loss_mean)
        return loss_mean
代码里的 similarity_map_01 是 A 的每个关键点与 B 的稠密描述子图算出的相似度图,kpts01 是关键点 warp 到 B 后的坐标;C01 = torch.diag(pmf01_kpts_valid) 取的就是「正确对应点的匹配概率」,-log 后即 NRE。外点分支把相似度 1 拼到相似度图末尾再 softmax,对应论文里的 类别。ids0_out/ids1_out 是没有有效对应的关键点。这里的 1 / 0.02 = 50 的逆温度很大,意味着匹配概率图非常尖。
2.3.4 可靠性损失:把分数压向可区分区域
NRE 的匹配概率图还能再做一件事:判断一个关键点是不是落在低纹理、重复纹理区域。如果在那种区域,描述子与周围所有像素都相似,匹配概率被摊平,正确对应点的概率 就不高。论文用同一张相似度图定义可靠性:
其中 bisampling 是在 处做双线性采样,。 越大,说明这个点的描述子越「独特」。可靠性损失用分数加权:
再对 A、B 两个方向取平均(Eq. 22)。权重 同时考虑了两张图上的分数:只有两边都强、且描述子可区分的点,才会被重点优化;低纹理区域的点即使分数高,也会因为 小而持续被压低。这和 D2-Net 用 reliability 加权、ASLFeat 用可靠性图的思想一脉相承,只是这里直接复用了 NRE 的概率图,不需要额外的可靠性分支。
消融上,从「RP+PK+DE」到「RP+PK+RL+DE」,Rep +3.82、MS +4.81、MMA +5.55、MHA +1.30,是四项损失里对 Rep/MS 帮助最大的一项;它没有牺牲定位精度,因为 只影响分数权重,不直接移动关键点。
代码:可靠性损失(官方训练代码 nets/losses.py,原文照录)
class ScoreMapRepLoss(object):
    """ Scoremap repetability"""

    def __init__(self, temperature: float = 0.1):
        super().__init__()
        self.temperature = temperature
        self.radius = 2

    def __call__(self, pred0, pred1, correspondences):
        b, c, h, w = pred0['scores_map'].shape
        wh = pred0['keypoints'][0].new_tensor([[w - 1, h - 1]])
        loss_mean = 0
        CNT = 0

        for idx in range(b):
            if correspondences[idx]['correspondence0'] is None:
                continue

            scores_map0 = pred0['scores_map'][idx]
            scores_map1 = pred1['scores_map'][idx]
            kpts01 = correspondences[idx]['kpts01']
            kpts10 = correspondences[idx]['kpts10']  # valid warped keypoints

            # =====================
            scores_kpts10 = torch.nn.functional.grid_sample(scores_map0.unsqueeze(0), kpts10.view(1, 1, -1, 2),
                                                            mode='bilinear', align_corners=True)[0, 0, 0, :]
            scores_kpts01 = torch.nn.functional.grid_sample(scores_map1.unsqueeze(0), kpts01.view(1, 1, -1, 2),
                                                            mode='bilinear', align_corners=True)[0, 0, 0, :]

            s0 = scores_kpts01 * correspondences[idx]['scores0']  # repeatability
            s1 = scores_kpts10 * correspondences[idx]['scores1']  # repeatability

            # ===================== repetability
            similarity_map_01 = correspondences[idx]['similarity_map_01_valid']
            similarity_map_10 = correspondences[idx]['similarity_map_10_valid']

            pmf01 = ((similarity_map_01.detach() - 1) / self.temperature).exp()
            pmf10 = ((similarity_map_10.detach() - 1) / self.temperature).exp()

            kpts01 = kpts01.detach()
            kpts10 = kpts10.detach()

            pmf01_kpts = torch.nn.functional.grid_sample(pmf01.unsqueeze(0), kpts01.view(1, 1, -1, 2),
                                                         mode='bilinear', align_corners=True)[0, :, 0, :]
            pmf10_kpts = torch.nn.functional.grid_sample(pmf10.unsqueeze(0), kpts10.view(1, 1, -1, 2),
                                                         mode='bilinear', align_corners=True)[0, :, 0, :]
            repetability01 = torch.diag(pmf01_kpts)
            repetability10 = torch.diag(pmf10_kpts)

            # ===================== reliability
            # ids0, ids1 = correspondences[idx]['ids0'], correspondences[idx]['ids1']
            # descriptor_map0 = pred0['descriptor_map'][idx].detach()
            # descriptor_map1 = pred1['descriptor_map'][idx].detach()
            # descriptors0 = pred0['descriptors'][idx][ids0].detach()
            # descriptors1 = pred1['descriptors'][idx][ids1].detach()
            # kpts0 = pred0['keypoints'][idx][ids0].detach()
            # kpts1 = pred1['keypoints'][idx][ids1].detach()
            # kpts0_wh = (kpts0 / 2 + 0.5) * wh
            # kpts1_wh = (kpts1 / 2 + 0.5) * wh
            # ls0 = local_similarity(descriptor_map0, descriptors0, kpts0_wh, self.radius)
            # ls1 = local_similarity(descriptor_map1, descriptors1, kpts1_wh, self.radius)
            # reliability0 = 1 - ((ls0 - 1) / self.temperature).exp()
            # reliability1 = 1 - ((ls1 - 1) / self.temperature).exp()

            fs0 = repetability01  # * reliability0
            fs1 = repetability10  # * reliability1

            if s0.sum() != 0:
                loss01 = (1 - fs0) * s0 * len(s0) / s0.sum()
                loss_mean = loss_mean + loss01.sum()
                CNT = CNT + len(loss01)
            if s1.sum() != 0:
                loss10 = (1 - fs1) * s1 * len(s1) / s1.sum()
                loss_mean = loss_mean + loss10.sum()
                CNT = CNT + len(loss10)

        loss_mean = loss_mean / CNT if CNT != 0 else pred0['scores_map'].new_tensor(0)
        assert not torch.isnan(loss_mean)
        return loss_mean
这段代码有两个需要说明的地方。第一,它实现的是论文 Eq. (19)–(22) 的可靠性:pmf01 = exp((C-1)/T) 就是 ,torch.diag(pmf01_kpts) 就是 ,s0 就是 ,len(s0)/s0.sum() 对应分母的归一化。第二,代码把这一类命名为 ScoreMapRepLoss(repeatability),并且注释掉了另一套 local_similarity 的可靠性实现;论文里的 ,而发布脚本传的是 temp_sp=0.1,两者不一致。复现时以脚本为准,但读论文时不要被命名带偏。
2.3.5 总损失与训练细节
四项损失加权求和:
论文报告 、、、,温度 、、;重投影的 、范数 。训练数据是 MegaDepth[10] 上用 DISK 生成的图像对,去掉与 IMW2020 验证/测试重叠的场景后剩 135 个场景、约 63k 张图;每张裁到 480×480,做颜色抖动和随机裁剪/缩放。优化器是 Adam,学习率从 0 在 500 步内 warmup 到 ,batch size 1、梯度累积 16;在 Titan RTX 上训练约两天。
| 损失 | 作用对象 | 权重 | 温度/阈值 | 一句话 |
|---|---|---|---|---|
| DKD 的亚像素位置 | 1 | , | 把 warp 后的关键点拉向对应点 | |
| 局部 score 分布 | 1 | 让峰更尖、soft-argmax 更稳 | ||
| score map 的可靠性 | 1 | 压低低纹理/重复区域的分数 | ||
| 稠密 descriptor map | 5 | 用 NRE 约束整张描述子图 |
需要提醒的是,官方发布的 training/train.py 和论文报告并不完全一致:脚本里 w_pk=0.5、w_rp=1、w_sp=1、w_ds=5,temp_sp=0.1、temp_ds=0.1,学习率是 3e-4(不是论文的 ),并且用了两张 GPU。想严格复现论文数字,不能只照脚本默认值;论文与发布代码的差异应当被视为复现风险,而不是四舍五入。
三、实验结果
3.1 评测协议
- HPatches[11]:57 个光照场景 + 59 个视角场景;按 D2-Net 的做法去掉 8 个不可靠场景。指标有 Rep(重复率)、MS(匹配分)、MMA@k(前 k 像素阈值下的平均匹配精度)、MHA@k(估计单应的四个角点中正确的比例)。论文在 640×480 上最多取 5000 个关键点,分数阈值 0.2,FPS 在 Titan X Pascal 上测。
- IMW2020[12]:stereo 与 multiview 两个任务,最多 2048 个关键点,用 mutual nearest neighbor 匹配,报告 mAA@5°、mAA@10° 和 PPC(mAA(10°)/GFLOPs,按百分数计)。
- Aachen Day-Night[13]:用白天图像建 3D 模型,定位 98 张夜间 query,报告三个误差容忍度下的定位成功率;分别测「最多 2048 个关键点」和「不限关键点」两种设置。
需要说明的是,论文没有 ScanNet 实验;MegaDepth 只用于训练和生成图像对,不参与评测。
3.2 HPatches:定位精度与效率
| 方法 | 参数/M | GFLOPs | FPS | MMA@3 | MHA@3 |
|---|---|---|---|---|---|
| D2-Net(MS) | 7.635 | 889.40 | 6.60 | 37.29% | 38.33% |
| LF-Net(MS) | 2.642 | 24.37 | 29.88 | 55.60% | 57.78% |
| SuperPoint | 1.301 | 26.11 | 45.87 | 65.37% | 70.19% |
| R2D2(MS) | 0.484 | 464.55 | 8.70 | 75.77% | 71.48% |
| ASLFeat(MS) | 0.823 | 44.24 | 8.96 | 72.44% | 73.52% |
| DISK | 1.092 | 98.97 | 15.73 | 77.59% | 70.56% |
| ALIKE-N | 0.318 | 7.91 | 95.19 | 70.78% | 75.74% |
| ALIKE-L | 0.653 | 19.68 | 68.18 | 70.50% | 76.85% |
| ALIKE-N(MS) | 0.318 | 25.97 | 41.48 | 74.05% | 75.93% |
| ALIKE-L(MS) | 0.653 | 64.63 | 29.15 | 74.51% | 76.48% |
这张表最扎眼的是两条曲线:参数量和计算量降了一个数量级,MHA@3 反而最高。ALIKE-N 的 0.318M 参数是 SuperPoint 的 1/4、R2D2 的 2/3,GFLOPs 只有 ASLFeat(MS) 的 1/5.6,MHA@3 却从 73.52 升到 75.74(+2.22);ALIKE-L 以 19.68 GFLOPs 拿到 76.85(+3.33),计算量仍只有 ASLFeat(MS) 的 1/2.2。FPS 上,ALIKE-N 95.19、SuperPoint 45.87、ALIKE-L 68.18,R2D2(MS) 只有 8.70——R2D2 的参数只有 0.484M,但 464.55 GFLOPs 说明参数少不等于算得快,非参数操作(多尺度、稠密相关)才是大头。
另一个值得细看的是 ALIKE 与 DISK 的差别:DISK 的 MMA@3 是 77.59,比 ALIKE-N 的 70.78 高不少;但 MHA@3 反过来,ALIKE-N 75.74 比 DISK 70.56 高 5.18。到了最严格的 MMA@1,ALIKE-N 43.52、ALIKE-L 43.90,DISK 43.71,三者几乎打平;MHA@1 则是 ALIKE-N 42.04、ALIKE-L 45.00,DISK 只有 34.07。也就是说,DISK 能匹配上更多点,但 ALIKE 的点位更准,估计出的单应更可靠。论文因此把 MHA 当作更重要的下游指标,这也是它主张「accurate」的主要依据。
多尺度(MS)并不是无脑更好:ALIKE-N(MS) 的 MMA@3 从 70.78 升到 74.05,MHA@3 从 75.74 微升到 75.93(+0.19);ALIKE-L(MS) 的 MHA@3 反而从 76.85 降到 76.48,MHA@2 也从 65.93 降到 65.37。代价却很实在:ALIKE-N 的 GFLOPs 从 7.91 涨到 25.97(3.3×),FPS 从 95.19 掉到 41.48。所以 MS 更适合「离线、预算充足、想把 MHA@1/@2 再抬一点」的场景;实时应用直接用单尺度 N。
3.3 IMW2020:位姿估计
Stereo 任务(最多 2048 个关键点):
| 方法 | GFLOPs | mAA@5 | mAA@10 | PPC |
|---|---|---|---|---|
| D2-Net(MS) | 889.40 | 6.06% | 12.27% | 0.0138 |
| LF-Net(MS) | 24.37 | — | 23.44% | 0.9620 |
| SuperPoint | 26.11 | 19.71% | 28.97% | 1.1093 |
| R2D2(MS) | 464.55 | 27.20% | 39.02% | 0.0840 |
| ASLFeat(MS) | 77.58 | 22.62% | 33.65% | 0.4337 |
| DISK | 98.97 | 38.72% | 51.22% | 0.5175 |
| ALIKE-N | 7.91 | 35.12% | 47.18% | 5.9652 |
| ALIKE-L | 19.68 | 37.24% | 49.58% | 2.5187 |
Multiview 任务(最多 2048 个关键点):
| 方法 | GFLOPs | mAA@5 | mAA@10 | PPC |
|---|---|---|---|---|
| D2-Net(MS) | 889.40 | 17.77% | 28.30% | 0.0318 |
| LF-Net(MS) | 24.37 | — | 51.41% | 2.1099 |
| SuperPoint | 26.11 | 44.35% | 54.66% | 2.0935 |
| R2D2(MS) | 464.55 | 53.13% | 64.03% | 0.1378 |
| ASLFeat(MS) | 77.58 | 45.28% | 55.61% | 0.7168 |
| DISK | 98.97 | 63.25% | 72.96% | 0.7372 |
| ALIKE-N | 7.91 | 59.18% | 69.21% | 8.7507 |
| ALIKE-L | 19.68 | 60.30% | 70.22% | 3.5673 |
PPC 按论文定义(mAA(10°)/GFLOPs,按百分数计)。这里 DISK 仍然是精度上限:stereo mAA@10 51.22% vs ALIKE-N 47.18%,multiview 72.96% vs 69.21%。ALIKE 没有在精度上超过 DISK,但差距不大,而 PPC 高了约一个数量级(ALIKE-N 5.9652 vs DISK 0.5175,约 11.5×;ALIKE-L 2.5187,约 4.9×),这正是论文说的「约 10 倍和 5 倍」。原始匹配指标也能看出差距从哪来:stereo 上 ALIKE-N 检测 1803 个特征、Rep 43.30%、MS 81.10%,DISK 是 2048 个、44.80%、85.20%;multiview 上 ALIKE-N 产生 276.48 个匹配、1644.20 个 3D 路标、track length 4.97,DISK 是 526.35、2424.80、5.50。ALIKE 的点更少、更省算力,精度略低;在资源受限的场景,这个交换是划算的。
论文的结论是:不考虑 PPC 时,ALIKE 在 IMW2020 上除 DISK 外优于所有对比方法;考虑 PPC 时,ALIKE-N/L 分别比 DISK 高效约 10×/5×。这个表述是准确的,但读者要注意它并没有说「全面超过 DISK」。
3.4 Aachen Day-Night:视觉定位
| 方法 | 2048: 0.25m,2° | 2048: 0.5m,5° | 2048: 5m,10° | 无限: 0.25m,2° | 无限: 0.5m,5° | 无限: 5m,10° |
|---|---|---|---|---|---|---|
| D2-Net(SS) | 74.5% | 85.7% | 96.9% | 78.6% | 88.8% | 100.0% |
| D2-Net(MS) | 61.2% | 81.6% | 94.9% | 79.6% | 86.7% | 100.0% |
| SEKD(SS) | 42.9% | 51.0% | 57.1% | 54.1% | 65.3% | 74.5% |
| SEKD(MS) | 50.0% | 63.3% | 70.4% | 59.2% | 72.4% | 82.7% |
| SuperPoint | 72.4% | 79.6% | 88.8% | 73.5% | 81.6% | 93.9% |
| R2D2(MS) | 63.3% | 78.6% | 87.8% | 71.4% | 85.7% | 99.0% |
| ASLFeat(SS) | 54.1% | 67.3% | 76.5% | 77.6% | 88.8% | 100.0% |
| ASLFeat(MS) | 49.0% | 59.2% | 69.4% | 77.6% | 90.8% | 100.0% |
| DISK | 70.4% | 82.7% | 94.9% | 84.7% | 90.8% | 100.0% |
| ALIKE-N | 68.4% | 84.7% | 96.9% | 77.6% | 87.8% | 100.0% |
| ALIKE-L | 74.5% | 87.8% | 98.0% | 79.6% | 86.7% | 100.0% |
Aachen 的关键变量是关键点预算。限定 2048 个点时,ALIKE-L 的 74.5/87.8/98.0 是表里最好的(0.25m 与 D2-Net(SS) 并列 74.5),ALIKE-N 的 68.4/84.7/96.9 也优于 SuperPoint 的 72.4/79.6/88.8(严格阈值略低,但 0.5m/5° 和 5m/10° 更高);不限点时,DISK 的 84.7/90.8/100.0 最强,ALIKE-L 79.6/86.7/100.0、ALIKE-N 77.6/87.8/100.0 次之。论文想说明的是:在实用的关键点预算下,ALIKE 的性价比更好;但它并没有在「无限关键点 + 最严格阈值」这个格子里赢过 DISK。夜间/剧烈光照仍然是它的弱项,这一点在下一节的失败案例里更明显。
3.5 定性结果与消融
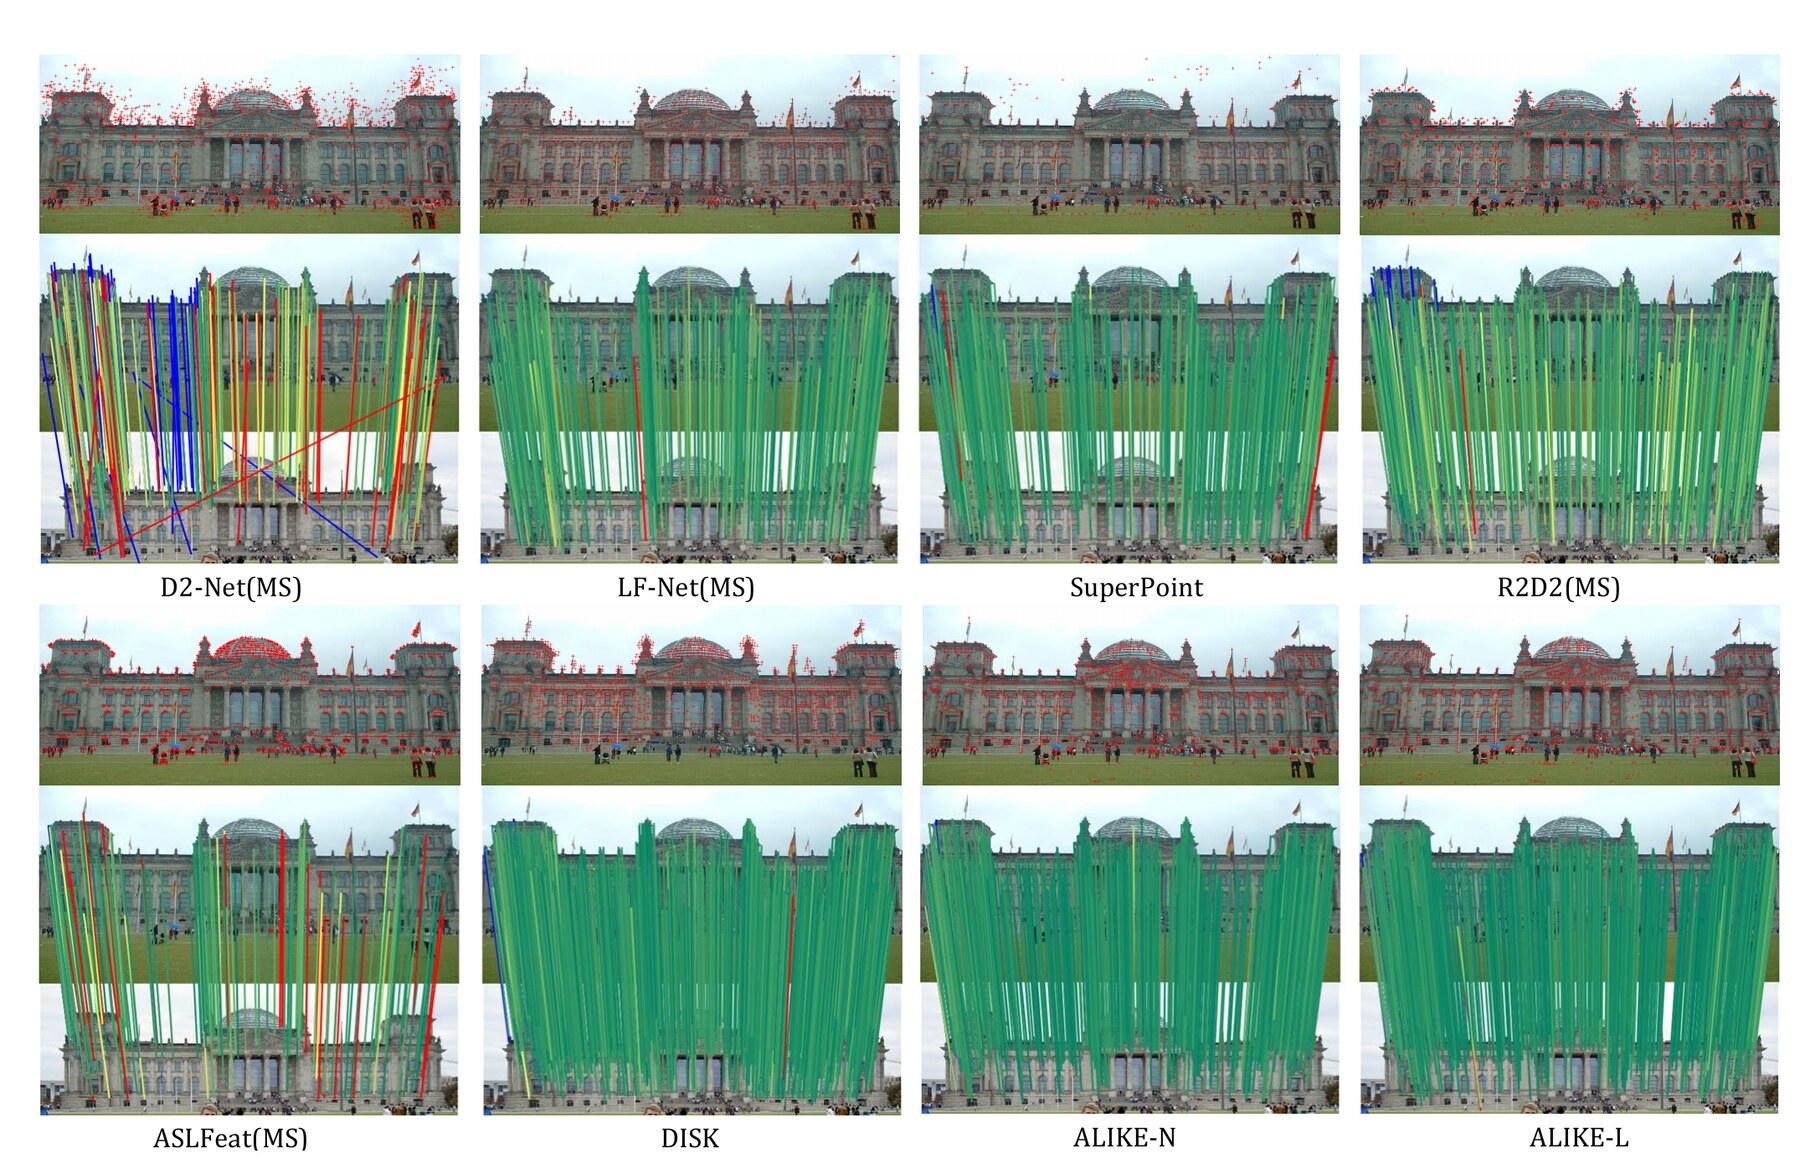
定性图里的差别和图注说的一致:D2-Net(MS) 从低分辨率特征图上取点,角点不准,出现大量红线;LF-Net(MS) 的点偏少;R2D2(MS) 的点容易在纹理边界上挤成一团;DISK 的点几乎全在建筑上,天空里也有少量不可靠点;SuperPoint 的点最稀疏;ALIKE-N/L 的点更多落在角点和边缘,错误匹配更少。这些是定性观察,不能替代表格,但能解释为什么 ALIKE 的 MHA 更高:点位的结构性更好。
消融部分,先看网络规模(Table II):
| 模型 | Rep | MS | MMA@3 | MHA@3 | GFLOPs |
|---|---|---|---|---|---|
| Tiny | 56.19% | 32.54% | 63.92% | 70.56% | 2.109 |
| Small | 58.25% | 34.96% | 67.61% | 73.52% | 3.893 |
| Normal | 54.93% | 38.58% | 70.78% | 75.74% | 7.909 |
| Large | 53.70% | 39.80% | 70.50% | 76.85% | 19.685 |
Tiny 的 Rep 最高(56.19),但 MS/MMA/MHA 都最低;Normal 相比 Tiny,MS +6.04、MMA +6.86、MHA +5.18,而 GFLOPs 只从 2.109 涨到 7.909(3.75×)。Large 相比 Normal,MHA 只 +1.11,GFLOPs 却涨到 2.49×,收益递减,所以论文选 Normal 作为默认模型。这个选择很务实:在实时场景里,Normal 是「精度—算力」曲线的拐点。
再看损失(Table III):
| 配置 | Rep | MS | MMA@3 | MHA@3 |
|---|---|---|---|---|
| RL+DE | 59.26% | 34.55% | 71.83% | 67.22% |
| PK+RL+DE | 48.75% | 30.88% | 62.95% | 72.59% |
| RP+RL+DE | 65.77% | 38.12% | 74.44% | 70.74% |
| RP+PK+DE | 51.11% | 33.77% | 65.23% | 74.44% |
| RP+PK+RL+DE | 54.93% | 38.58% | 70.78% | 75.74% |
| RP+PK+RL+Tri | 57.91% | 14.13% | 39.38% | 60.74% |
逐行读:RP 是定位精度的主引擎(RL+DE → RP+RL+DE,MHA +3.52,Rep +6.51);PK 用 Rep/MS/MMA 换 MHA(RL+DE → PK+RL+DE,MHA +5.37,Rep −10.51);RL 把 Rep/MS 拉回来(RP+PK+DE → 全量,Rep +3.82、MS +4.81);Triplet 则直接崩溃(MS 14.13、MMA 39.38)。论文没有单独做「DKD 开/关」的消融,DKD 的收益是和这四项损失绑在一起报的,这是读表时需要注意的归因限制。
四、局限性
4.1 论文承认的局限
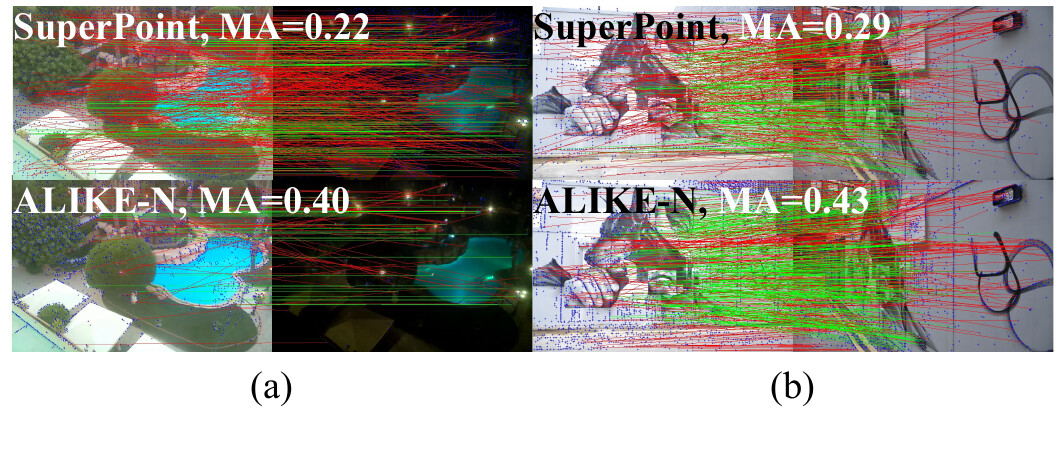
论文在 Section IV-F 只列了三类失败:极端光照变化、大视角变化、浅层网络只能提取低层描述子。前两类对应论文 Fig. 11 的两个例子,后一类是结构性的:ALIKE 为了实时性只用了浅层编码器,描述子的语义能力有限,在剧烈光照或大视角下容易匹配失败。作者给出的数字是:在这两个挑出来的困难样例上,ALIKE-N 的 MA 是 0.40/0.43,SuperPoint 是 0.22/0.29——ALIKE 更好,但离「解决」还很远。注意这只是两个样例,不是全集统计。
4.2 我自己再补几条
- 尺度/旋转没有单独评测。论文的训练增强是随机裁剪和缩放,HPatches 的 viewpoint 序列里也包含一定的尺度/旋转,但没有像 R2D2 那样单独报告尺度/旋转曲线。单尺度推理 + MS 的增益在 MHA@3 上并不显著(ALIKE-N 75.74 → 75.93),所以「尺度不变性」更多是数据增强带来的,而不是结构上的保证。
- 训练数据单一。训练对来自 MegaDepth 的 DISK 图像对(135 场景/63k 图),没有跨数据集训练或域适应实验;对航空、医疗、显微等分布外数据的泛化没有验证。Aachen 的夜间结果也说明光照域偏移仍然吃力。
- 没有 DKD-only 消融。DKD 是论文的核心卖点,但 Table II/III 只分别消融网络和损失,没有「NMS 位置 vs DKD 位置、其余完全相同」的一行。论文 Fig. 7 的定性对比和重投影损失的增益能间接说明问题,但严格的归因还缺一块。
- 没有和匹配器结合。论文的匹配是 mutual nearest neighbor + ratio/距离阈值,没有接 SuperGlue、LightGlue 之类的可学习匹配器;在稀疏点 + 强匹配器的现代管线里,ALIKE 的收益是否能保留,论文没有回答。
- 训练脚本与论文有出入。前面提到的
w_pk、temp_ds、学习率差异,以及 zip 里没有 requirements/README、依赖旧版 PyTorch Lightning,都会增加复现成本;ScoreMapRepLoss的命名和注释掉的local_similarity分支也容易让人误解。 - 速度口径。95 FPS 是
ALike.forward里的网络 + DKD 时间,不含图像解码、预处理和匹配;在嵌入式/CPU 上的表现没有报告。对 SLAM 这类端到端系统,实际帧率会更低。 - 稠密描述子的成本。ALIKE-N/L 在 上输出 128 维描述子(Tiny/Small 分别是 64/96 维),分辨率和通道数一涨,显存/带宽就成为瓶颈;ALIKED 改用稀疏可变形描述子正是针对这一点。ALIKE 适合「实时、稀疏、资源受限」,不适合「稠密匹配、高分辨率重建」。
还有一个小但实际的点:论文 Table IV 里 ASLFeat(MS) 的 GFLOPs 是 44.24,而 Table V 和 README 的效率表用的是 77.58;正文的「5.6×/2.2×」是按 44.24 算的,换用 77.58 倍数会更大。引用这些倍数时要注明口径。
五、结论与展望
ALIKE 的故事线其实很简洁:检测器的位置一直是个「不可导的洞」,作者用局部 soft-argmax 把它补上了。NMS 仍然负责粗定位,DKD 只负责格点内的连续偏移;一旦位置可导,重投影损失就能直接监督它,离散度峰值损失就能直接塑造局部 score 分布,可靠性损失和 NRE 则分别从「点靠不靠谱」和「描述子对不对」两个角度补全监督。网络刻意做小,换来 95 FPS 和 0.318M 参数,代价是描述子语义弱、极端条件下会失败。
对实践者,我的建议是:
- 默认用 ALIKE-N 单尺度:95 FPS、7.91 GFLOPs,HPatches MHA@3 75.74%,是实时 SLAM/AR 的甜点;需要更严格的 @1/@2 精度时再开 MS。
- 保留亚像素:
--no_sub_pixel只适合做消融;下游几何估计对亚像素很敏感,demo 默认也是开的。 - 关键点预算按场景调:Aachen 的结果说明 2048 个点以内 ALIKE 很有竞争力,但不限点时 DISK 更强;不要默认「越多越好」。
- 匹配器可以后接:ALIKE-N/L 输出 128 维 L2 描述子和分数,理论上可以直接喂给 SuperGlue/LightGlue 风格的匹配器,但论文没有验证;如果要上生产,先在自己的数据上做消融。
- 后继看 ALIKED:如果稠密描述子的显存/带宽是瓶颈,ALIKED[2] 的稀疏可变形描述子头是更合适的起点;如果只要检测器,DKD 的思想可以独立复用。
未来方向,论文自己提了「用高层语义/强化学习增强检测的可靠性与准确性」以及「集成到 SLAM/HDR 应用」;从今天的视角看,可微位置 + 轻量骨干这条线已经被 ALIKED、XFeat[14] 等继承,但「尺度/旋转不变性」和「极端光照下的描述子」仍然是开放问题。
六、上手
官方仓库提供推理代码和四个尺度的权重(models/alike-{t,s,n,l}.pth);训练代码不在 git 树里,而是打包在 assets/ALIKE_code.zip。下面的命令都来自 README 或脚本本身,训练部分会标注哪些是脚本写死的相对路径。
安装与权重
git clone https://github.com/Shiaoming/ALIKE.git
cd ALIKE
pip install -r requirements.txt
最小示例(KITTI / TUM 序列)
python demo.py assets/kitti
python demo.py assets/tum
demo 的默认模型是 alike-t,而论文的默认配置是 Normal(alike-n);要对照论文数字,显式指定:
指定模型与检测参数
python demo.py assets/kitti --model alike-n --device cuda --scores_th 0.2 --n_limit 5000参数和论文概念的对应关系:
--model:模型配置,可选alike-t/alike-s/alike-n/alike-l,默认alike-t;alike-n是论文默认的 Normal,alike-l是 Large。--scores_th:NMS 后的分数阈值 ,默认 0.2;低于它的点被丢弃(阈值模式)。--top_k:top-k 模式,默认 -1(关闭);大于 0 时按分数取前 k 个,忽略阈值。--n_limit:阈值模式下的最大关键点数,默认 5000。--no_sub_pixel:关闭 DKD 亚像素;demo 默认是开启的,打开这个开关后只用 NMS 格点,适合做消融。--device:运行设备,默认cuda;CPU 上也能跑,但 FPS 不能对照论文。
HPatches 评测
# 1. 下载 hpatches-sequences-release,放到 hseq/hpatches-sequences-release
# 2. 按 D2-Net 的做法去掉不可靠序列
python hseq/eval.py
训练(官方 zip,旧版 PyTorch Lightning)
# 训练代码在仓库的 assets/ALIKE_code.zip,不在 git 树里
unzip assets/ALIKE_code.zip -d alike_train
cd alike_train/training
# 脚本里写死了 ../data/{megadepth,hpatches,imw2020val},按此摆放数据
python train.py训练脚本有几个坑要提前知道:train.py 里 sys.path.append('../')、数据路径 ../data/...,说明它预期从 training/ 目录运行、数据放在 zip 根目录的 data/ 下;pytorch_lightning.core.lightning 是旧版 API,新版本 PyTorch Lightning 不兼容;gpus=[0,1] 默认两张卡,单卡要改;train.py 的损失权重/温度/学习率与论文报告不一致(见 2.3.5)。zip 里没有 requirements,训练环境的依赖需要自己对齐。
参考
- Zhao, Wu, Miao, Chen, Chen, Li. ALIKE: Accurate and Lightweight Keypoint Detection and Descriptor Extraction. IEEE Transactions on Multimedia, 2022. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Transactions on Instrumentation and Measurement, 2023. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Dusmanu, Rocco, Pajdla, Pollefeys, Sivic, Torii, Sattler. D2-Net: A Trainable CNN for Joint Detection and Description of Local Features. CVPR 2019. arXiv · 代码
- Revaud, Weinzaepfel, De Souza, Pion, Csurka, Cabon, Humenberger. R2D2: Repeatable and Reliable Detector and Descriptor. NeurIPS 2019. arXiv · 代码
- Tyszkiewicz, Fua, Trulls. DISK: Learning local features with policy gradient. NeurIPS 2020. arXiv · 代码
- Luo, Zhou, Bai, Chen, Zhang, Yao, Li, Fang, Quan. ASLFeat: Learning Local Features of Accurate Shape and Localization. CVPR 2020. arXiv · 代码
- Barroso-Laguna, Riba, Ponsa, Mikolajczyk. Key.Net: Keypoint Detection by Handcrafted and Learned CNN Filters. ICCV 2019. arXiv · 代码
- Germain, Lepetit, Bourmaud. Neural Reprojection Error: Merging Feature Learning and Camera Pose Estimation. CVPR 2021. arXiv
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A benchmark and evaluation of handcrafted and learned local descriptors. CVPR 2017. arXiv
- Jin, Mishkin, Mishchuk, Matas, Fua, Yi, Trulls. Image Matching across Wide Baselines: From Paper to Practice. IJCV 2021. arXiv · 代码
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Potje, Cadar, Araujo, Martins, Nascimento. XFeat: Accelerated Features for Lightweight Image Matching. CVPR 2024. arXiv · 代码