· 73 min read
论文解读:R2D2,检测器要可重复,描述子要可靠
TL;DR 局部特征常被当成一个整体来训,R2D2[1] 却把它拆成两个问题:检测器只追求可重复(repeatability),描述子再判断自己可不可靠(reliability)。网络在 L2-Net 主干上同时输出稠密 128 维描述子 、重复性热图 和可靠性热图 ,关键点是 的局部极大,最终分数 。训练不需要关键点标注:用随机单应或光流造 warp, 用局部余弦相似度加 peakiness 自监督; 和描述子用可导 AP 排序损失联合优化,AP 低于 的 patch 被 压到 0,描述子梯度也随之为 0。HPatches 上 WAF 模型 MMA@3 0.686、M-score 0.453(SIFT 0.288、LF-Net 0.335);Aachen Day-Night 夜间定位 45.9/65.3/86.7;模型只有 0.5M 参数、128 维、5K 点。官方 PyTorch 代码采用 CC BY-NC-SA 3.0,仅限非商用。
- 论文:R2D2: Repeatable and Reliable Detector and Descriptor,Jerome Revaud, Philippe Weinzaepfel, César De Souza, Noe Pion, Gabriela Csurka, Yohann Cabon, Martin Humenberger,NAVER LABS Europe,NeurIPS 2019。
- 代码:github.com/naver/r2d2(PyTorch,CC BY-NC-SA 3.0,仅限非商用)。
- 前作 / 后继:D2-Net、SuperPoint、DISK、DaD、RaCo。
本文数字以 NeurIPS 2019 相机版为准。arXiv v2(1906.06195v2)把作者增加到 7 位,部分表格和训练参数与 NeurIPS 版不同;两版都没有 ETH3D 或三维重建基准,Aachen 实验是用 COLMAP 做夜间定位。
一、动机:两个问题,被一个分数混在一起
局部特征提取通常被写成两步:先找关键点,再算描述子。这个写法容易让人忽略一点:两步的失败方式并不一样。检测器可能在两张图里都没找到同一个物理点,这时描述子再好也没用;也可能在两张图里都找到了,但描述子把一个点和一堆相似的点混在一起,匹配照样错。前者是可重复性问题,后者是可靠性问题。
经典的 SIFT[2] 用 DoG 找极值、用梯度直方图描述,两步都靠手工设计,可靠性没有被显式建模。学习型方法里,SuperPoint[3] 走的是 detect-then-describe:先用合成的角点预训练检测器,再用单应自适应把检测器迁移到真实图像,描述子另算。D2-Net[4] 把顺序倒过来,走 describe-then-detect:一张 VGG 特征图既当描述子,又从描述子通道里取局部极大当检测响应,不需要关键点标注。两条路线都比手工方法强,但都把「这个地方容易被检测到」和「这个地方的描述子能被正确匹配」压进了同一个分数:SuperPoint 的检测器只学过角点长什么样,D2-Net 的检测响应直接由描述子通道的极大值定义。
这两件事在真实图像里经常不一致。棋盘格的角点在局部非常尖,检测器很容易反复找到它,但每个角长得都一样,描述子无法唯一匹配;天空、河面、地面没有稳定的局部结构,检测器可能因为噪声偶尔响应,描述子也不可靠;树叶、海浪纹理很强,检测器有响应,但形状一直在变,描述子不稳定。反过来,一个纹理丰富的点可能描述子很独特,却因为遮挡或视角变化没有被重复检测到。用一个分数同时表达这两件事,网络只能学到一个折中。
R2D2 的做法是把它们拆成两张热图:
- 是重复性(repeatability),回答「这个位置在另一张图里还会不会被检测到」;
- 是可靠性(reliability),回答「这个位置的描述子能不能被正确匹配,也就是它的 AP 高不高」;
- 关键点仍然取 的局部极大,但最终排序分数是 。
这个拆分带来一个很实用的后果: 不只是推理时的过滤器,它还进入训练损失,决定「这个 patch 值不值得花容量去学描述子」。在 AP 低的区域, 被压到 0,描述子的梯度也被乘成 0,网络可以把容量集中在真正能匹配的地方。
论文开头的玩具例子把这一点讲得很清楚。左边是白色三角形,角点既好检测又好匹配;右边是棋盘格,每个角在检测器眼里都很尖,但描述子无法区分它们。检测器置信度在两种图案上都很高,描述子置信度只在三角形上高。
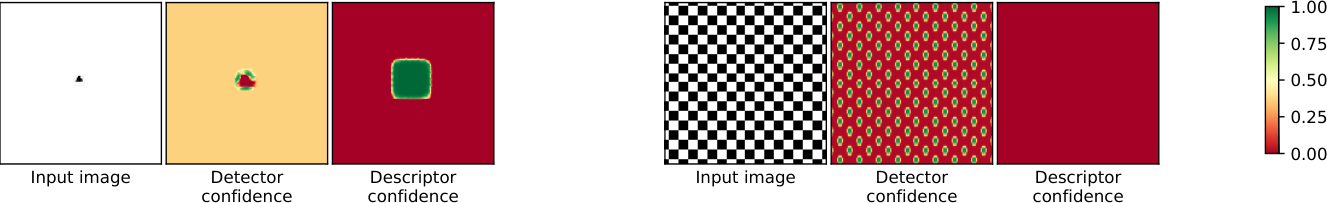
所以,如果只用 选点,棋盘格会排在最前面;这正是后文 reliability 阈值和 排序要解决的问题。
二、核心方法
2.1 一张主干,三个输出
R2D2 的主干是一个全卷积的 L2-Net[5] 变体:3×3 卷积、BatchNorm、ReLU,通道数从 32 逐级加到 128;为了保持全分辨率,下采样被替换成空洞卷积;最后一层 8×8 卷积换成 3 个 2×2 卷积,参数量减少约 5 倍。整个网络只有 0.5M 参数。
主干输出逐像素的 128 维描述子 ,每个位置做 L2 归一化。然后接两个 1×1 卷积分支:
- 可靠性分支: 逐元素平方后过 1×1 卷积得到 2 通道,再 softmax,取第二通道作为 ;
- 重复性分支:同样的平方和 1×1 卷积,但只有 1 通道,softmax 后得到 。
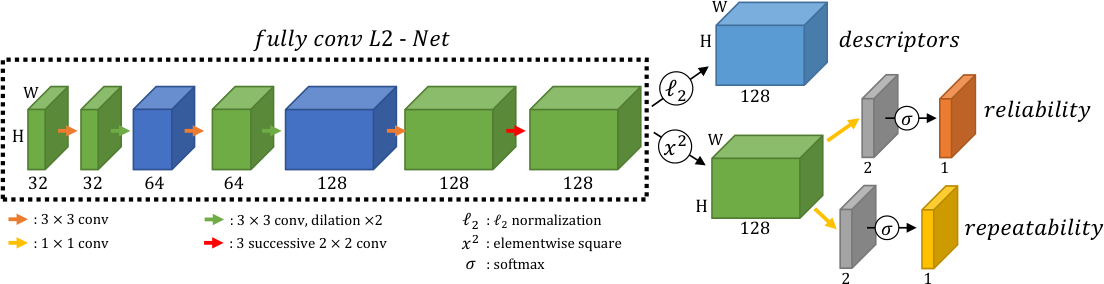
这里有两个容易忽略的设计点。
第一,平方操作是二阶池化。它让每个位置的特征先做一次逐元素平方,再线性组合;论文说这样比直接用 效果更好,代码里也确实是 x**2。代价很小,只是多了一次逐元素乘法。
第二,检测和描述仍然共享主干,但检测头是独立的。D2-Net 的检测分数直接由描述子通道的极大值定义,检测器没有自己的参数;R2D2 的 是一个单独的 1×1 卷积,有自己的损失,因此可以学到一个「按重复性定义的好点」,而不必同时是「描述子空间里最尖的点」。这是它和 D2-Net 最关键的结构差别。和 SuperPoint 的差别则在监督:SuperPoint 的检测器先学合成角点,再用单应自适应;R2D2 的 从一开始就用单应一致性训练,不需要任何关键点标签。
代码:网络结构与两个头(官方 nets/patchnet.py,原文节选)
class BaseNet (nn.Module):
    """ Takes a list of images as input, and returns for each image:
        - a pixelwise descriptor
        - a pixelwise confidence
    """
    def softmax(self, ux):
        if ux.shape[1] == 1:
            x = F.softplus(ux)
            return x / (1 + x)  # for sure in [0,1], much less plateaus than softmax
        elif ux.shape[1] == 2:
            return F.softmax(ux, dim=1)[:,1:2]

    def normalize(self, x, ureliability, urepeatability):
        return dict(descriptors = F.normalize(x, p=2, dim=1),
                    repeatability = self.softmax( urepeatability ),
                    reliability = self.softmax( ureliability ))
class Quad_L2Net (PatchNet):
""" Same than L2_Net, but replace the final 8x8 conv by 3 successive 2x2 convs.
"""
def __init__(self, dim=128, mchan=4, relu22=False, **kw ):
PatchNet.__init__(self, **kw)
self._add_conv( 8*mchan)
self._add_conv( 8*mchan)
self._add_conv( 16*mchan, stride=2)
self._add_conv( 16*mchan)
self._add_conv( 32*mchan, stride=2)
self._add_conv( 32*mchan)
# replace last 8x8 convolution with 3 2x2 convolutions
self._add_conv( 32*mchan, k=2, stride=2, relu=relu22)
self._add_conv( 32*mchan, k=2, stride=2, relu=relu22)
self._add_conv(dim, k=2, stride=2, bn=False, relu=False)
self.out_dim = dimclass Quad_L2Net_ConfCFS (Quad_L2Net):
""" Same than Quad_L2Net, with 2 confidence maps for repeatability and reliability.
"""
def __init__(self, **kw ):
Quad_L2Net.__init__(self, **kw)
# reliability classifier
self.clf = nn.Conv2d(self.out_dim, 2, kernel_size=1)
# repeatability classifier: for some reasons it's a softplus, not a softmax!
# Why? I guess it's a mistake that was left unnoticed in the code for a long time...
self.sal = nn.Conv2d(self.out_dim, 1, kernel_size=1)
def forward_one(self, x):
assert self.ops, "You need to add convolutions first"
for op in self.ops:
x = op(x)
# compute the confidence maps
ureliability = self.clf(x**2)
urepeatability = self.sal(x**2)
return self.normalize(x, ureliability, urepeatability)注意代码里的 BaseNet.softmax:单通道的 用的是 softplus 而不是 softmax,注释里作者自己说「这大概是历史上没被发现的一个错误」。论文里写的是 softmax;实际权重和行为都以代码为准。这个细节不影响整体思路,但说明复现时不能只看论文文字。
另外,Quad_L2Net 里几个 stride=2 看起来像下采样,但 PatchNet._add_conv 在 dilated=True 时把 stride 当作 dilation 的倍增因子(self.dilation *= stride),实际卷积的 stride 仍是 1。所以 、 和描述子都保持输入分辨率,论文说的「用空洞卷积替代下采样」在代码里就是这么实现的。
2.2 重复性 :让热图的峰跟着图像走
重复性没法用人工关键点监督。人工标注本质上是在模仿一个已有检测器,网络最多学到「像 SIFT 那样选点」,不会发现更好的点。R2D2 把它当成自监督任务:不告诉网络哪个像素是关键点,只要求「同一物理点在两张图里的 热图经过 warp 后尽量一致」。
具体做法是:给两张图 和 ,以及它们之间的稠密对应 (合成单应可以精确得到,真实图像对用光流估计)。把 的重复性热图 按 采样回 的坐标系,得到 。理想情况下 和 应该完全相同;但遮挡、边界和 warp 伪影会让逐像素对齐不现实,所以只在局部 patch 上比较:
其中 是把 的 patch 拉平后的向量, 是余弦相似度。这个损失有一个退化解: 和 都是常数时,余弦相似度也是 1,损失为 0。所以还要加一个 peakiness 损失,让 patch 内的最大值明显高于均值:
最终重复性损失是两项相加,peakiness 对两张图都算:
这里的监督信号是稠密的热图对齐,不是「这个像素是不是关键点」的离散标签;也没有人工标注的关键点位置。单应变换是精确的,光流是估计的,但两者都能给出逐像素的对应,监督密度远高于人工标点。这就是它比人工标注更可扩展的原因:任何有对应关系的图像对都能拿来训练,不需要定义「什么是关键点」。
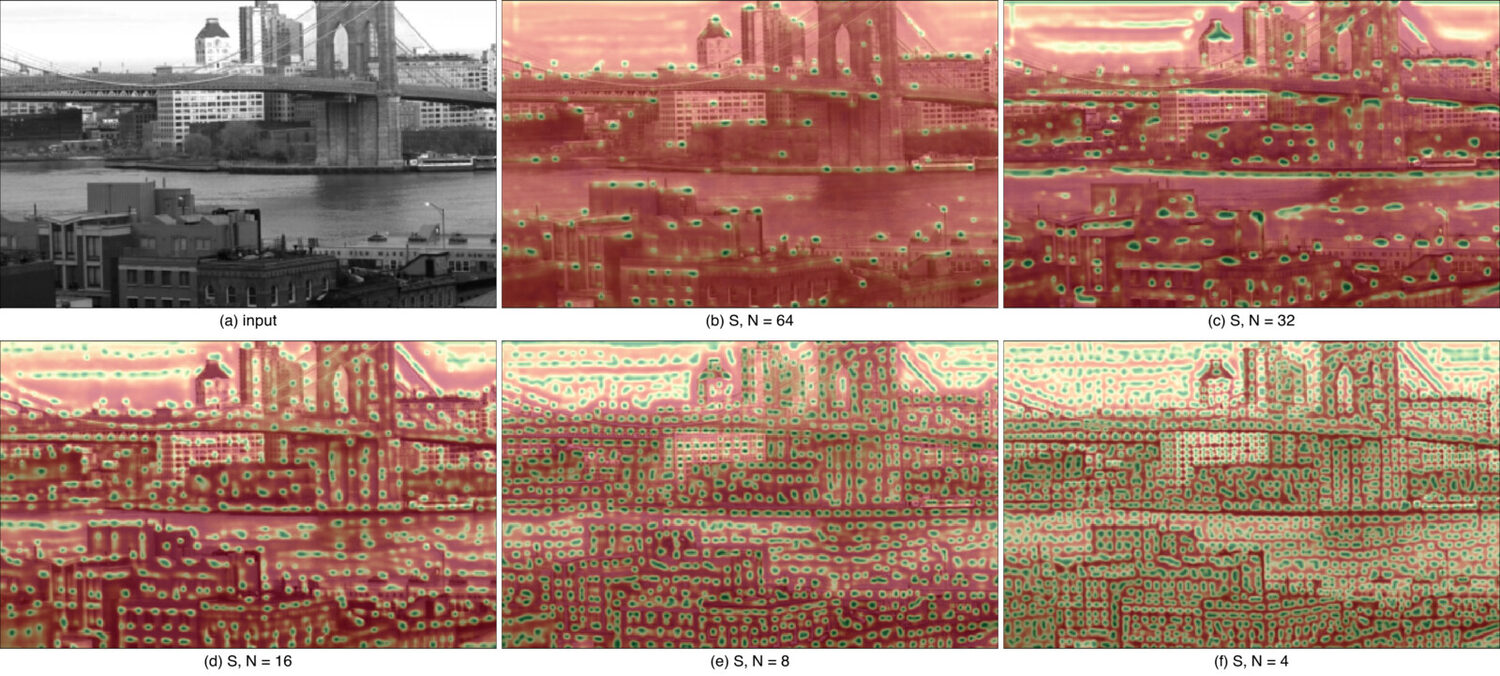
patch 大小 直接控制关键点的空间频率。 大,网络倾向于在少数强结构上产生峰,点少而稳; 小,局部极大变多,连天空都会被填成网格状的点。论文用 作为默认值, 用于需要更多点的定位任务。图 4 是同一个输入在不同 下的热图。
代码:重复性损失(官方 nets/repeatability_loss.py,原文照录)
class CosimLoss (nn.Module):
    """ Try to make the repeatability repeatable from one image to the other.
    """
    def __init__(self, N=16):
        nn.Module.__init__(self)
        self.name = f'cosim{N}'
        self.patches = nn.Unfold(N, padding=0, stride=N//2)

    def extract_patches(self, sal):
        patches = self.patches(sal).transpose(1,2) # flatten
        patches = F.normalize(patches, p=2, dim=2) # norm
        return patches

    def forward(self, repeatability, aflow, **kw):
        B,two,H,W = aflow.shape
        assert two == 2

        # normalize
        sali1, sali2 = repeatability
        grid = FullSampler._aflow_to_grid(aflow)
        sali2 = F.grid_sample(sali2, grid, mode='bilinear', padding_mode='border')

        patches1 = self.extract_patches(sali1)
        patches2 = self.extract_patches(sali2)
        cosim = (patches1 * patches2).sum(dim=2)
        return 1 - cosim.mean()
class PeakyLoss (nn.Module):
""" Try to make the repeatability locally peaky.
Mechanism: we maximize, for each pixel, the difference between the local mean
and the local max.
"""
def __init__(self, N=16):
nn.Module.__init__(self)
self.name = f'peaky{N}'
assert N % 2 == 0, 'N must be pair'
self.preproc = nn.AvgPool2d(3, stride=1, padding=1)
self.maxpool = nn.MaxPool2d(N+1, stride=1, padding=N//2)
self.avgpool = nn.AvgPool2d(N+1, stride=1, padding=N//2)
def forward_one(self, sali):
sali = self.preproc(sali) # remove super high frequency
return 1 - (self.maxpool(sali) - self.avgpool(sali)).mean()
def forward(self, repeatability, **kw):
sali1, sali2 = repeatability
return (self.forward_one(sali1) + self.forward_one(sali2)) /2代码和论文式 (1) 有一个小差别:论文说 包含所有 patch,代码用 stride=N//2 只取一半重叠的 patch,计算量更小。这个差别不影响机制。
下面这个合成例子把两张热图的分工摆在一起。左图是重复性 ,右图是可靠性 ;绿点是建筑上的可靠角点,红点是棋盘格角点。拖动 阈值,看保留的点怎样从多而杂变成少而准;再把 拉到 10 左右并切换排序方式,比较只按 和按 的差别。热图是按论文的定性行为构造的合成数据,不是网络输出:棋盘格在 上很尖,但 很低。
2.3 可靠性 :AP 排序与门控
描述子匹配可以看成一个检索问题:对图 1 的每个 query patch ,把它的描述子 和图 2 的所有 patch 描述子比一遍,按相似度排序。如果正样本排在前面,AP 就高;如果一堆负样本排在正样本前面,AP 就低。R2D2 直接用 AP 作为描述子质量的度量:
其中 是可导的 AP 近似,做法来自 He et al.[6]:把相似度用一组固定的阶梯函数量化到若干 bin,然后在这个软直方图上算 precision 和 recall。AP 是 listwise 的排序指标,不是逐对的二元分类,所以它直接优化「正样本有没有排到前面」,而不是「每个 pair 的标签对不对」。
但只优化 AP 还不够。天空、地面、1D 边缘、树叶、海浪这些区域,要么描述子本身没有区分度,要么外观不稳定;在这些地方花容量去优化描述子,不但浪费,还可能把网络拉向错误的方向。R2D2 的办法是让网络再预测一个可靠性 ,并用它门控 AP 损失:
这里必须指出一个印刷错误。论文式 (5) 印的是 ,但同页的图 3 和官方代码都是 。按加号,, 永远被推向 1,AP 低于 的 patch 也不会被抑制,这和正文「AP 低于 时让 变低」以及图 3 的曲面都矛盾。按代码的减号,:
- 当 :,增大 能降损失,网络会把 推向 1;
- 当 :,减小 能降损失,网络把 推向 0;
- 同时 ,所以 时描述子的梯度也被乘成 0,网络不再在这个 patch 上优化描述子。
这就是「软门控」: 不是硬阈值,而是一个可导的开关,让网络自己决定哪些区域值得学。 是论文选定的阈值,官方 ReliabilityLoss 里对应 base=0.5。
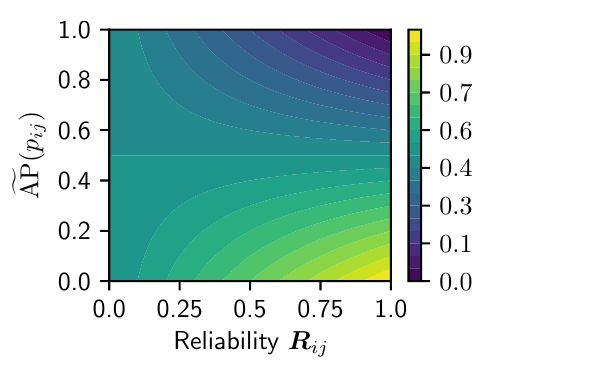
为什么不用二元交叉熵或 triplet?二元交叉熵只能告诉网络「这个 patch 的正样本对/负样本对分类对不对」,不能直接表达「正样本排在多少名」;triplet 只约束局部三元组,不能表达全局排序。AP 正好是评测用的指标,而且 给了「多高的 AP 才算可靠」一个可解释的阈值。更重要的是,AP 项和 项是联动的: 门控 AP,AP 又决定 的目标,描述子和可靠性在同一套排序信号里一起学。这是论文相对 Hartmann et al. 那类「先固定描述子、再预测可靠性」的做法最实质的区别。
代码:可导 AP 与可靠性门控(官方 nets/ap_loss.py、nets/reliability_loss.py,原文节选)
    def compute_AP(self, x, label):
        N, M = x.shape
        if self.euc:  # euclidean distance in same range than similarities
            x = 1 - torch.sqrt(2.001 - 2*x)

        # quantize all predictions
        q = self.quantizer(x.unsqueeze(1))
        q = torch.min(q[:,:self.nq], q[:,self.nq:]).clamp(min=0) # N x Q x M

        nbs = q.sum(dim=-1) # number of samples  N x Q = c
        rec = (q * label.view(N,1,M).float()).sum(dim=-1) # nb of correct samples = c+ N x Q
        prec = rec.cumsum(dim=-1) / (1e-16 + nbs.cumsum(dim=-1)) # precision
        rec /= rec.sum(dim=-1).unsqueeze(1) # norm in [0,1]

        ap = (prec * rec).sum(dim=-1) # per-image AP
        return ap
class ReliabilityLoss (PixelAPLoss):
""" same than PixelAPLoss, but also train a pixel-wise confidence
that this pixel is going to have a good AP.
"""
def __init__(self, sampler, base=0.5, **kw):
PixelAPLoss.__init__(self, sampler, **kw)
assert 0 <= base < 1
self.base = base
self.name = 'reliability'
def loss_from_ap(self, ap, rel):
return 1 - ap*rel - (1-rel)*self.baseReliabilityLoss 的默认 nq=20,即 AP 的量化 bin 数是 20;APLoss 自己的默认值是 25,训练时用的是 20。量化越粗,梯度越像阶梯,但计算越省;论文没有专门消融这个数。
下面这个部件把单个 query 的排名、AP 和式 (5) 的门控放在一起。拖正样本相似度 改变 AP,拖 和 看损失曲面与最优 。这里只有 1 个正样本和 11 个负样本,所以 ;真实训练中每个 query 有上千个负样本,AP 是连续的排序面积,但门控的斜率结构完全一样。默认 、、,此时 AP=1、最优 ;把 拖到 0.84 以下,AP 掉到 ,最优 翻到 0。
2.4 推理:多尺度、NMS、双阈值、top-K
训练时网络看到的是 192×192 的 crop;推理时要处理整张图,并且要兼顾尺度变化。R2D2 的做法很直接:从最长边 1024 开始,每次乘 (约 0.841)降采样,直到最长边小于 256;每个尺度都前向一次,把坐标按缩放比映射回原图。
在每个尺度上:
- 对 做 3×3 非极大值抑制,只保留局部极大;
- 要求 且 ;
- 把所有尺度的候选点按 排序,保留 top-K(默认 5000)。
这三个条件各管一件事。NMS 保证点不会挤在一起; 阈值保证「可重复」; 阈值保证「描述子可靠」;top-K 给出固定预算。少了 阈值,棋盘格和天空的点会混进来;少了 的局部极大, 高的平坦区域也可能被选上,但那些点并不稳定。最终分数用乘积而不是加权和,是因为两个条件缺一不可: 高 低(棋盘格)或 高 低(偶然有纹理但不重复)都不应该排前面。
论文报告在 Tesla P100 上处理 1M 像素图像,单尺度约 0.5 秒,所有尺度约 1 秒。这个速度在 2019 年是可用的,但今天看不算快;官方后来加了 Fast-R2D2,用池化和上采样换速度。README 里 faster2d2_WASF_N8_big.pt(1.0M、5K)的 HPatches MMA@3 是 0.650,而同样 1.0M 参数的 r2d2_WASF_N8_big.pt 报 10K 点、0.692;两者点数不同,这个差距不能全算在 Fast 结构上。
代码:NMS、双阈值与 top-K(官方 extract.py,原文节选)
class NonMaxSuppression (torch.nn.Module):
    def __init__(self, rel_thr=0.7, rep_thr=0.7):
        nn.Module.__init__(self)
        self.max_filter = torch.nn.MaxPool2d(kernel_size=3, stride=1, padding=1)
        self.rel_thr = rel_thr
        self.rep_thr = rep_thr

    def forward(self, reliability, repeatability, **kw):
        assert len(reliability) == len(repeatability) == 1
        reliability, repeatability = reliability[0], repeatability[0]

        # local maxima
        maxima = (repeatability == self.max_filter(repeatability))

        # remove low peaks
        maxima *= (repeatability >= self.rep_thr)
        maxima *= (reliability   >= self.rel_thr)

        return maxima.nonzero().t()[2:4]
scores = torch.cat(C) * torch.cat(Q) # scores = reliability * repeatability
XYS = torch.stack([X,Y,S], dim=-1)
D = torch.cat(D)
return XYS, D, scores idxs = scores.argsort()[-args.top_k or None:]
outpath = img_path + '.' + args.tag
print(f"Saving {len(idxs)} keypoints to {outpath}")
np.savez(open(outpath,'wb'),
imsize = (W,H),
keypoints = xys[idxs],
descriptors = desc[idxs],
scores = scores[idxs])2.5 训练数据与参数
训练数据有四路,论文里用 W、A、S、F 表示:
- W:随机网络图片,加随机单应和颜色抖动,构造合成图像对;
- A:Aachen 白天数据库图片,同样加随机单应;
- S:把 Aachen 白天图片用风格迁移变成夜间外观,构造日夜图像对;
- F:Aachen 白天真实图像对,用 SfM + EpicFlow + DeepMatching 生成稠密光流,再用一致性掩码过滤。
论文只说 W、A、F 大约各 4000 张;官方 README 给的实际规模是 W 3125 张、A 4479 张、S 8115 张(3636 对)、F 4479 张,S 是从 Aachen 白天图风格迁移出来的额外一路。训练脚本默认四路全用(--train-data W A S F)。训练时 192×192 crop、batch size 8 对、Adam、25 个 epoch、固定学习率 、weight decay 。官方 README 说一张较新的 GPU 上每 epoch 约 30 分钟,25 个 epoch 约 12 小时;数据总共约 15GB。HPatches 的图片没有参与训练。
代码:三个损失的默认组合(官方 train.py,原文节选)
default_sampler = """NghSampler2(ngh=7, subq=-8, subd=1, pos_d=3, neg_d=5, border=16,
                            subd_neg=-8,maxpool_pos=True)"""

default_loss = """MultiLoss(
        1, ReliabilityLoss(`sampler`, base=0.5, nq=20),
        1, CosimLoss(N=`N`),
        1, PeakyLoss(N=`N`))"""
代码里的 subq=-8 表示 query 点在图像上随机采样,而不是论文写的 8×8 规则网格;pos_d=3 对应正样本在 3 像素半径内取最相似的一个,neg_d=5 对应 5 像素外的负样本。论文和代码在采样细节上有出入,但正负样本的定义(半径 3 内取最相似、5 外取负样本)是一致的。默认 N=16,三个损失的权重都是 1。
三、实验结果
3.1 协议
HPatches[7] 有 116 个场景,其中 57 个是大幅光照变化,59 个是大幅视角变化。每个场景的第一张图作参考,后续图与它组成难度递增的图像对。指标有三个:
- Repeatability:两图之间找到的对应点数除以两图中较少的关键点数,再对所有图像对平均;
- M-score:匹配阶段能找回的 ground-truth 对应占共享视角区域内估计特征总数的比例;
- MMA / MMA@3:平均匹配准确率,即不同像素误差阈值下正确匹配的百分比;MMA@3 是误差阈值固定为 3 像素时的值。
Aachen Day-Night[8] 的任务是夜间定位:白天图像带已知位姿,用来建图;夜间查询图像没有位姿,用 COLMAP[9] 的 SfM + 注册流程估计位姿。指标是三个误差阈值下成功定位的百分比:0.5m/2°、1m/5°、5m/10°。
需要说明:这篇论文没有 ETH3D 实验,也没有三维重建精度指标。Aachen 实验里虽然用 COLMAP 建了 SfM 模型,但报告的是定位成功率,不是重建完整度或点云精度。
3.2 HPatches:两张图各值多少
先看拆分本身值多少。表 1 是论文的消融,5 次独立运行的均值和标准差:
| 配置 | 关键点分数 | MMA@3 | M-score |
|---|---|---|---|
| 只有可靠性(去掉 ) | 0.588 ± 0.010 | 0.361 ± 0.011 | |
| 只有重复性(去掉 ) | 0.639 ± 0.034 | 0.432 ± 0.033 | |
| 完整模型 | 0.688 ± 0.009 | 0.470 ± 0.011 |
三个信息量。第一,两个热图都去掉一个都会掉,说明它们不是冗余的。第二,去掉可靠性掉得更多(MMA 0.639→0.588,M-score 0.432→0.361),说明「描述子可靠」对最终匹配的贡献更大;这也符合直觉:可重复但不可靠的点(棋盘格)会制造大量错误匹配,比漏掉一些点更伤。第三,完整模型的 5 次平均是 0.688,论文后文选中的单个「平均模型」是 0.686,两者不是同一个数;引用时不要把 0.688 和 0.686 混着说。
主实验用 WAF 模型(W+A+F,,5K 点),HPatches MMA@3 0.686,M-score 0.453;LF-Net[10] 的 M-score 是 0.335,SIFT 是 0.288。这里的 0.453 是论文选中的单个模型在 3px 下的 M-score,而表 1 的 0.470 ± 0.011 是 5 次运行的均值;两者统计口径不同,论文没有解释这个差,引用时最好写明是哪一组。加了 S 的 WASF 模型 MMA@3 0.721,主要用于 Aachen 定位;、10K 点的 big 模型是 0.692。README 还报告,如果允许全分辨率推理(--min-size 0 --max-size 9999 --min-scale 0.3 --max-scale 1.0),MMA@3 还能再涨 3.2~3.7 个点:WAF 0.686→0.718,WASF 0.721→0.758。这说明推理时的 1024 像素上限确实丢了一些细节。
检测器重复性方面,论文在 HPatches 的 Oxford 子集上和 DoG、QuadNet[11] 比。表 2 的完整表格很大,这里取 的一列:
| 序列(变化) | DoG | QuadNet | R2D2 |
|---|---|---|---|
| graf(视角) | 0.18 | 0.21 | 0.42 |
| wall(视角) | 0.28 | 0.39 | 0.65 |
| leuven(光照) | 0.50 | 0.75 | 0.73 |
| bikes(模糊) | 0.39 | 0.49 | 0.71 |
| ubc(JPEG) | – | 0.66 | 0.54 |
R2D2 在视角(graf、wall)和模糊(bikes)上明显更好;光照的 leuven 上和 QuadNet 几乎打平但略低(0.73 对 0.75),JPEG 压缩的 ubc 上则明显输给 QuadNet(0.54 对 0.66)。leuven 上 QuadNet 全程领先或打平,ubc 上 QuadNet 全程不输,trees 只在 时 QuadNet 领先。论文正文说「显著超过」是整体趋势,不是每个序列都赢。随着 增大,R2D2 的优势变大,这和「它的点更可重复、但数量少」的解释一致。
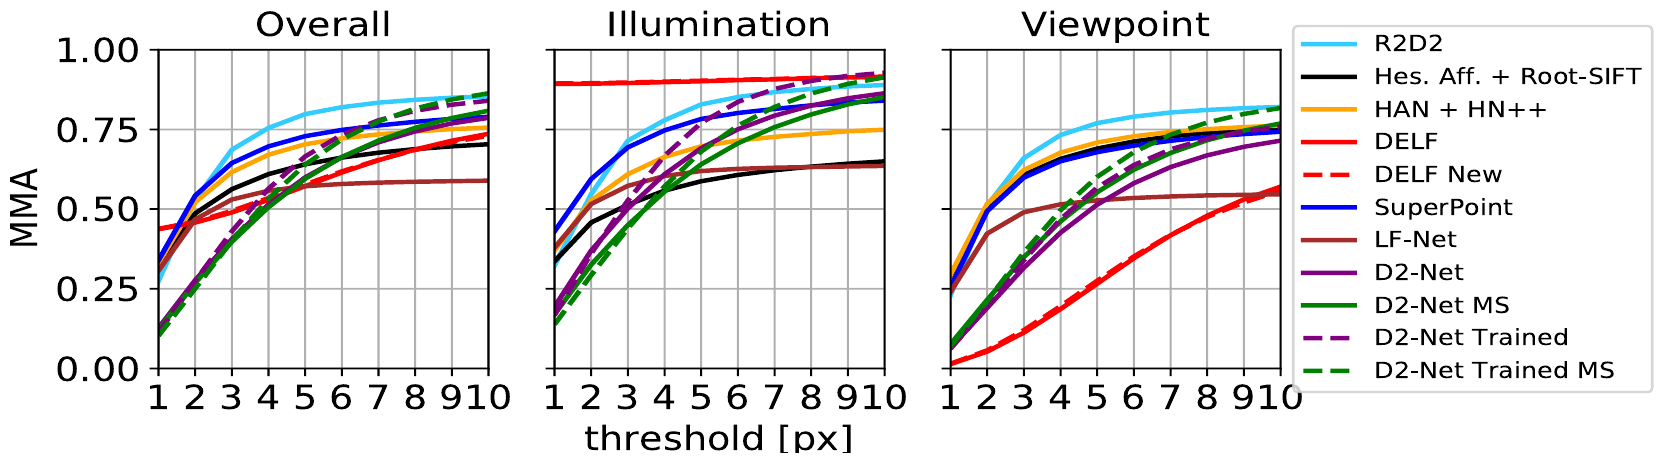
和 的取舍也值得单独说。 大时,低 下每个点的质量更高; 增大后,大 模型开始选到天空、河面这类较差的局部极大,MMA 反而下降。 小时则相反:点多,低 下质量不如大 ,但高 下更耐选。论文默认 、;定位任务要更多点,用 、。单尺度推理的 MMA@3 是 0.651,多尺度是 0.686,多尺度的收益是 +0.035。
3.3 Aachen:小模型在夜间定位上的位置
Aachen Day-Night 的结果(夜间查询)如下:
| 方法 | #点 | 维度 | 参数量 | 0.5m, 2° | 1m, 5° | 5m, 10° |
|---|---|---|---|---|---|---|
| RootSIFT | 11K | 128 | – | 33.7 | 52.0 | 65.3 |
| HAN+HN | 11K | 128 | 2M | 37.8 | 54.1 | 75.5 |
| SuperPoint | 7K | 256 | 1.3M | 42.8 | 57.1 | 75.5 |
| DELF (new) | 11K | 1024 | 9M | 39.8 | 61.2 | 85.7 |
| D2-Net | 19K | 512 | 15M | 44.9 | 66.3 | 88.8 |
| R2D2 | 5K | 128 | 0.5M | 45.9 | 65.3 | 86.7 |
| R2D2 | 10K | 128 | 1.0M | 45.9 | 66.3 | 88.8 |
这组数字要分两半看。好消息是效率:R2D2 用 0.5M 参数、128 维、5K 点,在最严格的 0.5m/2° 上拿到 45.9,比 D2-Net 的 44.9 高 1 个点,而 D2-Net 用了 15M 参数、512 维、19K 点。坏消息是论文正文说「超过所有对比方法」,但表里 的 R2D2 在 1m/5° 和 5m/10° 上其实略低于 D2-Net(65.3 vs 66.3,86.7 vs 88.8);只有 、10K 点的版本才在这两列追平。更准确的说法是:R2D2 在严格阈值上更强、模型小 30 倍;在宽松阈值上和 D2-Net 持平或略低。
训练数据消融(表 4)说明了各路的贡献:
| 训练数据 | HPatches MMA@3 | Aachen 0.5m,2° | 1m,5° | 5m,10° |
|---|---|---|---|---|
| W | 0.669 | 43.9 | 61.2 | 77.6 |
| W+A | 0.689 | 42.9 | 60.2 | 78.6 |
| W+A+S | 0.667 | 42.9 | 61.2 | 84.7 |
| W+A+F | 0.686 | 43.9 | 63.3 | 86.7 |
| W+A+S+F | 0.719 | 45.9 | 65.3 | 86.7 |
几个反直觉的点。只用网络图片 W 已经有 0.669 的 HPatches MMA 和 43.9 的 Aachen 严格阈值,说明合成单应训练本身的泛化不差。加 A 对 HPatches 有小幅提升(0.689),但对 Aachen 的严格阈值反而略降;加 S 把 HPatches 拉低到 0.667,却把 Aachen 的 5m/10° 从 78.6 拉到 84.7;加 F 把 Aachen 的 1m/5° 和 5m/10° 拉到 63.3/86.7。全数据最好,但 HPatches 的 0.719 是 WASF 模型的数,和主实验 WAF 的 0.686 不是同一个模型。论文说「其他数据源只带来小幅提升」,更准确地说,S 和 F 的收益主要在 Aachen 定位,HPatches 上并不单调。
Aachen 的数字还有一个现实问题:官方 README 明确说,论文发表后 Aachen 夜间图像的 ground truth 位姿和误差阈值被更新过,所以论文里的定位结果无法原样复现。引用这组数字时要把这个前提带上。
3.4 定性结果
图 6 是理解 和 分工的最好材料。第一行是输入和检出的关键点,第二行是重复性 ,第三行是可靠性 (绿色高、红色低)。
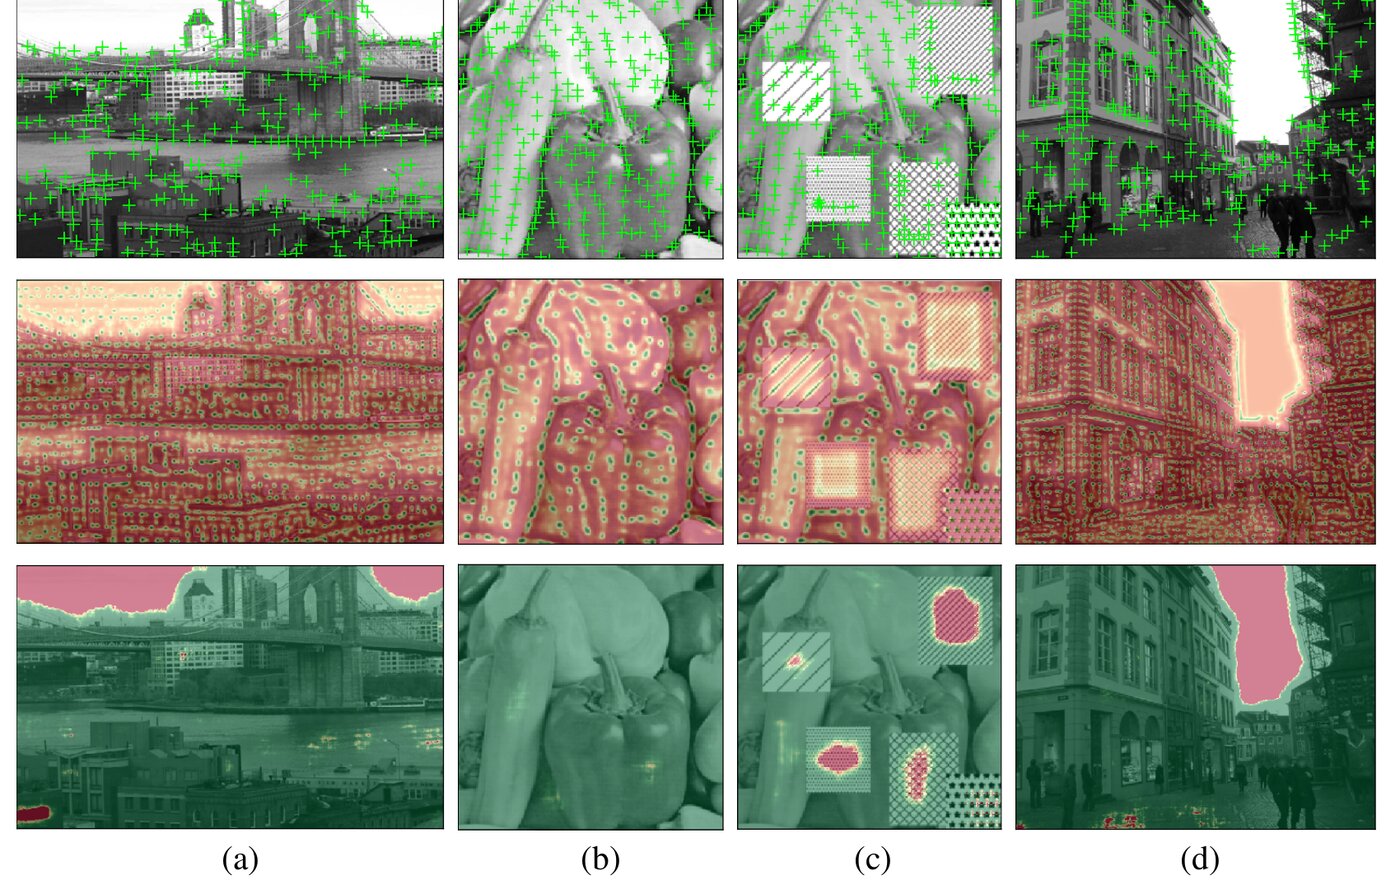
几个细节值得看。第一列(布鲁克林大桥)里,天空和河面在 上有不少响应,但在 里被标红;桥塔和建筑的角点在 里是绿色。第三列(辣椒)里,人工印上去的棋盘格在 上非常尖,但 把它们全部标红——这些图案训练时没见过,网络仍然靠「局部重复、无法唯一匹配」判断出低可靠性。第四列的街道图里,天空、路面、重复的窗户立面都被 压低,留下的点集中在门框、招牌、建筑转角。
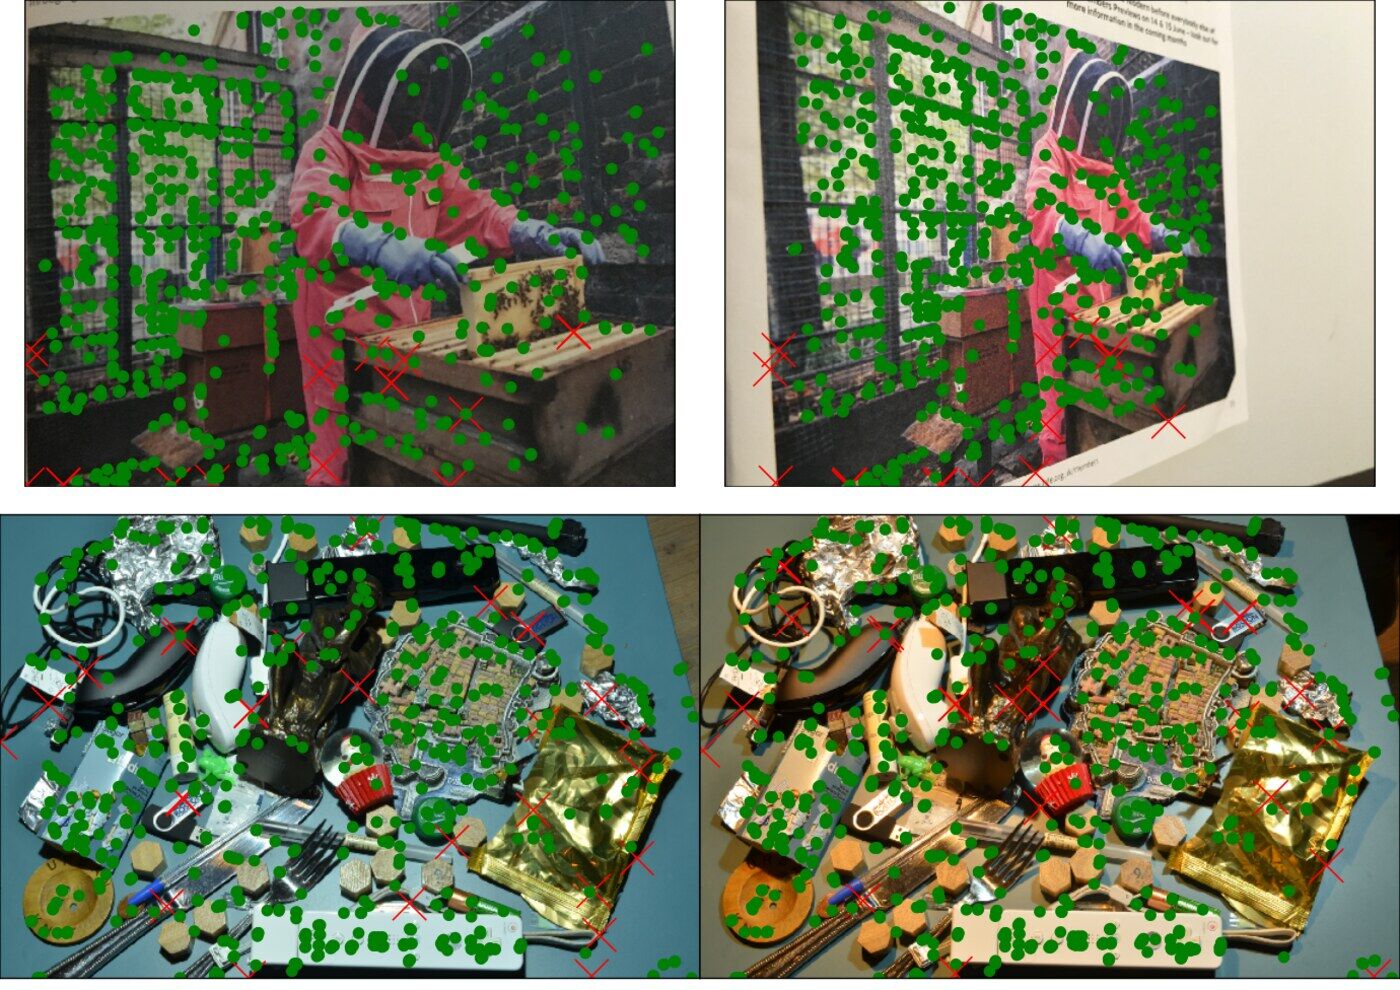
图 8 是两个匹配例子。上面是大幅视角变化(海报),下面是闪光/无闪光的光照变化(桌面物体)。绿点是正确匹配,红叉是错误匹配。两张图的匹配都覆盖了整幅画面,大多数是正确的;错误主要集中在重复纹理和遮挡边界。
四、局限性
论文没有单独的局限性一节,也没有结论一节;下面先列它明确写到的取舍,再补几条我自己的观察。
论文明确写到的:
- 和 是固定的,存在密度与质量的取舍。 大 在低 下点更稳,高 下会选到天空、河面的差局部极大;小 点密,但质量下降。论文默认 、,定位任务用 、,没有自适应机制。
- 训练数据以 Aachen 街景为主。 W 是网络图片,A/S/F 都来自 Aachen。论文自己说「在 Aachen 上训练显然对街景有帮助」;W-only 已经不错,但 S/F 的收益集中在 Aachen 定位。HPatches 没有参与训练。
- 多尺度是必要的。 单尺度 MMA@3 0.651,多尺度 0.686;推理要跑多个尺度,成本翻倍。
- 旋转不是训练目标。 论文在 Oxford 的 bark/boat 上报告了不错的结果,但明确说「我们没有针对这类困难情况训练网络」。多尺度只解决尺度,不解决平面内旋转。
- Aachen 结果不可复现。 这是官方 README 说的,不是论文里的:ground truth 位姿和误差阈值后来改过。
我自己再补几条:
- 热图分辨率不是瓶颈,推理分辨率才是。 网络用空洞卷积保持全分辨率, 和 都是输入尺寸;真正丢细节的是推理时把最长边限制在 1024。README 的全分辨率模式能涨 3~4 个 MMA 点,正好说明这一点。所以「热图分辨率低」不是这篇论文的局限,至少不是作者承认的那一条。
- 是 per-patch 的标量,不是 per-match 的置信度。 它预测的是「这个 patch 的平均 AP 高不高」,不以另一张图为条件,也不区分「这次匹配对不对」。局部重复但全局可区分的结构(例如有独特上下文的窗户)可能被 误压;遮挡是单向的, 也不知道。它适合当先验过滤器,不适合当匹配验证器。
- AP 代理比较粗。 每个 query 只有 1 个正样本,负样本来自规则/随机网格,AP 量化成 20 个 bin;梯度是分段常数,靠近平局时分辨率有限。换更大的 batch、更多负样本或更细的量化可能还有空间,论文没有消融这些。
- 推理超参是固定的。 、、top-K=5000 都是手调的;换域(遥感、医学、室内)时, 的分布会变,固定阈值不一定合适。论文没有给出校准方法。
- Aachen 的正文表述有过度概括。 表 3 里 的 R2D2 在 1m/5° 和 5m/10° 上低于 D2-Net,正文却说超过所有方法; 版本才追平。这不是方法的问题,但引用时要以表为准。
- 没有 ETH3D、没有重建指标。 论文的「3D」部分只有 Aachen 的 COLMAP 定位;没有三角化精度、点云完整度、重投影误差这些重建指标。如果任务关心的是 SfM/重建,这篇的实验覆盖是不够的。
- 许可证限制。 CC BY-NC-SA 3.0,仅限非商用;代码和权重都是这个许可证,训练代码也在仓库里。
五、结论与展望
R2D2 的核心贡献不是一个新的主干,而是一个监督分解:把「哪里容易重复检测」和「哪里的描述子值得匹配」拆成两个热图,用不同的自监督信号训练,再用 AP 门控把它们耦合起来。这个想法可以独立于具体网络:任何稠密描述子模型都可以加一个 头,用 AP 排序损失训练,再用 门控描述子损失。论文的消融说明,这个拆分本身就能带来 0.05 左右的 MMA 提升,不是靠更大的模型或更多的数据堆出来的。
如果今天要用它,我会给几条实用建议:
- 匹配任务默认用
r2d2_WAF_N16.pt(0.5M,5K,MMA@3 0.686);夜间定位或需要更多点时用r2d2_WASF_N16.pt(0.721)或r2d2_WASF_N8_big.pt(0.692,10K)。 - 不要只按 排序;保留 阈值和 排序,尤其在棋盘格、重复立面、天空多的场景。可以把它当成一个便宜的前置过滤器。
- 如果算力允许,用全分辨率推理(
--min-size 0 --max-size 9999 --min-scale 0.3 --max-scale 1.0),README 报告 +3~4 个 MMA 点;否则至少保留多尺度。 - 换域时先用单应做自监督微调;W-only 是强基线,真实图像对(光流)对定位类任务更有帮助。 按需要的点的密度选,不要默认 16 用到所有场景。
- 商用前先看许可证:代码和权重是 CC BY-NC-SA 3.0,非商用。
从前作和后继看,R2D2 处在 D2-Net 和 SuperPoint 之间:它保留了 D2-Net 的 describe-then-detect 思路(稠密描述子先算,检测从特征图上出),但把检测头独立出来,并且第一次把「描述子可靠性」当成一个显式的学习目标。DISK[12] 后来用策略梯度直接优化关键点选择,走的是另一条路:不预测可靠性热图,而是把采样本身当策略;DaD 和 RaCo 则把重点放在检测器的可重复性和排序上。R2D2 的 头更像一个「描述子质量预测器」,这个视角在今天的稀疏匹配器里仍然有用,例如把 作为 LightGlue[13] 这类学习型匹配器的先验,或者在 BA 里给残差加权。
如果要继续做,我觉得有三个方向:一是把 per-patch 的 扩展成 per-match 的置信度,让它在遮挡和重复结构下更细;二是把 和 做成自适应,按图像内容和下游任务分配点;三是把可靠性监督从单应/光流扩展到大规模 SfM 的 track,减少对 Aachen 这类特定域的依赖。
六、上手
官方仓库是 PyTorch 实现,权重在 models/ 下,extract.py 可以直接跑。下面命令都来自 README,安装部分是一个比较旧的栈(Python 3.6+、PyTorch 1.1+、CUDA 10.1);如果你的环境已经配好 PyTorch,可以跳过 conda 那两行。
安装(官方 README 的 conda 命令,旧栈)
git clone https://github.com/naver/r2d2
cd r2d2
conda install python tqdm pillow numpy matplotlib scipy
conda install pytorch torchvision cudatoolkit=10.1 -c pytorch
最小推理示例:对一张图抽 5000 个点,结果写到同路径的 .r2d2 文件。这个文件是 npz 格式,包含 keypoints(N×3,x、y、scale;scale 是 patch 直径)、descriptors(N×128,L2 归一化)和 scores(N,即 )。
抽取关键点与描述子(官方 README 的最小示例)
python extract.py --model models/r2d2_WASF_N16.pt --images imgs/brooklyn.png --top-k 5000参数和论文概念的对应关系:
| 参数 | 默认值 | 对应论文 |
|---|---|---|
--top-k | 5000 | 保留的关键点数 |
--scale-f | 多尺度降采样因子 | |
--min-size / --max-size | 256 / 1024 | 推理时的最长边范围 |
--reliability-thr | 0.7 | 阈值 |
--repeatability-thr | 0.7 | 阈值 |
--min-scale / --max-scale | 0 / 1 | 尺度范围;全分辨率时设为 0.3 / 1.0 |
权重选择:r2d2_WAF_N16.pt 是论文主实验模型(HPatches 0.686);r2d2_WASF_N16.pt 是定位实验模型(0.721);r2d2_WASF_N8_big.pt 是 1.0M 参数、10K 点的版本(0.692);faster2d2_WASF_N16.pt / faster2d2_WASF_N8_big.pt 是 Fast-R2D2,速度更快,README 的模型表只给了后者的 0.650(5K 点)。权重和代码都是 CC BY-NC-SA 3.0。
训练需要先下载约 15GB 数据:Aachen 的 database_and_query_images.zip 要手动下载,其余由脚本拉取。训练命令默认用 W/A/S/F 四路数据、25 个 epoch,单卡约 12 小时。
训练数据准备与训练命令(官方 README)
DATA_ROOT=/path/to/data
mkdir -p $DATA_ROOT
ln -fs $DATA_ROOT data
mkdir $DATA_ROOT/aachen
# 手动下载 Aachen 的 database_and_query_images.zip 到 $DATA_ROOT/aachen/
./download_training_data.sh
python train.py --save-path /path/to/model.ptHPatches 评测沿用 D2-Net 的脚本:克隆 d2-net、下载 HPatches、抽特征,再用它的 notebook 算 MMA。README 也提供了预计算的 results/*.npy,不想重跑可以直接用。
HPatches 评测流程(官方 README)
git clone https://github.com/mihaidusmanu/d2-net.git
cd d2-net/hpatches_sequences/
bash download.sh
bash download_cache.sh
cd ../..
ln -s d2-net/hpatches_sequences
python extract.py --model models/r2d2_WAF_N16.pt --images d2-net/image_list_hpatches_sequences.txt
最后提醒一句:论文的 Aachen 数字和今天官网的 ground truth 对不上,README 已经说明原因。复现 HPatches 的 0.686 没问题;复现 Aachen 的 45.9/65.3/86.7 不要期待完全一致。
参考
- Revaud, Weinzaepfel, De Souza, Pion, Csurka, Cabon, Humenberger. R2D2: Repeatable and Reliable Detector and Descriptor. NeurIPS 2019. arXiv · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV 2004. DOI
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Dusmanu, Rocco, Pajdla, Pollefeys, Sivic, Torii, Sattler. D2-Net: A Trainable CNN for Joint Detection and Description of Local Features. CVPR 2019. arXiv · 代码
- Tian, Fan, Wu. L2-Net: Deep Learning of Discriminative Patch Descriptor in Euclidean Space. CVPR 2017. CVF · 代码
- He, Lu, Sclaroff. Local Descriptors Optimized for Average Precision. CVPR 2018. arXiv
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Sattler, Maddern, Toft, Torii, et al. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Schönberger, Frahm. Structure-from-Motion Revisited. CVPR 2016. 项目页
- Ono, Trulls, Fua, Yi. LF-Net: Learning Local Features from Images. NeurIPS 2018. arXiv
- Savinov, Seki, Ladicky, Sattler, Pollefeys. Quad-Networks: Unsupervised Learning to Rank for Interest Point Detection. CVPR 2017. arXiv
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码