· 149 min read
论文解读:Foundation4D,多相机视频的统一感知与重建模型
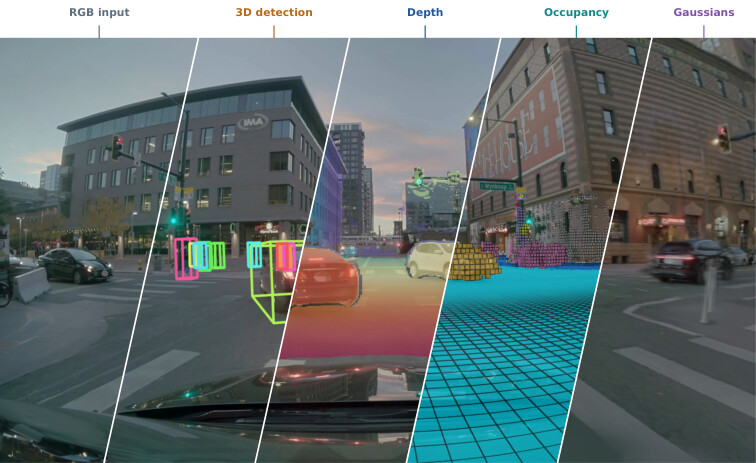
TL;DR NVIDIA 的 Foundation4D[1] 把「前向几何」和「驾驶感知」放进同一个模型:共享 DINOv2 骨干加因子化时空注意力,一次前向从六路相机视频里同时吐出相机位姿与度量深度、3D 检测、语义占据和可渲染的 3D 高斯。窗口之外还有一套推理系统——Sim(3) 拼接或位姿图优化把 48 帧窗口接成整段视频,离线跟踪把逐帧检测串成轨迹。数字很硬:Waymo / nuScenes 深度 AbsRel 0.09 / 0.15(次优 0.13 / 0.19),nuScenes 检测 60.9 mAP / 66.5 NDS(比 GeoUP-Joint 高 1.7 / 1.2),OpenOccupancy 27.4 IoU / 18.1 mIoU,PAI 上轨迹 ATE 比微调后的 VGGT 低 30%–53%。同时发布 1,253 段带稠密深度与 0.1 m 占据标注的 PAI-Foundation4D 基准;代码与权重未开源,只放出了数据集。
- 论文:Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles,NVIDIA(附录按几何、检测、占据、高斯、数据分组列出作者),2026-10-21。
- 代码:无(未开源)
- 数据:PAI–Foundation4D(1,253 段测试 clip),底层 PAI 数据集。
- 项目页:research.nvidia.com/labs/sil/projects/foundation4d
- 前作 / 预备知识:DUSt3R 解读、BEVFormer 解读、VidMap 解读。
一、动机:感知与重建,两条线各走各的
自动驾驶系统通常分成两条线。一条把多相机图像变成 BEV 或查询式表示,做 3D 检测、跟踪、占据[2];另一条把同一批图像重建成可渲染的 3D 场景,给仿真用。两条线共享传感器、共享车辆,却各自训练各自的网络,同一帧图像被反复编码。
过去两年,前向几何这条线被 DUSt3R、MASt3R、VGGT 一类模型推到「只输入图像就能出相机位姿和稠密几何」[3, 4, 5]。但 VGGT 的核心是全局注意力:所有相机、所有时间步的图像 token 进同一个注意力,token 数是 ,成本随它平方增长。几十张图可以,六路相机 × 几十帧的视频就不行。
驾驶场景里已经有人往统一走。GeoUP 把 VGGT 扩成多相机,联合输出深度、3D 框和占据,但要求输入相机内参、rig 标定和 ego 位姿[6];DVGT 输出度量点图与 ego 位姿,不做检测和占据[7];DriveVGGT 用标定引导注意力并分解 rig 头[8];TRIG 把轨迹与 rig 先验分开编码[9];DVGT-2 和 LingBot-Map 把同一副骨架做成流式,LiAuto-GeoX 则用小骨干蒸馏。这一族的结构差异会在第三节逐项展开。重建侧,Instant NuRec 能前向重建可渲染场景,但需要真值 ego 位姿[10]。
Foundation4D 想同时拿下三件事:不依赖外部 ego 位姿、静态标定一次给定即可、一个骨干服务四类输出、窗口预测能拼成整段视频。论文的贡献可以拆成五条:
- 统一的单窗口模型:共享 DINOv2 编码器 + 因子化时空聚合器,下接位姿/深度、检测、占据、高斯四个任务头。
- rig-ego 分解的位姿头和度量尺度训练,让不同窗口的预测处在同一个单位下,后面的位姿图优化才敢直接按 SE(3) 求解。
- 视频级推理系统:Sim(3) 拼接与位姿图优化(PGO)两条路线,加上离线多目标跟踪,把窗口预测接成整段轨迹、几何和物体轨迹。
- 一套标注流水线,以及 PAI–Foundation4D 基准:1,253 段 clip 上同时评几何、检测和占据,深度与占据标注都来自多帧聚合的 LiDAR。
- 把预测出的位姿、深度和物体轨迹作为 lidarless NuRec 的先验,端到端 turnaround 从 16.0 小时/段降到 3.7 小时/段。
二、核心方法
2.1 问题定义与总体架构
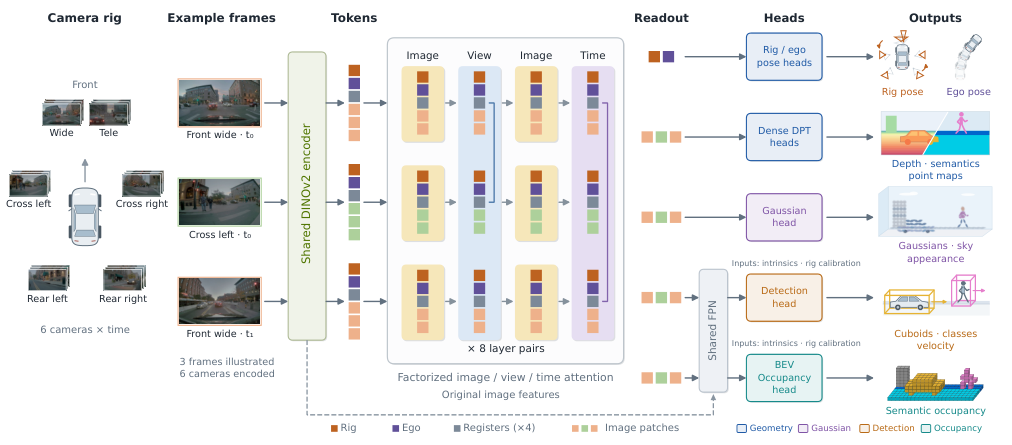
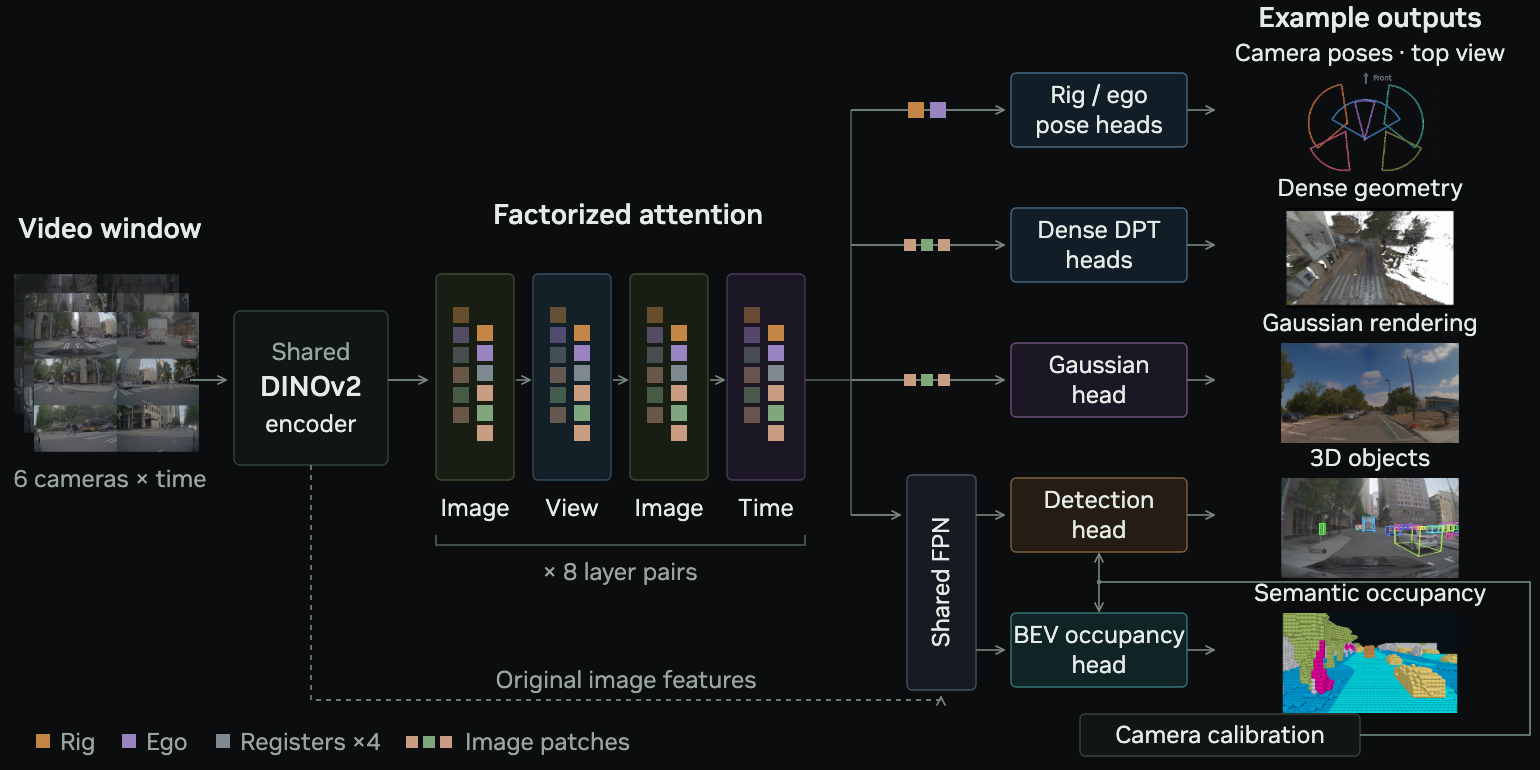
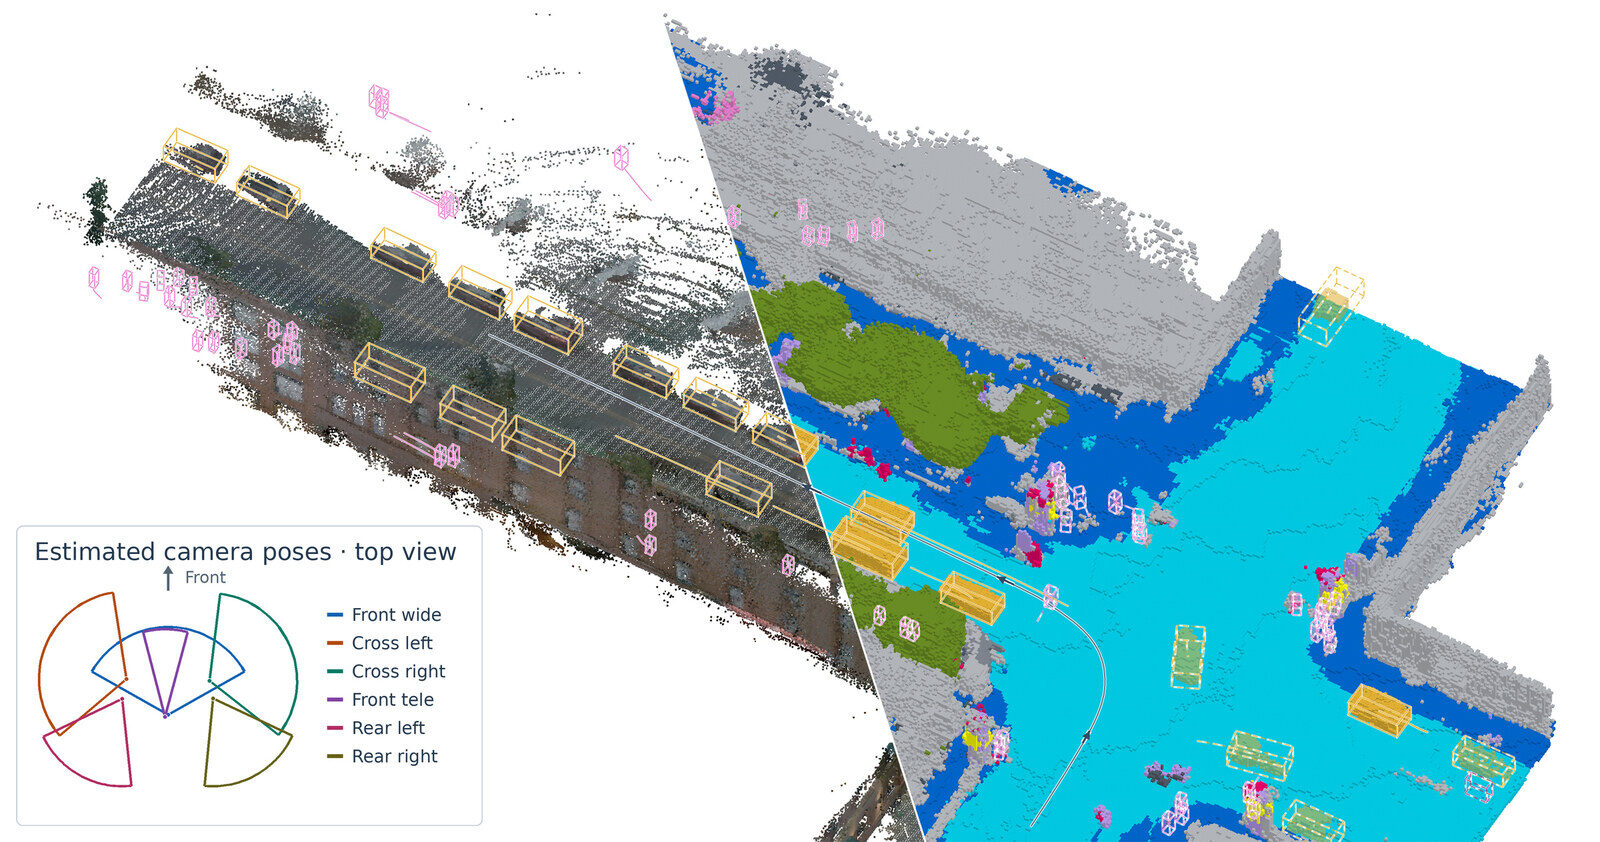
输入是 路相机、 个时间步的图像,以及每路相机的内参、固定的 rig 外参和每张图的采集时间 。模型在窗口参考系里工作:原点锚定在第一个参考时刻的 1 号相机。每个时间步输出一组预测——相机到世界的位姿 、相机 深度、窗口系下的点图、车辆 rig 系下的 3D 框、占据栅格和高斯属性;位置编码和采样都用已知的内参与静态外参,运动只由网络预测。
骨干是 VGGT 式的共享 DINOv2 ViT-L/14[11](特征宽 ),每张图独立编码。 的输入产生 的 patch 网格,聚合前双线性降到 ,即每张图 1369 个 token;编码器原始的 特征则留给检测和占据的特征金字塔。聚合之后接三类头:几何头(rig/ego 位姿、深度、辅助点图)、高斯头(DPT 解码),以及共享 FPN 的检测头和 BEV 占据头。
2.2 因子化时空注意力
VGGT 的全局注意力把 个 token 放进同一个注意力。以论文的配置算:6 路相机 × 8 个时间步 × 1369 token ≈ 65,712 个 token,每层每头的注意力矩阵就有约 项——这不是显存能装下的量级。
Foundation4D 的做法是把一个三维的注意力拆成三个两维操作。16 层里,每层先做图像内自注意力(每张图自己 1369 个 token),再做跨相机(固定 token、固定时间,6 路相机之间)或跨时间(固定 token、固定相机, 个时间步之间)自注意力。两种跨轴注意力逐层交替,经过 16 层,信息可以在「相机—时间—图像」三轴之间多跳传播,但任何一层都不需要同时attend全部 token。最后把最后一层图像内注意力和时间注意力的输出按通道拼接,得到宽度 的上下文 token。
每张图的 token 序列还带三种特殊 token:rig token 负责相对相机标定,ego token 负责 rig 运动,另有四个 register token 吸收辅助上下文;它们和其它 token 一起参与注意力。下面是这个设计的成本账:
把 T 从 8 拉到 32,省下的倍数线性涨;把 C 从 2 加到 8 也一样。原因很直观:联合成本 ∝ ,因子化成本里最大的项是 ,两者之比约为 。但因子化并不免费——VGGT 式全局注意力被拆开后,视频级和深度精度都有损失:表 5 里加上因子化注意力,第 (a) 行到 (b) 行 ATE 从 128.48 涨到 149.88 cm,换来 H100 上 8.5% 的端到端运行时间下降。论文没有回避这一点,把它写成「为规模付出的精度代价」。
工程上也配合了注意力:骨干用 FlashAttention-3[12],二维 RoPE[13] 用自定义 CUDA kernel 直接作用在打包好的 QKV 布局上,省掉注意力前的一次重排。
2.3 几何:rig-ego 分解与度量深度
位姿不是直接回归一个 矩阵,而是分解成静态和动态两部分:
是相机 在参考相机系里的固定外参, 是参考相机随时间的轨迹。两个头各读各的 token:rig 头只读第一个时间组里所有相机的 rig token,ego 头只读参考相机跨时间的 ego token,各自过一个 VGGT 式的 transformer 头,再回归平移和四元数。预测出来的是 world-to-camera 编码,组装前转成 camera-to-world。
这样设计有三个好处。其一,静态标定只估计一次、复用整个窗口,而不是每个时间步都重新猜相机之间的关系;表 5 的 (c) 行印证了这一点:rig 平移误差 7.16 → 5.00 cm,rig 旋转误差 0.808° → 0.796°,rig mAA@15 从 74.24 升到 77.91。其二,采集时间 被显式保留,ego 轨迹按采集时刻插值(平移线性、旋转最短弧 slerp),异步相机也能组装。其三,当不同窗口都在同一度量单位下监督时,它们的尺度一致,后面的 PGO 才能假设「整段单一尺度」并按 SE(3) 求解。
先把异步这件事拖出来看。下面是一个六相机车的俯视图:时间轴走到第 帧,前广角相机的曝光比这一帧晚 ,于是它看到的车体位置是 ,而它相对车体的外参始终是 。
深度侧是 DPT[14] 解码器:把上下文 patch 特征重排成空间特征图,多尺度卷积融合,输出 的相机 深度、辅助点图(窗口系)、辅助语义 logits(21 类)以及置信度图。点图和语义只做训练辅助,推理时用不上——但语义预测会以停止梯度的形式借给高斯头做透明度掩码。
度量尺度是这套系统里收益最大的一处改动:表 5 里从 (c) 加上度量尺度训练得到 (d),ATE 从 141.72 直接砍到 70.67 cm,深度 AbsRel 也从 0.136 降到 0.129。之后的相对位姿监督 (e) 把 RTE 再压到 3.22 cm、RRE 到 0.042°,辅助语义监督 (f) 把 AbsRel 带到最低的 0.127。
2.4 3D 检测:900 个查询、共享金字塔
检测头沿用 PETR 的思路[15]:用一组锚在可学习 3D 参考点上的 query 表示物体假设,每个 query 预测类别分数和一个立方体(中心、尺寸、yaw、平面速度)。解码器是 DETR3D 式[16]的结构,query 自注意力、多尺度可变形交叉注意力和 FFN 交替;每一层交叉注意力里,query 先预测参考点周围的 3D 偏移,再用内参、镜头模型和外参把采样点投到各相机视角,在特征金字塔上采样,最后按相机、尺度和采样点做 query 相关的加权。默认配置 900 个 query、6 层解码器、宽度 256。
「把 3D 点投到相机上」听起来抽象,其实就是一次针孔投影。拖动下面的三个量:左边是 ego 系俯视图里的 3D 框,右边是同一组角点用内参投影到前视相机图像里的样子。
特征金字塔和占据共享:编码器的 高分辨率特征与聚合器的上下文特征经横向投影对齐通道,上下文特征上采样后沿自顶向下路径加回去。这个共享金字塔很便宜——运行时间表里 DET/OCC neck 在 时只有 14 ms。
监督是一对一的匈牙利匹配,分类用 sigmoid focal loss,回归用加权 ;每个解码器层都监督。训练时还加了两样东西:DN-DETR 式的 query denoising[17](把真值框按尺寸扰动后作为已知目标的查询,跳过匹配),以及一个 YOLOX 风格的辅助 2D 头[18](逐相机预测 2D 框、类别、objectness 和投影中心)。这两项只在训练时用。内部数据是 12 类:汽车、重卡、公交、火车/有轨电车、其他车辆、行人、骑行者、挂车、外凸物、无轨电车、婴儿车、动物;公开基准上换分类器。
2.5 语义占据:BEV 可变形注意力 + channel-to-height
占据分支在车辆 rig 系下输出 m、0.2 m 体素的二值占据和语义标签。为了省显存,中间特征一直保持 BEV 形状,只在输出时把高度维展开。
BEV 投影模块受 Deformable DETR 启发[19]:每个 BEV 格子沿竖直柱子均匀放四个参考点,每个点编码归一化 3D 坐标,分别初始化 query 特征和位置编码;transformer 层用自注意力和可变形交叉注意力 refine。交叉注意力把 3D 采样点按内参和静态 rig 外参投到各相机——因为参考点和 BEV 网格都定义在每个时间步自己的 rig 系里,这一步不需要 ego 位姿。最后学一个合并层,把四个柱状特征压成一个 BEV 特征。
输出头是两层转置卷积:一路 个二值通道,一路 个语义通道,channel-to-height 插件[20]把通道重排成高度。损失是 BCE + Lovász hinge + 体素 CE + Dice,外加一个接在上采样 BEV 特征上的辅助 BEV 分割头(CE + Dice),权重 。推理时对二值概率取 0.5 阈值,被占体素取语义分数最高的类。
channel-to-height 是整个分支里最反直觉的一步:网络从头到尾只在二维 BEV 上算,最后却输出三维体素。把下面的滑块从 0 拉到 100%,看一个 BEV 格子里的 个通道怎么变成竖直方向的 个体素;画布可以拖动旋转,从侧面看这层高度怎么长出来。
消融(表 14)说明每个部件都有用:把 LSS 换成 BEV 可变形注意力,全 ROI IoU/mIoU 从 24.03/10.37 升到 27.08/11.44;DINOv2 换成 VGGT 初始化到 27.64/11.94;加辅助 BEV 分割到 12.28 mIoU,加 Dice 到 12.51;加 PlanNet 数据到 28.64/13.33;最后加长训练、加大 batch 到 32.35/15.84。注意 IoU 涨得比 mIoU 快——几何边界好学,语义类别难分。
2.6 3D 高斯:逐像素预测,不做逐场景优化
高斯分支沿用 Instant NuRec 的表示:静态高斯 + 绑定到物体的高斯 + 天空 cubemap。对解码器输出网格上的每个源像素 ,预测中心 、RGB、尺度、单位四元数、透明度和一个辅助法向,协方差 。
中心不是自由回归的,而是沿相机射线反投影:
是预测的度量深度, 是标定反投影得到的单位射线, 把相机深度换成射线距离。关键点:训练时用真值位姿和物体轨迹,推理时用自己预测的位姿和轨迹,不需要任何逐场景优化。天空、自车和未知区域的高斯透明度会被几何分支的语义预测乘上一个掩码(训练时用软概率、停止梯度;推理时用离散标签)。
「逐像素一个高斯」在渲染时到底长什么样?下面是一个合成的玩具场景:每个点是一个各向异性的高斯,按深度从远到近做 alpha 合成。拖动视角看视差,调尺度看空洞和模糊。
渲染时,物体高斯按预测轨迹插值后刚性变换到目标时刻,静态高斯不动;可微 splatting[21]得到累积颜色和透明度,天空 cubemap 填补剩余透射,最后每个相机学一个仿射颜色变换 吸收曝光差异。训练目标是 ,另外加源视图一致性、法向、天空一致性和仿射正则。监督用的目标帧有两个:一个在上下文区间内部,一个在最后样本之后 0.5 s 内——后者正是外推能力的来源,也是它不够强的原因(见局限性)。
2.7 三阶段训练
三个内部数据集:NRE 67,970 段、PlanNet 75,921 段、MLMCF 59,999 段,平均约 12 s,合计约 695 小时驾驶数据。传感器是六路多项式 f-theta 相机(30 FPS)和 128 线 LiDAR(10 Hz)。NRE 以高速为主,PlanNet 偏城市和居住区,MLMCF 更均衡。
| 数据集 | Clip 数 | 城市 | 居住区 | 高速 | 乡村 | 其他 |
|---|---|---|---|---|---|---|
| NRE | 67,970 | 16.5% | 9.1% | 64.5% | 7.6% | 2.3% |
| PlanNet | 75,921 | 42.5% | 17.3% | 20.8% | 16.5% | 2.9% |
| MLMCF | 59,999 | 36.5% | 10.9% | 42.9% | 6.9% | 2.8% |
训练分三步,核心思路是先短窗口省算力,再拉长时间,最后加高斯:
- 第一阶段:编码器、聚合器、几何/检测/占据头一起训,每相机 4 个时间步、随机帧间隔最大 8,约 170k 次更新。
- 第二阶段:窗口拉到 8 个时间步、最大间隔 16,冻结图像编码器,再训 45k 次。
- 第三阶段:先冻结已有模型热身高斯头,再联合微调聚合器和四个任务头 10k 次,编码器仍冻结。
优化器 AdamW,主学习率 (第一阶段编码器用 1/10),高斯头热身 ,最终联合微调 ;BF16 混合精度,但几何和高斯解码器以及数值敏感的检测/占据算子保留 FP32。联合损失权重 。在 64 张 H100 上,一次更新在 4 个时间步时约 3.8 s、8 个时约 8.3 s;感知训练约 18 天,高斯头与联合微调再 9 天。
2.8 视频级推理:拼接、PGO 与离线跟踪
模型只看一个窗口。超过窗口长度的视频要两件事:把窗口的位姿和几何对齐到同一坐标系,把逐帧检测串成轨迹。这类「重叠窗口 + 子图对齐」的做法在 VGGT-Long 和 VGGT-SLAM 2.0 里已经出现[22, 23],Foundation4D 把它和检测/跟踪接到了同一套预测上。
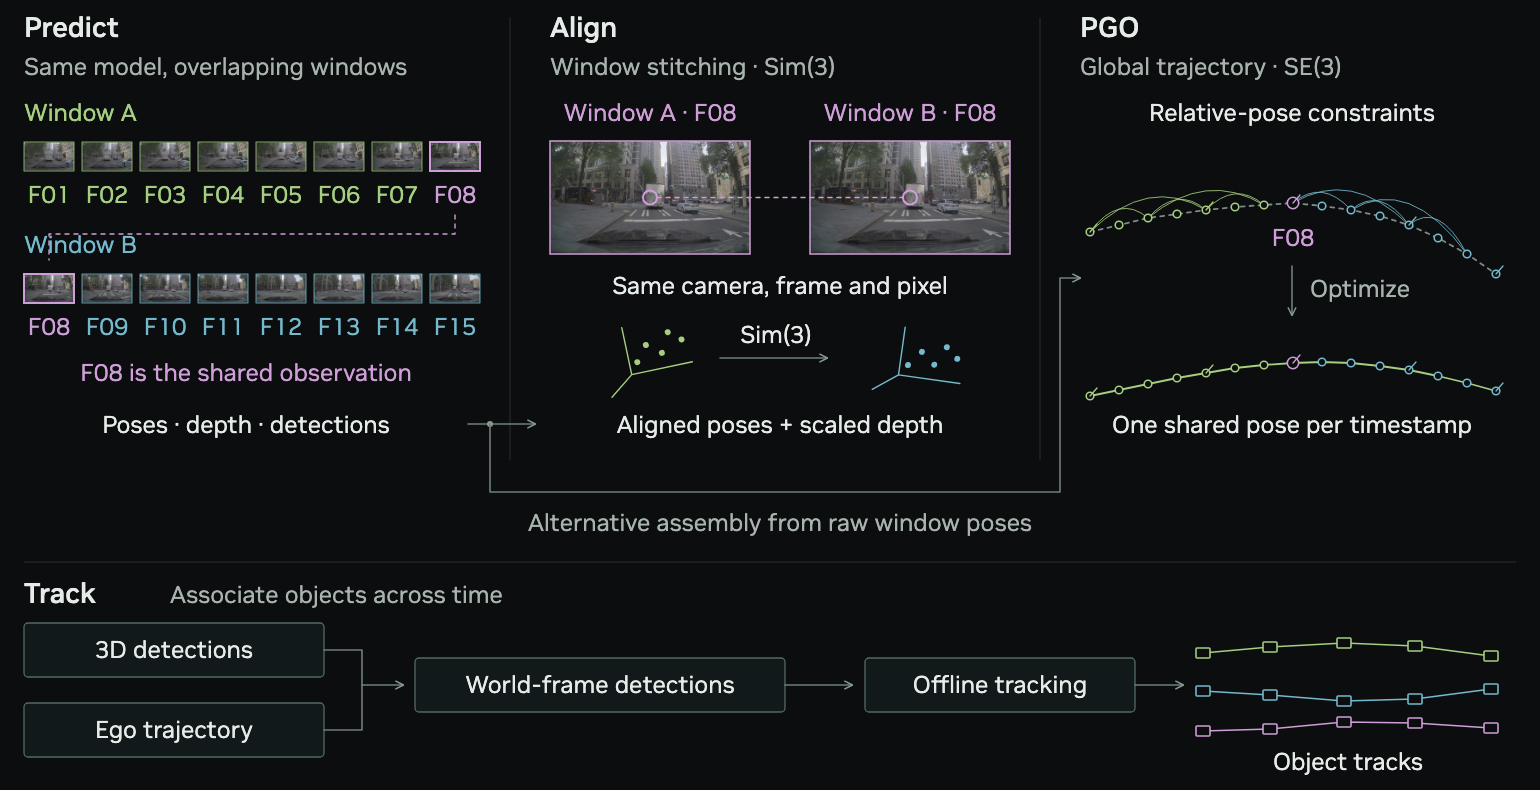
顺序拼接(stitching) 是直白的做法:每个新窗口用一次 Sim(3) 对齐到前一个已对齐的窗口。对应点来自深度反投影的点图,跨相机、跨重叠帧收集;用 Huber 的迭代重加权最小二乘估计 ,权重是两张深度置信度的几何平均,天空对应点用语义预测剔除。估计出的相似变换作用到窗口内所有相机位姿,深度乘上 。问题也很直白:后面的窗口不会修正前面的位姿,误差逐窗口累积。表 6 里,只用拼接的 ATE 是 65.55 cm。
位姿图优化(PGO) 把整个视频的参考相机轨迹作为一张图。每个唯一的参考相机采样是一个节点,所有包含该采样的窗口共享同一个节点;窗口 内部的预测相对位姿 是测量,同一个节点对来自不同窗口的测量是不同的因子,因而可以互相约束。图里没有外部位姿因子,也没有回环检测,只有窗口重叠。目标是
先解旋转(闭式平均 + L-BFGS 用旋转向量 refine),再固定旋转解平移——平移目标变成线性最小二乘。 惩罚内部节点前后两段平移速度之差,抑制短时间内的速度抖动,。因子连接同一窗口内间隔 1、2、4、8 行的采样,权重从窗口开头的 1 线性降到 0.1。最后每个采样从其所在最靠近窗口中心的那个窗口取深度,位姿用式 (16) 的修正量转移到实际采集时刻。表 6 里 PGO 把 ATE 从 33.11 降到 31.26 cm(加运动先验),相对拼接几乎是腰斩。
拼接与 PGO 的差别值得用一个玩具模型亲手拖一拖。下面是一个二维俯视的示意:一条每窗 30 m、每窗转 2° 的弯道,相对位姿加平移和航向噪声;拼接只把相邻窗的测量链起来,PGO 用间隔 1/2/4 窗的全部约束一起解。两种方法拿到的噪声测量完全相同,唯一差别是图的结构。
离线多目标跟踪 把检测变成轨迹:先用组装好的 ego 轨迹把每个时间步的检测框(中心、朝向、速度)从各自的 rig 系转到世界系,再按时序关联。一个匀速卡尔曼滤波维护每条轨迹的平面位置和速度,检测模型预测的位置和速度同时作为测量;预测后做匈牙利匹配,带距离门限,未匹配的检测新建轨迹,未匹配的轨迹在一段存活时间内保留。跟踪跑两遍:第一遍用较短寿命形成保守轨迹,再插值空隙、平滑,第二遍用较长寿命把碎片接起来(最大间隔 24 和 50 个 30 Hz 帧)。最后 RTS 反向平滑让后续观测改善早先状态,高度和 yaw 单独平滑,每条轨迹取中位立方体尺寸。
这套后处理值 2.2 个 HOTA:只用检测速度做运动预测是 41.4,加卡尔曼到 42.1,再加 RTS 到 43.6(表 10)。预测位姿的影响也被单独量化:固定真值框和真值 ID、只把真值 ego 位姿换成预测位姿,HOTA 从 100.0 掉到 83.8,说明残余的定位误差真实存在;但接上预测检测和完整跟踪器后只从 43.6 掉到 40.5(−3.1,即 7.1%),整条流水线基本扛住了。
三、VGGT 系前馈模型:同一副骨架的十种改法
要理解 Foundation4D 改了什么,先要知道它站在谁的肩膀上。VGGT 是这一族的参考实现:每帧图像过 DINOv2 ViT-L,加一个相机 token 和四个 register token;24 层里帧内自注意力和全局自注意力交替,没有 cross-attention;相机头从相机 token 回归 9 维(四元数、平移、两个视场角),深度和点图走 DPT 头。它不要求输入标定,代价是尺度只能归一化,且全局注意力随视图数平方增长[5, 24, 25]。
之后的工作基本都在改四个地方:注意力怎么拆(让多相机视频算得起)、流式还是离线(因果缓存 vs 整窗)、标定和尺度怎么进来(已知内外参、射线编码、度量监督)、位姿怎么参数化(逐相机 9D、ego 7D、rig×ego、traj+rig)。下面这张表把这条线上会反复提到的模型放在一起。
| 模型 | 输入 / 标定 | 骨干 / 时空聚合 | 几何输出、任务头 / 流式 |
|---|---|---|---|
| VGGT[5] | N 视图,无标定 | DINOv2-L,24 层帧内+全局 | 相机 9D + 深度 + 点图;跟踪头;离线 |
| DVGT[7] | 多相机视频,无标定 | DINOv3-L,24 block 三段注意力 | ego 7D + 度量点图;无任务头;离线 |
| DVGT-2[26] | 单目流式 | 同 DVGT | 相对位姿 + 局部点图;轨迹/动作头;因果 W=4 |
| DriveVGGT[8] | 6 路,已知 K/E | VGGT 式,TVA+MCA | rig×ego 位姿 + 深度;无任务头;离线 |
| GeoUP[6] | V 相机×T,标定+ray | VGGT-L 初始化,12 层 | 度量深度 + c2r 位姿;检测+占据;历史缓存 |
| TRIG[9] | 6×T,标定+位姿先验 | 冻结 DINOv2-L,5 个 rig block | traj+rig 位姿 + 深度;无任务头;稀疏注意力 |
| LiAuto-GeoX[27] | 6 路,标定条件 | DINOv2-S 学生,12+12 层 | 深度 + 位姿;无任务头;离线 |
| LingBot-Map[28] | 单目流 | DINOv2-L,GCA 锚帧+窗口 | 绝对 c2w + 深度;无任务头;20 FPS 流式 |
| MapAnything[24] | 任意视图 + 可选几何 | ViT-G + 16 层融合 | 射线 + 相对深度 + scale;无任务头;离线 |
| DA3[25] | 任意视图 + 可选位姿 | DINOv2 单流,2:1 混合 | 深度 + 6D ray map + 相机;3DGS;离线 |
| Foundation4D | 6 路视频 + 内参/rig/时间 | DINOv2-L,16 层因子化 | rig-ego 位姿 + 度量深度;检测+占据+高斯;PGO |
3.1 四个改法,各自付什么代价
注意力拆法。 DVGT 把每个 block 的注意力拆成帧内、跨视图、跨帧三步,24 个 block 重复[7];GeoUP 的 12 层是 self → temporal → view;DriveVGGT 用 per-camera temporal attention 加 4 层 multi-camera attention;TRIG 更省,24 层里只有第 0/4/11/17/23 层做跨相机全局注意力,其余 19 层只做每相机时序[9];DA3 则用单个 vanilla DINOv2 流,前 2/3 层帧内、后 1/3 层跨视与帧内交替[25]。Foundation4D 的选择是 16 层、每层「帧内 + 跨视/跨时二选一」,把跨轴信息分摊到多层多跳里。
流式代价。 DVGT-2 只缓存最近 4 帧,输出相对位姿、局部点图和轨迹/动作,单帧约 260–270 ms[26];LingBot-Map 走得更远,用 8 个锚帧、64 帧局部窗口、以及每个被逐出帧保留的 6 个记忆 token 取代全局注意力,KV-cache 下约 20 FPS,能跑到一万帧,但没有回环[28]。流式不是免费的:同一套评测里 DVGT-2 的深度 AbsRel 从 DVGT-1 的 0.18 退到 0.22(nuScenes),Waymo 从 0.20 退到 0.26(表 2)。Foundation4D 不追求单帧流式,而是整窗预测、再用 PGO 在窗口之间做全局一致——本质上是拿延迟换精度。
标定与尺度。 纯 VGGT 路线(DVGT、DVGT-2、LingBot-Map、DA3 主模型)都不要求标定,尺度要么归一化、要么靠锚帧;MapAnything 把「可选的内参/位姿/深度」做成条件输入,再用一个 scale token 输出全局度量尺度[24]。驾驶线则反过来把标定当免费午餐:DriveVGGT 直接吃已知 K/E,尺度由 rig 基线给定;GeoUP 用 Plücker ray 把标定编码进 patch 特征,深度按米监督;TRIG 进一步把 9D 位姿序列先验喂进去;Foundation4D 用已知内参和 rig 外参做位置编码与采样,但 ego 运动仍由网络预测,深度用度量监督。
位姿参数化。 VGGT 给每个视图一个绝对 9D 相机;DVGT 只给参考相机的 ego 7D 轨迹;TRIG 把位姿拆成「每时刻 trajectory + 每相机 rig」两套嵌入,在 5 个 rig block 里融合;DriveVGGT 预测 rig 相对位姿再乘 ego 运动;Foundation4D 的 rig-ego 分解与它们同源,区别是 rig 头只在第一个时间组读一次静态外参,ego 头读跨时间 token。
任务头。 这一族里大多数只做几何:VGGT 多一个跟踪头,GeoUP 接检测和占据,DA3 接 3DGS,Foundation4D 四类全接。GeoUP 是最接近的前作:nuScenes 检测 56.5 mAP(单数据集版)和 59.2(联合训练版),Foundation4D 是 60.9 / 66.5,高 1.7 mAP(表 7)。GeoUP 也做占据,但本文的 OpenOccupancy 表没有列它,无法直接比;那张表里最强的是 SPSC-temporal 25.5 IoU,Foundation4D 27.4(表 12)。
数字上,这一族在驾驶基准里的排序很清楚(表 2):Foundation4D 的 Waymo / nuScenes 深度 AbsRel 是 0.09 / 0.15,GeoUP 0.13 / 0.19,LiAuto-GeoX 0.19 / 0.27,DVGT-1 0.20 / 0.18,DVGT-2 0.26 / 0.22。轨迹(表 3)上 DVGT-1 在 Waymo 拼接是 62.33 cm,Foundation4D 32.70;PGO+LM 后 54.55 vs 23.62。这些数字要带着协议读:各模型的训练数据、是否用标定、窗口长度都不同,论文也注明「适配到各自基准」,不是同条件复现。真正可比的结论只有两条:几何预训练比骨干规模更重要(表 8 里 DINOv3 骨干的 RayDN 反而掉点),以及预测越一致,PGO 越能兑现(DVGT-1 在 nuScenes 上 PGO 几乎无益,Foundation4D 从 22.13 到 17.48)。
开源情况也影响复现:DVGT / DVGT-2、DriveVGGT、LingBot-Map、VGGT、MapAnything、DA3 都有公开代码;GeoUP、TRIG、LiAuto-GeoX 和本文 Foundation4D 未开源(GeoX 只有论文)。想在驾驶数据上复现这条线,DVGT 是最现实的起点;要检测/占据的联合输出,目前只有 GeoUP 的论文描述可参考。
四、数据与基准:PAI–Foundation4D
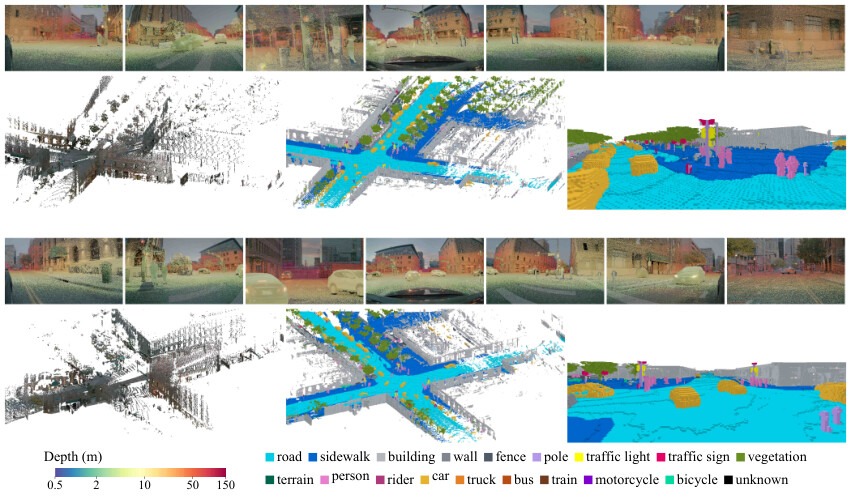
统一模型需要三类稠密监督——深度、占据、轨迹——而且要在同一段驾驶记录上对齐。公开数据集没有这样的组合,所以作者建了 PAI–Foundation4D:PAI 数据集里 1,253 段测试 clip,六路相机,深度图 + 0.1 m 体素的语义占据(含逐体素速度),几何、检测、占据三项评测共用同一批 clip。
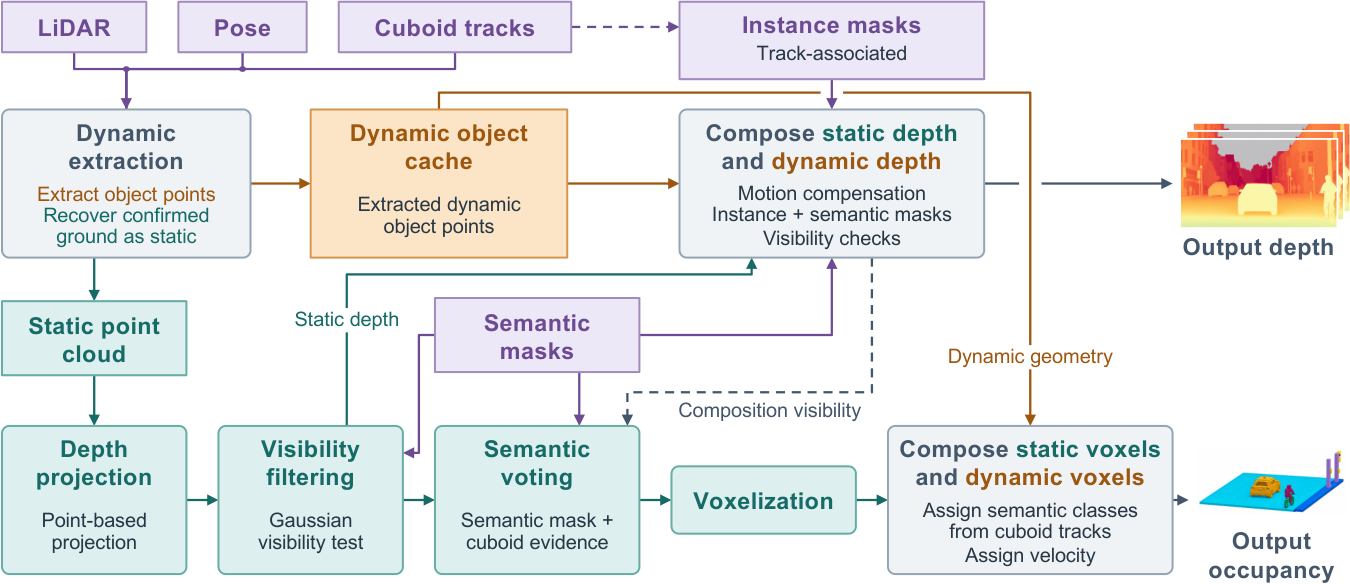
流水线的核心是时间聚合。单帧 128 线 LiDAR 很稀,所以静态点跨整段 clip 累积,动态点只取最多 10 帧、按立方体轨迹 warp 到目标时刻的姿态,立方体内部的地面点剔除,只保留高置信度地面回波。这样既提高覆盖,又不会把运动物体拖成鬼影。深度图把聚合后的静态场景和运动补偿后的动态点渲染进每个相机视角,投影考虑滚动快门期间的相机运动;最近可见点给静态深度,动态点用固定半径高斯 splat 融合,并用实例掩码与遮挡检查决定是否覆盖背景。缺失、天空、自车像素置零。
占据标注则把类别投给 3D 点再体素化:静态点从多相机、多帧的图像语义图里投票,越近权重越大,再用静态立方体轨迹补类;动态点继承所属轨迹的类;红绿灯和交通标志在 3D 里从稠密区域向邻近连通点传播。体素 0.1 m,范围 、、,动态体素优先于静态体素,但道路、人行道和地形例外。
五、实验结果
5.1 评测协议
几何评测用每个序列一次的多视角 Sim(3) 对齐:窗口级评测对齐一个窗口,视频级评测对齐整段 clip;同一个尺度 同时作用到所有预测深度上。指标包括 ATE(相机中心平均误差)、RTE / RRE(相邻位姿的相对平移和旋转误差)、rig RTE / RRE(恢复的相机间静态外参与标定比)、rig mAA@K(1° 到 K° 的平均联合旋转与平移方向精度),以及 AbsRel 和 。
公开基准上的结果都是按基准微调后的:Waymo[30] / nuScenes[31] 几何微调 20k 次迭代(内参数据 + 两个训练集,采样概率 0.30/0.35/0.35),nuScenes 检测 10k 次,OpenOccupancy 30k 次,PAI 占据 45k 次。所有方法用 48 帧窗口、5 帧重叠(PAI 的几何评测),深度按窗口独立对齐尺度,位姿按整段 clip 评测。这一点很重要:公开数字和论文的训练 recipe 不完全可比,读表时要记住。
5.2 几何
先看深度(表 2)。窗口级评测、48 帧不重叠窗口下,Foundation4D 在 Waymo 上 AbsRel 0.09、 91.97%,在 nuScenes 上 0.15 / 86.44%,都是第一。对比对象里 GeoUP 最强(0.13 / 0.19),DVGT-2[26]的流式版本反而比 DVGT-1 差(0.26 / 0.22),LiAuto-GeoX[27]在 nuScenes 上掉到 0.27——说明蒸馏出来的小模型跨数据集不稳。
视频级轨迹(表 3)更能说明问题。同样的 48 帧窗口、5 帧重叠,拼接时 Foundation4D 把 Waymo ATE 从 DVGT-1 的 62.33 压到 32.70 cm,nuScenes 从 31.02 到 22.13;切到 PGO+LM 后是 23.62 / 17.48,相对 DVGT-1 降低 29%–57%。有意思的是 PGO 对 DVGT-1 在 nuScenes 上几乎没用(31.02 → 30.54),对 Foundation4D 却从 22.13 到 17.48——PGO 的上限取决于各窗口预测的一致性,预测越一致,全局优化越能兑现。
rig 估计是这套模型比较独特的能力:不需要外部标定,Waymo 上 rig mAA@15 是 83.37%(拼接)/ 83.54%(PGO+LM),nuScenes 上 99.22%。nuScenes 的 rig 更规整、相机更少,所以几乎满分。
PAI 基准上(表 4),对比对象是内部数据微调过的 VGGT†。拼接下 ATE 111.12 → 78.06 cm(−29.8%),rig 平移误差 29.26 → 3.90 cm(−86.7%),rig mAA@15 从 42.50% 到 88.72%。PGO+LM 再把 ATE 压到 52.75 cm,相对 VGGT† 低了 52.5%。深度改善随距离变大:相对 VGGT,10 m 内只降 2.2%,60 m 外降到 7.7%,PGO+LM 时 8.4%。
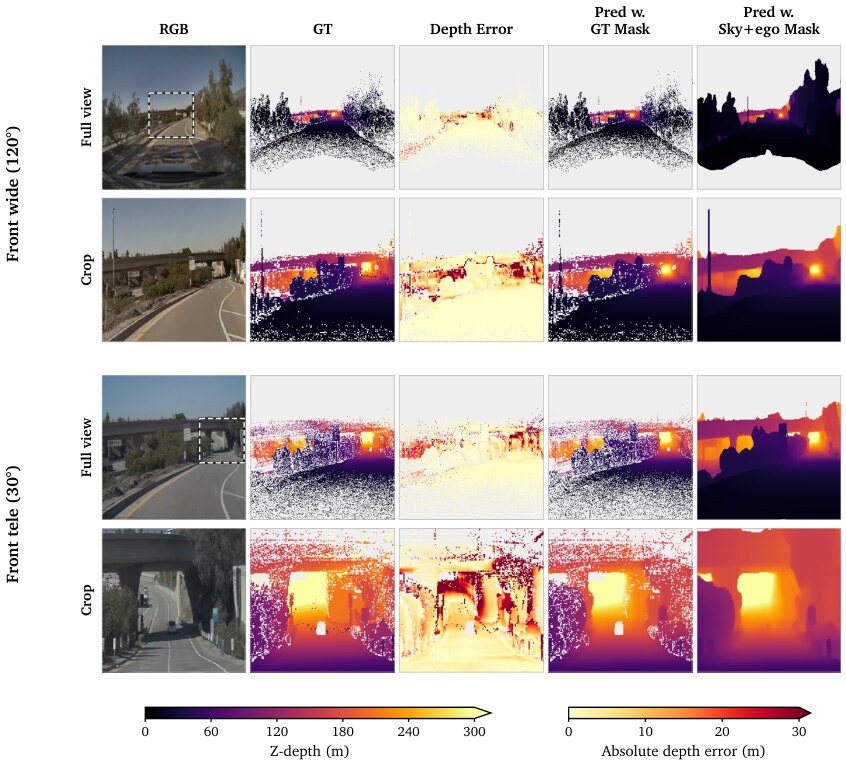
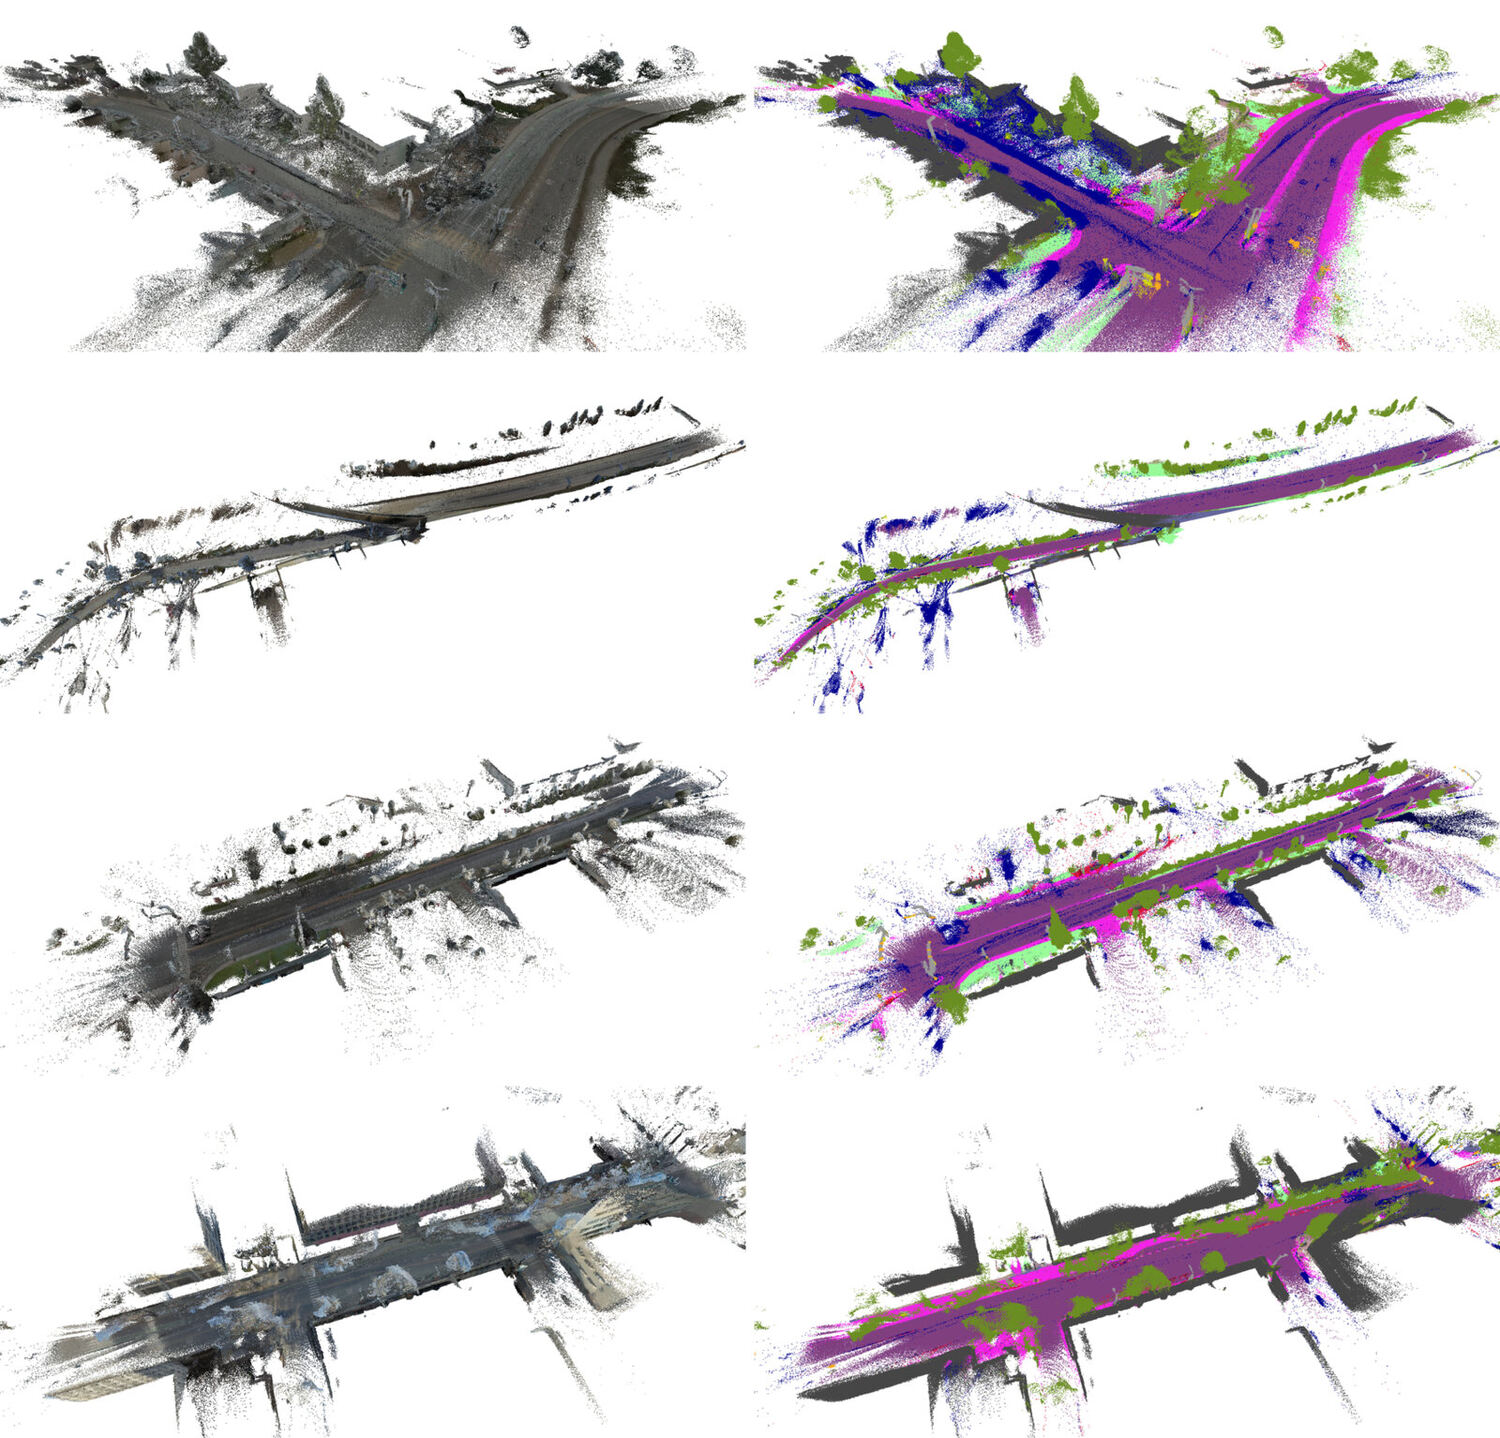
消融把每个设计拆开(表 5)。基线是适配到这套设置的 VGGT:ATE 128.48 cm,AbsRel 0.133。
| 变体 | ATE ↓ (cm) | rig RTE ↓ (cm) | rig mAA@15 ↑ (%) | AbsRel ↓ |
|---|---|---|---|---|
| (a) 基线 | 128.48 | 7.75 | 71.78 | 0.133 |
| (b) + 因子化全局注意力 | 149.88 | 7.16 | 74.24 | 0.140 |
| (c) + rig-ego 分解 | 141.72 | 5.00 | 77.91 | 0.136 |
| (d) + 度量尺度训练 | 70.67 | 5.88 | 76.98 | 0.129 |
| (e) + 相对位姿监督 | 69.81 | 5.62 | 76.91 | 0.130 |
| (f) + 辅助语义监督 | 69.53 | 5.77 | 75.69 | 0.127 |
读法很直接:因子化注意力是用精度换速度(ATE +21.4 cm,运行时间 −8.5%);rig-ego 分解主要修 rig 和局部运动;度量尺度是最大的一步,直接把 ATE 腰斩;相对位姿监督修 RTE/RRE;语义监督修深度和轨迹平移,但 rig 精度反而略有回落。表 6 再对比推理方式:不加掩码的拼接 69.53,加天空掩码 65.55,PGO 33.11,PGO+运动先验 31.26 cm。
5.3 检测与跟踪
先看 nuScenes(表 7)。对比基线覆盖 PETRv2、SparseBEV、StreamPETR、RoPETR 和 RayDN[32, 33, 34, 35, 36]。Foundation4D 拿到 60.9 mAP / 66.5 NDS,比第二好的 GeoUP-Joint 高 1.7 / 1.2。论文特别讨论了一个反直觉现象:给 RayDN 换 ViT-L DINOv3[37]骨干,mAP 只有 49.9,反而低于它自己的 EVA02-L 版本(54.1);而两个用几何预训练初始化的 ViT-L(GeoUP 和 Foundation4D)都超过 56。结论是相机 rig 上的几何预训练比骨干规模更重要。
检测头的组件消融(表 8)也印证了同一件事:VoVNet 21.4,DINOv2 30.1,VGGT 27.5;把分辨率从 518² 提到 1036² 得 31.7,加 FPN 可变形注意力 32.1,加 query denoising 和辅助 2D 头到 34.7,最后换大 schedule 加多任务到 47.0 mAP / 43.6 HOTA。
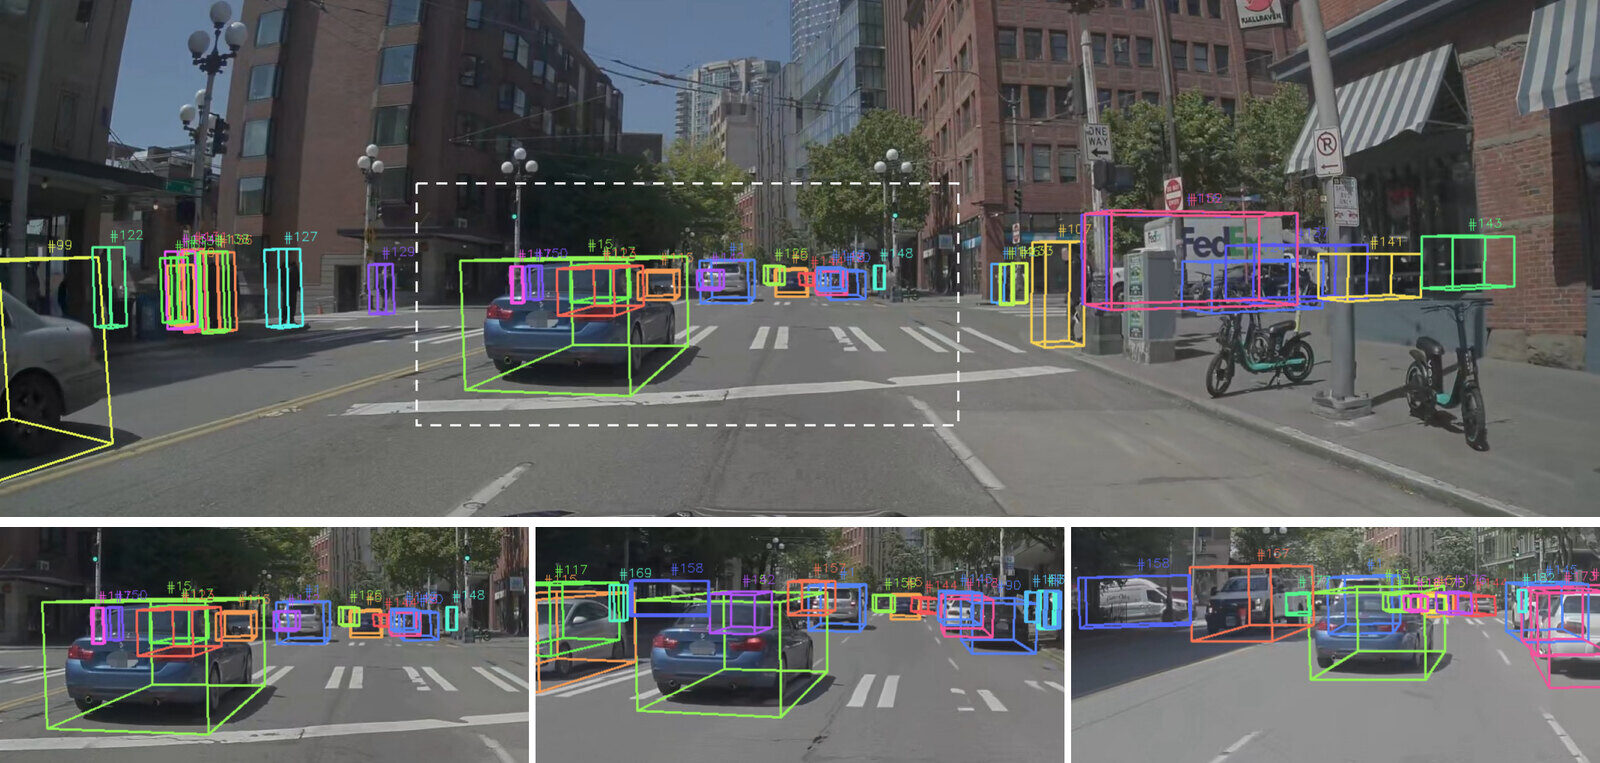
PAI 上(1,253 段、750,552 个时间戳、32 时间步窗口、六路 1036²),五个主类平均 38.00 mAP / 34.76 HOTA[38],全部 12 类 29.11 / 25.66。按平面距离拆开:五类在 64 m 内 52.23 mAP,108 m 内 40.43,108–200 m 只有 11.16——长距检测仍是短板。
时间上下文是推理时免费的旋钮:一个训练好的 checkpoint,把窗口从 2 个时间步加到 32 个,mAP +10.07、HOTA +6.89,不重新训练(表 9)。这也是整个系统里最划算的一处。
5.4 语义占据
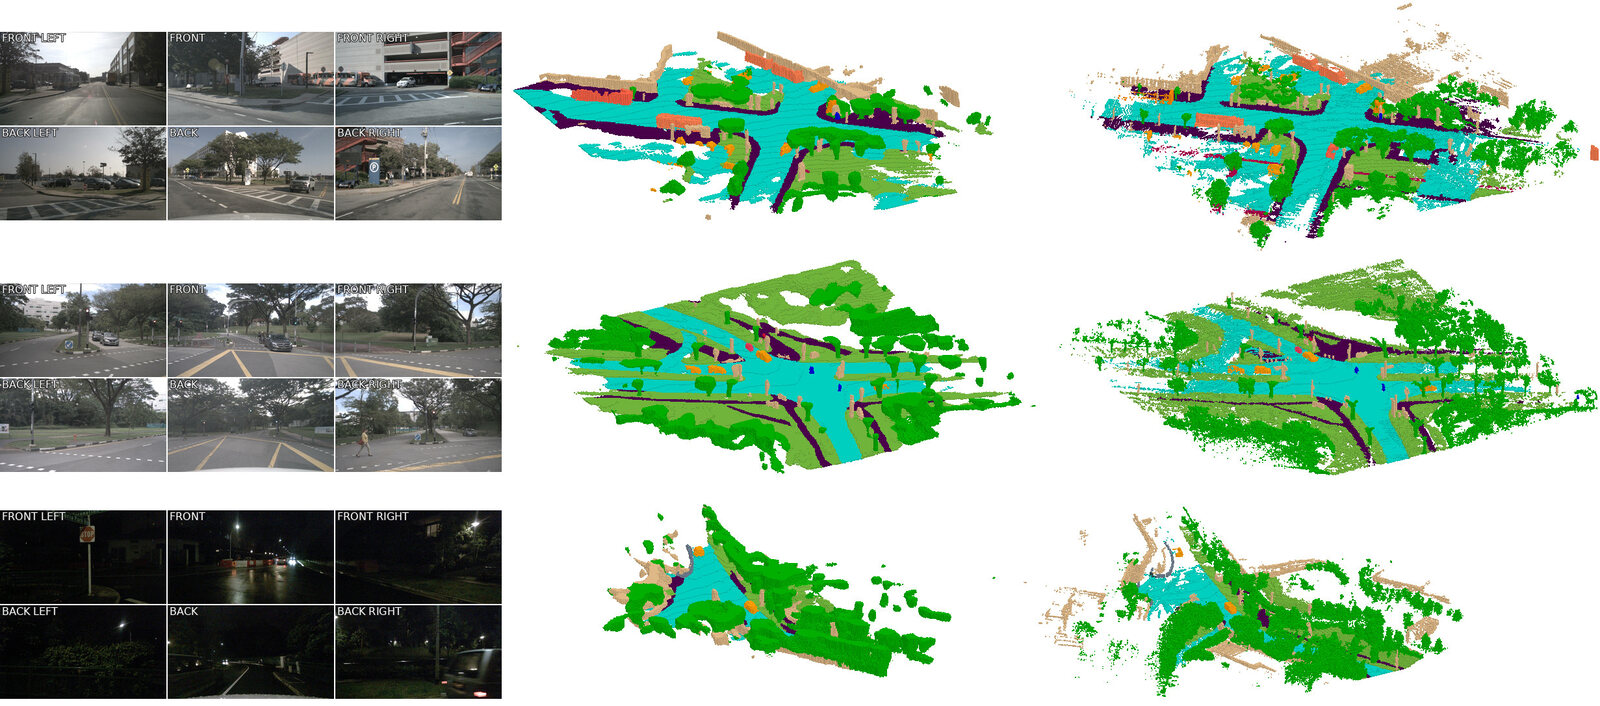
OpenOccupancy[39]上(表 12),对比基线覆盖平面表示 TPVFormer、稠密体素 MonoScene/OccGen/OccMamba、稀疏表示 SparseOcc/SPSC[40, 41, 42, 43, 44, 45]。Foundation4D 是 27.4 IoU / 18.1 mIoU,次优的 SPSC-temporal 是 25.5 / 16.2。按类看,它在 driveable surface(39.9)、sidewalk(28.5)、terrain(24.2)、manmade(13.4)这些大结构上领先,差距集中在 barrier 和 traffic cone——论文猜是预训练标签集里没有这两类。一个简单的 BEV 占据头能打过 TPV、稠密体素和稀疏表示,作者把功劳归给大规模多任务预训练,而不是解码器设计。
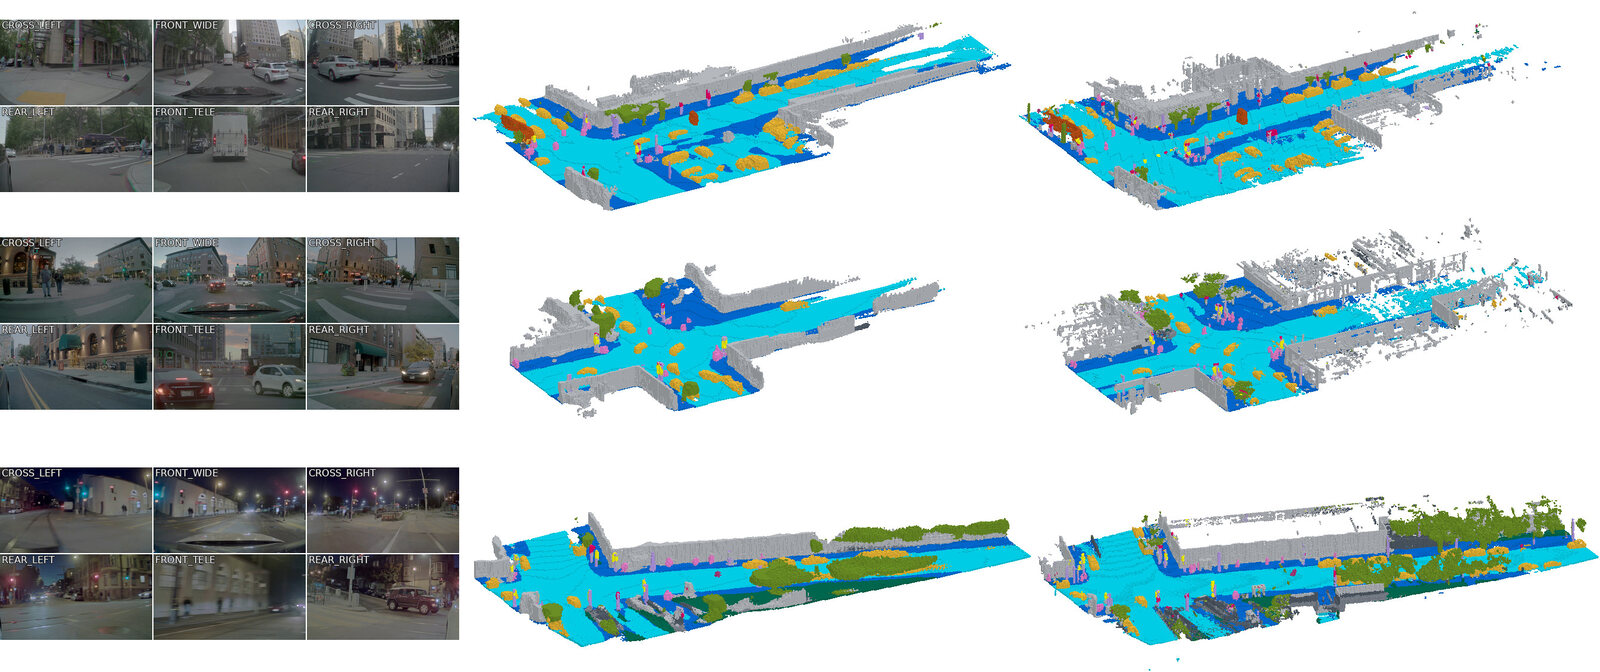
PAI 上(表 13)全 ROI 31.5 IoU / 14.1 mIoU;近场 [-20, 0] m 38.4/18.4,[0, 50] m 35.0/16.0,远场 50–100 m 掉到 22.9/6.9。细杆、红绿灯和骑行者是主要失分区。
5.5 高斯重建
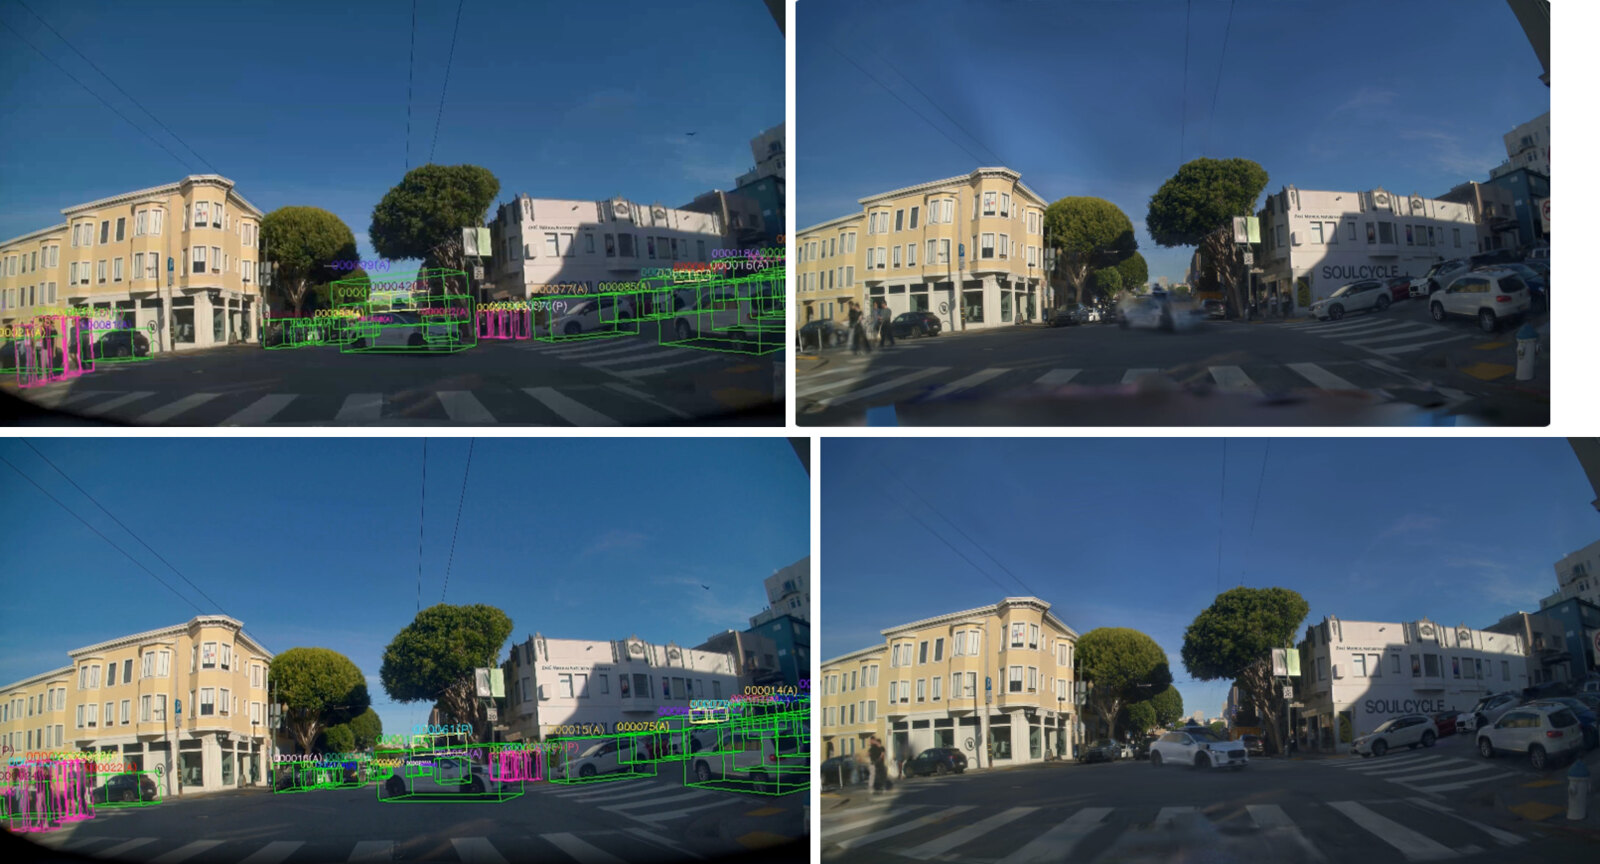
表 15 是这套系统最有趣的结果。Instant NuRec 用真值 ego 位姿,Foundation4D 用自己预测的位姿和物体轨迹,五个公共相机上 PSNR 22.66 → 23.94 dB(+1.28),SSIM 0.78 → 0.80。换成真值位姿的 Foundation4D 是 24.02 dB——也就是说,预测位姿只损失 0.08 dB,前向几何的质量足以支撑可渲染重建。静态区域收益最大(22.83 → 24.27),动态区域 PSNR 略低(19.98 对 20.01)但 SSIM 更高(0.73 对 0.72)。
| 目标集 | 区域 | Instant NuRec PSNR / SSIM | F4D 真值位姿 | F4D 预测位姿 |
|---|---|---|---|---|
| Overall | 全部 | 22.66 / 0.78 | 24.02 / 0.80 | 23.94 / 0.80 |
| Overall | 静态 | 22.83 / 0.78 | 24.34 / 0.81 | 24.27 / 0.81 |
| Overall | 动态 | 20.01 / 0.72 | 20.03 / 0.73 | 19.98 / 0.73 |
| 插值 | 全部 | 22.86 / 0.78 | 23.98 / 0.80 | 23.91 / 0.80 |
| 外推 | 全部 | 20.34 / 0.75 | 20.77 / 0.76 | 20.65 / 0.76 |
| 外推 | 动态 | 17.71 / 0.66 | 16.00 / 0.63 | 15.84 / 0.62 |
外推是软肋:动态区域从 17.71 掉到 15.84。原因在训练——只有两个目标时刻,一个在上下文内、一个在上下文后 0.5 s 内;更远的未来没有监督。
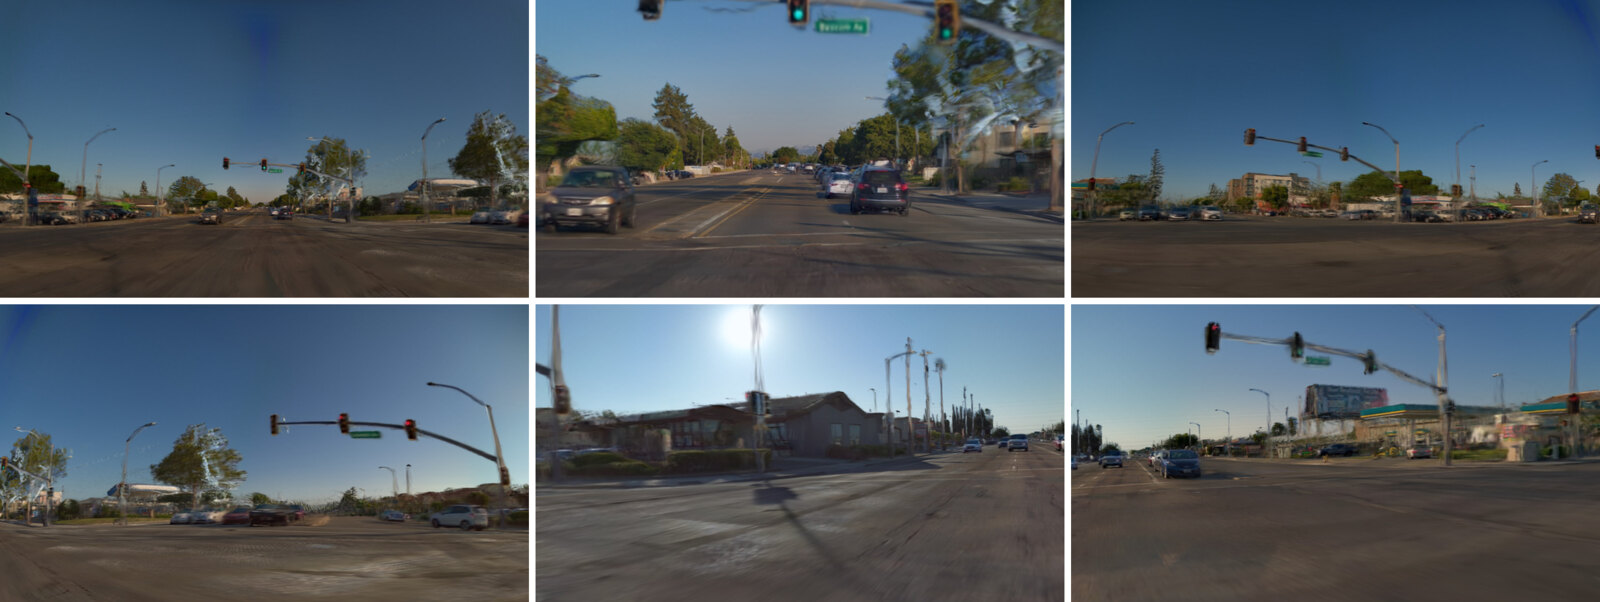
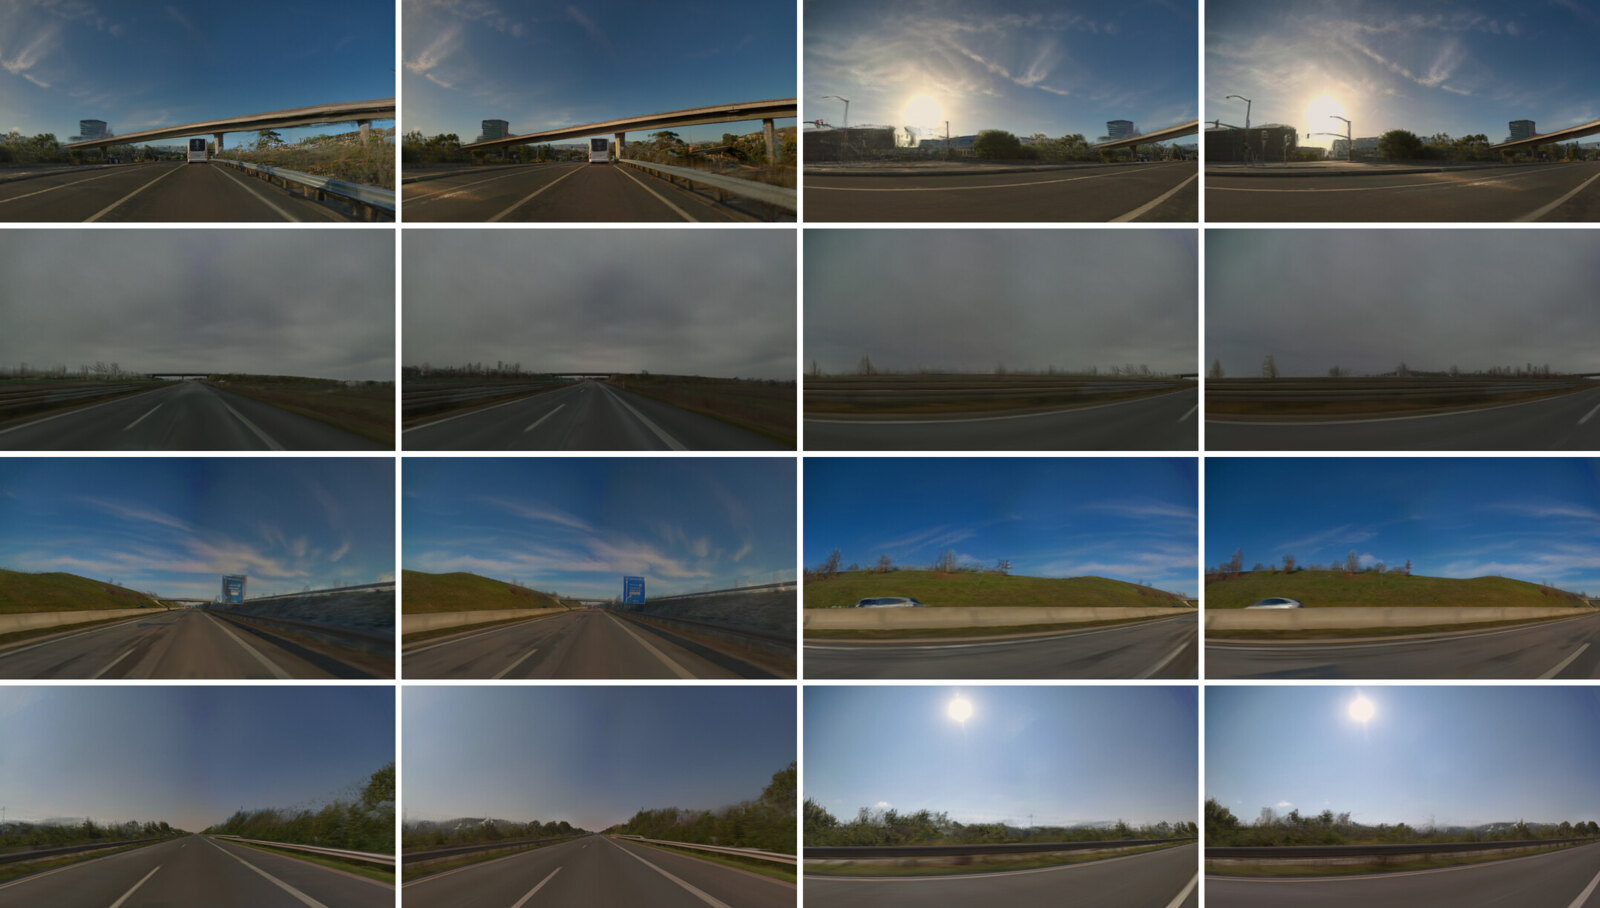
需要注意协议:Foundation4D 用六路输入、Instant NuRec 用五路(它没为前长焦训练),两者的窗口配置也不同;这是系统级对比,不是单独比较高斯解码器。
5.6 统一模型:任务组合的收益并不对称
论文把几何(GEO)、检测(DET)、占据(OCC)的七种组合都训了一遍(表 16),同一个 LingBot-Map[28]初始化、同样的 80k 更新。结论不是「联合训练总是更好」,而是收益取决于组合:
把三个按钮都点开(默认状态)就是论文的推荐配置,但注意两处不对称:检测喜欢三个任务全开,占据反而更喜欢只和几何共训(11.82 对 11.53)。几何则是联合训练的主要受益者:轨迹 ATE 5.00 → 4.55,rig mAA@3 37.09 → 42.05,rig 平移误差 7.53 → 6.64(−13.4%)——检测和占据的监督把共享特征「锚」在了 3D 结构上。代价是深度 AbsRel 从 0.123 略升到 0.127。
5.7 运行时间
| 组件 | T=24 | T=36 | T=48 |
|---|---|---|---|
| 图像编码器 | 2.218 | 3.322 | 4.455 |
| 时空聚合器 | 1.248 | 2.175 | 3.305 |
| 几何头 | 1.786 | 2.673 | 3.559 |
| 共享 DET/OCC neck | 0.014 | 0.021 | 0.028 |
| 检测头 | 0.090 | 0.128 | 0.168 |
| 占据头 | 1.060 | 1.576 | 2.104 |
| 3DGS 头(不含渲染) | 3.255 | 4.578 | 6.155 |
| 全前向(s) | 9.673 | 14.480 | 19.782 |
| 峰值显存(GiB) | 32.47 | 45.44 | 58.41 |
单张 H100、六路相机、1036²,全前向在 24 / 36 / 48 个时间步分别是 9.7 / 14.5 / 19.8 s,峰值显存 32.5 → 58.4 GiB。高斯头约占三分之一,编码器第二,几何头第三;共享 FPN 和检测头便宜得可以忽略,占据头因为要稠密解码(逐时间步释放)反而比检测贵一个量级。这是一个离线、非实时的系统,不是车端在线模型。
5.8 应用到 lidarless NuRec
论文最后演示了一个下游用法:NuRec 传统上依赖 LiDAR 点云和独立的重建/感知流水线来初始化几何、分离动态物体;现在用 Foundation4D 预测的位姿、稠密深度(融合成点云)、法向和物体轨迹作为先验,NuRec 只对 RGB 做逐场景高斯优化。端到端 turnaround 从 16.0 小时/段降到 3.7 小时/段(4.3×):位姿估计 3.5 → 0.4 h(8.8×),深度估计与融合 8.0 → 1.0 h(8×)。表 18 的说明也明确:这些行是不同处理范围的整体数字,不是可加的分解,软硬件也不同代。
六、局限性
论文自己列的:
- 统一模型不是单调更好。三任务全开时占据 mIoU 11.53,低于几何 + 占据的 11.82;更好的任务权重和数据采样可能有用,但试错成本高。几何与渲染监督如何互相影响,也没有系统研究——三阶段训练把高斯放到最后,是为了省掉早期的解码/渲染开销。
- 长距和边界。深度误差随距离增长,物体边界和细结构处最差;异步相机的采集时间差会混淆 rig 监督,插值无法消除歧义。
- 检测与跟踪。拥挤场景和远距离的漏检、置信度抖动会打断关联,轨迹碎片化;需要更稳的检测和更好的跨空档恢复。
- 占据。远距离退化,稀有类经常漏检或分错,帧间预测在边界和细结构处会抖。
- 高斯。动态区域的新视角外推明显弱(表 15 里 15.84 对 17.71 dB)。
我自己再补几条:
- 全部训练数据是内部数据(NRE / PlanNet / MLMCF),公开基准上的结果都经过基准专用微调,基线却多用已发布 checkpoint。作为对比这不算不公平,但它不是「拿公开数据重训就能复现」的工作;加上 64×H100、27 天训练和未开源的代码权重,复现门槛极高。
- 离线而非在线。48 帧窗口、PGO、两遍跟踪、RTS 平滑全是离线批处理;单窗口前向 10–20 s(H100),距离车端实时有数量级差距。论文的定位是数据引擎和仿真,而不是部署模型。
- PGO 假设整段视频单一度量尺度、且没有回环检测,只靠窗口重叠约束。这个假设由固定尺度监督支撑,跨传感器、跨录制或尺度漂移时未必成立;城市环路那种长时间重访也没有显式利用。
- 基准比较的协议差异。检测表里 GeoUP-Joint 的结果论文自己说无法复现;SPSC 系列用的是其论文报告的分数;高斯对比是 6 路对 5 路、两套窗口 recipe 的系统级对比。PAI 的 mAP 也不能和 nuScenes 直接比——评测区域和类别都不一样。
- 外推监督太弱。高斯只有两个目标时刻(一个上下文内、一个 0.5 s 内),动态外推到更远未来没有约束,这也解释了表 15 里的退化。
七、结论与展望
把这篇论文放到 2026 年的上下文里看,它的位置很清楚:前向几何(DUSt3R → VGGT → DVGT/DA3[25]/MapAnything[24]一线)已经能从一个窗口恢复度量几何,驾驶感知(BEV/查询式检测、占据)也已经成熟;Foundation4D 做的是把两者接到同一个骨干上,并且认真处理窗口之间的拼接——staging、PGO、跟踪都是工程,但正是这些工程让「一个模型输出整段场景」成为可评测的事情。再加上 PAI–Foundation4D 基准和 lidarless NuRec 的落地,这是一条从数据标注到仿真应用的完整链路。
对做类似系统的人,这篇论文有几条可操作的启示:
- 先做度量尺度和 rig-ego 分解,再加任务。消融里度量尺度一步把 ATE 砍半,rig-ego 分解把 rig 误差压低;任务组合的收益只有 1–2 个点,顺序反了会白花算力。
- 窗口拼接先用优化,再谈学习。PGO + 运动先验把 ATE 从 65.55 压到 31.26 cm,成本远低于重训模型;但 PGO 的上限由各窗口预测的一致性决定(nuScenes 上对 DVGT-1 几乎无效)。
- 共享 FPN + 简单 BEV 头很便宜。neck + 检测头只占 0.1 s,占据头 1–2 s;多任务的主要成本在高斯头和编码器,不在感知头。
- 推理时的时间窗口是免费的性能。固定 checkpoint,32 个时间步比 2 个时间步高 10 个 mAP,值得在部署预算里单独调。
展望方面,论文留下的口子也很明确:任务权重与采样的联合优化、几何与渲染监督的相互影响、流式/在线版本、动态物体的长时外推。如果代码和数据继续开放,这套「共享骨干 + 视频级后处理」的范式很可能会被更多驾驶世界模型沿用。
参考
- Q. Zhou, S. Huang, M. Liu, B. Ke, F. Xue, G. Brasó, S. Agostinho, T. Meinhardt, et al.. Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles. NVIDIA, arXiv:2610.30340, 2026. arXiv
- Z. Li, W. Wang, H. Li, E. Xie, C. Sima, T. Lu, Y. Qiao, J. Dai. BEVFormer: Learning Bird's-Eye-View Representation from Multi-Camera Images via Spatiotemporal Transformers. ECCV 2022. arXiv
- S. Wang, V. Leroy, Y. Cabon, B. Chidlovskii, J. Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv
- V. Leroy, Y. Cabon, J. Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv
- J. Wang, M. Chen, N. Karaev, A. Vedaldi, C. Rupprecht, D. Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- L. Xu, X. Wang, Z. Huang, H. Li, Y. Yang, N. Wang, S. Liu. Geometry-Grounded Unified 3D Perception for Autonomous Driving. arXiv:2608.13147. arXiv
- S. Zuo, Z. Xie, W. Zheng, S. Xu, F. Li, S. Jiang, L. Chen, Z. Yang, J. Lu. DVGT: Driving Visual Geometry Transformer. CVPR 2026. arXiv · 代码
- X. Jia, Y. Liu, Y. Hong, R. Xia, J. You, B. Sun, Z. Hao, J. Yan. DriveVGGT: Calibration-Constrained Visual Geometry Transformers for Multi-Camera Autonomous Driving. arXiv:2511.22264. arXiv
- L. Liao, W. Xu, H. Wang, L. Yang, S. Yang, W. Liu, C. Huang. TRIG: Trajectory-Rig Decoupled Metric Geometry Learning. arXiv:2607.05801. arXiv
- NVIDIA. Instant NuRec: Feed-Forward 3D Gaussian Reconstruction for Driving Scene Simulation. NVIDIA, arXiv:2607.14203, 2026. arXiv
- M. Oquab, T. Darcet, T. Moutakanni, et al.. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv
- J. Shah, G. Bikshandi, Y. Zhang, V. Thakkar, P. Ramani, T. Dao. FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision. NeurIPS 2024. arXiv
- J. Su, Y. Lu, S. Pan, A. Murtadha, B. Wen, Y. Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 2024. arXiv
- R. Ranftl, A. Bochkovskiy, V. Koltun. Vision Transformers for Dense Prediction. ICCV 2021. arXiv
- Y. Liu, T. Wang, X. Zhang, J. Sun. PETR: Position Embedding Transformation for Multi-View 3D Object Detection. ECCV 2022. arXiv
- Y. Wang, V. C. Guizilini, T. Zhang, Y. Wang, H. Zhao, J. Solomon. DETR3D: 3D Object Detection from Multi-View Images via 3D-to-2D Queries. CoRL 2021. arXiv
- F. Li, H. Zhang, S. Liu, J. Guo, L. M. Ni, L. Zhang. DN-DETR: Accelerate DETR Training by Introducing Query Denoising. CVPR 2022. arXiv
- Z. Ge, S. Liu, F. Wang, Z. Li, J. Sun. YOLOX: Exceeding YOLO Series in 2021. arXiv:2107.08430. arXiv
- X. Zhu, W. Su, L. Lu, B. Li, X. Wang, J. Dai. Deformable DETR: Deformable Transformers for End-to-End Object Detection. ICLR 2021. arXiv
- Z. Yu, C. Shu, J. Deng, K. Lu, Z. Liu, J. Yu, D. Yang, H. Li, Y. Chen. FlashOcc: Fast and Memory-Efficient Occupancy Prediction via Channel-to-Height Plugin. arXiv:2311.12058. arXiv
- B. Kerbl, G. Kopanas, T. Leimkühler, G. Drettakis. 3D Gaussian Splatting for Real-Time Radiance Field Rendering. ACM TOG 2023. arXiv
- K. Deng, Z. Ti, J. Xu, J. Yang, J. Xie. VGGT-Long: Chunk it, Loop it, Align it — Pushing VGGT's Limits on Kilometer-scale Long RGB Sequences. arXiv:2507.16443. arXiv
- D. Maggio, L. Carlone. VGGT-SLAM 2.0: Real-time Dense Feed-forward Scene Reconstruction. arXiv:2601.19887. arXiv
- N. Keetha, N. Müller, J. Schönberger, et al.. MapAnything: Universal Feed-Forward Metric 3D Reconstruction. 3DV 2026. arXiv
- H. Lin, S. Chen, J. H. Liew, et al.. Depth Anything 3: Recovering the Visual Space from Any Views. ICLR 2026. arXiv · 代码
- S. Zuo, Z. Xie, W. Zheng, S. Xu, F. Li, H. Li, L. Chen, Z. Yang, J. Lu. DVGT-2: Vision-Geometry-Action Model for Autonomous Driving at Scale. arXiv:2604.00813. arXiv
- J. Lian, H. Sun, Y. Wu, L. Mu, S. Wang, L. Hui, N. Mao, T. Wei, P. Zhou, K. Zhan, J. Yang. LiAuto-GeoX: Efficient Grounded Driving Transformer. arXiv:2606.05774. arXiv
- L. Chen, J. Gao, S. Zhang, Y. Chen, K. L. Cheng, Y. Sun, L. Hu, N. Xue, X. Zhu, Y. Shen, Y. Yao, Y. Xu. LingBot-Map: Geometric Context Transformer for Streaming 3D Reconstruction. arXiv:2604.14141. arXiv
- N. Ravi, V. Gabeur, Y. Hu, et al.. SAM 2: Segment Anything in Images and Videos. arXiv:2408.00714. arXiv
- P. Sun, H. Kretzschmar, X. Dotiwalla, et al.. Scalability in Perception for Autonomous Driving: Waymo Open Dataset. CVPR 2020. arXiv
- H. Caesar, V. Bankiti, A. H. Lang, S. Vora, V. E. Liong, Q. Xu, A. Krishnan, Y. Pan, G. Baldan, O. Beijbom. nuScenes: A Multimodal Dataset for Autonomous Driving. CVPR 2020. arXiv
- Y. Liu, J. Yan, F. Jia, S. Li, A. Gao, T. Wang, X. Zhang. PETRv2: A Unified Framework for 3D Perception from Multi-Camera Images. ICCV 2023. arXiv
- H. Liu, Y. Teng, T. Lu, H. Wang, L. Wang. SparseBEV: High-Performance Sparse 3D Object Detection from Multi-Camera Videos. ICCV 2023. arXiv
- S. Wang, Y. Liu, T. Wang, Y. Li, X. Zhang. Exploring Object-Centric Temporal Modeling for Efficient Multi-View 3D Object Detection. ICCV 2023. arXiv
- H. Ji, T. Ni, X. Huang, Z. Shi, T. Luo, X. Zhan, J. Chen. RoPETR: Improving Temporal Camera-Only 3D Detection by Integrating Enhanced Rotary Position Embedding. arXiv:2504.12643. arXiv
- F. Liu, T. Huang, Q. Zhang, H. Yao, C. Zhang, F. Wan, Q. Ye, Y. Zhou. Ray Denoising: Depth-aware Hard Negative Sampling for Multi-view 3D Object Detection. ECCV 2024. arXiv
- O. Siméoni, H. V. Vo, M. Seitzer, et al.. DINOv3. arXiv:2508.10104. arXiv
- J. Luiten, A. Osep, P. Dendorfer, P. Torr, A. Geiger, L. Leal-Taixé, B. Leibe. HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking. IJCV 2021. arXiv
- X. Wang, Z. Zhu, W. Xu, Y. Zhang, Y. Wei, X. Chi, Y. Ye, D. Du, J. Lu, X. Wang. OpenOccupancy: A Large Scale Benchmark for Surrounding Semantic Occupancy Perception. ICCV 2023. arXiv
- Y. Huang, W. Zheng, Y. Zhang, J. Zhou, J. Lu. Tri-Perspective View for Vision-Based 3D Semantic Occupancy Prediction. CVPR 2023. arXiv
- A. Cao, R. de Charette. MonoScene: Monocular 3D Semantic Scene Completion. CVPR 2022. arXiv
- G. Wang, Z. Wang, P. Tang, J. Zheng, X. Ren, B. Feng, C. Ma. OccGen: Generative Multi-modal 3D Occupancy Prediction for Autonomous Driving. ECCV 2024. arXiv
- H. Li, Y. Hou, X. Xing, Y. Ma, X. Sun, Y. Zhang. OccMamba: Semantic Occupancy Prediction with State Space Models. CVPR 2025. arXiv
- P. Tang, Z. Wang, G. Wang, J. Zheng, X. Ren, B. Feng, C. Ma. SparseOcc: Rethinking Sparse Latent Representation for Vision-Based Semantic Occupancy Prediction. CVPR 2024. arXiv
- Q. Guo, S. Li, B. Xie, J. Geng, W. Li. SPSC: Sparse and Scalable Multi-Modal 3D Occupancy Prediction for Autonomous Driving. AAAI 2026. AAAI