· 95 min read
论文解读:XoFTR,让可见光与热红外在 LoFTR 里对上话
TL;DR XoFTR 是 METU 与 ROKETSAN 在 CVPR 2024 Image Matching Workshop 上提出的可见光—热红外(TIR)局部特征匹配器[1]:它以 LoFTR 为骨架,把粗匹配的互近邻一对一改成 AdaMatcher 式的一对多分配,用 PMatch 式 MIM 在真实可见—热红外对上预训练,再用余弦变换生成的伪热红外图在 MegaDepth 上微调,最后在 1/2 尺度重匹配并回归亚像素。自建 METU-VisTIR 上,阴—阴相对位姿 AUC@20 为 55.06(DKM 19.17、LoFTR 14.11),阴—晴为 45.03(DKM 23.60);代价是 640×512 单对推理 116 ms(LoFTR 102 ms)。代码、权重与数据集均已开源(代码 Apache-2.0,数据集 CC BY-NC-SA 4.0)。
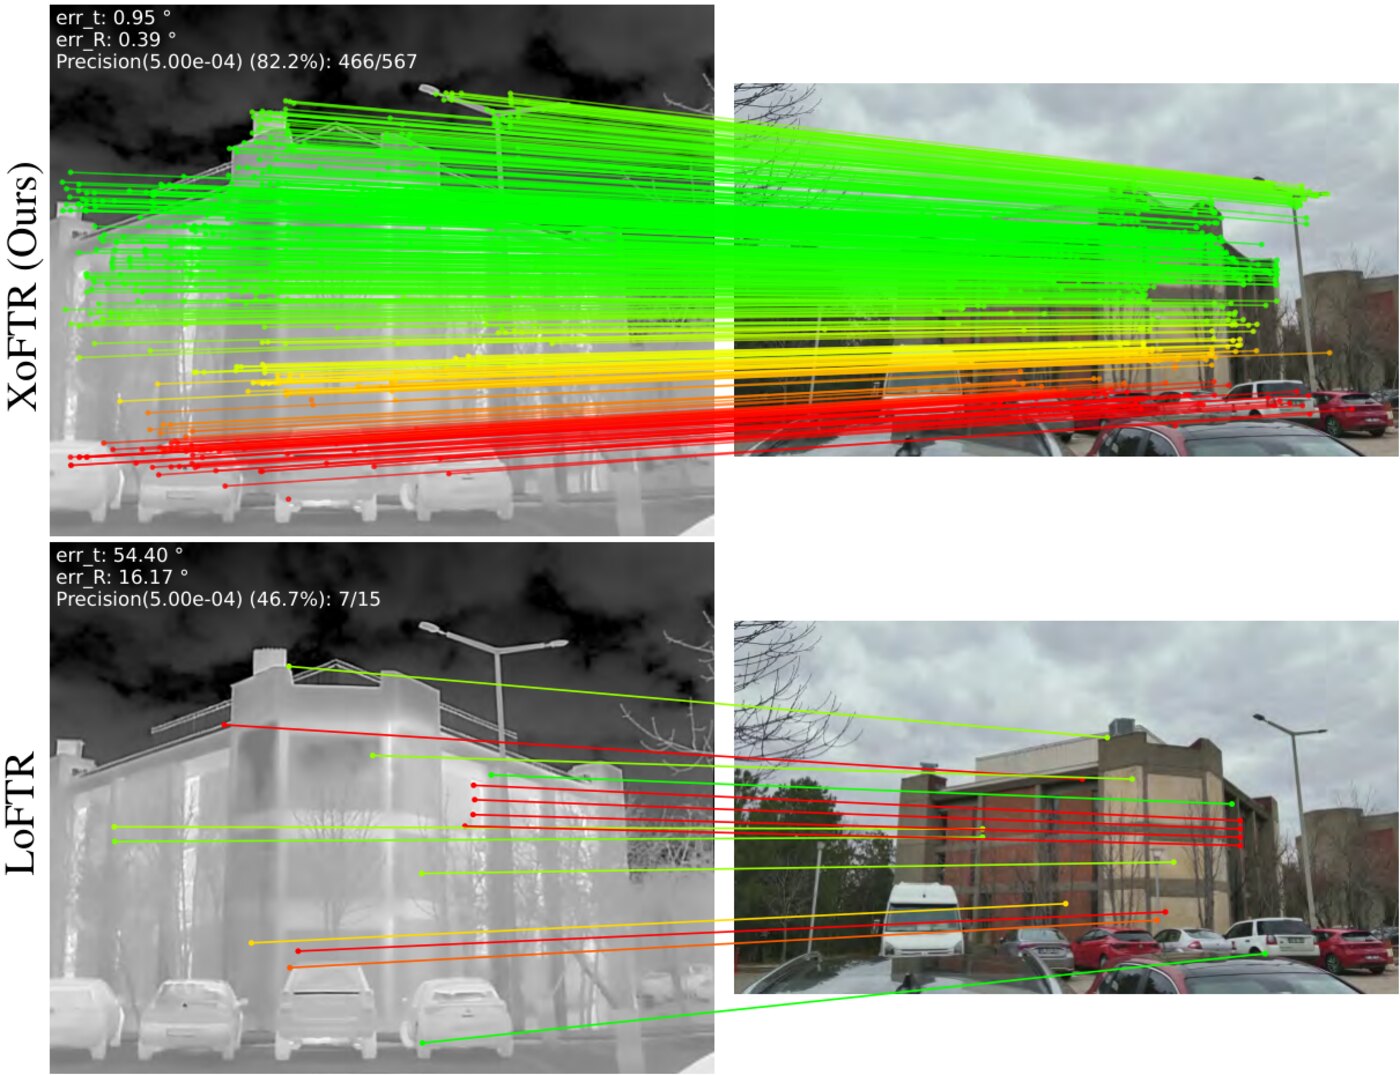
- 论文:XoFTR: Cross-modal Feature Matching Transformer,Önder Tuzcuoğlu、Aybora Köksal、Buğra Sofu、Sinan Kalkan、A. Aydın Alatan(METU 图像分析中心 / ROKETSAN),CVPR 2024 Workshops(Image Matching Workshop),arXiv:2404.09692,CVF 版本。
- 代码:github.com/OnderT/XoFTR(Apache-2.0;权重与数据集通过 Google Drive 发布,数据集为 CC BY-NC-SA 4.0)。
- 前作 / 预备知识:站内 LoFTR、DKM、SuperGlue、LightGlue;跨模态的另一条路线见 MINIMA。
一、动机:热红外能穿透坏天气,却穿不过模态鸿沟
热红外(thermal infrared,TIR)相机的卖点很直接:它记录的是物体自身的热辐射,不依赖环境光,因此雨、雾、雪、夜间都不至于让图像彻底失效;可见光相机在这些条件下则可能过曝、欠曝或一片模糊。把两者放在一起匹配,是无人机夜间定位、多传感器融合、红外—可见光配准等任务的共同需求。
但“都拍到了同一栋楼”不等于“能匹配”。可见光记录反射光,热红外记录热辐射,同一块墙面在两种图像里的亮度关系是非线性的:沥青路面在可见光里很暗,白天却可能因为吸热而变亮;玻璃幕墙在可见光里纹理丰富,在热红外里却可能是一块均匀的冷区。再叠加 TIR 相机通常分辨率更低、视场更窄,以及无人机视角带来的尺度与视点变化,可见—热红外匹配同时撞上了模态差异与视角差异两堵墙。
现有方法基本分两路。手工描述子(互信息、LGHD 一类)和早期的学习型方法[2]能在强度关系上做文章,但大多只在同视角、小形变的配准设定下验证;Shape-Former、MIVI 这类跨模态方法又往往不做大视角、大尺度的多视图匹配。另一路是可见光匹配器:SuperGlue、LightGlue 这类检测器+图神经网络的方法[3, 4],以及 LoFTR、DKM、ASpanFormer 这类无检测器(detector-free)方法[5, 6, 7],它们在 MegaDepth 上训练、在可见光基准上很强,却默认训练与测试同模态——把热红外图直接喂进去,性能会塌。论文表 1 的分类很直白:LoFTR、DKM、AdaMatcher、PMatch 支持多视图但不支持多模态;Shape-Former、MIVI 支持多模态但不支持多视图;只有 XoFTR 两者都打勾。
作者把缺口归纳成两条:没有带标注的城市场景可见—热红外数据,以及粗匹配的一对一假设与跨模态特征不一致相冲突。围绕这两条,论文的贡献是:
- 一套两阶段训练流程:先在真实可见—热红外对上做掩码图像建模(masked image modeling,MIM)预训练,再用伪热红外增强的可见光数据微调;
- 一套从 1/8 粗匹配到 1/2 细匹配、再到亚像素回归的匹配管线,粗匹配允许一对多,细匹配用低置信度阈值过滤;
- 一个新的城市场景可见—TIR 数据集 METU-VisTIR,带 GT 相机位姿,覆盖阴天与晴天;
- 在上述基准和公开单应数据上总体大幅超过 LoFTR、DKM、ASpanFormer、SuperGlue、LightGlue 等强基线。
二、核心方法
2.1 总体架构:保留 LoFTR 的注意力,换掉其余假设
XoFTR 的骨架几乎就是 LoFTR:ResNet 风格 CNN 抽三层特征(1/8、1/4、1/2),1/8 特征加正弦位置编码后送入 4 层线性自注意力/交叉注意力(直接复用 LoFTR 的 LocalFeatureTransformer[5]),得到相关后的粗特征;随后粗匹配、细匹配、亚像素精化依次进行。论文没有提出新的注意力块,所有改动都在“怎么选匹配、怎么训练、怎么从粗到细”上——这也解释了为什么它的收益主要来自分配规则与数据,而不是网络容量。
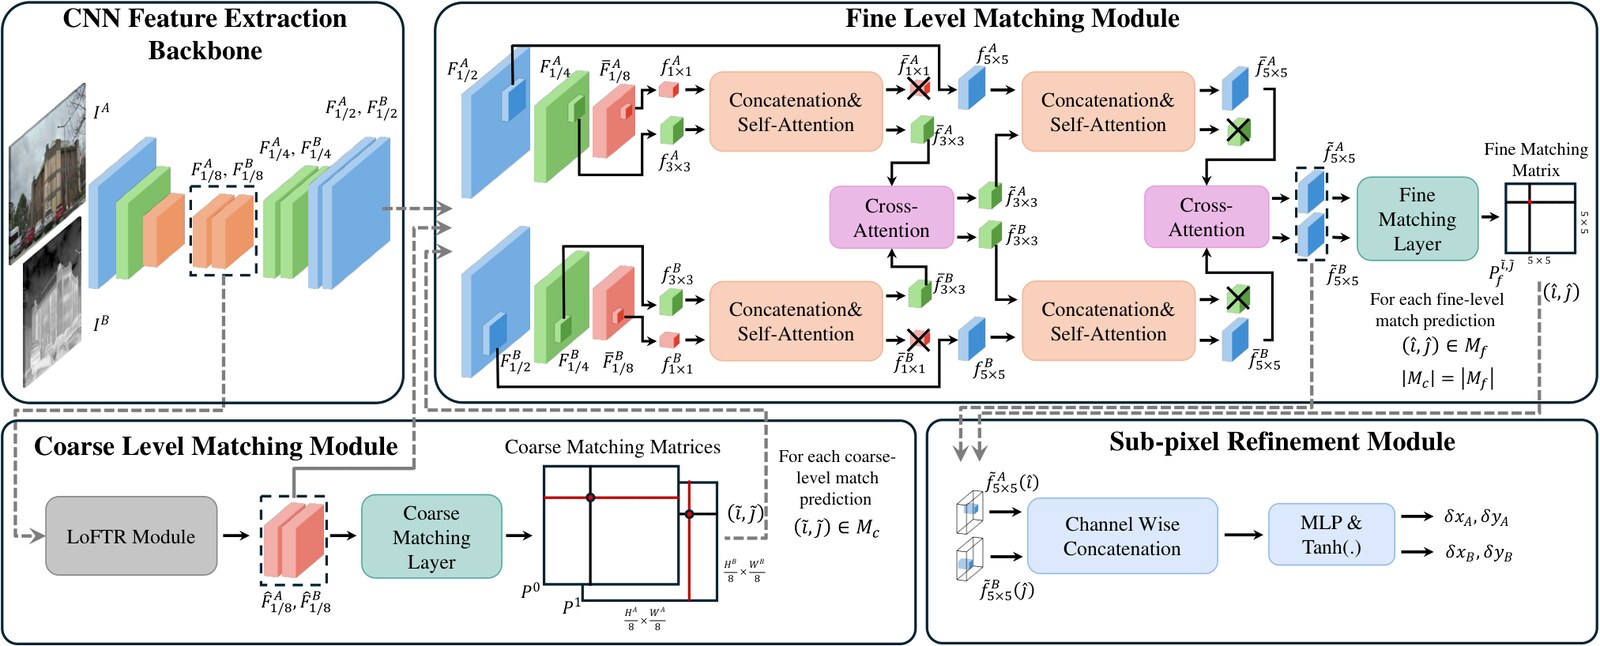
一个容易被忽略的实现细节:网络在 forward 里对每张输入图单独做标准化,
image0_mean = data['image0'].mean(dim=[2,3], keepdim=True)
image0_std = data['image0'].std(dim=[2,3], keepdim=True)
image0 = (data['image0'] - image0_mean) / (image0_std + eps)
# image1 同样处理
这不是普通的数据预处理,而是跨模态匹配的必要条件:可见光与热红外的绝对亮度分布完全不同,逐图减均值、除标准差至少把“模态整体偏移”消掉,让网络只看结构。论文正文没有强调这一点,但官方代码把它放在模型内部,推理时也生效。
2.2 粗匹配:为什么要放弃一对一
LoFTR 的粗匹配是标准的一对一:对相似度矩阵做两个方向的 softmax,得到 (每行归一化)与 (每列归一化),再要求一对 patch 同时是对方的行最大值与列最大值(互近邻,mutual nearest neighbor),并且双 softmax 置信度超过阈值。这个规则隐含一个假设:在 1/8 尺度上,一个 patch 只对应另一个模态的一个 patch。
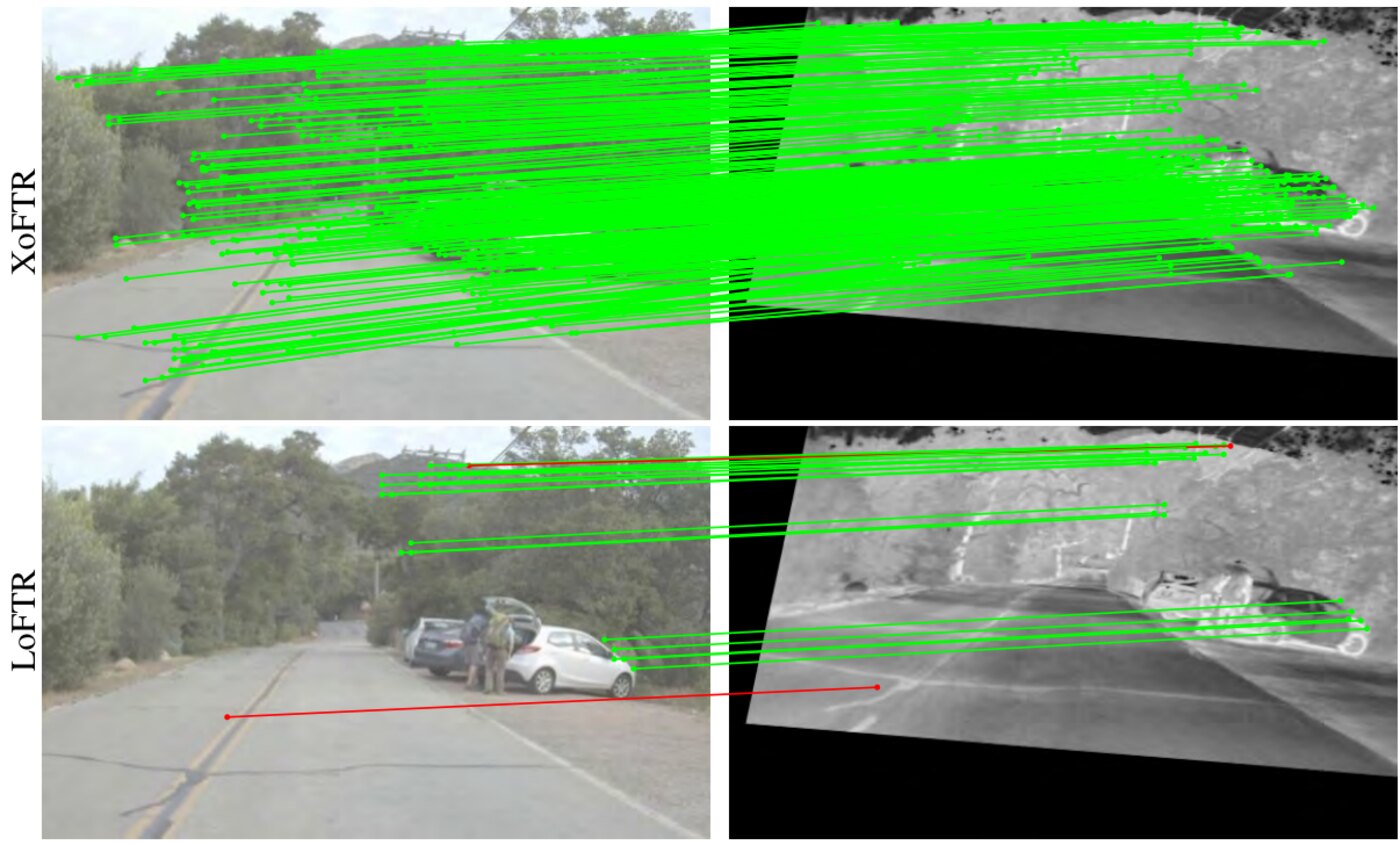
跨模态恰恰破坏这个假设。TIR 分辨率更低、视场更窄,加上视角与尺度差,一个可见光 patch 覆盖的场景区域可能落在好几个 TIR patch 的交界处;反过来,一个 TIR patch 也可能同时“像”好几个可见光 patch。此时行最大值与列最大值指向不同的配对,互近邻会把本来正确的匹配直接丢掉——而且是在最早期、召回率最脆弱的一步丢掉,后面的细匹配再强也救不回来。AdaMatcher 在大尺度/大视角可见光匹配里已经指出过这个问题[8],XoFTR 把它搬到跨模态场景。
具体做法是:相似度仍由线性投影后的内积给出,
两个方向的匹配概率为
但粗匹配集合改成两个方向的行/列最大值并集(下面简称 CLMM):
直白地说:只要 是 眼里最像的,或者 是 眼里最像的,任意一个方向成立且置信度过阈值,就保留。于是多个可见光 patch 可以同时选中同一个 TIR patch(many-to-one);反过来,一个可见光 patch 也可以作为多个 TIR patch 的列最大值,对应多个 TIR patch(one-to-many)。阈值 ,softmax 温度 。
这样做的代价是粗匹配数量变多、精度下降;论文的赌注是:粗匹配阶段应该保召回,把消歧留给 1/2 尺度的细匹配。细匹配会在每个粗匹配周围 5×5 窗口里重新计算相似度,并用 过滤低置信度,最终每条粗匹配至多产出一个细匹配。消融支持这个赌注:把粗匹配换回一对一(表 5 第 3 行),AUC@5/10/20 从 12.59/27.90/45.03 掉到 9.95/22.60/38.73,分别损失 2.64/5.30/6.30 个点。论文没有报告该变体的运行时间,只把完整模型比 LoFTR 多出的 14 ms 归因于一对多带来的更多粗匹配。
代码:粗匹配的行/列最大值并集(官方 src/xoftr/xoftr_module/coarse_matching.py,原文节选)
        # confidence thresholding
        # {(nearest neighbour for 0 to 1) U (nearest neighbour for 1 to 0)}
        mask = torch.logical_or((conf_matrix_0_to_1 > self.thr) * (conf_matrix_0_to_1 == conf_matrix_0_to_1.max(dim=2, keepdim=True)[0]),
                               (conf_matrix_1_to_0 > self.thr) * (conf_matrix_1_to_0 == conf_matrix_1_to_0.max(dim=1, keepdim=True)[0]))

        mask = rearrange(mask, 'b (h0c w0c) (h1c w1c) -> b h0c w0c h1c w1c',
                         **axes_lengths)
        if 'mask0' not in data:
            mask_border(mask, self.border_rm, False)
        else:
            mask_border_with_padding(mask, self.border_rm, False,
                                     data['mask0'], data['mask1'])
        mask = rearrange(mask, 'b h0c w0c h1c w1c -> b (h0c w0c) (h1c w1c)',
                         **axes_lengths)

        # find all valid coarse matches
        b_ids, i_ids, j_ids = mask.nonzero(as_tuple=True)

        mconf = torch.maximum(conf_matrix_0_to_1[b_ids, i_ids, j_ids], conf_matrix_1_to_0[b_ids, i_ids, j_ids])
官方实现还有两个值得对照的细节。其一,训练时分别计算两个方向的 softmax 矩阵;推理时为了省显存,复用同一个 conf_matrix_ 变量,先算行 softmax 选一遍,再算列 softmax 选一遍,最后取并集——数学上等价,但不必同时保留两个完整矩阵。其二,border_rm=2 会把粗特征图最外两圈 patch 的匹配全部屏蔽,避免把图像边界上“半个 patch”的伪匹配带进细匹配。
下面这个玩具模型把分配规则单独拎出来:A 是可见光 patch 网格,B 是热红外 patch 网格,两侧的小圆点是 patch 中心,连线是保留下来的粗匹配,红圈标出有 GT 却被丢掉的 A 点。拖动分辨率比 (TIR 相对更粗时 )和视角偏移,看看一对一与一对多分别剩下多少条正确匹配。
玩具模型说明:相似度用高斯核,softmax 温度 0.12;真实网络在 1/8 特征图上用学习到的线性投影,温度 0.1、阈值 0.3,并额外裁掉 2 格边界。这里只看分配规则本身,不模拟网络噪声。
默认参数下(、、),一对一只剩 15 条匹配、召回 62.5%;一对多保留全部 24 个 A 点,而它们只落在 15 个 B 格点上,召回 100%、没有错误匹配。把 拉回 1.0,两种规则都回到 24/24——差异完全来自尺度/视点造成的多对一。这也说明 XoFTR 的粗匹配增益不是“多加了几条线”,而是把跨模态里本来存在、却被互近邻判死的对应关系保留了下来。
2.3 细匹配:在 1/2 尺度上重开一局
粗匹配只给出 1/8 尺度上的 patch 对,位置误差可达 8 个原图像素;如果直接拿粗匹配去做 RANSAC,精度不够。LoFTR 的做法是在 1/2 尺度上对每个粗匹配周围裁剪固定窗口,用相关特征做 soft-argmax 得到亚像素。XoFTR 同样在 1/2 尺度重匹配,但不是一次 soft-argmax,而是一个小型的窗口 Transformer:
- 先把 LoFTR 前后的 1/8 特征沿通道拼接,经 1×1 卷积降到 1/4 尺度特征的通道数(196),再经 3×3 深度可分离卷积与 BN,得到融合了“相关前外观”和“相关后上下文”的 ;
- 对每条粗匹配 ,在 、、 上分别裁 、、 窗口;
- 把 1×1 窗口降维后与 3×3 窗口拼成 token,做窗口内自注意力,再在 A/B 两图之间做双向交叉注意力;然后把 3×3 输出与 5×5 窗口拼接,重复一遍自注意力+交叉注意力;
- 在 5×5 窗口的 25×25 相似度矩阵上做双 softmax,取最大值并过 。
公式上,融合与逐级传递是
5×5 窗口的匹配概率则是
自注意力用普通多头注意力,交叉注意力用双向注意力(query/key 共享投影),窗口本身只有 9 或 25 个 patch token,计算量很小;自注意力时还会把上一级的窗口(1×1 粗特征或 3×3 中间特征)作为额外的 1 或 9 个 token 拼进来,所以实际序列长度是 10 和 34。位置信息由一个两层 MLP 把绝对 2D 坐标编码进特征(隐层 512);论文用的是绝对位置偏置而不是正弦编码,消融里去掉它,AUC@20 掉 1.67。
为什么是 1/2?1/8 太粗,1/4 仍可能把两个相邻结构混在一个 cell 里;1/2 已经接近原图纹理,且只在粗匹配周围开窗,成本与图像面积无关。消融第 4 行把 FLMM+CLMM 整体换成 LoFTR 的粗到细模块(1/2 尺度、一层 5×5 窗口),AUC@20 从 45.03 掉到 26.77,损失 18.26 个点——这是所有模块替换里最重的一刀。第 6 行去掉细匹配的第二个阈值 ,掉 1.47 个点;第 7 行去掉位置偏置,掉 1.67 个点。
代码:FLMM 的窗口注意力顺序(官方 src/xoftr/xoftr_module/fine_process.py,原文节选)
        # self attention (c + m)
        feat_m_unfold, _ = self.self_attn_m(torch.cat([feat_m0_unfold, feat_m1_unfold], dim=0),
                                                         torch.cat([feat_c0, feat_c1], dim=0))
        feat_m0_unfold, feat_m1_unfold = torch.chunk(feat_m_unfold, 2, dim=0)

        # cross attention (m0 <-> m1)
        feat_m0_unfold, feat_m1_unfold = self.cross_attn_m(feat_m0_unfold, feat_m1_unfold)

        # down proj m
        feat_m_unfold = self.down_proj_m_f(torch.cat([feat_m0_unfold, feat_m1_unfold], dim=0))
        feat_m0_unfold, feat_m1_unfold = torch.chunk(feat_m_unfold, 2, dim=0)

        # self attention (m + f)
        feat_f_unfold, _ = self.self_attn_f(torch.cat([feat_f0_unfold, feat_f1_unfold], dim=0),
                                                         torch.cat([feat_m0_unfold, feat_m1_unfold], dim=0))
        feat_f0_unfold, feat_f1_unfold = torch.chunk(feat_f_unfold, 2, dim=0)

        # cross attention (f0 <-> f1)
        feat_f0_unfold, feat_f1_unfold = self.cross_attn_f(feat_f0_unfold, feat_f1_unfold)
细匹配的选择逻辑与粗匹配不同:每个 5×5 窗口只取全局最大值(denser=False 时),并要求它过 。论文把这一步解释为“在 1/2 尺度上重新评估置信度、过滤低置信度匹配”,图 2 也标注 ,即设计上每条粗匹配对应一个细匹配;实现里过不了 的会被丢掉。这带来一个实现层面的细节:如果两条粗匹配共享同一个 A 点(一对多的典型情形),它们各自独立地在自己的 5×5 窗口里取 argmax,代码并没有跨粗匹配做全局去重,最终仍可能输出重复的 A 点。论文说“细匹配+亚像素精化可以防止一个点匹配多个点”,更准确的理解是“每条粗匹配只保留一个细匹配,且低置信度的会被阈值滤掉”,而不是严格的全局互斥。这一点论文没有展开,算是我读代码时补的注脚。
代码:细匹配的阈值与最大值选择(官方 src/xoftr/xoftr_module/fine_matching.py,原文节选)
            # 1. confidence thresholding
            mask = conf_matrix_fine > self.fine_thr

            if mask.sum() == 0:
                mask[0,0,0] = 1
                conf_matrix_fine[0,0,0] = 1

            if not self.denser:
                # match only the highest confidence
                mask = mask \
                    * (conf_matrix_fine == conf_matrix_fine.amax(dim=[1,2], keepdim=True))
            else:
                # 2. mutual nearest, match all features in fine window
                mask = mask \
                    * (conf_matrix_fine == conf_matrix_fine.max(dim=2, keepdim=True)[0]) \
                    * (conf_matrix_fine == conf_matrix_fine.max(dim=1, keepdim=True)[0])

            # 3. find all valid fine matches
            # this only works when at most one `True` in each row
            mask_v, all_j_ids = mask.max(dim=2)
            b_ids, i_ids = torch.where(mask_v)
            j_ids = all_j_ids[b_ids, i_ids]
            mconf = conf_matrix_fine[b_ids, i_ids, j_ids]
2.4 亚像素精化:一次回归四个偏移
细匹配给出的仍然是 1/2 尺度上的离散格点,换算回原图后误差约 1 像素。SPRM 把匹配点上的 5×5 特征向量拼起来,过两层 MLP,再用 tanh 回归四个数:
和只回归单侧坐标的做法不同,这里同时回归 A、B 两张图的坐标,因此两端的误差可以联合优化。论文把“细匹配 + 亚像素精化”整体视为防止一点多配的机制(实际能保证多少,见 2.3 节的代码注脚)。代码里 tanh 之后又乘了 0.5:
        sub_ref = self.subpixel_mlp(torch.cat([feat_f0_unfold[b_ids, i_ids],
                                                     feat_f1_unfold[b_ids, j_ids]], dim=-1))
        sub_ref0, sub_ref1 = torch.chunk(sub_ref, 2, dim=-1)
        sub_ref0 = torch.tanh(sub_ref0) * 0.5
        sub_ref1 = torch.tanh(sub_ref1) * 0.5
这意味着偏移被限制在 ±0.5 个 1/2 尺度像素,即原图 ±1 像素以内。论文公式 (7) 没有写这个 0.5,是代码与公式的一处小差异;如果照公式理解成 ±1 个 1/2 像素(原图 ±2 像素),会高估它的修正范围。
SPRM 的监督不需要像素级 GT,而是用 GT 位姿算出的本质矩阵 ,最小化对称极线距离:
这是一个“把点拉回极线”的弱监督:不需要知道精确对应,只要匹配点满足对极几何即可。代码里还加了一道过滤:只对对称极线距离小于 的匹配计算损失,避免用已经跑偏的匹配去训练回归头。消融第 5 行去掉 SPRM,AUC@20 从 45.03 掉到 44.68,只损失 0.35——它是精度上的“最后一公里”,不是召回的主力。
代码:对称极线距离损失(官方 src/losses/xoftr_loss.py,原文照录)
    def _symmetric_epipolar_distance(self, pts0, pts1, E, K0, K1):
            """Squared symmetric epipolar distance.
            This can be seen as a biased estimation of the reprojection error.
            Args:
                pts0 (torch.Tensor): [N, 2]
                E (torch.Tensor): [3, 3]
            """
            pts0 = (pts0 - K0[:, [0, 1], [2, 2]]) / K0[:, [0, 1], [0, 1]]
            pts1 = (pts1 - K1[:, [0, 1], [2, 2]]) / K1[:, [0, 1], [0, 1]]
            pts0 = convert_points_to_homogeneous(pts0)
            pts1 = convert_points_to_homogeneous(pts1)

            Ep0 = (pts0[:,None,:] @ E.transpose(-2,-1)).squeeze(1)  # [N, 3]
            p1Ep0 = torch.sum(pts1 * Ep0, -1)  # [N,]
            Etp1 = (pts1[:,None,:] @ E).squeeze(1)  # [N, 3]

            d = p1Ep0**2 * (1.0 / (Ep0[:, 0]**2 + Ep0[:, 1]**2 + 1e-9) + 1.0 / (Etp1[:, 0]**2 + Etp1[:, 1]**2 + 1e-9))  # N
            return d

    def compute_sub_pixel_loss(self, data):
        """ symmetric epipolar distance loss.
        Args:
        data (dict): {
            m_bids (torch.Tensor): (N)
            T_0to1 (torch.Tensor): (B, 4, 4)
            mkpts0_f_train (torch.Tensor): (N, 2)
            mkpts1_f_train (torch.Tensor): (N, 2)
            }
        """

        Tx = numeric.cross_product_matrix(data['T_0to1'][:, :3, 3])
        E_mat = Tx @ data['T_0to1'][:, :3, :3]

        m_bids = data['m_bids']
        pts0 = data['mkpts0_f_train']
        pts1 = data['mkpts1_f_train']

        sym_dist = self._symmetric_epipolar_distance(pts0, pts1, E_mat[m_bids], data['K0'][m_bids], data['K1'][m_bids])
        # filter matches with high epipolar error (only train approximately correct fine-level matches)
        loss = sym_dist[sym_dist<1e-4]
        if len(loss) == 0:
            return torch.zeros(1, device=loss.device, requires_grad=False)[0]
        return loss.mean()
2.5 两阶段训练(一):MIM 预训练
跨模态匹配最缺的是“同一场景、不同模态、带对应关系”的数据。可见光有 MegaDepth 这种百万级 SfM 数据集[9],热红外没有对应的城市场景大规模标注。XoFTR 的第一阶段用 KAIST 多光谱行人数据集[10]:9.5 万对车载可见—热红外图像,原始分辨率 640×512,取顶部 640×480 区域(避开下半部分路面),不做匹配标签,只做掩码图像重建。
做法沿用 PMatch 的配对 MIM[11],并吸收 MAE、SimMIM、ConvNeXt V2 的掩码策略[12, 13, 14]:论文把 MIM 输入设为 640×410,随机挖掉 50% 的 64×64 patch,把二值掩码直接乘在输入图上(防止卷积看到被遮区域),过 CNN 后在 1/8、1/4、1/2 三层用可学习的 mask token 替换被遮位置;LoFTR 粗注意力之后,把 FLMM 当作解码器,对每个被遮的粗 token 取 5×5 窗口,经一个线性层映射成 10×10 像素块,用 MSE 监督两幅图的重建。因为 KAIST 的可见—热红外对已经配准、视差很小,两幅图使用相同位置的窗口,交叉注意力可以直接从另一个模态借上下文。
不过官方代码里 PRETRAIN_IMG_RESIZE=640、PRETRAIN_IMG_PAD=True,实际做法是长边缩到 640 后补成正方形(KAIST 的 640×512 会补成 640×640);论文的 640×410 与代码不完全一致,复现时以配置为准。
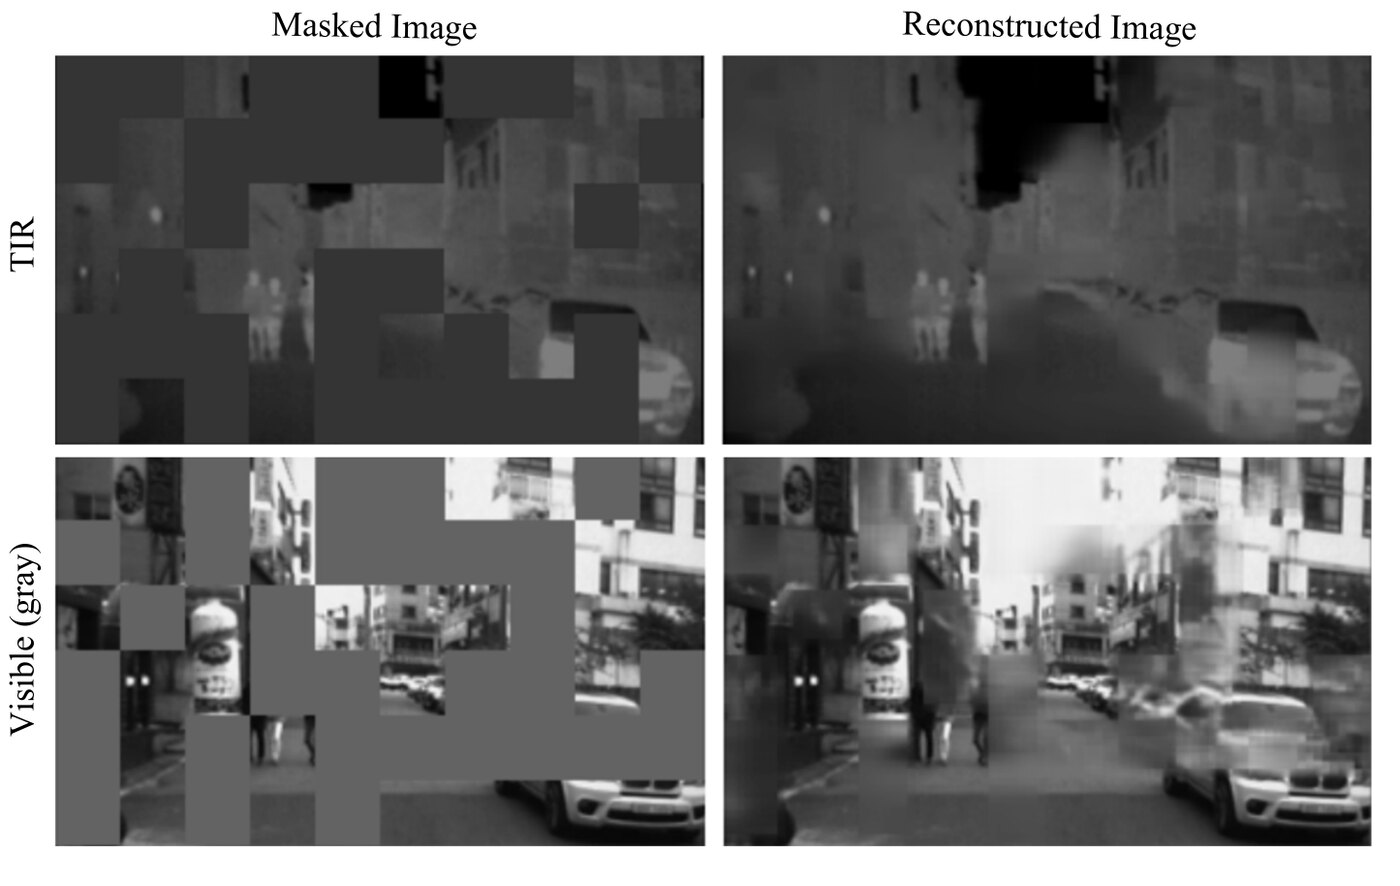
这套预训练要的不是“画出热红外图”,而是让骨干、粗注意力和 FLMM 解码器在真实跨模态对上先学会“哪里是边缘、哪里是同一栋楼”,为第二阶段提供一个对强度变化不敏感的初始化。成本是 9 个 epoch、2 张 A5000 上 24 小时。效果见消融第 1 行:不做预训练、直接微调,AUC@5/10/20 为 11.81/26.51/42.93;完整模型是 12.59/27.90/45.03,预训练贡献 +0.78/+1.39/+2.10。
这个增益不算大,作者也没有回避:它比伪热红外增强小了整整一个量级。我的理解是,9 个 epoch 的 KAIST 预训练只能覆盖车载行人场景的有限外观,而第二阶段的伪热红外增强本身就在强行制造强度不变性,两者功能有重叠;如果预训练数据换成多城市、多传感器、多天气的可见—TIR 对,MIM 的潜力应该还没吃完。
代码:MIM 的逐层掩码与 mask token 替换(官方 src/xoftr/xoftr_pretrain.py,原文照录)
    def mask_layer(self, feat, mae_mask, mae_mask_scale, mask=None, mask_scale=None, mask_token=None):
        """ Mask the feature map and replace with trainable inpu tokens if available
        Args:
            feat (torch.Tensor): [N, C, H, W]
            mae_mask (torch.Tensor): (N, L) mask for masked image modeling
            mae_mask_scale (int): the scale of layer to mae mask
            mask (torch.Generator): mask for padded input image
            mask_scale (int): the scale of layer to mask (mask is created on course scale)
            mask_token (torch.Tensor): [1, C, 1, 1] learnable mae mask token
        Returns:
            feat (torch.Tensor): [N, C, H, W]
        """
        mae_mask = self.upsample_mae_mask(mae_mask, mae_mask_scale)
        mae_mask = mae_mask.unsqueeze(1).type_as(feat)
        if mask is not None:
            mask =  self.upsample_mask(mask, mask_scale)
            mask = mask.unsqueeze(1).type_as(feat)
            mae_mask = mask * mae_mask
        feat = feat * (1. - mae_mask)
        if mask_token is not None:
            mask_token = mask_token.repeat(feat.shape[0], 1, feat.shape[2], feat.shape[3])
            feat += mask_token * mae_mask
        return feat
代码:MIM 的 MSE 重建损失(官方 src/losses/xoftr_loss_pretrain.py,原文照录)
import torch
import torch.nn as nn
import torch.nn.functional as F

class XoFTRLossPretrain(nn.Module):
    def __init__(self, config):
        super().__init__()
        self.config = config
        self.W_f = config["xoftr"]['fine_window_size']

    def forward(self, data):
        """
        Update:
            data (dict): update{
                'loss': [1] the reduced loss across a batch,
                'loss_scalars' (dict): loss scalars for tensorboard_record
                }
        """
        loss_scalars = {}

        pred0, pred1 = data["pred0"], data["pred1"]
        target0, target1 = data["target0"], data["target1"]
        target0 = target0[[data['b_ids'], data['i_ids']]]
        target1 = target1[[data['b_ids'], data['j_ids']]]

        # get correct indices
        pred0 = pred0[data["ids_image0"]]
        pred1 = pred1[data["ids_image1"]]
        target0 = target0[data["ids_image0"]]
        target1 = target1[data["ids_image1"]]

        loss0 = (pred0 - target0)**2
        loss1 = (pred1 - target1)**2
        loss = loss0.mean() + loss1.mean()

        loss_scalars.update({'loss': loss.clone().detach().cpu()})
        data.update({"loss": loss, "loss_scalars": loss_scalars})
2.6 两阶段训练(二):伪热红外微调
第二阶段要解决的是“没有城市场景可见—TIR 训练对”。作者没有去收集更多数据,而是把 MegaDepth 的可见光图在线转换成伪热红外图,让网络在微调时不断见到“同一场景、不同强度映射”的样本。转换分四步:
- 随机 HSV 抖动(色相 ±90、饱和度 ±30、明度 ±30,概率 0.9)与随机模糊(核 2–4,概率 0.7);
- 转灰度,归一化到 (代码里等价地先算 再做余弦,公式里不再重复减);
- 余弦变换: 其中 、、, 服从正态分布;
- 最小-最大归一化(论文归一到 ,代码乘 255 存成 uint8),再转回三通道灰度图。
这里有两处论文与代码的小出入:论文写的是 5×5 高斯模糊,代码用的是 albumentations 的 A.Blur,核大小 2–4、概率 0.7;论文公式把结果归一到 ,代码最后乘 255 存成 uint8(只差一个缩放)。
在微调时,增强随机作用在图像对中的一张(要么可见光那张保持原样、另一张变伪热红外,要么反过来),于是网络见到的既有“真实可见光 vs 伪热红外”,也有“伪热红外 vs 真实可见光”。
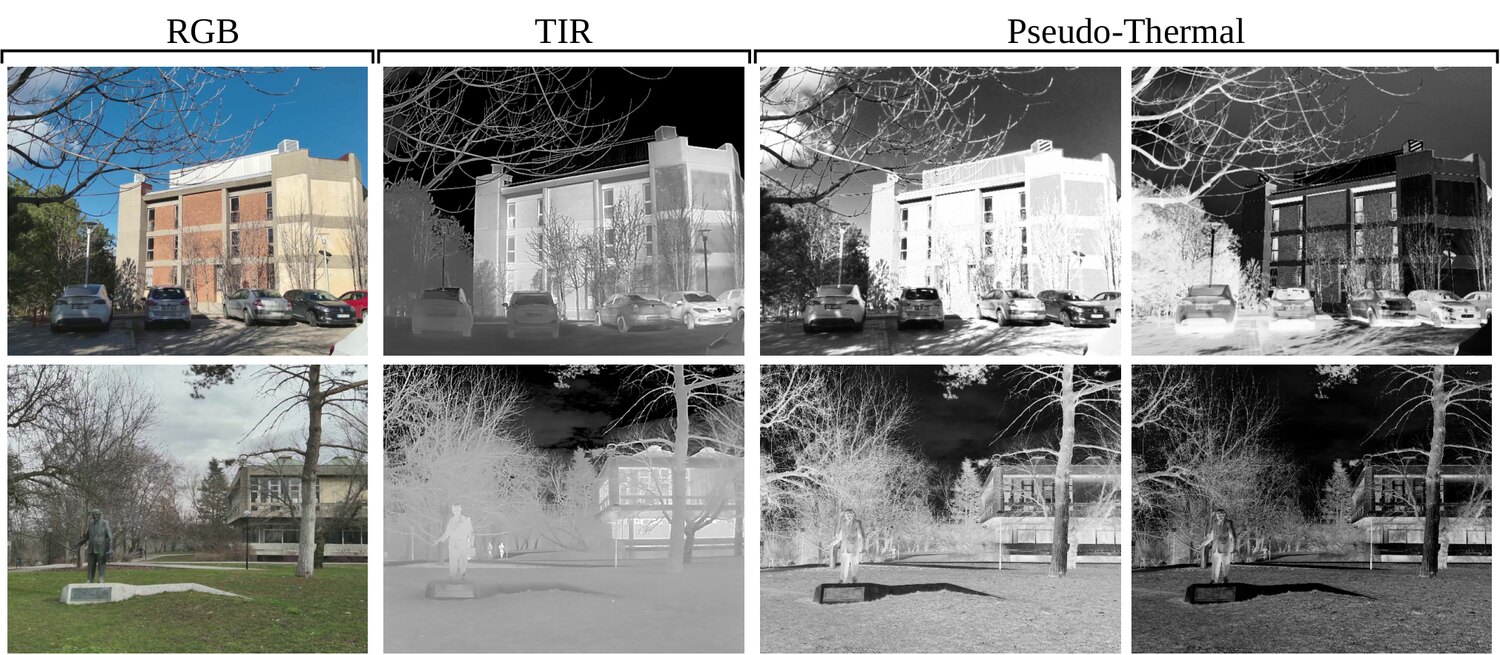
为什么用余弦而不是 GAN?论文的理由是可靠性:GAN 在测试分布偏离训练数据时会产生伪影和像素级不准确,而匹配需要的正是像素级可靠的结构;余弦变换虽然“不像真正的热红外”,但它是一个可控、无幻觉的非线性强度重映射,足以逼迫网络学会对强度变化不变。消融第 2 行把增强关掉,AUC@5/10/20 从 12.59/27.90/45.03 暴跌到 2.92/7.43/14.94,损失 9.67/20.47/30.09——这是全文最大的单项差距,比预训练、一对多分配、FLMM 都重要。换句话说,跨模态匹配的第一性问题是数据里的模态多样性,不是网络结构。
代码:伪热红外的 HSV、灰度与余弦变换(官方 src/utils/augment.py,原文节选)
    def augment_pseudo_thermal(self, image):

        # HSV augmentation
        image = self.hsv(image=image)["image"]

        # Random blur
        image = self.blur(image=image)["image"]

        # Convert the image to the gray scale
        image = cv2.cvtColor(image, cv2.COLOR_RGB2GRAY)

        # Normalize the image between (-0.5, 0.5)
        image = image / 255 - 0.5 # 8 bit color

        # Random phase and freq for the cosine transform
        phase = np.pi / 2 + np.random.randn(1) * self.theta_r
        w = self.w_0 + np.abs(np.random.randn(1)) *  self.w_r

        # Cosine transform
        image = np.cos(image * w + phase)

        # Min-max normalization for the transformed image
        image = (image - image.min()) / (image.max() - image.min()) * 255

        # 3 channel gray
        image = cv2.cvtColor(image.astype(np.uint8), cv2.COLOR_GRAY2RGB)

        return image
下面的部件把两件事放在一起:上半部分切换表 5 的三个训练配置,下半部分拧余弦变换的频率与相位。先看默认状态——完整两阶段(③)是 12.59/27.90/45.03;切到 ②(有 MIM、无伪热红外)会看到 AUC@20 只剩 14.94,而切到 ①(无 MIM、有伪热红外)是 42.93。也就是说,伪热红外增强贡献了约 30 个点,MIM 贡献约 2 个点。
说明:AUC 数字取自论文表 5,训练配置与表中三行一一对应;余弦曲线用与论文公式 (8) 相同的参数化,但输入是 0 到 1 的灰度条,不是真实图像,曲线形状只用于说明强度重映射。
2.7 损失函数
总损失是三项加权:
- 粗匹配损失 :对 、 分别做 focal loss,GT 是 1/8 网格用深度和位姿投影得到的匹配矩阵。与 LoFTR 不同,构造 GT 时不加互近邻约束,允许 many-to-one / one-to-many,和粗匹配的分配规则一致。
- 细匹配损失 :对每条粗匹配的 25×25 窗口做 focal loss,GT 在 1/2 尺度上构造,并加互近邻约束,只允许一对一。也就是说,粗阶段允许模糊,细阶段要求明确。
- 亚像素损失 :式 (11) 的对称极线距离,权重 。从代码只保留 的匹配看,归一化坐标下的平方距离本来就在 量级,不放大梯度会被前两项淹没——这是我的理解,论文没有解释这个权重的来历。代码里这道过滤本身也等于先筛掉明显错误的粗匹配,再回归。
focal loss 的超参是 、,正负样本权重各为 1。两种损失的正负样本处理并不一样:粗匹配损失只对正样本计算 focal 项(pos_mask),细匹配损失则对正、负样本都计算;读代码时这一点比公式更容易被忽略。
代码:三项损失的权重与调用顺序(官方 src/losses/xoftr_loss.py,原文节选)
        # 0. compute element-wise loss weight
        c_weight = self.compute_c_weight(data)

        # 1. coarse-level loss
        loss_c = self.compute_coarse_loss(data, weight=c_weight)
        loss_c *= self.loss_config['coarse_weight']
        loss = loss_c
        loss_scalars.update({"loss_c": loss_c.clone().detach().cpu()})

        # 2. fine-level matching loss for windows
        loss_f_match = self.compute_fine_matching_loss(data)
        loss_f_match *= self.loss_config['fine_weight']
        loss = loss + loss_f_match
        loss_scalars.update({"loss_f":  loss_f_match.clone().detach().cpu()})

        # 3. sub-pixel refinement loss
        loss_sub = self.compute_sub_pixel_loss(data)
        loss_sub *= self.loss_config['sub_weight']
        loss = loss + loss_sub
        loss_scalars.update({"loss_sub":  loss_sub.clone().detach().cpu()})
2.8 METU-VisTIR:一个带位姿的城市场景可见—TIR 基准
为了评估跨模态匹配,作者用 DJI Mavic 3 Thermal 无人机采集了 6 个场景的可见—TIR 序列。两颗相机物理位置接近,但参数差异不小:
| 项目 | 热红外相机 | 可见光相机 |
|---|---|---|
| 分辨率 | 640×512 | 3840×2160 |
| 视场角 | 61° | 84° |
| 波段 | 8–14 µm(LWIR) | RGB |
6 个场景中 4 个同时拍了阴天与晴天,2 个只有阴天。GT 位姿用 COLMAP[15] + HLOC[16] 在可见光图像上做 SfM 恢复;由于相机是自动对焦,作者用同模态 COLMAP 得到两路相机的内参,再用标定板估计畸变。自动对焦会带来轻微的 GT 参数误差,论文明确承认这一点。最终构造两个测试集:阴—阴 1382 对,阴—晴 1208 对,共 2590 对。
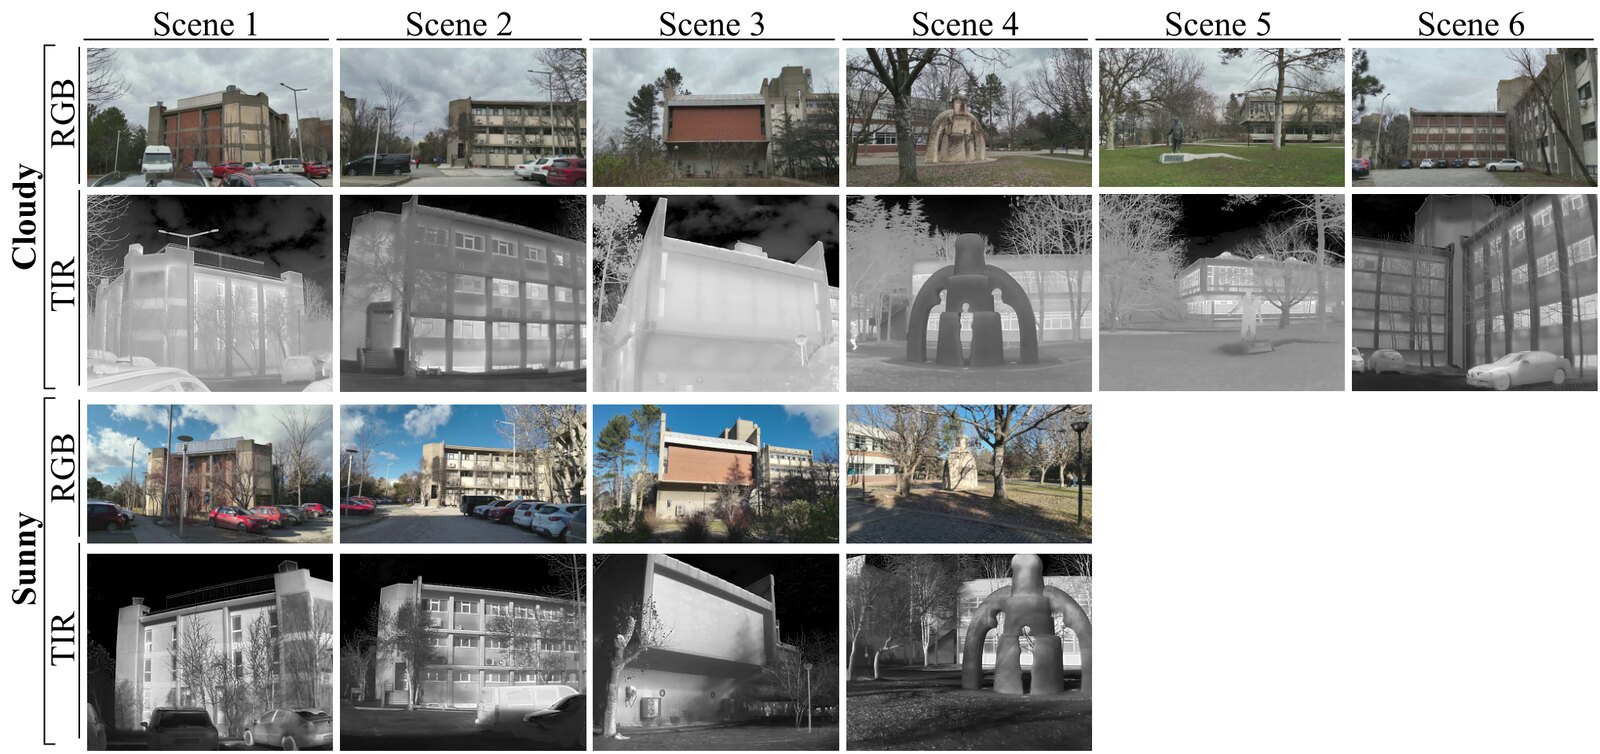
这是论文最有价值的部分之一:在此之前,可见—TIR 匹配缺少一个公开的、带 GT 位姿的城市场景多视图基准,大家只能在单应配准或自己的私有数据上比较。它的局限也同样明显:6 个场景、一台无人机、一种 TIR 波段,2590 对测试图像;没有夜间、雨雾、雪天,也没有跨季节。论文说 “comprehensive”,但按数据规模看,它更像一个“有代表性的小型基准”,而不是 MegaDepth 级别的训练/评测资源。
三、实验结果
3.1 相对位姿估计:METU-VisTIR
评测协议沿用 LoFTR:把图像长边缩到 640,用匹配点 + RANSAC(阈值 1.5 像素)估计本质矩阵,计算旋转与平移的最大角误差,报告 AUC@5°/10°/20°。两个测试集分别评测;官方评测脚本对每个场景单独算 AUC,再在阴—阴、阴—晴两组内对场景取平均。
结果非常悬殊。阴—阴集上,XoFTR 的 AUC@5/10/20 是 22.03/39.03/55.06;第二名 DKM 只有 5.79/11.47/19.17,LoFTR 是 2.63/6.55/14.11,ASpanFormer 1.82/4.73/10.60。阴—晴集上,XoFTR 是 12.59/27.90/45.03,DKM 7.26/14.63/23.60,LoFTR 2.77/7.71/16.36。也就是说,在最宽松的 20° 阈值下,XoFTR 比 DKM 高 35.89(阴—阴)和 21.43(阴—晴)个点,比 LoFTR 高 40.95 和 28.67 个点。
几个值得注意的现象:
- 检测器类方法整体不行。SuperPoint+SuperGlue 在阴—阴只有 3.90/8.75/16.35,D2-Net+NN 2.16/6.01/12.80,ReDFeat 2.36/5.45/11.26。跨模态下关键点本身就不重复,检测器+描述子的范式在第一步就输了;DKM、LoFTR 这类无检测器方法靠稠密特征和注意力,至少能保住一部分召回。
- “用真实 TIR 训练”不等于“跨域可用”。LoFTR-MTV 是在真实航空可见—TIR 对上训练的 LoFTR,按理说模态对得上,但在 METU 上只有 1.54/3.89/8.80(阴—阴),比原始 LoFTR 还低。作者的解释是训练域/场景不匹配;这也说明跨模态匹配的瓶颈不只是“有没有 TIR 数据”,还有数据分布与训练配方。
- 天气一变,性能确实掉。同一个模型从阴—阴到阴—晴,AUC@20 从 55.06 掉到 45.03,@5 从 22.03 掉到 12.59。论文把原因归为阳光带来的阴影、反光与温度变化;这也是它没有专门做去光照归一化的结果。
- DKM 是唯一像样的基线。它的稠密匹配在阴—阴能到 19.17,阴—晴也只有 23.60,仍不到 XoFTR 的一半;且从定性图看匹配数量巨大、精度不高(见 3.4)。XoFTR 的优势是“数量与精度同时高”。
下面这个表格浏览器把论文表 2、表 3、表 4 放在一起,按钮切换数据集与阈值。默认是阴—晴、AUC@20:XoFTR 45.03,第二名 DKM 23.60。
说明:数值逐项取自论文表 2、表 3、表 4。表 4 的三列表头写作 @5°/@10°/@20°,但同节正文先说角点误差是 3、5、10 像素,结果段又讨论 10 和 20 像素阈值,三处口径不一致;部件里的 5/10/20 只是沿用表头数字,不对应严格的像素或角度含义。
3.2 单应估计:跨出自家数据集还能打吗
为了证明不是只在自己的数据集上有效,作者在公开的 LGHD LWIR/RGB(44 对建筑)和 FusionDN RoadScene(221 对道路)上合并构造了 1325 个单应测试对:每对原图随机生成 5 个单应,包含 0.8–1.2 的缩放、±0.15 的透视、±15° 的旋转。评测指标是角点误差累积曲线的 AUC。
XoFTR 在 @10 和 @20 两列上大幅领先:23.37 和 48.15;@10 的第二名是 ASpanFormer(18.87),@20 的第二名是 SP+SuperGlue(37.95);DKM 只有 9.55 和 25.87。但在最严格的 @5 列上,XoFTR 的 8.19 输给 ASpanFormer 的 9.50(差 1.31)。论文对此的表述是 “surpasses … for 10 and 20 pixel error thresholds”,没有掩盖 @5 的失利。这个结果其实很符合直觉:XoFTR 的粗匹配偏召回、细匹配再过滤,误差分布尾部更薄但头部不一定最尖;ASpanFormer 的自适应注意力跨度在干净、近单应的场景里更容易给出极高精度的匹配。
3.3 消融与运行时间
论文在 METU-VisTIR 阴—晴集上做了 7 组消融,全部以相对位姿 AUC 衡量:
| 变体 | @5° | @10° | @20° | 与完整模型的差(@20°) |
|---|---|---|---|---|
| (1) 无 MIM 预训练 | 11.81 | 26.51 | 42.93 | −2.10 |
| (2) 无伪热红外增强 | 2.92 | 7.43 | 14.94 | −30.09 |
| (3) 粗匹配只用一对一 | 9.95 | 22.60 | 38.73 | −6.30 |
| (4) 换成 LoFTR 的粗到细模块 | 6.31 | 14.46 | 26.77 | −18.26 |
| (5) 无 SPRM | 12.31 | 27.39 | 44.68 | −0.35 |
| (6) 无细匹配第二阈值 θ_f | 11.58 | 26.08 | 43.56 | −1.47 |
| (7) FLMM 无绝对位置偏置 | 12.23 | 26.99 | 43.36 | −1.67 |
| 完整 XoFTR | 12.59 | 27.90 | 45.03 | — |
排序很清楚:伪热红外增强(−30.09)> 细匹配管线(−18.26)> 一对一分配(−6.30)> MIM(−2.10)> 位置偏置(−1.67)> 第二阈值(−1.47)> SPRM(−0.35)。这几乎是全文的论点排序:跨模态的第一瓶颈是数据里的模态多样性,第二是把粗匹配可靠地推到高分辨率,第三才是匹配分配规则;MIM 和 SPRM 是锦上添花,不是雪中送炭。
运行时间方面,A5000 上 640×512 的单对推理,XoFTR 116 ms,LoFTR 102 ms,多出 14 ms(约 13.7%)。作者归因于一对多分配带来的更多粗匹配——每条粗匹配都要走一遍 FLMM 窗口。论文没有报告参数量、FLOPs 或显存占用;考虑到它复用了 LoFTR 的骨干与粗注意力,参数量应该接近 LoFTR,主要增量在 FLMM 的窗口注意力和掩码预训练头(推理时不使用)。
3.4 定性结果:数量、精度与失败模式
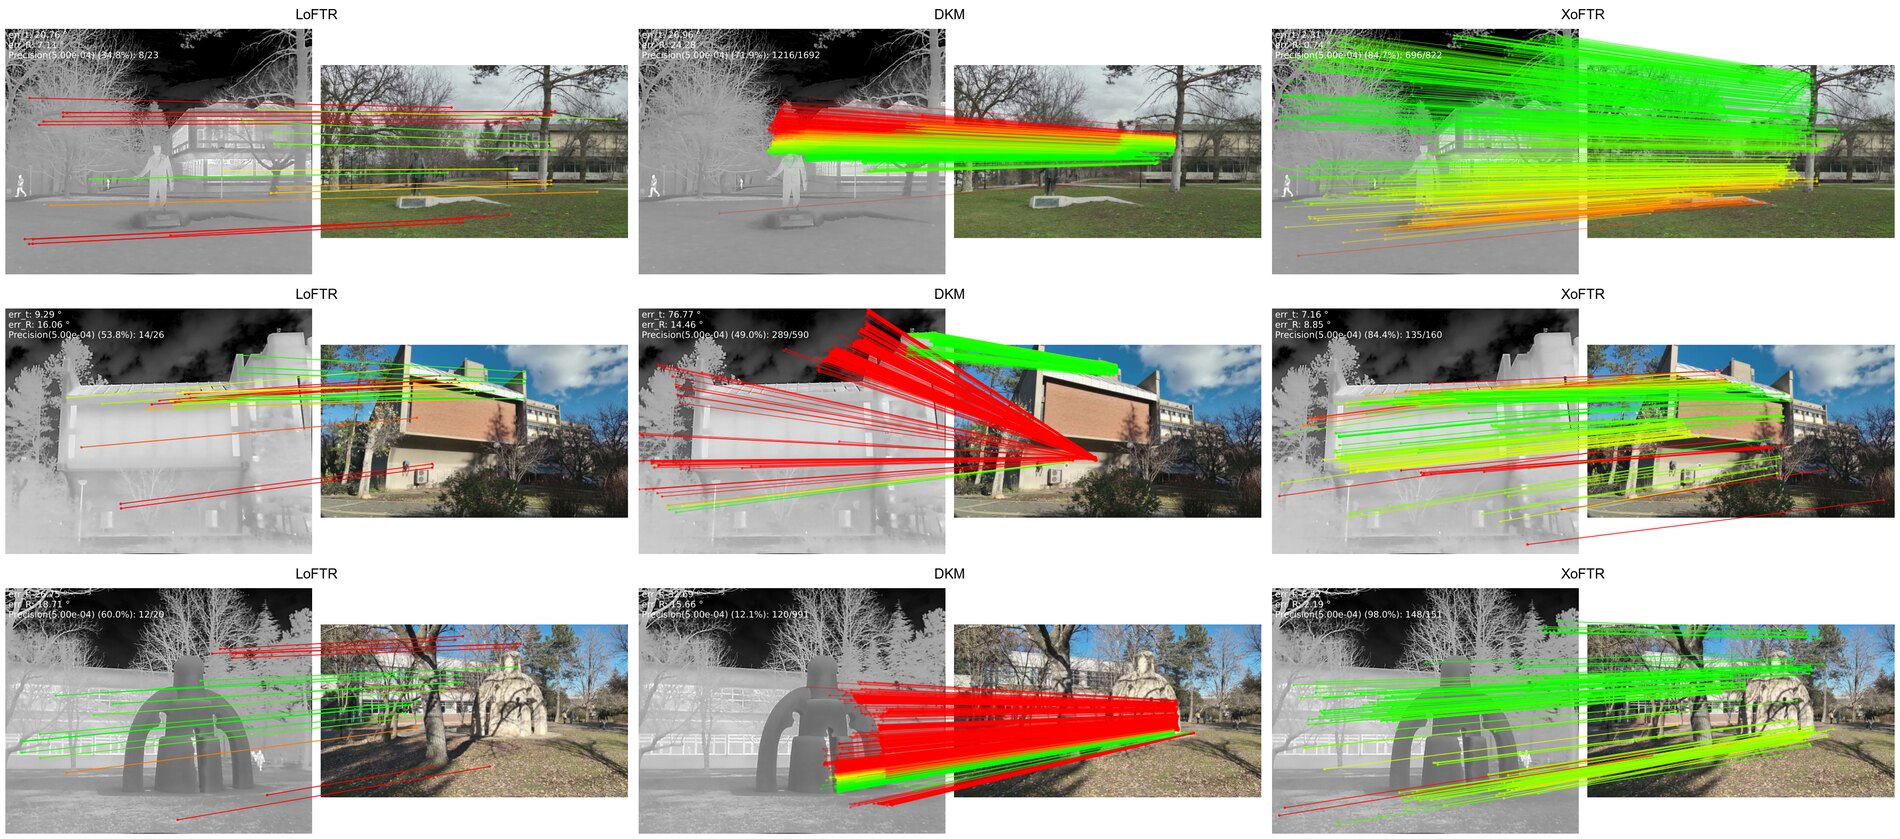
这张图把三种失败模式摆得很清楚:
- LoFTR 是“太少”:每对图像只有十几到二十几条匹配,RANSAC 勉强能解,但一旦遇到大尺度或低纹理就崩;第一行它的平移误差是 20.76°,第三行 20.75°。
- DKM 是“多而杂”:第一行给出 1692 条匹配,精度 71.9%,看起来还行;第三行 991 条里只有 12.1% 是极线内点,大量红线横穿图像,RANSAC 被淹没。稠密匹配的召回很高,但跨模态下的误匹配也成片出现。
- XoFTR 是“多而准”:696/822(84.7%)、135/160(84.4%)、148/151(98.0%),三条场景的平移误差分别只有 2.31°、7.16°、6.52°。它的匹配集中在建筑立面、树枝、车辆轮廓这些跨模态仍然稳定的结构上,而不是热红外里均匀的墙面。
失败模式也不是没有。第三行 XoFTR 的 148/151 精度极高,但匹配几乎全集中在雕塑和右侧建筑,左侧草地与道路几乎没有匹配——热红外里这些区域太平坦,特征本身就弱。这类“局部极好、覆盖不全”的行为,对需要全局分布匹配的 SfM 来说可能比精度更麻烦。
四、局限性
4.1 论文自己承认的
论文没有单独的 Limitations 章节,但正文里明确提到了几处:
- 运行时间增加:116 ms vs LoFTR 102 ms,原因是一对多粗匹配带来更多细匹配计算(5.4 节)。
- 天气变化导致性能下降:阴—晴比阴—阴低约 10 个 AUC@20 点,作者归因于阳光、阴影与温度变化(5.2 节)。
- GT 位姿不完美:相机自动对焦,内参由同模态 COLMAP + 标定板估计,可能存在轻微误差(4 节)。
- 伪热红外“没有真正的热特性”:论文在 2 节明确说余弦变换简单、计算轻,但产生的图像缺乏真实热红外特征;选它是因为 GAN 会产生伪影、像素不准确。
- 数据集规模:论文称 METU-VisTIR 为 “comprehensive”,但没有讨论 6 个场景是否足够代表城市场景。
4.2 我自己再补几条
- 数据覆盖比论文标题听起来窄:只有 6 个场景,一台 DJI Mavic 3 Thermal,一种 LWIR 波段(8–14 µm),只有阴/晴两种天气;TIR 最擅长的夜间、雨、雾、雪完全没有测试。所谓“鲁棒于恶劣天气”是动机,不是这篇论文的实验结论。
- 训练/测试域跨度很大,但没有拆解:预训练在 KAIST(车载、行人、640×512 取顶部 640×480),微调在 MegaDepth(可见光、地面视角、伪 TIR),测试在 METU(无人机、俯视、真实 TIR)。到底是哪个源域贡献最大、KAIST 换成别的 TIR 数据会怎样,论文没有做迁移消融。
- MIM 的增益可能被训练预算混淆:无预训练变体(表 5 第 1 行)是直接微调,没有额外的预训练算力;完整模型多了 9 个 epoch × 2 张 A5000。要证明“MIM 本身有用”,更公平的对照是给无预训练变体同样的算力或更长的微调。+2.10 个点的差距不算大,也没有多 seed 方差。
- “防止一对多”在代码里不是全局保证:如 2.3 节所说,细匹配对每条粗匹配独立取窗口 argmax,没有跨粗匹配去重;共享同一 A 点的两条粗匹配仍可能输出重复点。论文的表述容易被读成严格互斥,实际是“每条粗匹配只产出一个细匹配 + 阈值过滤”。
- SPRM 的修正范围被代码悄悄限死:tanh 后乘 0.5,最多修正 ±1 原图像素;论文公式 (7) 没写这个 0.5。对于 1/8 粗匹配、1/2 细匹配的误差量级,±1 像素够用,但如果输入分辨率更高或粗匹配更差,这个上限会变成瓶颈。
- 速度与部署:116 ms/对(A5000,640×512)约 8.6 FPS,离无人机实时视频(30 FPS)还有距离;论文没有 ONNX/TensorRT、半精度、剪枝或 LightGlue 式早退实验。实际系统里可能要配合关键帧策略,而不是每帧都匹配。
- 没有下游任务:只做了两视图相对位姿和单应,没有接入 HLOC 做视觉定位,也没有做 SfM/三维重建。匹配指标好不等于重建好,尤其在匹配分布不均匀(见 3.4 第三行)时。
- 基线选择有时代局限:Shape-Former、MIVI 因无公开代码/难以复现未被比较;MINIMA(CVPR 2025)用 4.8 亿对合成多模态数据把跨模态匹配又推进了一大步[17]。这不是作者的错,但读者应知道 2024 年的“SOTA”在 2025 年已经不是终点。
- 单应 @5 不是第一:8.19 vs ASpanFormer 9.50;论文原文也只声称在 10 和 20 像素阈值上领先,并没有说 @5 也第一。
- 表 4 的单位有笔误:表头写 @5°/@10°/@20°,正文却说是 3/5/10 像素、并讨论 “10 and 20 pixel error thresholds”。按正文理解是像素;这类小不一致不影响结论,但复现时要注意。
五、结论与展望
XoFTR 的故事线其实很朴素:LoFTR 的注意力本身已经足够通用,跨模态匹配的瓶颈不在网络结构,而在“分配假设”和“训练数据”。作者没有发明新的注意力,而是做了三件便宜但有效的事:
- 把粗匹配的互近邻一对一换成行/列最大值并集,承认跨模态下多对一是常态,把消歧留给高分辨率细匹配;
- 用真实可见—TIR 对做 MIM,让网络在无匹配标签的情况下先学会跨光谱稳定的结构;
- 用余弦变换把可见光图变成伪热红外,以近乎零成本制造模态多样性,补上城市场景没有 TIR 训练数据的缺口。
消融给出的排序也值得记住:伪热红外增强(−30.09 @20)远大于细匹配管线(−18.26)和一对多分配(−6.30),MIM 只有 −2.10。对做跨模态匹配的实践者,这意味着先想办法把数据里的模态变化造出来,再谈网络设计;一个便宜的强度重映射,可能比一个精巧的模块更值钱。
给要用它的人几条建议:
- 直接推理:用官方 640 权重 +
DataIOWrapper,输入灰度图、长边 640、保持长宽能被 8 整除;模型内部会做逐图标准化,不要再手工减均值。 - 阈值:默认 、 适合 RANSAC;如果下游需要更多匹配(例如低纹理场景),可以把
denser=True打开,让每个细窗口输出多条互相近邻匹配,但精度会下降。 - 换传感器:如果你的 TIR 不是 8–14 µm、或分辨率/视场与 DJI 差别很大,先在自己的数据上验证;必要时用本文的伪热红外增强在自己的可见光数据上微调,这比重新设计网络更划算。
- 做 SfM/定位:接到 HLOC 里时注意匹配分布,XoFTR 可能在某些区域没有匹配;可以用多尺度或关键帧补充,不要指望单对图像覆盖全图。
- 别的模态:NIR、SAR、深度、事件相机与可见光的差异不再是“亮度反转”,余弦变换的假设不成立;这时 MINIMA 那种“用生成模型合成多种伪模态 + 大规模数据”的路线更合适[17],或者针对具体模态设计预训练任务。
未来可以做的方向:更大规模、多城市、多传感器、含夜间/雨雾的可见—TIR 数据集;把 MIM 预训练扩展到更多模态与更长时间;用蒸馏/早退/量化把 116 ms 压到实时;把匹配器接入 SfM/定位管线做端到端评估;以及研究“匹配分布均匀性”这类目前被 AUC 掩盖的指标。
六、上手
官方仓库提供了完整推理、评测与训练代码(Apache-2.0),权重有 640 和 840 两个分辨率版本,METU-VisTIR 数据集单独发布(CC BY-NC-SA 4.0,仅限非商业)。环境是 Python 3.8 + PyTorch 2.0.1 + CUDA 11.8。
安装(conda 环境,版本要对上)
conda env create -f environment.yaml
conda activate xoftr
权重与数据需要从 README 里的 Google Drive 链接手动下载:
- 权重:
weights_xoftr_640.ckpt/weights_xoftr_840.ckpt; - 数据集:METU-VisTIR,解压后把
METU_VisTIR软链到data/下; - 预训练权重(可选):
pretrain_weights/epoch=8-.ckpt,微调脚本默认从这里初始化。
最小推理示例(基于 notebooks/xoftr_demo.ipynb,这里把绘图换成一次 MAGSAC 过滤):
最小推理:加载权重、读两张图、输出匹配
import cv2
import torch
import numpy as np

from src.xoftr import XoFTR
from src.config.default import get_cfg_defaults
from src.utils.misc import lower_config
from src.utils.data_io import DataIOWrapper

config = get_cfg_defaults(inference=True)
config = lower_config(config)
config['xoftr']['match_coarse']['thr'] = 0.3   # θc
config['xoftr']['fine']['thr'] = 0.1           # θf
config['xoftr']['fine']['denser'] = False
config['test']['img0_resize'] = 640
config['test']['img1_resize'] = 640

matcher = XoFTR(config=config["xoftr"])
matcher = DataIOWrapper(matcher, config=config["test"], ckpt="weights/weights_xoftr_640.ckpt")

out = matcher.from_paths(
    "assets/METU_VisTIR_samples/cloudy/scene_7/visible/images/IM_04525.jpg",
    "assets/METU_VisTIR_samples/cloudy/scene_7/thermal/images/IM_01139.jpg",
    read_color=True,
)
mkpts0, mkpts1, mconf = out['mkpts0'], out['mkpts1'], out['mconf']

# 用 MAGSAC 估计基础矩阵并过滤
F, inlier_mask = cv2.findFundamentalMat(
    mkpts0, mkpts1, cv2.USAC_MAGSAC,
    ransacReprojThreshold=1, maxIters=10000, confidence=0.9999,
)
inlier_mask = inlier_mask.ravel() > 0
mkpts0, mkpts1, mconf = mkpts0[inlier_mask], mkpts1[inlier_mask], mconf[inlier_mask]
print(len(mkpts0), "inliers")
如果不想用 DataIOWrapper,也可以直接喂张量:图像转灰度、除以 255、尺寸能被 8 整除,调用 matcher(batch) 后从 batch['mkpts0_f']、batch['mkpts1_f']、batch['mconf_f'] 取结果。注意模型内部会做逐图标准化,输入保持原始灰度即可。
评测相对位姿:
在 METU-VisTIR 上复现表 2 / 表 3
python test_relative_pose.py xoftr --ckpt weights/weights_xoftr_640.ckpt
# 保存匹配可视化
python test_relative_pose.py xoftr --ckpt weights/weights_xoftr_640.ckpt --save_figs
脚本默认 --match_threshold 0.3、--fine_threshold 0.1、--ransac_thres 1.5,结果写到 results_relative_pose/。数据集目录结构要求 index/scene_info_test/、index/val_test_list/test_list.txt 和 cloudy/、sunny/,下载包里已经带好。
训练分两段,官方给了复现脚本,但作者明确说换 GPU/ batch size 后不保证完全复现:
两阶段训练:MIM 预训练 + MegaDepth 微调
# 阶段一:KAIST 上 MIM 预训练(2×A5000,约 24 小时)
scripts/reproduce_train/pretrain.sh

# 阶段二:MegaDepth + 伪热红外微调(8×A100,约 24 小时)
scripts/reproduce_train/visible_thermal.sh
pretrain.sh 里 batch size 是每卡 2、共 2 卡;visible_thermal.sh 是 8 卡、每卡 2,并默认从 pretrain_weights/epoch=8-.ckpt 初始化。数据准备(MegaDepth、KAIST、索引文件、软链接)见 docs/TRAINING.md;MegaDepth 的索引文件需要单独下载,不能只下原图。
参数与论文概念的对应关系:
| 代码 / 参数 | 论文符号 | 默认值 | 作用 |
|---|---|---|---|
match_coarse.thr | 0.3 | 粗匹配置信度阈值 | |
fine.thr | 0.1 | 细匹配第二阈值 | |
fine.denser | — | False | True 时每个细窗口输出多条互相近邻匹配 |
fine_window_size | 5 | 细匹配窗口大小 | |
medium_window_size | 3 | 中间层窗口大小 | |
test.img0_resize / img1_resize | — | 640 | 推理时长边缩放 |
ransac_thres | — | 1.5 px | 评测时 RANSAC 阈值 |
权重协议:代码是 Apache-2.0;数据集是 CC BY-NC-SA 4.0,禁止商业使用;权重文件放在 Google Drive,仓库没有单独声明权重许可证,商用前需要自行确认。仓库最后更新于 2025-08-21,训练代码、评测脚本、demo notebook 都在,未集成到 HLOC 或其它 SfM 管线。
参考
- Tuzcuoğlu, Köksal, Sofu, Kalkan, Alatan. XoFTR: Cross-modal Feature Matching Transformer. CVPR Workshops (Image Matching Workshop) 2024. arXiv · 代码
- Deng, Ma. ReDFeat: Recoupling Detection and Description for Multimodal Feature Learning. IEEE TIP 2023. arXiv
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Chen, Luo, Zhou, Tian, Zhen, Fang, McKinnon, Tsin, Quan. ASpanFormer: Detector-Free Image Matching with Adaptive Span Transformer. ECCV 2022. arXiv · 代码
- Huang, Chen, Liu, Liu, Xu, Wu, Ding, Tang, Wang. Adaptive Assignment for Geometry Aware Local Feature Matching. CVPR 2023. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Hwang, Park, Kim, Choi, Kweon. Multispectral Pedestrian Detection: Benchmark Dataset and Baseline. CVPR 2015. CVF
- Zhu, Liu. PMatch: Paired Masked Image Modeling for Dense Geometric Matching. CVPR 2023. arXiv
- He, Chen, Xie, Li, Dollár, Girshick. Masked Autoencoders Are Scalable Vision Learners. CVPR 2022. arXiv
- Xie, Zhang, Cao, Lin, Bao, Yao, Dai, Hu. SimMIM: A Simple Framework for Masked Image Modeling. CVPR 2022. arXiv
- Woo, Debnath, Hu, Chen, Liu, Kweon, Xie. ConvNeXt V2: Co-designing and Scaling ConvNets with Masked Autoencoders. CVPR 2023. arXiv
- Schönberger, Frahm. Structure-from-Motion Revisited (COLMAP). CVPR 2016. 项目页 · 代码
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale (hloc). CVPR 2019. arXiv · 代码
- Ren, Jiang, Li, Liang, Zhou, Bai. MINIMA: Modality Invariant Image Matching. CVPR 2025. arXiv · 代码