· 77 min read
论文解读:OctoSense,多传感器机器人感知的数据集与晚期融合 MAE
TL;DR 机器人感知从来不只靠一个摄像头,但自监督基础模型的预训练几乎只吃 RGB。OctoSense[1] 用一套开源硬件平台补上数据缺口:59 小时、2474 公里、8.4 TB 的多传感器同步驾驶数据,带深度、光流、分割和自车运动真值;再用模态专用分词器和「先空间、再时间、后跨模态」的晚期融合 MAE 在这份数据上预训练。冻结编码器接上轻量探针后,深度 RMSE 白天 4.73 m(V-JEPA 2.1 为 6.38 m)、夜间 6.08 m(9.51 m),光流 EPE 1.97 px(9.13 px),平移误差 0.06 m;RTX 5090 与 Orin NX 上计算表征只需 6.68 ms 和 112 ms,Orin 上比参数量相近的早期融合快约 60%。平台与数据工具链以 MIT 开源,模型、训练和 dataloader 代码尚未开源。
- 论文:OctoSense: Self-Supervised Learning for Multimodal Robot Perception,Anthony Bisulco、Jeremy Wang、Kostas Daniilidis、Randall Balestriero、Pratik Chaudhari,宾夕法尼亚大学 GRASP 实验室 / Brown University,arXiv 2026 年 6 月 25 日。
- 代码:github.com/anthonytec2/OctoSense(MIT,平台 + 数据工具链;模型代码未开源)。
- 数据:Hugging Face
anthonytec2/OctoSense、项目主页。 - 背景:读这篇前最好知道 MAE 的掩码重建、FSQ 的离散化思路,以及 DINO / V-JEPA 这条视觉自监督主线;站内可先看交互式理解 DINO 系列和 SSIO 与 IMUDINO。
一、动机:机器人的传感器不止一个,但自监督预训练几乎只看 RGB
视觉自监督这几年把「一个 ViT 吃遍所有图像任务」推到了很高的水位:DINOv2[2]、DINOv3[3]、SigLIP 2[4]、Perception Encoder[5] 和 V-JEPA 2.1[6] 在分类、检索、深度、分割上都能给出很强的冻结特征。但它们共享一个前提:输入是图像或视频,最多加文本。机器人不是这样工作的。一辆自动驾驶车同时挂着 LiDAR、事件相机、IMU、RTK-GPS 和 CAN,一台四足机器人还要读关节角;这些传感器的时间分辨率、噪声结构、失效方式完全不同——摄像头怕黑夜和眩光,LiDAR 怕雨雪和丢包,事件相机没有绝对亮度,IMU 会漂移。只从 RGB 学到的表征,天然继承 RGB 的失效模式。
要把多传感器自监督做起来,缺的不只是损失函数,而是两样基础设施。第一是数据:现有带事件相机的机器人数据集大多只有几十分钟到几小时(M3ED 3 小时 46 分[7],DSEC 53 分钟),而 DINO / V-JEPA 级别的预训练需要成千上万小时的多样化数据。第二是架构:把所有模态的 token 直接扔进一个 Transformer(早期融合)在显存和带宽上都很贵,更不用说部署到 Orin 这类车端芯片。论文的贡献正好对应这两块:
- OctoSense 平台与数据集:开源硬件、时间同步、标定与 GT 生成流水线,发布 59 小时 / 2474 公里 / 8.4 TB 的同步驾驶数据;按作者说法,这是目前带事件相机的机器人数据集中最大的一个。
- 晚期融合多模态 MAE:模态专用分词器把异构传感器变成统一的离散重建目标,编码器按「模态内空间 → 模态内时间 → 跨模态」三级注意力融合,并在推理时缓存历史 token,只算新测量。
- 下游验证:冻结编码器 + 任务探针,在深度、光流、语义分割、自车运动和转向角五个任务上超过五个 RGB 基础模型;夜间和传感器退化时的优势更大,并在 M3ED 上做了零样本迁移。
这篇文章值得读的地方,不只是「多模态 MAE 又刷了榜」,而是它把数据采集、时间同步、伪真值生成、分词器、融合架构、推理延迟放在同一条工程链上讨论。下面按这条链展开。
二、OctoSense:一套平台、一份数据集、一条数据流水线
2.1 传感器、采集与硬件时间同步
平台面向汽车和 Unitree Go2-W 四足两种载具,汽车版是本次发布的主力。传感器包括:两路 1920×1456、100 Hz 的 FLIR Blackfly S 彩色相机(IMX421),两路 640×480 的 SilkyEV VGA 事件相机(最高 50 MEv/s),一台 Ouster OS1-64(2048×64、10 Hz),一台 FLIR A35 热像仪(320×256、50 Hz),VectorNav VN-100T-CR IMU(400 Hz),u-blox ZED-F9P RTK-GPS(5 Hz),以及 2021 款 Mazda CX-5 的 CAN 总线(转向、轮速、油门)或 Go2-W 的 12 路关节角 / 足端力 / 电机设定值。图 1 的 B 面板把每个传感器的分辨率、视场、接口和数据率列全了。
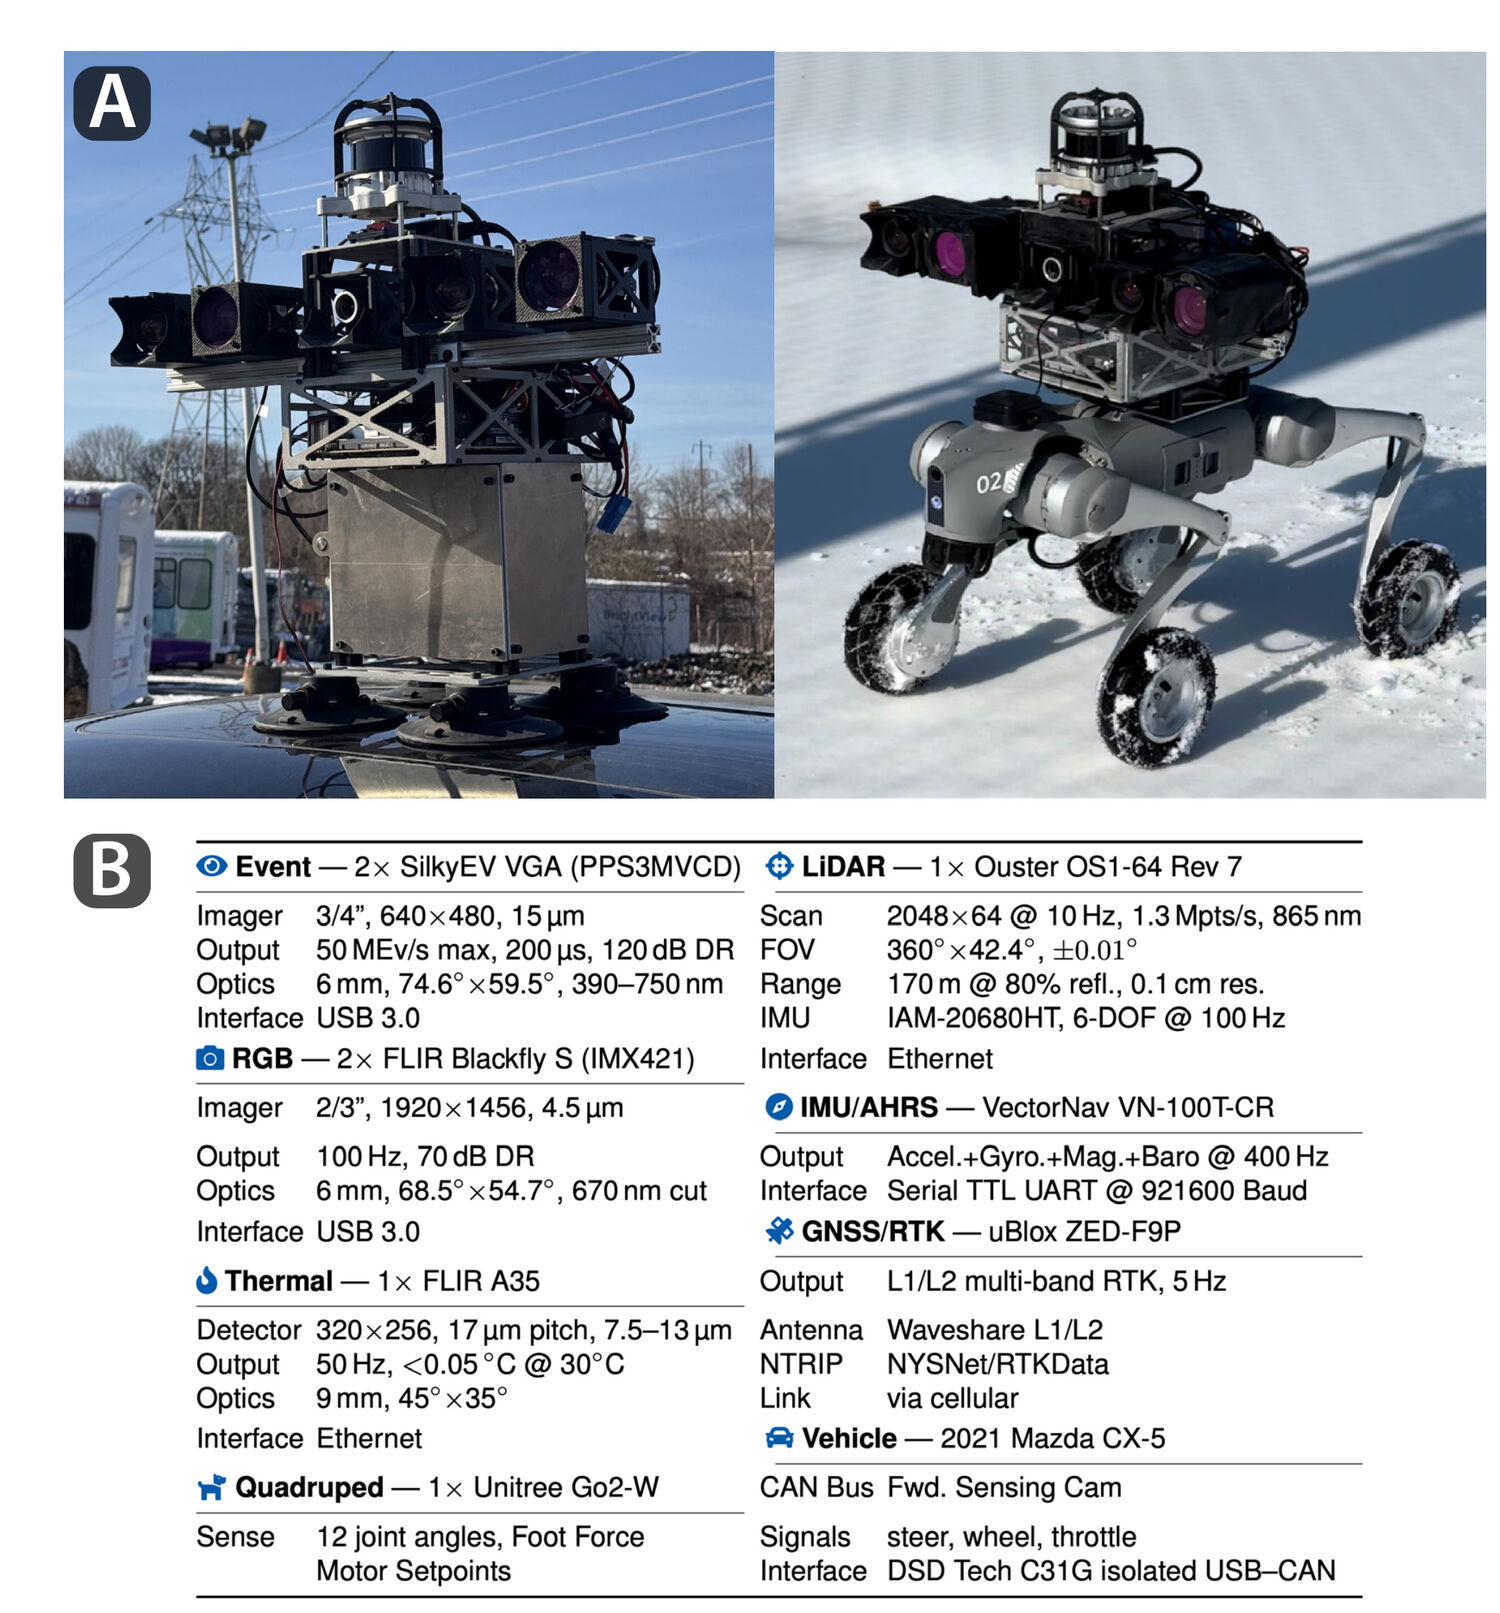
数据采集本身就是一篇工程笔记。原始八路数据合起来约 1.7 GB/s,作者把 LiDAR / 事件包按原始格式记录,RGB 和热成像用无 B 帧的 H.265 编码,把总带宽压到 78.7 MB/s(21×);ROS 2 的 Zenoh 可组合节点做零拷贝传输,web 监控面板实时看每个传感器的速率和时间戳。工程上的坑也很具体:事件相机前加 390–750 nm 带通滤光片挡掉 LiDAR 的红外干扰;低温会让 SilkyEV 的时间戳损坏,于是给相机包 1 英寸橡胶泡沫保温;IMU 用橡胶减振柱软安装;LiDAR 数据线在高振动下丢包,就把线固定到刚性支架并用扎带压进泡沫。这些细节在附录 B 里,读起来比方法节更像一篇真实的野外实验记录。
时间同步是整份数据集的骨架。每台传感器用自己的晶振计时,起点、频率、延迟都不同;作者做了一块自定义 PCB(Teensy 4.1 + DS3231 温补晶振,后者漂移约 2 ppm),由它给所有传感器发硬件触发。难点在于:只要漏掉一个触发脉冲,后面整段数据都会错位。于是他们把每秒的 PPS 脉冲组织成周期信号,并且每 4 分 15 秒插入一次六脉冲的 UID 序列,用脉冲宽度编码窗口编号,事后可以无歧义地把任意一段数据对齐回全局时钟;UID 阶段之后,各通道恢复成每秒钟一个 10 ms 脉冲。
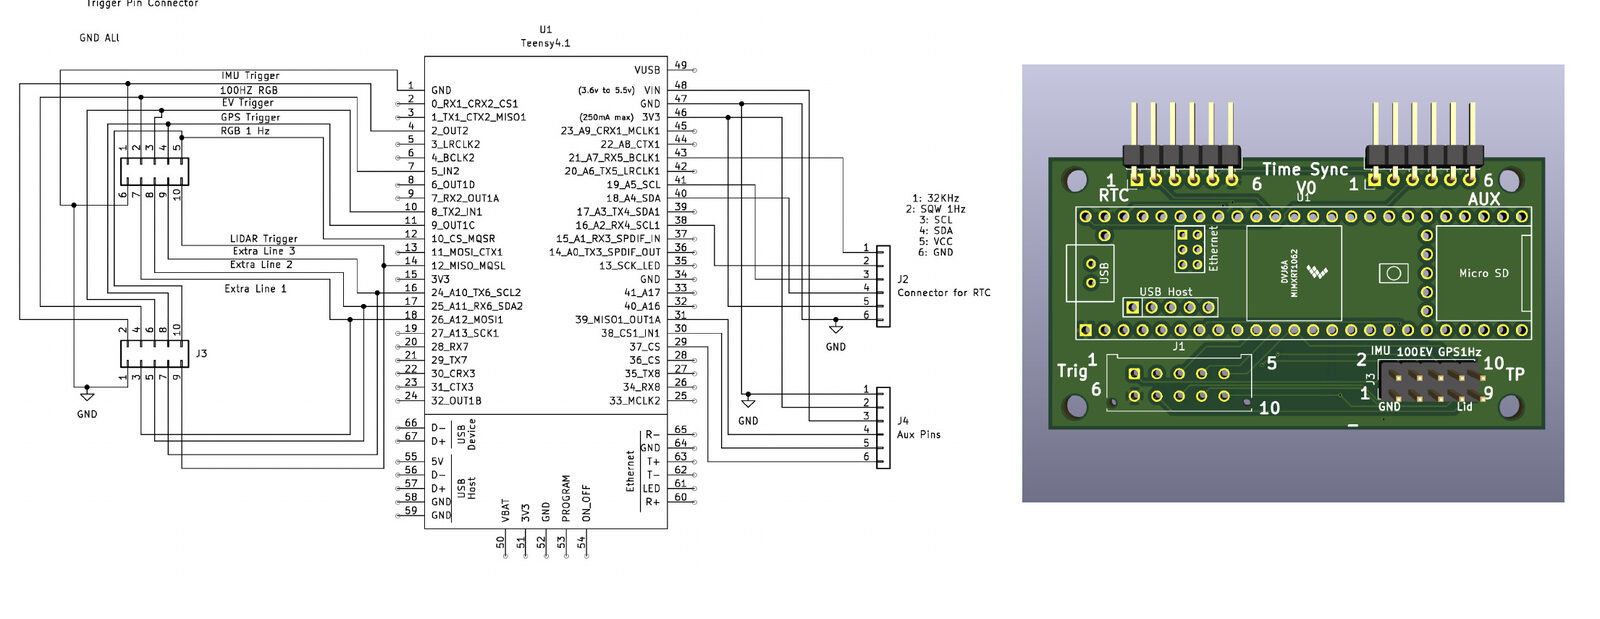
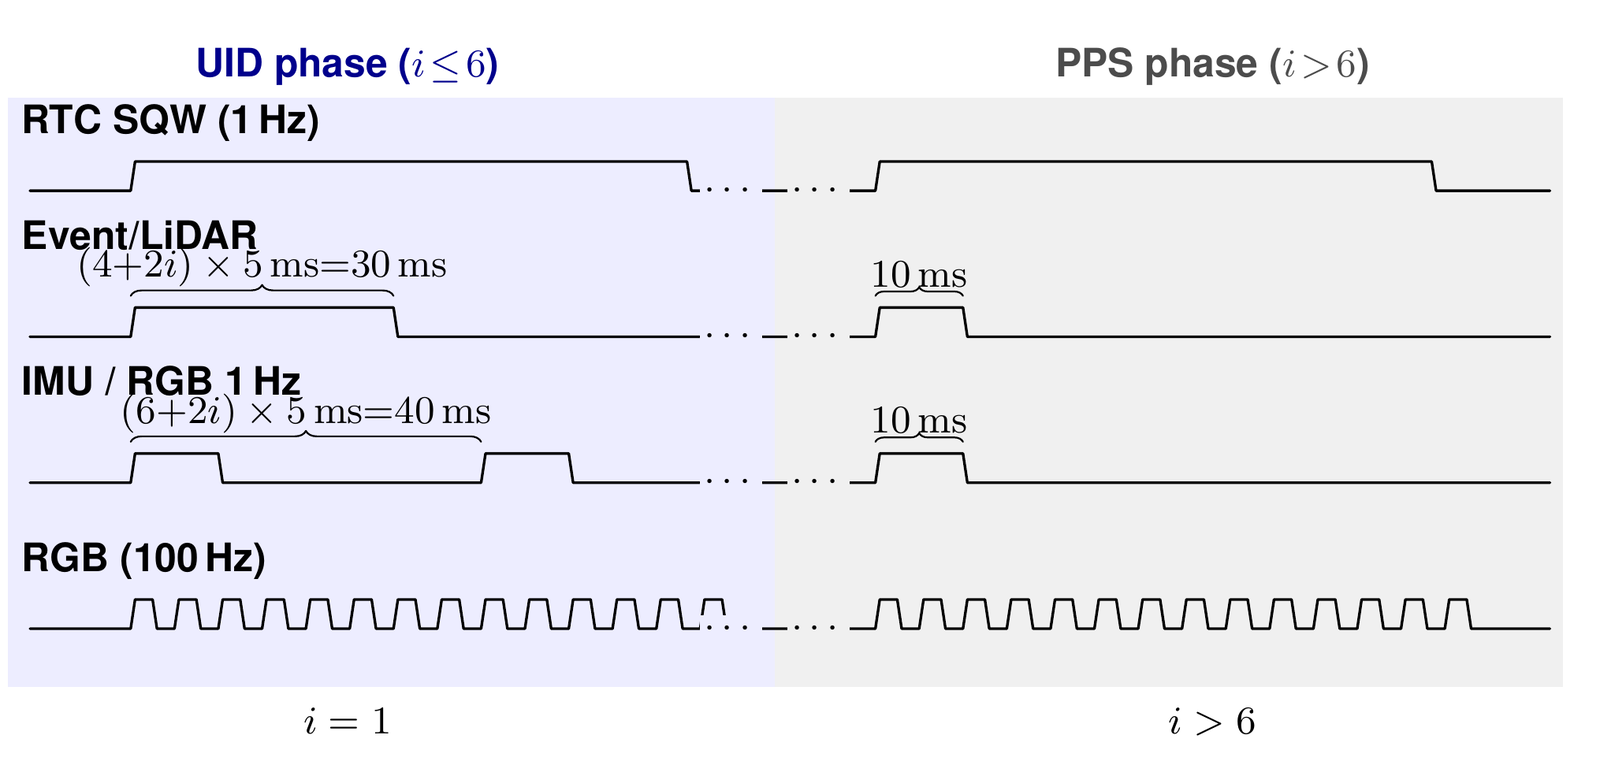
有了带 UID 的 PPS 对,剩下的就是拟合。把传感器 s 的第 k 个脉冲时间记为 ,全局时钟记为 ,假设两者是仿射关系 ,状态取 ,观测矩阵 ,过程噪声按时间间隔累积 。每个传感器跑一遍 Kalman 滤波,再用 RTS 平滑器回扫;对异常脉冲,用马氏距离 做门控,阈值 5,前 30 个脉冲不门控以便滤波器收敛。表 S2 给每个传感器配了不同的测量方差:IMU 的 ms(400 Hz 边沿量化),FLIR 相机 5 ms(100 Hz),事件相机 0.01 ms(微秒级触发),系统时钟 25 ms(OS 调度抖动)。GPS 和热成像没有走外部触发(GPS 触发记录不可靠,热成像外触发会撕裂画面),而是用系统时间记录,再用 IMU 触发包对齐到全局时钟。
这套逻辑在官方仓库里有完整实现,核心是 kalman_filter_and_rts 的前向滤波:状态转移是随机游走(),预测步只给协方差加过程噪声,更新步在预测和校正之间插入马氏距离门控。
代码:PPS 时间同步的 Kalman 滤波(官方 data_processing/timesync/timeSyncUtil.py,原文节选)
    x_prev = x0.copy()
    P_prev = P0.copy()

    # Forward filter pass: predict + (optionally gated) update.
    # Update step delegated to pykalman's _filter_correct, which uses
    # scipy.linalg.pinv natively and so handles near-singular S_k without our
    # legacy try/except dance. The predict step is trivial (F=I) so we keep it
    # inline; outlier gating must happen between predict and update

    R_mat = np.array([[float(R)]])
    obs_offset = np.zeros(1)
    n_rejected = 0
    for k in range(N):
        # Predict (identity state-transition / random walk: state carries over,
        # covariance just grows by the process noise)
        x_pred = x_prev.copy()
        Qk = Q_base * dt[k]
        P_pred = P_prev + Qk

        # Time-varying measurement matrix and innovation/Mahalanobis gate
        H = np.array([1.0, tD[k]]).reshape(1, 2)
        z = tG[k]
        y = z - float((H @ x_pred).item())
        # S_k = H P_pred H^T + R is always > 0 (R > 0 floors it), so no guard needed.
        S_k = float((H @ P_pred @ H.T + R_mat).item())
        mahal_dist = abs(y) / np.sqrt(S_k)

        if mahal_gate is not None and k > 30 and mahal_dist > mahal_gate:
            x_upd, P_upd = x_pred.copy(), P_pred.copy()
            rejected[k] = True
            n_rejected += 1
        else:
            _, x_upd, P_upd = _filter_correct(
                H, R_mat, obs_offset, x_pred, P_pred, np.array([z])
            )

        xs_pred[k], Ps_pred[k] = x_pred, P_pred
        xs_filt[k], Ps_filt[k] = x_upd, P_upd
        innov[k], S[k] = y, S_k
        Qk_list[k] = Qk
        x_prev, P_prev = x_upd, P_upd
滤波之后还有一步 map_events_to_global:对每个事件时间戳,找到它两侧的 PPS 状态 ,线性插值后算 。这样,一条事件流里的每个事件、每一帧图像、每一线 LiDAR 都能落到同一时间轴。
2.2 标定与真值:把 LiDAR 点云变成相机的稠密标签
标定用的是一块 6×6 AprilGrid(标记边长 11.2 cm),中心贴一个反光圆(retro-reflective circle)。AprilGrid 给 RGB 和事件相机提供角点,反光圆则在 LiDAR 的反射率图里非常显眼,于是同一个目标在相机和点云里都有对应特征。事件相机先用二阶 IIR 滤波器重建成帧,再用 AprilTag 检测;相机内参、相机-相机、相机-IMU 外参用 Kalibr[8]求解,作者 fork 了 Kalibr 并把 AprilTag 的 blackTagBorder 默认值改成 1(他们的标签只有一个黑边),否则检测不出来。
LiDAR 到相机的外参用三类残差求解:(i) 圆心在图像上的重投影误差;(ii) 用 LiDAR 点云拟合出的圆半径;(iii) 点到标定板的距离。圆心先在 LiDAR 里通过阈值化反射率、拟合平面和圆得到,在图像里通过 AprilTag + PnP 得到;外参初值用 RANSAC 加 Kabsch–Umeyama 对齐,再用 Levenberg–Marquardt 细化。图 S3 的 E 面板把 LiDAR 深度投到 RGB 上,边缘对齐得相当紧。
真值流水线在 data_processing/depth_gt/ 里,逻辑是「累积 + 过滤 + 投影」:
- 用 RKO-LIO[9]估计平台在 SE(3) 里的位姿,并对每个 360° LiDAR 扫描做去畸变,把点云变换到同一时刻。
- 以参考扫描为中心,累积前后共 61 帧扫描(约 6 秒窗口),得到比较稠密的点云。
- 用 YOLO26-medium[10]在最接近该扫描的校正 RGB 上检测车辆和行人,把落在动态物体上的点从缓存里删掉;官方代码还把掩码向外膨胀 16 像素,以覆盖后视镜、天线、保险杠这些边缘。
- 在世界坐标系里做体素一致性过滤:只保留被至少 4 个不同扫描观测到、体素边长 0.3 m 的点。静态面会在同一个体素里反复出现,移动车辆只留下单帧拖影,于是被滤掉。
- 把剩下的点投到校正后的左相机,做 z-buffer,每个像素保留最近深度;输出 1920×1456 的 uint16 厘米深度图。光流则由深度和相机位姿重新投影得到,分割伪标签用 Cityscapes 上训练的 EoMT[11]生成。
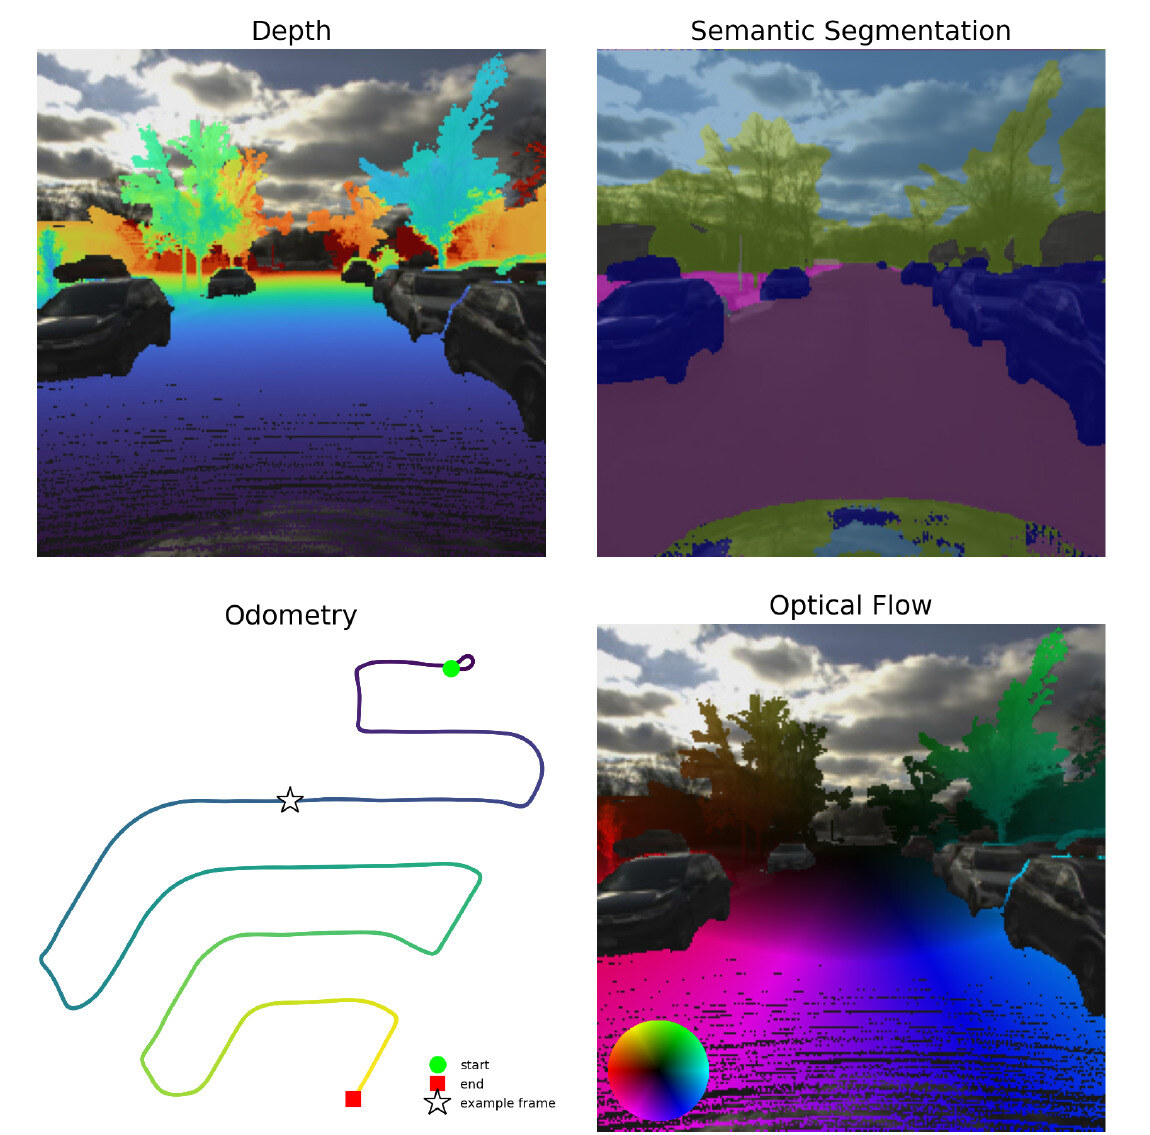
体素一致性过滤和 z-buffer 是整个 GT 生成里最关键的两步,官方实现都是 GPU 版:
代码:地图一致性滤波与 z-buffer(官方 data_processing/depth_gt/geometry.py,原文照录)
def map_consistency_filter_gpu(pts_map: torch.Tensor, scan_tag: torch.Tensor,
                               voxel: float, min_scans: int) -> torch.Tensor:
    """ Packs (voxel, scan) into one int64 key for a single ``torch.unique`` instead
    of ``np.unique(axis=0)``. Returns a bool mask over ``pts_map``."""
    N = pts_map.shape[0]
    if N == 0:
        return torch.zeros(0, dtype=torch.bool, device=pts_map.device)
    vox = torch.floor(pts_map / voxel).to(torch.int64)
    vox -= vox.min(dim=0, keepdim=True).values
    vmax = vox.max(dim=0).values + 1
    key = vox[:, 0] * (vmax[1] * vmax[2]) + vox[:, 1] * vmax[2] + vox[:, 2]

    # Pack: upper bits = voxel key, lower 16 bits = scan_tag (max ~2^16 scans).
    assert scan_tag.max().item() < (1 << 16), "scan_tag overflows 16 bits"
    packed = (key << 16) | scan_tag.to(torch.int64)
    uniq_packed = torch.unique(packed, sorted=True)       # dedup (voxel, scan) pairs
    # Project back to voxel key; it's now non-decreasing because of the packing.
    uniq_key_flat = uniq_packed >> 16
    uniq_vox, counts = torch.unique_consecutive(uniq_key_flat, return_counts=True)

    pos = torch.searchsorted(uniq_vox, key)
    pos_c = pos.clamp(max=uniq_vox.numel() - 1)
    match = uniq_vox[pos_c] == key
    counts_per_point = torch.where(match, counts[pos_c], torch.zeros_like(counts[pos_c]))
    return counts_per_point >= min_scans


def zbuffer_gpu(uv: torch.Tensor, depth: torch.Tensor, hw):
    H, W = hw
    out = torch.full((H * W,), float("inf"), dtype=torch.float32, device=depth.device)
    if uv.shape[0]:
        flat = uv[:, 1] * W + uv[:, 0]
        out.scatter_reduce_(0, flat, depth, reduce="amin", include_self=True)
    out = torch.where(torch.isinf(out), torch.zeros_like(out), out)
    return out.reshape(H, W)
这两段代码很能说明作者的工程取向:一致性过滤把「体素编号 + 扫描编号」压进一个 int64,用一次 torch.unique 同时完成去重和计数;z-buffer 用 scatter_reduce_(reduce="amin") 一次写入所有投影点,避免了逐像素排序。
2.3 数据规模、覆盖与分布
数据集最终包含 59 小时、2474 公里、8.4 TB。原始录制其实有 75 小时,作者删掉了 LiDAR 丢包超过 5 秒、事件时间戳或热成像数据损坏、以及有数据包丢失的片段,才得到发布版。数据分布在纽约长岛和费城两地:长岛 1232 公里 / 23 小时,费城 1251 公里 / 34 小时(GPS 有效区间的统计,和总里程略有出入)。场景覆盖城市、郊区、乡村、高速和住宅区,时间从日出、白天、日落到夜间,并专门保留了一批传感器退化序列——太阳眩光、雪地反光、LiDAR 丢包等——作为独立的测试集。图 5 是 GPS 轨迹,图 6 是退化场景的例子。
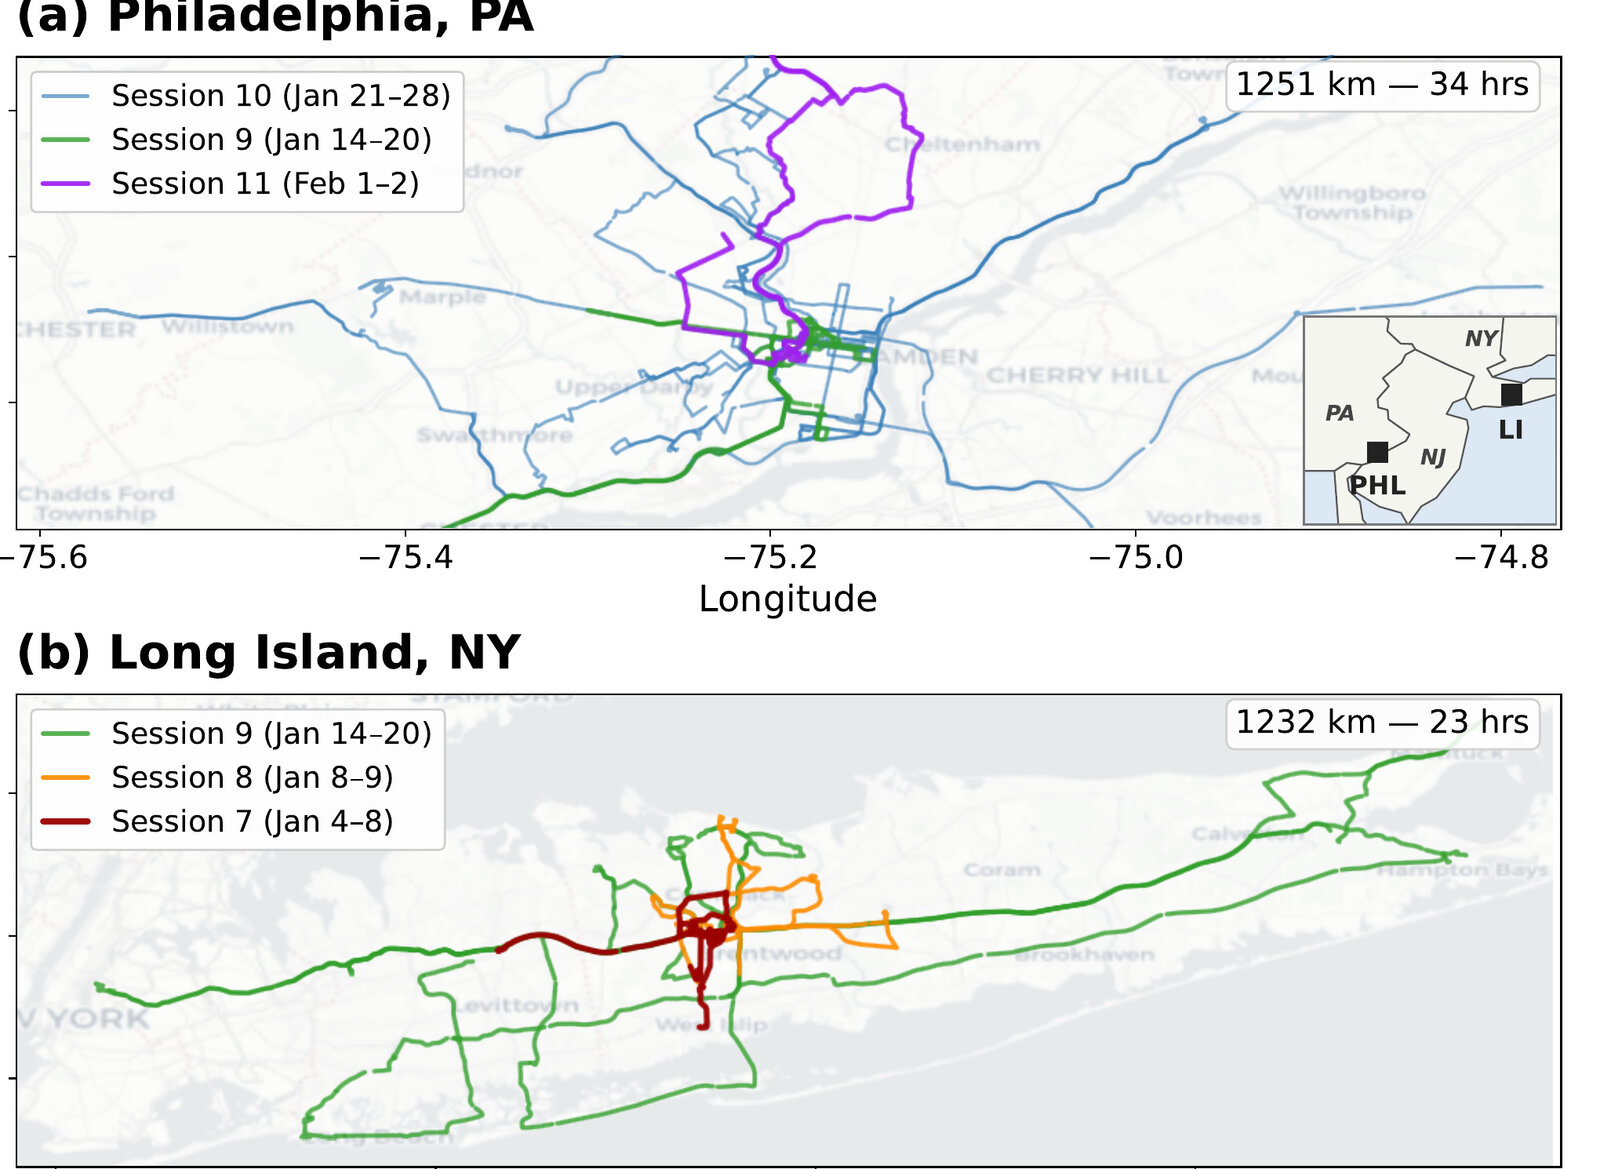
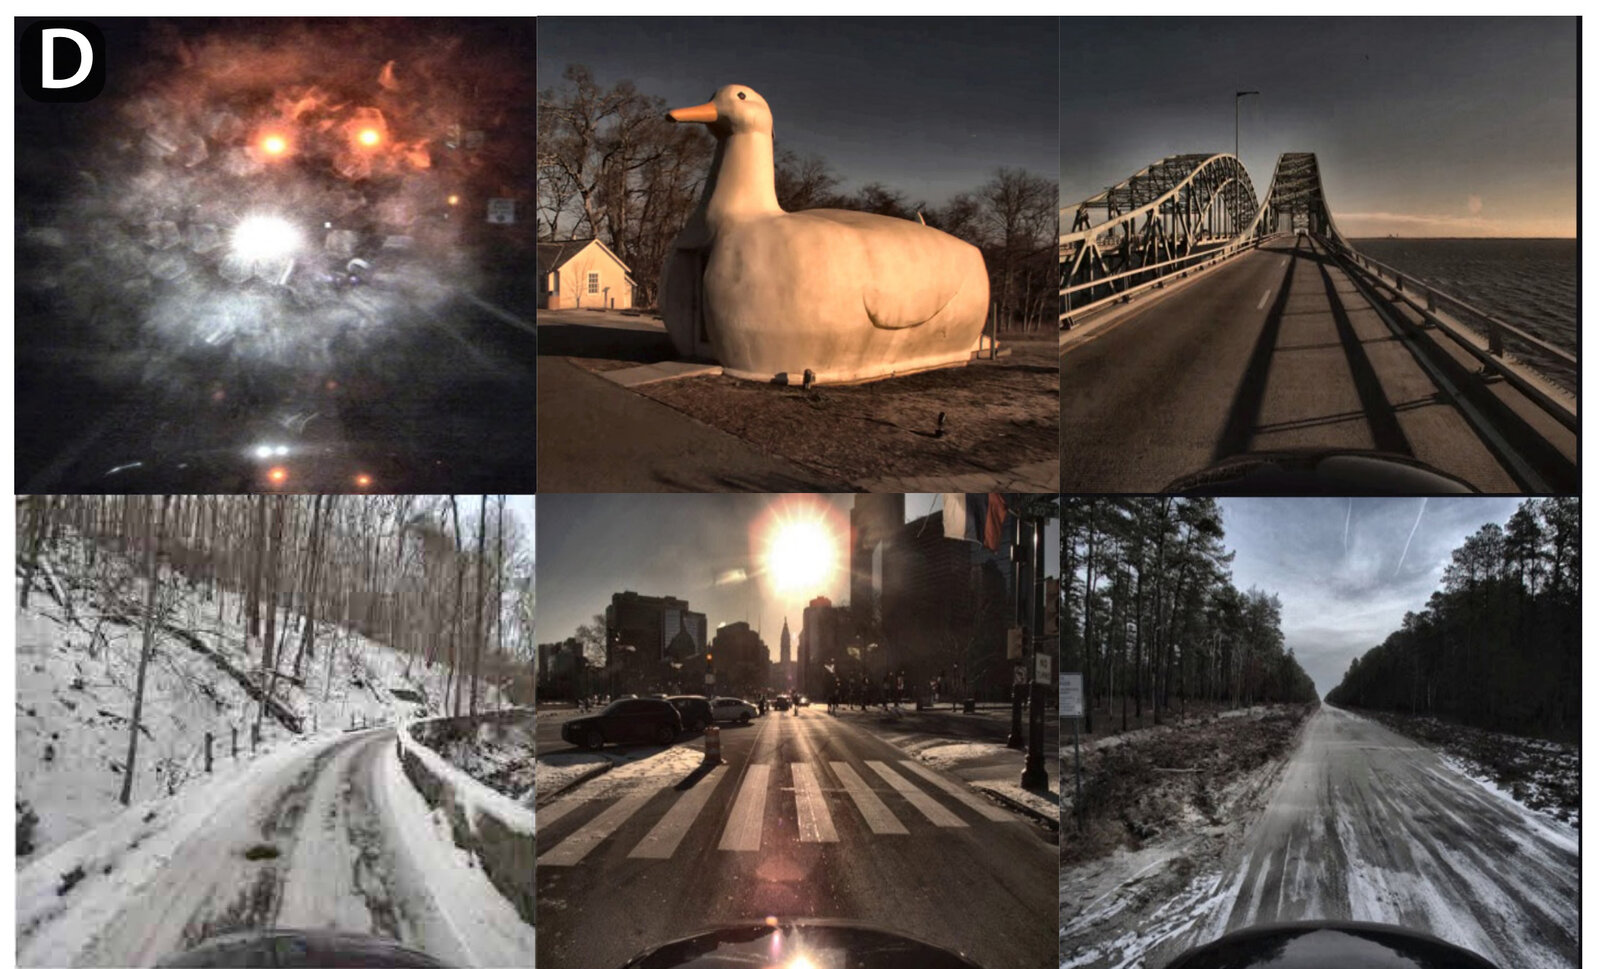
和现有数据集横向比,OctoSense 的定位很清楚:KITTI 6 小时、nuScenes 5 小时 33 分、Waymo 感知集 6 小时 24 分、M3ED 3 小时 46 分,而 OctoSense 是 59 小时 / 2474 公里;在「带事件相机」这一类里,它把时长从小时级推到了几十小时级。作者把 293 个序列划为训练集、78 个划为测试集,每个序列约 10 分钟;测试集同时包含白天和夜间,退化序列单独留出。
数据之外,仓库还提供了一套自然语言检索工具:每 5 秒的图像窗口用 Gemma 4[12]从三帧代表图生成描述,描述里带速度、转向、里程和本地时间等遥测信息;再用 Qwen3-Embedding-8B[13]嵌入,建 FAISS[14] + BM25 的混合索引,配一个 FastAPI 网页。预建索引约 700 MB,可以直接下载后用 CPU 查询。对于一份 8.4 TB 的数据集,「怎么找到想要的片段」和「有多少小时」同样重要。
三、方法:把四种异构传感器塞进一个掩码自编码器
3.1 四种输入,四种分词器
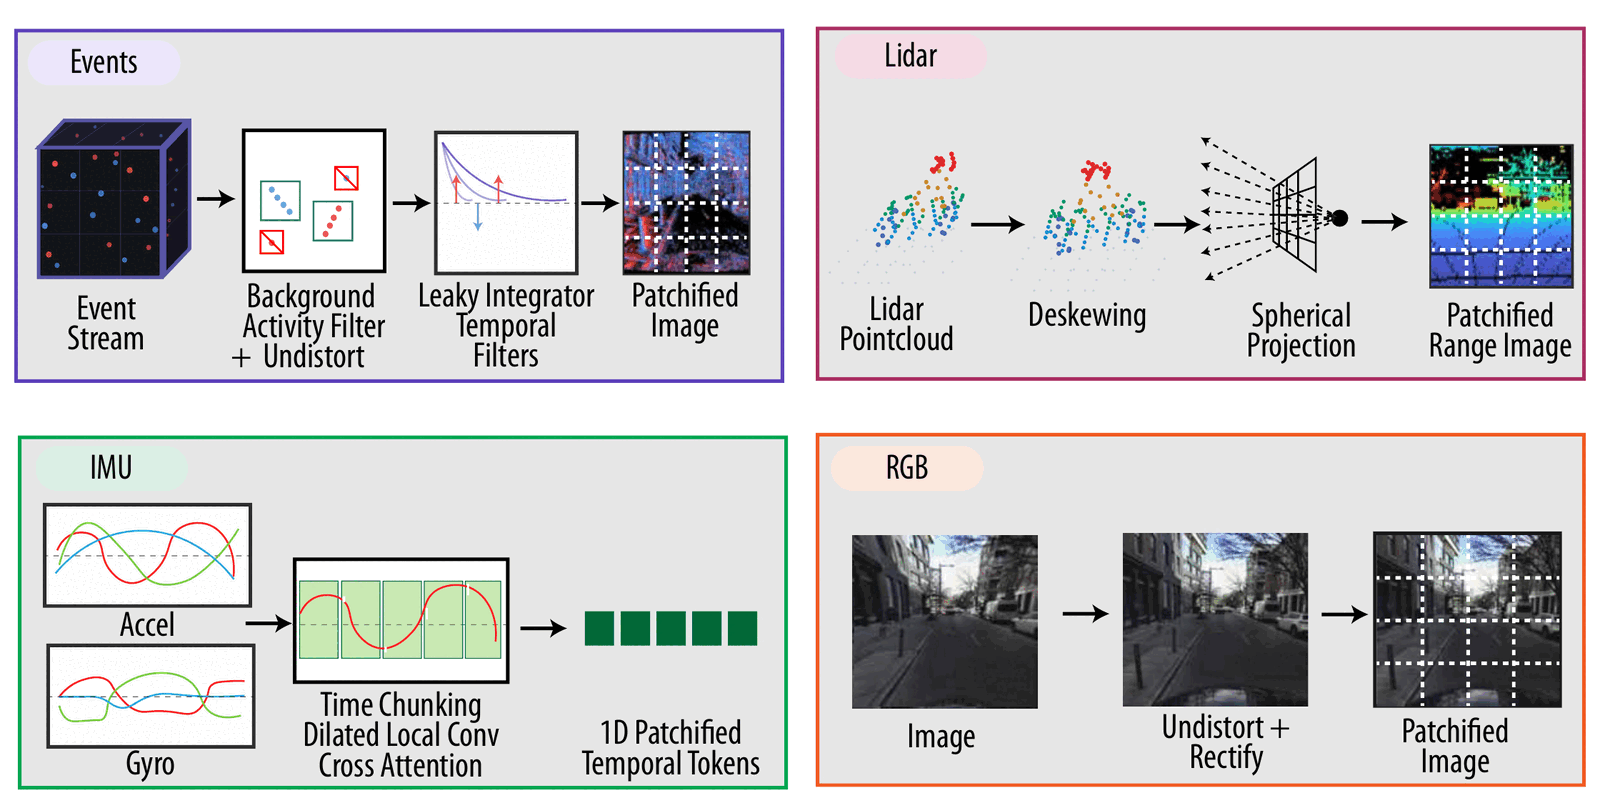
方法面对的第一件事不是融合,而是「怎么把不同物理量的传感器变成同一种 token」。论文的处理如图 7:
- RGB:去畸变、校正,切成 16×16 的 patch,输入 3×192×192,每帧 144 个 token。
- 事件:先去畸变、校正,用时空滤波器去掉孤立事件;然后用一组不同带宽的 leaky integrator 把稀疏事件流变成 multi-channel 的类图像表示(3×192×192),再切 12×12 的 patch,每帧 256 个 token。
- LiDAR:点云先去畸变,球面投影成 64×2048 的距离图,裁出前向 90° 视场得到 64×512,再切 8×16 的 patch,每帧 256 个 token。
- IMU:1.6 秒、400 Hz 的六通道(三轴加速度 + 三轴角速度)序列,切成 16 个 40 样本的 chunk;每个 chunk 先过 1D 空洞卷积,再用 cross-attention pooling 压成一个 token,整段只有 16 个 token。
3.2 用 FSQ 把异构模态变成同一类重建目标
如果沿用原始 MAE 的像素 MSE,多模态会很难训:RGB 是稠密强度,事件是稀疏激活,LiDAR 是带孔洞的对数深度,IMU 是快速变化的六通道时间序列,量纲和统计都不一样。论文采用 BEiT / 4M 这一路的做法:先给每个模态单独训一个 tokenizer,把每个 patch 压成有限集合里的一个 token;MAE 不预测原始像素,而是预测被冻结 tokenizer 给出的 token。
具体地,每个 tokenizer 是一个 6 层、宽 384 的 Transformer 编码器(图像类模态用二维 RoPE,IMU 用一维),解码器是 Transformer + 卷积的混合结构——作者在附录里对比过,纯线性 readout 会让重建发糊,卷积解码器明显更锐。瓶颈用 FSQ(finite scalar quantization)[15]:每个维度量化到固定档位,五维的档位是 [8,8,8,8,5],组合起来码本大小 。训练目标是所有 patch 上的 ,不是只算被遮住的 patch——V-JEPA 2.1 的经验是,全 patch 重建对稠密预测更有利。
每个模态的损失有各自的修正:LiDAR 在对数深度上算 ,再加一个深度有效性掩码的二元交叉熵(处理射线丢失造成的孔洞)和 SiLog 损失;事件相机对 filter bank 的激活做加权 ,平衡有事件和无事件的像素;IMU 先减均值、做固定归一化,再回归时间序列。四个 tokenizer 训练完后冻结,作为 MAE 的重建目标。这一步其实继承了 MultiMAE[16]和 4M[17]的思路:先把异构输入统一成离散 token,再让融合网络在 token 空间里做重建。
3.3 晚期融合:空间 → 时间 → 跨模态
一个 1.4 秒的窗口里,模型拿到 8 帧 LiDAR、8 帧左 RGB、8 帧左事件,以及一段 1.6 秒的 IMU(图 8)。融合方式有两种:
- 早期融合:把所有模态、所有时刻的 token 拼成一个长序列,直接进一个 12 层 ViT。优点是跨模态交互最早发生;缺点是显存和带宽压力大,token 数随模态数线性增长。
- 晚期融合(论文的选择):每个模态先走自己的空间编码器(每个时刻独立,3 层、宽 576),再走自己的时间编码器(沿每个未遮住的 tube 做注意力,2 层、宽 576,作者叫 tubelet attention),最后所有模态的 token 一起进跨模态编码器(3 层、宽 576、9 个注意力头)。解码器是 8 层、宽 384、12 个头的 Transformer。
位置编码用四维 RoPE,坐标是 : 是窗口内的时间位置, 是图像块坐标(IMU 置零), 是模态编号。这样同一套注意力既能区分「第几帧、图像哪个位置」,也能区分「哪个传感器」,不需要额外的 modality embedding。
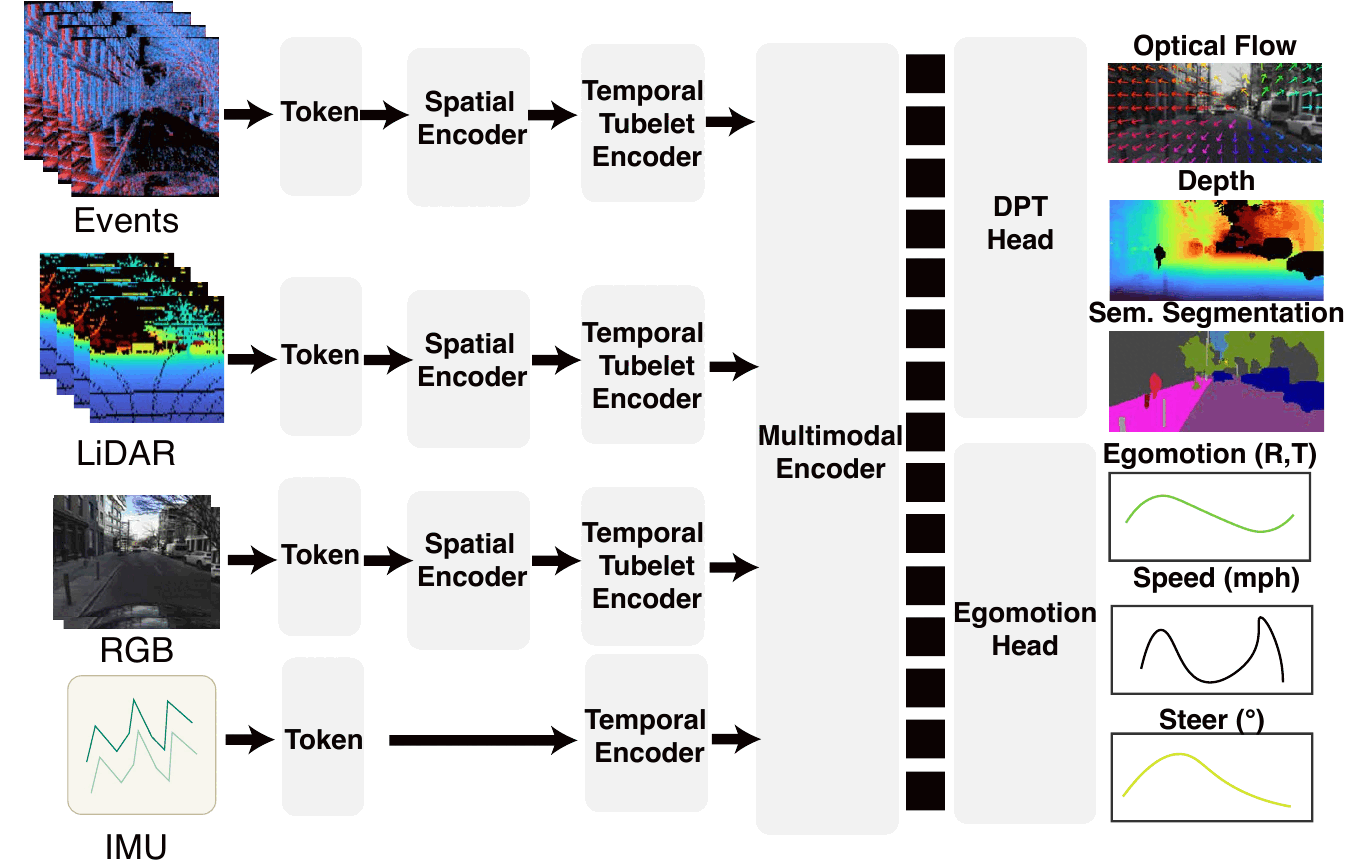
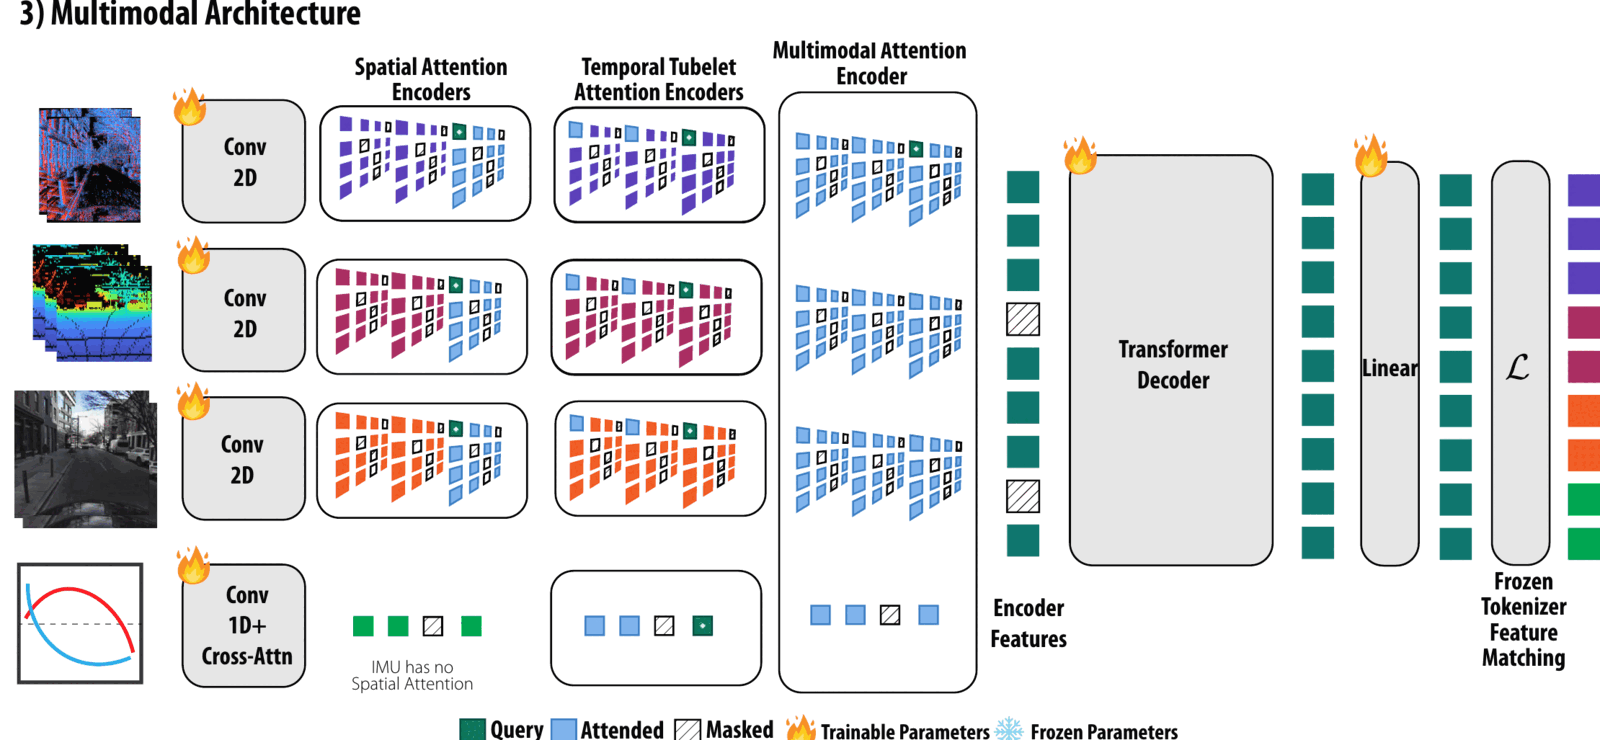
这个设计的核心是把全时空注意力因式分解。全注意力的复杂度随「模态数 × 时间 × 空间」的乘积增长;晚期融合把它拆成「每帧空间注意力 + 每管时间注意力 + 一次跨模态注意力」,在保持表达能力的同时把计算量压下来。论文的消融也说明这种拆法几乎不损精度:把 tubelet attention 换成模态内全时空注意力(w/ full attention),深度 4.73 vs 4.73 m、光流 1.96 vs 1.97 px、分割 0.405 vs 0.411,基本持平;但全注意力的延迟没有单独报告,作者明确说晚期融合的动机是显存、带宽和部署。
3.4 掩码策略:Dirichlet 分配 + 时空管
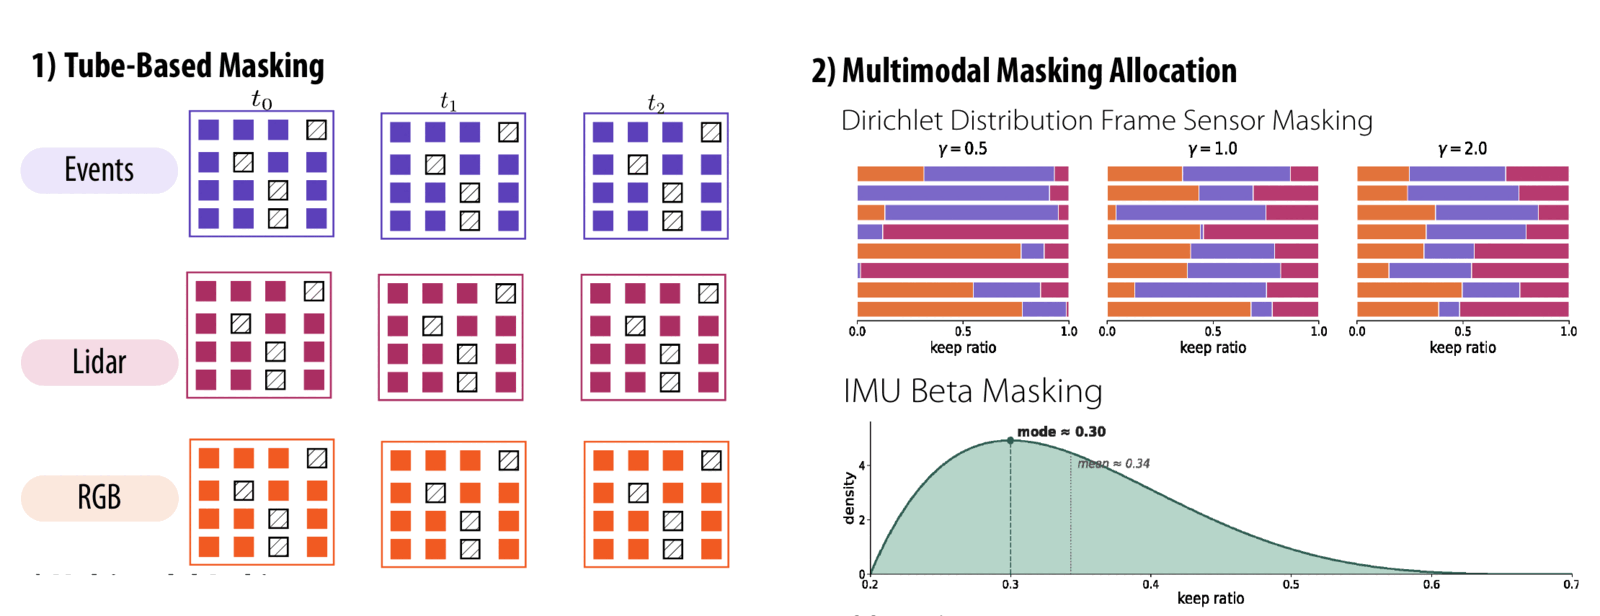
多模态 MAE 的一个关键选择是「遮多少、遮哪个模态」。如果每个模态独立地按固定比例遮,模型可能学会只依赖最容易重建的模态;如果总是遮同一个模态,又会让其他模态欠训练。论文用 Dirichlet 分布来分配掩码预算。
对图像类模态 ,先从 采样一个三维比例 ,再令
也就是说,模态 s 的 keep ratio 是 ,mask ratio 是 。由于 的期望是 ,平均 keep ratio 是 ,平均 mask ratio 正好是 0.8。 从 里均匀抽: 时 Dirichlet 质量集中在单纯形的角上,一次采样往往让某一个模态占掉大部分 keep 预算,另外两个几乎全遮; 时质量靠近中心,三个模态分得更平均。这个设计同时覆盖了「多模态互补」和「模态缺失」两种情形——模型必须学会在某一路几乎全黑时,从其他路把信息补回来。
对 IMU 这种一维序列,论文不用 tube,而是每个 token 独立保留,keep 概率为
取值落在 [0.2, 0.7],均值约 0.34。图像类模态的掩码则是贯穿整个时间窗口的时空管:同一个空间 patch 在 8 帧里要么一起保留、要么一起遮住。这比逐帧随机遮更难,因为模型不能靠相邻帧「抄答案」。
下面这个部件把公式变成可以拧的旋钮:拖动 ,看三个模态的 keep ratio 和管状掩码图案怎么变;点「换一组采样」重新抽一次。
3.5 推理缓存与任务探针
训练好的编码器可以当冻结特征提取器。推理时,1.4 秒的窗口每次滑动只前进 0.4 秒,很多 token 是重复的;论文把历史窗口的模态特征缓存起来,只对新测量做前向,再把新特征和缓存拼成当前窗口。表 3 与表 S7 的数字:在 RTX 5090 上,早期融合 11.35 ms,晚期融合 7.61 ms,加缓存 6.68 ms(1.70×);在 Jetson Orin NX 上,早期融合 288 ms,晚期融合加缓存 112 ms。两者参数量只差 1.3 M(83.7 M 对 85 M),所以这不是「用小模型换速度」,而是融合方式本身在车端更友好。
下游任务分两类探针。稠密任务(深度、光流、分割)用 DPT[18]风格的头:从编码器四个均匀间隔的层取特征,每层先过一个带四维位置编码的 Transformer block 混合时间信息,再选出和单帧 RGB patch 数相同的 token,拼成特征金字塔;深度用 SiLog 损失,光流用 Charbonnier 损失,分割用交叉熵。自车运动用三个独立的 cross-attention 读出模块,查询 attend 到编码器最后一层,分别预测相对平移/旋转、线速度/角速度、CAN 速度和转向角;旋转用预测矩阵与真值矩阵的平方 Frobenius 范数,推理时投影回 SO(3),其余目标先做 Z-score 再用 Huber 损失。
3.6 训练设置
晚期融合 MAE 在 4 张 NVIDIA B200 上训练 150 个 epoch,每卡 batch 128(有效 512),学习率 、OneCycle 调度、bf16 混合精度;优化器是 Muon(二维权重)+ AdamW(偏置和归一化层)。训练窗口 1.4 秒、8 帧、帧间隔 0.2 秒,相邻窗口重叠 1 秒;IMU 窗口 1.6 秒。四个 tokenizer 各训 60 个 epoch,图像类用 4 张 B200,IMU 只用 1 张。论文说全部实验约 7000 GPU 小时,这个量级对学术组来说不算小,但也远不到 DINO / V-JEPA 的规模。
四、实验结果
4.1 主结果:五个任务,白天与夜间
先看白天。表 1 的深度 RMSE:晚期融合 4.73 m,V-JEPA 2.1 6.38 m,DINOv2 6.82 m,最好的 RGB-only 视频 MAE 也要 7.41 m;夜间差距更大,晚期融合 6.08 m,V-JEPA 2.1 9.51 m,DINOv2 9.95 m。光流更夸张:白天 1.97 px 对 9.13 px,夜间 2.39 px 对 10.90 px。语义分割的领先很小——0.411 对 DINOv2 的 0.410——作者解释伪标签本身就是 DINOv2-based 的 EoMT 生成的,存在天花板效应。自车运动则是「几乎做满」:平移 0.06 m、旋转 0.23–0.24°、转向 2.51°/2.27°,而 RGB-only 的 V-JEPA 2.1 转向误差是 5.98°/6.83°。
下面的浏览器把表 1 和表 2 的数据放在一起:切换条件(白天 / 夜间 / 传感器退化)和任务,条形按数值排序,红色是本文的融合基线,深色高亮是完整的晚期融合模型,浅色是测试时留一模态消融。
4.2 传感器退化:差距在摄像头失效时拉开
表 2 是专门的退化测试集。晚期融合的深度 4.77 m、光流 2.12 px、平移 0.06 m、旋转 0.23°;V-JEPA 2.1 是 7.40 m / 10.85 px / 0.51 m / 0.43°,DINOv2 是 7.41 m / 19.97 px / 0.65 m / 0.58°。在正常条件下,深度差距是 1.65 m;退化条件下,和 V-JEPA 的差距变成 2.63 m,和 DINOv2 变成 2.64 m。原因不复杂:LiDAR 和 IMU 不受光照影响,事件相机在强光/逆光下也不会像普通相机那样整片过曝,融合表征因此多了一条退路。
4.3 消融:早期 vs 晚期、注意力范围、留一模态
早期融合 vs 晚期融合:早期融合深度 4.98/6.30 m、光流 2.01/2.45 px,晚期融合 4.73/6.08 m、1.97/2.39 px,晚期略好;但延迟上晚期在 5090 是 7.61 vs 11.35 ms,在 Orin 上是 112 vs 288 ms。也就是说,晚期融合不是用精度换速度,而是两边都略占。
管状注意力 vs 全注意力:w/ full attention 的精度和 tubelet attention 基本持平(深度 4.73 vs 4.73 m、光流 1.96 vs 1.97 px、分割 0.405 vs 0.411),说明精度主要来自「多模态 + 掩码重建」,注意力怎么因式分解不是瓶颈;但全注意力在长窗口、多模态下的计算量会迅速膨胀,作者选择 tubelet 是为了可部署性。
留一模态:这是最能说明各模态分工的消融。去掉 LiDAR 后,深度从 4.73 涨到 6.74 m,光流从 1.97 涨到 7.19 px,平移从 0.06 涨到 0.73 m;去掉 RGB 后,深度几乎不变(4.70),但分割从 0.411 掉到 0.366;去掉事件或 IMU,多数任务变化很小。作者的解释是:LiDAR 提供直接的几何信号,RGB 负责把其他模态的 token 锚定到像素对齐的语义上;事件和 IMU 的贡献被 5 Hz 的评测频率掩盖了——事件相机原生是微秒级,IMU 是 400 Hz,而探针按约 5 Hz 的窗口做预测,它们的高频信息根本用不上。这个结论对做多模态融合的人很重要:没看到收益,不一定是模态没用,可能是评测频率不对。
还有一个小细节值得注意:w/o IMU 的深度 4.67 m 比完整模型的 4.73 m 还略好,光流 2.05 比 1.97 略差,基本在噪声范围内。论文没有回避这一点,而是把它归入「IMU 在当前评测下贡献有限」。
4.4 数据缩放律:多模态也需要更多数据
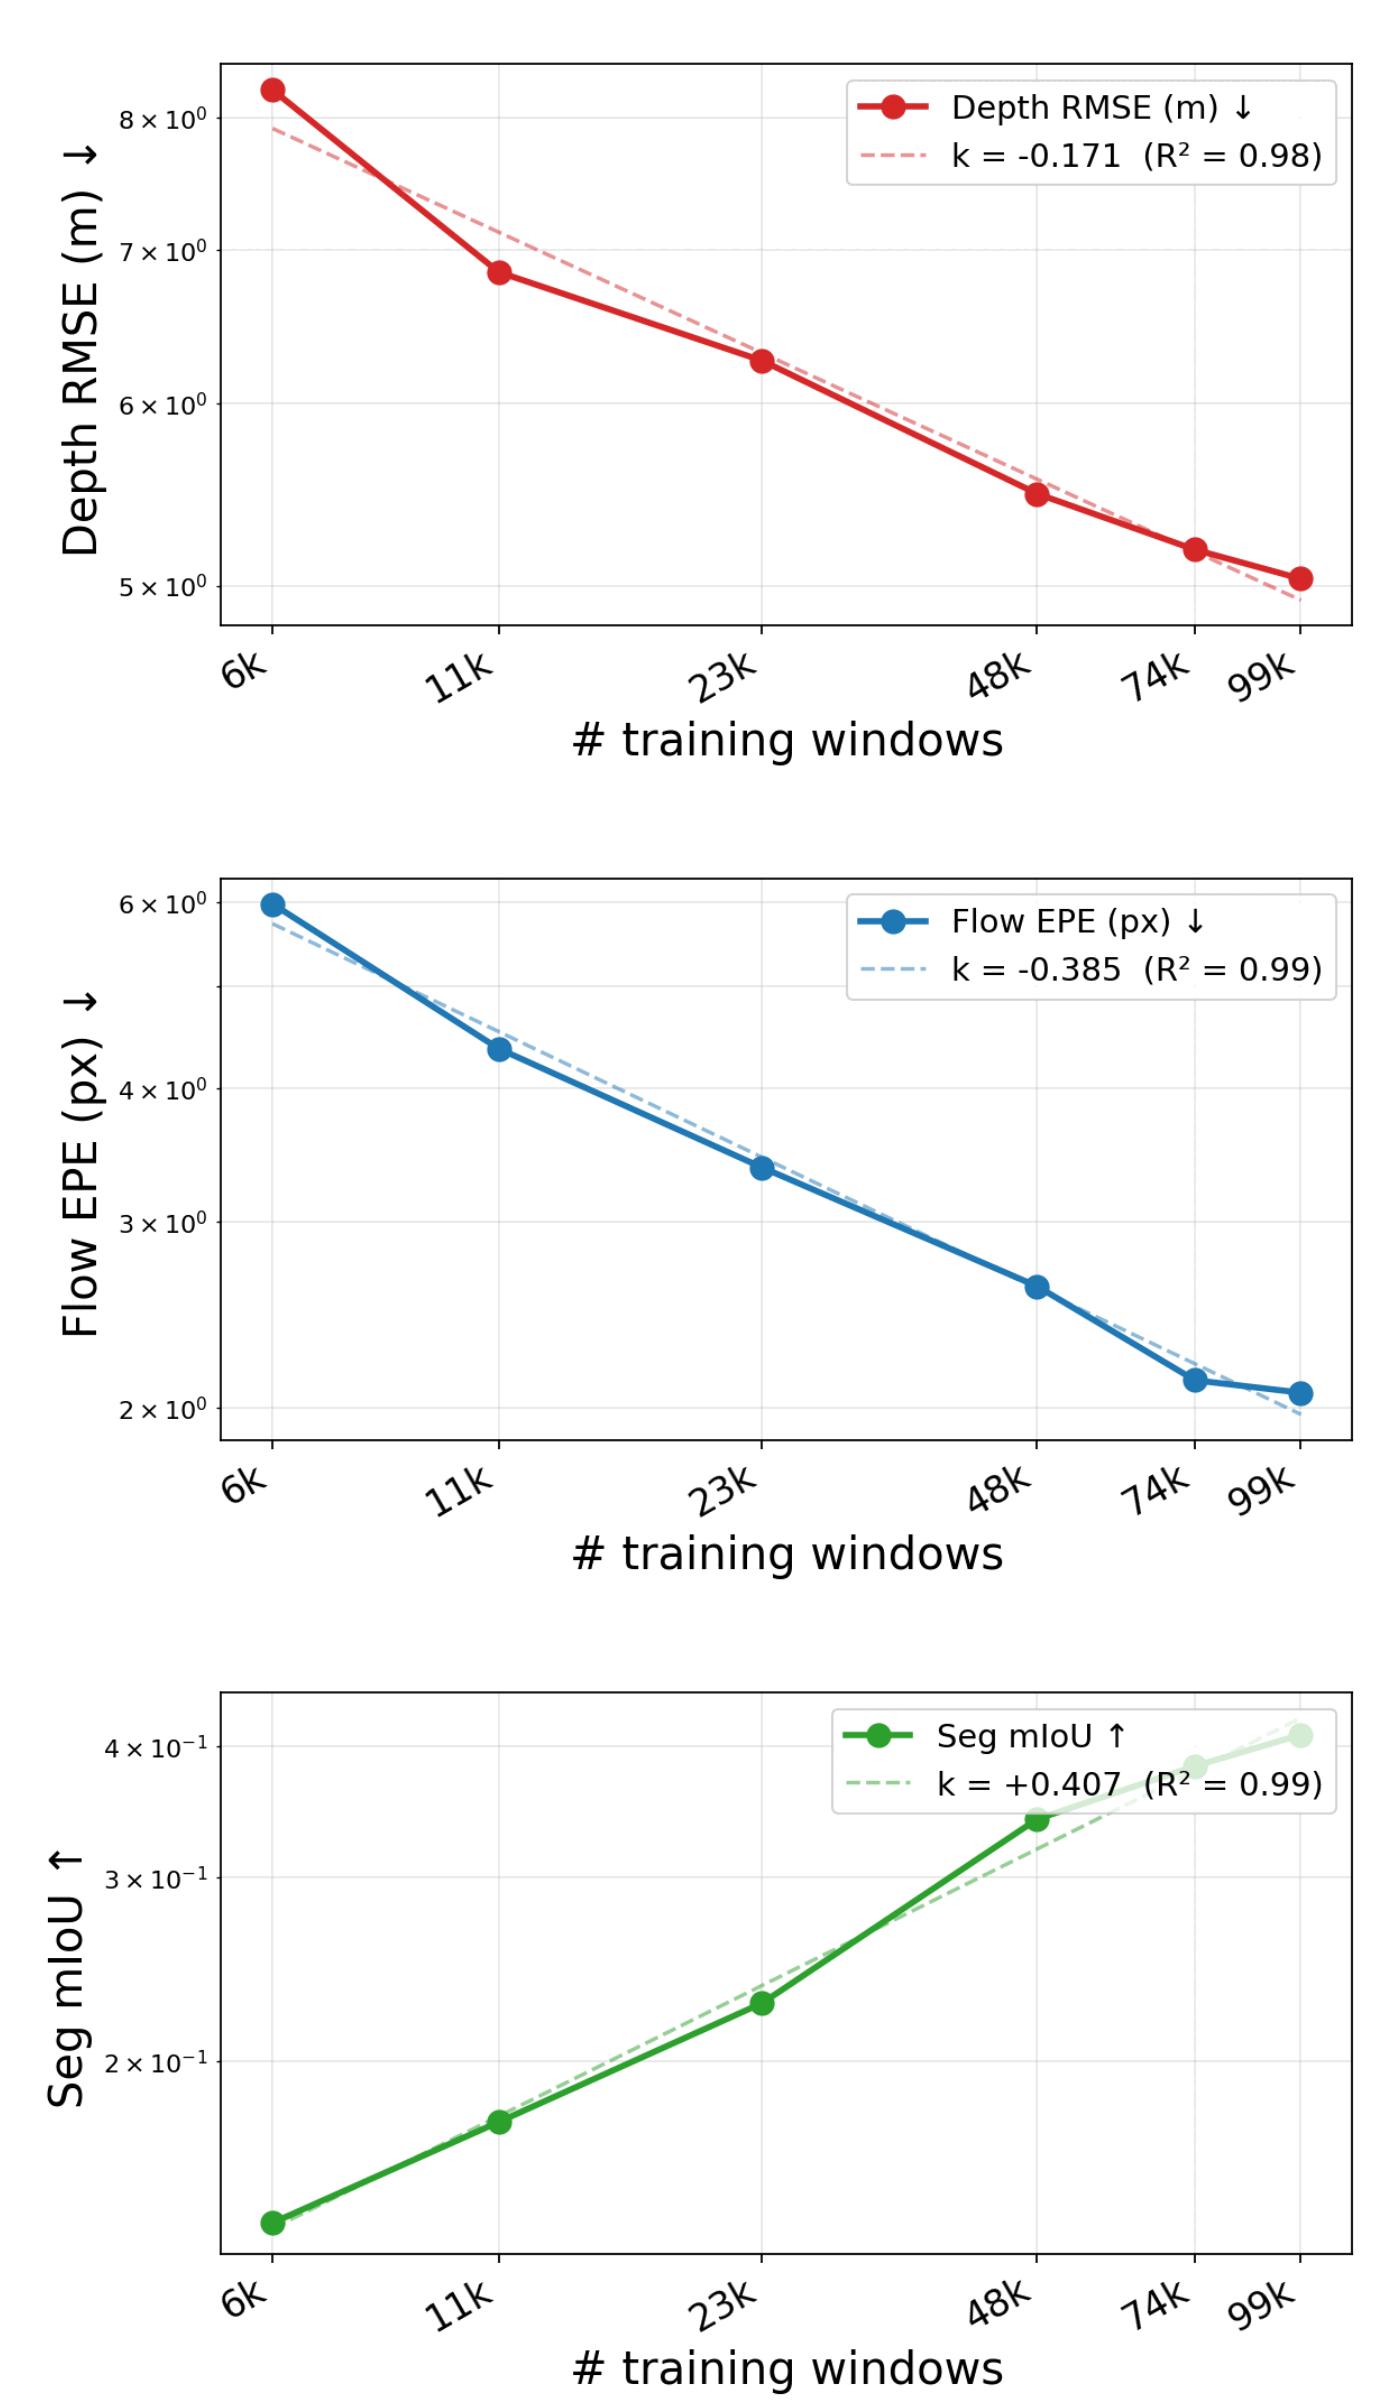
图 S17 把训练窗口数从 6K 扫到 99K,拟合幂律 。深度 RMSE 的指数 (),光流 EPE 的 (),分割 mIoU 的 ()。换算成「窗口数翻倍」:深度误差约乘 0.89,光流约乘 0.77,分割 mIoU 约乘 1.33。光流和分割的斜率明显更陡,说明它们从数据规模里获益更多;深度在 99K 窗口时已经比较平,继续加数据的边际收益在下降。
下面的部件把三条拟合曲线放在同一把滑块上:拖动窗口数,看三个指标的预测值怎么一起变。
4.5 跨数据集:M3ED 零样本迁移
在 M3ED 上,晚期融合的深度 9.05 m(V-JEPA 2.1 9.72 m、DINOv2 9.53 m),光流 1.60 px(V-JEPA 1.59 px,基本打平),自车运动 0.36 m / 0.82°(V-JEPA 0.22 m / 0.64°,排第二)。这个结果比表 1 冷静得多:稠密感知有优势,但自车运动输给了纯 RGB 的 V-JEPA。作者的解释是,M3ED 的传感器配置和 OctoSense 不同(事件相机型号不同,内外参也不同),而自车运动对几何标定和 IMU 噪声很敏感;能在这个条件下排第二,已经说明表征没有过拟合到自家平台。换一个角度读:多模态预训练的可迁移性,在稠密任务上比在 ego-motion 上更稳。
4.6 定性结果:重建与稠密预测
图 12 是重建。左列主要遮事件(RGB 49% / 事件 96% / LiDAR 95% / IMU 56% masked),右列主要遮 RGB(RGB 99% / 事件 89% / LiDAR 52% / IMU 81% masked)。即使某个模态 95% 以上的 token 被遮住,重建出的 RGB、事件、LiDAR 距离图仍然保留了主要结构;IMU 的六条曲线(accx/y/z、gyrx/y/z)也能大致跟上。这说明模型不是只学会了「复制可见 token」,而是真的在跨模态补全。
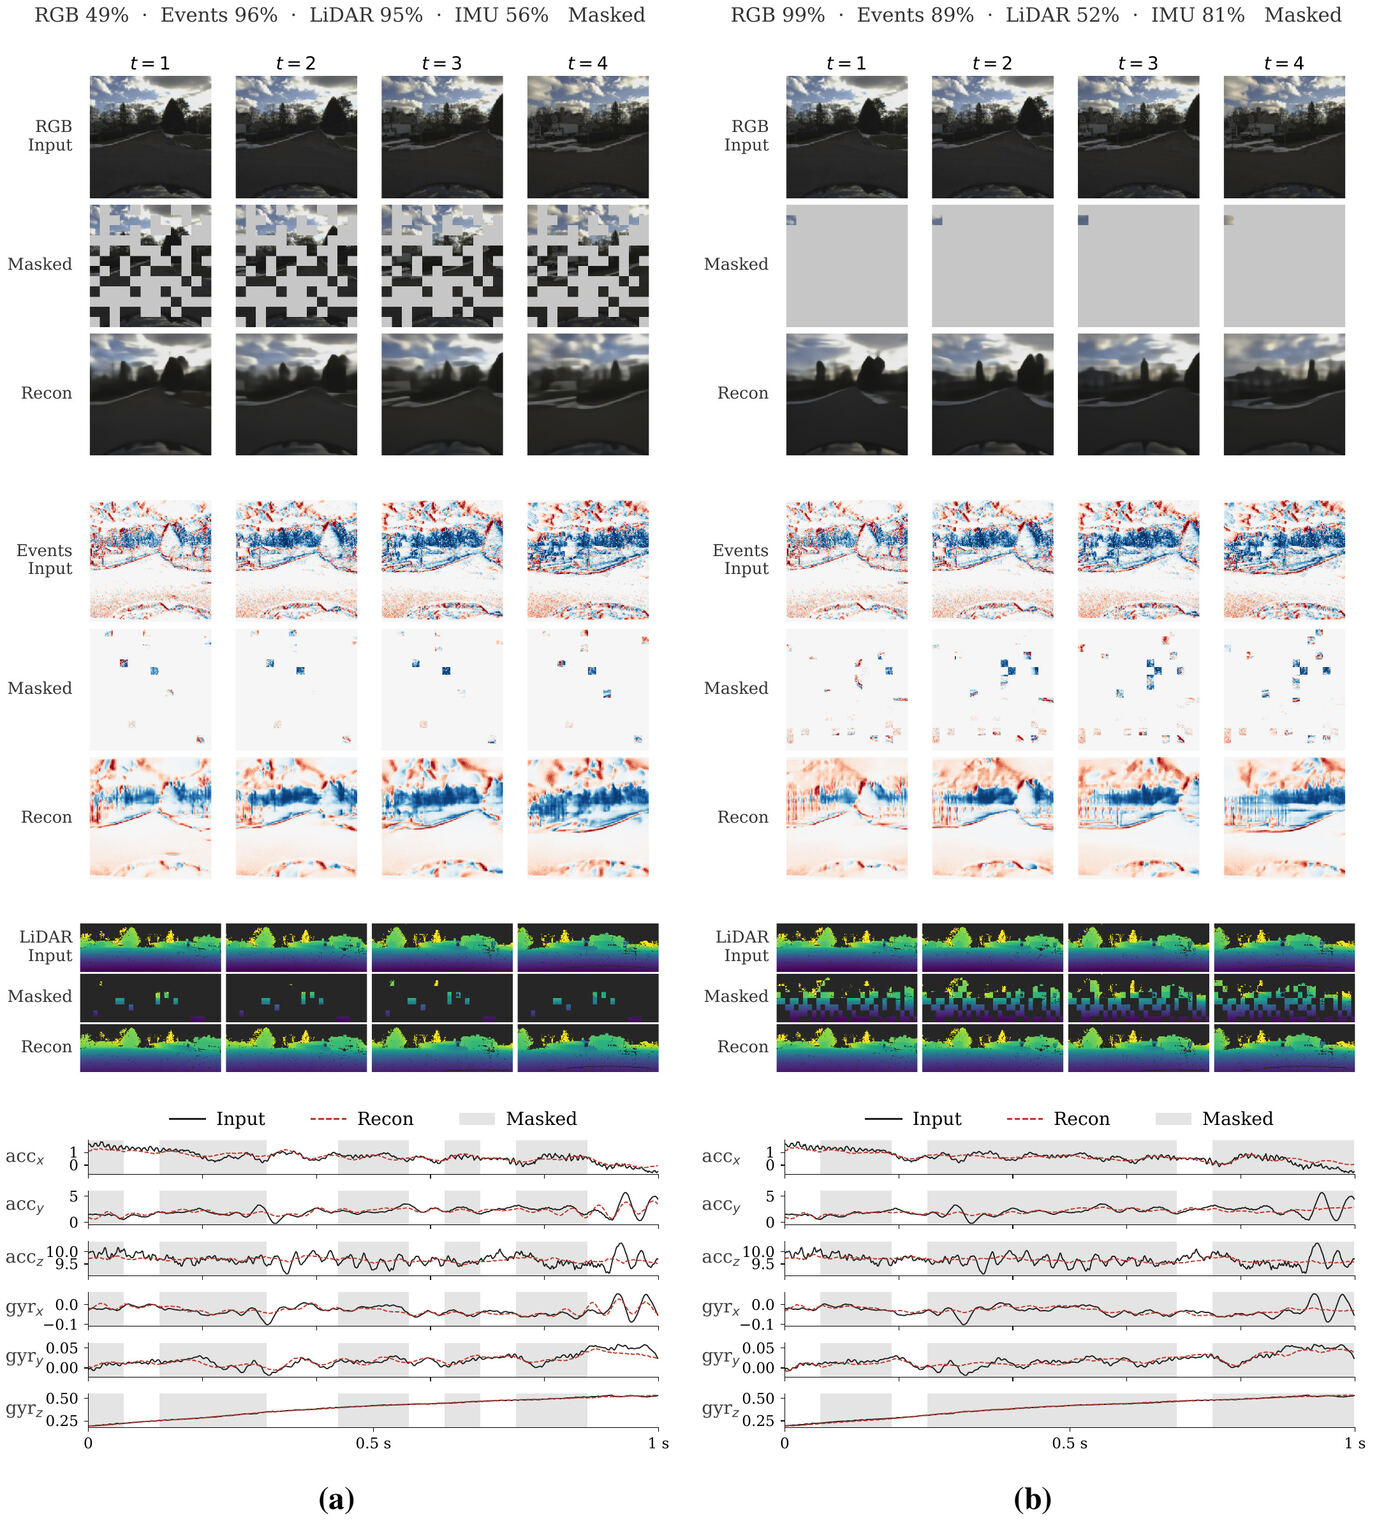
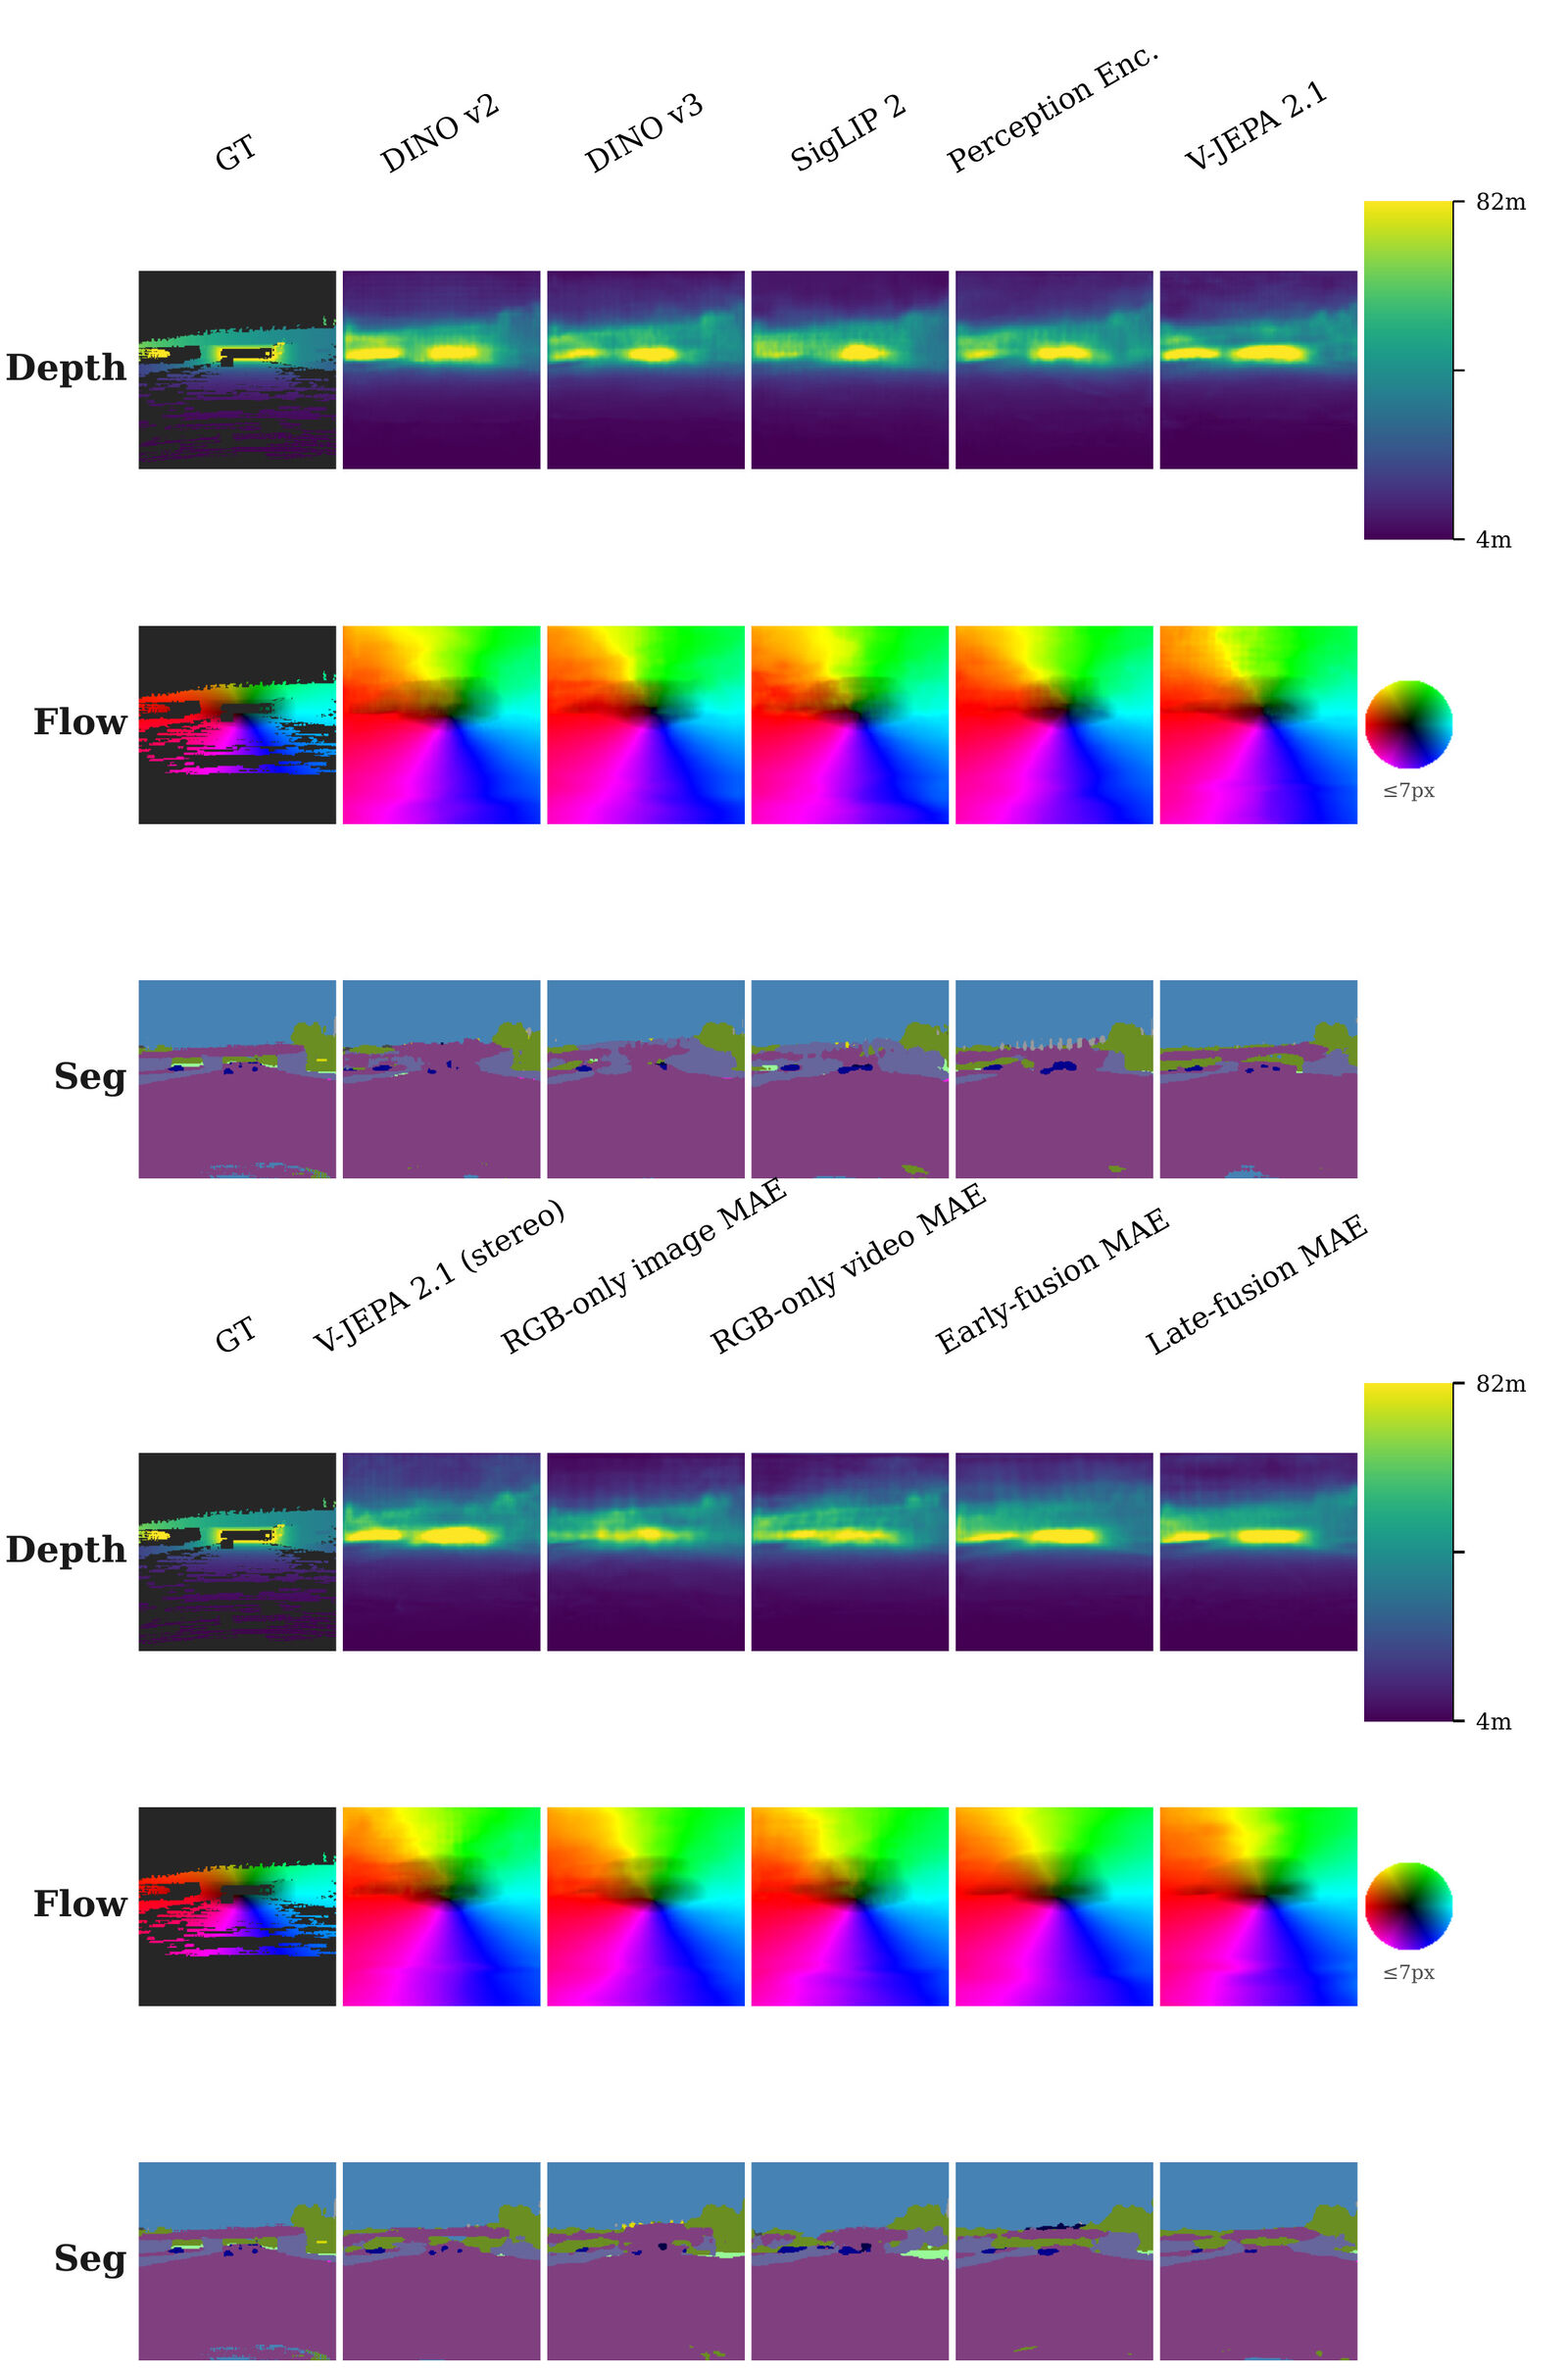
图 13 是稠密预测的定性对比。高速场景里,晚期融合的深度图在远处车辆和护栏上更干净,光流在道路边缘没有出现 DINO 系列那种大块拖影,分割的路面/车辆边界也更贴合 GT。这些视觉差异和表 1 的数字一致:光流的提升最大,分割最小。
五、局限性
先说论文自己承认的:
- 数据规模仍比基础模型小几个数量级。DINO / V-JEPA 的预训练数据是网络级规模,OctoSense 只有 59 小时;作者说要做「机器人感知 foundation model」,需要社区一起把数据池做大。
- 算力限制了模型规模。论文只训到 ViT-B 量级(编码器约 84 M 参数),没有探索更大的网络。
- 评测频率低估了事件相机和 IMU。探针按约 5 Hz 的窗口做预测,而事件是微秒级、IMU 是 400 Hz;作者把高速跟踪、低延迟机动留作未来工作。
- 未来方向是更长的时序窗口 + 循环架构,进而做目标跟踪、3D 实例检测(需要先补伪标注),以及分析多模态之间的冗余与协同。
再说我自己读出来的几点:
- 「八类传感器」是平台能力,不是表征能力。论文的模型只吃左 RGB、左事件、LiDAR、IMU 四路;右目、热成像、CAN / 关节角都没有进编码器(脚注明确说实验不用右目和热成像)。数据集比方法宽,这是好事,但也意味着热成像和本体感知的潜力还没被验证。
- 真值链是伪真值链。位姿来自 RKO-LIO,深度来自累积 LiDAR + YOLO 掩码 + 体素过滤,分割来自 DINOv2-based 的 EoMT。分割只比 DINOv2 高 0.001,很可能是因为「老师」就是 DINOv2 系;绝对 mIoU 0.41 也远低于监督 Cityscapes 的水平。读绝对数字时要把这层天花板放在心上。
- 零样本迁移不是全面领先。M3ED 上自车运动输给 V-JEPA,光流只是打平;论文的「全面超过」主要集中在同分布测试集和退化集。
- 延迟数字的边界要说清。6.68 ms / 112 ms 是 B=1、T=8、编译后的编码器前向,不含 tokenizer 前端和下游探针;它证明的是「融合表征够快」,不是「整个感知栈够快」。
- 时间同步的精度没有端到端统计。论文给了每个传感器的触发抖动 和滤波设计,但没有给同步后各模态时间戳的残差分布;对做融合的人来说,这比「用了 PPS」更值得关心。
- 代码开放程度有限。仓库只有平台和数据工具链,模型、训练、dataloader 都「将在以后发布」,也没有权重。这意味着论文的核心数字目前无法独立复现,能复现的是数据下载、可视化、GT 生成和语义检索。
六、结论与展望
OctoSense 的价值可以拆成两层。数据层,它把「多传感器同步采集」这件苦活做成了可复制的开源平台:自定义同步板、UID + PPS 协议、Kalibr 标定、LiDAR 累积 GT、语义检索,每一环都有代码和工程细节。方法层,它证明了在不追求超大模型的前提下,模态专用 tokenizer + FSQ 离散目标 + 晚期融合,已经足以让冻结表征在深度、光流、自车运动上明显超过 RGB 基础模型,而且在车端芯片上跑得动。
如果让我给实践者提三条建议:
- 先做模态专用分词器,再谈融合。直接把不同频率、不同统计的传感器拼进一个 Transformer,训练会很脆;FSQ 把异构输入统一成离散目标,是一个便宜且有效的抓手。
- 把「留一模态」和「退化/夜间」当成一等公民。多模态的卖点不是平均性能,而是某一路失效时的鲁棒性;评估协议里如果没有这些切片,融合的收益会被平均值掩盖。
- 评测频率要匹配传感器。事件和 IMU 在 5 Hz 的探针下几乎不贡献,不代表它们没用;做高速跟踪、低延迟控制时,它们才是主角。
局限也很清楚:数据规模、伪真值、未开源的模型代码、以及只覆盖四路模态的表征。下一步如果作者放出训练代码和权重,或者把热成像、右目、本体感知接进来,这篇论文的上限还会再抬一截。
七、上手:只跑数据工具链
官方仓库明确写了:本次发布只包含平台和数据工具链,多模态 MAE 的模型、训练和 dataloader 代码尚未开源。所以下面只演示数据侧的安装、下载、可视化和语义检索;不猜模型命令,也不拿第三方复现凑数。
安装用 conda,环境里带 FFmpeg 和 CPU 版 PyTorch;有 CUDA 的话按 README 的兼容表换 GPU wheel:
安装命令(conda 环境 + 可选 GPU wheel)
git clone https://github.com/anthonytec2/OctoSense.git
cd OctoSense
conda env create -f environment.yml
conda activate octosense
# 有 CUDA GPU 时,按 torchcodec 兼容表重装 GPU wheel:
pip install 'torch==2.12.*' 'torchvision==0.27.*' 'torchcodec>=0.14' \
  --index-url https://download.pytorch.org/whl/cu130
数据在 Hugging Face 上,用仓库自带的下载脚本按平台、序列、模态挑。事件流占每段序列约 78% 的字节,只想先看看数据的话可以 --no-events:
下载数据(整车 / 单序列 / 跳过事件流)
pip install huggingface_hub

# 所有汽车序列(完整,含事件流)
python download_octosense.py --platform car --out ./octosense

# 跳过 events.h5,节省约 78% 的下载量
python download_octosense.py --platform car --no-events --out ./octosense

# 单个序列,只取核心 LiDAR/IMU/GPS + 深度 + 分割
python download_octosense.py --sequence rosbag2_2026_01_04-13_51_24 \
  --modalities data,depth,seg
可视化用 Rerun,一条命令把 LiDAR、双目 RGB、重建事件视频、深度、GPS、IMU、CAN 和 caption 放到同一条时间轴上:
生成 Rerun 可视化
python data_processing/viz/rerun_viz.py --dir <sequence_dir>
# 默认只渲染窗口;--full 渲染整段约 10 分钟的序列
语义检索可以下载预建索引(约 700 MB),用 CPU 直接查;网页 UI 需要把 DATA_BASE_PATH 指到包含 <session>/<bag>/img_left.mp4 的数据根目录,否则只能看文字结果、视频片段会 404:
语义检索(CLI 查询 + FastAPI 网页)
# 下载预建索引
hf download anthonytec2/OctoSense --repo-type dataset \
  --include "semantic_search/*" --local-dir ./octosense

# CLI 查询
cd data_processing
python -m sem_search.main query "a car turning left at dusk" \
  --index-dir ../octosense/semantic_search

# 网页 UI,浏览器打开 http://localhost:8000
DATA_BASE_PATH=./octosense/car python -m sem_search.main serve \
--index-dir ../octosense/semantic_search --port 8000一个容易踩的坑:timesync/ 产出的主 HDF5 叫 <bag_id>.h5(例如 rosbag2_2026_01_04-13_51_24.h5),但 Hugging Face 上发布时统一叫 data.h5;下游的 lidar_cal/、depth_gt/、seg_gt/ 按 <bag_id>.h5 找文件,所以对下载的序列跑这些阶段前,要先把 data.h5 重命名或软链成 <bag_id>.h5。另外,GT 生成和建索引需要 GPU;只查询已有索引时 CPU 就够。
参考
- Bisulco, Wang, Daniilidis, Balestriero, Chaudhari. OctoSense: Self-Supervised Learning for Multimodal Robot Perception. arXiv 2606.27317, 2026. arXiv · 代码
- Oquab, Darcet, Moutakanni, Vo, Szafraniec, et al.. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv · 代码
- Siméoni, Sibalis, Vo, Baldassarre, et al.. DINOv3. arXiv 2508.10104, 2025. arXiv · 代码
- Tschannen, Gritsenko, Wang, et al.. SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features. arXiv 2502.14786, 2025. arXiv
- Bolya, Huang, Sun, Cho, Madotto, Wu, Kim, Hoffman. Perception Encoder: The best visual embeddings are not at the output of the network. arXiv 2504.13181, 2025. arXiv · 代码
- Mur-Labadia, Muckley, Bar, Assran, Sinha, Rabbat, LeCun, Ballas, Bardes. V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning. arXiv 2603.14482, 2026. arXiv
- Chaney, Cladera, Lucas, Bisulco, et al.. M3ED: Multi-Robot, Multi-Sensor, Multi-Environment Event Dataset. CVPR Workshops 2023. CVF
- Furgale, Rehder, Siegwart. Unified Temporal and Spatial Calibration for Multi-Sensor Systems. IROS 2013. IEEE · 代码
- Malladi, Guadagnino, Lobefaro, Stachniss. A Robust Approach for LiDAR-Inertial Odometry Without Sensor-Specific Modeling. IEEE RA-L, 2026. arXiv · 代码
- Sapkota, Cheppally, Sharda, Karkee. YOLO26: Key Architectural Enhancements and Performance Benchmarking for Real-Time Object Detection. arXiv 2509.25164, 2025. arXiv
- Kerssies, Cavagnero, Hermans, Norouzi, Averta, Leibe, Dubbelman, de Geus. Your ViT is Secretly an Image Segmentation Model. CVPR 2025. arXiv · 代码
- Gemma Team, Google DeepMind. Gemma 4. Google DeepMind, 2026. 模型页
- Qwen Team. Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models. arXiv 2506.05176, 2025. arXiv
- Johnson, Douze, Jégou. Billion-scale Similarity Search with GPUs. IEEE Transactions on Big Data, 2019. arXiv · 代码
- Mentzer, Minnen, Agustsson, Tschannen. Finite Scalar Quantization: VQ-VAE Made Simple. ICLR 2024. arXiv · 代码
- Bachmann, Mizrahi, Atzmon, Zamir. MultiMAE: Multi-modal Multi-task Masked Autoencoders. ECCV 2022. arXiv · 代码
- Mizrahi, Bachmann, Atzmon, Zamir. 4M: Massively Multimodal Masked Modeling. NeurIPS 2023. arXiv · 代码
- Ranftl, Bochkovskiy, Koltun. Vision Transformers for Dense Prediction. ICCV 2021. arXiv · 代码