· 69 min read
论文解读:DaD,用强化学习训练不依赖描述子的关键点检测器
TL;DR DaD 把关键点检测器看成一个在图像网格上输出概率分布的策略,用 REINFORCE 直接最大化两视图可重复性奖励——训练时既不需要描述子,也不需要 feature track[1]。它最关键的一步不是损失函数,而是采样:把 DeDoDe v2 推理时用的 KDE 平衡、NMS、确定性 top-K 搬到训练里,既避免 on-policy 采样塌缩到单个峰,又让训练和推理看到同一种点。作者随后发现一个更根本的现象:旋转增广会让检测器二选一,只检测亮关键点或只检测暗关键点,ALIKED 和 REKD 也有同样的偏好。DaD 不硬掰,而是训练亮、暗两个专家,再用逐点最大(pointwise max)蒸馏成一个。512 个关键点时,MegaDepth1500 的 E/F AUC@5° 为 64.9/50.6,ScanNet1500 为 25.7/18.3,HPatches AUC@3px 为 58.2,五个基准全部最好;但到 8192 个关键点,优势明显收窄,HPatches 和 ScanNet F 上被基线反超。代码 MIT 开源,PyPI 上可以直接
pip install dad-detector。
- 论文:DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection,Johan Edstedt、Georg Bökman、Mårten Wadenbäck、Michael Felsberg,Linköping University / Chalmers,arXiv 2025-03-10(v2 03-11)。
- 代码:github.com/Parskatt/dad(MIT,PyPI
dad-detector0.2.2) - 前作:DeDoDe、DeDoDe v2、S-TREK、REKD;站内可以先看 SuperPoint 这类检测器-描述子一体的做法。
一、动机:检测器被描述子和匹配器绑住了
SfM、SLAM、视觉定位都要先在两幅图之间找到对应点,而对应点的起点是关键点检测器。以 COLMAP 为代表的大规模 SfM 流程[2]尤其依赖稳定、可重复的稀疏关键点。传统流水线是「检测 → 描述 → 匹配」:检测器每张图独立选点,描述子给每个点一个向量,匹配器(最近邻、SuperGlue、LightGlue)再把两个向量集合对齐[3, 4]。问题在于,这个流水线里的检测器并不是为「可重复性」训练的,而是为「描述子最近邻」训练的:一个点只有在两张图里都被检测到、而且描述子足够近,才算一条有效匹配。于是检测器继承了描述子的偏好,描述子和检测器共享权重,匹配器又依赖描述子,三者越绑越紧。
另一条路是无检测器匹配(detector-free):LoFTR、RoMa 这类方法直接为像素估计稠密对应,不再依赖检测器,精度和鲁棒性都很好[5, 6]。但它们没有关键点,也就没有天然的 feature track;要做大规模 SfM,还得把稠密对应「吸附」回离散的关键点上,多一层启发式。
所以近年出现了一批解耦检测器的工作:DeDoDe 先检测、再用独立的描述子描述[7];ALIKED 用可变形卷积做轻量检测和描述[8];REKD 用旋转等变网络直接学可重复的关键点[9];S-TREK 也用可重复性奖励做强化学习[10]。它们都在试图回答同一个问题:能不能只优化「这个点会不会在另一张图里再出现」,而不经过描述子?
DaD 的回答是把检测器写成一个策略,把「两张图里的检测能不能对上」写成奖励,然后用策略梯度直接优化。这样训练信号就是可重复性本身,不再有描述子或 track 作为中间人。但直接这么做会遇到两个坑:
- 采样塌缩:如果每张图独立地从 softmax 分布里抽 K 个点,模型很快会把概率集中到一个峰或一小片区域,K 个点全挤在一起,奖励上去了,但检测器只学会了一个点。
- 多样性退化:即使采样不塌缩,模型也会发现「只选亮像素」或「只选暗像素」能拿到同样高的可重复性奖励,于是主动放弃另一半关键点。
这两点分别对应论文的两个核心设计:平衡 top-K 采样,以及亮/暗专家蒸馏。论文的贡献也按这个线索展开:
- 一个不需要描述子、不需要 track 的关键点检测 RL 目标,包含对齐的采样、奖励归一化和正则化;
- 对 RL 训练中涌现出的检测器类型(亮/暗、bouba/kiki)的观察;
- 逐点最大蒸馏,把两个专家合成一个更多样的检测器;
- 在 512 到 8192 个关键点的预算上系统比较,低预算时达到新的 SotA。
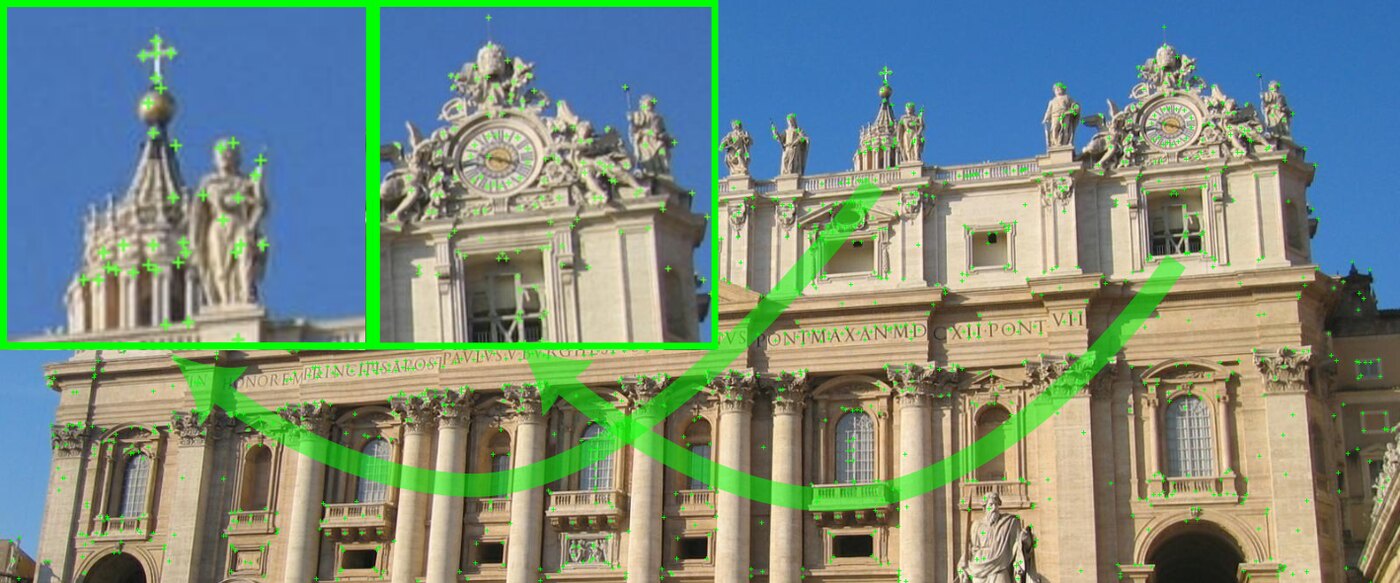
二、核心方法
2.1 把检测器写成概率分布
给定图像 ,网络输出一张与原图同分辨率的 scoremap ,把它当成 logits,在整张图的网格上做 softmax:
于是一次检测就是从 里抽一组点 。这个视角的好处是:检测器不再输出「分数」,而是输出一个可以在训练时采样、在推理时取 top-K 的分布。K 个点的联合概率是各点概率的乘积,log 概率是求和,正好适合策略梯度。
网络结构沿用 DeDoDe-S:VGG11 编码器保留 stride 1/2/4/8 四层,通道数 64/128/256/512;解码器每个 stride 由 3 个 [5×5 深度可分离卷积, BatchNorm, ReLU, 1×1 卷积] 组成,并把上一级解码器的输出拼进来。最终输出一张稠密的 scoremap;推理时再从中选点。
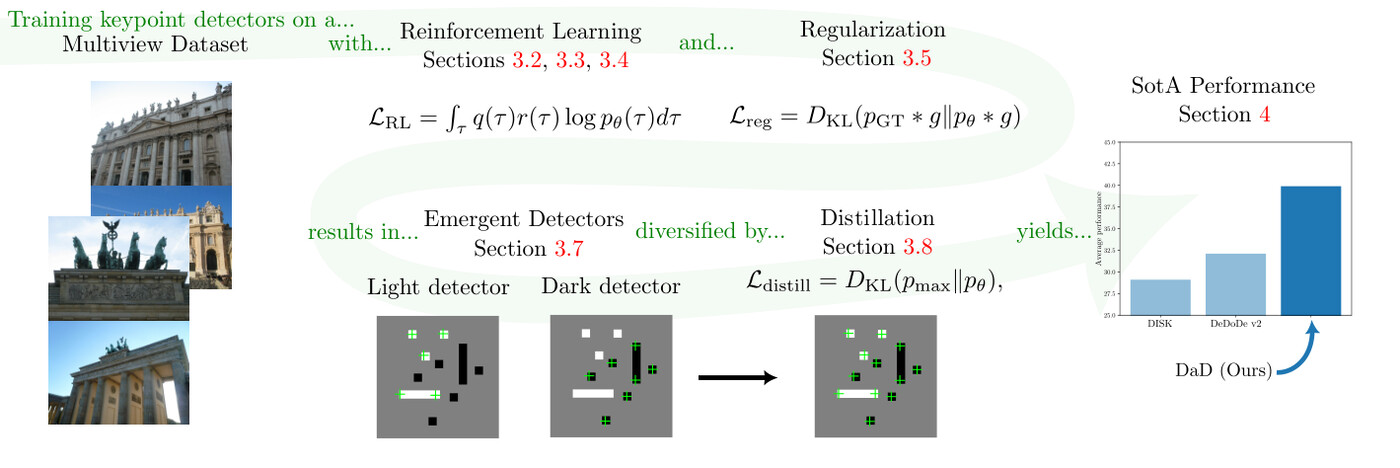
2.2 奖励:两视图可重复性,不需要 feature track
对一对图像 ,从采样分布 里取 对候选对应点 。奖励定义为:把 用深度 和相对位姿投影到 ,如果投影点与 的像素距离小于阈值 ,奖励为 1,否则为 0:
注意这里没有任何描述子:对应关系是用深度和位姿算出来的,奖励只问「两个检测是不是同一个 3D 点」。这正是它和 DISK、S-TREK 那一类工作的区别——不需要预先建 track,也不需要可微的匹配器。训练时用 DISK 式的双向最近邻建立候选对应[11]:对 A 中每个点用深度投影到 B 找最近邻,反过来也做一遍;在深度无效或遮挡的区域不做匹配,并用 masked log-softmax 保证不可见的点不被惩罚。
策略梯度的目标是让高奖励的配对概率变大:
实现时取负号当损失。期望是在另一个分布 上取的(off-policy), 就是下一节的平衡 top-K 采样器;论文沿用 S-TREK 的做法,没有再乘 的重要性权重。严格说这优化的不是 的无偏梯度,而是一个 加权的代理目标——这一点我放到局限性里再展开。
奖励归一化是第二个容易忽略的细节。常见的 advantage 写法是 ,但论文发现减法形式会让稀有但有效的关键点拿到负奖励,概率被往下压,模型过早收敛到一小撮「稳赚」的点。他们改用除法:
这样所有奖励都非负,梯度只会「提高」被选中点的概率,只是提高的幅度按该图像对上的相对成功率缩放; 防止 时梯度爆炸。论文还试过线性递减的奖励(越准奖励越高),关键点确实更亚像素,但位姿估计反而更差,作者猜测是因为点变得不够多样。
2.3 采样:KDE 平衡 + NMS + 确定性 top-K
现在回到开头的采样塌缩。论文要求采样满足三个性质:
- 稀疏(sparsity):不能把一整片区域或一条线都选上,否则「检测到一片」并不构成可重复的关键点;
- 多样(diversity):点要覆盖整张图,不能全挤在纹理最强的角落;
- 优先(priority):如果一个点在两幅图里的检测概率都高于另一个点,它应该总是排在前面。
他们直接借用了 DeDoDe v2 推理时的采样器,但做了一件 DeDoDe v2 没做的事:训练时也用它[12]。具体分三步。先对 做高斯核密度估计:
再用它把原始分布压平:
指数 的作用是:一个点周围的密度越高,它被压得越狠;孤立的高分点几乎不被惩罚。接着做窗口为 3 的 NMS,最后确定性地取分数最高的 K 个点:
三个性质分别由三步保证:NMS 保证稀疏,KDE 保证多样,top-K 保证优先。top-K 还有一层方差上的理由:如果按 随机抽 K 个点,一个真实关键点即使概率是 ,也有 的概率一次都抽不到;当 时这个概率很大,梯度估计会非常抖。确定性 top-K 直接消灭了这种方差。
下面的部件把一维的分数曲线画出来:左边是密集的纹理区,中间是稀疏区,右边是一个孤立强峰。拖动 看平衡强度,取消 NMS 看重复选点。论文里固定用 。
浅色实线 p,虚线 pg,主题色 q;圆点是选中的 14 个点。
有两个细节值得记住。第一,这套采样训练和推理都用,但推理时去掉了 KDE 平衡,只保留 NMS 和 top-K,另外加了 ALIKED 式的亚像素修正:在每个点周围做一个 、温度 的局部 softmax,用期望代替格子中心。论文没有解释为什么推理时去掉 KDE;从结果看,去掉后点更集中在高分区域,位姿估计更准,但这也意味着训练和推理的采样分布并不完全一致。第二,KDE 的 取图像尺寸的 2%,NMS 窗口是 3 像素;这两个数决定了「多大范围算一个点」和「多远的两个峰算重复」,论文没有给出逐项消融。
2.4 正则化:别让奖励把点带到奇怪的地方
只有可重复性奖励还不够。RL 可以找到一些「两张图都能重复检测、但对 SfM 没用」的点,比如深度不连续处的边缘。论文加了一个很轻的正则项,沿用 DeDoDe 的做法,把预测的 scoremap 拉向「深度估计有效」的区域:
其中 是每张图「深度估计是否成功」的指示分布, 是 像素的高斯核。注意两侧都先做了高斯平滑,所以这不是逐像素的强监督,而是一个粗粒度的空间先验:关键点可以不在深度图上,但不要整体漂到深度无效的区域。总损失就是
论文说正则权重在一个数量级内变化时性能都很稳定;这一点比很多需要精细调权的工作省心。
2.5 意外发现:检测器会变成「只亮」或「只暗」
训练收敛后,作者发现同一个目标会收敛出两种截然不同的检测器:一种专门检测亮关键点(亮检测器),一种专门检测暗关键点(暗检测器)。这不是随机噪声,而是一个可以用玩具模型解释的必然结果。
设想两张图,每张图有 10 个白点和 10 个黑点,位置完全随机;同一个编号的白点(或黑点)在两张图里是同一个 3D 点。每张图最多选 10 个点,命中一个编号相同的点得 1 分。三种策略的期望得分是:
- 选 5 个白点 + 5 个黑点:两张图独立选,白点期望重合 个,黑点同理,总共 5 分;
- 只选 10 个白点:两张图都会把 10 个白点全选中,10 分;
- 只选 10 个黑点:同样 10 分。
「看起来最均衡」的 5/5 策略,期望反而只有极端策略的一半。原因是:你选得越专一,两张图选到同一批点的概率越高;你想两头兼顾,就两头都不重合。下面的部件就是这个玩具模型,拖动 看期望怎么从 5 变到 10。
每张图固定选 10 个点(nw 个白 + nb = 10 − nw 个黑),两张图独立选;实线连接的是「两张图都选中了同一个编号」的点,也就是命中。位置是随机布局,只用于示意。
论文把这个玩具模型当作一个警示:可重复性和多样性在这里是直接冲突的。要拿到高奖励,最省力的方式就是放弃一半关键点。实际训练里,旋转增广会让这个冲突显形:如果只做直立训练,检测器会有很强的方向偏置(只检测白色圆形的右下角),但不会二选一;一旦加上 的旋转增广,它就会退化成亮检测器或暗检测器。
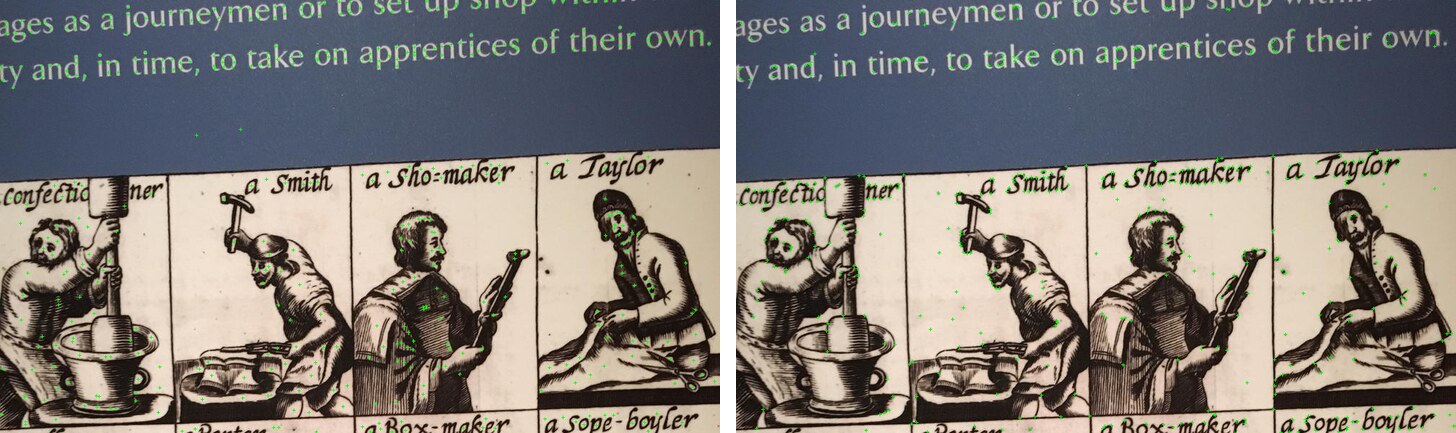
这不是 DaD 独有的毛病。作者把 ALIKED 也拿出来做对照:未做旋转增广的 ALIKED 有明显的直立偏置(只检测白色圆形的右下角),做了旋转增广之后同样变成亮/暗二选一;REKD 用的是旋转等变架构而不是增广,也仍然只检测暗点。换句话说,只要优化旋转不变的可重复性,检测器就会在亮/暗之间做选择,跟具体是增广还是等变架构无关。
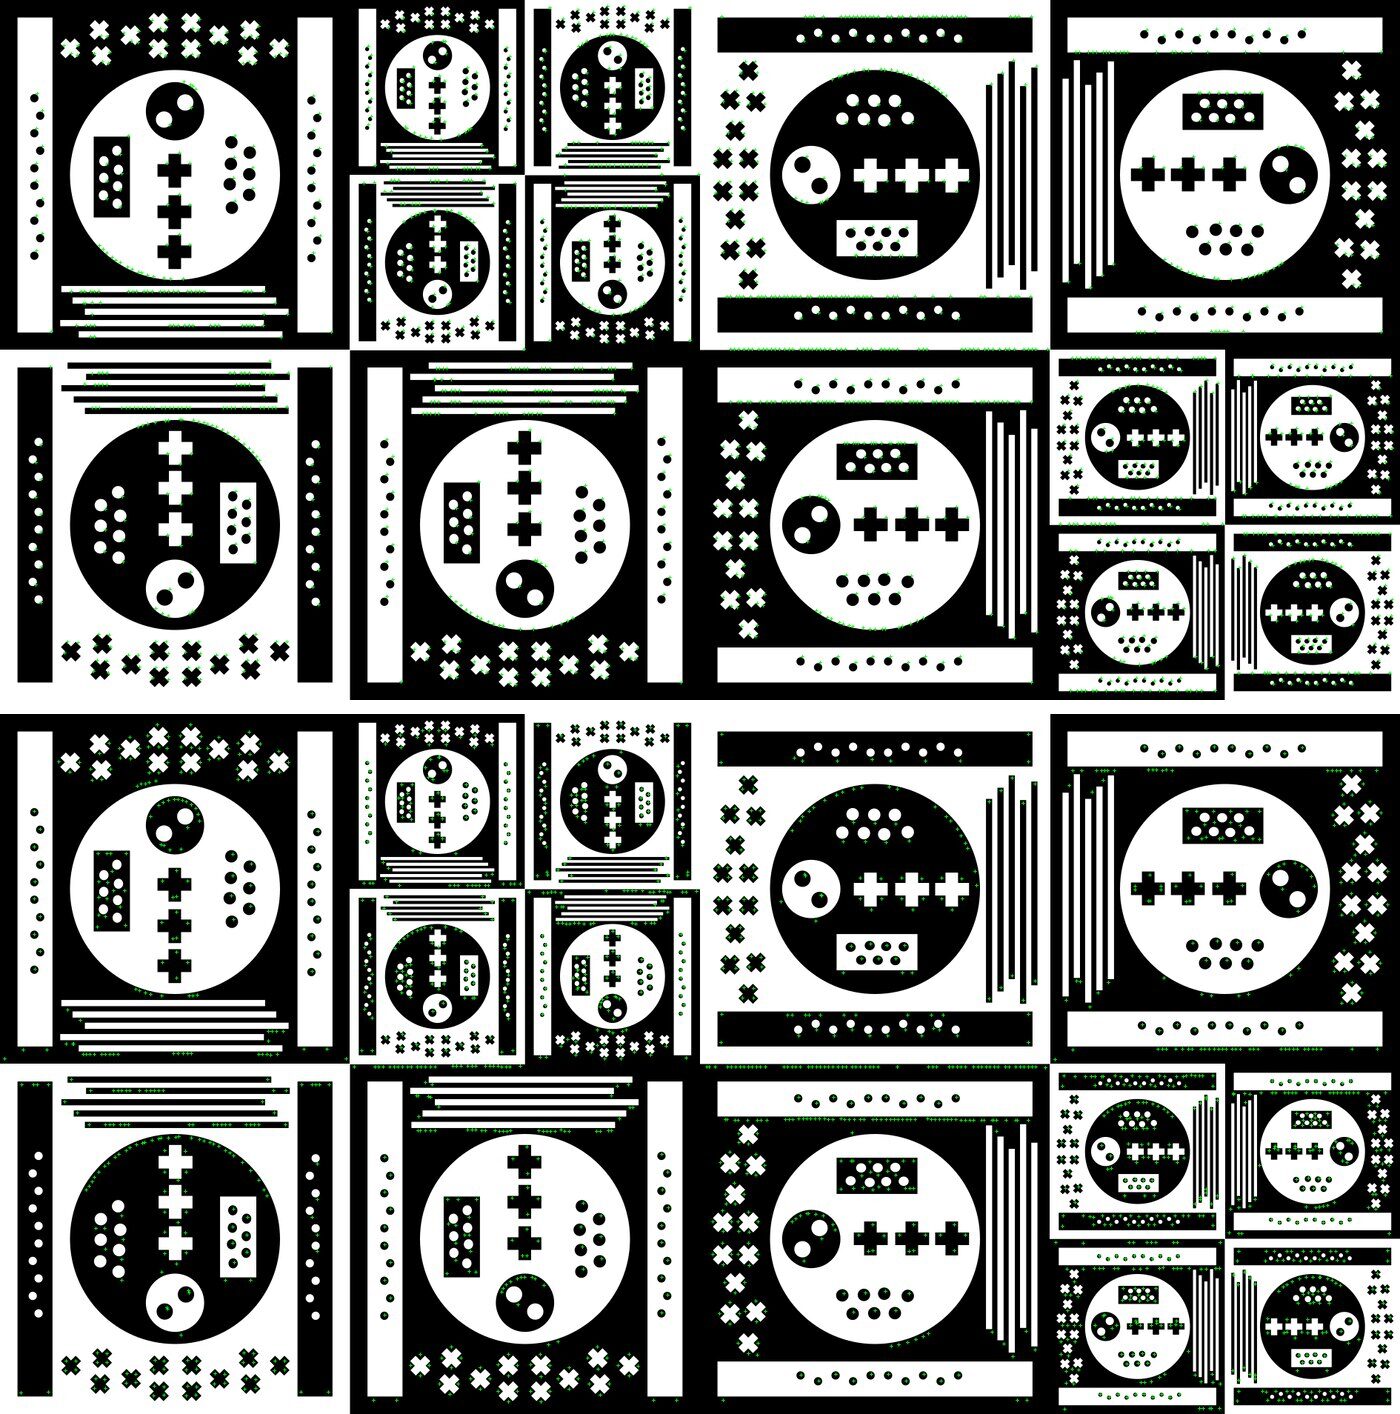
作者也试过用图像取反(negation)做增广,想把两类点强行拉回来,结果性能明显下降。于是他们换了个思路:不跟这个现象对抗,而是把两种专家都训练出来,再蒸馏成一个。
2.6 蒸馏:逐点最大,而不是平均
设亮检测器和暗检测器的分布分别为 、。蒸馏目标不是两者的平均,而是广义平均:
其中 。 就是算术平均, 是均方平均, 是逐点最大:
学生网络用 KL 散度拟合这个目标:
为什么是 max?论文给了一个很直观的解释和一个小定理。平均会把两个峰往中间挪,乘积会把峰削窄、把只有一个检测器强的位置压到接近零;而逐点最大在「两个分布的关键点互为伙伴」的假设下,会保留两个分布各自的局部极大值,也不会在别处凭空造出新峰。代价是「被吞并」(subsumed)的峰可能消失:如果某个峰在另一个分布的同位置上始终更弱,它本来也不该单独算一个关键点。实际使用中,亮/暗两个专家的峰大多落在不同的位置,所以 max 近似于「两套关键点的并集」。
下面的部件把四种组合画出来:原始 与 、平均、相乘、逐点最大。拖动 移动暗检测器的峰,观察局部极大值的数量和位置。
还差一个「为什么 KL 的方向是这个方向」的细节。论文用的是 ,目标在前、学生在后。这个方向的 KL 对「目标有质量、学生却给了零」的位置惩罚趋于无穷,所以学生必须覆盖目标的所有峰,不能只挑一个;反过来 会鼓励学生只拟合一个峰(mode-seeking),正好会退化成单类型检测器。蒸馏能保住亮/暗两类点,KL 的方向也有一份功劳。
消融结果(表 1,MegaDepthIMCPT 上 E/F 平均 AUC@5°)说明两件事。第一,蒸馏本身的收益比合并规则更大:512 个点时,亮专家 50.2、暗专家 50.0,蒸馏后 51.0;8192 个点时,55.9/55.7 → 56.5。第二,max 相对平均的收益不大但方向一致:论文说约高 0.3 分;按表算,max 相对 在五个预算上的差分别是 0.3/0.1/0.0/0.2/0.5 分;1024 个点时 反而比 max 高 0.3 分(54.1 对 53.8)。所以「max 更好」是一个统计上站得住、幅度上不要夸大的结论。论文还试过把蒸馏后的学生再用 RL 微调,结果它又退化回单类型——这进一步说明亮/暗偏好是目标的内在属性,不是初始化碰巧。
2.7 架构与训练细节
训练在 MegaDepth 上做,图像缩放到 640,随机做 旋转;AdamW,解码器学习率 ,编码器 。暗检测器训练 60 万对,亮检测器 80 万对,蒸馏再 80 万对,每次约 10 小时 A100。推理时图像长边缩放到 1024,NMS 窗口 3,去掉 KDE 平衡,加 的局部 softmax 亚像素修正。
这里有个容易被忽略的工程点:训练时的 K=512 只是采样预算,不是模型容量。scoremap 是稠密的,推理时可以取 512、1024、2048、4096、8192 个点;论文的所有基准都按这五个预算报告。低预算时检测器的「选点质量」最重要,高预算时只要分数图大致靠谱,多取点总能覆盖到足够多的好点——这也解释了后面结果里的一个规律:DaD 的优势集中在低预算。
三、实验
3.1 设置
三个基准:
- MegaDepth1500:1500 对室外图像,来自圣彼得大教堂和勃兰登堡门,重叠率 ,分别估计 Essential 和 Fundamental 矩阵,报告位姿 AUC@5°[5, 13];
- ScanNet1500:1500 对室内图像,重叠率 ,同样报告 E/F 的 AUC@5°[14];
- HPatches:116 个序列,主要看视角变化子集,估计单应矩阵,报告角点 EPE 的 AUC@3px[15]。
匹配协议是这篇论文比较特别的地方:为了只评估检测器,他们不训练描述子,而是用一个独立的稠密匹配器 RoMa 来匹配关键点[6]。对 A 中每个点采样 RoMa 的稠密 warp 得到 B 中的对应点,再和 B 的检测点做双向最近邻,距离阈值是图像尺寸的 0.25%;然后用 PoseLib 的 RANSAC 估计位姿,阈值 2 像素,跑 5 次取平均,减少 RANSAC 随机性[16]。图像缩放和推理设置沿用 LightGlue 的协议[17]。基线包括 SuperPoint、ReinforcedFP[4, 18]、ALIKED、ALIKED(旋转增广)、REKD、DISK、DeDoDe v2,外加 SIFT 作参考。
这个协议的好处是公平:所有检测器都用同一个匹配器,不比较描述子。坏处也很直接:你测到的是「检测器 + RoMa」的组合,RoMa 的错误会掩盖检测器之间的差异;而且 DaD 本身没有描述子,真要用在传统 SfM 里,还得另配一个匹配器。这一点我在局限性里展开。
3.2 相对位姿与单应估计
下面的部件把表 2–6 和表 1 做成了可切换的条形图。选基准、选关键点预算,条按当前预算排序,DaD 用主题色标出;把预算从 512 拉到 8192,看 DaD 的领先幅度怎么变化。
先看低预算。512 个点时,DaD 在五个基准上全部最好:MegaDepth1500 E/F 为 64.9/50.6,比最强的基线 ALIKED(63.8/49.7)高 1.1/0.9;ScanNet1500 E/F 为 25.7/18.3,比最强的基线 ReinforcedFP(25.2/17.0)高 0.5/1.3;HPatches 为 58.2,比 ReinforcedFP 的 55.8 高 2.4。1024 个点也全部最好。到 2048,五个里仍有四个最好,只有 ScanNet E 例外:DaD 28.3,ReinforcedFP 28.8。再往上,规律变了:
- 4096 个点时,ScanNet F 上 DaD 22.2,低于 SuperPoint / ReinforcedFP 的 22.6;HPatches 上 61.5,低于 ReinforcedFP 的 62.8;MegaDepth1500 E 仍是最高(69.3),F 也是最高(57.8)。
- 8192 个点时,MegaDepth1500 E 与 ALIKED(旋转增广)打平(68.8),F 被 ALIKED(旋转增广)的 57.6 反超(DaD 56.4);ScanNet E 以 29.3 对 29.2 险胜 DeDoDe v2,F 则 23.0 低于 SuperPoint / ReinforcedFP 的 23.2;HPatches 61.4,低于 ReinforcedFP / DeDoDe v2 的 62.9。
这不是说 DaD 的高预算结果「崩了」——它仍然在第一梯队,只是不再全面领先。原因也不难理解:关键点检测器的任务是从整张图里挑出最有用的 K 个点;K 越大,随便一个不太差的检测器都能覆盖到足够多的好点,检测器之间的差距被稀释。论文自己的结论也把重点放在「few-keypoint setting」,这是诚实的定位。
消融(表 1)的读法在 2.6 已经说过:单专家 → 蒸馏学生的提升是实的(512 点 +0.8–1.0,8192 点 +0.6–0.8),max 与平均的差距则很小(相对 在 0.0–0.5 分之间;1024 点时 反而比 max 高 0.3 分)。如果只记一个结论:蒸馏的价值主要来自「两个专家都要」,而不是「max 这个合并函数特别神」;max 的好处是它有局部极大值保持的性质,调参时不用担心把峰挪走。
3.3 运行时间
表 7 在 A100、batch size 1 下测了检测器本身(不含匹配):ALIKED 8.89 ms,SuperPoint 6.46 ms,DISK 14.30 ms,DaD 18.74 ms,DeDoDe v2 42.76 ms,REKD 1499.78 ms。DaD 大约是 ALIKED 的 2.1 倍、SuperPoint 的 2.9 倍,但比 DeDoDe v2 快 2.3 倍。注意这只是检测器;论文的评测还要跑 RoMa,端到端时间主要由 RoMa 决定,所以「DaD 18.74 ms」不能直接当成整个匹配流程的耗时。
3.4 定性结果
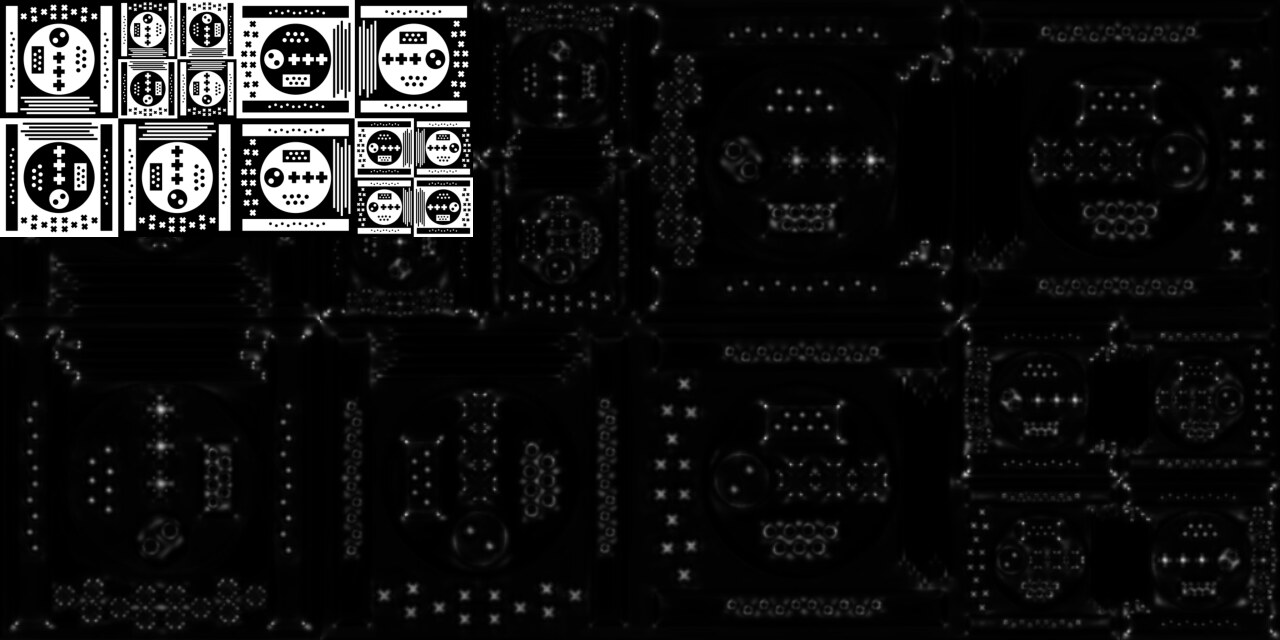
scoremap 长什么样?下图是 DaD 的 :亮点集中在角点、边缘和斑块中心,分布是稀疏的尖峰,而不是一整片高响应。这正是 softmax 后的概率图,也是 top-K 采样的依据。
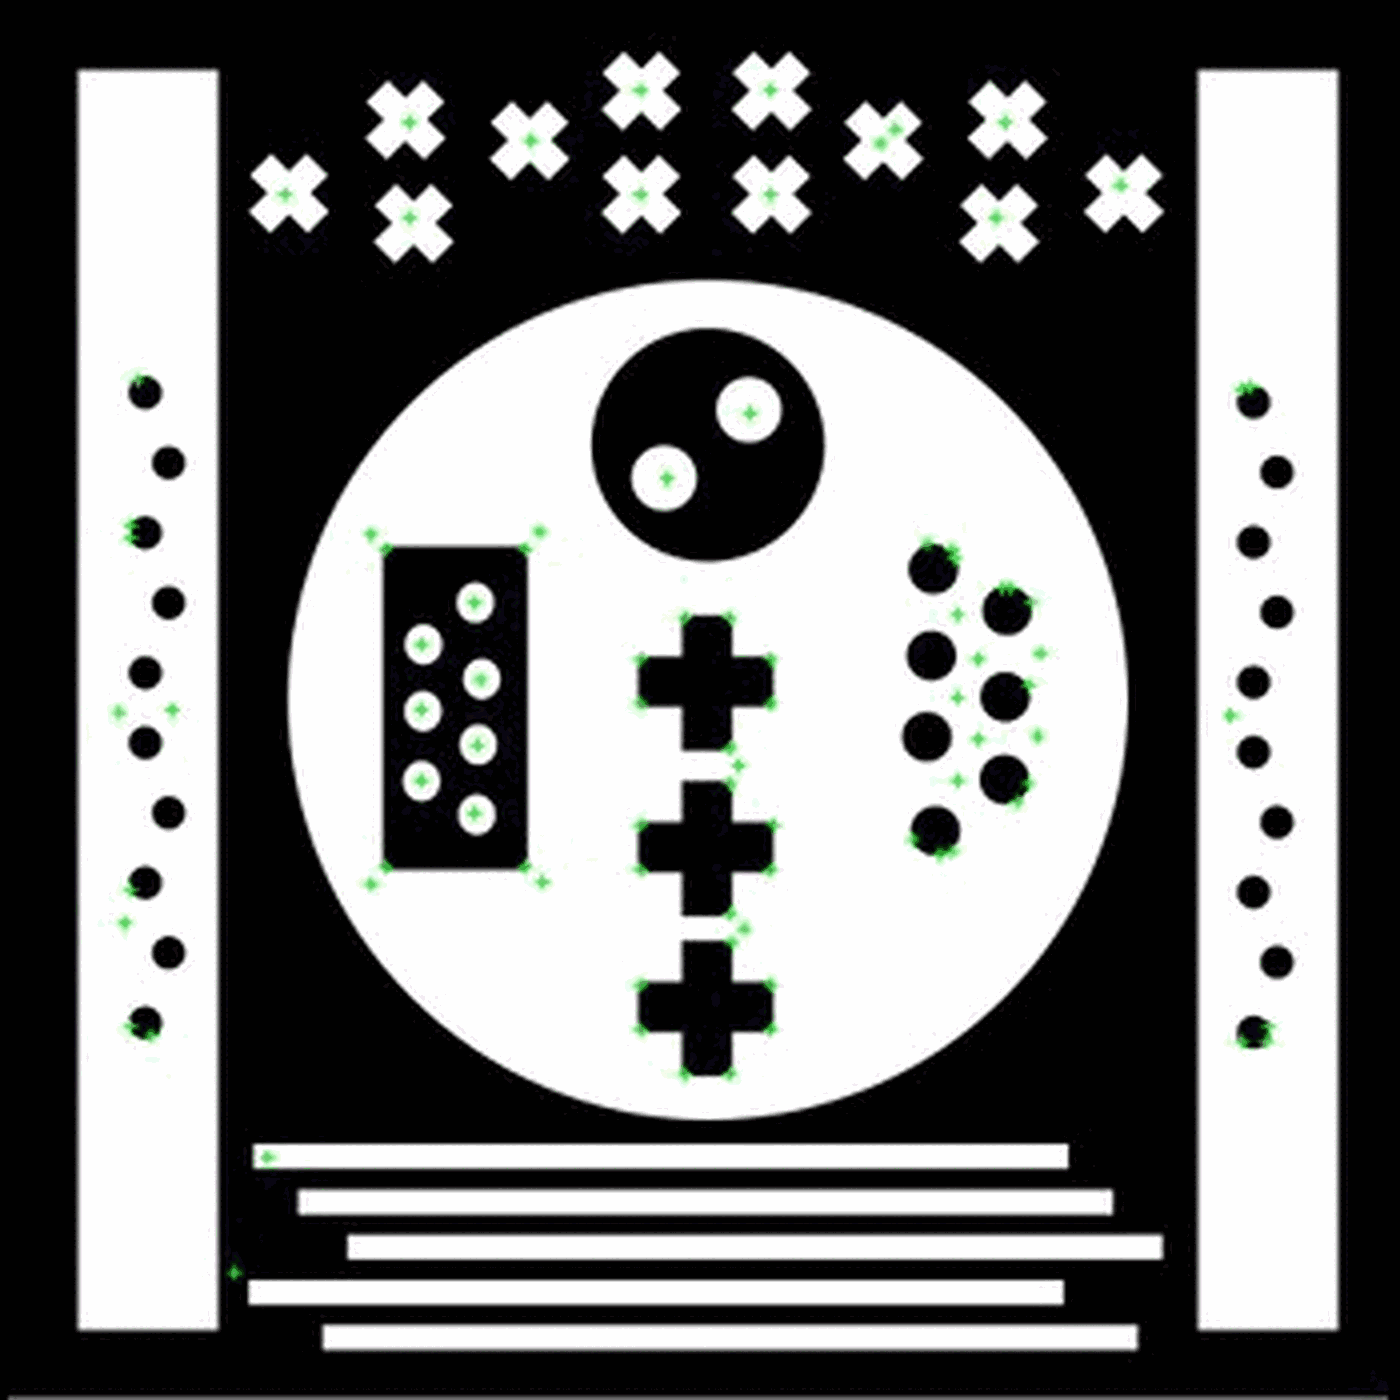
bouba/kiki 是论文对检测器风格的另一种观察:bouba 型喜欢把点放在斑块的质量中心,kiki 型喜欢放在角点。作者发现 kiki 型的暗检测器通常更好,于是从不同随机种子的训练结果里用肉眼挑了一个 kiki 暗检测器,再配一个 bouba 亮检测器做蒸馏。下图是合并后的 DaD:白色图案上的点落在斑块中心,黑色图案上的点落在角上——两种风格被同时保留了下来。
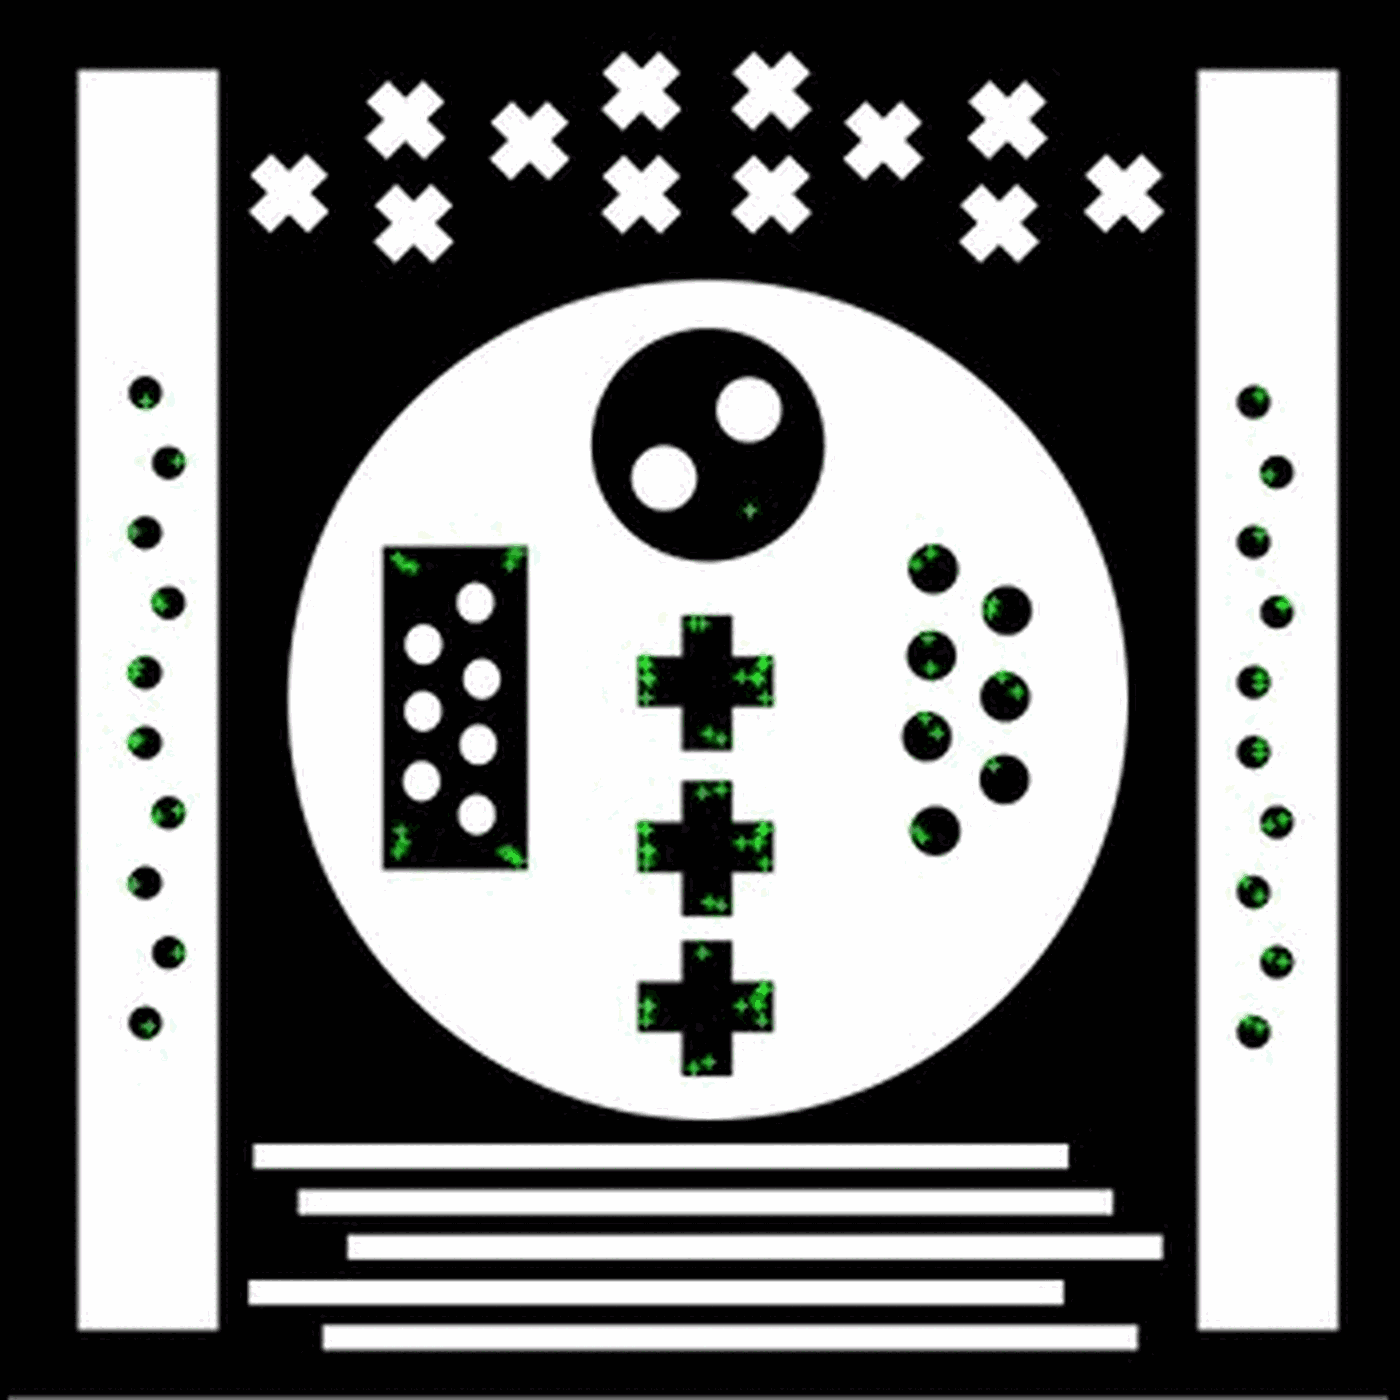
REKD 的对照图则说明「暗检测器」不是 DaD 的专利:REKD 用旋转等变架构,不用旋转增广,仍然只检测暗点,亮像素上几乎没有关键点。
四、局限性
先列论文自己承认的:
- 蒸馏目标不直接优化可重复性。学生拟合的是 ,而不是 RL 奖励; 只是两个专家的合并,不能保证学生在新图像上比专家更可重复。作者把「在保证多样性的同时直接优化可重复性」列为未来方向。
- 没有从架构上解决亮/暗不变性。蒸馏是一个工程上的补救,不是原理上的解法;如果能设计对亮/暗变化不变的网络,就不需要训练两个专家。
- 训练是随机的,需要多次尝试。README 明确提醒 RL 训练过程是随机的,可能要跑多次才能得到性能相近的检测器;暗专家的 kiki 风格还是作者肉眼挑的。这意味着复现不是「跑一遍就有」。
- 依赖深度和位姿。所谓 self-supervised 是指不用人工关键点标注,但训练仍然需要 MegaDepth 的深度和相机位姿;它不是那种完全无几何监督的自监督。
下面是我自己补的,和论文观点分开:
- 高预算下不是 SotA。8192 个点时,MegaDepth1500 F、ScanNet1500 F、HPatches 都被基线反超;如果你的 SfM 流程习惯用 8k 个点,DaD 的吸引力会小很多。论文的 new state-of-the-art 结论在低预算是成立的,高预算要按表看。
- 评测绑定 RoMa。所有检测器都用 RoMa 匹配,测到的是「检测器 + RoMa」;RoMa 的错误会掩盖检测器差异,换一个匹配器排名可能变。更重要的是,DaD 本身不输出描述子,实际部署时要么接稠密匹配器(贵),要么另训一个描述子(论文没做)。「descriptor-free」描述的是检测器,不是整个 pipeline。
- 运行时间只算了检测器。18.74 ms 不含 RoMa;端到端吞吐主要由匹配器决定。拿这个数字和 SuperPoint 的 6.46 ms 比,会高估 DaD 在完整流程里的速度劣势/优势。
- 采样三件套没有逐项消融。KDE、NMS、top-K 各自贡献多少,论文没有给表;我们只能从玩具模型和定性结果理解。推理时去掉 KDE 也没有解释,训练/推理的采样分布并不完全一致。
- off-policy 梯度没有重要性修正。上面的策略梯度式在 上取期望,但梯度里只有 ,没有 的权重;严格说这不是 的无偏梯度,而是一个 加权的代理。它有效,但理论上是近似。
- MegaDepth1500 与训练集的关系没有交代。MegaDepth1500 的两个场景(0015、0022)本身就来自 MegaDepth;论文只说 follow DeDoDe v2 在 MegaDepth 上训练,没有单独说明这两个场景是否在训练集中。不能直接断言有泄漏,但复现时值得确认。
- 「多样」主要是定性的。亮/暗、bouba/kiki 都是看图说话,没有量化的多样性指标;蒸馏带来的提升也只有零点几到一分。它更像一个有用的归纳偏置,而不是一个被严格定义和优化的目标。
五、结论与展望
DaD 的故事可以概括成三句话:
- 检测器可以只看可重复性。把检测写成概率分布,用两视图投影奖励做 REINFORCE,就不需要描述子和 track 作为中间人;奖励归一化用除法而不是减法,是为了不让稀有但有效的点被负奖励压死。
- 采样是隐藏的主角。KDE 平衡、NMS、确定性 top-K 看起来只是推理技巧,搬进训练后同时解决了塌缩、覆盖和方差三个问题;这也解释了为什么 DaD 在低预算下特别强——它训练的就是「怎么用少量点覆盖最重要的结构」。
- 多样性不能靠一个目标硬求。亮/暗二选一是旋转不变可重复性的内在多解性,连 ALIKED 和 REKD 都躲不掉;与其和它对赌,不如训练专家再用逐点最大蒸馏合并。max 的局部极大值保持性质让合并不会把峰挪走,KL 的方向则保证学生必须覆盖两个峰。
给实践者的几条建议:
- 如果你在 512–2048 个关键点的预算下做 SfM/定位,DaD 值得一试,尤其是 ScanNet1500 这类室内场景;到 4096 以上,先和 ALIKED、SuperPoint 比一下再决定。
- 如果你要自己训检测器,优先复现它的采样器(KDE + NMS + top-K)和除法奖励;这两件事比换骨干网络更影响结果。
- 做好「训练会分叉」的心理准备:不同的随机种子可能得到亮检测器或暗检测器,选种子、挑风格是流程的一部分,不是失败。
- 如果你的 pipeline 需要描述子,DaD 不能直接替换 SuperPoint;它需要一个独立的匹配器或描述子,端到端成本要重新算。
未来可以往几个方向走:把描述子也学出来,做成真正的端到端稀疏匹配器;把蒸馏扩展到更多专家(旋转、尺度、昼夜);设计对亮/暗变化等变的架构,从根上消除二选一;或者让 K 自适应,在低预算下进一步压榨检测器的选点能力。
六、上手
官方代码是 Parskatt/dad,MIT 协议。最省事的安装方式是用 PyPI 包 dad-detector:
安装命令(uv / pip)
curl -LsSf https://astral.sh/uv/install.sh | sh
uv pip install dad-detector
最小示例(来自 README,assets/0015_A.jpg 换成你自己的图片):
import dad
from PIL import Image

img_path = "assets/0015_A.jpg"
W, H = Image.open(img_path).size
detector = dad.load_DaD()
detections = detector.detect_from_path(
    img_path, num_keypoints=512, return_dense_probs=True
)

xy = detector.to_pixel_coords(
    detections["keypoints"], H, W
)  # 1 x 512 x 2,像素坐标
probs = detections["keypoint_probs"]  # 1 x 512,被选中点的概率
scoremap = detections["dense_probs"]  # 1 x H x W,完整 p_theta
参数和论文概念的对应关系:
| 代码 | 论文 | 说明 |
|---|---|---|
num_keypoints=512 | 采样预算;推理时可以改成 1024–8192 | |
keypoints | 归一化坐标,形状 | |
keypoint_probs | 每个被选中点的概率 | |
dense_probs | 完整 scoremap,形状 | |
to_pixel_coords | — | 把归一化坐标换成像素坐标 |
注意 dense_probs 会返回整张图,显存/内存占用随分辨率平方增长;只做推理时把 return_dense_probs=False 即可。官方 README 还提到一个实现细节:推理时会排除边界像素,训练时保留——这是另一个训练/推理不对称的小细节。
评测命令(需要按仓库说明准备对应数据集):
在 ScanNet1500 上评测 512 个关键点
python experiments/benchmark.py --detector DaD --num_keypoints 512 --benchmark ScanNet1500训练复现(RL 训练是随机的,可能要跑多次):
训练亮/暗专家与蒸馏学生
python experiments/repro_paper_results/rl.py
python experiments/repro_paper_results/distill.py
如果要改代码而不是只调包,用开发模式安装:
从源码安装
git clone git@github.com:Parskatt/dad.git
cd dad
uv sync
source .venv/bin/activate
参考
- Edstedt, Bökman, Wadenbäck, Felsberg. DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection. arXiv 2025. arXiv · 代码
- Schönberger, Frahm. Structure-from-Motion Revisited. CVPR 2016. 论文 · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV 2004. DOI
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Bökman, Wadenbäck, Felsberg. DeDoDe: Detect, Don't Describe — Describe, Don't Detect for Local Feature Matching. 3DV 2024. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Transactions on Instrumentation and Measurement 2023. arXiv · 代码
- Lee, Kim, Cho. Self-Supervised Equivariant Learning for Oriented Keypoint Detection. CVPR 2022. arXiv · 代码
- Santellani, Sormann, Rossi, Kuhn, Fraundorfer. S-TREK: Sequential Translation and Rotation Equivariant Keypoints for Local Feature Extraction. ICCV 2023. arXiv
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Edstedt, Bökman, Zhao. DeDoDe v2: Analyzing and Improving the DeDoDe Keypoint Detector. CVPR Workshops 2024. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Dai, Chang, Savva, Halber, Funkhouser, Nießner. ScanNet: Richly-Annotated 3D Reconstructions of Indoor Scenes. CVPR 2017. arXiv · 代码
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv · 代码
- Fischler, Bolles. Random Sample Consensus: A Paradigm for Model Fitting with Applications to Image Analysis and Automated Cartography. Communications of the ACM 1981. DOI
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Bhowmik, Gumhold, Rother, Brachmann. Reinforced Feature Points: Optimizing Feature Detection and Description for a High-Level Task. CVPR 2020. arXiv