· updated Oct 18, 2026 · 96 min read
浅谈视觉定位技术:Visual Localization Revisited
本文主要内容源自NAVER LAB Europe的Martin Humenberger于2020年撰写的“Methods for visual localization”一文,本文对其进行概括,并结合 2020 至 2022 年的进展进行引申介绍,主要介绍了视觉定位领域面临的主要问题、主要方法以及未来发展趋势。
本文初稿写于 2022 年 9 月,当时留下了不少待补充的段落。2026 年 10 月把这些空缺补齐,修正了原文的笔误与几处表述错误,并在文末加了一节「2022 年之后的进展」。正文主体仍保持 2022 年的视角,后记才是今天的视角。
背景
视觉定位(visual localization)是一种使用相机图像估计相机位姿的技术。这项技术可以用于不少基于位置(位姿)的应用如机器人、自动驾驶以及AR/MR等。众所周知Global navigation satellite systems (GNSS) (如 GPS)是一种最为常见的提供位置信息的技术,该技术已发展多年,但至今依然存在诸多限制。如室内场景、隧道场景 GPS 不可用,与此同时民用 GPS 的精度也堪忧:开阔地带的位置误差通常有数米,城市峡谷中更差,而且它只给位置、不给朝向,很难满足上述应用对 6DoF 位姿的需求。
由于卫星定位存在上述缺点,后来研究人员尝试使用相机图像进行室内定位以及室外高精定位。例如,自动驾驶领域,车载摄像头能够提供非常丰富的视觉信息,这些信息作为查询图(query image)可以与提前构建好的视觉地图数据库进行数据关联。此处的视觉地图可以是3D重建结果(3D点以及描述子,带有位姿的相机图像、2D点信息)、带有位姿的相机图像以及深度学习模型。查询图借助已经构建好的数据关联可以解算出其相对于“世界”的位姿。
注意视觉定位(Visual Localization, 后简称VLOC)与同时建图与定位(Simultaneous Localization and Mapping, SLAM )技术的相似与不同点。 前者是一种基于地图的定位(map-based localization)算法,其特点在定位而非地图,定位是指仅给定一幅图像,通过某种方式使用地图信息解算出拍摄这幅图像的相机6DoF位姿;此外,上文已经提到,其输入是一幅图像,不再依靠其他传感器(如IMU,GPS等)信息辅助定位;地图可以由SfM(structure-from-motion)或者由SLAM得到,但由于SfM生成的地图精度较高,相机在更高精度的地图中定位的精度会更高,所以实际中的建图算法主要采用SfM(如COLMAP,OpenMVG,OpenSfM等)。而SLAM的特点在于同时建图与定位,即在实时感知环境的同时定位相机在的环境中的位姿,为了达到实时性的要求,采用了局部BA,追踪局部地图,滑动窗口优化等策略;为满足精度要求,除使用相机图像数据,还可以使用IMU,GPS,LiDAR多等传感器数据,该部分非本文重点,不做展开。
下表展示了 SLAM/SfM/VLOC 的差异点,表后逐行展开。
| Approach | SLAM | SfM | VLOC |
|---|---|---|---|
| full name | Simultaneous Localization and Mapping | Structure from Motion | Visual Localization |
| inputs | image / IMU / GPS etc. | images (+GPS) | image only |
| map | online | offline | offline SfM |
| speed | fast (realtime) | slow | fast |
| accuracy | middle | high | high |
| method | ORB-SLAM, VINS, GVINS, LOAM | COLMAP, OpenMVG, VisualSFM, Meshroom, RealityCapture | HLoc, Kapture, InLoc, PixLoc |
| datasets | EuRoC, TUM-VI | - | Aachen Day-Night, CMU Seasons, RobotCar Seasons |
逐行解释一下这张表:
- 输入与地图。SLAM 的输入是连续的传感器流(图像、IMU、GPS、LiDAR 等),地图在线增量构建,关心的是「此刻我在刚建的这张图里的哪儿」;SfM 的输入是一堆无序或有序图像,离线建图,关心的是地图本身的精度与完整性;VLOC 的输入只有一张查询图(或一小段序列),地图事先离线建好,关心的是「这张图在那张老图里的哪儿」。
- 速度与精度。SLAM 必须实时,所以用局部 BA、滑动窗口、关键帧筛选换时间,精度中等且会随时间漂移;SfM 可以用全局 BA 慢慢算,精度最高;VLOC 的建图阶段用的就是 SfM 的地图,定位阶段只需对一张图做检索、匹配和 PnP,所以同时具备「高精度」与「快」,代价是必须提前建图。
- 典型系统。SLAM 一列是 ORB-SLAM、VINS、LOAM 这类实时系统;SfM 一列是 COLMAP、OpenMVG 等离线重建工具;VLOC 一列是 HLoc、Kapture、InLoc、PixLoc 这类「检索 + 匹配 + 位姿解算」的流水线。
- 数据集。SLAM 用 EuRoC、TUM-VI 这类时间同步的序列数据评估轨迹误差;VLOC 用 Aachen Day-Night、CMU Seasons、RobotCar Seasons 这类「建图图像与查询图像外观差异很大」的数据集评估单帧位姿的召回率。SfM 一般用重建完整性和重投影误差评估,没有统一的定位类基准,所以表中留空。
三者并非互斥:SLAM 的重定位模块本质上就是一个小型 VLOC;VLOC 的地图由 SfM 生成;而 SfM 的增量注册每一步也在做「新图像相对已有模型的定位」。
视觉定位的挑战
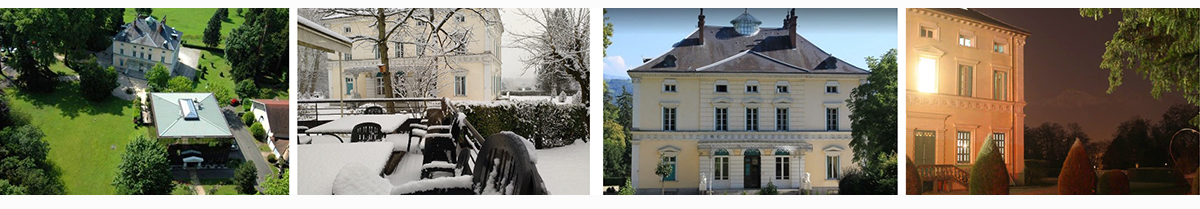
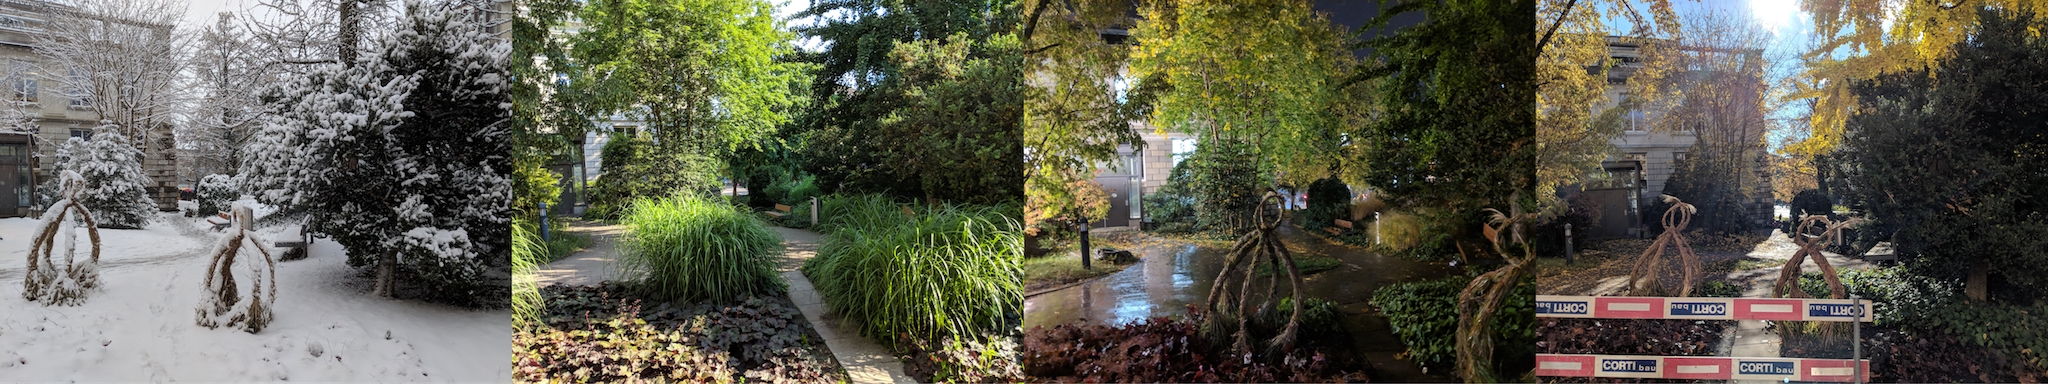
基于视觉信息的定位技术存在如下难点或者挑战:
- 光照变化;如建图时使用了白天的图像,而定位(查询)时使用的是晚上的图像,二者在图像外观上有比较明显的差异,而这种差异对于数据关联而言是较为困难的;
- 动态场景;比如说自动驾驶场景中的行人汽车等运动的非静态场景对于定位而言可能存在一定影响;
- 季节变化;比如说夏天建图,冬天定位,这种情况下场景同样也出现了较大的外观差异,势必影响;
- 视角变化;比如说查询图像与建图图像之间存在一定的视角变化,导致二者数据关联数量降低,定位精度势必降低;
- 物体遮挡;人以及物体等对场景的遮挡,这一点与动态场景类似,但并非完全一致;这一点强调的是查询图与静态场景的数据关联由于遮挡减少;
因此,目前有不少数据集用于评估不同定位算法在上述挑战场景中的表现。例如视觉定位挑战基准 The Visual Localization Benchmark,该基准中包括不同季节、光照等因素的数据集以及众多在这些数据集中的评分。另外,随着视觉定位领域的火速发展,我们可以在线找到非常多有用的资料,例如Torsten Sattler等人组织的Large-Scale Visual Localization系列课程,非常值得学习。最后,由于目前存在着大量的数据集,它们并不是同一个研究机构或者公司公开的,所以它们采用了不尽相同的数据格式,研究者在处理这些数据集时存在一定的阻力,为了解决这个问题,Kapture应运而生,借助这个工具可以比较方便地对多种数据集数据格式进行转换以及将不同的视觉地图格式之间进行转换(比如说COLMAP到OpenMVG或者相反)。
方案介绍
迄今为止,有非常多的算法用于解决视觉定位中存在的难点,下图非常概括地给出了视觉定位的方案。
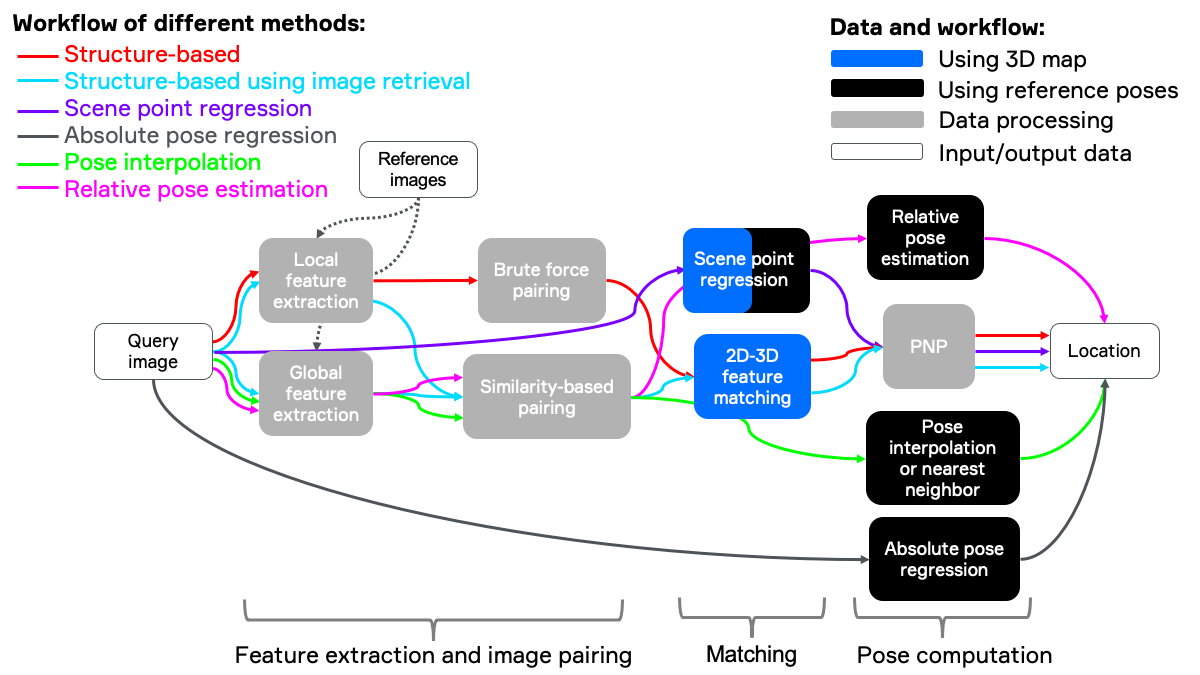
最为经典的方式是基于结构信息的定位方法(structure based),此处的结构信息可以理解为场景的3D结构,如场景的3D点云地图信息,通过构建查询图局部特征与地图点云之间的数据关联对相机进行定位。但是当地图比较大时,这种非常直接一步关联方式的效率就会变得非常低,此时可以借助图像检索(image retrieval)减小地图匹配的规模,提高定位效率,这种方式称为层次定位(hierarchical localization 或者 structure based using image retrieval)。另外一种方式是直接使用图像检索的结果进行定位,如对 top k 召回帧位姿加权,可见这种方式并不需要地图的结构信息,定位速度取决于图像检索效率,一般情况下非常快,但位姿精度并不准确。此外,场景点回归(scene point/coordinate regression)也是视觉定位中近来较火的研究领域,这种方式可以通过神经网络直接学习到2D像素位置与3D点之间的数据关联,之后采用与基于结构的方法类似的算法(如PnP1)解算位姿。目前场景点回归算法会使用场景的3D点用作训练,但在推理时并不需要。最后,绝对位姿回归(absolute pose regression)是一种使用神经网络进行端到端学习相机位姿的算法。
再来回顾一下,我们可以得到如下表格。这些方法在泛化能力以及精度上存在一定差异。此外,一些方式依赖3D地图而有些方法仅仅需要带有位姿(pose-tagged)的相机图像即可。使用场景的3D重建的信息的优势在于,位姿的精度可以做到非常高;劣势在于有些情况下场景的3D结构较为难以获取以及较难维护,如场景变化后的场景模型更新较为复杂。
| Approach | 3D map | Pros | Cons |
|---|---|---|---|
| Structure-based | yes | Perform very well in most scenarios | Challenging in large environments in terms of processing time and memory consumption |
| Structure-based with image retrieval | yes | Improve speed and robustness for large-scale settings | Quality heavily relies on image retrieval |
| Scene point regression | yes/no | Very accurate position in small-scale settings | To be improved in large environments |
| Absolute pose regression | no | Fast pose approximation, can be trained for certain challenges | Low accuracy |
| Pose interpolation | no | Fast and lightweight | Quality relies heavily on image retrieval and only provides a rough pose |
| Relative pose estimation | no | Fast and lightweight | Quality relies heavily on image retrieval and, e.g., local feature matches or a DNN used for relative pose estimation |
接下来针对上述提及的每种方法进行介绍。
基于结构信息的方案(structure based)
前文中已经提到,这是一种最经典的用于相机定位的算法。这种算法需要提前建好场景的3D地图,然后使用相机拍摄的图像来定位相机位姿2 3 4 5 6 7。场景地图的构建包括数据库相机图像位姿估计以及输出3D模型,此处的数据是指在同一个场景中不同位置以及角度拍摄的一系列图像, 完成地图构建的算法为structure from motion (SfM) 3 7。首先图像对(图像两两匹配或者根据外观相似性选择相似的图像匹配)进行像素级的局部特征匹配8 9,随后进行几何校验过滤错误匹配,经过这个过程之后可以得到场景图(scene graph),该场景图记录着图像之间的连接关系。随后使用诸如对极几何解算位姿并进行三角化 (triangulation)地图点,具体过程可以参考COLMAP7。
注意到上述数据关联中提到的局部特征,它是由图像中像素或者亚像素级别的坐标点以及用以描述该特征的描述子组成。早期的特征提取器是由人工精心设计的,如非常经典的 SIFT10(它不止包括特征提取器,也包括描述子)。但是 SIFT 这种人工特征存在比较明显的缺陷,如对光照变化、季节变化等因素较为敏感,此时的特征匹配性能不佳。如今,数据驱动的端到端学习的局部特征 R2D2 9,D2-Net11,SuperPoint12,Key.Net13,SuperGlue14(准确来说,SuperGlue是一种特征匹配器) 等被提出,在上述挑战场景中的表现远超传统特征(文献8 15 16 中介绍了局部特征的发展过程)。
需要注意的是,构建好的定位地图中的3D点不仅包含其3D坐标,也关联着其描述子。一个3D点是由多张建图图像上的 2D 特征三角化出来的(这条观测链叫 track),所以它天然对应多个描述子,匹配时怎么用这些描述子有几种常见做法:
- 全部保留:把 track 上每个 2D 观测的描述子都放进索引,查询特征与任一描述子匹配上即视为匹配到该 3D 点。召回最高,但内存和匹配耗时随 track 长度线性增长,而且长 track 的点会在 ratio test 里「自己和自己竞争」(最近邻与次近邻都来自同一个点),需要把 ratio test 改成跨 3D 点比较。
- 均值或 medoid 描述子:对一个 3D 点的所有描述子取均值(SIFT 这类整数描述子常取整数均值),或取离均值最近的那个真实描述子(medoid)。Active Search2 4 采用的是「按视觉单词分组后各组取整数均值」,既省内存又保留了一定的视角多样性。
- 按视角聚类:同一个点从相差 90° 的两个方向看,描述子差别很大,直接平均会把两边的特征都抹掉。可以按观测相机的视线方向把描述子聚成若干簇,每簇保留一个代表描述子。
- 不做聚合,退回 2D-2D 匹配:这是 HLoc17 的做法。查询图先检索出若干张相似的数据库图像,查询特征与这些图像上的 2D 特征直接匹配,再通过 track 把 2D 匹配「抬升」到 3D 点。好处是可以无缝使用 SuperGlue 这类需要成对图像上下文的学习型匹配器,也彻底绕开了描述子聚合问题;代价是依赖检索质量。
查询图像的2D点与地图的3D点通过描述子进行数据关联(KNN匹配)。一旦有了2D-3D匹配,查询相机的位姿可以通过perspective-n-point (PnP) 1算法进行求解。由于2D-3D可能存在外点(outliers),PnP通常以RANSAC18 19的方式进行以提升位姿解算鲁棒性。
现代RANSAC发展较快,如 MAGSAC20, MAGSAC++21,DEGENSAC 等针对原有RANSAC无法有效应对外点率较大的情况,目前最先进的RANSAC算法可以在内点率非常低时求解出model。Dmytro Mishkin 等人在CVPR 2020 开展了 RANSAC tutorial,如下视频是该教程。
不难想象,当场景非常大时地图会变得非常巨大,如用于视觉定位的数据集Aachen-Day-Night 22 v1 版本用 4328 张数据库图像重建出约 165 万个 3D 点,v1.1 扩充到 6697 张图像、约 230 万个 3D 点(特征与图像对的选择不同,点数也不同),然而这仅仅是德国亚琛老中城的一个小片区,如果将其范围扩展至整个城市,3D点的规模会变得非常巨大。可以想象,当在如此巨大的场景中进行2D-3D数据关联会变得非常慢,Torsten Sattler等人提出了Active Search23 24使用了一种基于词袋的方式进行匹配加速并设计了一种匹配优先级策略得到更多的2D-3D匹配对。
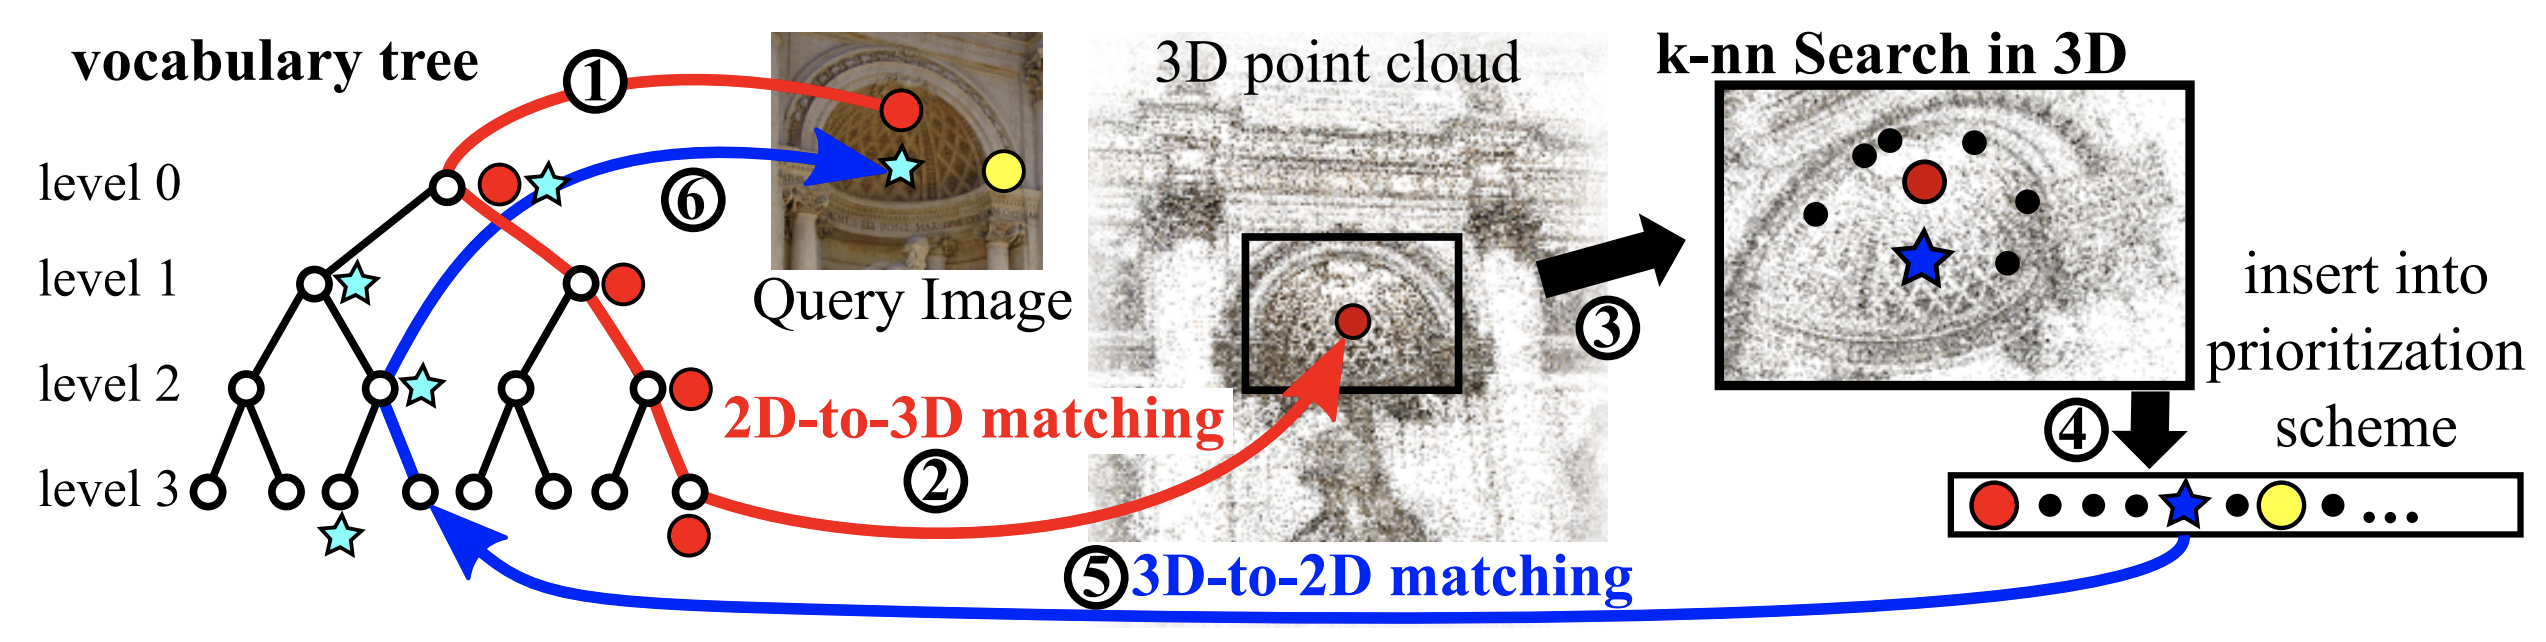
对于数据库的路标点,我们将其3D描述子通过离线的方式“分配”到视觉字典中;对于每一查询帧,我们采用同样的方式将其2D描述子“分配”到视觉字典中。于是我们可以得到图像上每个2D特征点的候选匹配点(3D),此时每个2D点可能有多个候选的3D匹配,根据候选匹配点的多少按照升序进行排列。具体的,对于每一个特征 f,遍历隶属于同一个单词内的2个最近邻,如 p1, p2,之后根据ratio-test决定该匹配是否有效。但Sattler等人认为,视觉字典其实会引入“量化误差”,该误差会限制2D-3D匹配数量。为了应对这个问题,一种通用的做法是将一个特征分配到多个单词,但作者设计了一种更加高效的策略 “Active Search”(ECCV 2012), 这个算法的基本思想是:一旦某个特征f与某个路标点p被确定为匹配对,那么处在p邻域的路标点( 个点)同样可能被查询图像观测到。于是作者设计了一种3D-2D匹配方式,即主动地寻找p邻域中的路标点( 个点)与图像中的2D特征点的匹配关系。
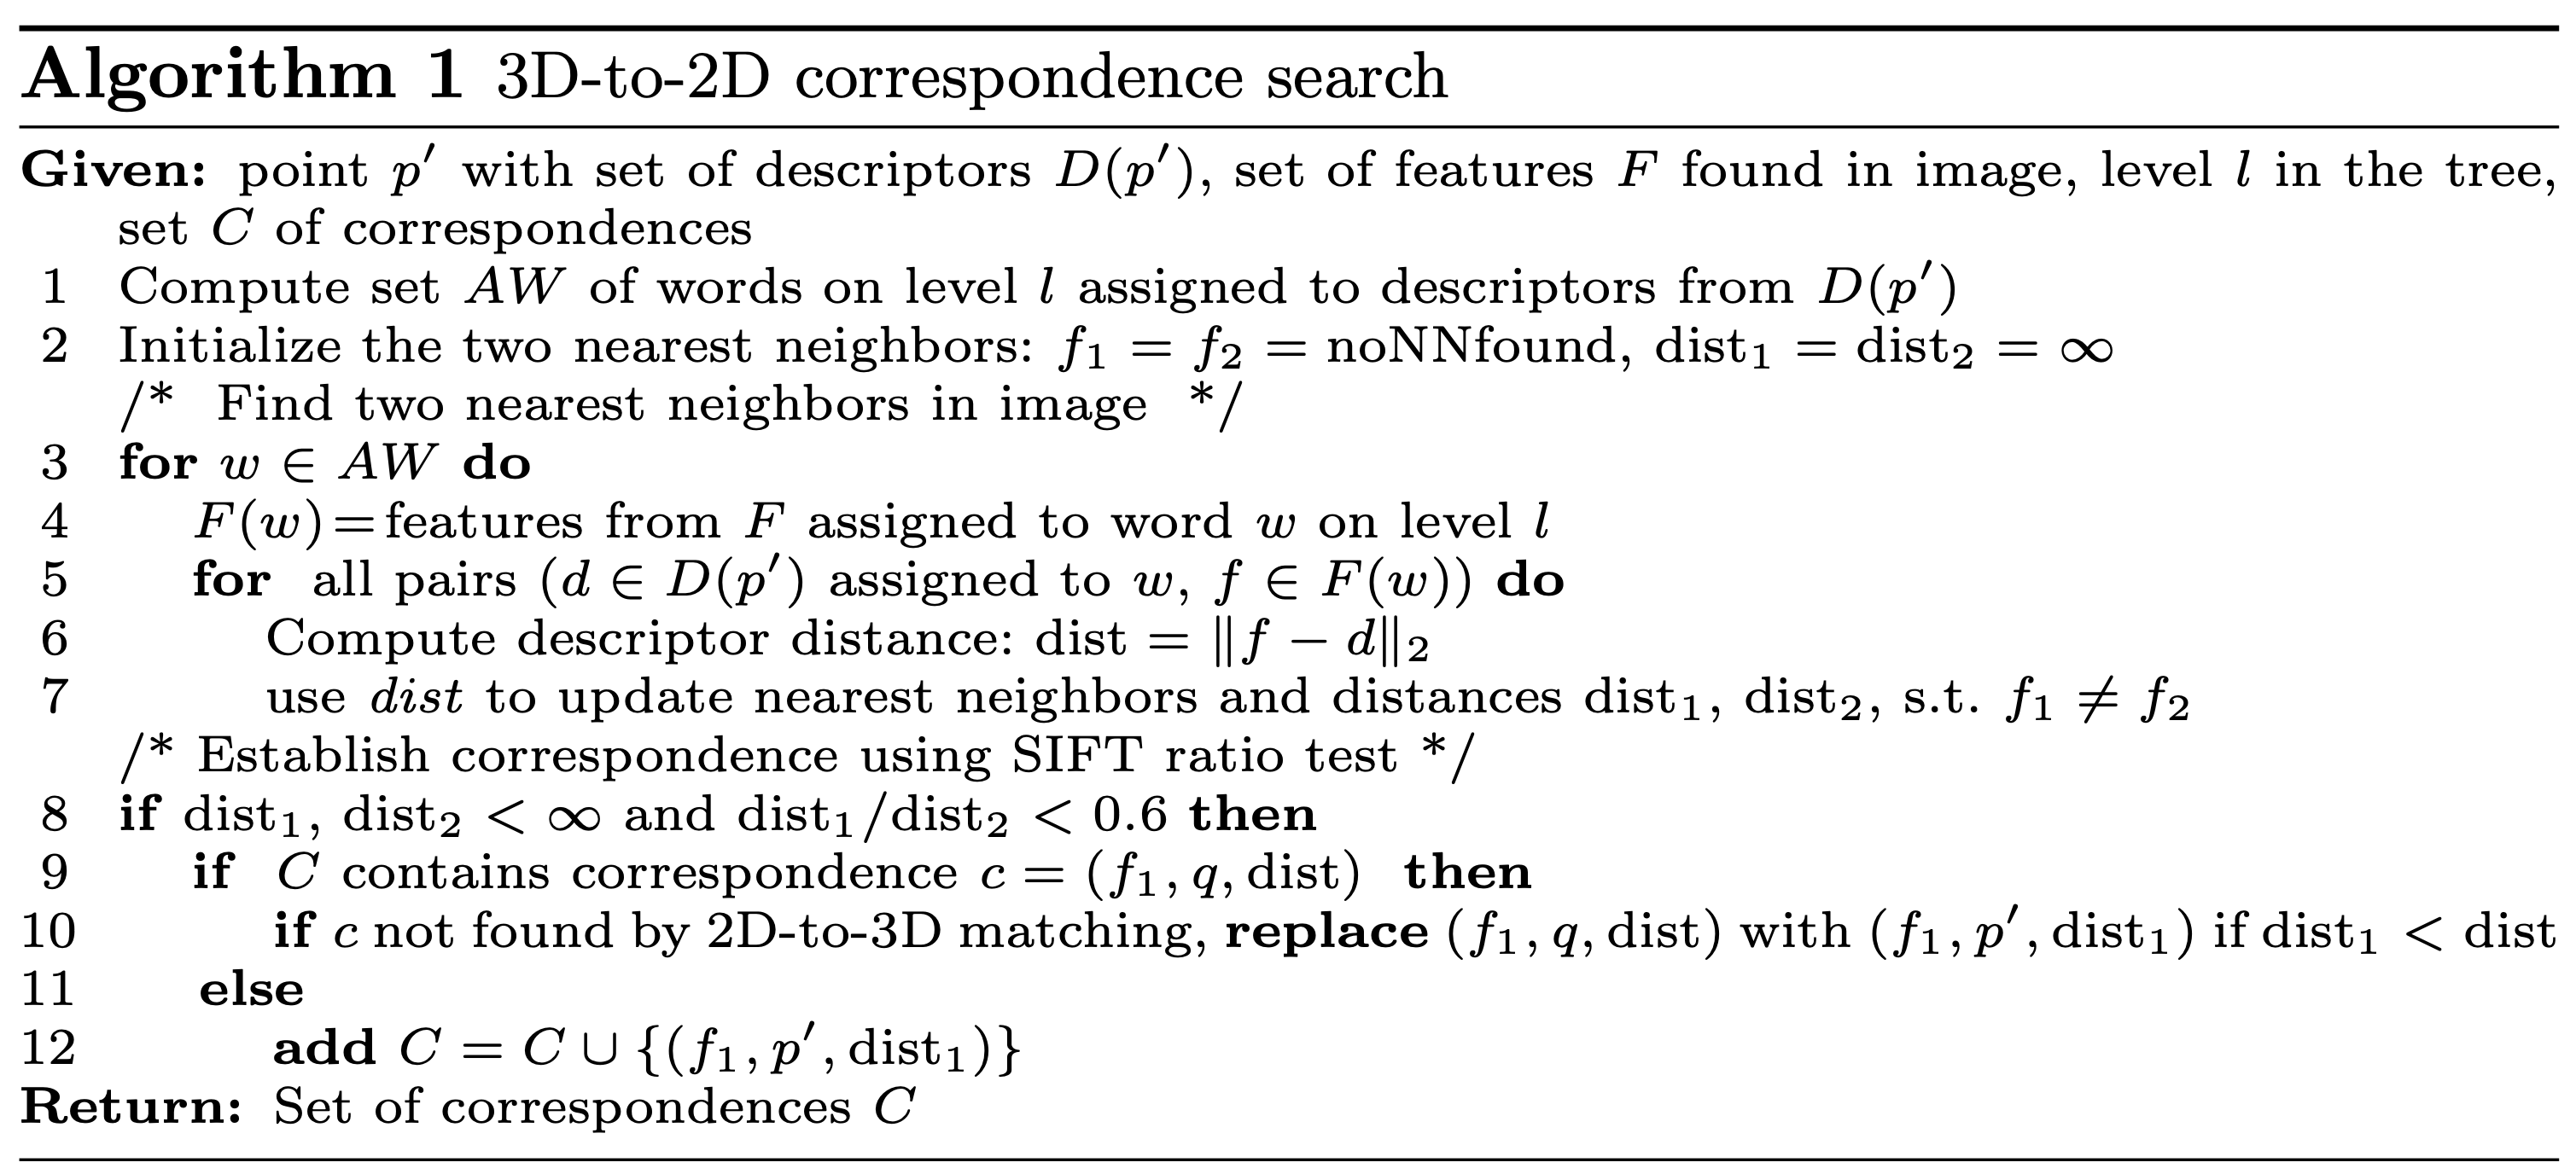
其算法流程的伪代码如上图所示:其中 表示 邻域中的某个3D点, 表示该点的描述子(可能有很多个), 表示的查询图上的特征, 表示字典树的第 层, 表示匹配对集合; 表示图像中的特征,AW表示activate visual words,AW记录了 不同的特征描述子隶属的单词(及其所在的层数);对于每一个AW记录的单词 ,同样获得图像特征中属于该单词 的特征们 ,接下来就是遍历所有属于该单词的3D特征描述子 与图像特征 之间的距离,记录两个最小距离 以及对应的图像特征 ;随后使用 判定该匹配是否有效;如果有效且原有的匹配集合中没有包含该匹配则加入该匹配关系;若原有匹配集合已经包含该匹配,则进一步判断,如果2D-3D匹配中没有该匹配则根据描述子距离是否更小进行替换。(这个过程有些类似于词袋匹配,不过此处是针对2D-3D匹配进行的设计)
此外,基于图像检索的方式会进一步加速该匹配过程,即首先检索全图中与查询图最接近的区域,随后查询图与该区域进行数据关联25 17,更为详细的介绍见后一小节。
另外一种构建2D-3D数据关联的方式是使用 scene point regression,其中的2D-3D 数据关联可以由DNN26 27 28 29 或者随机森林30得到。
SfM 建图
基于结构信息的定位技术非常依赖于视觉地图信息,接下来针对基于SfM的建图技术进行简要介绍。
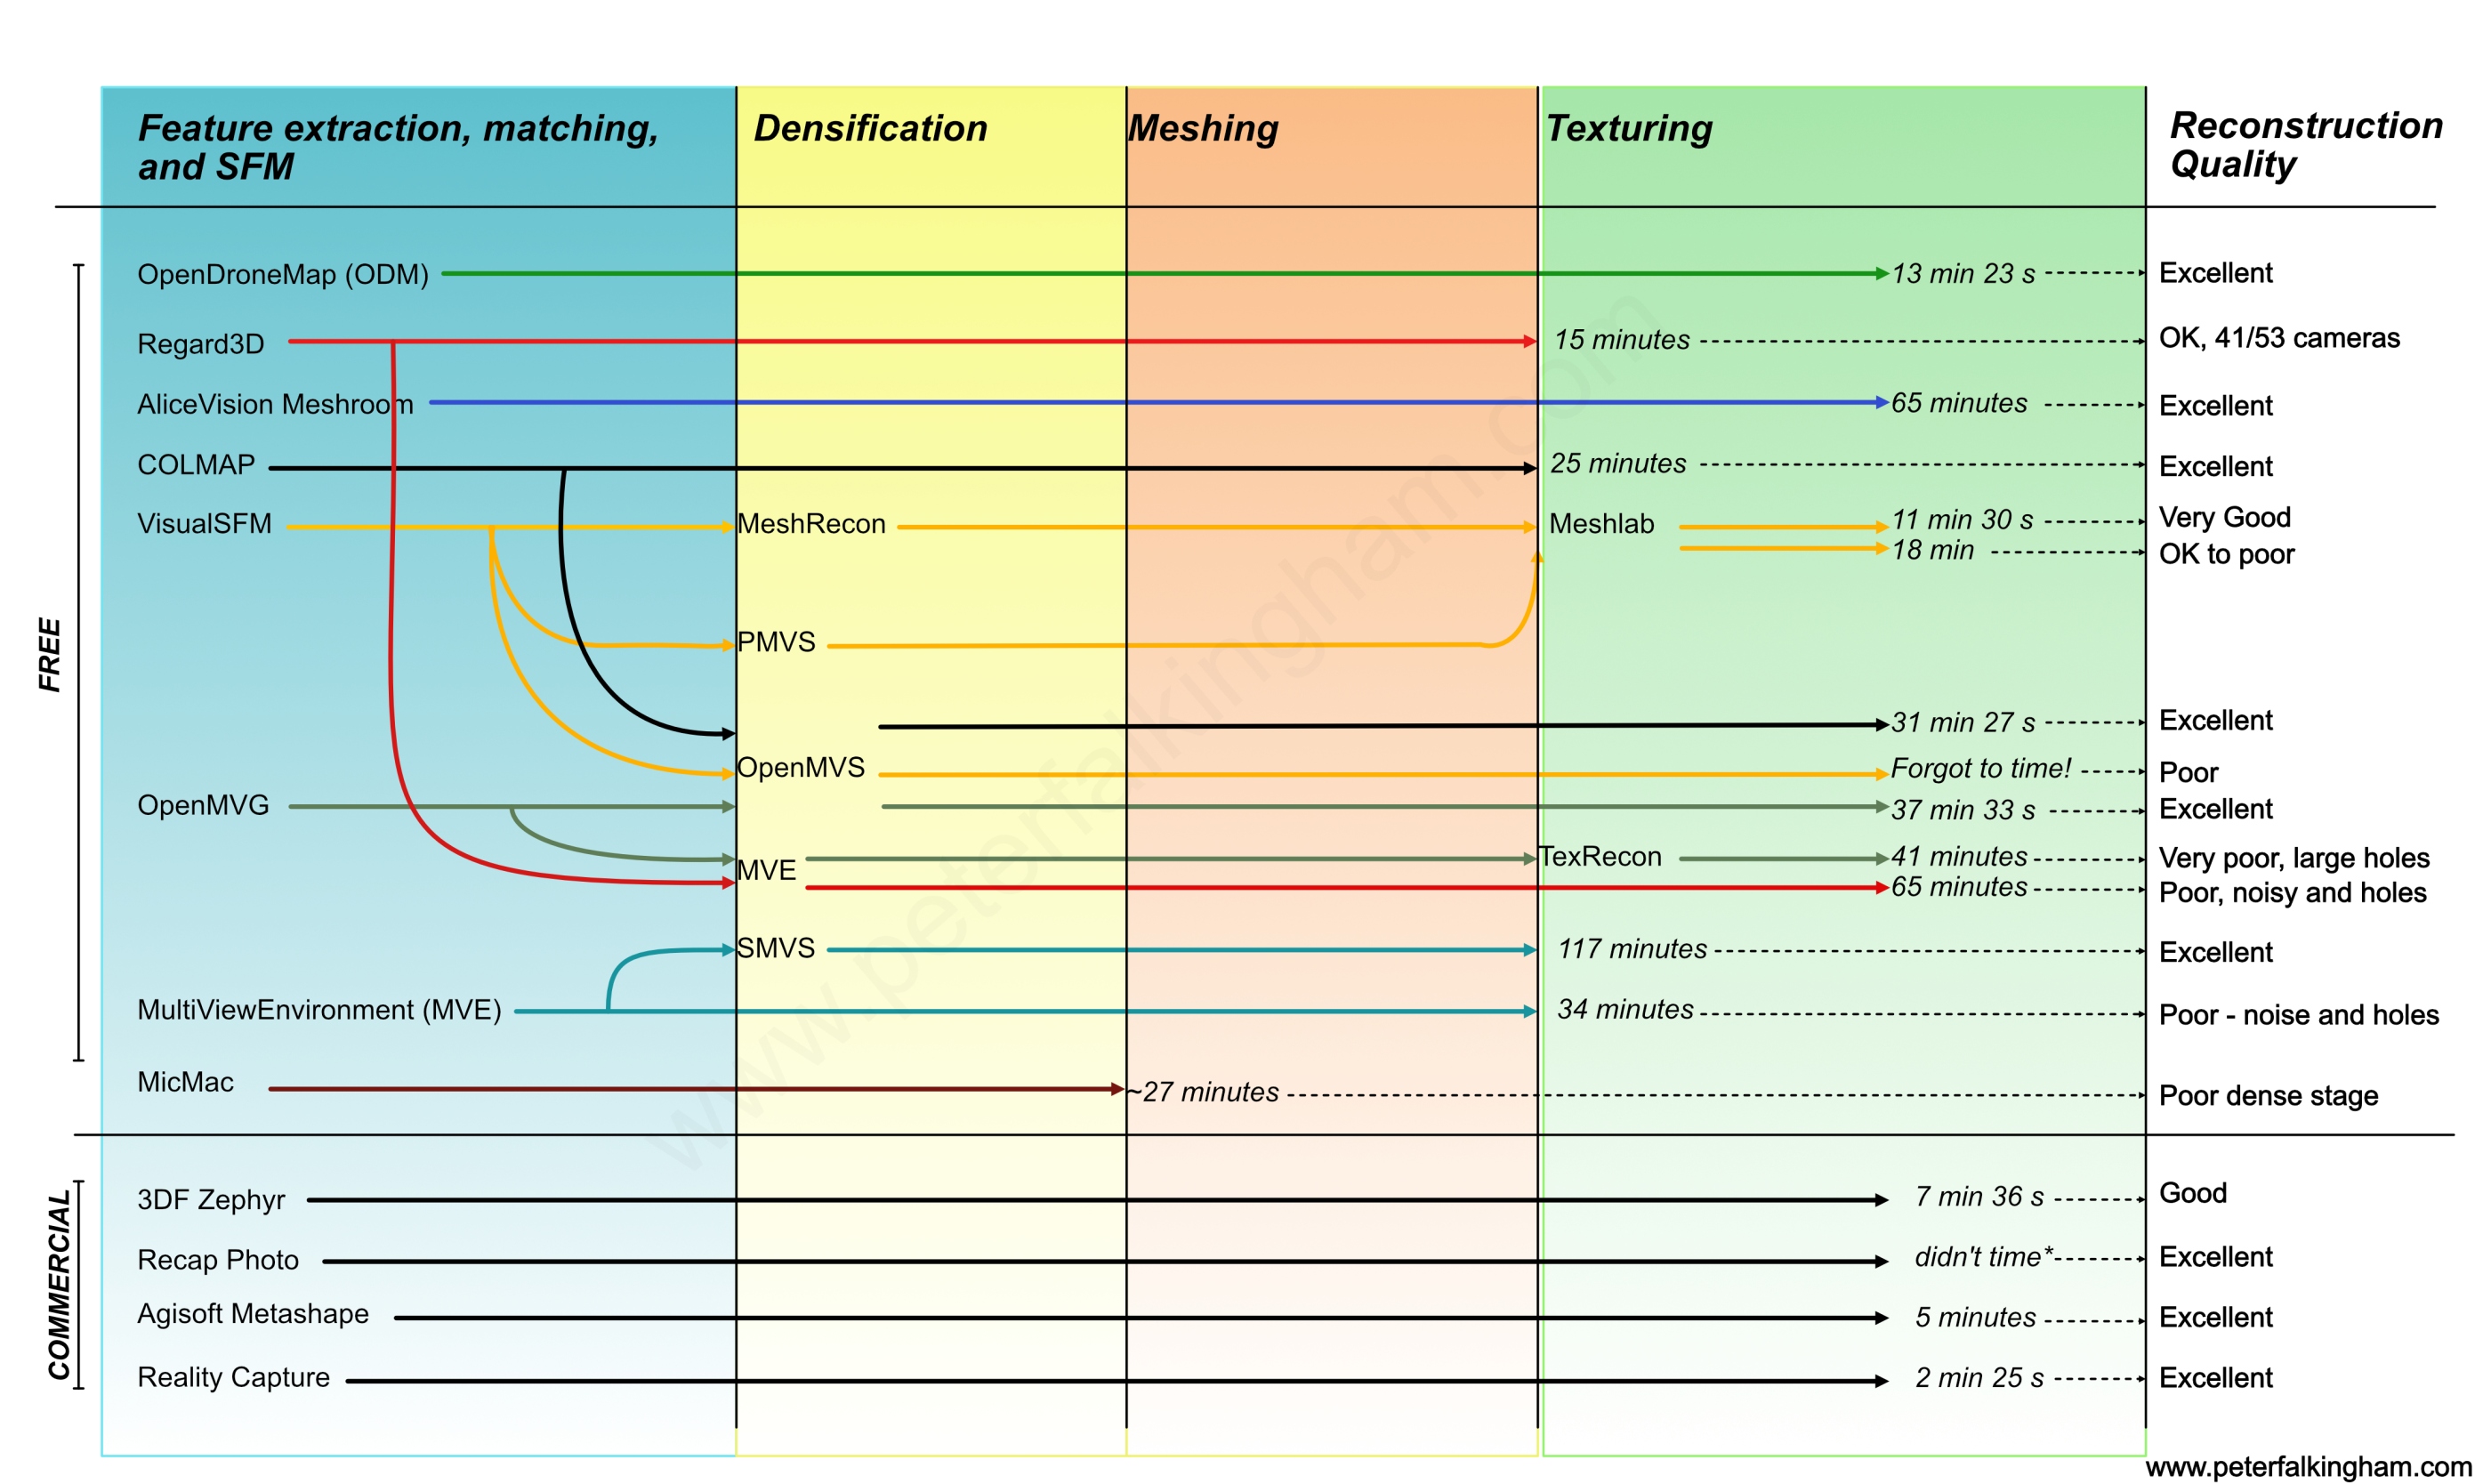
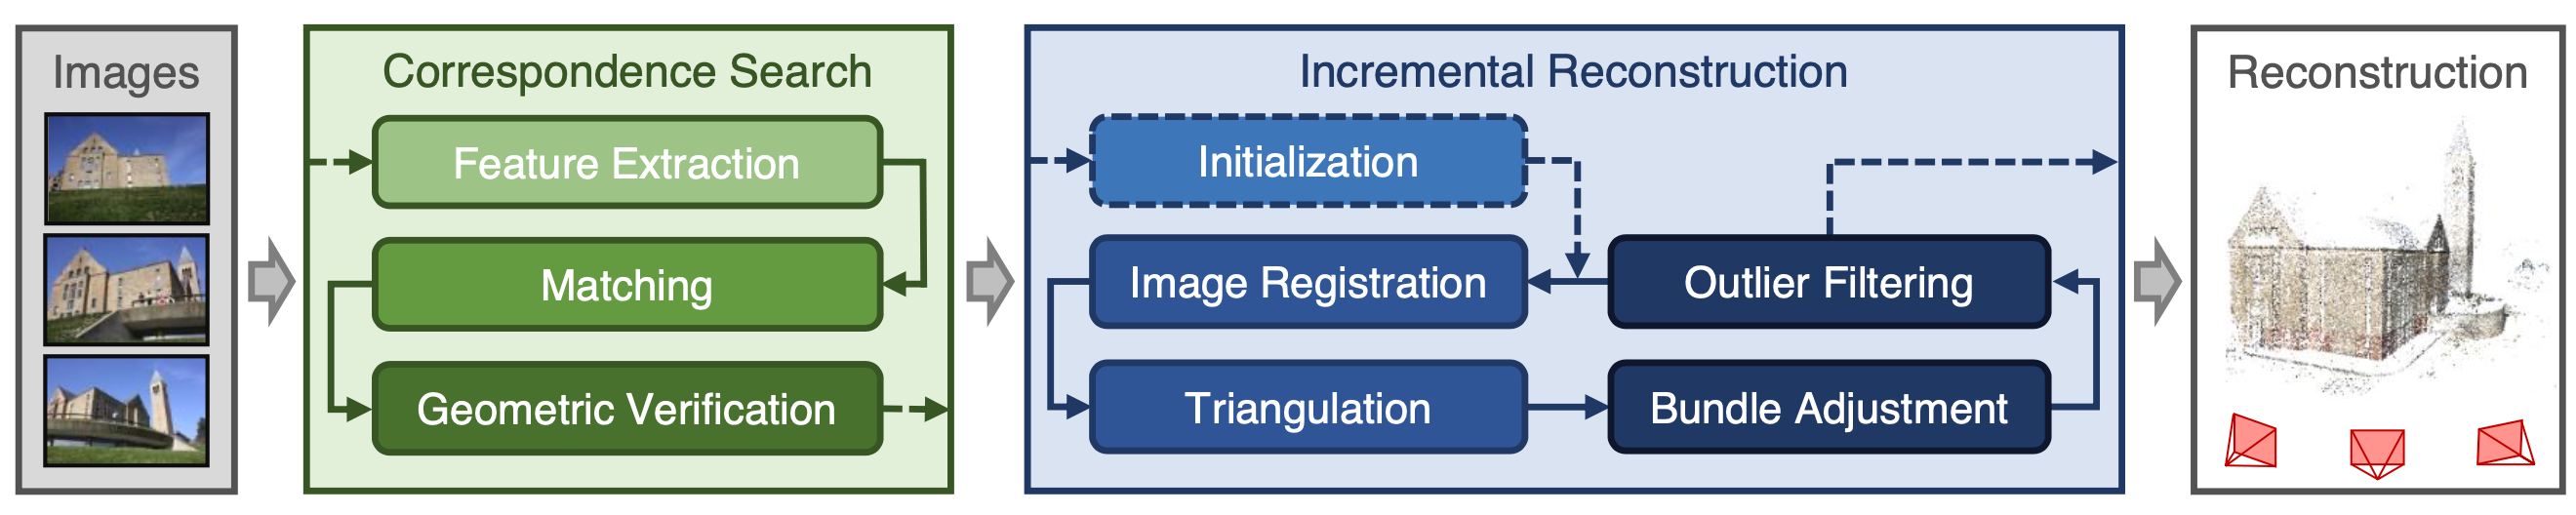
上述表格列举了SfM以及MVS的算法比较,虽然种类繁多,但目前使用最为广泛的是Schönberger 等人于 2016 年提出的 COLMAP7。SfM的流程可以概括为:首先进行特征提取/匹配以及后续的几何校验滤出外点,经过上述步骤可以得到所谓的场景图(Scene Graph),该场景图是后续的增量式的基础(提供数据关联等信息)。增量式重建中需要非常仔细地挑选两帧进行重建,在图像进行注册(即定位当前帧在地图中的位姿)之前,需要进行三角化场景点/滤出外点以及BA优化当前的模型。更为详细的介绍见笔者写的阅读报告(CODE, PDF),此处不再赘述。
不过现有的 SfM 在实际使用中经常会面对如下问题:
- 重复/对称结构引起的歧义:同一栋楼的两个相似立面、走廊里重复的门窗会产生大量「看起来对、几何上错」的匹配,导致相机错误注册、模型折叠(两处场景被拼到一起);
- 特征点定位误差:关键点检测本身有亚像素到几个像素的噪声,三角化后的 3D 点云就带着这些误差,深度越大误差越大,直接拉低后续定位精度;
- 跨时间、跨外观的建图:白天和夜晚、夏季和冬季拍的图像用传统特征几乎匹配不上,地图只能覆盖一种外观条件,而定位时偏偏要面对另一种;
- 弱纹理与低重叠:白墙、玻璃幕墙、天空、水面提不出可靠特征;图像之间重叠太少时增量注册链会断成多个子模型;
- 效率与规模:增量式 SfM 反复做全局 BA,耗时大致随图像数的三到四次方增长,城市级场景需要分块、分层或分布式处理;全局式 SfM 虽快,但对外点匹配和漂移更敏感;
- 退化运动与标定:纯旋转、直线行驶、内参未知或滚动快门都会让双视几何初始化失败或引入系统性偏差;
- 动态物体与遮挡:行人、车辆上的特征会被当成静态点三角化,污染地图;
- 地图维护:场景变了(施工、换招牌、季节)以后,如何只更新变化区域而不是整图重建,这是工程上很头疼但学术上研究不多的问题。
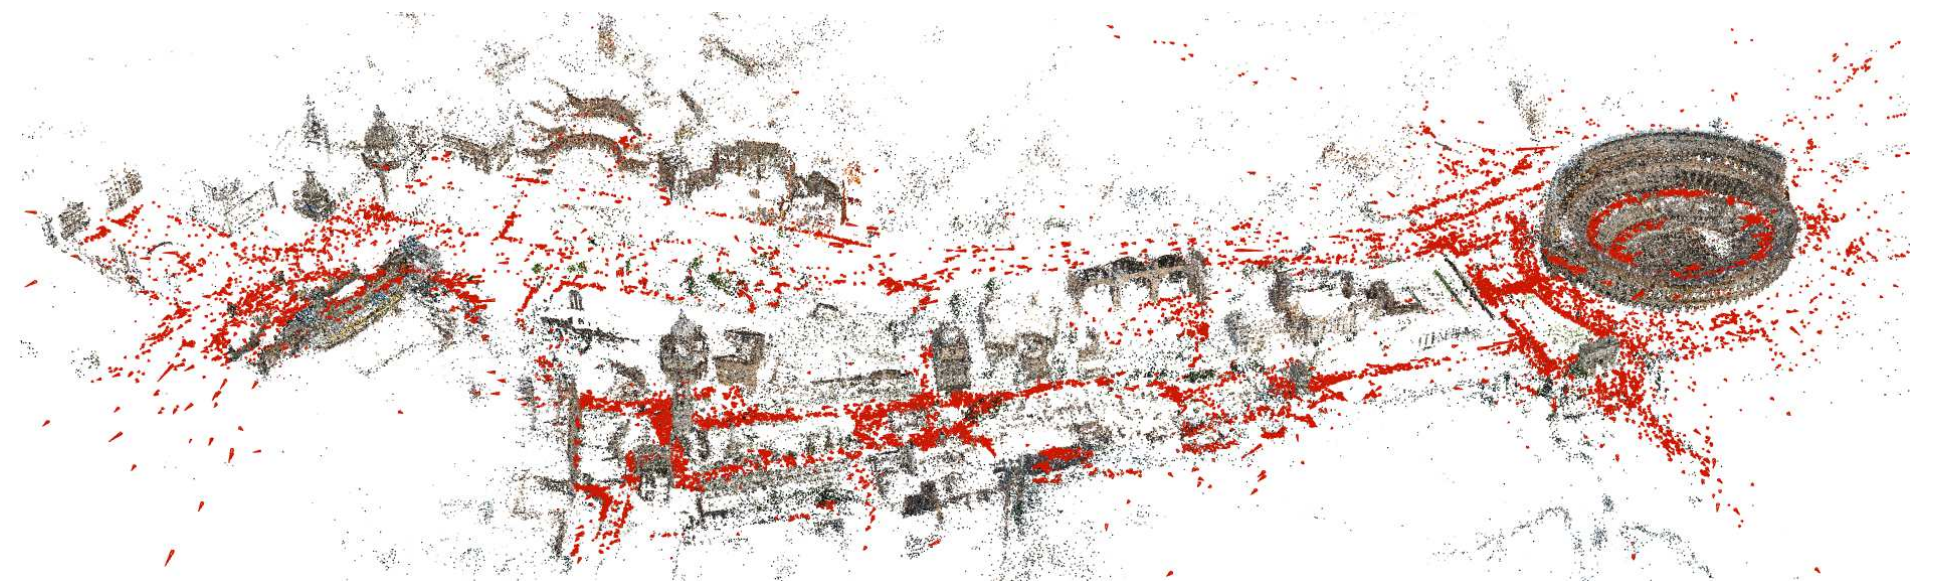
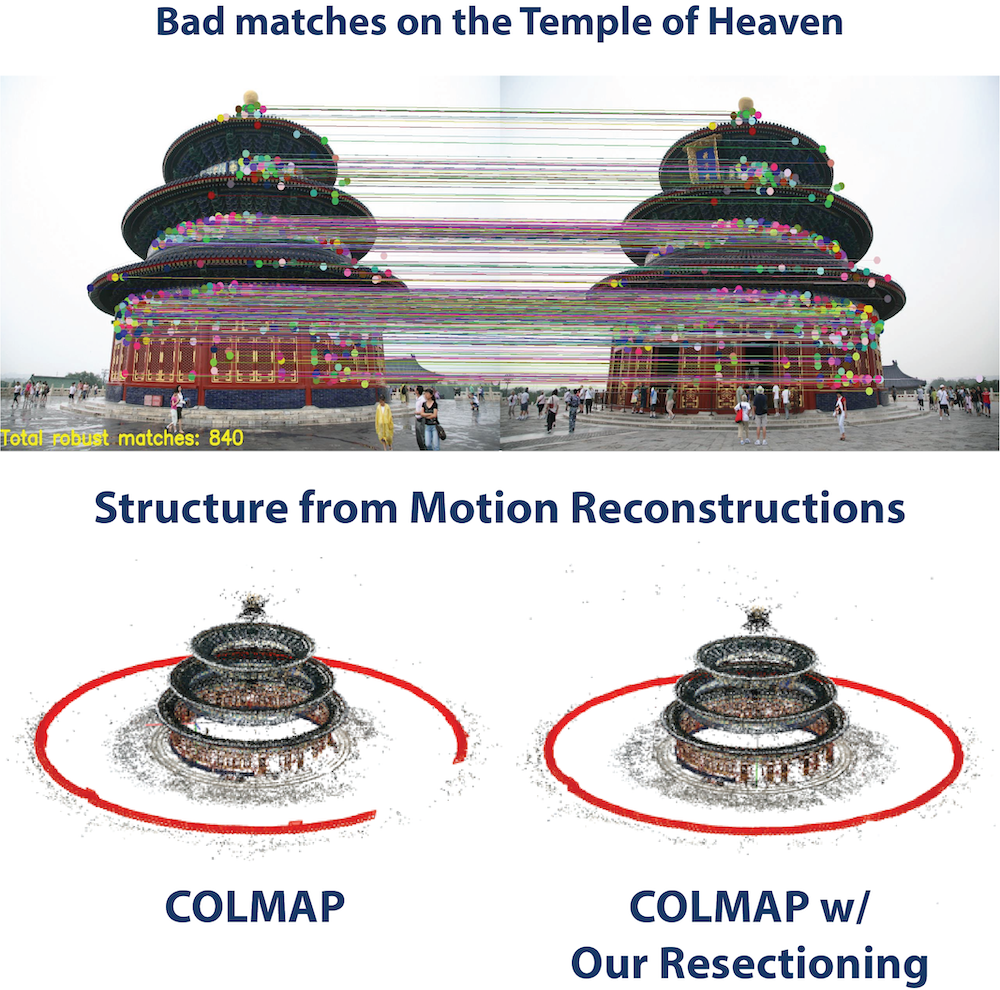
为了应对建图过程中重复场景(歧义)带来的相机错误注册的问题,来自CVG实验室的 Lixin Xue 基于COLMAP实现了目前几种应对该问题的建图方案 sfm-disambiguation-colmap,如下图所示的是原版COLMAP与修正错误注册后相机位姿以及场景点云,此时使用的修正异常注册算法为 ReliableResectioning。
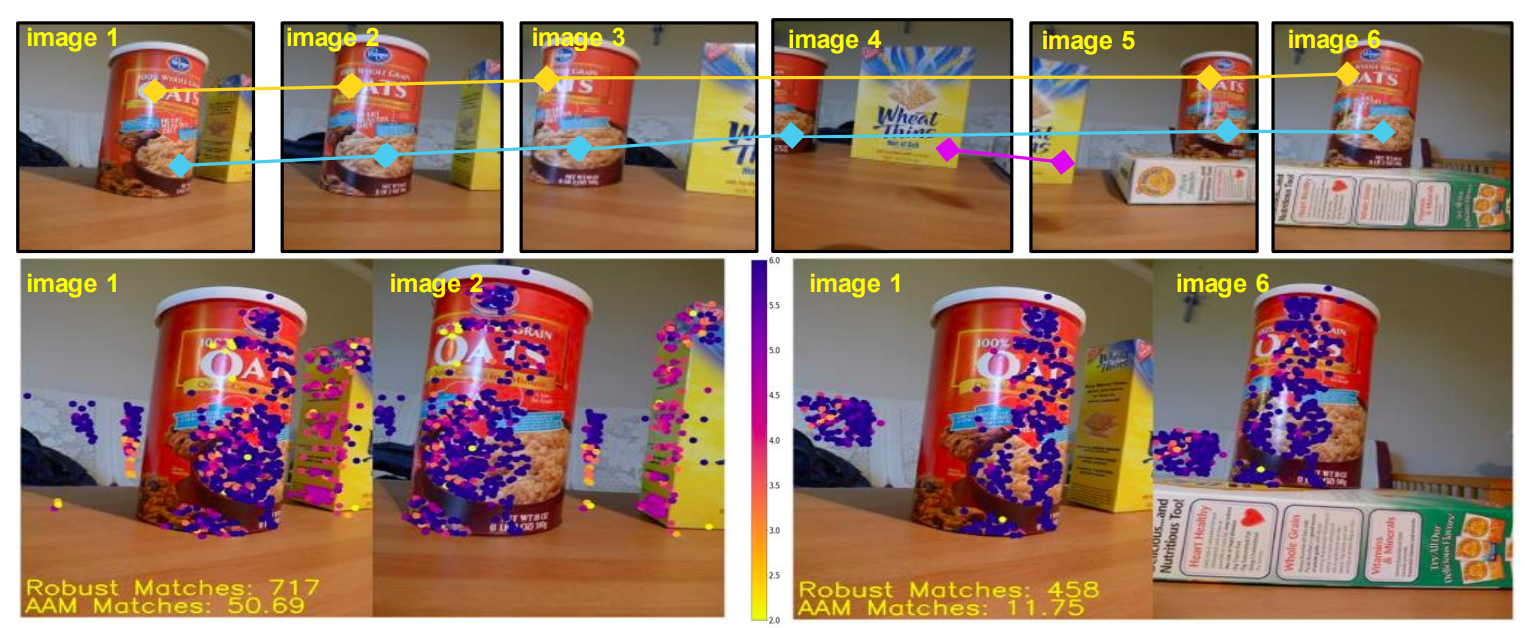
其基本思想是:由于相似的外观在不同视角经常出现,所以此时极其容易导致这些重复特征有较长的track-length,因此作者在建图过程选择下一帧时设计了新的选择策略,即给long-tracks特征较小的权重,而short-tracks特征较大权重,用于计算两张图之间的“歧异度调整匹配”(ambiguity-adjusted match, AAM,越大越好),优先注册非歧义的那些图像。
此外,由于2D点提取误差的存在,导致SfM重建得到的3D点云位置不够准确,并随着3D点越远(深度越大),该误差越大。为应对该问题,Sarlin 等人提出了 pixel-perfect-sfm (PDF)。
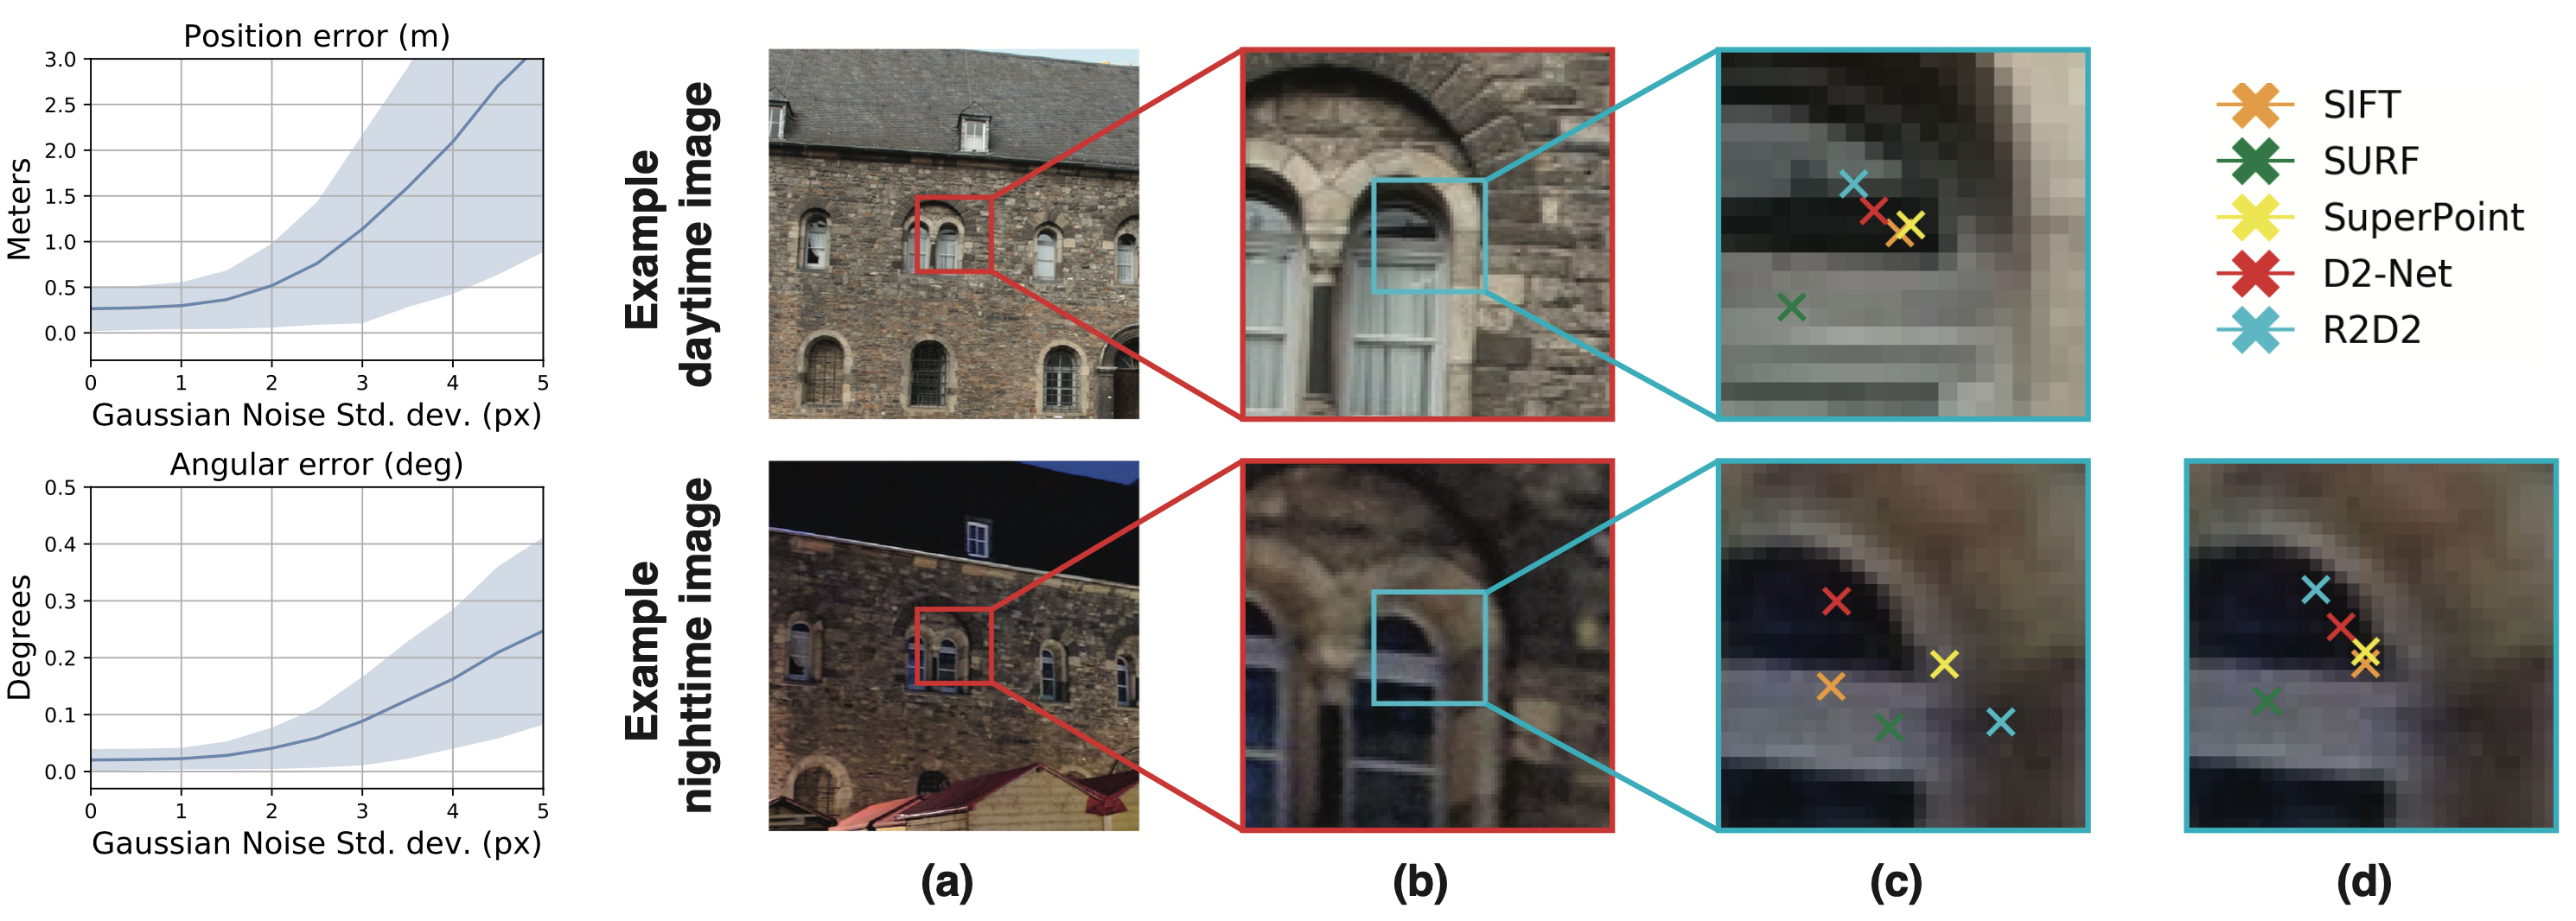
Sarlin 认为,在 3D 重建任务中,跨视角的可复检的特征点检测尤为重要。原有的 SfM 框架中(COLMAP),特征提取之后其位置并不会发生改变,若这个过程中出现了一定误差,势必造成后续几何结构的误差累计。于是作者针对以上 SfM 框架中的两个步骤进行了优化:1. 特征匹配后使用 Featuremetric 对特征点位置进行优化;2. 增量重建过程中通过类似的 Featuremetric 进行 BA(重投影误差变为 Featuremetric 误差)。该算法通过定量实验验证了其在 SfM 任务中的优势。
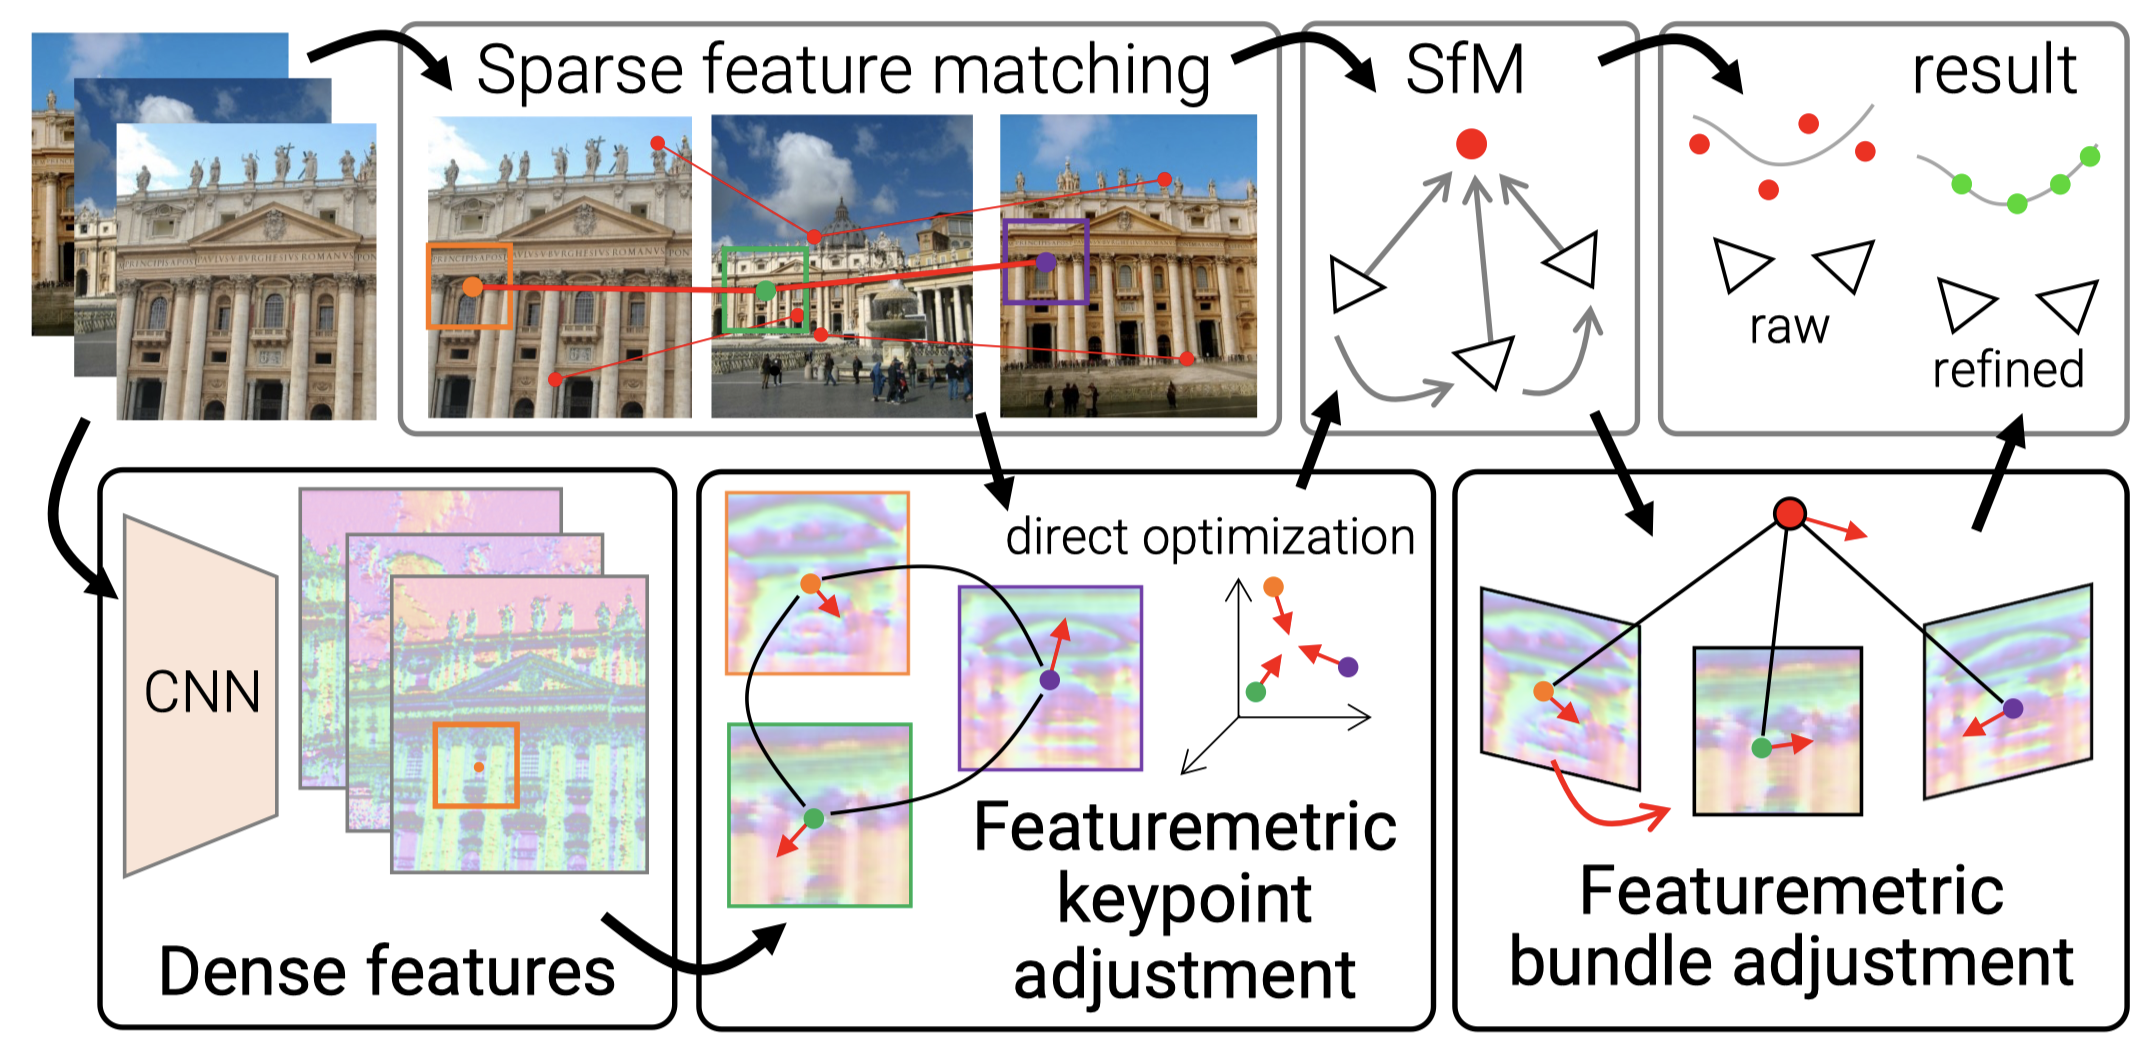
上图展示了 pixel-perfect-sfm 算法优化框架,它可在任何基于局部特征点的SfM流程中使用,首先使用CNN提取图像特征图(dense features),根据稀疏的特征匹配得到初始的tracks,调整每一个track对应的特征点在图像中的位置;根据调整后的位置进行SfM重建,重建过程中的BA优化残差由重投影误差变为Featuremetric误差,关于本文更加详细的解读参考链接。
建图问题的几类解法
上面列出的问题,大致可以对应到如下几类解法(部分是 2022 年之后出现的,详见文末后记):
- 换特征与匹配器。把 SIFT 换成 SuperPoint、R2D2、DISK 这类学习型特征,再用 SuperGlue 或 LightGlue 做匹配,是解决跨外观建图最直接有效的手段。HLoc 的建图流水线就是在 COLMAP 外面套了一层学习型特征与匹配,三角化和 BA 仍交给 COLMAP。
- 优化关键点位置。前面介绍的 pixel-perfect-sfm 在 SfM 前后各加一步 featuremetric 优化,把关键点误差从「检测器给什么用什么」变成「跨视角一致地调一调」。再往前一步是干脆不要检测器:LoFTR31 这类稠密匹配器直接输出半稠密对应,Detector-Free SfM32 围绕它重新设计了 track 构建与精修。
- 歧义消解。除了前文的 ReliableResectioning,常见思路还有基于共视图的几何验证(missing correspondence 分析、路径一致性检查)和基于检索的时间或地理先验。sfm-disambiguation-colmap 把这几种方法都实现了一遍,方便对比。
- 全局式 SfM。先解全体相机的旋转平均(rotation averaging),再解平移平均,最后一次全局 BA,避免增量式反复 BA 的开销。早期的 OpenMVG、Theia 走的是这条路,但鲁棒性一直不如 COLMAP;2024 年的 GLOMAP33 把平移平均换成直接联合估计相机位置与 3D 点的「全局定位」步骤,精度追平 COLMAP,速度快一到两个数量级。
- 分而治之。城市级场景按空间或共视关系切成子图,各自重建后再合并(hierarchical / distributed SfM),这是工程上大规模建图的标准做法。
- 语义与动态物体过滤。用语义分割把天空、行人、车辆上的特征直接剔除,或给它们更低的权重,地图会干净不少。
- 换一种地图表示。MeshLoc34(ECCV 2022)表明,用 MVS 生成的 mesh 代替稀疏点云做定位,匹配时在渲染视图上重新提特征,可以不依赖建图时的特征类型,地图更新也更容易。
基于结构信息+图像召回方案(structure based using image retrieval)
这种方式也就是所谓的层次定位(hierarchical localization)方案。简单来说就是该算法将定位过程分成两步,第一步是图像召回(检索),第二步类似于使用结构信息定位。第二步与上一节内容一致,此处省略,本节重点介绍图像检索在视觉定位技术中是如何使用的。
概念
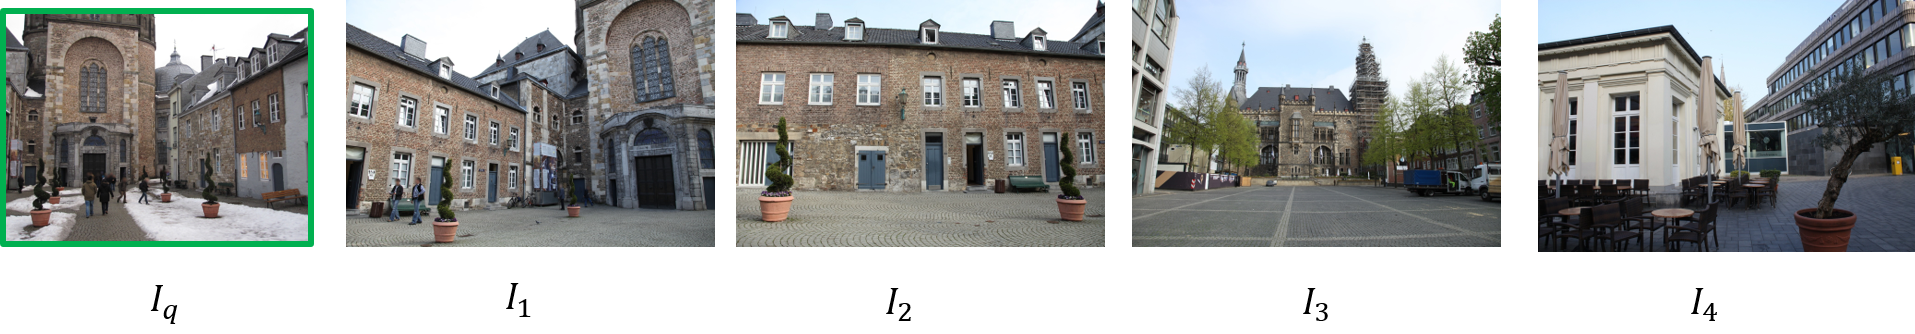
图像召回(检索),是从一系列图像数据库中以某种准则挑选出与查询图像最为相似的图像,通常在做完图像检索之后还会加一个重排序步骤(re-ranking,如query expansion)。在视觉定位任务中的图像召回(检索),按照召回标准可以被解释为查询帧(query)“看到”了与数据库帧(database)相同的场景(如,某栋建筑、地标),即我们通常讲的路标识别(landmark retrieval)或者数据库图像在查询图像拍摄地点附近拍摄的,并不一定“看到”相同的场景,这种召回标准叫做地点识别(geo-localization/place recognition )。二者的差异可以通过上图进行说明,其中 为查询图像,和为landmark retrieval,因为3张图像中包括相同的场景Aachen Cathedral。 和 为geo-localization,因为这两张图距离 的拍摄地很近,尽管图像外观并不相似,但在地理坐标是比较接近的。
 图片来源:Benchmarking Image Retrieval for Visual Localization35(arXiv)。
功能
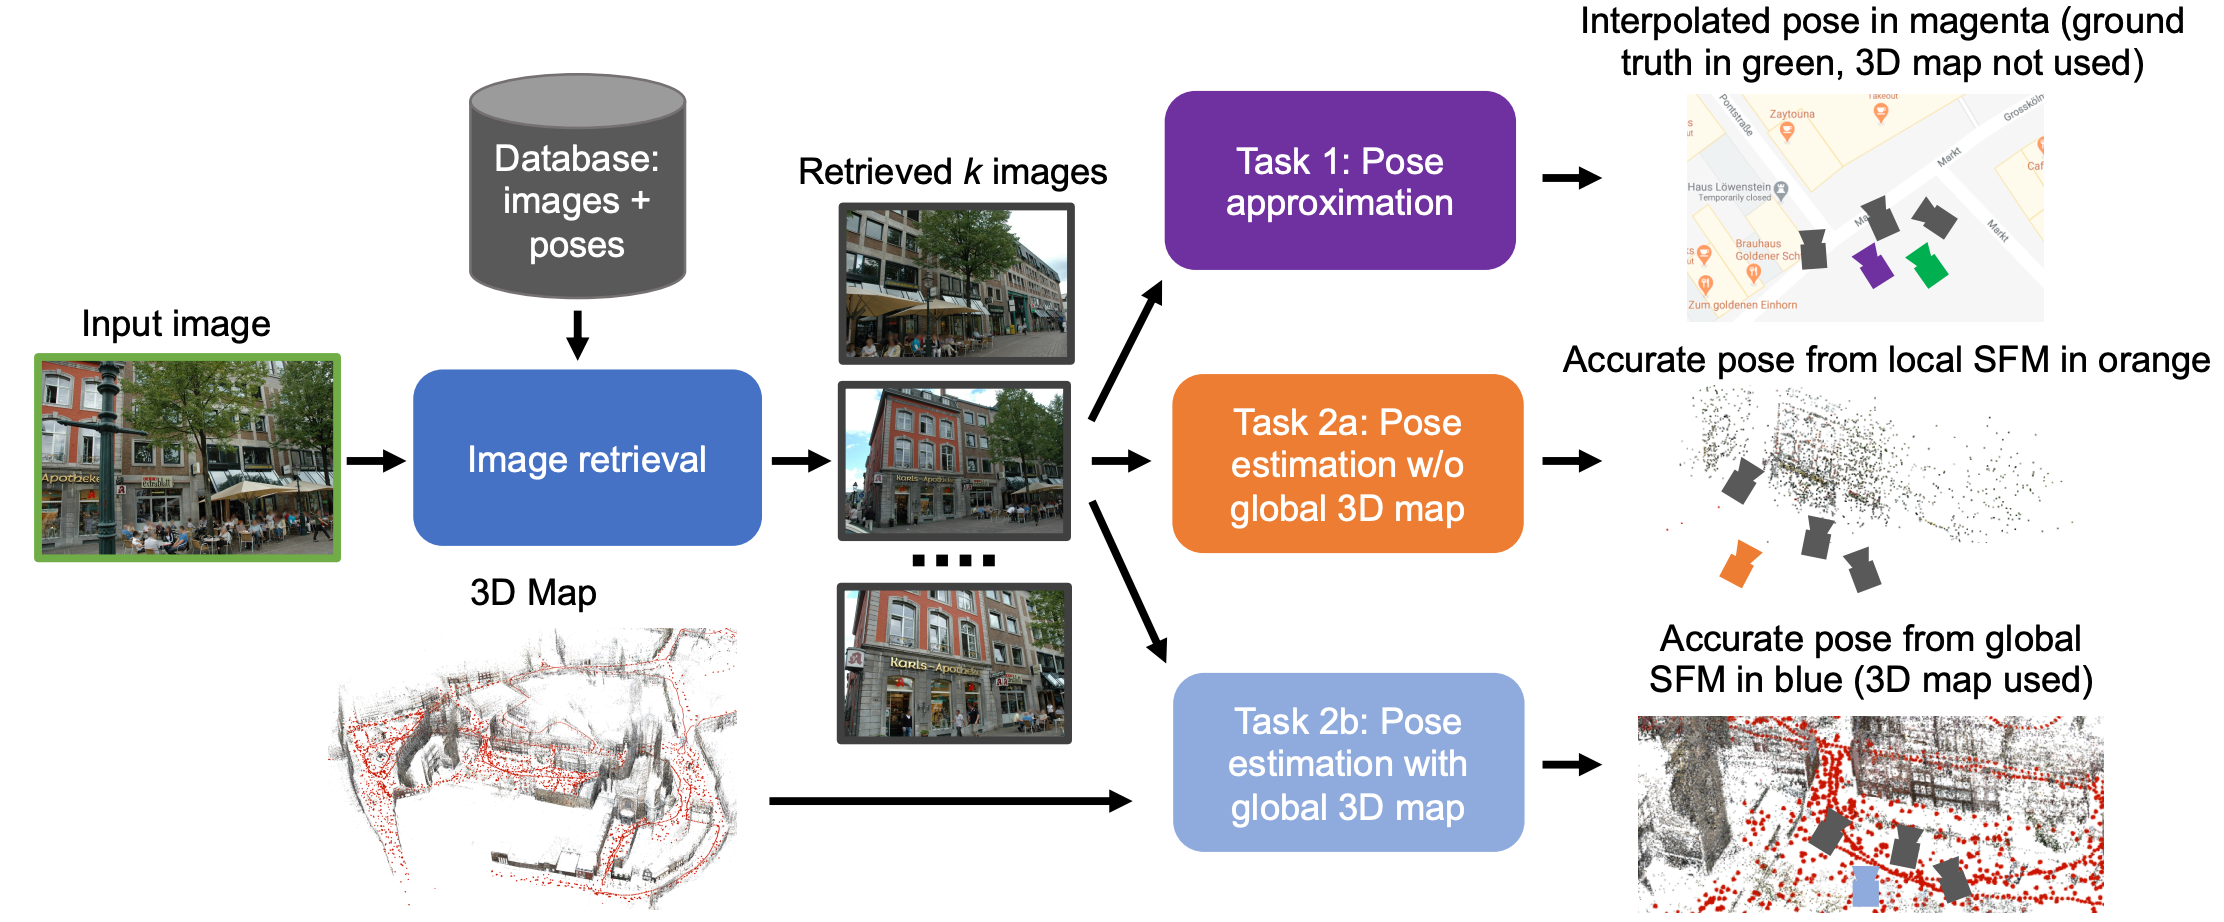
图像召回让视觉定位能够在超大场景中定位成为可能,同时可以使建图定位更加鲁棒(重定位)。之所以可以做的这一点,是因为图像召回可以非常显著地减小视觉定位的搜索空间,即查询图需要与多大范围地图的进行关联,有了图像召回,可以将这个范围缩小,降低数据关联耗时。此外,仅仅使用召回的图像(无需建图)也可以直接进行定位,即选择使用top k召回图像进行位姿加权36 37, 这要求在存储图像时,需要同时存储拍摄图像时相机位姿信息或者GPS地理坐标。此外,若已知相机内参,查询帧与召回的参考帧之间的相对位姿就可以非常方便地通过局部特征关联解算出来。此外,当已知召回的参考帧绝对位姿,那么查询帧的绝对位姿就可以通过上述相对位姿推演出38 39。
算法
过去十年,图像召回算法使用最多的是基于词袋(bag of words)的表示,但目前图像召回使用最多的是基于深度学习的方式40 41,这是由于深度特征中对图像的高层级的语义特征进行了编码(encode),这些信息非常适合用作图像召回任务。当网络使用ranking loss42 43 44专门对图像召回任务进行训练后,召回性能可以进一步得到提升。文献35 中介绍了一项关于图像召回在视觉定位任务中基准测试。作者在3个定位任务(使用全局3D地图,在线构建局部3D地图以及位姿插值)中评价了4种常见的图像表征方式。
国际顶级视觉会议 ICCV 从2014年至今开展了多次关于场景识别与视觉定位相关任务的介绍,这是2021年开展了的 Large-Scale Visual Localization Tutorial,其中 Giorgos Tolias进行了 Image Retrieval & Visual Representation 的介绍,内容较为详细,推荐一看。
下文对图像检索算法进行介绍。
视觉定位任务中图像召回(检索)通常是指实例级的检索IIR (Instance level Image Retrieval),与之对应的是类别级图像检索CIR (Category level Image Retrieval)。前者表示检索特定的图像,如埃菲尔铁塔、乐山大佛等;而后者是指检索一个类别的图形,如塔、佛像,至于到底是哪个塔以及哪个佛像不加区分。至于为何视觉定位任务中使用实例级别图像,原因是显而易见的,因为检索到图像之后,我们就可以大致清楚拍摄查询图像的相机可能与拍摄检索图像的相机的位姿是比较接近的,可以获得一个非常粗暴的定位结果,或者查询图像要与检索到的图像进行局部特征级的匹配并进行位姿解算得到精细化的位姿,从这个意义上讲非实例级的匹配是没有意义的。
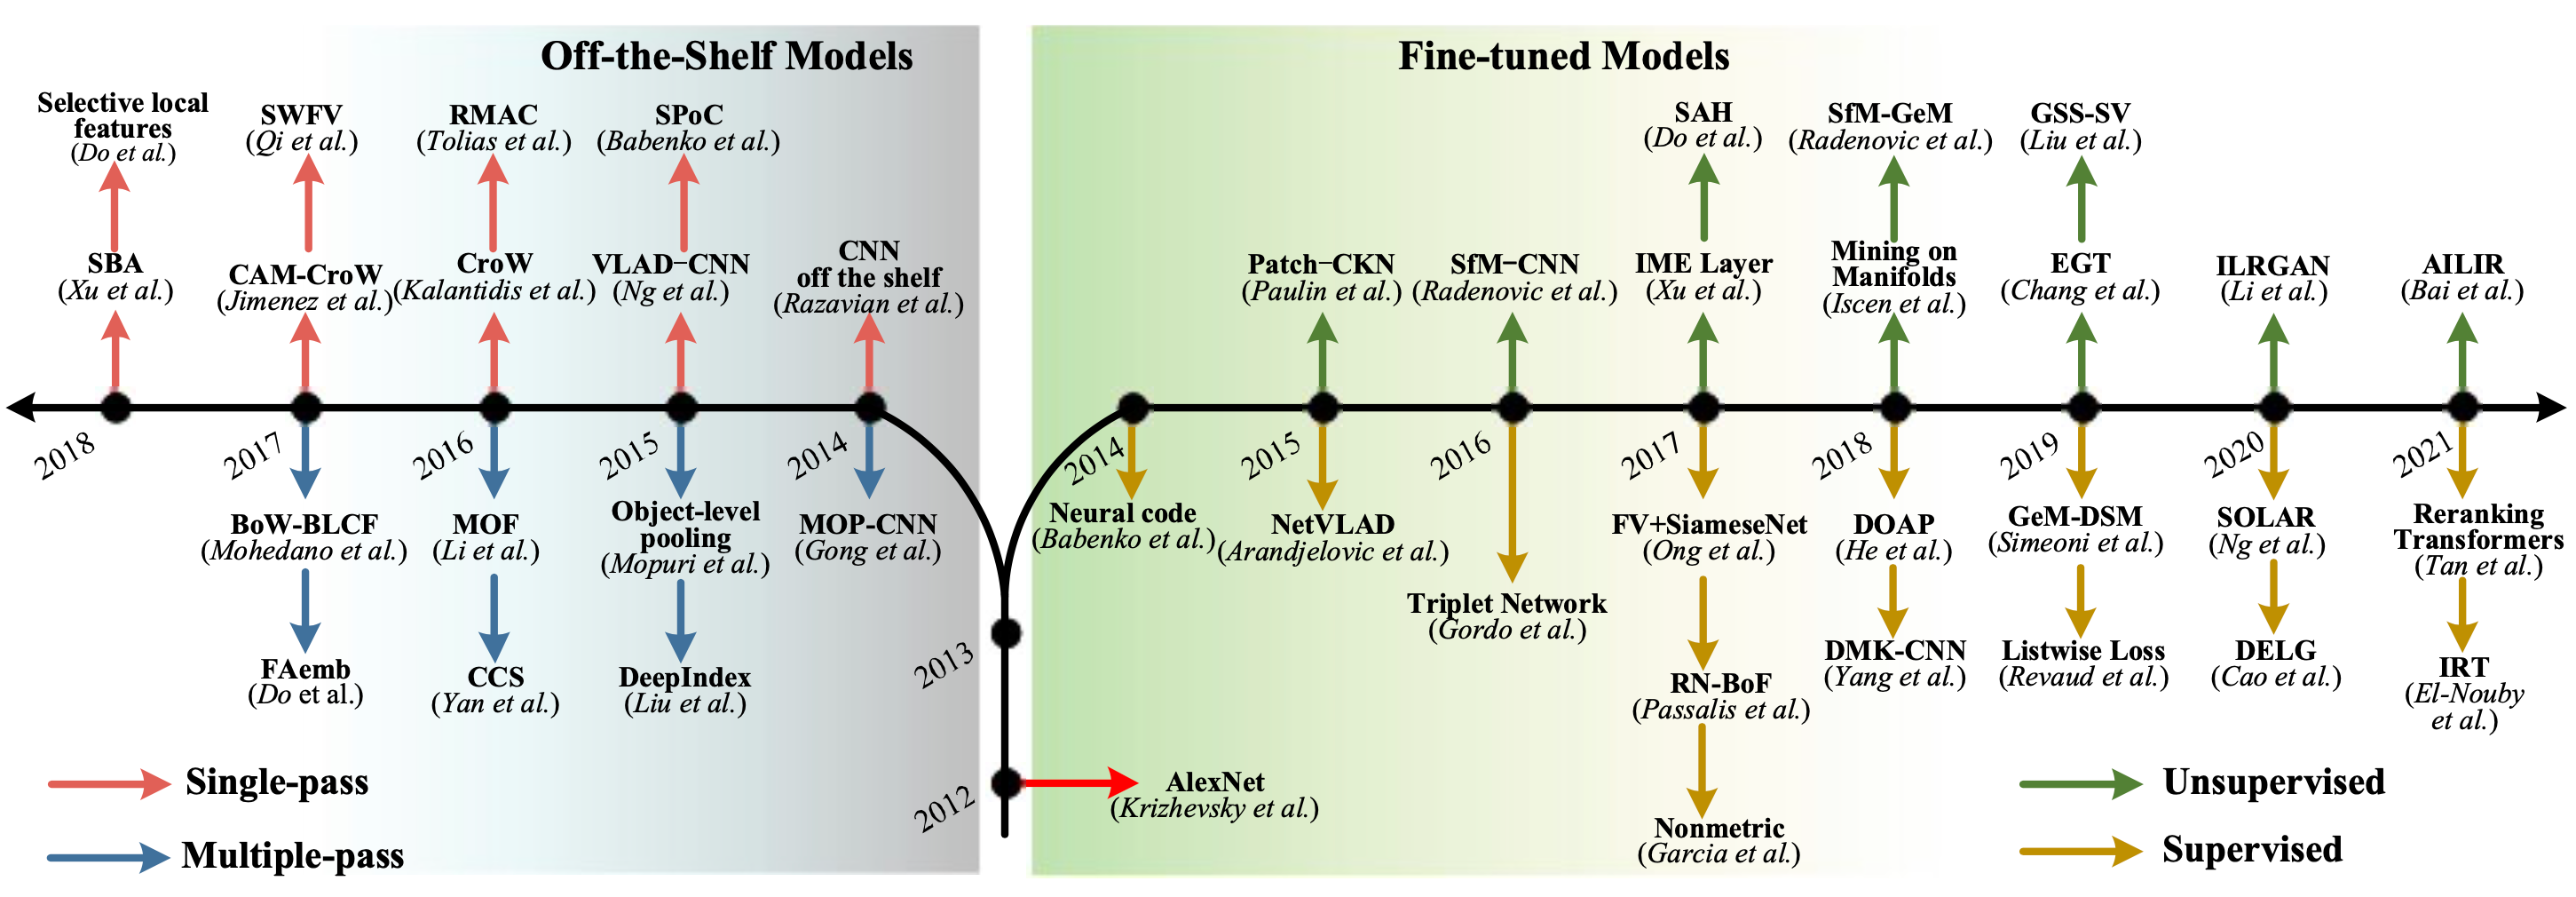
接下来详细对目前图像检索策略进行介绍,上图展示了IIR的发展脉络。整体而言,目前基于深度学习的IIR方法可以分为Off-the-shelf models(网络参数固定)以及Fine-tuned Models(网络参数调整)两个领域(后文进行简介),各自领域内衍生出诸多具有代表性的算法。例如,off-the shelf models中MAC系列(MAC/R-MAC等),fine-tuned models中的NetVLAD,DELG,HOW等。IIR的趋势在fine-tuned models方向发展,主干网络从传统的CNN网络转向Transformer,注意力机制可进一步提升网络性能,面向大规模图像召回任务的无监督学习将会成为以后的主流。
自从2012年 AlexNet问世以来,深度学习便在各研究方向进行探索,迄今为止,不少于百篇在IIR领域的优秀研究工作纷纷涌现。值得说明的是,虽然论文中的方法很多,但其大体上可以总结为如下图像召回流程。
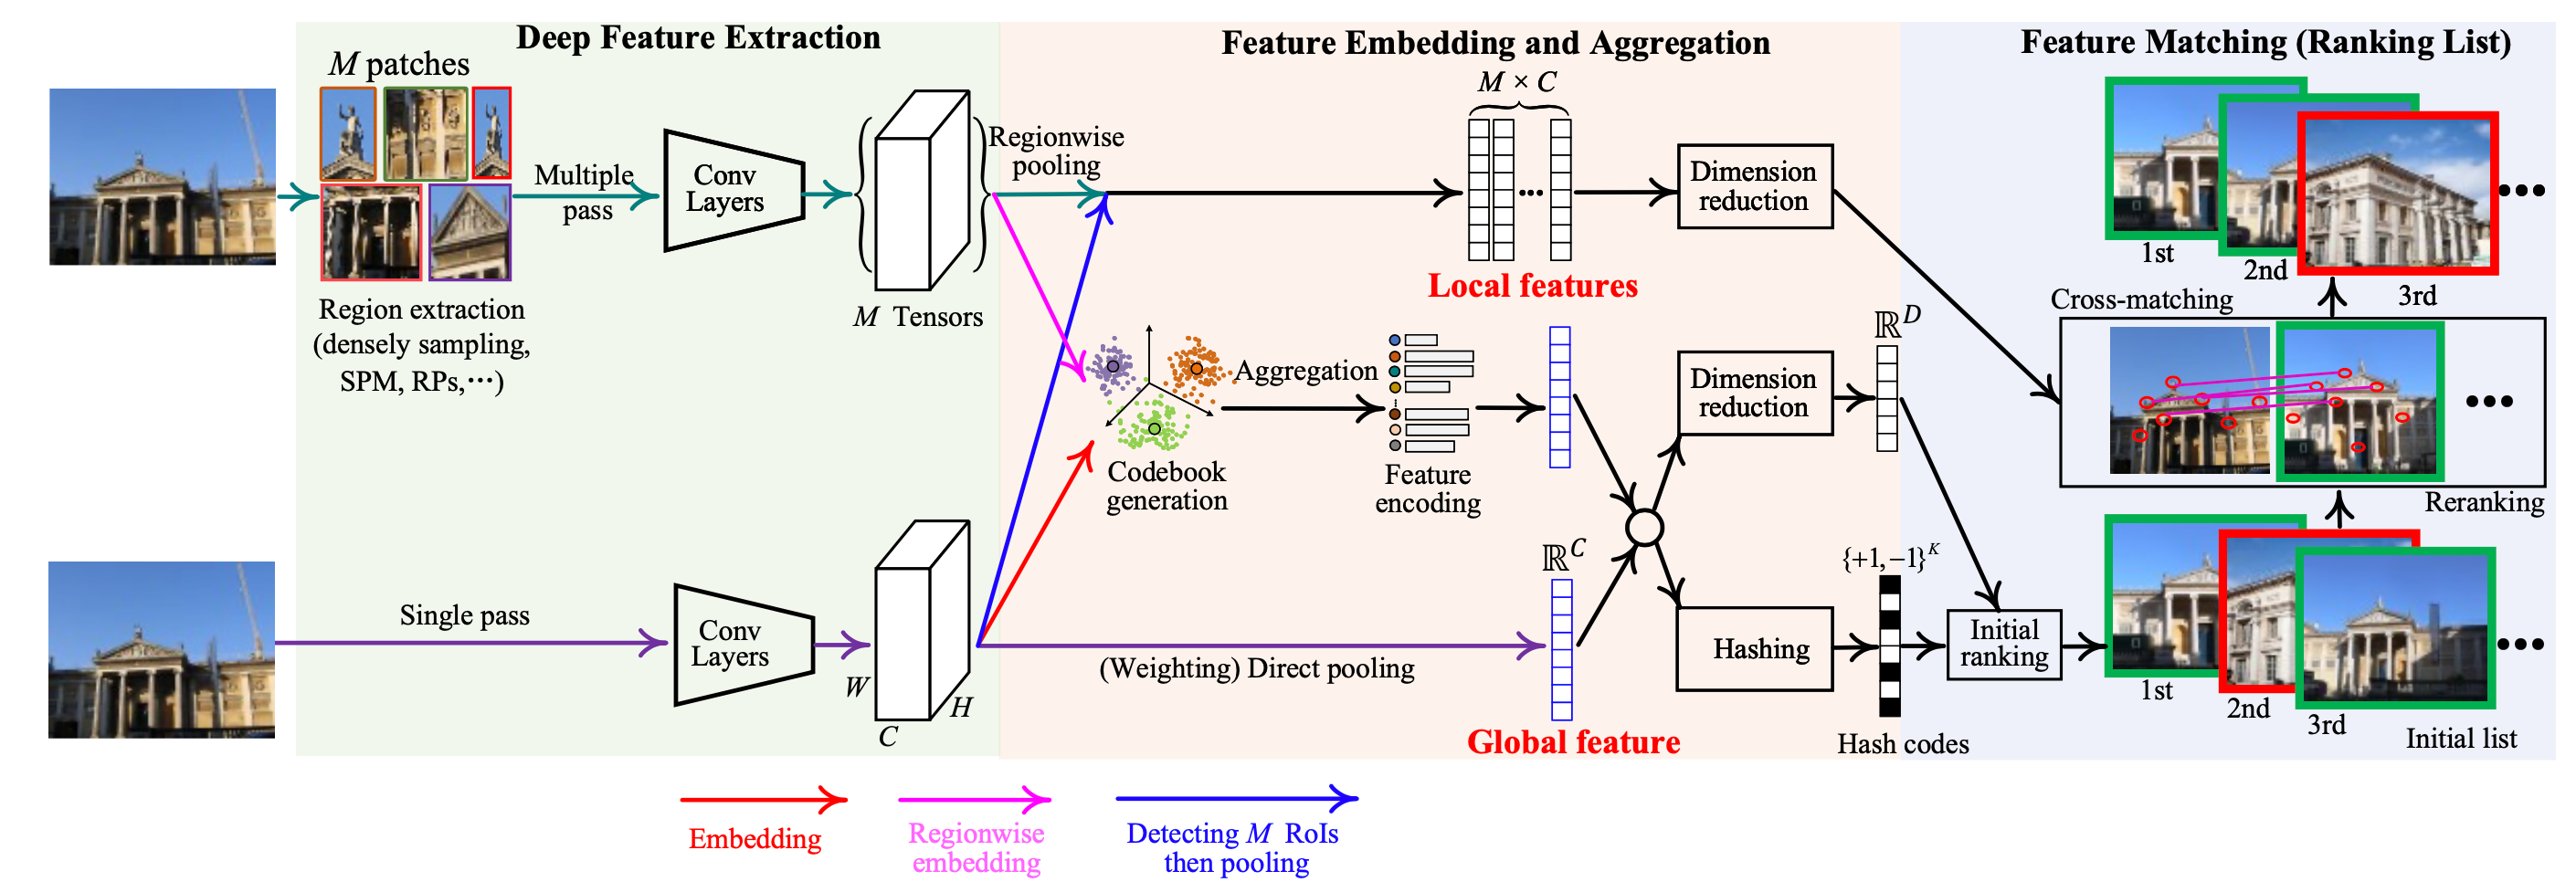
整体上看,图像召回任务可以分为三个主要步骤:深度特征提取(deep feature extraction)、特征嵌入与聚合(Feature Embedding and Aggregation)以及特征匹配(Feature Matching)或者叫做候选重排序(Re-ranking)
- 深度特征提取
该步骤主要利用神经网络强大的特征提取能力提取图像的特征,将RGB/灰度图映射为一个多维张量。此处的网络可以直接在原始图像上提取特征,这种方式称为single-pass feedforward;也可以在原始图像的patches上进行提取,此处涉及多种如上图所示的patches的设计方式,这种方式称为multi-pass feedforward。常用的特征提取网络(作为backbone)有AlexNet, VGGNet,GoogLeNet,ResNet等。
对于single-pass feedforward,网络的输入是一张图像,输出是一个高维张量 ,若将 和 维度展开,可得到,即 个长度为 的向量;
对于multi-pass feedforward,网络的输入是M个patches,输出是M个高维张量集合;
值得说明的是,这里的特征提取网络根据其权重是否进行调整可以分划分为无参数调整网络(off-the-shelf models)以及参数调整网络(fine-tune models)。
- 特征嵌入与聚合
该步骤主要目的是进一步提升特征的可辨别性以及获得最终的全局或者局部特征。
如选定特征嵌入方式为BoW,对于 single-pass feedforward 输出的局部特征,根据预先训练好的字典可以把每个特征分配到 个单词之一,之后统计每个单词出现的频次构建基于词袋的全局特征。将这个过程公式化:令局部特征为 ,字典(码本)为 , 为把 分配到最近单词的量化函数,则第 个单词的聚合值为其出现频率
全局描述子就是所有单词频率的集合 ,维度为 ,之后一般再做 TF-IDF 加权与 L2 归一化。VLAD 与 BoW 的差别在于聚合的内容:BoW 只记录「落在这个单词里的特征有几个」,VLAD 记录的是「这些特征相对聚类中心偏到了哪里」,即累加残差向量
所有单词的 拼接起来得到 ,维度为 ,其中 为局部特征维度、 为聚类数量。同样的 下 VLAD 保留的信息远多于 BoW,所以可以用很小的字典( 或 )得到有竞争力的全局特征,代价是维度高,通常要接 PCA 白化降维。
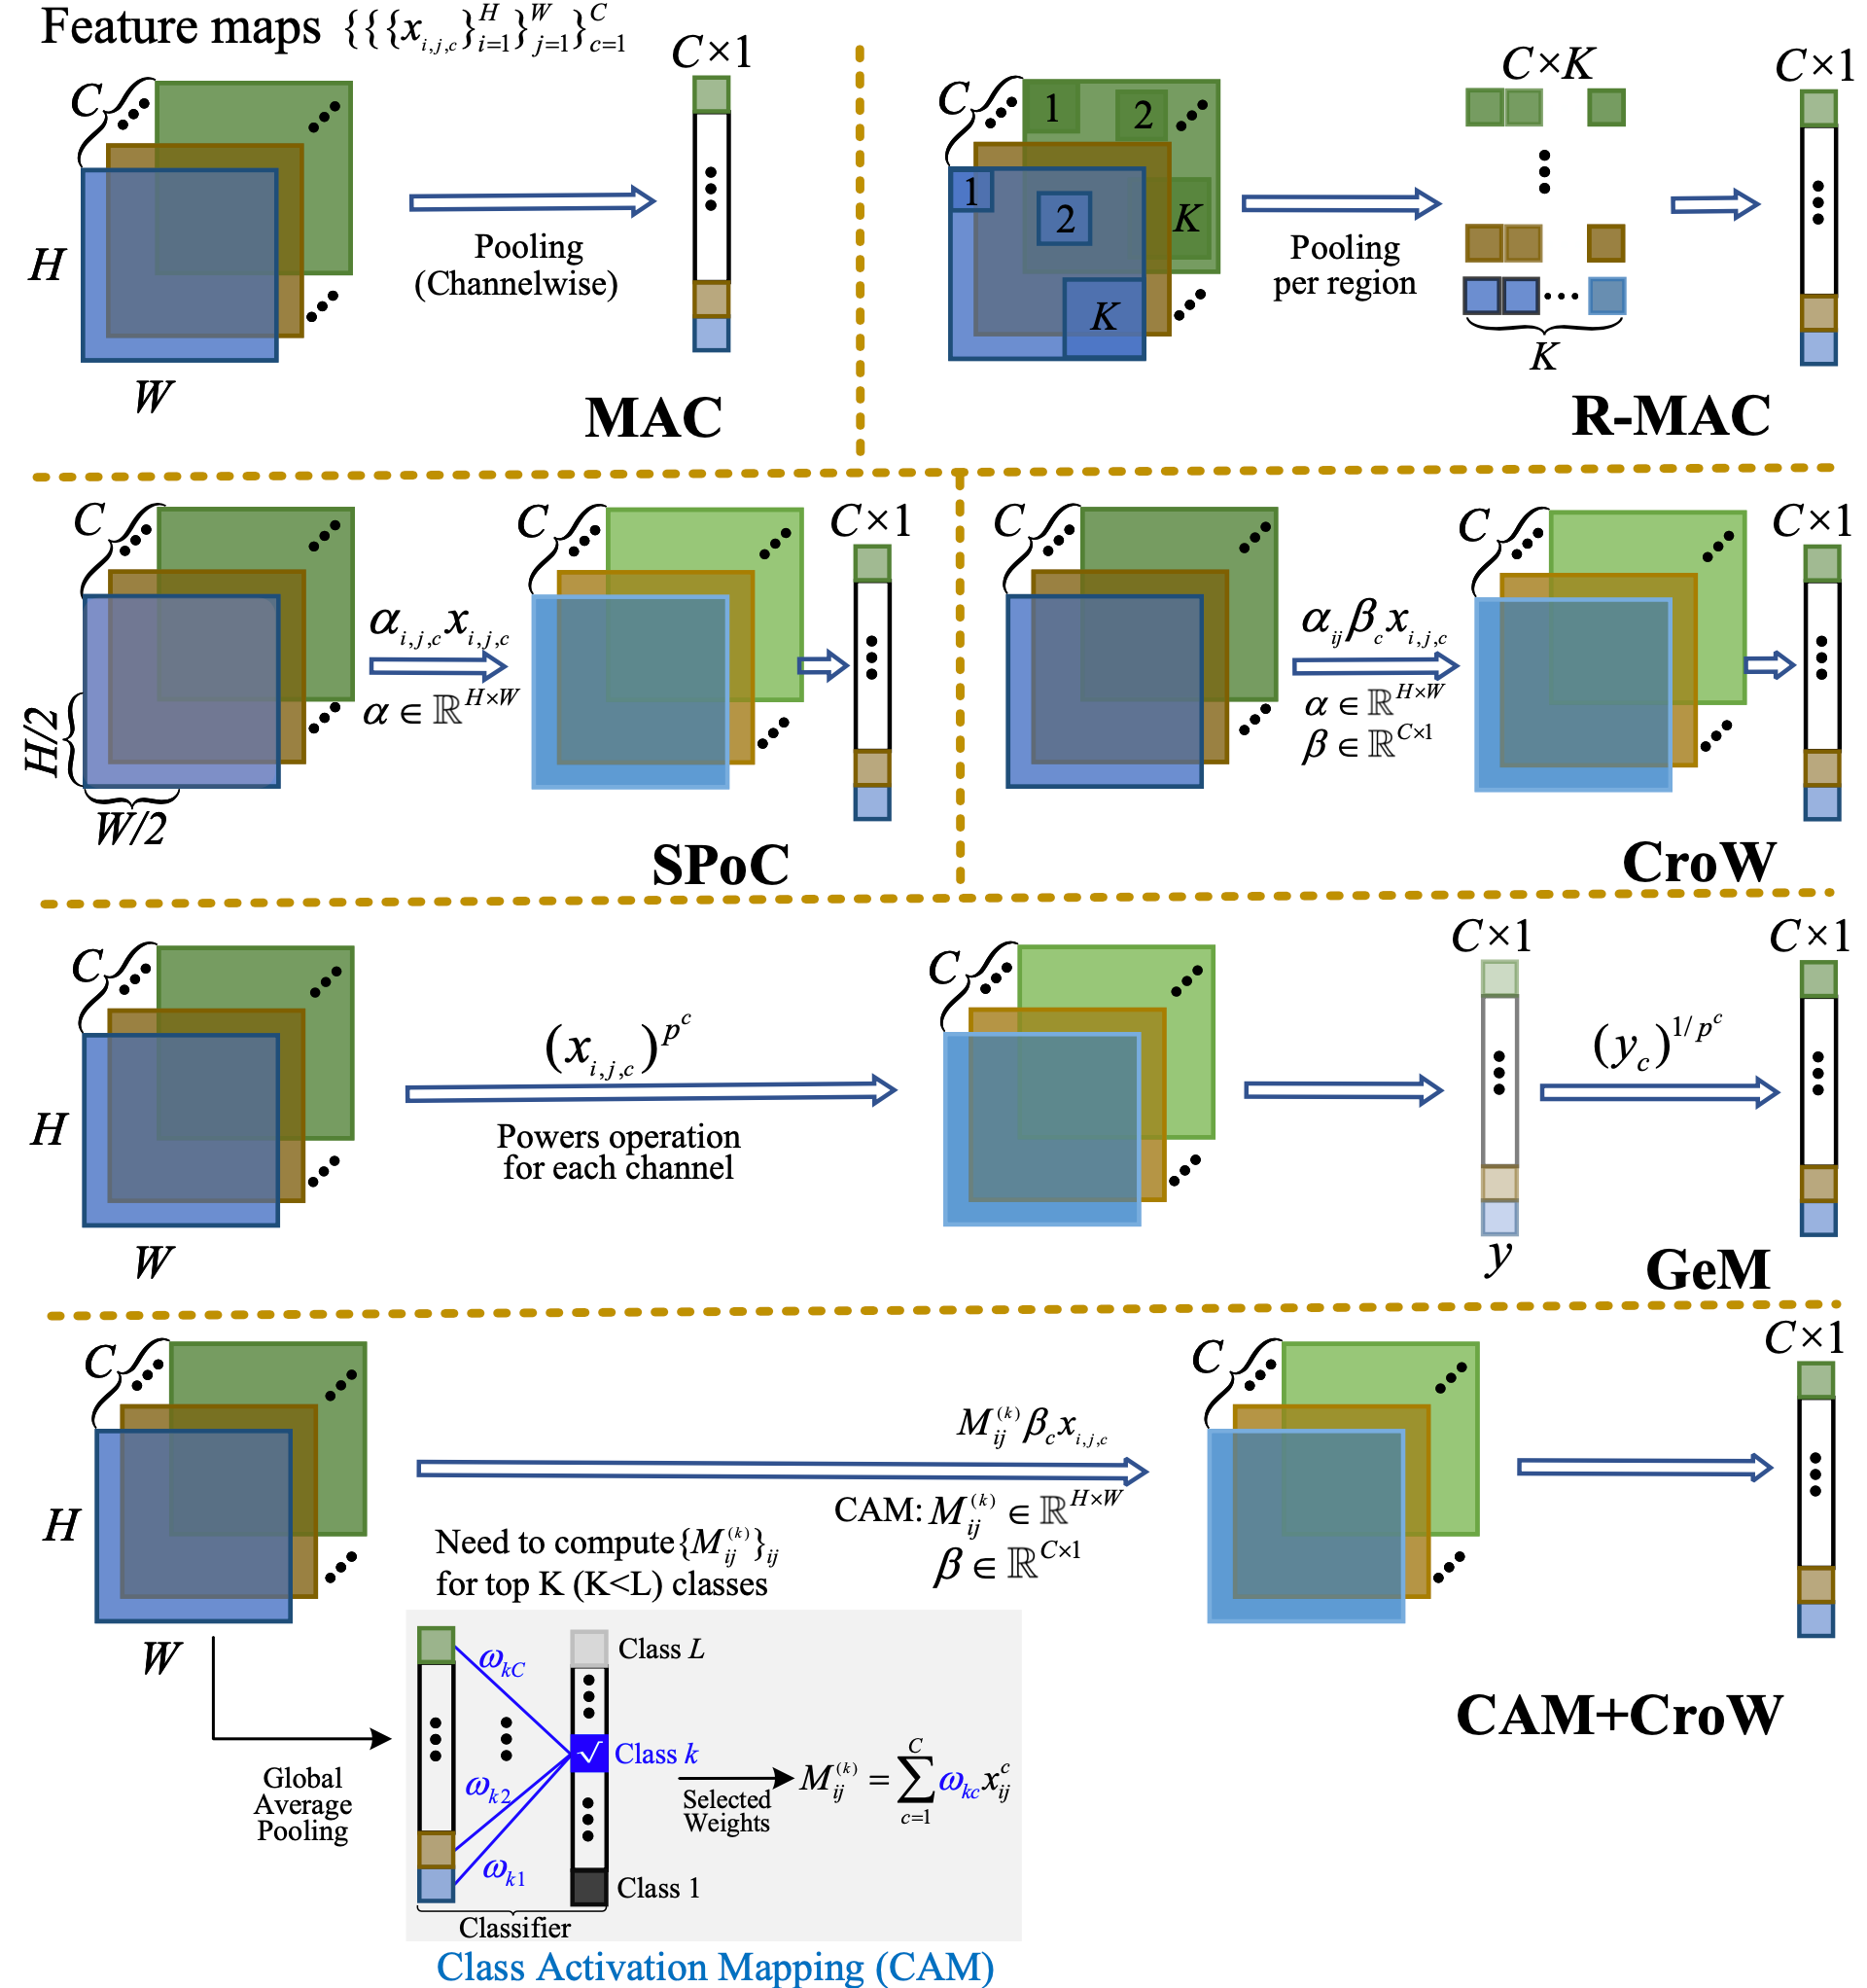
上图展示了如何将网络得到高维特征图转换成一维向量的过程。以 GeM 45为例,其具体形式如下表示:
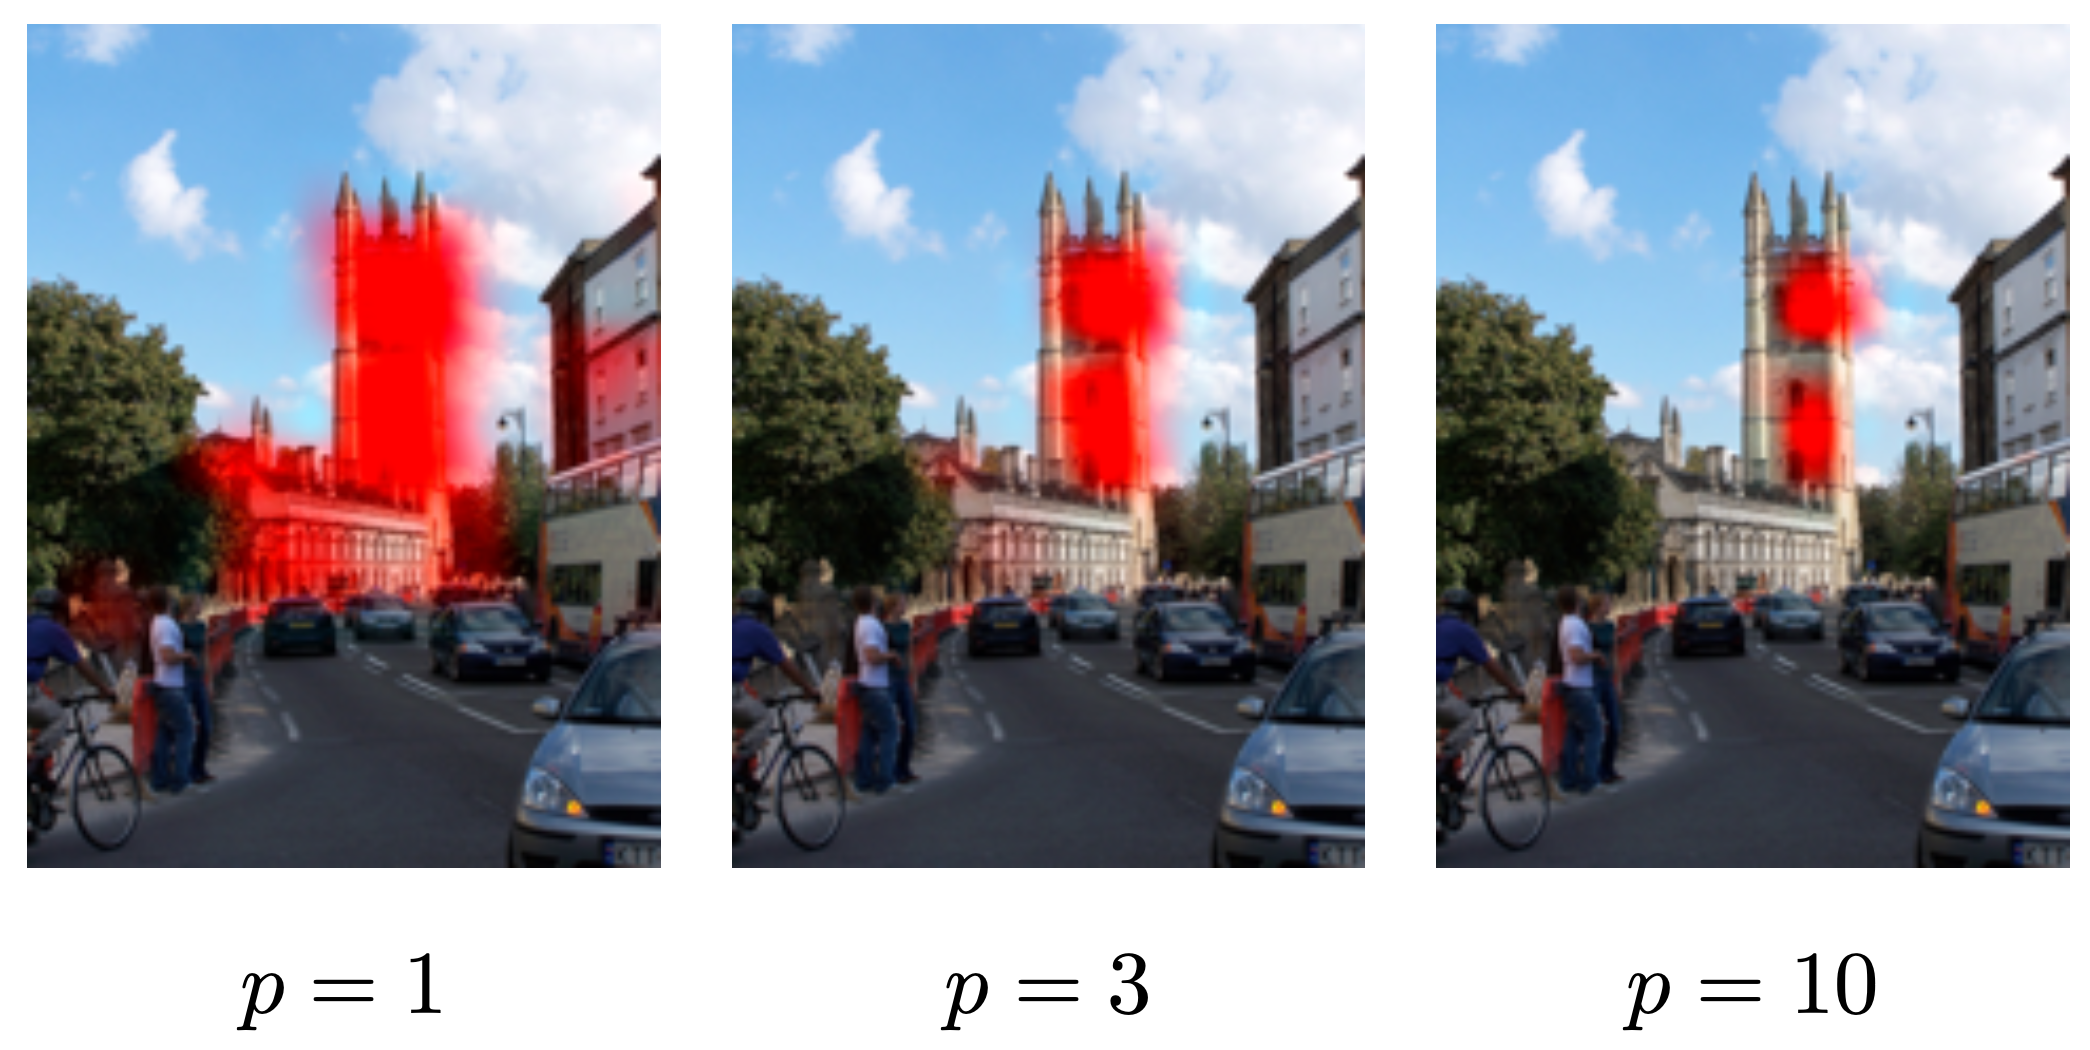
其中 维度为 , 表示第 个通道的特征图( 为通道数), 表示常量系数( 范数),不同的 会导致网络关注区域的差异,下图展示了这种差异。
此外,注意力机制可以被视作一种特征聚合,核心在于使用attention map强调最为相关的特征。而注意力机制中根据得到注意力图的差异可以分为无参数(non-parametric下图ab)与有参数注意力(parametric下图cd)。
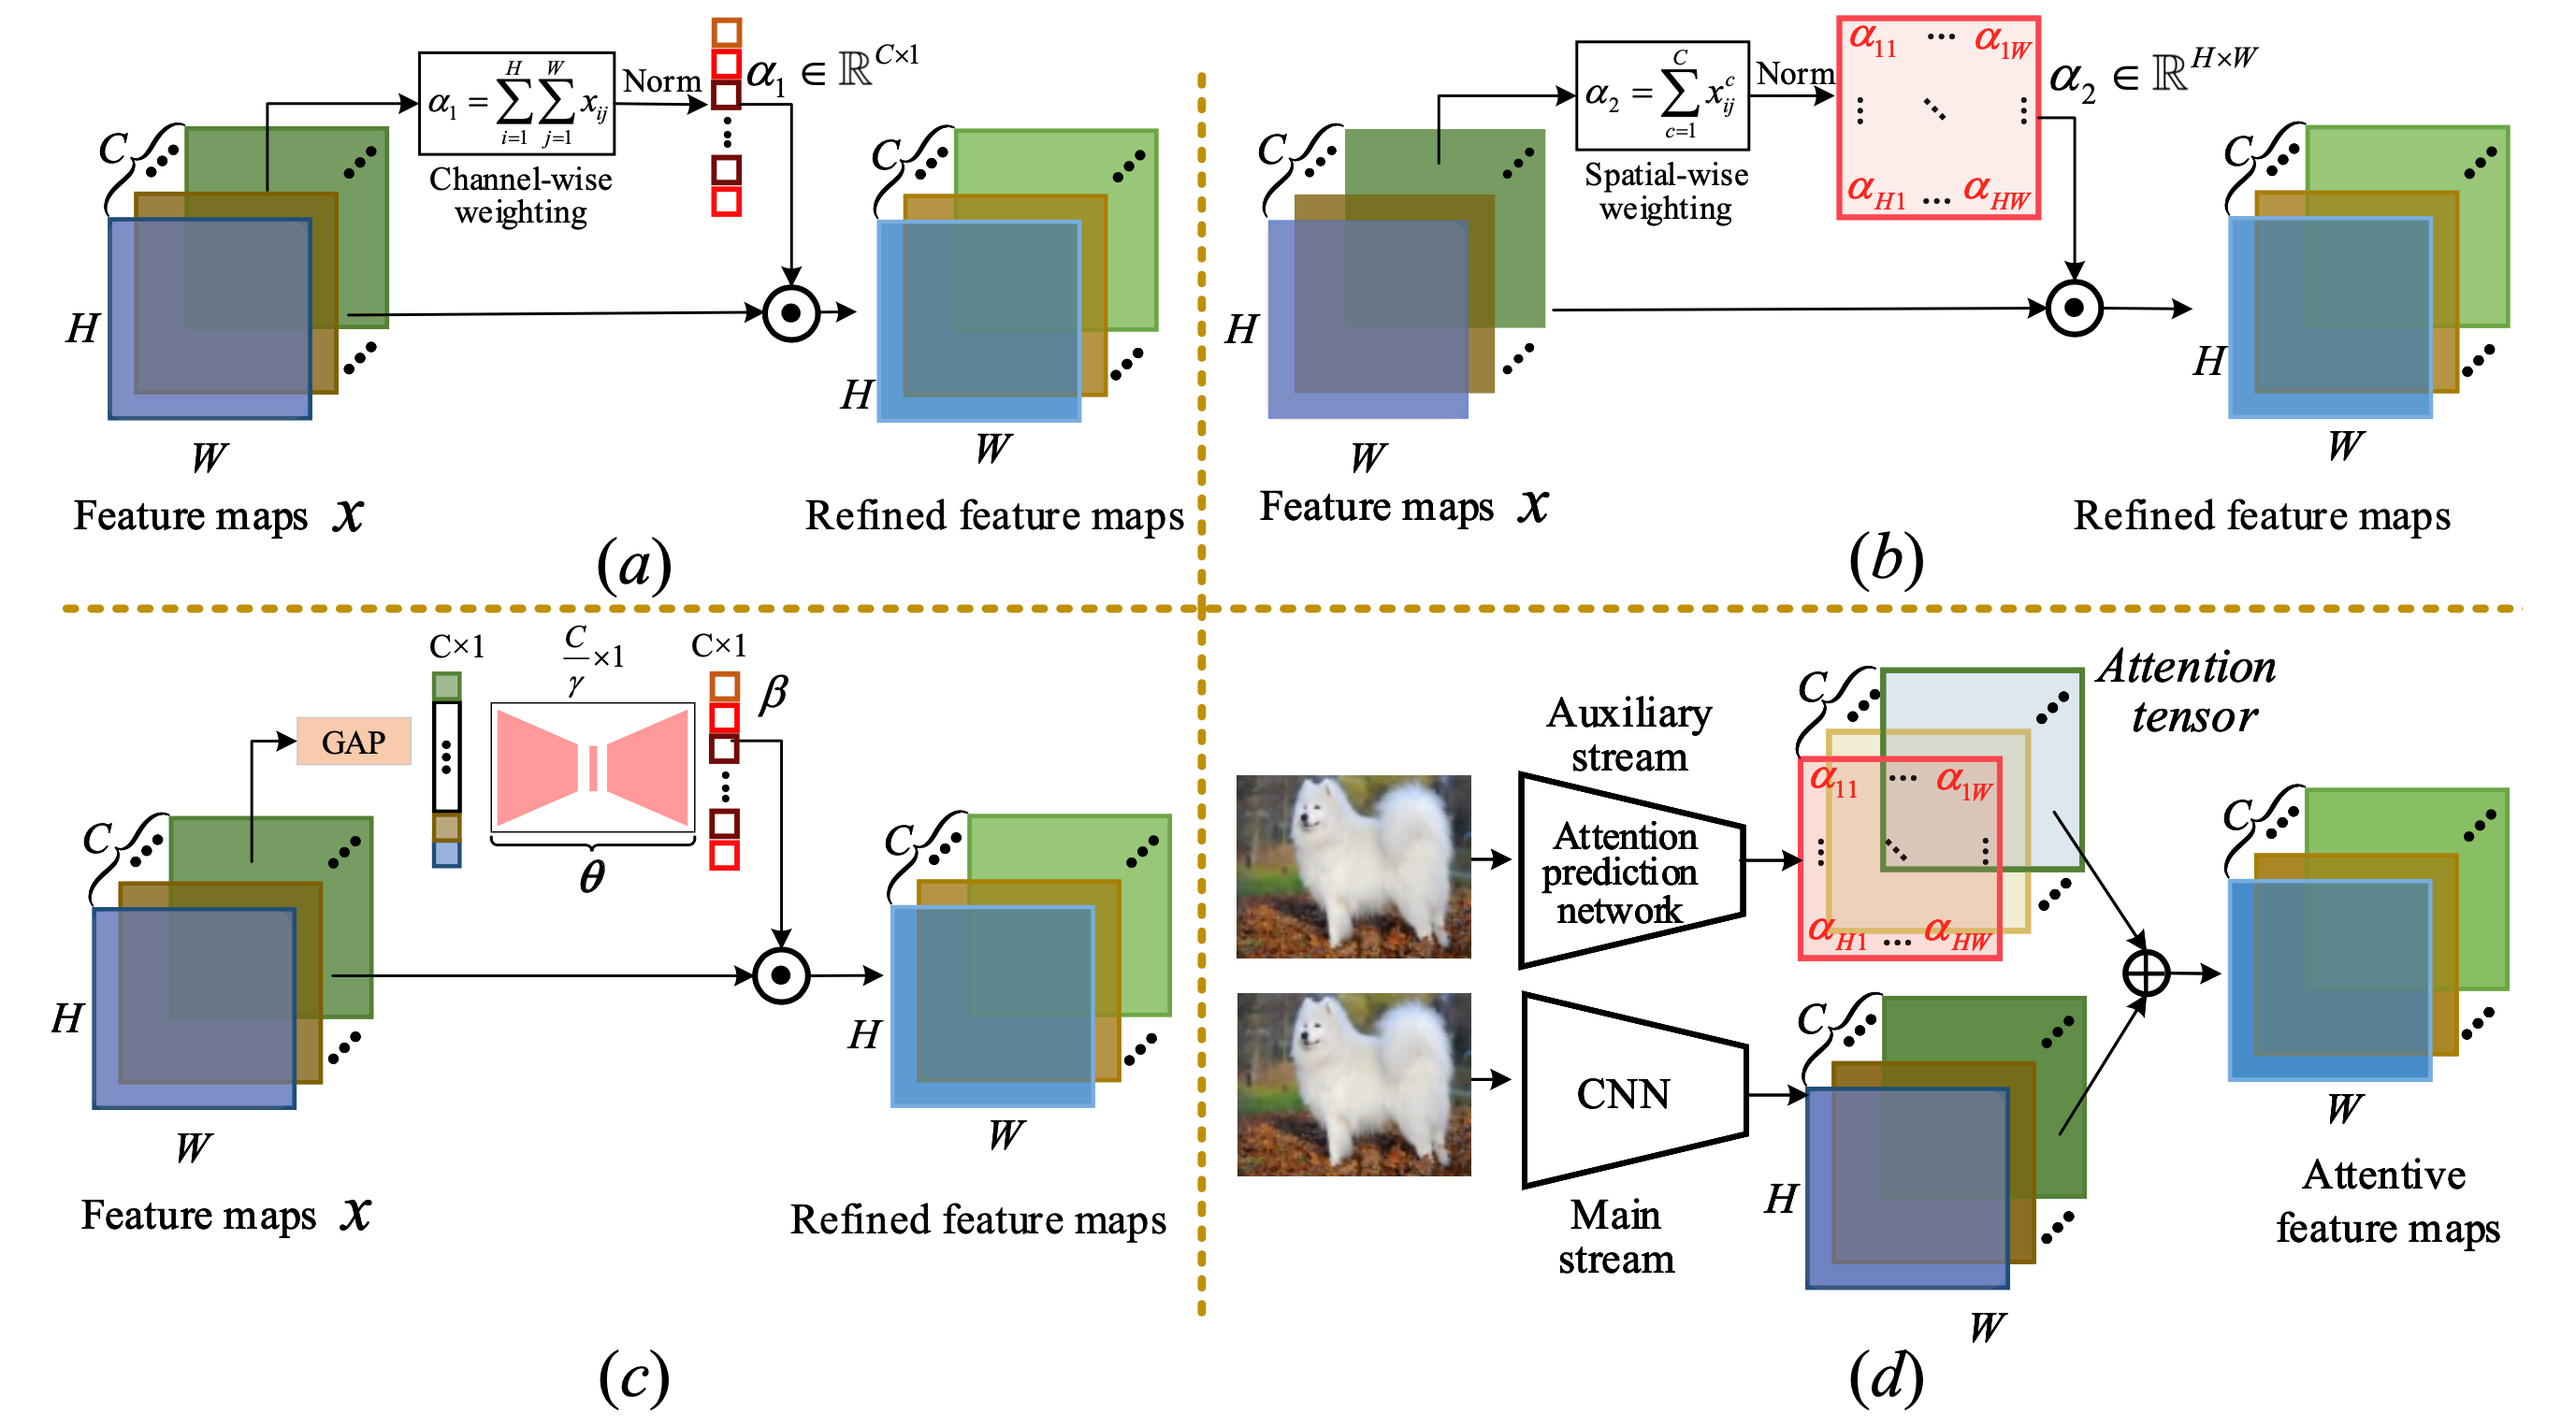
对于无参数的注意力,这种注意力机制较为直接地使用了DCNN输出层的feature maps,随后采用channel-wise(上图a)或者spatial-wise pooling(上图b)得到attention vector或者attention map; 对于有参数的注意力,通过网络学习得到注意力向量(上图c)或者注意力图(上图d)。 对于特征嵌入,hashing提供了一种新的思路,它可以将冗长的深度学习特征变换为紧凑的数据表示形式,这对于全局召回任务非常友好。
- 特征匹配/候选重排序 得到图像的全局或者局部描述之后,需要找到其在database中对应的match-lists。对于全局特征,可以使用欧氏距离、汉明距离或者其他距离度量对全局特征的相似度进行度量。对于局部特征,可以使用特征匹配+RANSAC或者ASMK的方式判定相似度。通常情况下,为了提升效率,首先使用全局描述子获得候选的match-lists之后,再使用re-ranking调整lists。
参考两篇综述文章:
经典全局特征:BoW 与 VLAD
BoW(bag of visual words)由 Sivic 和 Zisserman 在 2003 年的 Video Google46 中引入图像检索:把 SIFT 这类局部描述子用 k-means 量化成「视觉单词」,一张图像就变成一个单词直方图,检索时套用文本检索的倒排索引与 TF-IDF 权重。Nistér 和 Stewénius 的词汇树47把字典做到了百万量级,使百万张图像的实时检索成为可能,这也是 ORB-SLAM 等系统里 DBoW 重定位模块的原型。BoW 的问题是量化损失大:两个相距很远的描述子只要落在同一个单词就被视为相同,同一单词内的几何信息也全部丢失,因此通常要配合空间校验(用 RANSAC 验证几何一致性)做重排序。
VLAD(vector of locally aggregated descriptors)48是 Fisher 向量的简化版,上一节已经给出了公式。工程上还有几个细节:对 做幂归一化(power normalization,常取平方根)可以抑制突发纹理(burstiness);intra-normalization 对每个 单独 L2 归一化,避免某个单词主导整个向量;最后整体 L2 归一化再 PCA 白化到 128 至 4096 维。VLAD 在 2010 年代初是「紧凑全局特征」的事实标准,NetVLAD 正是在它上面长出来的。
NetVLAD
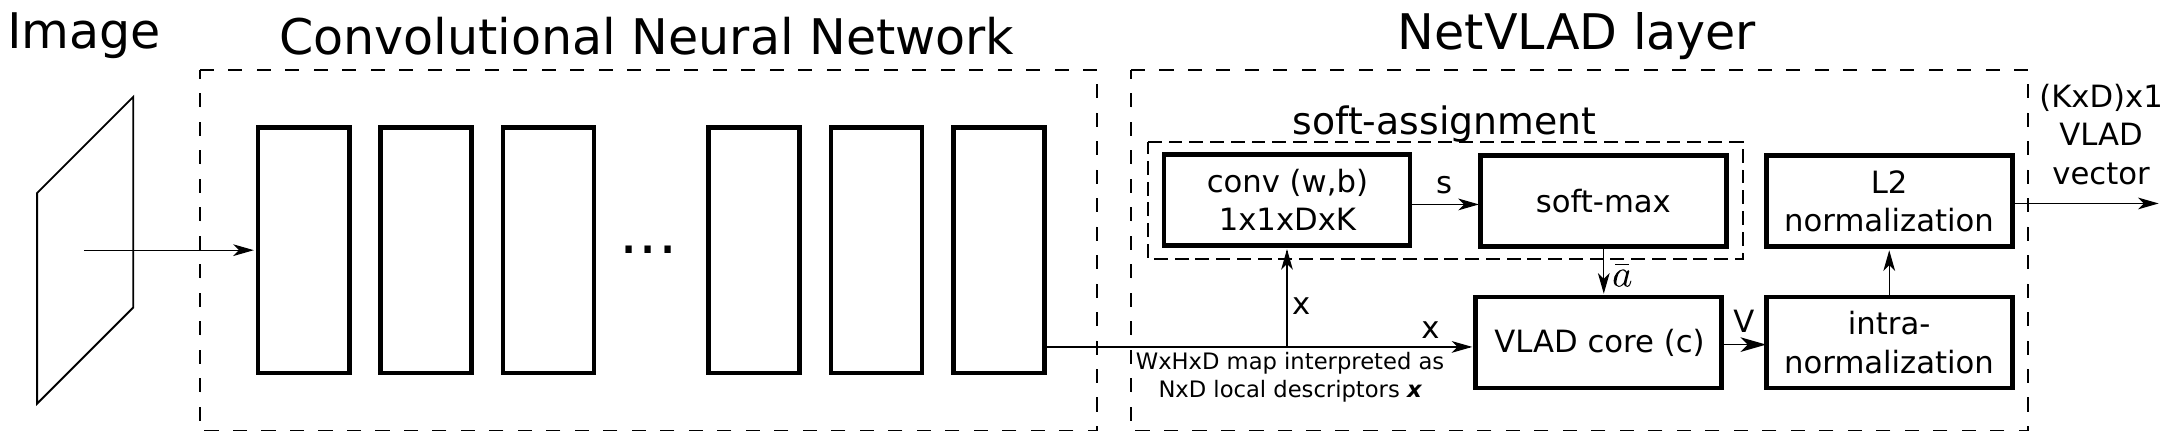
NetVLAD40(CVPR 2016)把 VLAD 变成了一个可以端到端训练的网络层。把 CNN 最后一层卷积输出的 特征图看成 个 维局部描述子 。VLAD 中「硬分配到最近聚类中心」这一步不可导,NetVLAD 用 softmax 形式的软分配代替:
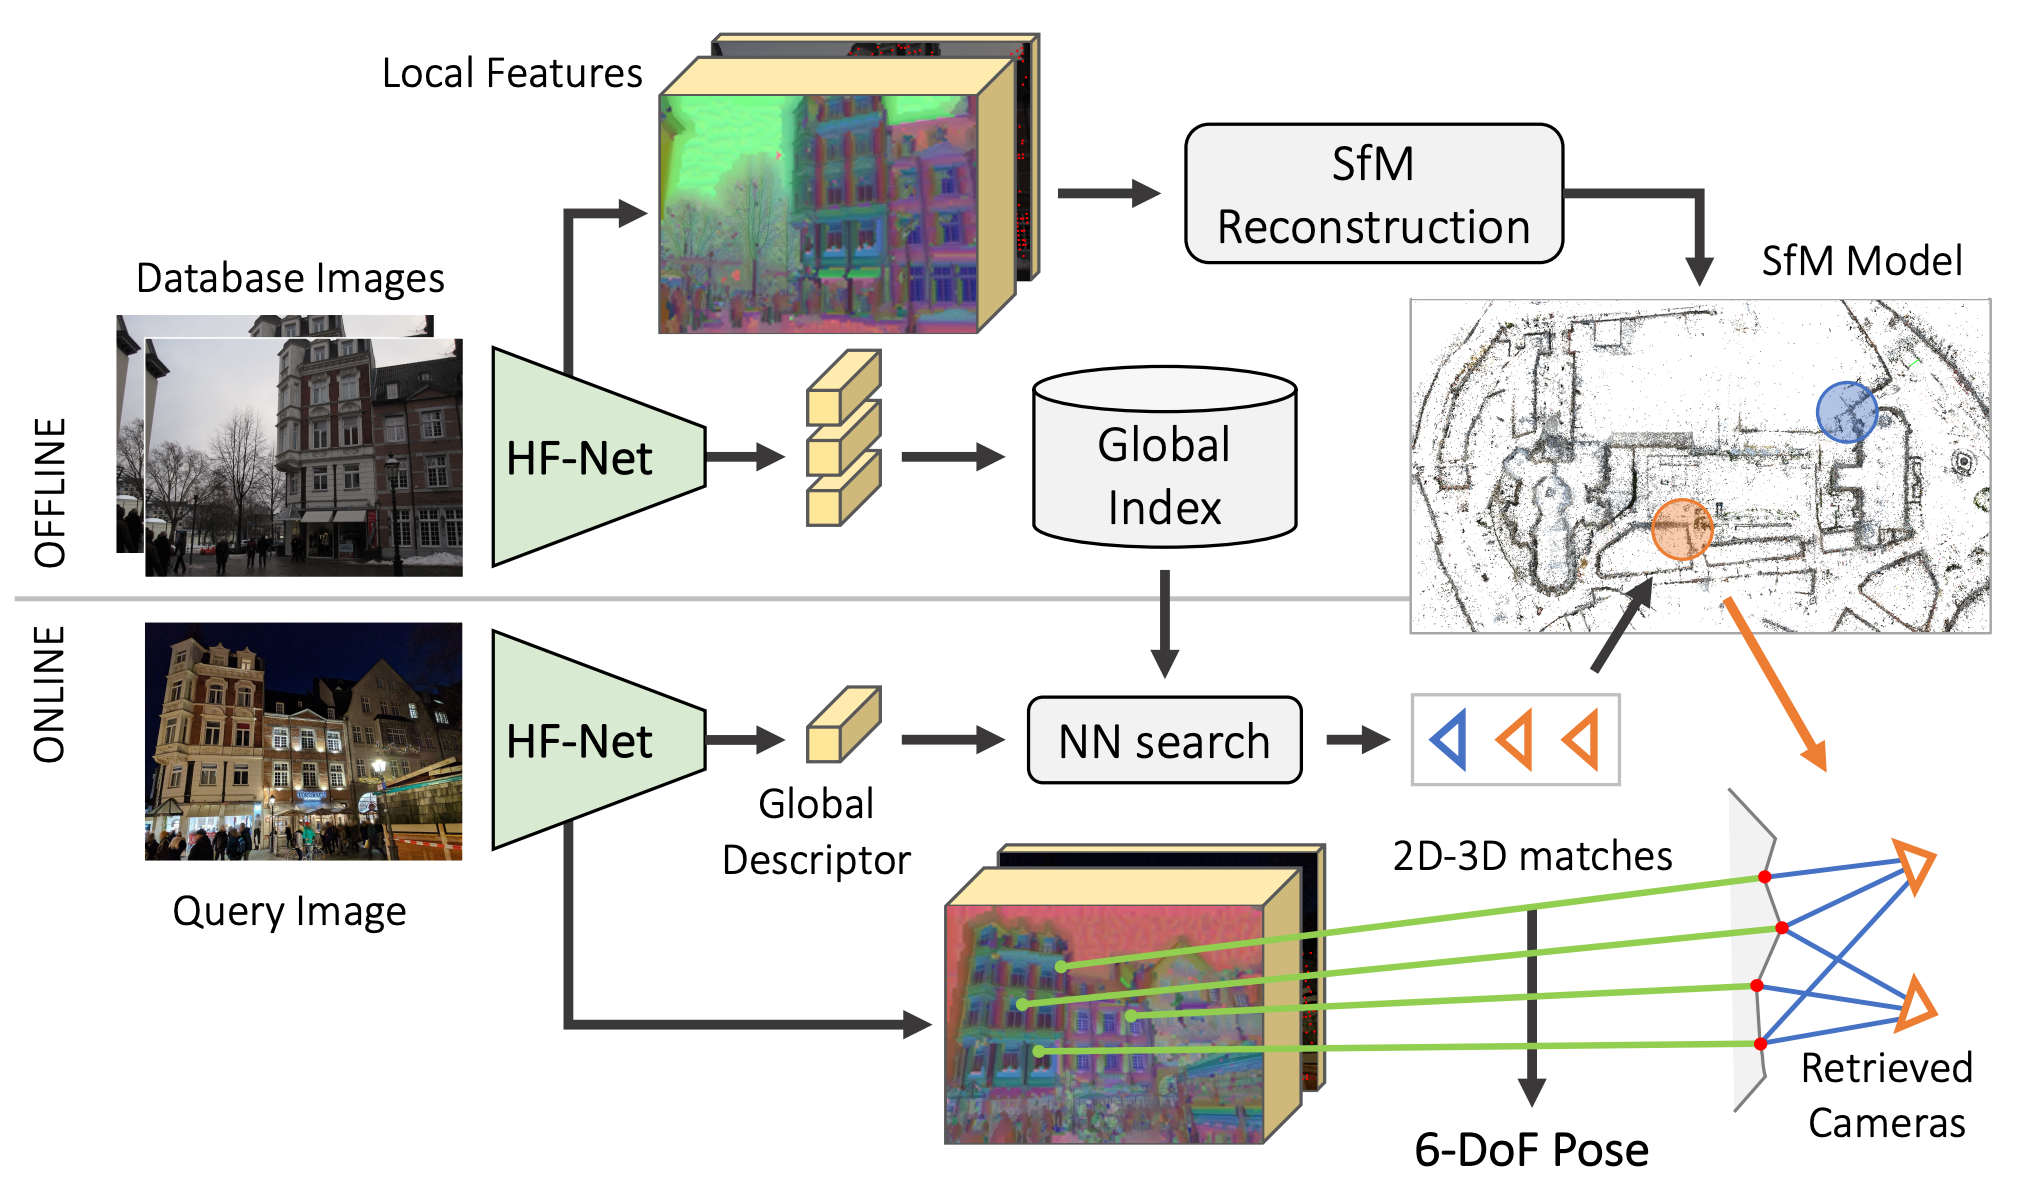
其中 都是可学习参数,聚类中心 与分配权重 解耦,比原始 VLAD 多了一份灵活性。输出的 矩阵经 intra-normalization 与 L2 归一化后展平,再 PCA 降到 4096 维。训练数据来自 Google 街景的 Time Machine 功能:同一地点不同年份的全景图提供弱监督,损失函数是弱监督的 triplet ranking loss,要求查询图与「至少一张」地理上相近的图像的距离小于与所有地理上远离的图像的距离。NetVLAD 在 Pitts250k、Tokyo 24/7 这类地点识别数据集上大幅超越了 off-the-shelf 特征,也成为之后六七年视觉地点识别(VPR)的默认基线。HF-Net49 把 NetVLAD 头和 SuperPoint 头蒸馏进同一个骨干,一次前向同时输出全局描述子与局部特征,是层次定位里最常见的组合。
GeM45 代表了另一条更简单的路线:不做聚类,直接对特征图做广义均值池化,再用从 SfM 模型中自动挖掘的正负样本对做对比学习微调(代码与模型见 cnnimageretrieval),维度只有 2048 却在地标检索上追平甚至超过 NetVLAD;AP-GeM44 进一步直接优化 average precision。文献35 及其扩展的 IJCV 版本50 的基准测试表明,在视觉定位任务里这几种全局特征各有胜负:为地标检索训练的 AP-GeM、DELG 并不比专门为地点识别训练的 NetVLAD 差,在位姿近似一类任务上甚至更好,所以「检索任务与定位任务需要的全局特征是否一样」这个问题的答案是「大体一样」。
ASMK 与 HOW
首先一张图像可以被表述 个 维向量 ,通常情况下 的数量较大,这些描述子可以被一个“量化器”进行压缩。此处的量化器通常是一个K-MEANS无监督聚类器 ,其中 表示聚类中心, 表示某个聚类中心,也可以称为单词,共有 个( )。量化的过程可以被描述为:每个局部描述子被分配到距离其最近的聚类中心,然后可以得到已经被分配好的集合 ,它表示 中某个描述子属于 单词, 表示在特征 中出现的单词。定义一个二值函数 , ,其中 ,表示量化前的向量x与其聚类中心距离残差,比如 ,则 。
那么两张图像SMK相似度可以描述为如下式:
其中 表示艾佛森括号,条件满足则为 1,否则为 0; 表示只有属于同一个单词的 才参与相似度计算; 是归一化系数,保证图像与自身的相似度为 1; 是核函数,用于评价两个二值向量的相似度,其具体形式如下, 是阈值(原文取 0), 控制选择性(原文取 3), 是描述子维度:
因此,SMK 的计算等价于先按单词分组、再在组内两两求核:
通过上式可以看到,计算两张图像SMK时候需要选择相同单词的局部特征计算cross-matching score,这个过程计算量略大。而ASMK首先对局部的特征进行聚合(aggregate),然后才进行计算相似度。其中的聚合是指,将属于同一个单词的残差加和,然后再去取符号函数,这个过程可由下式描述:
其中 为 中落入单词 的描述子集合。聚合后每个单词只剩一个二值向量,归一化系数相应变为 ,那么 ASMK 的相似度可以描述为下式:
从上式可以看出ASMK相似度是对属于同一单词的聚合后的特征使用kernel函数计算相似度。此外,计算ASMK相比SMK具有更高的效率以及可应对burstiness phenomenon(即重复纹理对图像召回的干扰)。
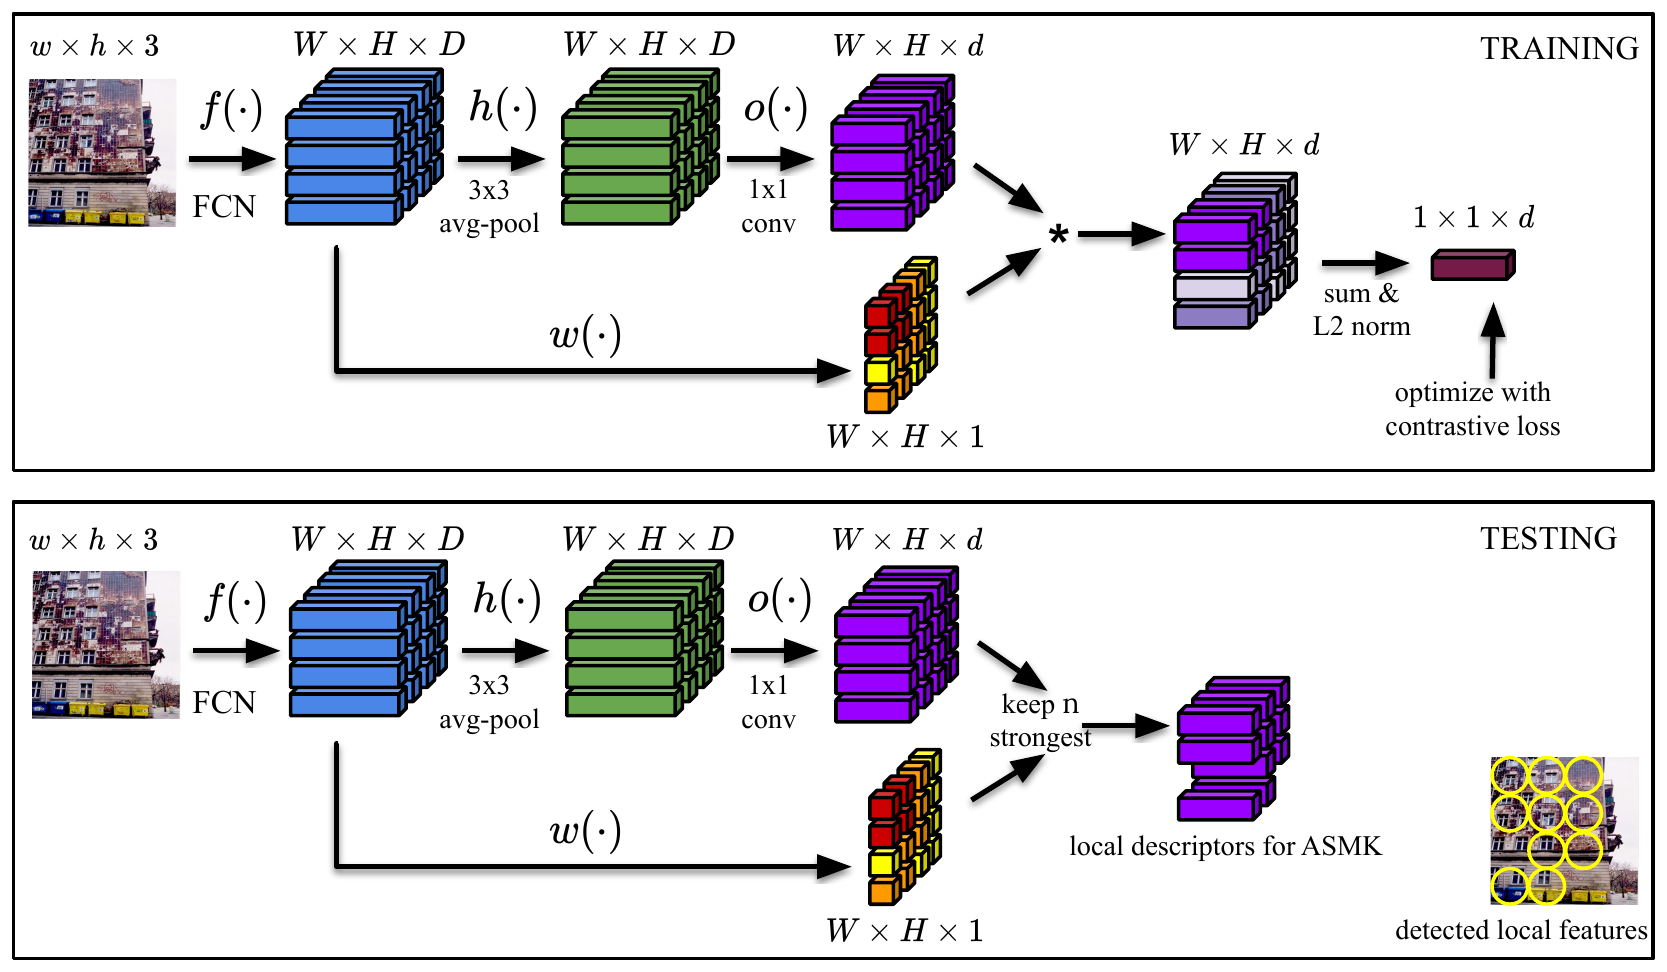
ASMK 最初(ICCV 201351)是为 SIFT 设计的,但它的框架对描述子类型不敏感,于是在深度学习时代又活了过来。HOW52(ECCV 2020)把 CNN 特征图上的每个位置当作一个局部描述子,用一个可学习的注意力分支给每个位置打分:训练时用注意力加权求和得到全局向量、以对比损失优化(这样就不需要局部特征级别的标注),测试时则保留注意力最高的 个局部描述子送入 ASMK。这种「训练像全局特征、测试像局部特征」的设计让 HOW 在 ROxford/RParis 上超过了同期的全局特征方法,而且内存可控。FIRe53(ICLR 2022)沿着同一思路,用迭代注意力把局部特征聚合成少量「超级特征」再做 ASMK,进一步减少了需要存储的描述子数量。
DELF 与 DELG
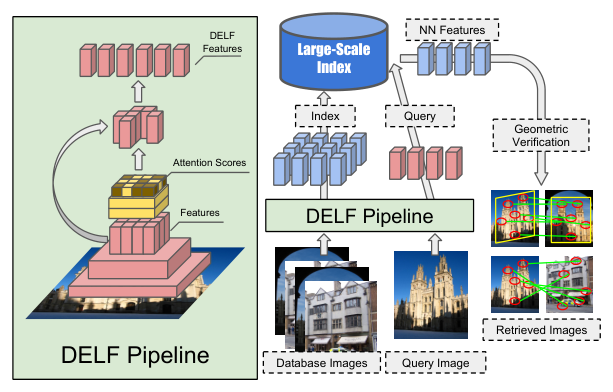
DELF54(ICCV 2017)是 Google 随 Google-Landmarks 数据集一起发布的局部特征。它在 ResNet-50 的特征图上接一个小的注意力网络,用图像级的地标分类标签训练:先训练骨干做分类,再固定骨干只训练注意力分支,让网络学会「图像里哪些位置对识别这个地标最有用」。测试时按注意力分数选出前几百个位置,它们的特征向量经 PCA 降到 40 维就是局部描述子,检索时用 KD 树做近似最近邻,再用 RANSAC 做几何校验重排序。DELF 第一次证明了只用分类标签做弱监督就能学出比 SIFT 更好的地标局部特征,在当时的 Google-Landmarks 与 Oxford/Paris 上大幅领先。
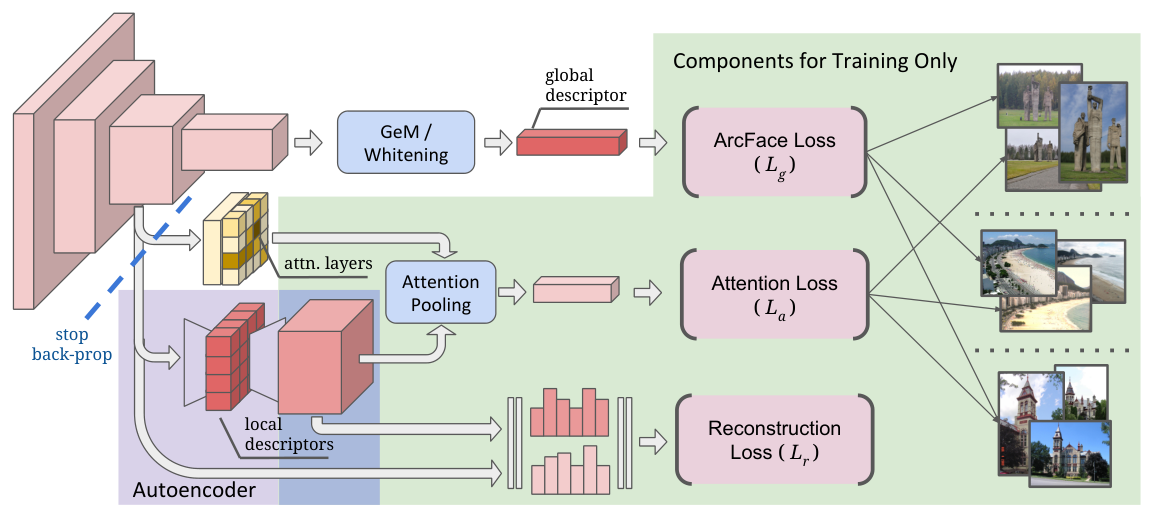
DELG55(ECCV 2020)把全局特征与局部特征统一到一个网络里:深层特征经 GeM 池化加白化得到全局描述子,用 ArcFace 角度间隔损失训练;浅层特征走 DELF 式的注意力分支得到局部特征,用一个自编码器代替 PCA 做降维(重建损失联合训练);局部分支的梯度不回传到骨干(图中的 stop back-prop),避免两个任务互相干扰。检索时先用全局特征取 top-k 候选,再用局部特征做几何校验重排序,一次前向同时拿到两种特征。这个「一个骨干、两个头、全局召回 + 局部重排」的范式就是 HF-Net 在检索领域的对应物,后来 Google Landmark Retrieval 比赛里的方案基本都沿用了这个结构。
基于场景坐标回归的方案(scene coordinate regression)
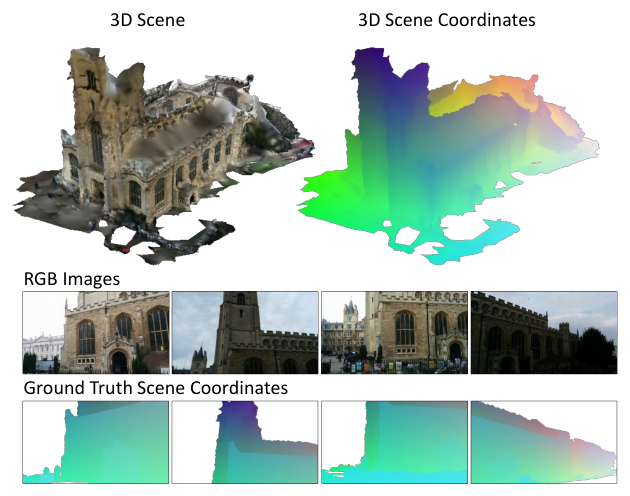
前面两类方法都要显式地「提特征、建索引、做匹配」,场景坐标回归(SCR)换了个思路:直接让模型回答「这个像素对应世界坐标系里的哪个点」。这样每个像素都是一个 2D-3D 对应,后面仍然用 PnP + RANSAC 解位姿,所以它既保留了几何方法的精度,又省掉了描述子匹配。这条线最早是 Shotton 等人用随机森林在 RGB-D 图像上做的30(CVPR 2013);DSAC56 把随机森林换成 CNN,并提出可微的 RANSAC(用概率采样假设代替 argmax,使端到端训练成为可能);之后 DSAC++26 证明只用 RGB 图像和位姿、不需要 3D 模型也能训练(先用启发式深度初始化,再用重投影误差微调),ESAC27 用专家混合把方法扩展到更大场景,HSCNet28 用「先分类到粗区域、再回归」的层次结构缓解大场景下回归的歧义,DSAC*29 则把 RGB、RGB-D 两种输入和有无 3D 模型的几种训练方式统一进一个框架。
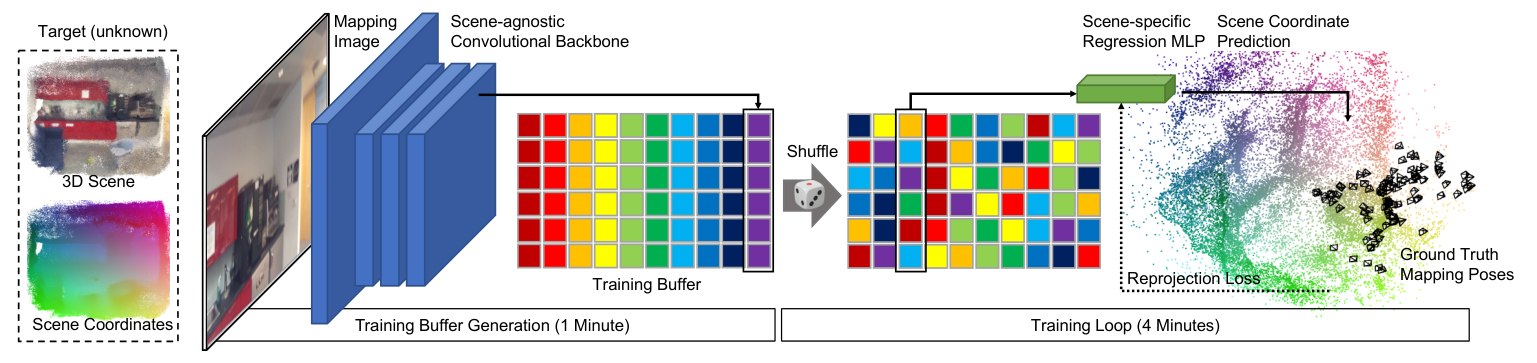
SCR 的优点是小场景精度极高(7-Scenes、Cambridge Landmarks 上通常是最好的),模型本身就是地图(几十 MB),推理时不需要存图像和描述子;缺点有两个,一是每个场景都要训练一个网络,DSAC* 要训十几个小时,二是场景大了以后回归精度下降明显。前一个问题在 2023 年被 ACE57(Accelerated Coordinate Encoding,CVPR 2023)基本解决:骨干网络在大量场景上预训练后冻结,每个新场景只训练一个 4 MB 的 MLP 头,并且把所有训练图像的特征打乱后混在一起训练(而不是按图像喂),梯度更稳定、收敛更快,建图时间从小时级降到 5 分钟。后一个问题的进展见文末后记。SANet58 和 DSM59 则走了另一条路:把检索到的参考图像(带深度或 3D 点)也作为输入,让网络回归「相对于这些参考图的场景坐标」,从而得到场景无关的 SCR。
位姿插值与相对位姿估计
前面方案表格里的最后两行,位姿插值与相对位姿估计,都不需要 3D 地图,只需要带位姿的数据库图像:
- 位姿插值(pose interpolation):检索到 top-k 图像后,直接把它们的位姿按相似度加权平均36,或者干脆取 top-1 的位姿。它的精度完全取决于数据库的采样密度,但 Sattler 等人37 指出,这个看似粗暴的基线在很多数据集上与绝对位姿回归网络精度相当,所以常被拿来当 APR 方法的「及格线」。
- 相对位姿估计(relative pose estimation):检索后在查询图与每张参考图之间估计相对位姿,再结合参考图的绝对位姿算出查询图的绝对位姿。相对位姿可以用局部特征匹配加本质矩阵分解得到(此时只能得到平移方向,尺度需要多张参考图三角化或借助检索位姿的分布恢复),也可以用网络直接回归39。Sattler 等人在 2017 年的工作60 表明,只要参考图足够密并做好三角化,这类「无 3D 模型」的方法在精度上可以逼近基于结构的方法,而地图只需保存图像和位姿,更新也容易得多。
基于位姿回归的方案(Pose regression-based)
最近,随着深度学习在图像分类,语义分割,图像召回以及其他视觉任务的成功应用,那么基于深度学习的视觉定位也成为了可能。方式比较粗暴,输入一张RGB图像,网络端到端回归出拍摄这张图像的相机位姿。基于low level特征可用于一些较为通用的视觉任务(如图像分类)的假设,一些研究者认为这些特征中同样也encode着位姿的某些信息,所以他们建议使用预训练模型通过迁移学习的的方式进行位姿估计任务。
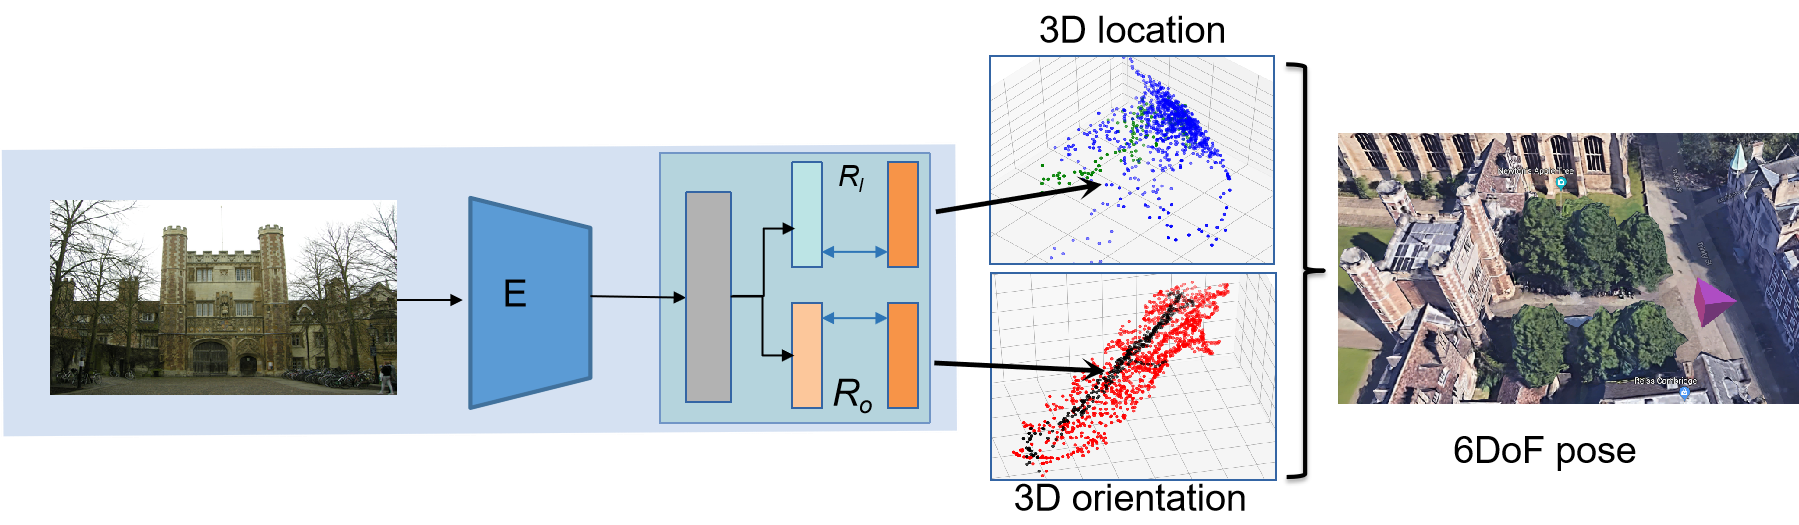
例如,大名鼎鼎的 PoseNet61 修改了分类任务CNN网络结构的任务头,如将VGG/GoogLenet/ResNet的softmax层替换成全连接(FC)层。如上图所示,网络对平移量与旋转量分别进行回归。
PoseNet61 是 Kendall 等人于 2015 年发表在ICCV上的文章,本文首次将CNN引入对位姿的学习,即将位姿估计问题建模成一个回归问题(regression),能够在室内外实现相机定位,在室外约 5 万平方米的范围内达到约 2 m/3° 、室内约 0.5 m/5° 的定位精度。
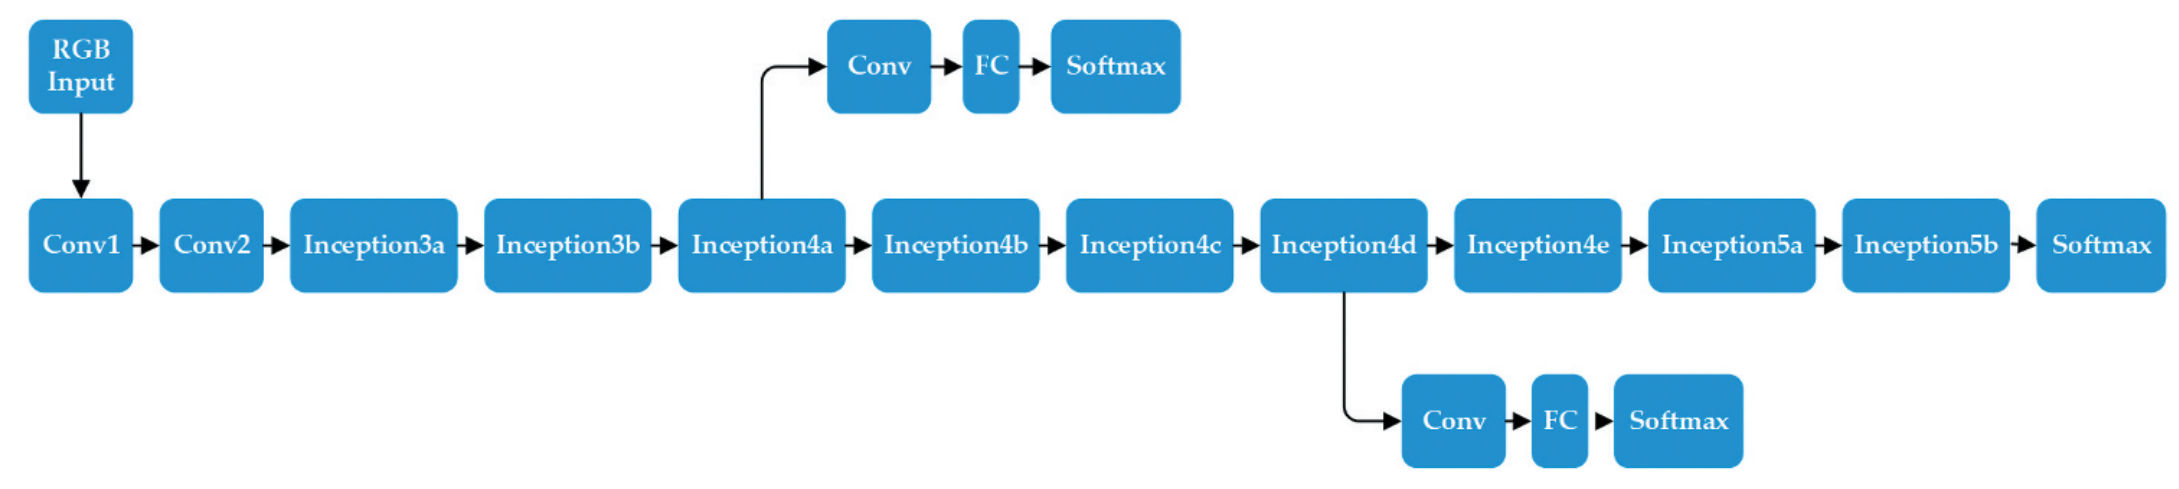
其网络结构较简单,是基于GoogLenet进行的修改,原始的GoogLenet输入是224*224的图像,之后经过5阶段(stage3-5分别有2/5/2个inception模块,共有9个),最后接FC+softmax用于预测类别(除此之外,还有两个中间层临时预测头)。PoseNet相较于GoogLenet有如下改进(代码见此处):
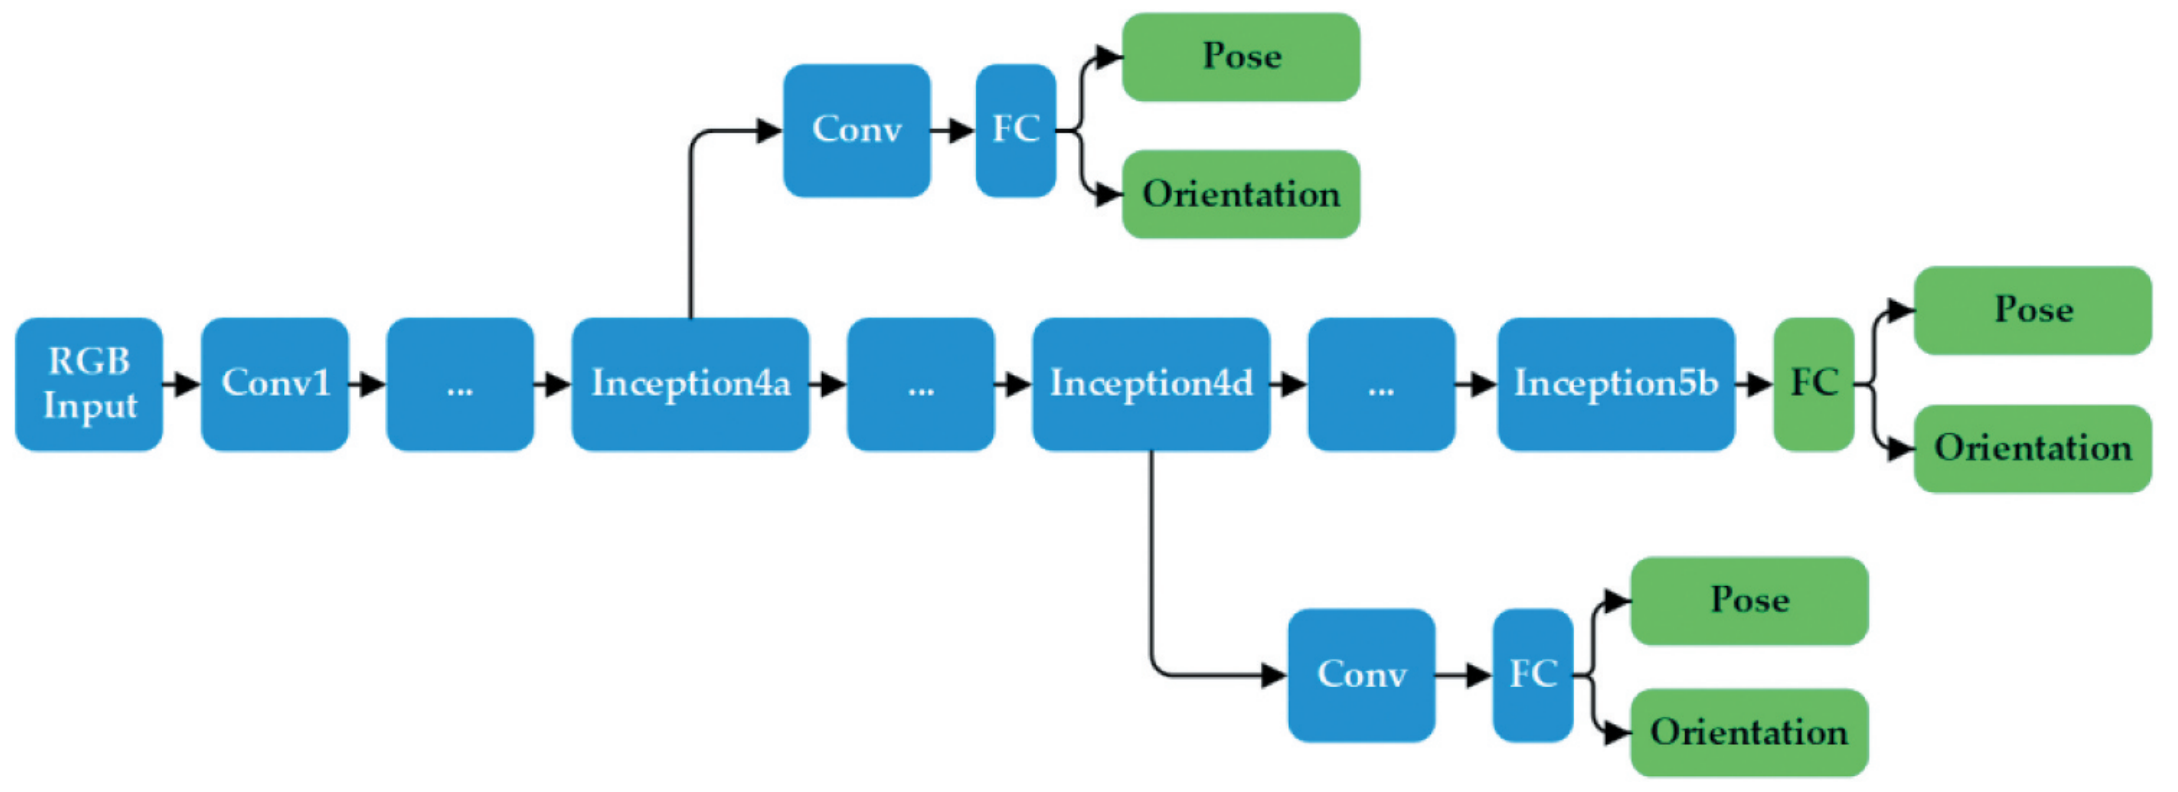
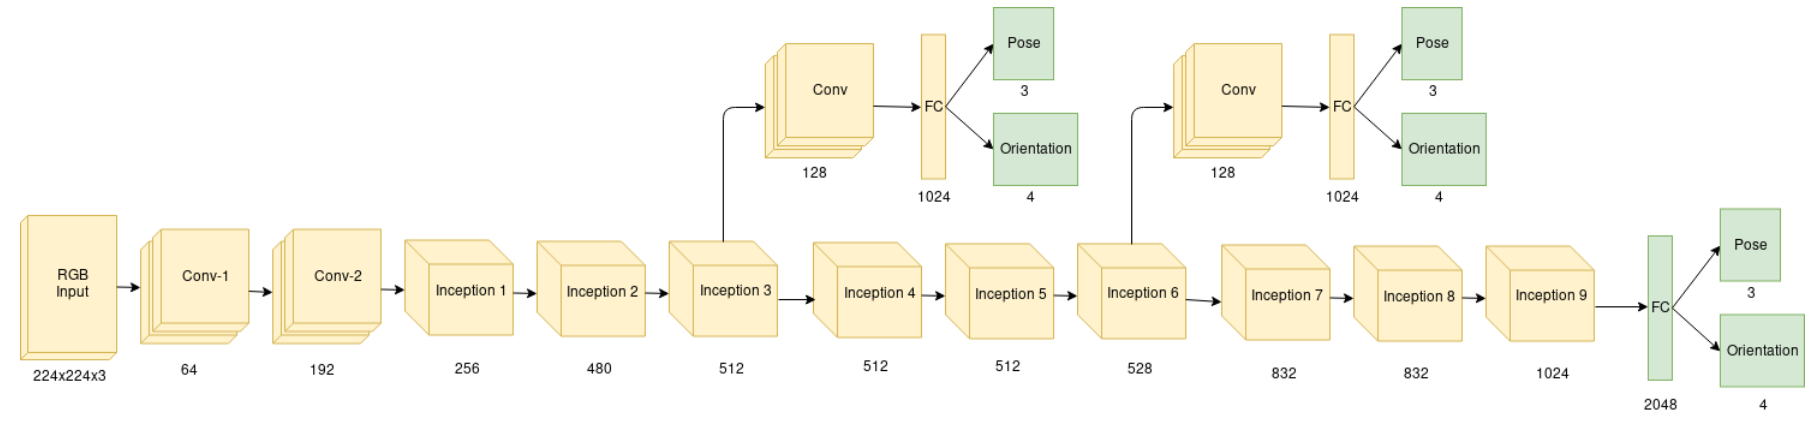
- 使用位姿回归器代替原来的3个softmax分类器,即移除softmax,最后层改为全连接层,输出位置矢量(3维)和四元数方向矢量(4维)的7维pose矢量;
- 在最终的回归器前插入一个长度为2048的全连接,目的是为了增强位姿回归的泛化性(但实际上并不好);
- 测试时需要对估计的四元数进行归一化;
损失函数非常简单:
其中 为尺度系数用于调整平移量与旋转量损失的权衡,如室外条件下比室内的平移量大,所以 室外会比室内大,具体的,室内120-750,室外250-2000。
直接通过端到端的方式的进行绝对位姿回归的拥有诸多益处。首先,位姿回归并不需要复杂的特征工程,它仅依赖于深度网络的强大的编码能力,能够有效应对光照变化以及视角变化。其次,与基于3D特征的定位方法相比,位姿回归需要更小的内存并且拥有常数级的推理时间(查询图像尺寸固定,如PoseNet推理耗时仅为5ms,权重大小仅为50MB)。最后,迁移学习能够使得网络能在中等规模数据集中高效训练。但是,PoseNet精度低是硬伤,相比于基于3D结构信息定位的方式的误差大了一个数量级。
为降低定位误差,一些算法针对PoseNet存在的问题进行改进,如使用新的损失函数43, 新增长短期记忆层(LSTM),新增数据集或者信息其他传感器观测62等。为了进一步提升性能,VLocNet63提出了一种同时学习绝对位姿以及相对位姿的算法, VLocNet++64通过语义分割辅助进一步的提升精度。
然而,端到端的学习位姿通常会使结果陷入局部最优,因为它与场景坐标紧密耦合,网络可以看作是地图(场景)的一种压缩,并不具备泛化能力。
Sattler 等人于 2019 年发表在CVPR上的工作37解释了相机定位任务中位姿回归问题的局限性:位姿回归相较于基于结构信息定位的算法精度低很多,作者设计了一个理论模型用于解释位姿回归中的failure cases。此外,这项工作得到几个结论:
- 目前位姿回归算法与直接对召回的top k相机位姿加权平均精度相当;
- 目前所有的位姿回归算法都无法保证具备泛化性(在其训练集以外);
- 随着训练集数量的增多,位姿回归的精度越高;
作者认为位姿回归可以建模成3个阶段:阶段一,特征提取 ,即使用某个主干网络对图像提取高维特征;阶段二,(非线性)特征嵌入 ,将阶段一得到的高维特征映射到成某长度为 的向量 ,该过程通常位于位姿回归器前一步;阶段三,通过线性映射将嵌入的特征投影到相机位姿空间,这个阶段即使用全连接层进行实现;所以相机位姿的估计量可以描述为下式:
其中 表示最后的线性投影矩阵,维度为 , 表示偏置量; 就是相机位姿 的估计量。
经过推导,相机位姿的估计量可以由下式表示,其中 表示投影矩阵 的第 列向量, 偏置量为 。
通过上式我们可以发现,相机位姿回归可以描述为:通过诸如 PoseNet 或者其变体可以学习到一系列的基础位姿 ,这样训练集可以表示为这些基础位姿的线性叠加。第二个阶段得到的嵌入后的向量决定了位姿加权权重。
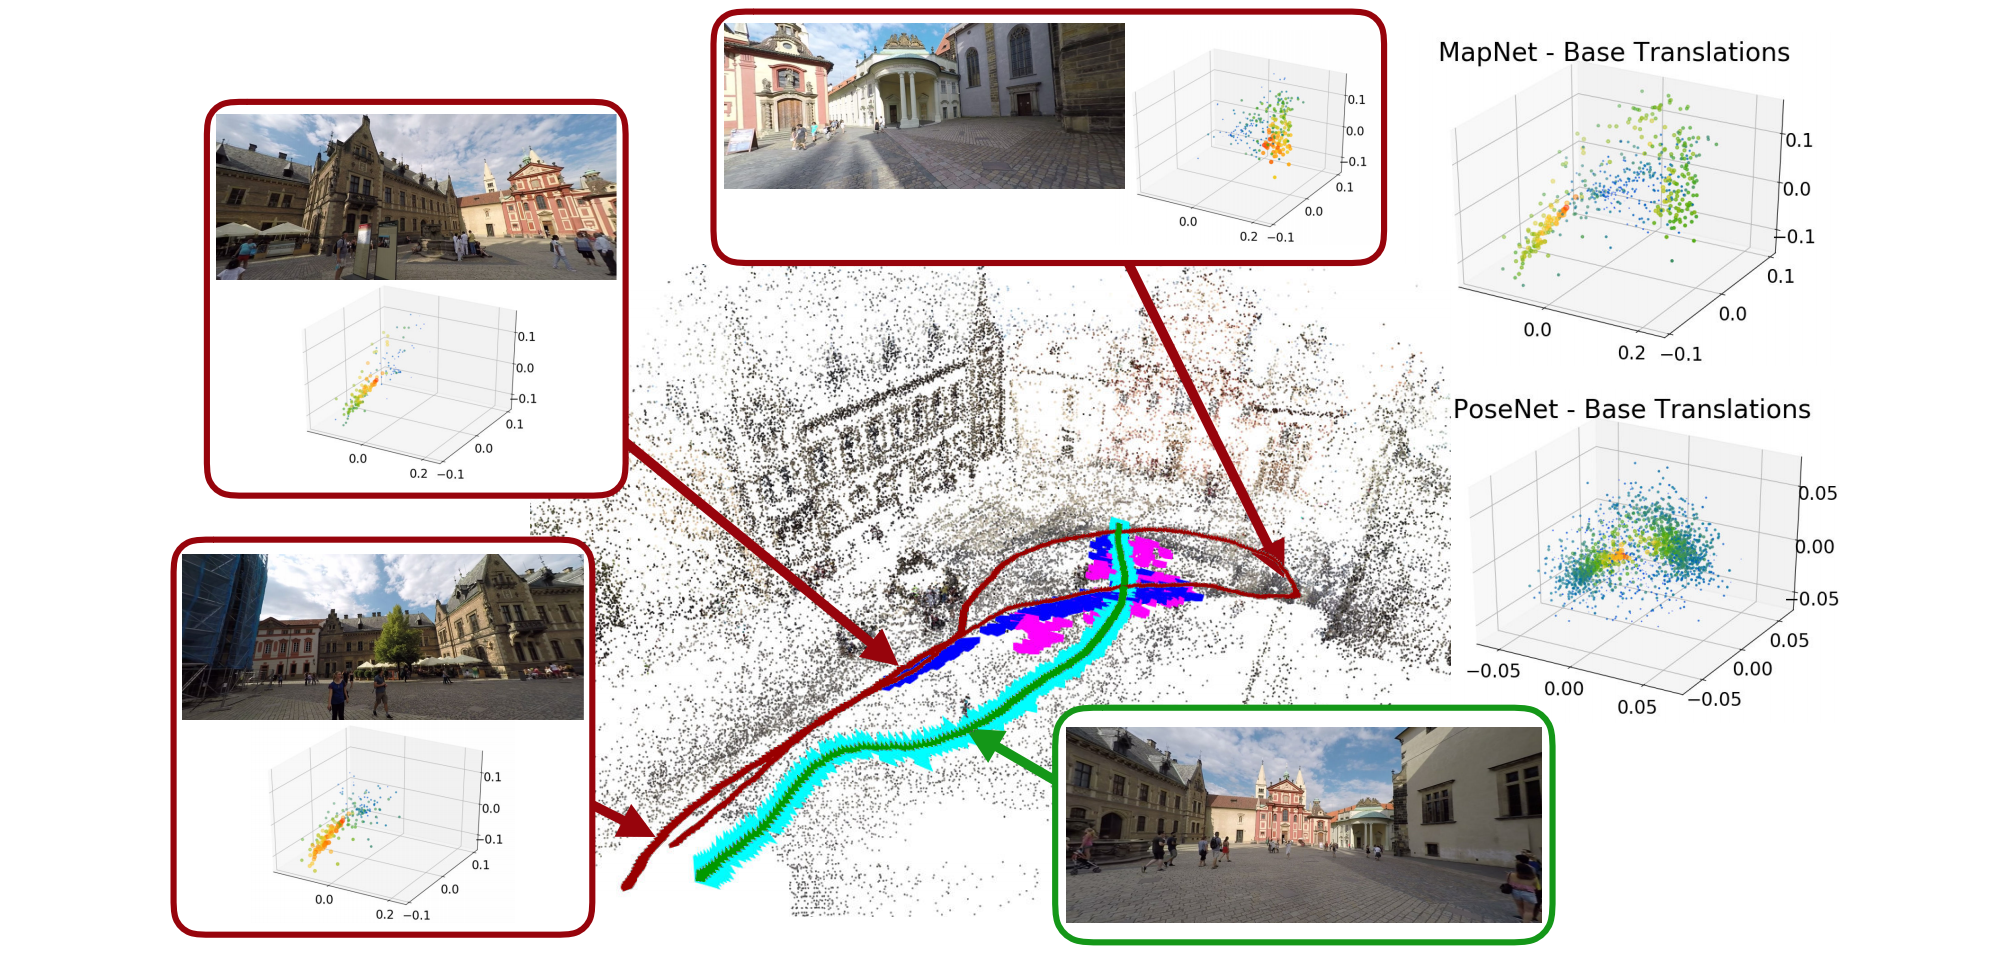
上图展示了分别使用PoseNet以及MapNet得到的基础平移量的分布图(分别有每张训练图以及全部图像的分布),颜色越暖,点size越大表示权重越大。其中深红色表示训练集,绿色表示测试集,PoseNet/MapNet以及ActiveSearch(基线)的预测结果分别用蓝色/紫色以及青色表示;
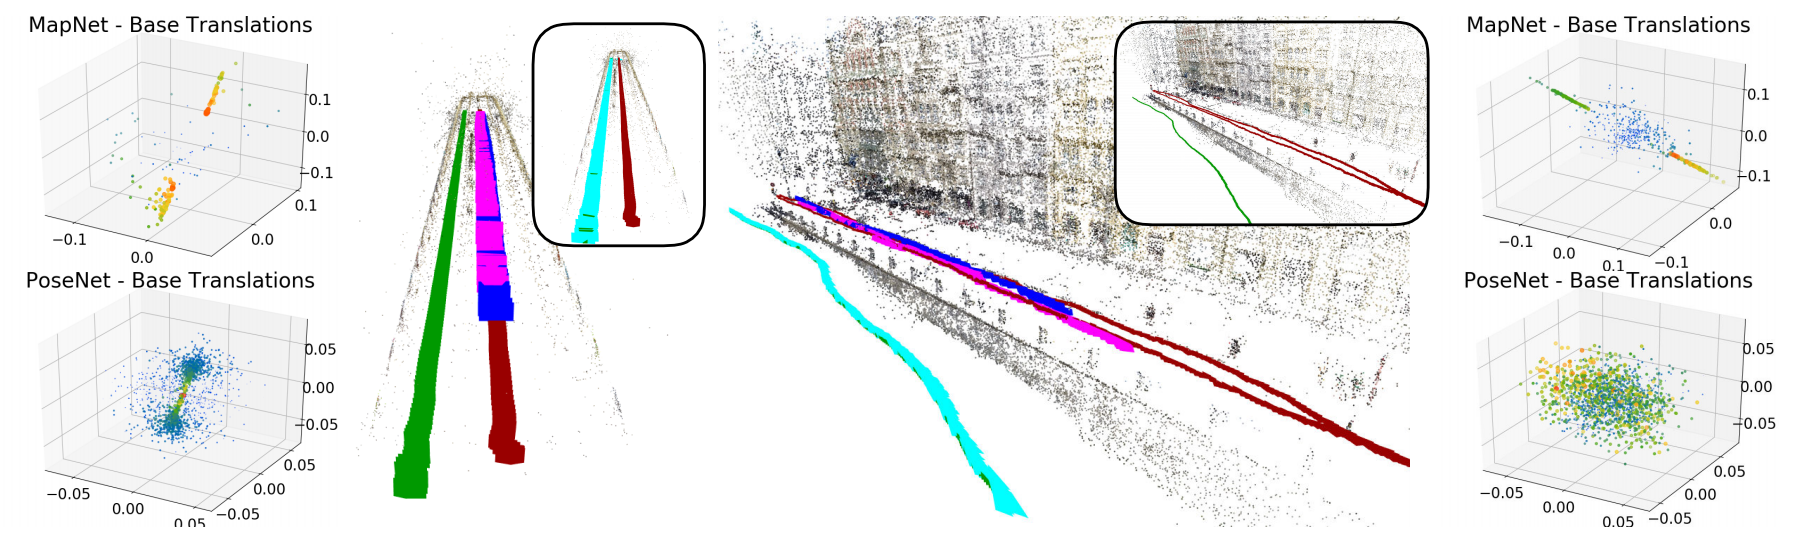
上图展示当训练集为直线段时位姿回归的结果,可见位姿回归的位姿的全部位于训练集附近,而距离测试集较远。下图展示了更为一般的测试场景,结果与上述结论一致,即位姿回归的结果无法泛化到训练集无法覆盖的区域。
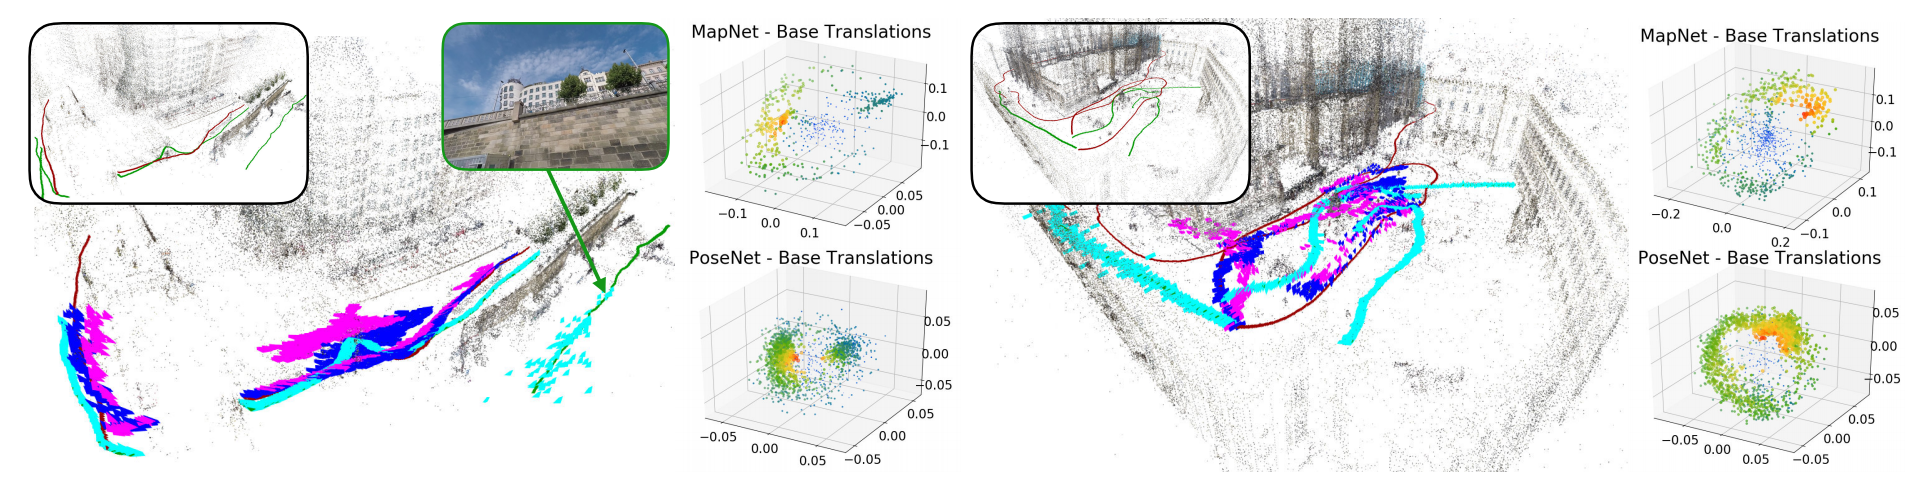
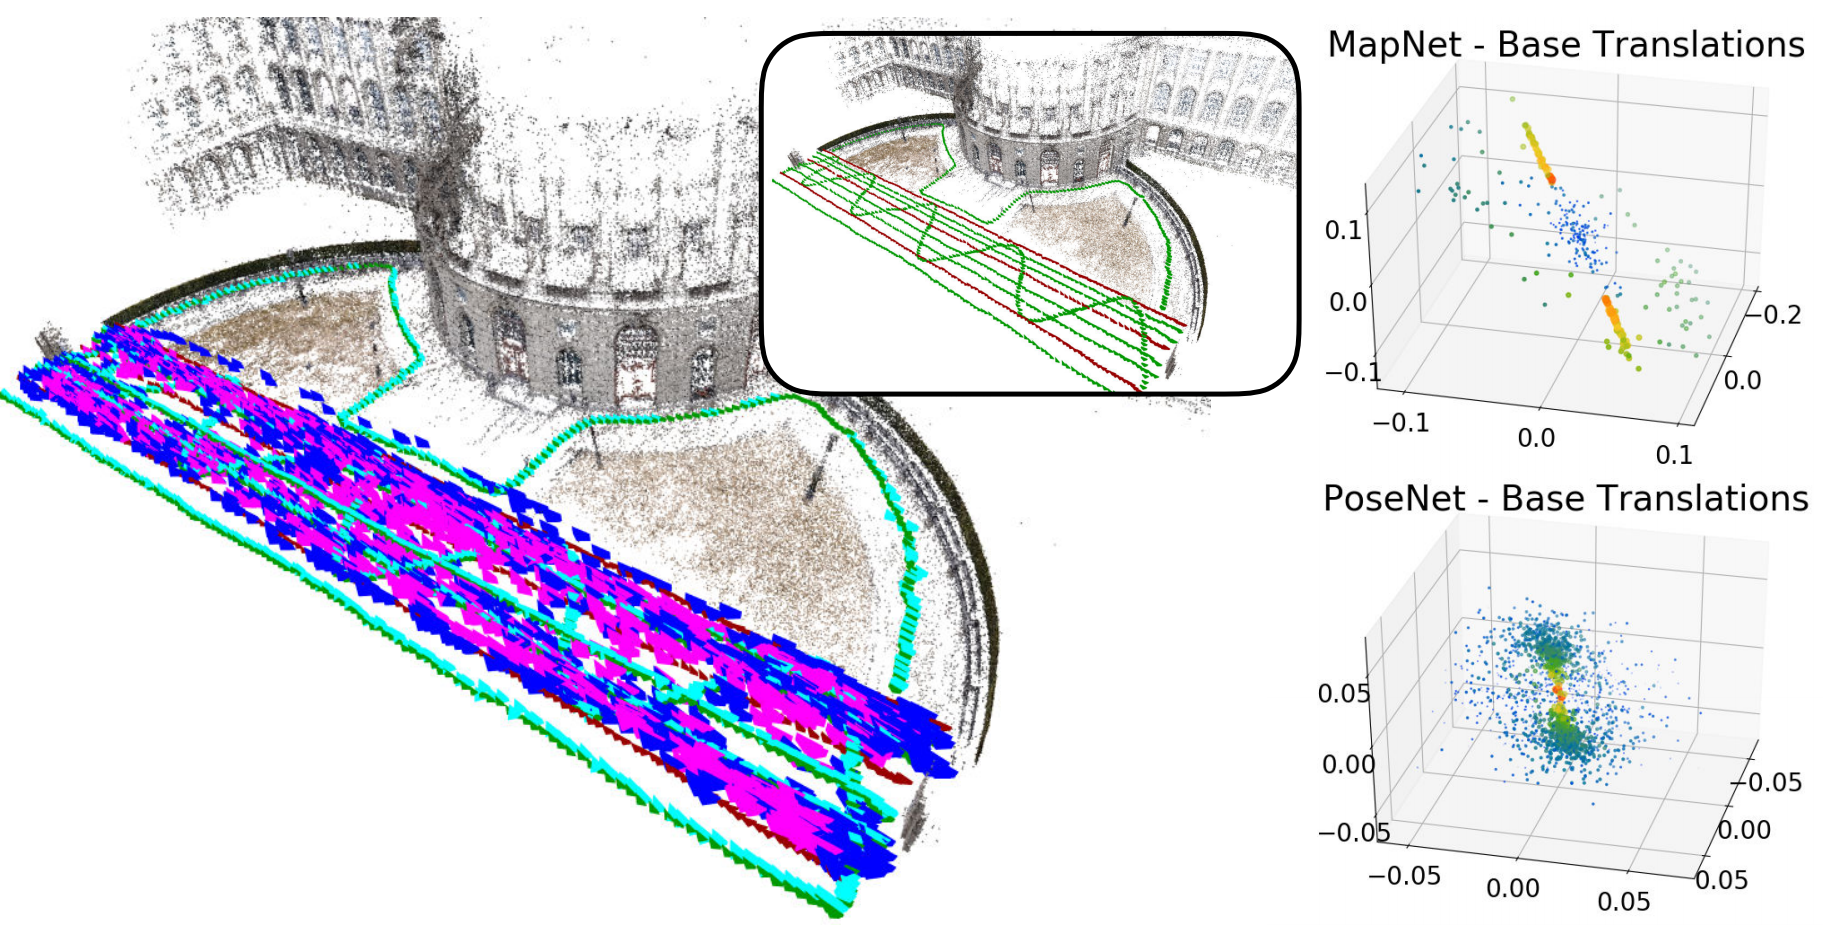
关于上述测试更为直观的介绍参考附录中提到的视频。
目前也有一些混合位姿估计算法将学习的目标转向视觉定位中的某个环节,而非使用端到端的方式,并将其与传统的图像检索和基于结构信息定位的算法结合。例如DSAC56 集合约束,它的目标聚焦在局部的视觉任务中,如2D-3D数据关联。虽然这种方式可以较大幅度提升位姿精度,但学习的模型仍然是场景相关的,并不具备泛化能力。为了提升泛化能力,SANet58提出了一种场景无关的视觉定位算法,该模型利用图像召回 top k 图像稠密MVS获得的三维点云的几何结构进行相机位姿回归。
基于特征度量优化的位姿精修(PixLoc / BA-Net)
上面几类方法得到的位姿,都可以再接一步精修(refinement)。传统做法是 PnP 之后用重投影误差做非线性优化,但它只用到了稀疏关键点,而且误差定义在像素坐标上。另一条思路是把误差定义在特征空间里:给定当前位姿估计,把 3D 点投到查询图上,比较投影处的深度特征与参考图上的特征,用 Gauss-Newton 或 Levenberg-Marquardt 直接优化位姿让特征对齐。这就是 featuremetric(特征度量)优化,可以看成「把直接法 SLAM 中的光度误差换成学习出来的特征误差」。
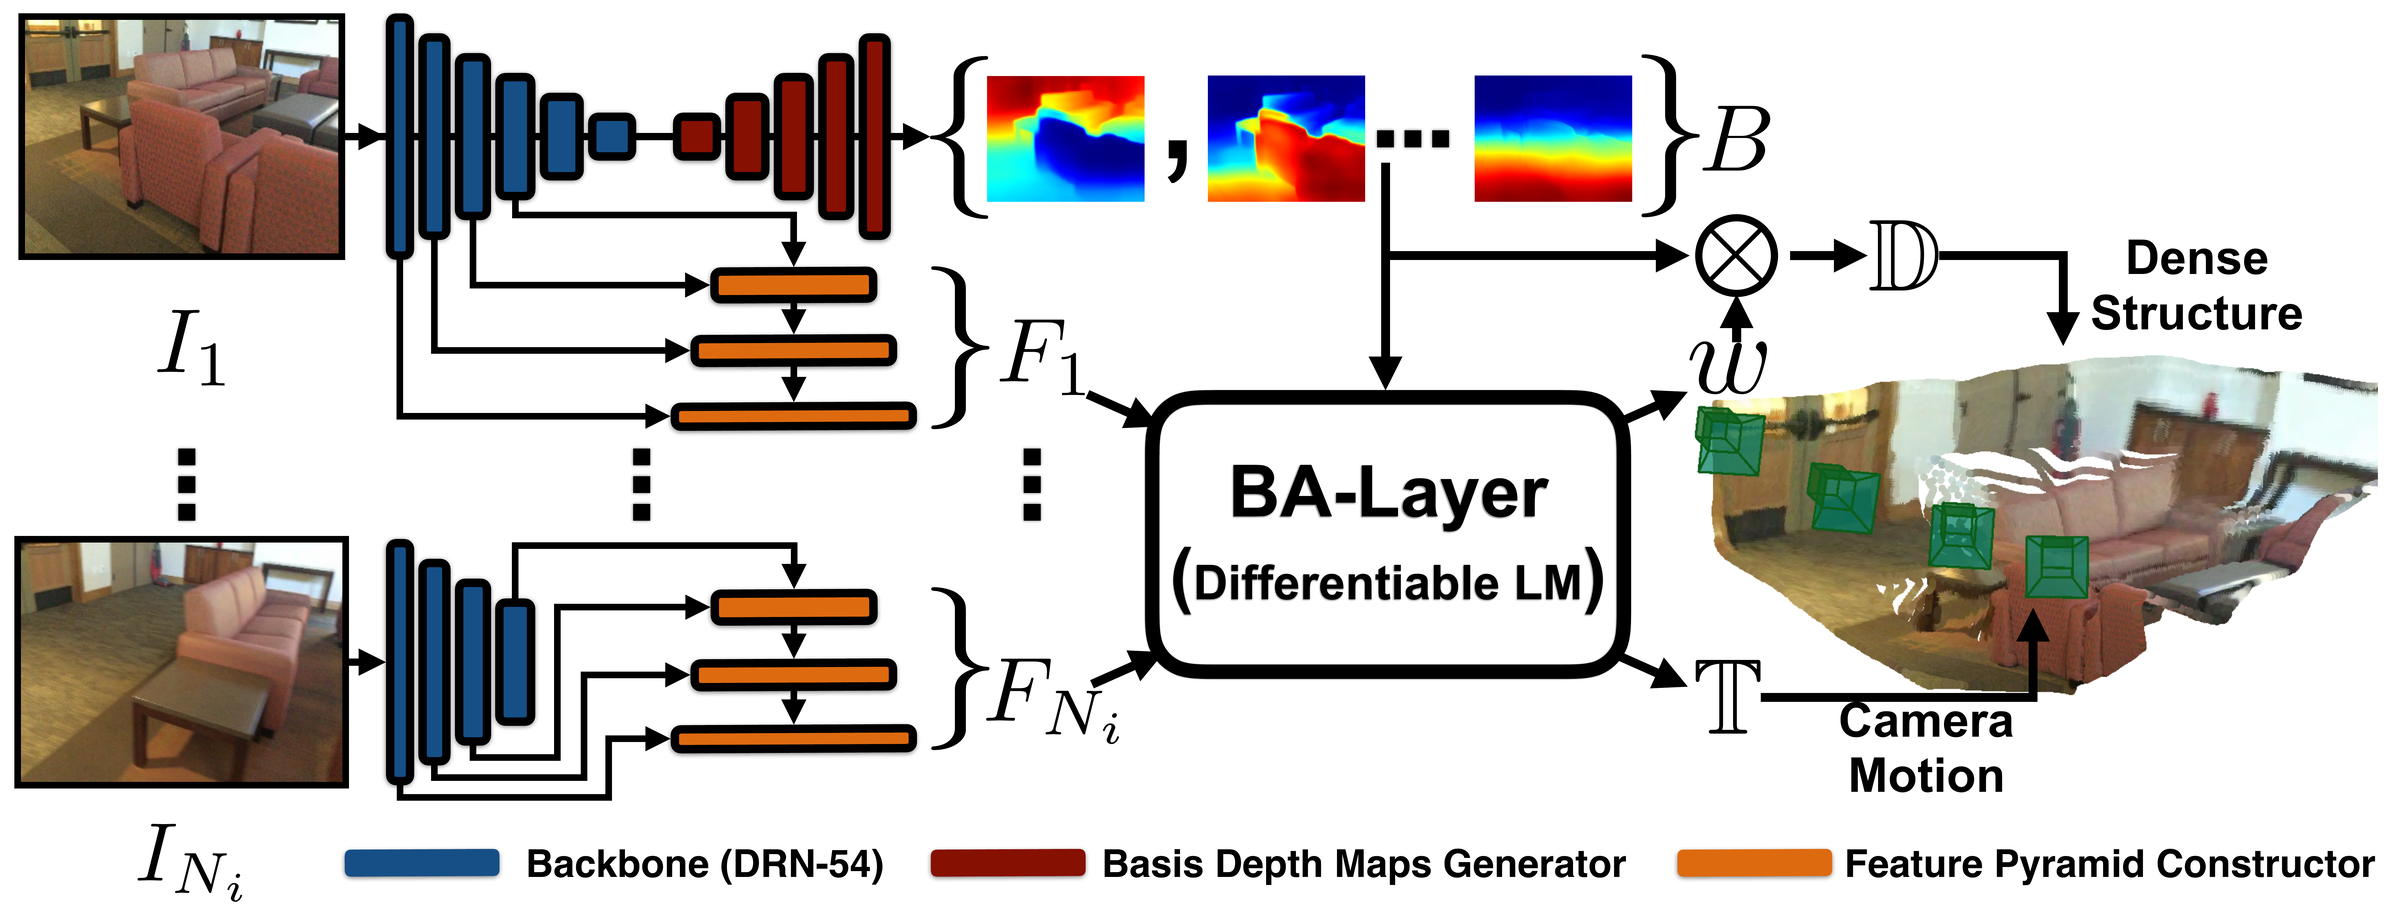
BA-Net65(ICLR 2019)最早把这件事做成端到端:网络同时输出多尺度特征图和若干张「基深度图」,一个可微的 LM 优化层在特征度量误差下联合求解相机位姿与基深度图的组合系数,优化器的阻尼系数也由网络预测。GN-Net66 则专门训练对天气、光照变化鲁棒的特征,使 Gauss-Newton 在多季节重定位中有更大的收敛域。
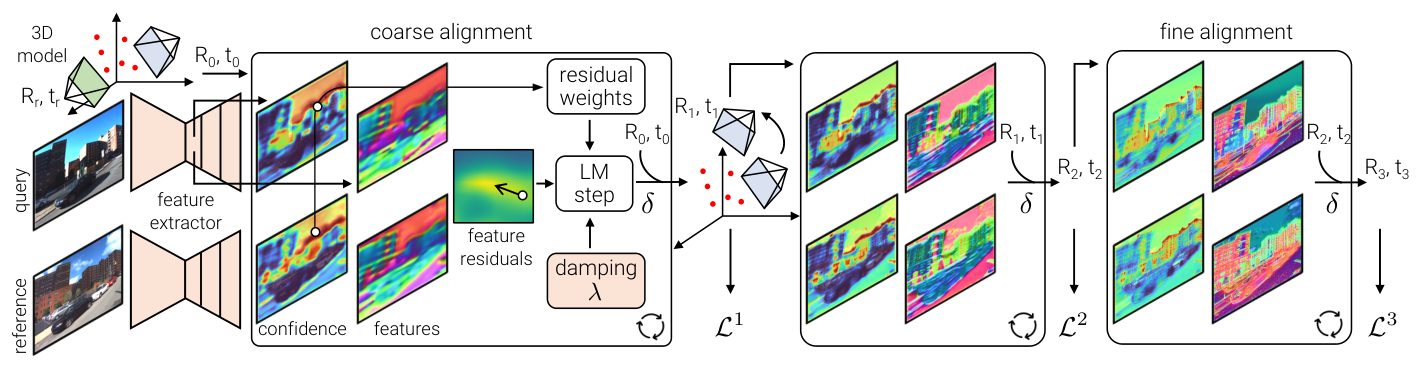
PixLoc67(CVPR 2021,SuperGlue 一作出品)把这个思路做成了场景无关的定位器:给定 3D 点、参考图像和一个粗位姿(来自检索或任何其他方法),CNN 为查询图与参考图提取多尺度的稠密特征与逐像素不确定性,然后由粗到细地用可微的 LM 优化位姿,使 3D 点在两张图上的特征一致。网络只学习「什么样的特征适合做对齐」,优化本身不含可学习参数,因此在一个数据集上训练就能泛化到完全不同的场景,而且可以用来精修 HLoc、APR 甚至 SCR 的输出。实验表明,只要初始位姿误差在几米、十几度以内,PixLoc 就能把它拉到与 HLoc 相当的精度。关于 PixLoc 的详细解读参考笔者的这篇笔记。
基于神经隐式表示的方案(NeRF-based)
秦通博士写的这篇NeRF-based SLAM 综述值得一读,其中列举了自 2020 年以来 NeRF 用于位姿估计的几篇工作,如 iNeRF、iMAP、NICE-SLAM 等。
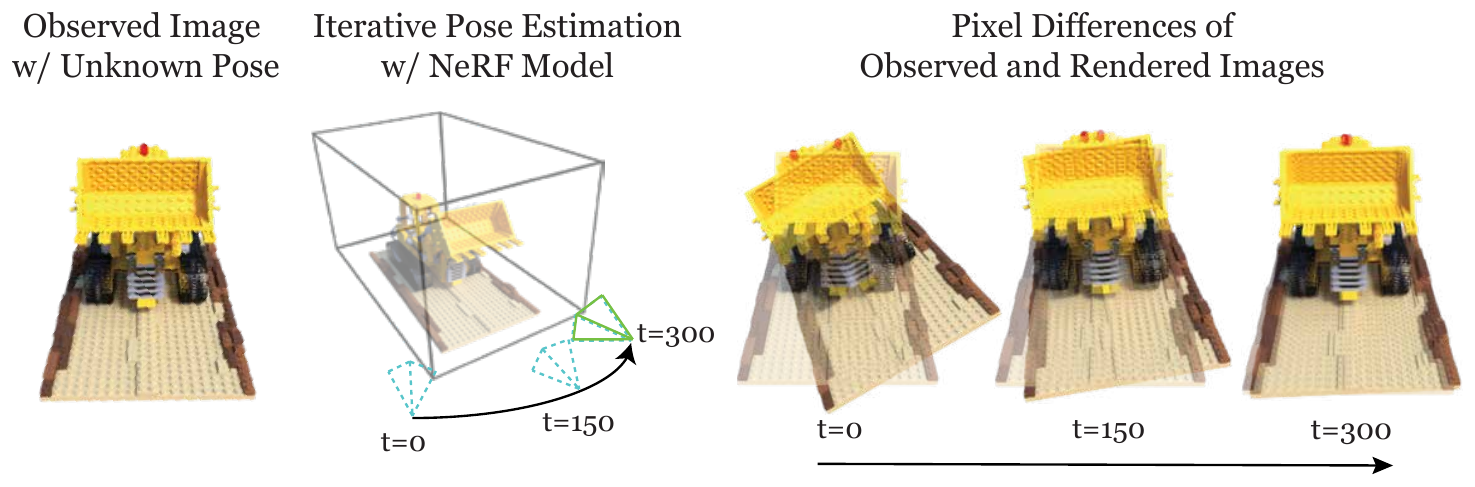
NeRF 用一个 MLP 把场景表示成「给定 3D 位置与视线方向,输出颜色与密度」的函数,通过体渲染可以从任意位姿渲染出图像。既然渲染过程可微,就可以反过来求位姿:iNeRF68(IROS 2021)固定训练好的 NeRF,把相机位姿当作待优化变量,最小化渲染图像与观测图像的光度误差,用梯度下降迭代更新位姿(为了省算力只在兴趣区域采样射线)。它证明了 NeRF 可以当作一种「可微分的地图」来做定位,但有两个硬伤:需要一个不错的初始位姿(收敛域只有十几度、十几厘米),而且每次定位要迭代上百步渲染,远达不到实时。后续的 LENS 等工作换了个用法:用 NeRF 渲染大量新视角的「合成训练图」来扩充 APR 的训练集,缓解 APR 泛化差的问题。
NICE-SLAM
发表在 CVPR 2022 的 NICE-SLAM69 中提到,iMAP70(Sucar et al. ICCV 2021)是首个可以实时工作的基于隐式表达的稠密 SLAM,但其存在三个问题:
- 仅能够在小范围的室内使用,无法扩展到较大的场景;
- 面临全局更新的问题,即每一个关键帧参与优化后导致的网络参数的全数更新(forgetting problems)
- 收敛很慢
而NICE-SLAM在一定程度上解决了上述问题,它使用了一种多层次grid-based场景表示方式对3D点进行描述,使用volume rendering的方式渲染出深度图以及RGB图像用于建图与追踪。
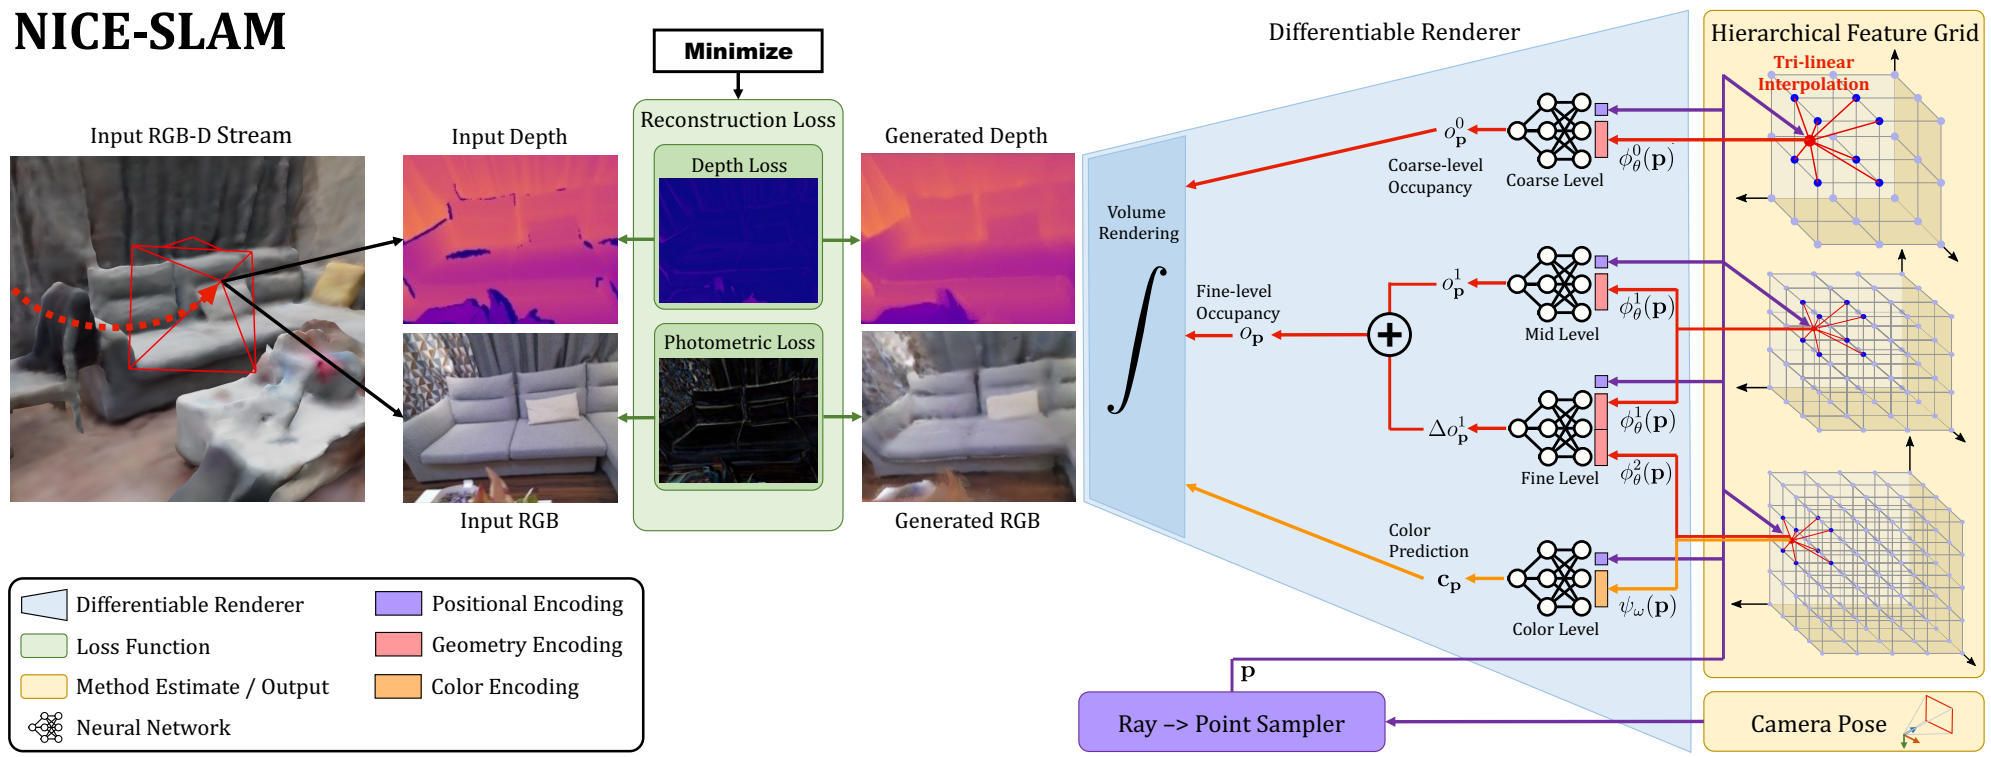
上图展示的NICE-SLAM的工作流程。系统的输入是RGBD信息,输出是相机位姿以及经过学习的场景表示(即hierarchical feature grid)。从右向左看,上图中的流程可以被描述为一个给定相机位姿以及场景表示,输出RGB以及深度图的过程。在测试阶段(从左向右看),网络同时估计场景表示以及相机位姿,这个过程是通过求解构建RGB以及depth时产生的重建loss的逆问题完成;且每次仅完成一项工作,比如,Mapping:反向传播过程仅更新场景表示;Tracking:反向传播仅更新相机位姿。
场景表示分为:geometry(几何信息,即深度图或3D点)以及 appearance(外观表示,即RGB图),所谓的多层次的场景表示是针对geometry表示而言,NICE-SLAM将其设计为3个不同尺度(coarse,mid以及fine-level)的feature-grids 及其对应的MLP解码器(这里提到的解码是将grid中的3D点编码后的信息解码成Depth,这与NeRF中MLP要做的事情完全一致,只不过换了一种称呼)。此外,对于场景的外观表示,有一个单独的feature-grid以及对应的MLP解码器(接在fine-level)。
对于几何表示,首先介绍在mid&fine-level对其进行表征的形式,对于每个3D点 通过空间三线性插值得到其编码feature,随后将其喂给MLP,输出对应的 occupancy ;fine-level作为对细节的补充,其解码器学习的是相对于 mid-level 输出的 offset:,完整的occupancy 可以表示为上述二者相加:
有了从mid&fine-level得到的occ后,我们也可以从coarse-grid得到一些关于场景的high-level信息,coarse-grid可以预测出occ大致的信息,作者提到粗尺度的信息可以捕获中/精尺度没有观测的信息,应对追踪过程中lost问题。
Mapping以及tracking过程中需要更新场景表示的参数以及MLP参数,损失函数分为geometric loss(粗深度以及精深度重建L1损失)以及photometric loss(RGB图像重建L1损失)
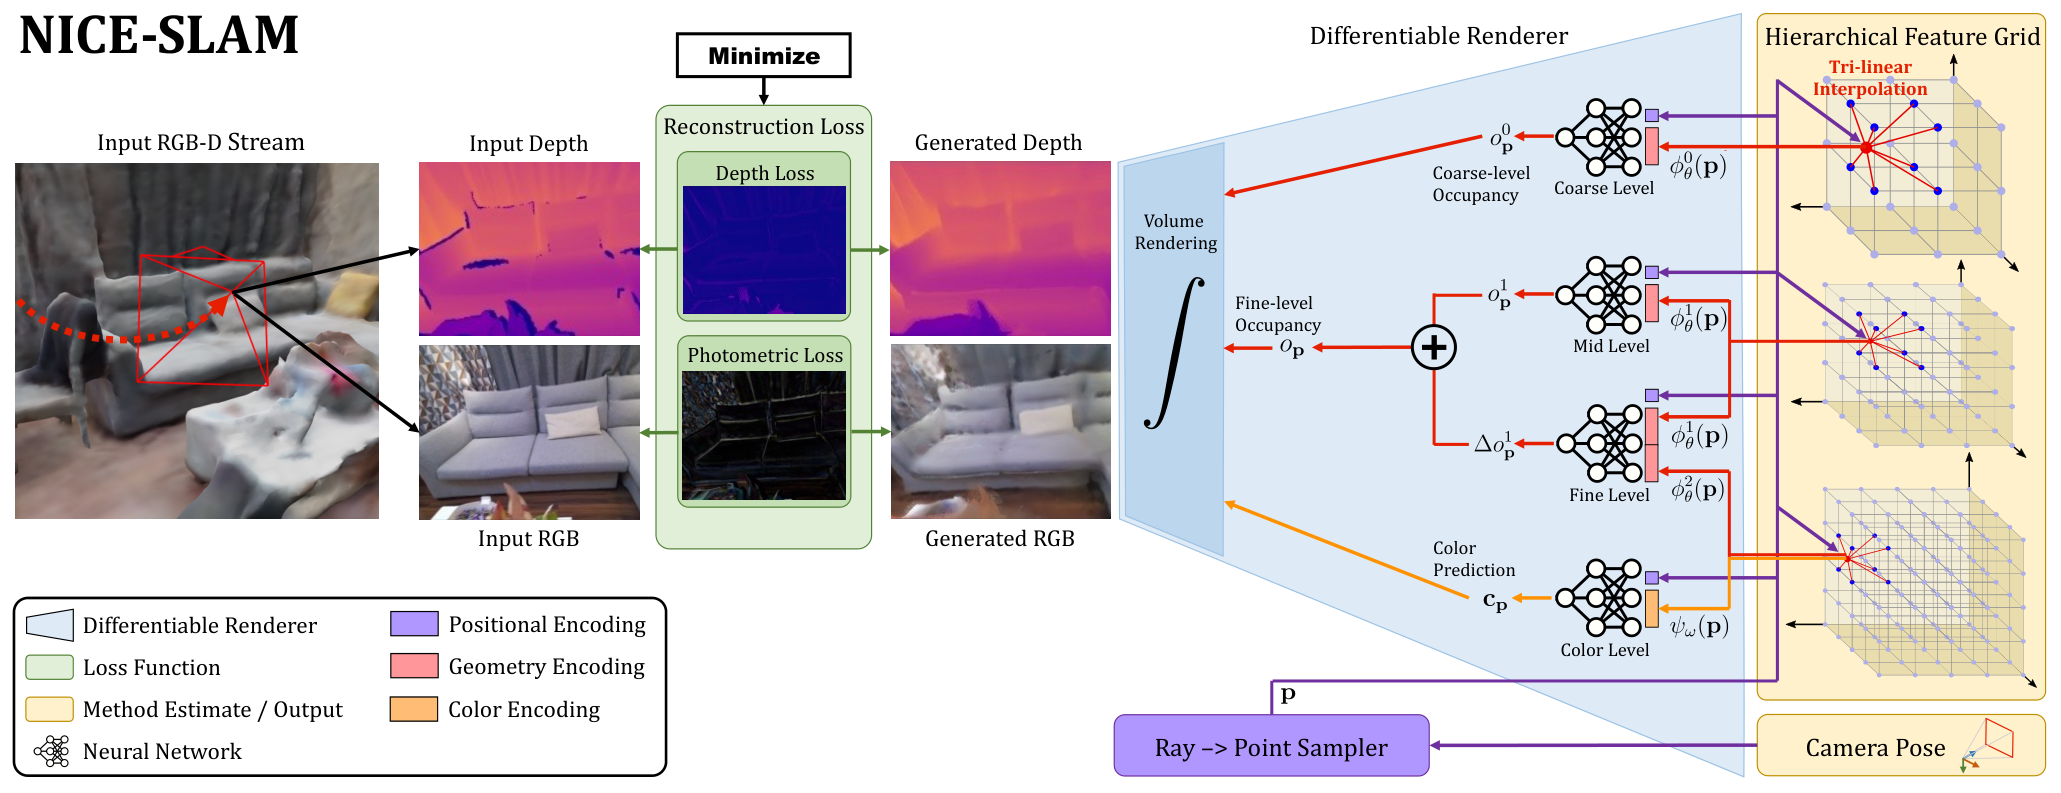
再补充几个 NICE-SLAM 的实现细节:
- 几何解码器是预训练并冻结的。三个几何解码器来自 ConvONet 的预训练权重(在合成数据上训练),系统运行时只优化网格里的特征,不动 MLP。这正是它比 iMAP 不易「遗忘」的原因:iMAP 的整个场景是一个 MLP,每次更新都会牵动全局权重;NICE-SLAM 的网格特征是局部的,更新一块区域只改动这块区域对应的格点。只有颜色解码器是在线联合优化的,因为外观难以预训练。
- 逐级训练。Mapping 时先只优化 mid-level 特征,再联合优化 mid 与 fine,最后把颜色一起优化(文中的 multi-stage 策略),避免细尺度过早拟合噪声。coarse-level 单独优化,它的分辨率很低(约 2 m 一格),用来「猜」没观测到的区域,例如相机快速转向时的新视野,以提高跟踪鲁棒性。
- Tracking 的损失带几何不确定性加权。相机位姿优化时的深度损失按渲染深度的方差加权(方差大的像素权重低),而且只对一部分采样像素做优化,这使它对深度相机噪声和动态物体有一定鲁棒性。
- 关键帧选择。Mapping 时只优化与当前帧视锥有重叠的关键帧,而不是像 iMAP 那样全局随机选,局部更新的计算量因此有界,这也是它能跑大场景的原因之一。
- 局限。它依赖 RGB-D 输入,没有回环检测与全局 BA,长序列仍会累积漂移;网格表示的内存随场景体积立方增长。之后的 Vox-Fusion、ESLAM(三平面)、Co-SLAM(哈希网格加坐标编码)、Point-SLAM(神经点云)分别从表示上改进,而 2024 年前后基于 3D Gaussian Splatting 的 SLAM(SplaTAM71、MonoGS72 等)把渲染速度提到实时,隐式 SLAM 这条线基本转向了显式的高斯表示,详见后记。
结论展望
- 最近的基准测试和定位挑战结果表明,基于几何的方法仍然优于端到端方法。然而,值得注意的是,为了达到最佳性能,纯几何学流程中的几个模块被深度学习的方案所取代,如局部和全局特征提取。事实上,基于深度网络的表征比手工制作的特征更有优势,能够较好地应对各种变化;
- 当我们的目的只是为了获得一个粗略的位置时,纯粹的基于图像召回(检索)的方式是一个低成本的解决方案,例如
geo-localization; - 当三维模型或点云都不可用时,位姿回归的方式仍然有效;
- 为了应对的视觉定位中的挑战,使用场景的语义信息(物体、建筑或景观)是一种较好的手段。例如,人们可以使用语义类别(如树、建筑、街道)来改善局部特征的匹配73 74,或者使用物体进行定位75 76 77。Weinzaepfel等人78提出建立一个感兴趣区域物体的数据库,并直接回归查询图像中检测到的物体与它们在三维空间表征的局部特征匹配。由于汽车、人甚至树木等动态区域给视觉定位带来了挑战,人们也可以在视觉定位中忽略这些区域9 3;
- 此外,未来方向还包括:改进局部和全局特征,利用多相机系统和图像序列,以及为绝对和相对相机位姿回归增加更好的泛化能力。
后记:2022 年之后的进展(2026 年 10 月补记)
上面的正文停在 2022 年秋天。之后三年视觉定位领域变化不小,这里按「检索、匹配、场景坐标回归、相对位姿、3D 基础模型、建图与地图表示」几条线补一段,方便读者衔接到当下。
检索:从 NetVLAD 到 DINOv2 时代
NetVLAD 之后的 VPR 工作主要在损失函数与训练数据上下功夫(CosPlace 用分类式训练、MixVPR 用全连接层混合聚合、EigenPlaces 用多视角分组),真正的分水岭是自监督视觉基础模型。AnyLoc79(2023)发现,冻结的 DINOv2 特征配上无监督的 VLAD 聚合,不经任何 VPR 训练就能在室内、室外、水下、空中等完全不同的场景上通吃;SALAD80(CVPR 2024)在 DINOv2 骨干上用最优传输做特征到聚类的软分配再微调,成为新的强基线;之后 MegaLoc 等工作把多个数据集混合训练,追求「一个模型适用所有检索场景」。对定位流水线而言,检索这一步已经很少再成为瓶颈。
匹配:LightGlue、稠密匹配与「不要检测器」
SuperGlue 之后,LightGlue81(ICCV 2023)用自适应的深度与宽度剪枝把匹配器提速数倍、精度持平,成为 HLoc 中的默认匹配器。另一条线是放弃关键点检测:LoFTR31(CVPR 2021)在低分辨率特征图上用 Transformer 做稠密互注意力,再在精细尺度上精修,解决了弱纹理区域「检测不出点」的问题;RoMa82(CVPR 2024)用 DINOv2 做粗匹配特征,稠密匹配的鲁棒性又上了一个台阶。Detector-Free SfM32(CVPR 2024)则把稠密匹配器带进建图流程,专门解决「没有可复检关键点」时如何建 track 与做 BA 的问题。这些工作的综合效果是:传统意义上最难的昼夜、跨季节匹配,在 Aachen Day-Night、InLoc 这些基准上已经接近饱和。
场景坐标回归的复兴
ACE 把 SCR 的建图时间压到 5 分钟后,这条线重新热了起来。ACE083(ECCV 2024)把 ACE 变成一个 SfM:从一两张图像出发,交替「用当前 SCR 网络注册新图像」与「用新注册的图像继续训练网络」,不需要任何初始位姿就能重建出整个图像集合的位姿,精度接近 COLMAP、耗时同量级;GLACE84(CVPR 2024)给 ACE 加上全局编码(检索特征)作为条件输入,缓解大场景下的回归歧义,使 SCR 第一次在 Aachen 这类城市级数据集上拿到有竞争力的结果。SCR 的吸引力在于地图只有几 MB、推理一次前向、不需要存储任何图像或描述子(隐私友好);缺点是每个场景仍要训练、对训练未覆盖的视角泛化有限。
相对位姿与 Map-free 定位
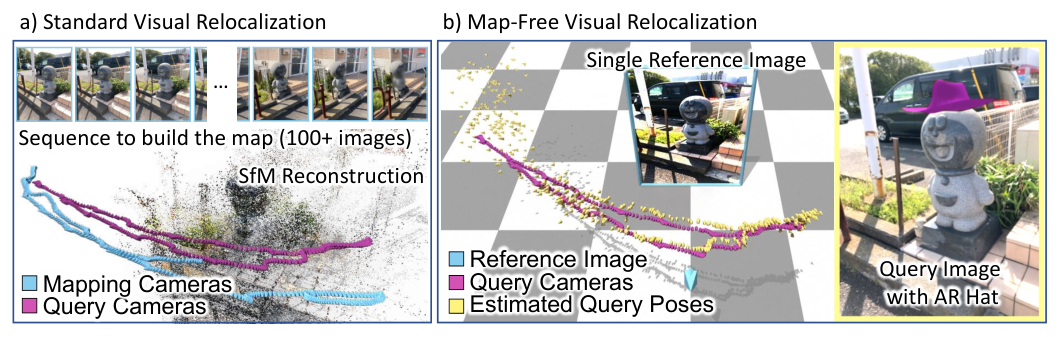
正文里相对位姿估计被当成「精度有限的轻量方案」,但 Map-free Relocalization85(ECCV 2022)给它找到了一个新场景:AR 应用里用户只拍过一张参考图,没有地图,要求直接估计查询图相对这张图的带尺度位姿。这个基准催生了一批「从两张图直接回归相对位姿」的工作,其中 Reloc3r86(CVPR 2025)在约 800 万图像对上训练一个对称的相对位姿回归网络,再用多张检索到的参考图做运动平均,在多个数据集上做到了与基于结构的方法相当的精度,推理只需几十毫秒。更大的变化来自下一节的 3D 基础模型:MASt3R 这类网络本身就输出两张图之间带尺度的几何关系,在 Map-free 基准上大幅刷新了榜单。
3D 基础模型:DUSt3R、MASt3R 与 VGGT
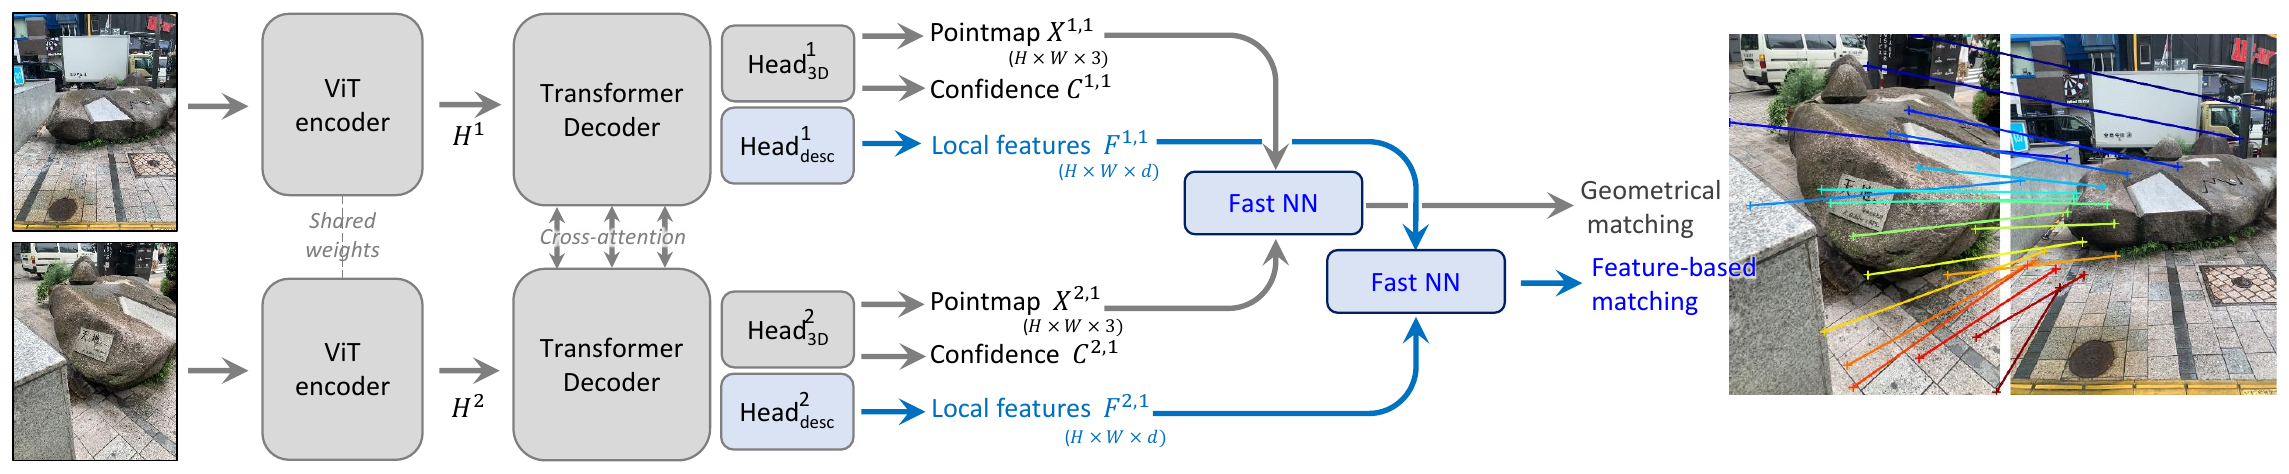
2024 年最重要的变化是 DUSt3R87(CVPR 2024)提出的「点图」(pointmap)范式:给两张图,网络直接输出每个像素在第一张图相机坐标系下的 3D 坐标,不需要内参、不需要位姿,匹配、深度、相对位姿都从点图里顺手得到。MASt3R88(ECCV 2024)在它上面加了一个稠密局部特征头与快速互近邻匹配,专门强化匹配精度,在 Map-free 上把 VCRE 的 AUC 绝对值提升了约 30 个百分点;MASt3R-SfM89(3DV 2025)与 MASt3R-SLAM(CVPR 2025)则分别把它扩展成无约束图像集合的 SfM 和实时单目 SLAM。
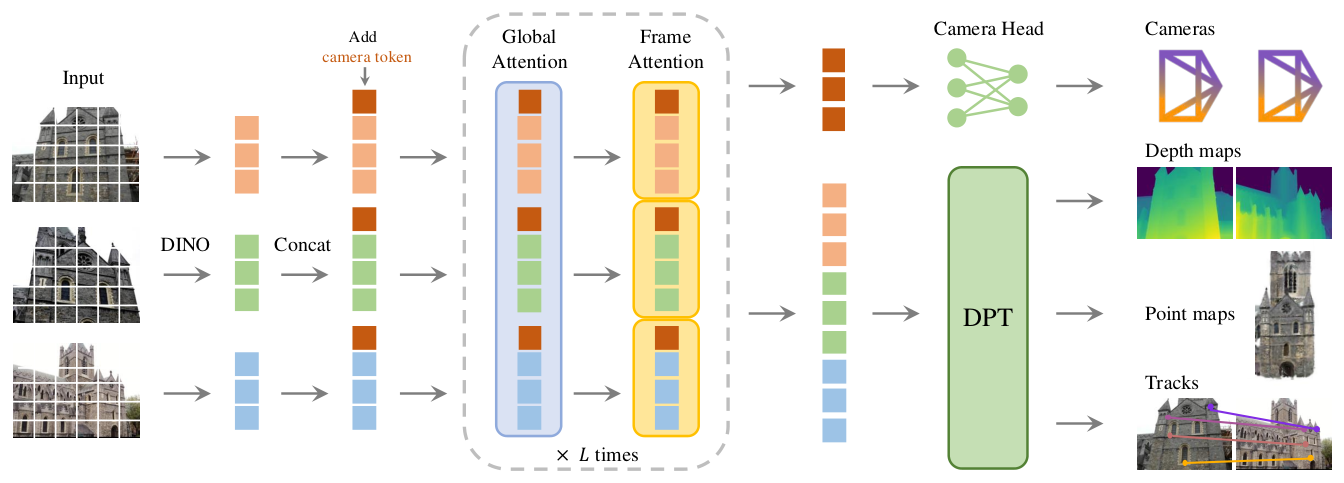
VGGT90(CVPR 2025 最佳论文)更进一步,一个前馈 Transformer 一次吃进几十到上百张图像,直接输出所有相机的内外参、深度图、点图,整个过程不需要任何迭代优化,速度在秒级,而且在相机位姿估计、多视角深度等任务上超过了需要后优化的方法。对视觉定位而言,这些模型正在模糊「建图」与「定位」的边界:定位不再一定是「查询图对已有地图做匹配」,也可以是「把查询图和几张检索到的参考图一起喂给网络,直接读出相对位姿」。截至 2026 年,基于结构的 HLoc 式流水线在大场景、高精度的基准上仍然是最可靠的选择,但在小规模、低延迟、无地图的场景中,前馈 3D 基础模型已经是更实用的方案。
建图与地图表示
- 全局式 SfM 回归主流:GLOMAP33(ECCV 2024)用「全局定位」替代平移平均,在 COLMAP 的特征匹配基础上把重建速度提高一到两个数量级而精度持平,这是十年来全局式 SfM 第一次在鲁棒性上追平增量式。
- 显式辐射场地图:3D Gaussian Splatting(SIGGRAPH 2023)把 NeRF 的隐式表示换成显式的高斯椭球,渲染实时。随之而来的 SplaTAM71、MonoGS72(均为 CVPR 2024)用它做 SLAM,而把 3DGS 当作定位地图的工作也在跟进:既可以像 iNeRF 那样「渲染、比较、优化」,也可以在高斯上绑定特征描述子做匹配。它的价值在于一张地图同时服务定位、渲染与 AR 遮挡,而不再需要点云、mesh、纹理各存一份。
- 地图压缩与隐私:SCR 与神经地图的副产品是地图不再暴露原始图像和可逆的描述子,这对云端定位服务是重要卖点;与之相关的「隐私保护定位」(把点升维成线、随机化特征等)在 2019 至 2023 年也形成了一个小方向。
一句话总结
2022 年时本文的结论是「几何方法仍优于端到端方法,但几何流水线里的模块正在逐个被学习取代」。到 2026 年,这个过程几乎走完了:检索、特征、匹配,甚至三角化与 BA 都有了可用的学习版本,而几何约束没有被抛弃,只是从「人写的算法」变成了「网络输出的结构(点图、场景坐标)加上一步轻量的几何求解」。读者如果今天要搭一套定位系统,可靠的起点仍然是 HLoc 式的「检索 + 匹配 + PnP」流水线,但把检索换成 DINOv2 系特征、匹配换成 LightGlue 或 MASt3R、建图换成 GLOMAP 或 ACE0,会比 2022 年的版本轻松得多。
附录
点击展开
两张综述大图,直接点开看高清版:visual-localization-survey、image-retrieval-survey。
Early works
Here are a list of works by Torsten Sattler etc.
- Fast Image-Based Localization using Direct 2D-to-3D Matching, [Homepage], [PDF], ICCV 2011
- Image Retrieval for Image-Based Localization Revisited, [Homepage], [PDF], BMVC 2012
- Improving Image-Based Localization by Active Correspondence Search, [Homepage], [PDF], ECCV 2012
- Scalable 6-DOF Localization on Mobile Devices, [Homepage], [PDF], ECCV 2014
Hierarchical Localization
- From Coarse to Fine: Robust Hierarchical Localization at Large Scale, [PDF], [CODE], CVPR 2019
- SuperGlue: Learning Feature Matching with Graph Neural Networks, [Homepage], [PDF], [CODE], CVPR 2020
- hloc - the hierarchical localization toolbox, [CODE]
Pixel to Pose and Pose Refinement
- Back to the Feature: Learning Robust Camera Localization from Pixels to Pose, [Homepage], [PDF], CVPR 2021,详见笔记
Footnotes
-
Laurent Kneip, Davide Scaramuzza, and Roland Siegwart. A Novel Parametrization of the Perspective-three-point Problem for a Direct Computation of Absolute Camera Position and Orientation. In CVPR, 2011. ↩ ↩2
-
T. Sattler, B. Leibe, and L. Kobbelt. Fast image-based localization using direct 2d-to-3d matching. In ICCV, 2011. ↩ ↩2
-
Pierre Moulon, Pascal Monasse, and Renaud Marlet. Global Fusion of Relative Motions for Robust, Accurate and Scalable Structure from Motion. In ICCV, 2013. ↩ ↩2 ↩3
-
Torsten Sattler, Bastian Leibe, and Leif Kobbelt. Efficient & Effective Prioritized Matching for Large-Scale Image-Based Localization. PAMI, 39(9):1744–1756, 2017. ↩ ↩2
-
Liu Liu, Hongdong Li, and Yuchao Dai. Efficient Global 2D-3D Matching for CameraLocalization in a Large-Scale 3D Map. In ICCV, 2017. ↩
-
H. Taira, M. Okutomi, T. Sattler, M. Cimpoi, M. Pollefeys, J. Sivic, T. Pajdla, and A. Torii. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. PAMI, 2019. ↩
-
Johannes L. Schonberger and Jan-Michael Frahm. Structure-from-motion Revisited. In CVPR, 2016. ↩ ↩2 ↩3 ↩4
-
Gabriela Csurka, Christopher R. Dance, and Martin Humenberger. From Handcrafted to Deep Local Invariant Features. arXiv, 1807.10254, 2018. ↩ ↩2
-
Revaud Jerome, Philippe Weinzaepfel, Cesar De Souza, and Martin Humenberger.R2D2: Reliable and Repeatable Detectors and Descriptors. In NeurIPS, 2019. ↩ ↩2 ↩3
-
David G. Lowe. Distinctive Image Features from Scale-invariant Keypoints. IJCV, 60(2):91–110, 2004. ↩
-
Mihai Dusmanu, Ignacio Rocco, Tomas Pajdla, Marc Pollefeys, Josef Sivic, Akihiko Torii, and Torsten Sattler. D2-Net: a Trainable CNN for Joint Description and Detection of Local Features. In CVPR, 2019. ↩
-
Daniel DeTone, Tomasz Malisiewicz, and Andrew Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. In CVPR Workshops, 2018. ↩
-
Axel Barroso-Laguna, Edgar Riba, Daniel Ponsa, Krystian Mikolajczyk. Key.Net: Keypoint detection by handcrafted and learned cnn filters. ICCV 2019. PDF, Code ↩
-
Paul-Edouard Sarlin, Daniel DeTone, Tomasz Malisiewicz, and Andrew Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. In CVPR, 2020. ↩
-
Johannes Lutz Schonberger, Hans Hardmeier, Torsten Sattler, and Marc Pollefeys. Comparative Evaluation of Hand-Crafted and Learned Local Features. In CVPR, 2017. ↩
-
Ma Jiayi et.al. Image Matching from Handcrafted to Deep Features: A Survey. International Journal of Computer Vision (IJCV 2020) ↩
-
Paul-Edouard Sarlin, Cesar Cadena, Roland Siegwart, and Marcin Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. In CVPR, 2019. ↩ ↩2
-
M. Fischler and R. Bolles. Random Sampling Consensus: A Paradigm for Model Fitting with Application to Image Analysis and Automated Cartography. Communications of the ACM, 24:381–395, 1981. ↩
-
O. Chum and J. Matas. Optimal Randomized RANSAC. PAMI, 30(8):1472 –1482, 2008. ↩
-
Barath Daniel, Matas Jiri, Noskova Jana. MAGSAC: marginalizing sample consensus, CVPR 2019. ↩
-
Barath Daniel, Noskova Jana, Ivashechkin Maksym, Matas Jiri. MAGSAC++: a fast, reliable and accurate robust estimator, CVPR 2020. ↩
-
Torsten Sattler, Will Maddern, Carl Toft, Akihiko Torii, Lars Hammarstrand, Erik Stenborg, Daniel Safari, Masatoshi Okutomi, Marc Pollefeys, Josef Sivic, Fredrik Kahl, and Tomas Pajdla. Benchmarking 6DoF Outdoor Visual Localization in Changing Conditions. In CVPR, 2018. ↩
-
Sattler, Torsten, Bastian Leibe, and Leif Kobbelt. Improving image-based localization by active correspondence search. ECCV 2012. PDF ↩
-
Image-Based Localization, https://www.graphics.rwth-aachen.de/software/image-localization ↩
-
Martin Humenberger, Yohann Cabon, Nicolas Guerin, Julien Morat, Jerome Revaud, Philippe Rerole, Noe Pion, Cesar de Souza, Vincent Leroy, and Gabriela Csurka. Robust Image Retrieval-based Visual Localization using Kapture. arXiv:2007.13867, 2020. ↩
-
Eric Brachmann and Carsten Rother. Learning less is more – 6d camera localization via 3d surface regression. In CVPR, 2018. ↩ ↩2
-
Eric Brachmann and Carsten Rother. Expert sample consensus applied to camera re-localization. In ICCV, 2019. ↩ ↩2
-
Xiaotian Li, Shuzhe Wang, Yi Zhao, Jakob Verbeek, and Juho Kannala. Hierarchical scene coordinate classification and regression for visual localization. In CVPR, 2020. ↩ ↩2
-
Eric Brachmann and Carsten Rother. Visual camera re-localization from rgb and rgb-d images using dsac, arXiv, 2020. ↩ ↩2
-
Jamie Shotton, Ben Glocker, Christopher Zach, Shahram Izadi, Antonio Criminisi, and Andrew Fitzgibbon. Scene Coordinate Regression Forests for Camera Relocalization in RGB-D Images. In CVPR, 2013. ↩ ↩2
-
Jiaming Sun, Zehong Shen, Yuang Wang, Hujun Bao, and Xiaowei Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. In CVPR, 2021. ↩ ↩2
-
Xingyi He, Jiaming Sun, Yifan Wang, Sida Peng, Qixing Huang, Hujun Bao, and Xiaowei Zhou. Detector-Free Structure from Motion. In CVPR, 2024. ↩ ↩2
-
Linfei Pan, Dániel Baráth, Marc Pollefeys, and Johannes L. Schönberger. Global Structure-from-Motion Revisited (GLOMAP). In ECCV, 2024. ↩ ↩2
-
Vojtech Panek, Zuzana Kukelova, and Torsten Sattler. MeshLoc: Mesh-Based Visual Localization. In ECCV, 2022. ↩
-
Noé Pion, Martin Humenberger, Gabriela Csurka, Yohann Cabon, and Torsten Sattler. Benchmarking Image Retrieval for Visual Localization. In 3DV, 2020. ↩ ↩2 ↩3
-
Akihiko Torii, Josef Sivic, and Tomas Pajdla. Visual Localization by Linear Combination of Image Descriptors. In ICCV Workshops , 2011. ↩ ↩2
-
Torsten Sattler, Qunjie Zhou, Marc Pollefeys, and Laura Leal-Taixe. Understanding the Limitations of CNN-based Absolute Camera Pose Regression. In CVPR, 2019. ↩ ↩2 ↩3
-
Wei Zhang and Jana Kosecka. Image Based Localization in Urban Environments. In 3DPVT, 2006. ↩
-
Qunjie Zhou, Torsten Sattler, Marc Pollefeys, and Laura Leal-Taixe. To Learn or not to Learn: Visual Localization from Essential Matrices. ICRA, 2020. ↩ ↩2
-
Relja Arandjelovic, Petr Gronat, Akihiko Torii, Tomas Pajdla, and Josef Sivic. NetVLAD: CNN Architecture for Weakly Supervised Place Recognition. In CVPR, 2016. ↩ ↩2
-
Akihiko Torii, Relja Arandjelovic, Josef Sivic, Masatoshi Okutomi, and Tomas Pajdla. 24/7 Place Recognition by View Synthesis. In CVPR, 2015. ↩
-
Albert Gordo, Jon Almazan, Jerome Revaud, and Diane Larlus. End-to-End Learning of Deep Visual Representations for Image Retrieval. IJCV, 124:237—-254, 2017. ↩
-
Alex Kendall and Roberto Cipolla. Geometric Loss Functions for Camera Pose Regression with Deep Learning. In CVPR, 2017. ↩ ↩2
-
Jerome Revaud, Jon Almazan, Rafael Sampaio de Rezende, and Cesar Roberto de Souza. Learning with Average Precision: Training Image Retrieval with a Listwise Loss. In ICCV, 2019. ↩ ↩2
-
Filip Radenovic, Giorgos Tolias, and Ondrej Chum. Fine-Tuning CNN Image Retrieval with no Human Annotation. PAMI, 41(7):1655–1668, 2019. PDF, Code ↩ ↩2
-
Josef Sivic and Andrew Zisserman. Video Google: A Text Retrieval Approach to Object Matching in Videos. In ICCV, 2003. ↩
-
David Nistér and Henrik Stewénius. Scalable Recognition with a Vocabulary Tree. In CVPR, 2006. ↩
-
Hervé Jégou, Matthijs Douze, Cordelia Schmid, and Patrick Pérez. Aggregating Local Descriptors into a Compact Image Representation. In CVPR, 2010. ↩
-
From Coarse to Fine: Robust Hierarchical Localization at Large Scale with HF-Net, pdf ↩
-
Martin Humenberger, Yohann Cabon, et.al. Investigating the Role of Image Retrieval for Visual Localization — An exhaustive benchmark. IJCV 2022, PDF ↩
-
Giorgos Tolias, Yannis Avrithis, and Hervé Jégou. To Aggregate or Not to Aggregate: Selective Match Kernels for Image Search. In ICCV, 2013. ↩
-
Giorgos Tolias, Tomas Jenicek, and Ondřej Chum. Learning and Aggregating Deep Local Descriptors for Instance-Level Recognition (HOW). In ECCV, 2020. ↩
-
Philippe Weinzaepfel, Thomas Lucas, Diane Larlus, and Yannis Kalantidis. Learning Super-Features for Image Retrieval (FIRe). In ICLR, 2022. ↩
-
Hyeonwoo Noh, Andre Araujo, Jack Sim, Tobias Weyand, and Bohyung Han. Large-Scale Image Retrieval with Attentive Deep Local Features (DELF). In ICCV, 2017. ↩
-
Bingyi Cao, Andre Araujo, and Jack Sim. Unifying Deep Local and Global Features for Image Search (DELG). In ECCV, 2020. ↩
-
Eric Brachmann, Alexander Krull, Sebastian Nowozin, Jamie Shotton, Frank Michel, Stefan Gumhold, and Carsten Rother. DSAC – differentiable RANSAC for camera localization. In CVPR, 2017. ↩ ↩2
-
Eric Brachmann, Tommaso Cavallari, and Victor Adrian Prisacariu. Accelerated Coordinate Encoding: Learning to Relocalize in Minutes using RGB and Poses (ACE). In CVPR, 2023. ↩
-
Luwei Yang, Ziqian Bai, Chengzhou Tang, Honghua Li, Yasutaka Furukawa, and Ping Tan. Sanet: Scene agnostic network for camera localization. In ECCV, 2019. ↩ ↩2
-
Shitao Tang, Chengzhou Tang, Rui Huang, Siyu Zhu, and Ping Tan. Learning Camera Localization via Dense Scene Matching (DSM). In CVPR, 2021. ↩
-
Torsten Sattler, Akihiko Torii, Josef Sivic, Marc Pollefeys, Hajime Taira, Masatoshi Okutomi, and Tomas Pajdla. Are Large-Scale 3D Models Really Necessary for Accurate Visual Localization? In CVPR, 2017. ↩
-
Alex Kendall, Matthew Grimes, and Roberto Cipolla. PoseNet: A Convolutional Network for Real-Time 6-DOF Camera Relocalization. In ICCV, 2015. ↩ ↩2
-
Samarth Brahmbhatt, Jinwei Gu, Kihwan Kim, James Hays, and Jan Kautz. Geometry aware learning of maps for camera localization. In CVPR, 2018. ↩
-
Abhinav Valada, Noha Radwan, and Wolfram Burgard. Deep auxiliary learning for visual localization and odometry. In ICRA, 2018. ↩
-
N. Radwan, A. Valada, and W. Burgard. Vlocnet++: Deep multitask learning for semantic visual localization and odometry. RA-L, 3(4):4407–4414, 2018. ↩
-
Chengzhou Tang and Ping Tan. BA-Net: Dense Bundle Adjustment Network. In ICLR, 2019. ↩
-
Lukas von Stumberg, Patrick Wenzel, Qadeer Khan, and Daniel Cremers. GN-Net: The Gauss-Newton Loss for Multi-Weather Relocalization. RA-L, 2020. ↩
-
Paul-Edouard Sarlin, Ajaykumar Unagar, Måns Larsson, Hugo Germain, Carl Toft, Viktor Larsson, Marc Pollefeys, Vincent Lepetit, Lars Hammarstrand, Fredrik Kahl, and Torsten Sattler. Back to the Feature: Learning Robust Camera Localization from Pixels to Pose (PixLoc). In CVPR, 2021. ↩
-
Lin Yen-Chen, Pete Florence, Jonathan T. Barron, Alberto Rodriguez, Phillip Isola, and Tsung-Yi Lin. iNeRF: Inverting Neural Radiance Fields for Pose Estimation. In IROS, 2021. ↩
-
Zihan Zhu, Songyou Peng, Viktor Larsson, Weiwei Xu, Hujun Bao, Zhaopeng Cui, Martin R. Oswald, and Marc Pollefeys. NICE-SLAM: Neural Implicit Scalable Encoding for SLAM. In CVPR, 2022. ↩
-
Edgar Sucar, Shikun Liu, Joseph Ortiz, and Andrew J. Davison. iMAP: Implicit Mapping and Positioning in Real-Time. In ICCV, 2021. ↩
-
Nikhil Keetha, Jay Karhade, Krishna Murthy Jatavallabhula, Gengshan Yang, Sebastian Scherer, Deva Ramanan, and Jonathon Luiten. SplaTAM: Splat, Track & Map 3D Gaussians for Dense RGB-D SLAM. In CVPR, 2024. ↩ ↩2
-
Hidenobu Matsuki, Riku Murai, Paul H. J. Kelly, and Andrew J. Davison. Gaussian Splatting SLAM. In CVPR, 2024. ↩ ↩2
-
Carl Toft, Erik Stenborg, Lars Hammarstrand, Lucas Brynte, Marc Pollefeys, Torsten Sattler, and Fredrik Kahl. Semantic match consistency for long-term visual localization. In ECCV, 2018. ↩
-
Nikolay Kobyshev, Hayko Riemenschneider, and Luc Van Gool. Matching features correctly through semantic understanding. In 3DV, 2014. ↩
-
Renato F Salas-Moreno, Richard A Newcombe, Hauke Strasdat, Paul HJ Kelly, and Andrew J Davison. Slam++: Simultaneous localisation and mapping at the level of objects. In CVPR, 2013. ↩
-
Andrea Cohen, Johannes L Schonberger, Pablo Speciale, Torsten Sattler, Jan-Michael Frahm, and Marc Pollefeys. Indoor-outdoor 3d reconstruction alignment. In ECCV, 2016. ↩
-
Shervin Ardeshir, Amir Roshan Zamir, Alejandro Torroella, and Mubarak Shah. Gis-assisted object detection and geospatial localization. In ECCV, 2014. ↩
-
Philippe Weinzaepfel, Gabriela Csurka, Yohann Cabon, and Martin Humenberger. Visual localization by learning objects-of-interest dense match regression. In CVPR, June 2019. ↩
-
Nikhil Keetha, Avneesh Mishra, Jay Karhade, Krishna Murthy Jatavallabhula, Sebastian Scherer, Madhava Krishna, and Sourav Garg. AnyLoc: Towards Universal Visual Place Recognition. RA-L, 2023. ↩
-
Sergio Izquierdo and Javier Civera. Optimal Transport Aggregation for Visual Place Recognition (SALAD). In CVPR, 2024. ↩
-
Philipp Lindenberger, Paul-Edouard Sarlin, and Marc Pollefeys. LightGlue: Local Feature Matching at Light Speed. In ICCV, 2023. ↩
-
Johan Edstedt, Qiyu Sun, Georg Bökman, Mårten Wadenbäck, and Michael Felsberg. RoMa: Robust Dense Feature Matching. In CVPR, 2024. ↩
-
Eric Brachmann, Jamie Wynn, Shuai Chen, Tommaso Cavallari, Áron Monszpart, Daniyar Turmukhambetov, and Victor Adrian Prisacariu. Scene Coordinate Reconstruction: Posing of Image Collections via Incremental Learning of a Relocalizer (ACE0). In ECCV, 2024. ↩
-
Fangjinhua Wang, Xudong Jiang, Silvano Galliani, Christoph Vogel, and Marc Pollefeys. GLACE: Global Local Accelerated Coordinate Encoding. In CVPR, 2024. ↩
-
Eduardo Arnold, Jamie Wynn, Sara Vicente, Guillermo Garcia-Hernando, Áron Monszpart, Victor Adrian Prisacariu, Daniyar Turmukhambetov, and Eric Brachmann. Map-free Visual Relocalization: Metric Pose Relative to a Single Image. In ECCV, 2022. ↩
-
Siyan Dong, Shuzhe Wang, Shaohui Liu, Lulu Cai, Qingnan Fan, Juho Kannala, and Yanchao Yang. Reloc3r: Large-Scale Training of Relative Camera Pose Regression for Generalizable, Fast, and Accurate Visual Localization. In CVPR, 2025. ↩
-
Shuzhe Wang, Vincent Leroy, Yohann Cabon, Boris Chidlovskii, and Jérôme Revaud. DUSt3R: Geometric 3D Vision Made Easy. In CVPR, 2024. ↩
-
Vincent Leroy, Yohann Cabon, and Jérôme Revaud. Grounding Image Matching in 3D with MASt3R. In ECCV, 2024. ↩
-
Bardienus Duisterhof, Lojze Žust, Philippe Weinzaepfel, Vincent Leroy, Yohann Cabon, and Jérôme Revaud. MASt3R-SfM: A Fully-Integrated Solution for Unconstrained Structure-from-Motion. In 3DV, 2025. ↩
-
Jianyuan Wang, Minghao Chen, Nikita Karaev, Andrea Vedaldi, Christian Rupprecht, and David Novotny. VGGT: Visual Geometry Grounded Transformer. In CVPR, 2025. ↩