· updated Jan 27, 2025 · 23 min read
笔记:CVPR 2021 | PixLoc:端到端场景无关视觉定位算法(SuperGlue 一作出品)
今天要介绍的文章是“Back to the Feature: Learning Robust Camera Localization from Pixels to Pose”,发表于 CVPR 2021,本文的一作正是 SuperGlue 的作者,本文实现一种端到端场景无关的相机定位网络,在公开数据集上表现优异。
论文:https://arxiv.org/abs/2103.09213
摘要
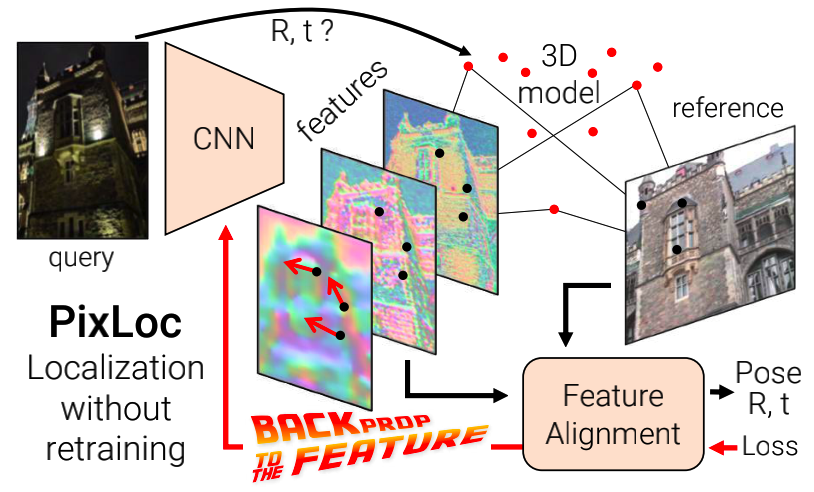
最近在相机位姿估计任务中涌现了不少基于学习的算法。其中很多是回归出某些几何量(如位姿回归或者 3D 坐标回归)来实现定位,但这些方法的泛化性在视角变化或者模型参数变换后会大打折扣。
本文提出了一种场景无关的算法 PixLoc,输入为一张图像以及 3D 模型,输出图像对应的相机位姿。本文方法基于直接对齐多尺度深度特征,将相机定位问题转换成度量学习。PixLoc 端到端地学习了从像素到位姿的数据先验,这种能力可以在新的场景以及模型下表现优异。本文算法不仅能够在给定粗略姿先验的情况下定位,而且能够对位姿以及特征点进行联合优化。
原有技术问题
端到端地回归出相机相对位姿(pose regression)或者场景的 3D 坐标(coordinate regression)通常是场景相关的,无法有效地拓展到新的场景,如场景出现了较大的光照变化,如训练集中仅有白天的图像而定位集出现晚上的图片,或者视角发生较大的变化时位姿的精度通常是较低的;另外一点就是精度相较于视觉定位(2D-3D)的方式精度低。
新技术创新点
作者提到,端到端的视觉定位算法应该着重于表征学习,不是让网络学习基本的几何关系亦或编码的 3D 图,而是让网络能够较好地理解几何原则以及鲁棒地应对外观以及结构变化。
本文作者提出的 PixLoc 能够做到场景无关的端到端学习位姿,且能够较好地做到跨场景(室外到室内)的相机定位。
关键技术点
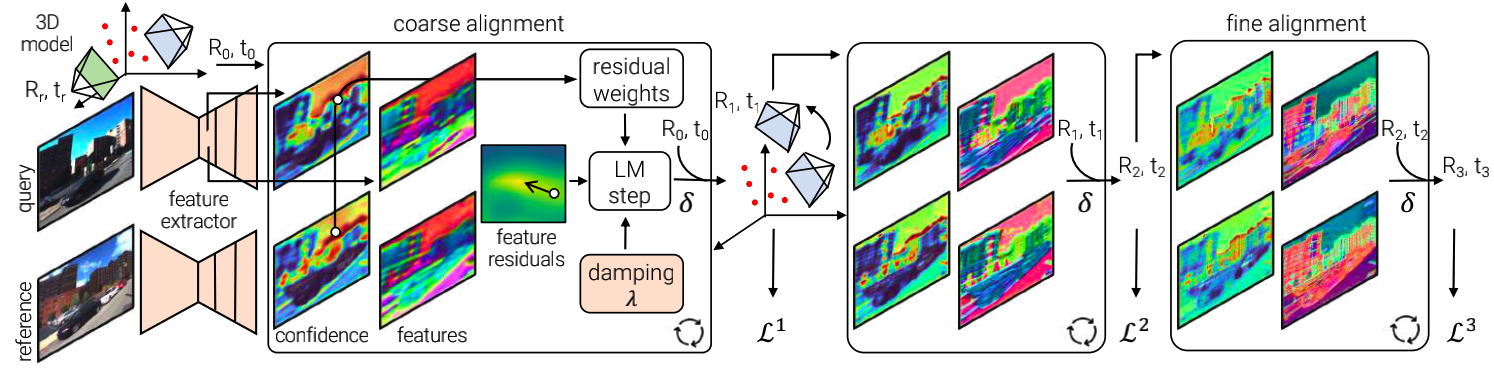
总览:利用已知的 3D 模型将 query 图与 reference 图像直接对齐对位姿进行解算,其中对齐过程中用了一种面向深度特征的非线性优化。
输入:稀疏 3D 模型(如 SfM 稀疏模型),粗略的初始位姿(可以通过图像召回获取)
输出:查询图像对应的相机位姿
公式化:目标是估计查询图像 的 6-DOF 相机位姿,稀疏 3D 模型中 3D 点云表示为:
其中的参考图表示为:
图像对齐
图像表征:对于输入的查询图像 以及参考图像:
利用 CNN 提取多尺度的特征,可以在第尺度上得到维的特征图:
其中越小尺度越小,注:特征图在通道上做了归一化以提高泛化性。
相机位姿:
以最小化查询图像与参考图像之间的外观差异。对于给定的特征尺度以及被参考图像观测到的 3D 点,定义如下残差项:
其中表示 3D 点在查询图像上的投影坐标,表示亚像素插值操作。于是对于所有的个观测的残差可以定义为如下形式:
其中表示代价函数,表示每个残差的权重(后续介绍),通过 LM 算法迭代优化得到待优化位姿。
为了增大收敛域(convergence basin),本文从最 coarse 的一个尺度进行连续优化,下一尺度优化的初值是上一个尺度优化的结果。所以说,低分辨率的特征负责位姿预测的鲁棒性,而高分辨率的特征负责精化位姿精度。
引入视觉先验:上述过程其实可以等价于传统的光度对齐的思路,考虑到 CNN 拥有强大的学习复杂视觉先验的能力,本文试图将这种视觉先验引入位姿优化。为了达到这个目标,CNN 对每个尺度的特征图预测了一张对应的不确定图(笔者:文中没有具体说是如何得到该量),于是查询图与参考图像逐点权重可以通过下述方式进行计算:
如果 3D 点重投影的不确定性小,那么这个权重会趋向于 1,若该不确定性较大,这个权重趋近于 0;
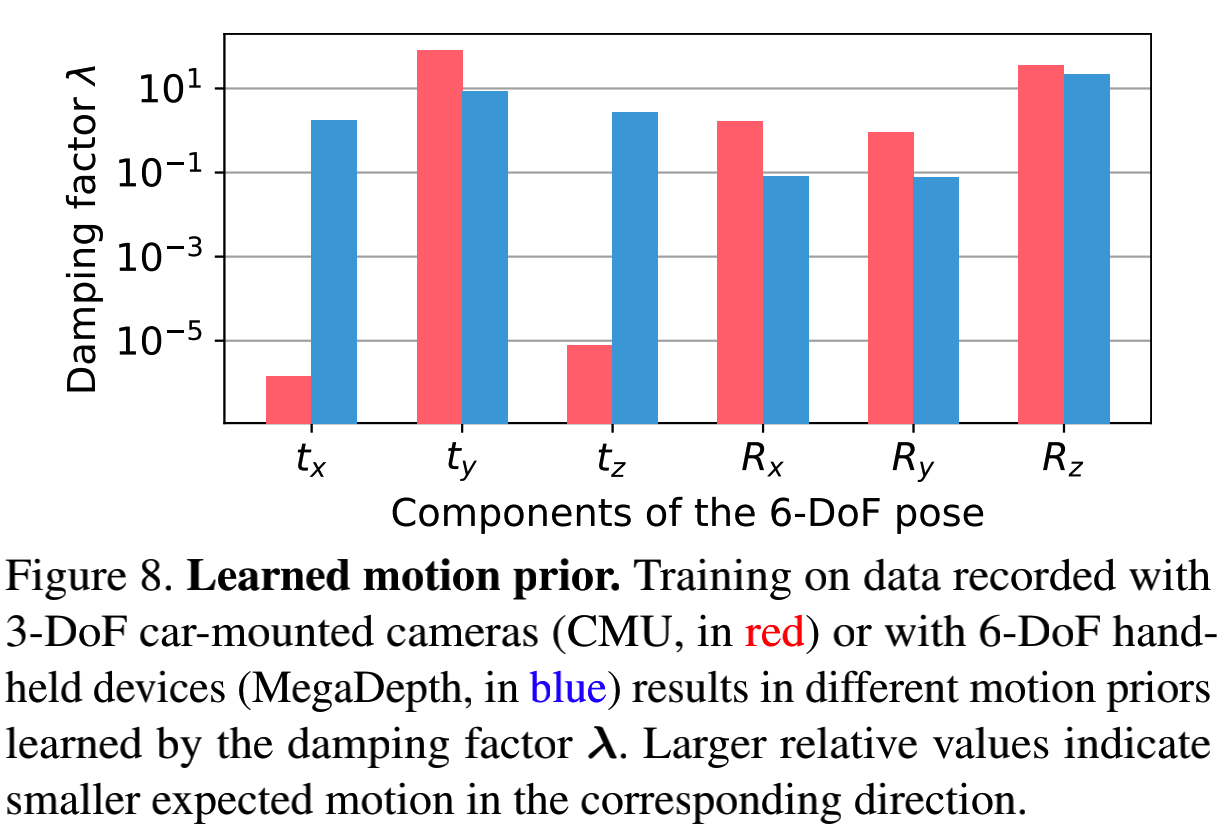
将优化器与数据相匹配:LM 是一种通用的优化算法,其中包括很多启发式的操作,例如代价函数的选择,阻尼参数的选择等。作者认为上述参数的选择会极大地削弱模型推广到新的数据的能力,因为它将优化器与训练数据进行了“绑定”(笔者:即优化器与数据相关,泛化能力就会变弱)。所以,若优化器能够具有泛化性,就要让优化器适应姿势或残差的分布,而不是场景的语义内容。本文的方法是将阻尼因子作为一个网络学习的参数来对待,对于位姿的 6 参数而言,每个参数对应着不同的阻尼量,即将原来的标量替换成了向量:
将其参数化为如下形式(笔者:没有明确表示什么):
该方法在训练过程中调整各个姿态参数的曲率,直接从数据中学习运动先验知识。例如,当相机安装在汽车或一个基本直立的机器人上时,我们期望平面内旋转的阻尼很大。相反,普通的启发式算法对所有姿态参数一视同仁,不允许每个参数拥有不同阻尼量。
从位姿中学习
这部分实际上对应着对已有的位姿进行优化,即后文介绍的 PoseLocalizer。
由于 CNN 本身是不关注 3D 点的类型的,无论是通过视觉 SfM 来的,或者来自 RGBD 传感器/LiDAR 扫描等,PixLoc 可以用于以上各种 3D 点云的输入(笔者:如何做到异构特征的数据关联,如 LiDAR 地图与视觉图像?)。
训练:由于上述不确定图以及代价函数的存在,PixLoc 能够适应于噪声很大的稀疏 SfM 模型作为输入,在训练过程中一个不完美的 3D 结构是完全够用的(无需高精度稠密 3D 模型)。
损失函数:对于每一个尺度,都可以计算出一个:
其真值为,损失函数被构建为 3D 点的平均重投影误差:
其中为 Huber 核函数。
与现有算法比较
PixLoc vs. sparse matching:传统的局部特征匹配的方式包括多种数据操作,这些操作并不可微,例如特征点提取/匹配/RANSAC。相比于需要大量训练的强化学习的方式而言,本文端到端的方式可微分并且操作简单。
PixLoc vs. GN-Net:Von Stumberg 等人最近也提出了一些使用直接对齐的跨季节定位算法,他们的工作主要为了解决小基线场景且需要非常准确的逐像素真值对应关系以及大量的超参调整。作为对比,本文算法能够应对含有噪声的数据,且做到鲁棒定位。
定位流程
配合图像检索(即首先要做一步图像召回),PixLoc 可以是一个独立的定位模块,但也可以对之前方法估计的姿势进行优化。因为该算法只需要一个三维模型和一个粗略的初始姿势。
初始化
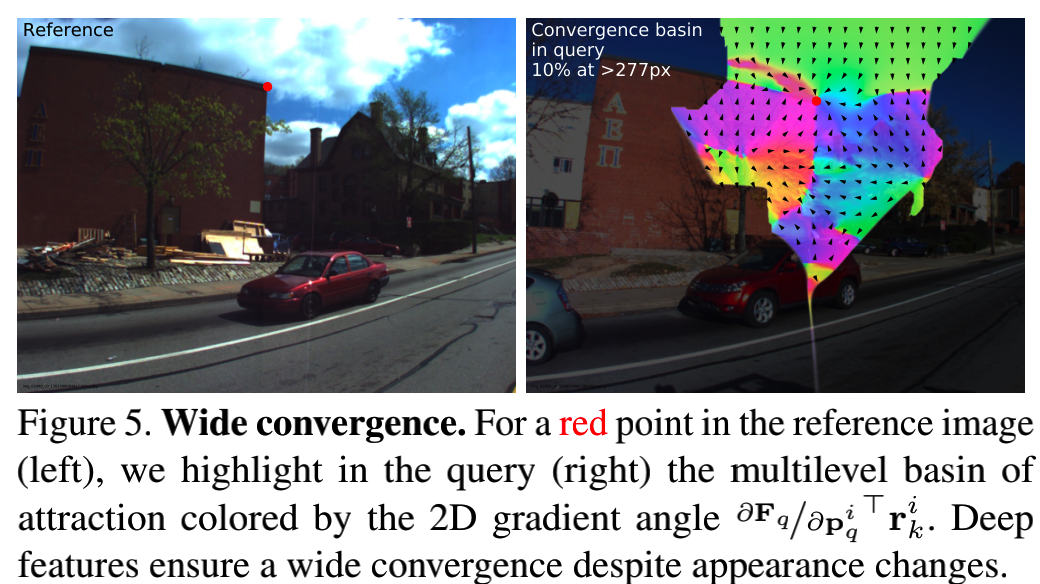
初始位姿的精度应该取决于对齐过程中收敛域的大小,经过深度 CNN 处理后一个特征点的感受野可以保证是非常大的,如下图所示,左图红色的点位于参考图像,右侧的高亮区域表示查询图像的多尺度收敛域,可见这个范围是比较大的。
3D 结构
本文使用了用 HLoc+COLMAP 重建的稀疏 SfM 模型,对于召回的参考图像,如 top5~10,将它们观测的 3D 点云收集起来并在其对应的 2D 点提取多尺度特征图(对于每个 3D 点至少有一个内点),详见 Fig3。
实验
网络结构:特征提取阶段使用了在 ImageNet 上预训练的 VGG19 编码器,,。算法使用 PyTorch 实现,特征提取耗时 100ms,位姿优化 200ms~1s。
端到端算法对比
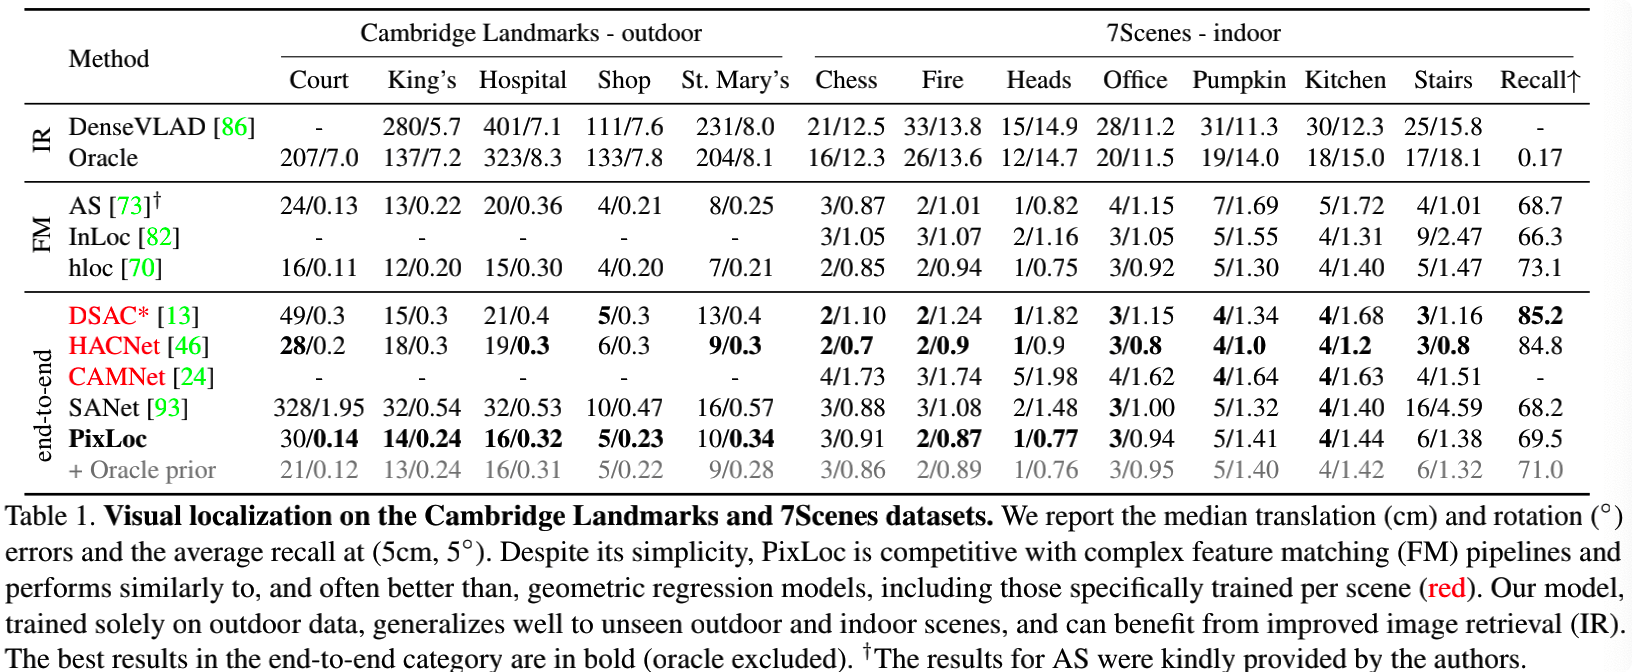
Cambridge Landmarks 以及 7Scenes datasets 定位效果
上图展示了不同算法在 Cambridge Landmarks 以及 7Scenes datasets 定位精度对比,数字表示在给定阈值(5cm/5deg)条件下的召回率以及平移和旋转误差中值。可以看到 PixLoc 能够与复杂的特征匹配(FM)的流程定位效果相当,与几何回归模型的定位效果相近;以上标红的算法表示模型针对每个场景进行了训练,而本文算法仅在室外场景中训练了一次,便可以很好地泛化到没有见过的室内外场景。
大场景定位算法比较
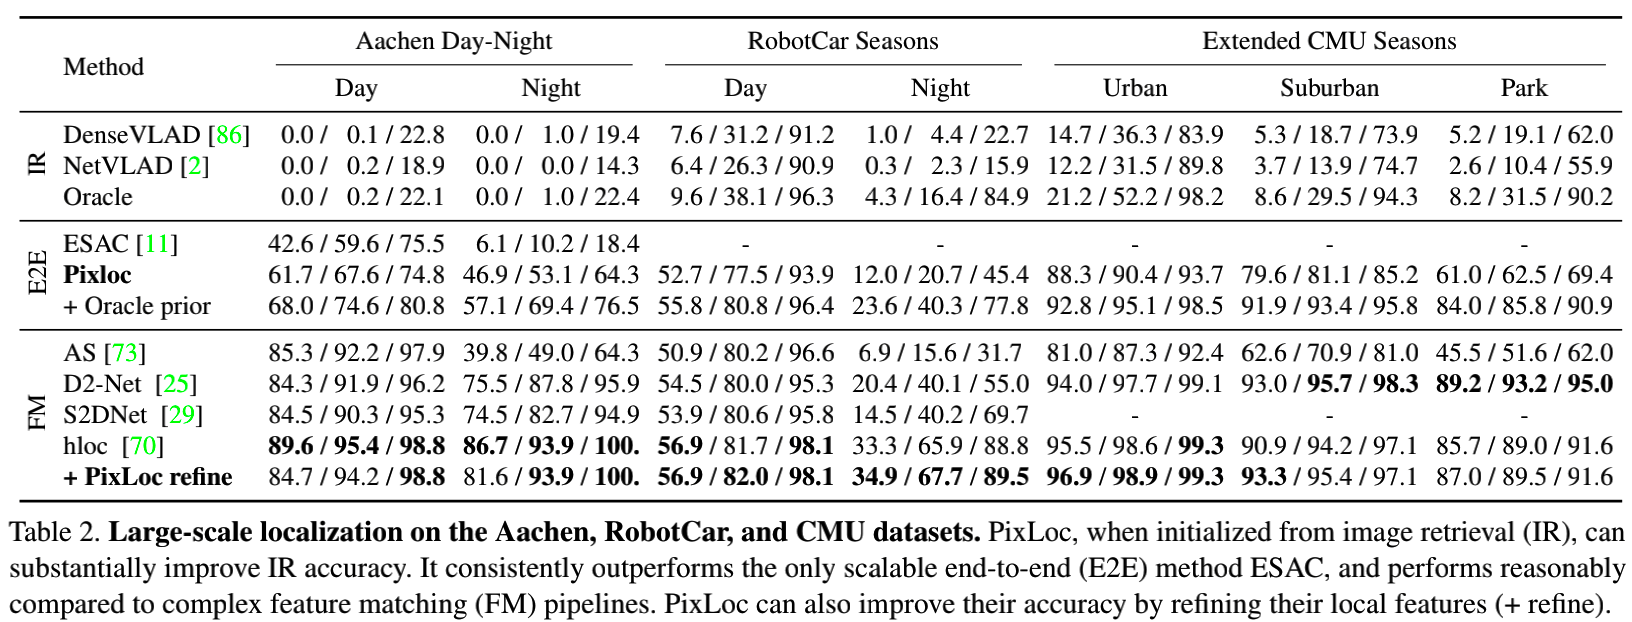
在 Aachen, RobotCar, CMU dataset 大尺度场景定位对比
以上给出了在大场景中定位召回率统计(阈值分别为 (25cm, 2deg)、(50cm, 5deg)、(5m, 10deg))。在初始位姿是由图像召回给定时,本文算法既简单又能够在挑战场景如夜晚获得相比 ESAC 精度更高的结果。作者提到,PixLoc(使用的 NetVLAD 召回图像,无 reranking)相较于 FM 的方式不够鲁棒,这是由于错误的图像召回会导致初始位姿不佳,使得算法无法收敛。此时若使用了召回效果较好的 oracle,召回率会有比较明显的提升。
PixLoc 还可以作为后处理位姿优化模块对定位位姿进行优化,上表中列出了使用 PixLoc 优化 hloc 的定位位姿的前后对比,平均增加了 2.4% 的召回率。
见解
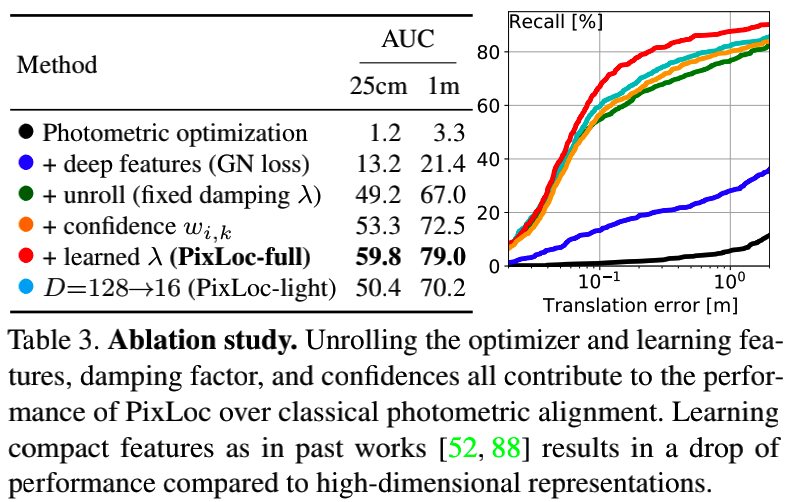
消融实验:作者也尝试了 Gauss-Newton loss,但是模型没有收敛;作者比较了添加每个改进后的 AUC,可以看到每个小改进都有一定作用。
pixloc-tab3
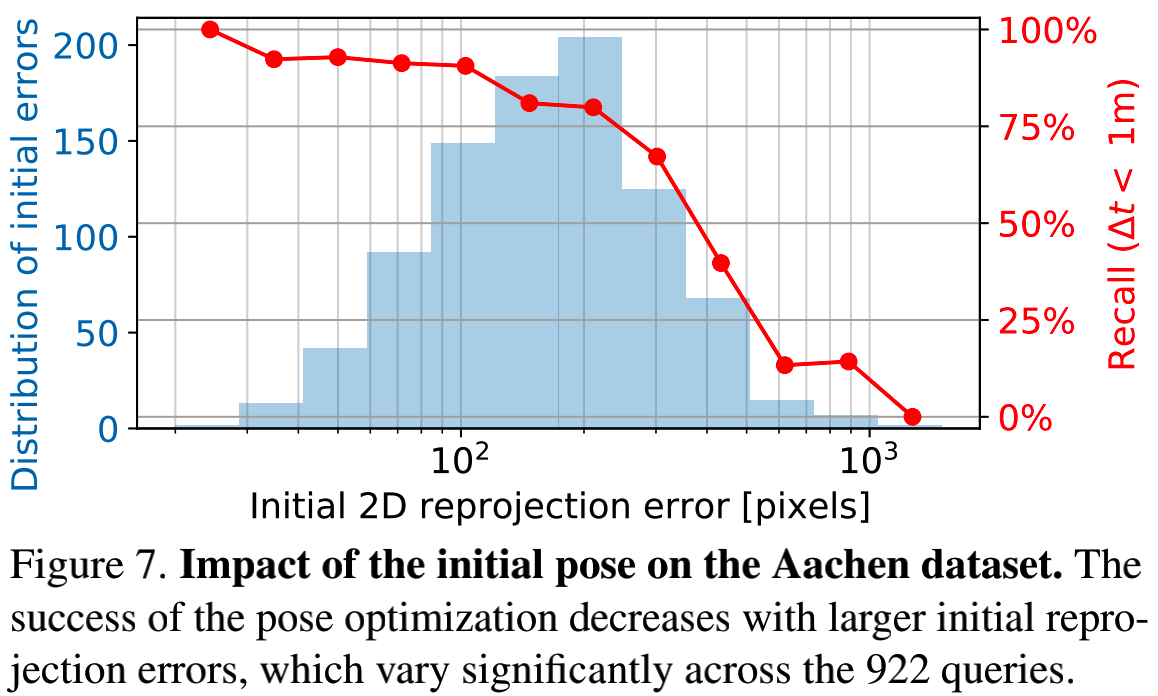
局限性:PixLoc 受限于 CNN 感受野的大小,如果初始位姿的重投影误差较大,模型预测会陷入局部最优;因此,PixLoc 容易受到视角变化/遮挡物的影响,也对错误的相机标定敏感。
pixloc-fig7
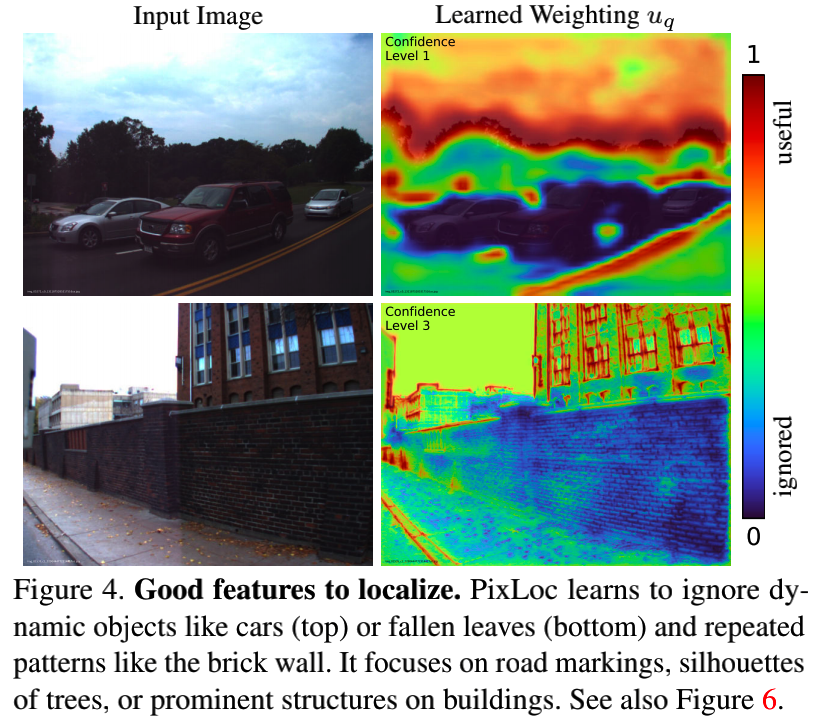
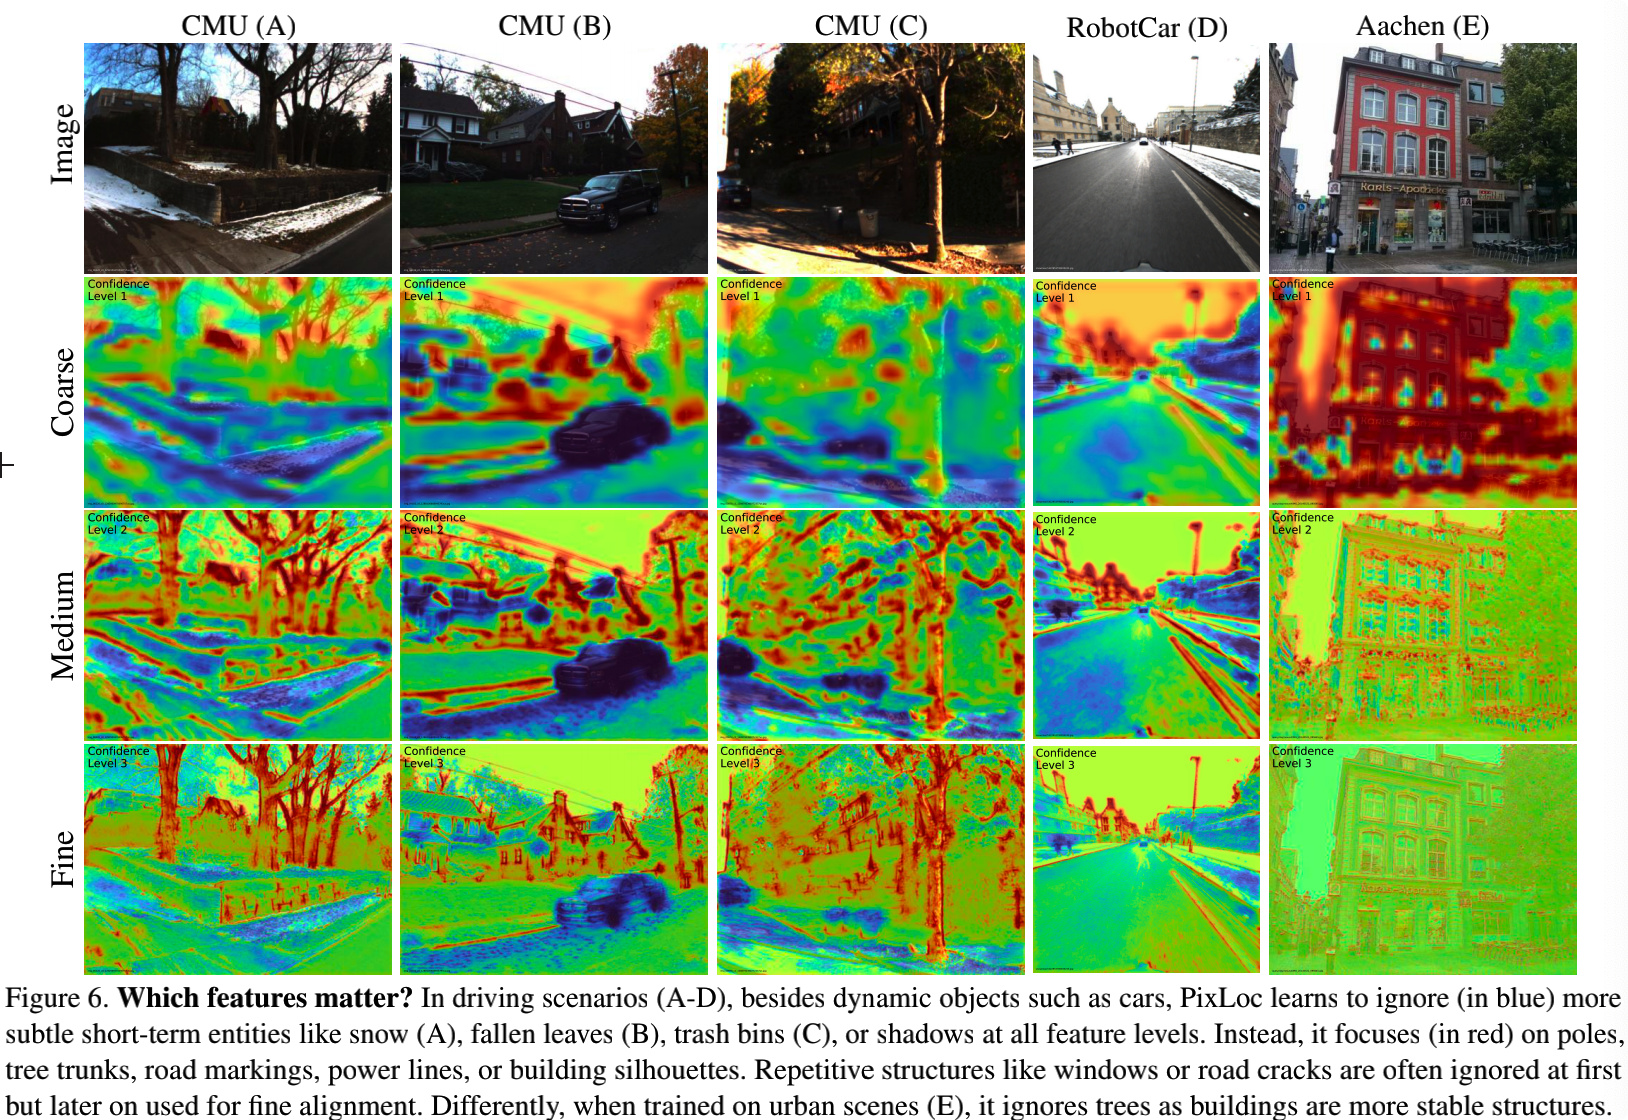
可解释性:对权重图进行可视化可以帮助我们理解 PixLoc 到底关注场景的何种线索。A-D 为室外驾驶场景,PixLoc 可以忽略动态物体如车辆,同时也可以忽略掉短期的特征如雪(A),落叶(B),垃圾桶(C)以及影子等;PixLoc 更加关注于柱子,树干,路标,电线以及建筑轮廓。重复的纹理如窗户在一开始会被忽略但到后期会被用来做优化。不同的是,对于城市场景 E,网络更加关注于固定的建筑物而不是大树。
pixloc-fig6
借鉴意义
- 提供了一种场景无关的端到端视觉定位算法,一次模型训练,可用于多个场景的相机定位;
- 精度较高,能够与目前最优的端到端的相机定位算法精度相当甚至更好;
- 可以对相机位姿进行后处理以精化定位位姿;
代码解析
建议从 pixloc/run_Aachen.py 开始阅读。
- 配置项
default_confs,分为两种模式:from_retrieval 和 from_poses 模式,它们分别对应 RetrievalLocalizer 以及 PoseLocalizer,两种模式的区别在于前者没有直接给出初始位姿,由召回的参考帧给定初始位姿;后者使用已有的位姿使用 feature map 进行优化;此二者均继承 Localizer 基类;只是成员函数实现存在一定差异;此外,配置项目录pixloc/pixlib/configs,在 demo 文件中设置experiment = 'pixloc_megadepth'来决定使用的配置文件为train_pixloc_megadepth.yaml,这个文件中定义了数据 data/model 等配置
if args.from_poses:
    localizer = PoseLocalizer(paths, conf)
else:
    localizer = RetrievalLocalizer(paths, conf)
poses, logs = localizer.run_batched(skip=args.skip)- 基类 Localizer 有两个非常重要的函数:特征提取器 extractor 以及 optimizer;其中 optimizer 是最核心的位姿优化器;
# Loading feature extractor and optimizer from experiment or scratch
conf = oc.create(conf)
conf_features = conf.features.get('conf', {})
conf_optim = conf.get('optimizer', {})
if conf.get('experiment'):
    pipeline = load_experiment(
            conf.experiment,
            {'extractor': conf_features, 'optimizer': conf_optim})
    pipeline = pipeline.to(device)
    logger.debug(
        'Use full pipeline from experiment %s with config:\n%s',
        conf.experiment, oc.to_yaml(pipeline.conf))
    extractor = pipeline.extractor
    optimizer = pipeline.optimizer
    if isinstance(optimizer, torch.nn.ModuleList):
        optimizer = list(optimizer)
else:
    assert 'name' in conf.features
    extractor = get_model(conf.features.name)(conf_features)
    optimizer = get_model(conf.optimizer.name)(conf_optim)

self.paths = paths
self.conf = conf
self.device = device
self.optimizer = optimizer
self.extractor = FeatureExtractor(
extractor, device, conf.features.get('preprocessing', {}))- 此外,值得注意的是 pixloc 的代码习惯非常值得我们学习,如 pixloc 加载模型的方式(根据 yaml 配置文件自动选择加载对应的模型文件,使用了 omegaconf),在推理时采用了
learned_optimizer(继承了 BaseOptimizer,其中 _run() 函数实现在 feature map 上进行 LM);Python 中面向对象的编程模式被应用得非常娴熟,可复用的模块颇多,为后续算法设计提供了不少资源……
RetrievalLocalizer
对于 pose from retrieval (RetrievalLocalizer): pixloc/localization/localizer.py,其优化器 refiner 为 RetrievalRefiner(继承 BaseRefiner),其操作过程如下:
-
初始化 RetrievalLocalizer 中各个成员函数/变量,其中比较重要的是 RetrievalRefiner,即优化器;
-
在初始化该优化器时,可选地输入全局描述子,后续会根据该全局描述子估计一个大概的初始位姿,若没有全局描述子则使用 topk1 的位姿作为初始位姿;
接下来执行位姿估计的主流程 run_query:
- 获取参考帧上观测到的 3D 点,并记录其被哪些参考帧观测,记为 p3did_to_dbids;
- 上述过程准备好了查询帧相机内参,初始位姿,3D 点 p3did_to_dbids 等信息;
- 调用 BaseRefiner 的
refine_query_pose函数对查询帧位姿进行优化,输入量为上述信息;- 获取参考帧图像:由 p3did_to_dbids 获取参考帧 id,然后得到参考帧名字,随后根据给定的参考帧路径得到参考帧图像;
- 同样地根据参考帧获得其关联的 3D 点集合:dbid_to_p3dids[db_id] -> a lot of p3ds 初始化优化的尺度,默认是 1;
- 提取参考帧的稠密特征图 dense_feature_extraction,获得每个 3D 点在参考帧上的特征集合 dbid_p3did_to_feats[dbid] -> a lot of p3ds’ feats
- 3D 点特征聚合 aggregate_features,输入上述 3D 点在参考帧上的特征,以及 3D 点对应的参考帧,输出每个 3D 点的多尺度响应;在其实现中,若开启 average_observations,则对多帧观测进行加权或者平均;
- 读取查询图像,提取特征图;
- 在 feature map 上对查询帧初始位姿进行优化
refine_pose_using_features,详见pixloc/pixlib/models/learned_optimizer.py;使用 PyTorch 实现了 LM 迭代过程,对位姿进行优化;这个过程从 coarse 尺度到 fine 尺度进行优化,也是一个迭代优化的过程;之所以要这么做,是由于多尺度的策略可以实现较大的收敛区间,比较好地应对初始位姿不准的问题;
接下来对 refine_pose_using_features 函数进行详细介绍,在该函数中有个变量 opt = self.optimizer,在优化时使用了它的 run() 方法。我们重点看下这个 run() 里面做了什么事情:追溯一下不难发现这个方法实际上调用了 LearnedOptimizer 类的 _run()。对于 _run() 函数,源码如下:
def _run(self, p3D: Tensor, F_ref: Tensor, F_query: Tensor,
          T_init: Pose, camera: Camera, mask: Optional[Tensor] = None,
          W_ref_query: Optional[Tuple[Tensor, Tensor]] = None):

    # 初始位姿
    T = T_init

    # 多尺度雅可比矩阵
    J_scaling = None
    if self.conf.normalize_features:
        F_ref = torch.nn.functional.normalize(F_ref, dim=-1)
    args = (camera, p3D, F_ref, F_query, W_ref_query)
    failed = torch.full(T.shape, False, dtype=torch.bool, device=T.device)

    # LM时的\lambda为可学习的参数
    lambda_ = self.dampingnet()

    for i in range(self.conf.num_iters):
        # 公式3,雅可比矩阵
        res, valid, w_unc, _, J = self.cost_fn.residual_jacobian(T, *args)
        if mask is not None:
            valid &= mask
        failed = failed | (valid.long().sum(-1) < 10)  # too few points

        # compute the cost and aggregate the weights
        cost = (res**2).sum(-1)
        cost, w_loss, _ = self.loss_fn(cost)
        weights = w_loss * valid.float()
        if w_unc is not None:
            weights *= w_unc
        if self.conf.jacobi_scaling:
            J, J_scaling = self.J_scaling(J, J_scaling, valid)

        # solve the linear system
        # 公式3:海塞矩阵, H * delta = g
        g, H = self.build_system(J, res, weights)

        # 使用cholesky_solve求解正规方程得到delta
        delta = optimizer_step(g, H, lambda_, mask=~failed)
        if self.conf.jacobi_scaling:
            delta = delta * J_scaling

        # compute the pose update
        # 公式4:位姿更新量
        dt, dw = delta.split([3, 3], dim=-1)
        T_delta = Pose.from_aa(dw, dt)

        # 公式5:更新后的位姿
        T = T_delta @ T

        self.log(i=i, T_init=T_init, T=T, T_delta=T_delta, cost=cost,
                  valid=valid, w_unc=w_unc, w_loss=w_loss, H=H, J=J)
        if self.early_stop(i=i, T_delta=T_delta, grad=g, cost=cost):
            break

    if failed.any():
        logger.debug('One batch element had too few valid points.')

    return T, failed
如下是 optimizer_step 函数的实现:
def optimizer_step(g, H, lambda_=0, mute=False, mask=None, eps=1e-6):
    """One optimization step with Gauss-Newton or Levenberg-Marquardt.
    Args:
        g: batched gradient tensor of size (..., N).
        H: batched hessian tensor of size (..., N, N).
        lambda_: damping factor for LM (use GN if lambda_=0).
        mask: denotes valid elements of the batch (optional).
    """
    if lambda_ is 0:  # noqa
        diag = torch.zeros_like(g)
    else:
        diag = H.diagonal(dim1=-2, dim2=-1) * lambda_

    # 公式4:(H + \lambda \times diag(H))
    H = H + diag.clamp(min=eps).diag_embed()

    if mask is not None:
        # make sure that masked elements are not singular
        H = torch.where(mask[..., None, None], H, torch.eye(H.shape[-1]).to(H))
        # set g to 0 to delta is 0 for masked elements
        g = g.masked_fill(~mask[..., None], 0.)

    H_, g_ = H.cpu(), g.cpu()
    try:
        U = cholesky(H_)
    except RuntimeError as e:
        if 'singular U' in str(e):
            if not mute:
                logger.debug(
                    'Cholesky decomposition failed, fallback to LU.')
            delta = -torch.solve(g_[..., None], H_)[0][..., 0]
        else:
            raise
    else:
        delta = -torch.cholesky_solve(g_[..., None], U)[..., 0]

    return delta.to(H.device)
PoseLocalizer
对于 pose from localizer (PoseLocalizer): pixloc/localization/localizer.py,其优化器 refiner 为 PoseRefiner(继承 BaseRefiner),其操作过程如下:
-
初始化 PoseLocalizer 中各个成员函数/变量,其中比较重要的是 PoseRefiner,即优化器;
-
在初始化该优化器时,由于已经有了初始位姿,此时并不需要全局描述子,这是与上述 RetrievalLocalizer 的不同之处;至于初始位姿如何获取,PoseLocalizer 依赖
hloc对查询帧进行定位后输出的 log 文件(该文件中保存了查询帧的位姿); -
接下来对初始位姿进行优化 run_query,过程与上述过程相同,唯一不同的是,初始位姿获取方式的差异,从位姿进行定位的初始位姿是根据 log 文件得到的初始位姿,后续过程略。