· 103 min read
论文解读:VidMap,把视频的时间结构塞进全局 SfM
TL;DR VidMap 是 MP-SfM 作者团队做的离线视频 SfM 系统[1]。它的出发点是一个老矛盾:SLAM 因果、增量,初始化差一点就一路漂,碰到纯旋转或跟踪丢失就再也救不回来;SfM 全局优化、无需初始化,却把视频当成无序图像集合,于是在重复结构面前分不清真回环和假回环。VidMap 把两边的长处拼起来:用 RoMa v2 这种稠密匹配器当跟踪器,沿时间链式传播稀疏轨迹,再用多流(multi-flow)直接匹配压住漂移;回环由图像检索提出,但从不和顺序轨迹合并,而是作为带「来源标签」的独立观测进入 GLOMAP 式的全局优化,顺序边用 Huber、回环边用 Cauchy;最后把 Depth Anything 3 的度量深度连同逐图尺度塞进全局定位和 BA,专治纯旋转、前向运动这类多视图几何本身无解的退化。结果:在手机长视频基准 LaMAR 上,无标定设置的全程 W-AUC 从最强基线 ViPE 的 76.6 提高到 88.5,有标定设置下也从 78.8 到 89.7;在灾难现场数据集 CroCoDL 的机器人序列上,GLOMAP 只有 19.2,VidMap 是 80.3;在短而规整的 ETH3D-SLAM 上也超过了拿着真值内参的 DROID-W 和 DPV-SLAM。消融里最刺眼的一行:去掉全局定位中的深度先验,LaMAR 全程 W-AUC 从 88.5 掉到 37.7。代码 Apache-2.0 开源,首次运行会下载约 9 GB 的模型权重。
- 论文:VidMap: Exploiting Temporal Structure for Video-Based Structure-from-Motion,Zador Pataki、Paul-Edouard Sarlin、Marc Pollefeys,ETH Zurich / Google / Microsoft Spatial AI Lab,ECCV 2026,arXiv 2026 年 7 月 29 日。
- 代码:github.com/cvg/vidmap
- 预备知识:本文假定读者知道 COLMAP 这一类增量 SfM 的流程,以及 hloc 里「检索 + 匹配 + PnP」的套路;稠密匹配器可以参考站内的 FlexGlue 解读。
一、动机:SLAM 和 SfM 各自卡在哪里
视频是今天数量最大的视觉数据:手机、眼镜、机器人都在连续拍。要把这些视频变成训练数据或三维模型,第一步是估计相机的内参和度量尺度的位姿。现有系统主要分两类,各自的短板都是结构性的,不是换个更好的特征就能补上的。
SLAM(ORB-SLAM3、DROID-SLAM、DPV-SLAM 等)[2, 3, 4]是因果的、增量的:每来一帧就注册一帧,任何时刻只用过去的信息。这带来三个问题。其一,弱初始化下的误差会随时间传播、累积;其二,纯旋转、前向运动这些退化构型会导致跟踪丢失,而且常常不可恢复;其三,大多数系统假定内参已知。回环检测能纠正位姿漂移,但纠正不了已经「焊死」在地图里的早期决定。作者还指出,学术 SLAM 系统为了实时性把各模块耦合得很紧,很难换进新的学习组件。
SfM(COLMAP、GLOMAP)[5, 6]是离线的,先看完所有观测再做决定,所以可以全局优化、可以联合标定内参、不需要初始化。代价是它不认识「时间」:视频被当成一袋无序图像,所有图像对一视同仁。于是在有重复结构(视觉混叠,visual aliasing)的室内场景,一个错误的回环匹配会以和正确顺序匹配同样的权重进入优化,把本来对的轨迹拧成一团。Doppelgangers 及其后续工作[7, 8]专门训练分类器判断两张图是不是同一个地方,能提高前端的鲁棒性,但没有触及这个结构性问题。另外,SfM 在做运动估计之前就完成了全部的数据关联,不能像 SLAM 那样根据运动自适应地选关键帧和分配计算。
前馈学习模型(DUSt3R、VGGT 及它们的长序列变体 VGGT-Long、LoGeR、LingBot-Map)[9, 10, 11, 12, 13]在稀疏视角、低重叠的场景很鲁棒,但精度低于基于几何优化的方法,而且上下文窗口有限,长视频只能分块再对齐,块间的增量漂移又回来了。另一条路线是直接在视频上用光流做 SfM:ParticleSfM 把稠密点轨迹接进全局 SfM,但对应只来自链式的相邻帧光流,没有回环;FlowMap 用梯度下降从光流恢复位姿、内参和深度,但只适用于短序列且没有几何验证[14, 15]。作者的立场很明确:学习模型用在它们擅长的地方(图像匹配、单目深度),精度和可扩展性仍交给显式几何优化。
论文把这些观察归结为一句话:SLAM 有时间意识但没有全局视野,SfM 有全局视野但没有时间意识。VidMap 要做的,就是在 SfM 的全局优化框架里把「时间」当成一等公民。
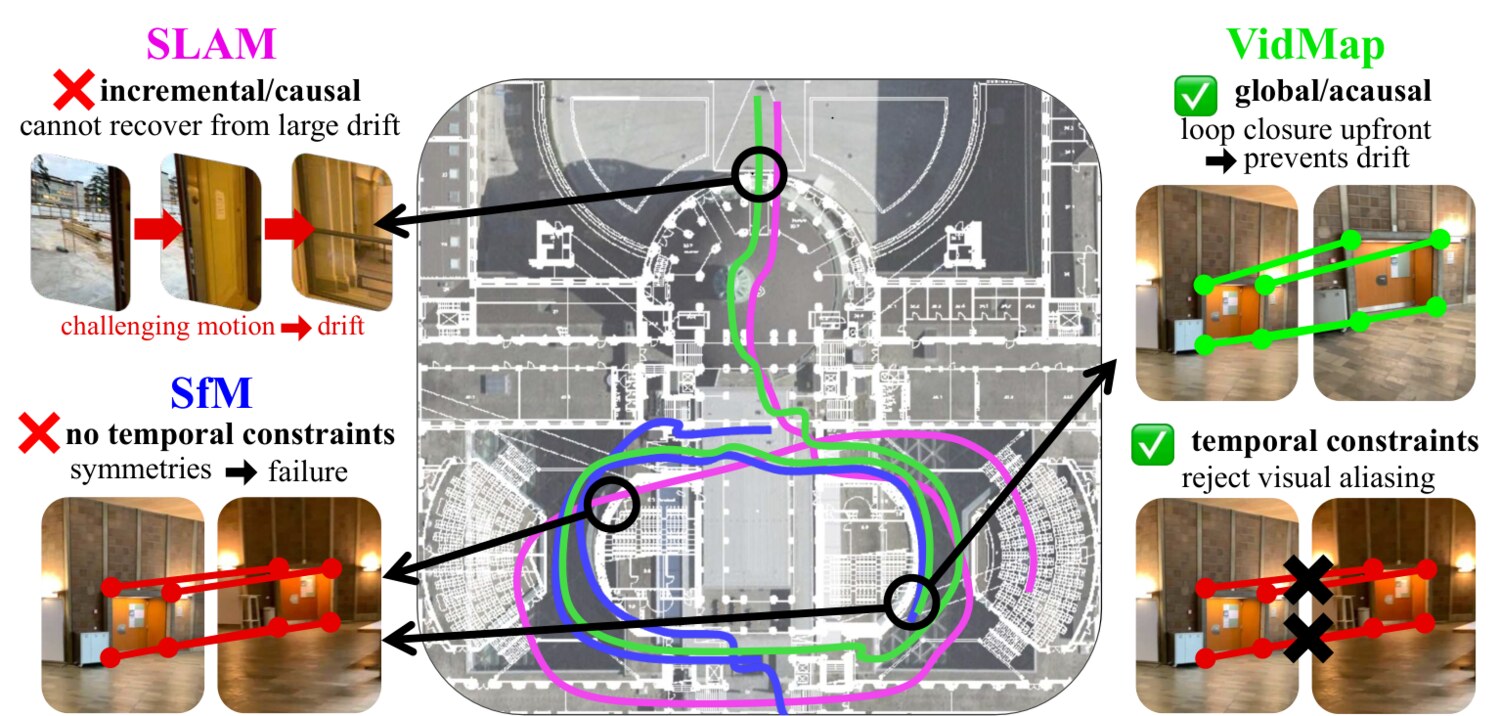 图 1:论文的 teaser。中间是同一段长视频的俯视轨迹:粉色 SLAM 在经过门洞这种挑战性运动后漂走且无法恢复,蓝色 SfM 被两扇长得一样的门(左下)骗出错误的回环,整条轨迹坍缩;绿色 VidMap 一方面提前做回环闭合防止漂移(右上),另一方面保留时间顺序、拒绝那两扇门之间的假回环(右下)。
二、核心方法
2.1 问题定义与总体架构
给定一段内参未知的视频 ,目标是为一组被选中的关键帧 估计位姿 、内参 ,以及一个稀疏点云 。
系统分两大块(图 2)。视频感知的提取(video-aware extraction)把 SLAM 里的顺序跟踪、关键帧选择、滑动窗口这些概念搬到离线的稠密匹配上:按时间顺序处理视频,选关键帧,用稠密匹配器沿时间链式传播稀疏轨迹并带上协方差,用图像检索找回环并和顺序观测分开存放,再为每个关键帧提取单目深度和焦距先验。注意这一步虽然沿时间走,但不是因果的:要做低分辨率匹配、关键帧检测、高分辨率精化、轨迹传播等多遍,而且在看完整段序列之前不做任何不可逆的决定。来源感知的建图(provenance-aware mapping)则在 GLOMAP 的全局 SfM 里加了两样东西:带逐图尺度的单目深度先验,以及按观测来源(顺序 / 回环)区别对待的鲁棒损失。
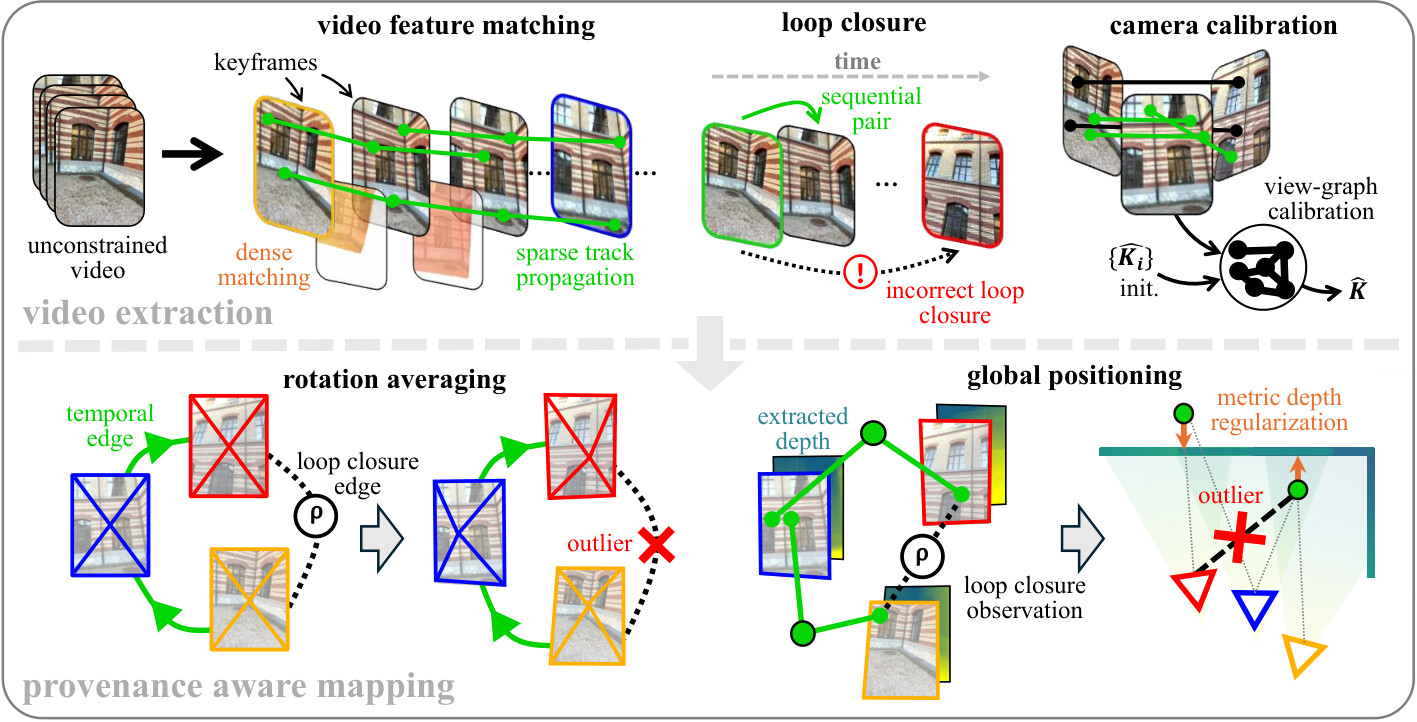 图 2:系统总览。上排从左到右:无约束视频 → 用光流选关键帧、用稠密匹配传播稀疏轨迹 → 检索提出回环(红框标出一个错误的回环)→ 视图图标定给出共享内参 。下排:旋转平均里顺序边(绿)和回环边(黑虚线)用不同的鲁棒损失 ,错误回环被当作外点剔除;全局定位里回环观测同样被区别对待,而度量深度先验(橙色箭头)把点拉回合理的深度。
接下来按模块逐个看。
2.2 视频特征匹配:把稠密匹配器当跟踪器用
为什么是稠密匹配器。 稀疏 SfM 依赖可重复的关键点检测器,在白墙、地板这类无纹理区域就没有点可用。稠密匹配器(这里用 RoMa v2)[16, 17]对任意位置都能给出对应点,还附带逐像素的匹配确定性 和定位协方差 。更关键的一个结构性事实是:相邻视频帧在局部是无歧义的,它们重叠大、外观接近,稠密匹配可以用整幅图的上下文消解让稀疏或无序匹配困惑的局部歧义。把这种逐对的保证沿时间链起来,就得到了对视觉混叠免疫的长轨迹,而这正是检索式回环最容易出错的地方。
跟踪。 给定 中的稀疏关键点 ,用稠密流场把它传播到 :,协方差为匹配器预测的 。在逐对误差独立的加性模型下,沿顺序链传播的轨迹协方差是累加的:
也就是说只走相邻帧的话,轨迹的定位不确定性随链长线性增长,这就是漂移的来源。
关键帧检测。 不是固定时间间隔,而是看图像位移:用低分辨率(560×560)的流场把上一个关键帧上采样的点一帧帧往后传,当足够比例的点移动超过阈值、或者因为遮挡丢失时插入新关键帧。附录给的默认值是位移阈值 (归一化坐标)、目标覆盖率 、匹配确定性阈值 。
多流漂移校正。 这是提取部分最有意思的设计(图 3)。对每个新关键帧 ,除了用 的顺序预测 ,还从前面一个窗口 (默认 ,步长 2,即每隔一个关键帧匹配一次)里的每个关键帧 直接匹配到 ,得到候选 ,其协方差是那条轨迹在 处的累积协方差加上这一跳的协方差:。选协方差迹最小的候选 ,但只有当它和顺序预测一致时才接受:
这个一致性检查是关键:非相邻帧之间的直接匹配更容易被视觉混叠骗,所以顺序预测始终是「仲裁者」,直接匹配只负责在两者一致时把不确定性拉下来。思路来自 MFT 这类长程光流跟踪器[18],但这里的候选打分用的是匹配器预测的协方差,而不是另训一个质量网络。
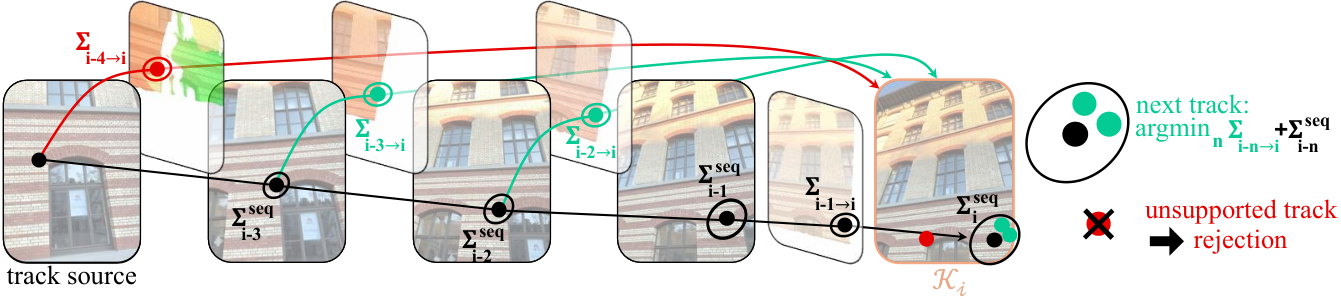 图 3:多流漂移校正。黑色是沿相邻关键帧链式传播的顺序预测,协方差 一路累加;绿色和红色是从窗口内更早的关键帧直接匹配到 的候选,各带「源头累积协方差 + 本跳协方差」。右侧:取迹最小的候选,若与顺序预测不一致(红叉)则拒绝、退回顺序预测。
下面这个玩具模型只看协方差的迹怎么随关键帧数增长:每一跳相邻匹配贡献单位方差,跨 个关键帧的直接匹配贡献 的方差(基线越长匹配越不准, 控制这个增速)。拖 看多流什么时候失效,拖 看窗口的边际收益。
轨迹过滤。 确定性低于阈值的轨迹终止;对窗口内每一对 估一个基础矩阵,去掉极线误差大的轨迹,这能抓住跨越深度边界的漂移和遮挡处「脑补」出来的对应;最后按空间密度做概率性稀疏(附录 E.1:核密度 ,保留概率 ),让观测在图像上分布均匀。每张图的轨迹预算 个点。
深度估计。 对每个关键帧用 Depth Anything 3[19]预测一张度量深度图,得到每个观测像素的深度先验 和不确定性 ,留给后面的全局定位和 BA 用。
所以呢。 附录 B 把 RoMa 换成光流 / 点跟踪器(RAFT、AllTracker、CoTracker3)[20, 21, 22],在 ETH3D-SLAM 上跨 5 个关键帧的 Recall@5px 从 RoMa + 多流的 74 掉到 RAFT 的 68、CoTracker3 的 58;只用 RoMa 链式传播、不做多流校正是 72。换成 ALIKED + LightGlue 的稀疏匹配[23, 24],LaMAR 上 100 m 窗口的中位误差从 0.33 m 变成约 3 m,因为无纹理段落根本没有可重复的关键点。详见 3.5 节。
2.3 回环闭合与来源标签
顺序跟踪给出的是可靠但短视的约束:它永远不知道相隔五分钟的两帧其实在同一个地方。回环闭合(loop closure,LC)补上这些长程约束,但代价是它可能出错。
检索与匹配。 这一步就是 hloc 式的「检索再匹配」[25]:用 MegaLoc[26]提取全局描述子,每个关键帧检索相似度超过阈值的前 个候选,排除掉已经被顺序重叠覆盖的图像对。候选对用稠密匹配器在已有的关键点位置上匹配(最长边 800 像素),再做几何验证。
轨迹建立。 这是和 GLOMAP 最根本的分歧(图 4)。标准全局 SfM 通过传递性把所有对应合并成轨迹,顺序观测和回环观测合并之后就再也分不开了:一个错误的回环会把两条本来互不相干的顺序链焊成一条不可分割的轨迹,后面的优化只能在「全信」和「全丢」之间选。VidMap 的轨迹只由顺序边构建;当一个回环匹配落到已经属于某条顺序轨迹的关键点上,不做传递性合并,而是作为一个额外的观测挂上去,带来源标签 ,顺序观测则是 。两条顺序链保持独立,回环只是它们之间的一条「软链接」。
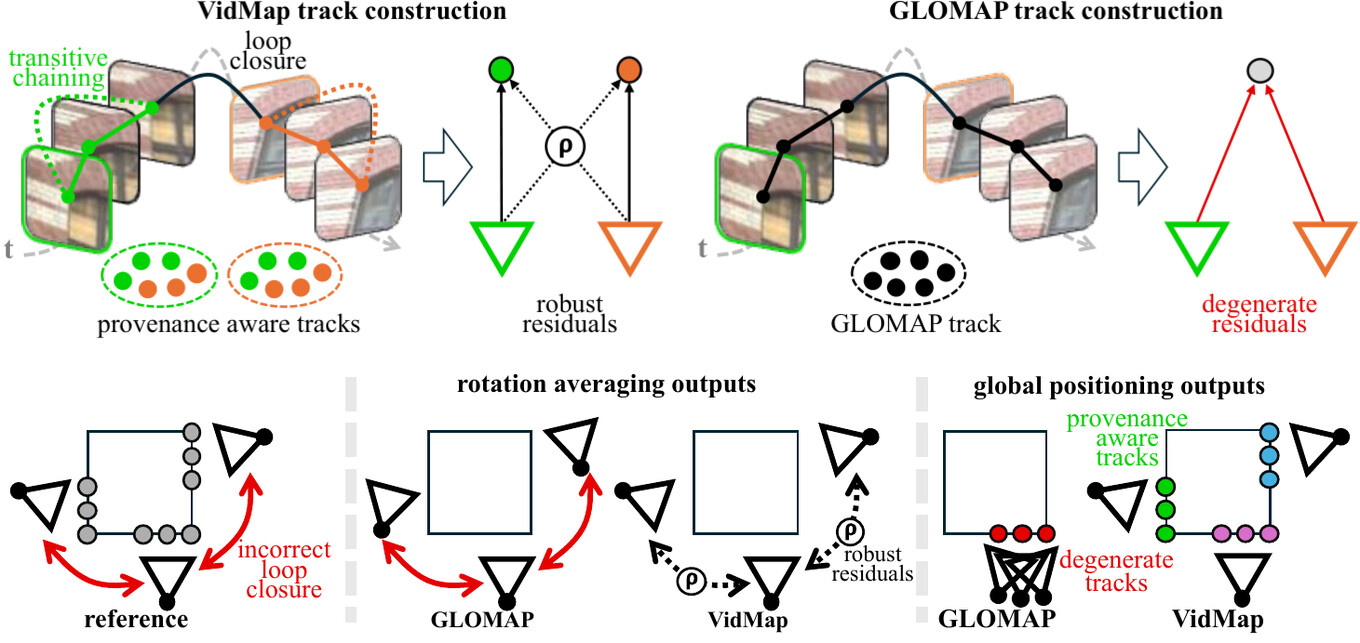 图 4、图 5:来源感知的轨迹建立与优化。上排左:VidMap 的两条顺序轨迹(绿、橙)通过回环软链接,残差上套鲁棒损失 ,回环错了也只是一个被压低权重的观测;上排右:GLOMAP 把它们合并成一条轨迹,回环错了就是退化的残差,几何上无解。下排:一个正方形轨迹加一条错误回环(红色双向箭头)。旋转平均里 GLOMAP 把两段轨迹拧到一起,VidMap 用 把回环边压成外点;全局定位里 GLOMAP 生成了退化的轨迹(红点),VidMap 的来源感知轨迹保持分离(绿、蓝、紫)。
所以呢。 这个设计的全部价值在 2.5 节的来源相关损失里兑现:消融「无来源损失」(所有边一视同仁)在 LaMAR 上全程 W-AUC 从 88.5 掉到 79.9,100 m 窗口从 89.3 掉到 77.0;而「无回环边」在 LaMAR 上只掉到 85.5,在 ETH3D-SLAM 上 5 cm 阈值却从 51.4 掉到 32.9。两个数字放在一起看:回环在 LaMAR 这种长视频上不是精度的主要来源(顺序轨迹 + 深度先验已经很稳),但一旦引入回环又不区分来源,视觉混叠带来的伤害大于回环的收益。
2.4 未标定视频:焦距的两步估计
内参未知时,VidMap 在全局建图之前分两步估焦距。先用 GeoCalib[27]对每个关键帧独立预测透视场并用 LM 优化出焦距,再选置信度最高的 个关键帧,加上「共享内参」约束重新优化出一个焦距。然后用视图图标定(view-graph calibration)[28]精化:从基线大、三角化角度好的图像对的基础矩阵里解焦距;如果良态的图像对不够多,就退回 GeoCalib 的估计。精化后的内参作为 BA 的初值,BA 里再和位姿、结构一起优化。
这一步做得多好可以从表 1 直接读出来:LaMAR 上 VidMap 无标定的全程 W-AUC 是 88.5,用真值标定是 89.7,只差 1.2;而 ETH3D-SLAM 上无标定 5 cm 阈值 51.4、有标定 69.4,差了 18 个点。作者的解读是:运动越简单、精度越容易做高的序列,标定就越成为瓶颈。
2.5 全局建图:来源相关的鲁棒损失
VidMap 建在 GLOMAP 之上,沿用它的四个阶段:视图图构建、旋转平均、全局定位(global positioning,GP)、BA。两处新机制中,第一处是来源相关的鲁棒损失。
旋转平均。 对每对关键帧用深度和对应点估计相对旋转 (用 RePoseD 的深度正则化相对位姿求解器[29],它能处理平面、纯旋转、前向运动这些五点法会失效的构型),再最小化所有边上的测地距离 得到全局朝向 。顺序边用 Huber 损失,它对大残差仍保持线性增长,意思是「我相信这些边,残差大也只是略微降权」;回环边用 Cauchy 损失,残差一大就几乎不再贡献梯度,错误的回环会被自动压成外点。
下面的部件画出三种损失和它们的影响函数权重 ,拖动残差 看同样大小的误差在顺序边和回环边上分别「值多少」。
所以呢。 「无来源损失」是表 4 里 LaMAR 上第二大的退化(全程 88.5 → 79.9),作者的措辞是 catastrophic failure;图 8 左给出了一个样例,不区分来源的版本把一个走廊环路的两侧对称结构拧到了一起。
2.6 带深度先验的全局定位
第二处新机制是在 GP 里加入带逐图尺度的度量深度先验。GLOMAP 的 GP 固定旋转,从方位(bearing)约束里联合求相机中心 和三维点 。VidMap 在此基础上为每张图加一个尺度因子 ,把单目深度 缩放到重建的尺度上,目标函数是
三项分别是:
- 方位残差 :观测射线 (已旋转到全局坐标系)与相机中心指向三维点的方向之差, 是归一化因子。这是 GLOMAP 原有的项。协方差 由轨迹提取给出的二维像素协方差 经相机内参和旋转传播到三维方位空间(附录 E.1 给了完整推导:这个协方差秩为 2,零空间沿射线方向,GP 里用对角近似)。
- 深度残差:点在相机坐标系下的深度 应与缩放后的先验 一致。前方的点用对数残差 ,跑到相机后方的点退回线性 ,这样残差处处有定义。
- 尺度正则 :把 往 1 拉,也就是把重建往度量尺度上拉,不确定性 控制拉多紧。
鲁棒损失 同样按来源选择。这个设计里有两个容易被略过、但消融证明极其关键的选择:
- 为什么要逐图尺度 。 单目度量深度模型的尺度误差在不同图像上不一样,如果直接用 (消融「无尺度优化」),模型的系统性偏差会被当成几何信号,优化器去迁就深度,几何就被拉坏:LaMAR 全程 W-AUC 从 88.5 掉到 39.7,和完全不用深度(37.7)一样糟。
- 为什么还要把 往 1 拉。 如果 完全自由(消融「无度量尺度」,去掉正则项),深度就只剩下相对形状信息,长程的尺度漂移压不住:LaMAR 100 m 窗口从 89.3 掉到 71.7,全程从 88.5 掉到 74.1。但在短序列 ETH3D-SLAM 上这个消融反而略好(5 cm 阈值 52.2 对 51.4),说明度量先验是用来管长程的。
下面这个玩具模型只演示第一点。生成 200 个真实深度 m 的点,单目预测 带一个系统性尺度偏差 和对数域噪声 。「不优化尺度」就是固定 ;「优化尺度」是带正则的闭式解 。看残差直方图。
2.7 BA 与渐进式鲁棒优化
BA 同时精化位姿、三维点、内参和逐图尺度 (MP-SfM 在增量重建后固定尺度,这里不固定[30]):
其中 是像素域的重投影误差,用轨迹提取给出的 加权。注意到了 BA 阶段不再按来源区分损失:作者的理由是此时重建已接近正确解,几何验证已经过滤掉不一致的回环观测,统一的鲁棒损失即可。「无 BA 深度」的消融在 LaMAR 上只掉 3 个点(88.5 → 85.5),但在 ETH3D-SLAM 的 5 cm 阈值上掉了 7 个点(51.4 → 44.5),说明 BA 里的深度项主要服务于高精度。
渐进式非凸优化。 受 GNC(graduated non-convexity)[31]启发,GP 和 BA 都分多轮,逐步收紧鲁棒损失。附录 E.4 解释了为什么一开始不能就用鲁棒损失:GP 从随机初始化出发,位姿是乱的、三维点可能在相机后方,这时大残差是常态,鲁棒损失会把这些本来有效的观测当外点压掉,退化段落(没有匹配梯度、只能靠几何先验)就得不到任何梯度。所以早期 GP 先用逐对深度一致性检查标出深度与匹配不一致的观测,其余全部用 L2,让所有观测都贡献梯度;几何收敛后再换成鲁棒损失压真外点。BA 也一样(附录 E.5):第一轮用宽松的重投影阈值和松的鲁棒损失,第二轮收紧,否则严格阈值下 ETH3D-SLAM 的 AUC@5cm 从 67.5 掉到 59.3,EuRoC 从 22.2 掉到 12.2(表 8,这组数字的协议和主表不完全一样,但趋势清楚)。此外沿用 MP-SfM 的做法,深度残差的 Cauchy 尺度随几何稳定而退火;把单目深度通过相对位姿投到另一张图上,深度比超过阈值的观测切到 Cauchy 损失。
深度正则化的相对位姿(MDRP)。 每对关键帧的相对位姿用 PoseLib 的 estimate_monodepth_pose,从对应点和单目深度联合解旋转、平移和度量尺度。它的作用是处理五点法失效的退化构型,但附录 E.3 坦言在整个为鲁棒性设计的流程里它的边际收益很小:LaMAR-HGE 上 50 m 窗口的中位误差 0.14 m 对 0.17 m,全程 0.43 对 0.45。
三、实验结果
3.1 数据集与指标
四个数据集,所有超参数在单独的验证序列上调好后对全部数据集固定不变:
| 数据集 | 内容 | 真值 | 评测序列 |
|---|---|---|---|
| LaMAR[32] | 苏黎世三个大场景(CAB、HGE、LIN)的 iPhone / iPad 视频,1920×1440,长轨迹、复杂运动、视觉混叠、无纹理、退化视角 | LiDAR 对齐,厘米级,但只覆盖稀疏的关键帧 | 50 |
| CroCoDL[33] | 4 个灾难现场建筑,手机(62 段)和四足机器人(26 段),非结构化环境 | LiDAR 对齐,约 10 cm | 88 |
| ETH3D-SLAM[34] | 手持全局快门相机的室内外短序列,约 740×460 | 动作捕捉 | 55(61 段里去掉 6 段近乎全黑的) |
| EuRoC[35] | 无人机灰度双目鱼眼,752×480,快速六自由度运动、运动模糊;只用左目 | Vicon + Leica | 11 |
前两个是新的评测方式:以往的 SLAM / SfM 论文基本没在这么长、这么业余的手机视频上评测过。两个数据集的用法也不同:CroCoDL 是灾难现场,Depth Anything 3 这类模型的训练分布里没有,专门用来看泛化。
指标。 ETH3D-SLAM 和 EuRoC 序列短,用全局 Sim(3) 对齐后平移误差的 AUC(阈值 5 cm、10 cm、50 cm、1 m、10 m)。LaMAR 和 CroCoDL 序列长,全局对齐会被长程漂移主导、掩盖局部精度,所以作者用窗口化的 AUC(W-AUC):对每一帧,以它为中心取一个 米长的窗口,在窗口内做局部 Sim(3) 对齐,记录中心帧的平移误差,再对这些逐帧误差算 AUC,阈值取窗口长度的 5%; m 和全程。读表的时候要记住:10 m 列衡量局部精度,全程列衡量全局一致性,一个方法可以局部很准却全局漂得很远。
下面这个玩具模型用一条带漂移的二维轨迹演示 W-AUC 怎么随窗口变化。每帧走 1 m,估计轨迹带线性增长的航向偏差和尺度偏差。
3.2 基线
三类共 13 个基线,都用官方实现。SLAM / 视觉里程计:DPV-SLAM(学习的 patch 跟踪)、MegaSaM 和 ViPE(学习光流 + 现成单目深度 + 标定先验)[36, 37]、DROID-W(DROID-SLAM 加动态物体掩膜)[38]、MASt3R-SLAM(稠密点图的两视图预测)[39]。端到端模型:DA3-Long(用 Depth Anything 3 重建重叠子序列再按 VGGT-Long 的方式对齐)、LoGeR、LingBot-Map、VGGT-SLAM2[40]。全局 SfM:GLOMAP 配 SuperPoint + LightGlue 或 SuperPoint + RoMa v2[41],顺序窗口匹配加 MegaLoc 检索的回环;有标定设置下还比 MP-SfM。SLAM 方法在有标定设置下拿到的是逐帧的真值内参。作者对一些基线做了有利于它们的调整,比如 MASt3R-SLAM 的关键帧选择在跟踪失败时会追溯注册上一帧、并在 LaMAR 的真值时间戳上强制注册帧,COLMAP 用 MP-SfM 里对低三角化角度更宽容的配置。
3.3 结果
四个数据集、两种标定设置、十多个方法,表格很大。下面的部件把表 1、2、3 和表 4 的消融放在一起,选基准和阈值看条形图;VidMap 用主题色,其余方法按分数排序。
把四个数据集放在一起看,论文的叙事很清楚:
- 长而乱的视频(LaMAR、CroCoDL)是 VidMap 的主场,所有列领先 5 到 25 个点。GLOMAP 和 DPV-SLAM 这些只靠多视图几何的方法漂移比 VidMap 大一个数量级;ViPE、MegaSaM 带了度量深度先验,漂移有限但精度不够。有真值标定和自标定的结果几乎一样,说明自标定不是瓶颈。
- 短而规整的视频(ETH3D-SLAM、EuRoC)上几何先验基本只是加噪声,DPV-SLAM 是最强基线,VidMap 在有标定设置下仍在 ETH3D 上领先,在 EuRoC 上持平。无标定设置下差距又拉大,因为基线们要么不能自标定、要么标定得不好。
- CroCoDL 上 DA3-Long 明显退化,因为它的深度模型没见过灾难现场;VidMap 的几何优化对这种分布外数据更稳。
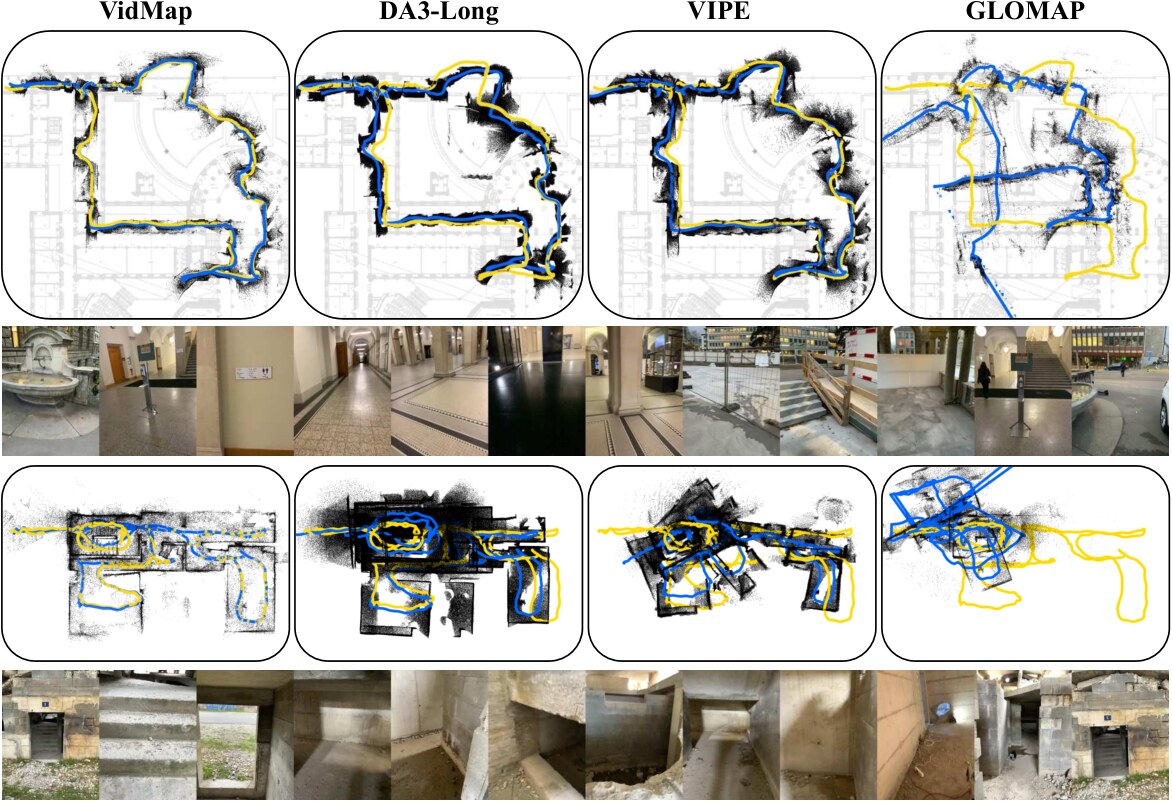 图 6:定性对比。上:LaMAR 一个场景,VidMap 的蓝色估计轨迹紧贴黄色真值,DA3-Long 和 ViPE 在转角处逐渐漂开,GLOMAP 则整体错位。下:CroCoDL 一个灾难现场,DA3-Long 和 ViPE 的轨迹明显拧曲,GLOMAP 几乎失败。输入帧里有大量无纹理墙面、昏暗走廊和废墟。
3.4 消融
消融已经在上面的部件里(选最后两个视图),这里只补论文的解读和图 8 的可视化:
- 深度先验 是长程精度的决定因素。GP 阶段去掉深度,LaMAR 的 100 m 窗口从 89.3 掉到 13.6;BA 阶段去掉深度影响小得多。两种处理尺度的方式各有分工:不优化逐图尺度和没有深度一样糟,不加度量正则则长程漂移。作者的总结是「把度量单目深度当作软先验,而不是硬约束」。
- 时间结构 中,回环边在短序列上最重要(ETH3D 5 cm 阈值 51.4 → 32.9),来源相关损失在长序列上最重要(LaMAR 全程 88.5 → 79.9)。
- ETH3D 上的深度消融影响小,因为序列短、运动约束好,多视图几何本身够用。
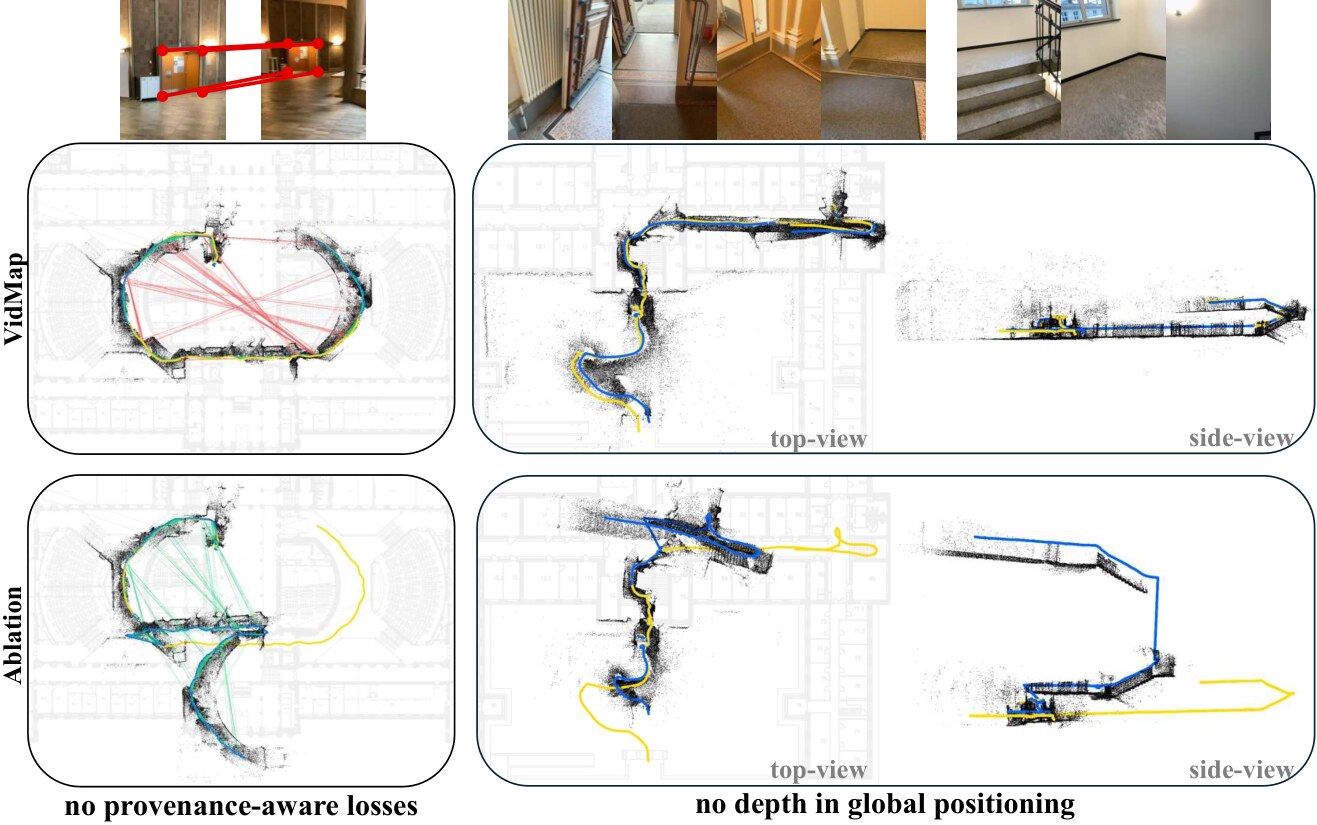 图 8:视觉消融。左:LaMAR CAB 的环形走廊,上方两幅图是会被检索成回环的两扇对称的门。VidMap(上)把这些回环边标成外点(红线)并保持轨迹闭合;去掉来源感知损失(下)后,这些错误回环被当成普通边接受(绿线),整个环被拧成两段。右:一段穿过门洞、下楼梯的序列。VidMap(上)的俯视和侧视都贴合黄色真值;GP 里去掉深度先验(下)后,退化运动段的几何被破坏,轨迹断成几截并在侧视图里向上漂。
3.5 跟踪器对比
附录 B 回答了一个很自然的问题:为什么要用 RoMa 这种稠密匹配器做跟踪,而不用专门的光流或点跟踪器?作者把轨迹传播的骨干分别换成 RAFT、AllTracker、CoTracker3,其余(关键帧选择、回环、深度、全局建图)保持不变,用真值位姿评测跨关键帧传播后的极线误差。
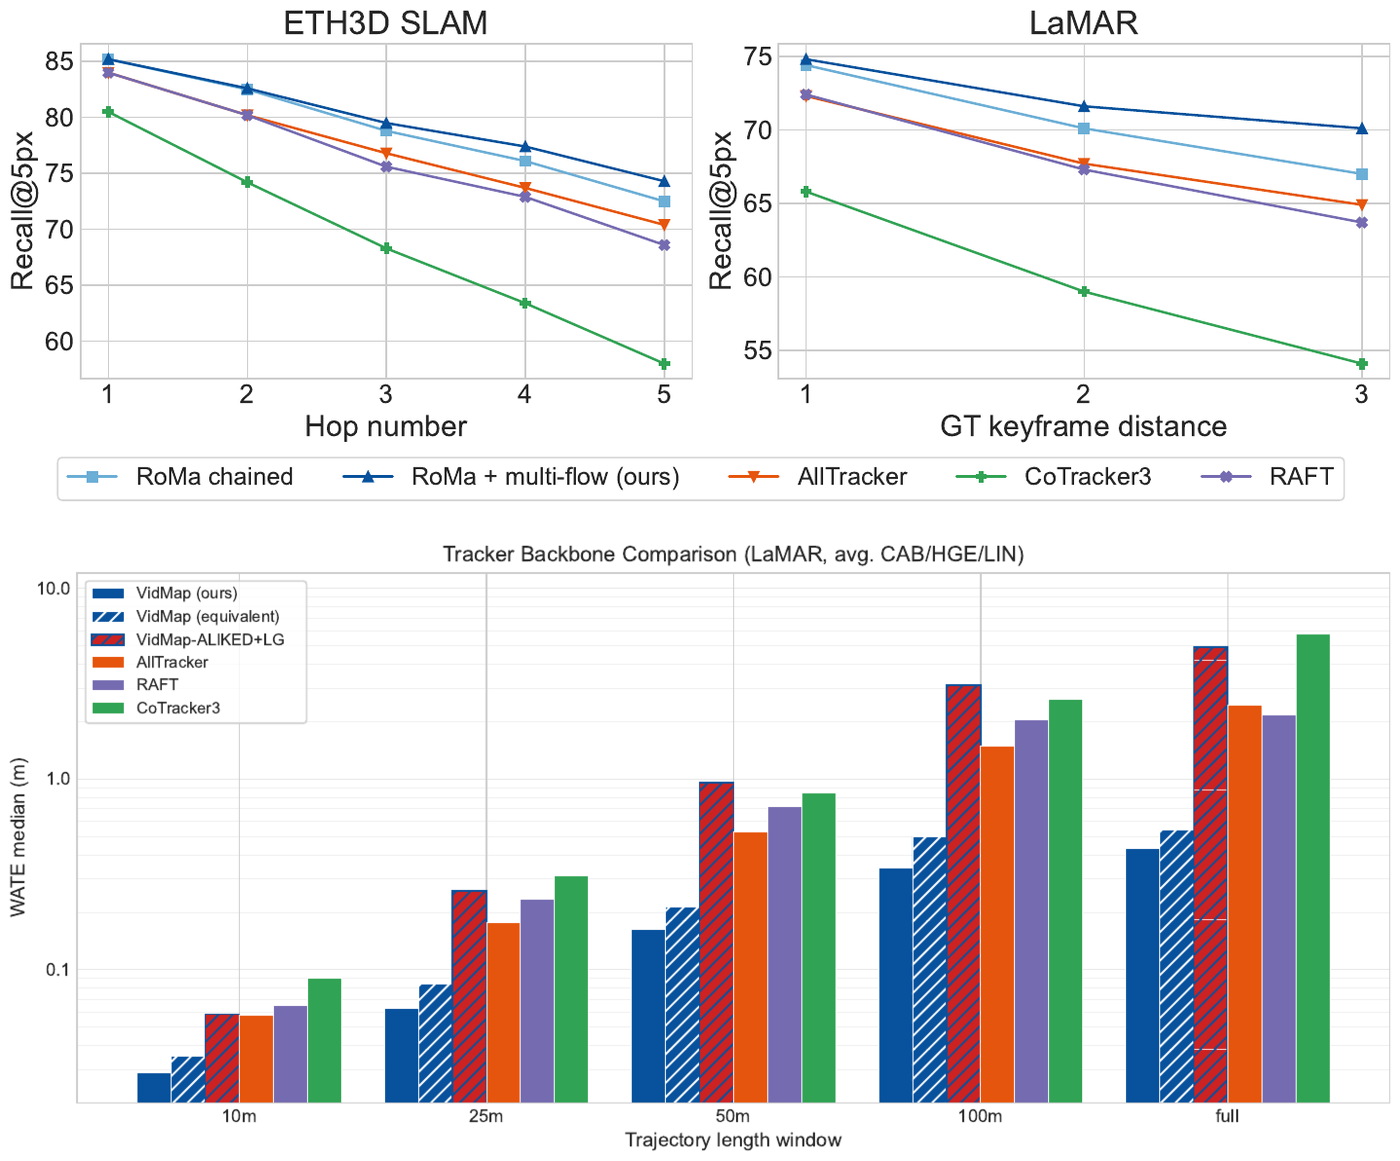 图 16、图 18:跟踪器骨干对比。上排:Recall@5px 随关键帧跳数(ETH3D-SLAM,左)和真值关键帧距离(LaMAR,右)的变化。RoMa 单纯链式传播就已经高于所有光流 / 点跟踪器,加上多流校正后差距进一步拉大,而且跳数越多拉得越开。下排:LaMAR 上各窗口长度的中位窗口平移误差(对数坐标)。VidMap 在所有尺度都最低;换成 ALIKED + LightGlue 的稀疏匹配(红色斜纹)在 100 m 以上的窗口误差高出一个数量级。
两个发现值得记下。其一,RoMa 的优势在于它对每一对图像从零建立对应,而光流方法只能在局部传播匹配,碰到头戴设备甩头这种大视角变化就跟不上了;CoTracker3 在合成数据上为动态物体训练,对刚性三维结构反而不准。其二,ALIKED + LightGlue 的稀疏变体失败的方式是互补的:它不漂,但在无纹理区域根本检不出可重复的关键点,覆盖率崩了。所以作者说完整流程是「全局匹配的鲁棒性 + 稠密跟踪的覆盖率」。
3.6 运行时间与内存
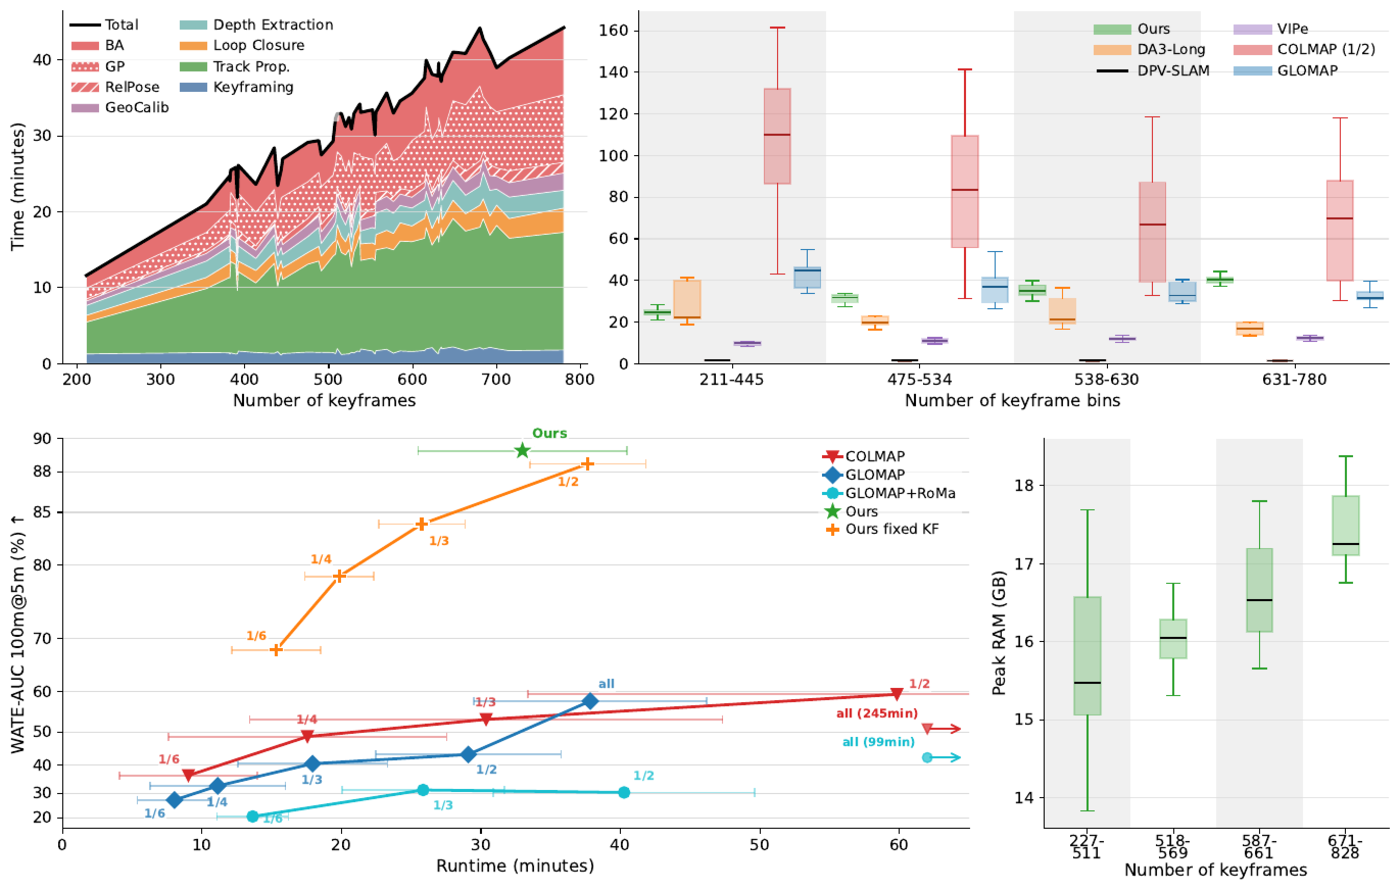 图 7:运行时间。左上:各组件耗时随关键帧数线性增长,800 个关键帧约 45 分钟,其中轨迹传播(绿)约 15 分钟是最大头,GP(红点纹)和 BA(红)次之。右上:按关键帧数分箱的总耗时,VidMap(绿)和 GLOMAP(蓝)相当、是 COLMAP(红,注意图例标的是其一半时间)的三分之一到五分之一;ViPE 和 DPV-SLAM 快得多但精度低。左下:关键帧策略的速度 / 精度权衡。橙色是固定抽帧(1/6 到 1/2),绿星是运动感知的关键帧选择,它用 1/3 抽帧的时间达到了 1/2 抽帧以上的精度;COLMAP 和 GLOMAP 无论怎么抽帧都在 60 以下。右下:峰值内存 15 到 18 GB。
VidMap 是离线系统,不追求实时,但时间随关键帧数线性增长,内存保持在 16 GB 上下,和 GLOMAP 处于同一量级,远快于 COLMAP。README 还给了几个加速开关的实测代价(LaMAR 一段序列):
| 设置 | 影响阶段 | 省时 | 精度损失 |
|---|---|---|---|
多流跳数 [1,2,4,8](默认是窗口 9、步长 2) | 提取 | 约 9.9% | 约 0 |
多流跳数 [1,2,4] | 提取 | 约 15.3% | 0.39% |
多流跳数 [1,2] | 提取 | 约 21.3% | 1.56% |
| 只用粗分辨率做关键帧选择 | 提取 | 约 9.0% | 0.05% |
| 1000 个点(默认 1200) | 建图 | 约 40% | 0.63% |
| 500 个点 | 建图 | 约 66% | 2.07% |
把多流跳数改成对数间隔 [1,2,4,8] 几乎免费,这和 MFT 用对数间隔的直觉一致。另外 GP 和 BA 都可以用 CUDA 求解器(需要 Ceres 2.3 以上加 cuDSS),README 说在一段 LaMAR 序列上总建图时间减少约 13%。
3.7 定性结果
附录 A 把无约束视频的挑战分成五类,并各给了图。退化几何:纯旋转让三角化无解;无纹理区域:稀疏匹配没有覆盖;局部对称:相邻帧的顺序匹配不会混淆,但检索会;全局对称:建筑级别的相似结构产生假回环;轨迹规模:越长越叠加。
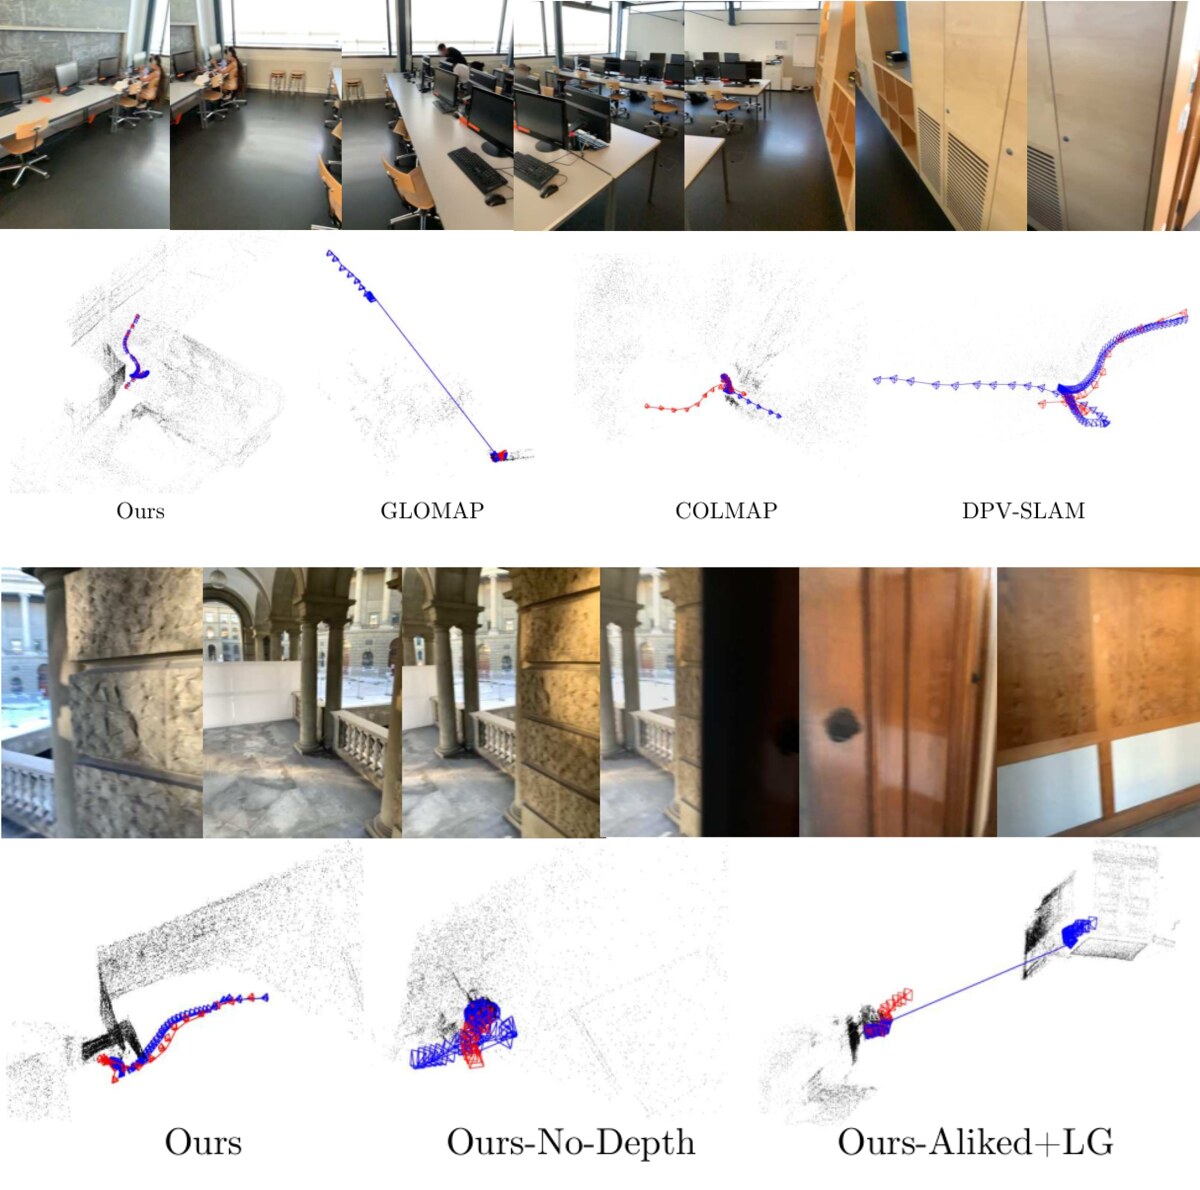 图 9、图 11:退化运动。上:一段以纯旋转为主的办公室视频。VidMap(Ours)恢复出房间的几何;GLOMAP 碎成两块,COLMAP 只注册了很少的相机,DPV-SLAM 一路漂走。下:相机穿过一扇门进入走廊,纯旋转叠加很短的轨迹。VidMap 恢复了轨迹;去掉深度先验(中)在退化段丢失跟踪、尺度坍缩;换成 ALIKED + LightGlue(右)得到两个互不相连的重建。作者的结论是两个组件缺一不可:几何先验补不了缺失的轨迹,稠密匹配解不了退化的几何。
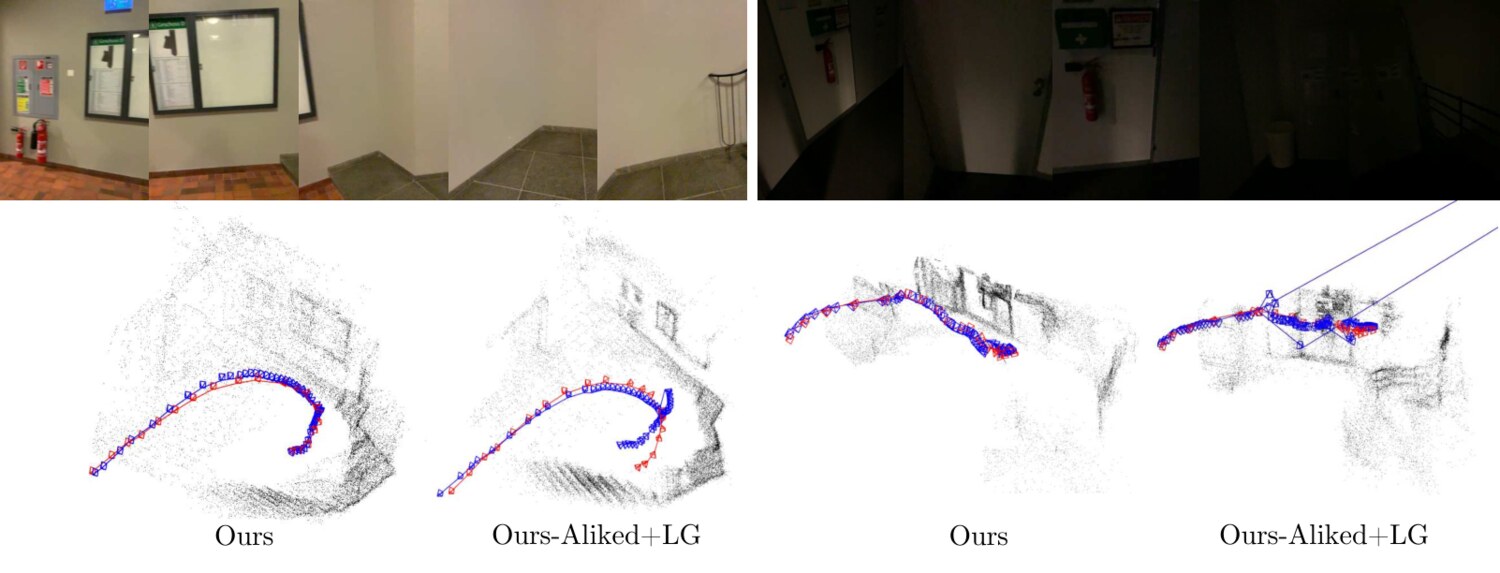 图 10:穿过无纹理区域。左:相机掠过一面白墙,只靠显著关键点(ALIKED + LightGlue)的变体在这一段欠约束,轨迹末端弯折;稠密匹配的轨迹传播在整段都保持了对应。右:一个昏暗、几乎没有特征的房间,稀疏变体建不出足够的匹配,VidMap 虽然丢了几帧,但靠回环闭合把重建接了回来。
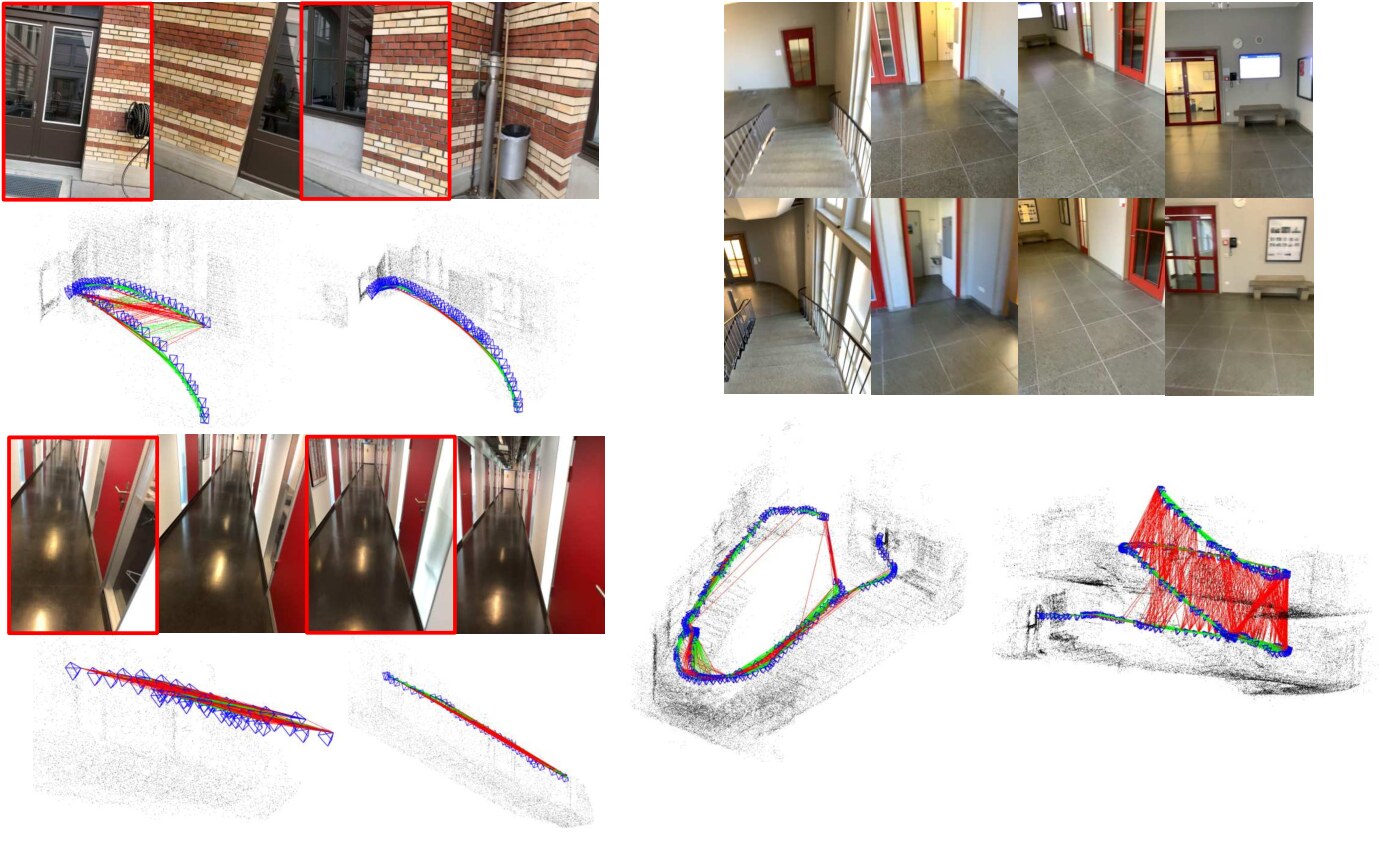 图 12:局部对称。三段序列各展示几帧样例(红框是会被互相混淆的帧)和标准 SfM(左)与 VidMap(右)的重建;视图图里红色的边是错误的回环。标准 SfM 把所有对应一视同仁地传递合并,错误回环直接把相机排成一条直线或叠在一起;VidMap 的顺序轨迹加来源相关损失把这些假回环的权重压掉,几何保持正确。
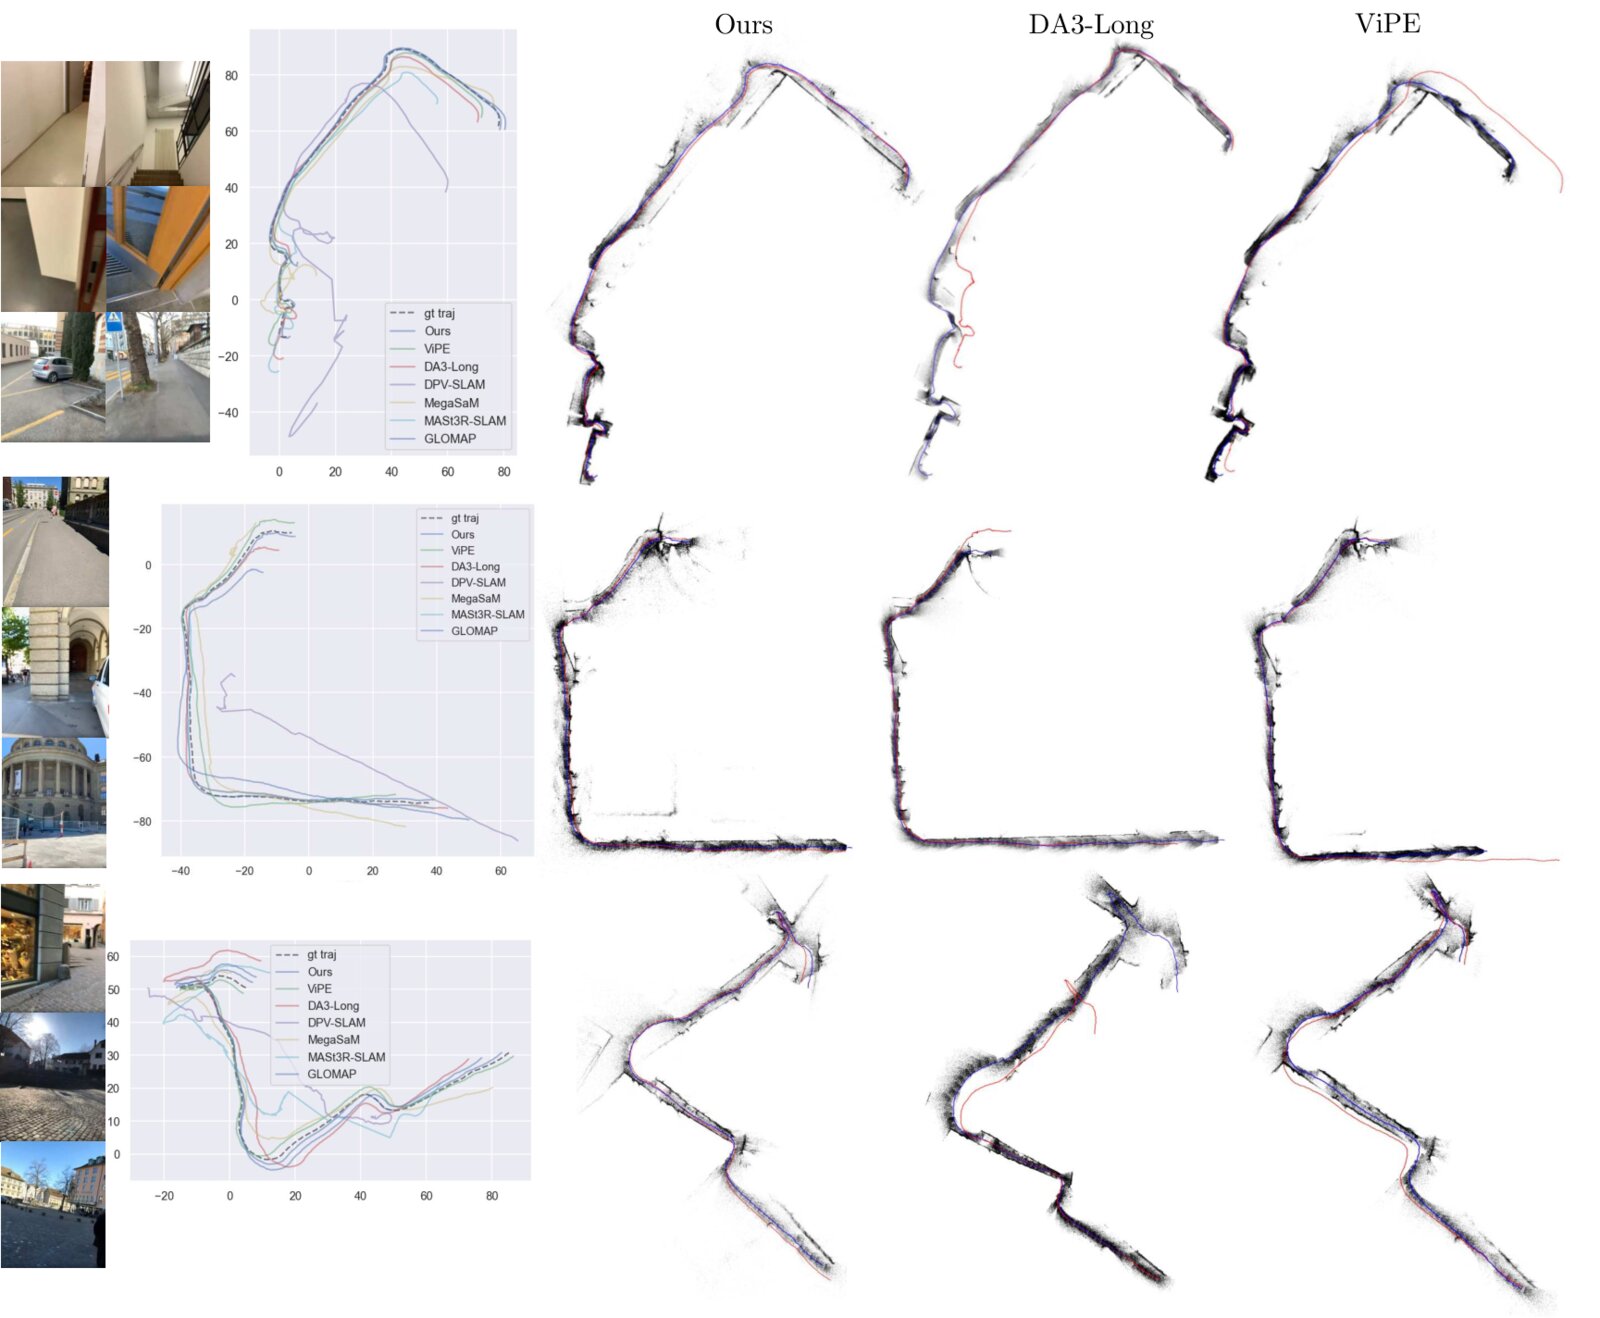 图 14:LaMAR 的三个场景。每行左侧是样例帧和所有方法的俯视轨迹(真值为虚线),右侧是 VidMap、DA3-Long、ViPE 的重建叠加真值(红)和估计(蓝)轨迹。VidMap 在三个场景上都保持了一致的尺度和拓扑;DA3-Long 和 ViPE 的误差随轨迹长度累积,在第一行末端和第三行中段都能看到蓝色轨迹离开红色轨迹。
四、局限性
附录 A.1 列出了五条作者自己承认的局限:
- 前向运动的关键帧选择。 前向运动时很多轨迹留在极点附近、图像位移很小,关键帧判据会选出太少的帧,恰恰是这种需要额外几何支撑的时候全局定位欠约束。
- 弱几何与视觉混叠的相互作用。 接近前向的运动加上很少的离极点轨迹,平移和深度的约束本来就弱;如果此时视觉混叠又提出一批互相一致的假回环,它们的总影响可以压过顺序约束。Cauchy 损失只是降低每条边的权重,并不消除它的梯度,全局定位可能收敛到错误解。
- 跟踪失败。 严重模糊、遮挡、剧烈视角变化或低纹理都会终止轨迹,而全局优化无法凭空恢复缺失的对应,大规模丢轨迹会导致漂移甚至重建失败。
- 长程漂移。 没有可靠回环时,很长的序列上小的局部误差仍会累积,即便做了全局优化。CroCoDL 机器人序列上 VidMap 从 10 m 窗口的 91 掉到全程的 80 就是例子。
- 对学习先验的依赖。 单目深度和标定先验在分布外的图像或相机上可能不可靠,EuRoC 的灰度鱼眼就是一个明显的案例:无标定的 AUC@10cm 只有 31.6,有标定是 54.6。
我自己再补几条:
- 「视频」是硬假设。 整个提取流程依赖相邻帧局部无歧义、重叠大。帧率低的延时视频、剪辑过的视频、多段拼接的视频都破坏这个假设,这时它就退化成一个带深度先验的 GLOMAP。README 的支持矩阵也印证了这一点:多相机 rig 必须标定好才支持,无标定的 rig 不支持。
- 静态场景假设。 论文没有处理动态物体。DROID-W 和 MegaSaM 都有运动掩膜,而 VidMap 的稠密匹配加极线过滤只能被动地丢掉一部分动态轨迹。在行人很多的场景效果如何,论文没有评测。
- 计算成本。 800 个关键帧约 45 分钟、16 GB 内存、首次运行要下载 9 GB 权重,这是一个研究级的离线工具,不是能跑在设备上的东西。精度和 ViPE 这种 3 到 5 FPS 的系统之间差的是 10 倍以上的时间。
- GP 阶段的 L2 预热是整个流程里最脆弱的环节之一。它假设深度一致性检查已经把最坏的外点标出来了,否则 L2 阶段会被错误观测带偏。论文没有给这一步的失败案例。
- 数据集细节有一处不一致:正文说 CroCoDL 有 26 段机器人序列、共 88 段,附录 C 却写 14 段四足机器人序列,README 的复现表又只报 64 段。不影响结论,但复现时要留意用哪个子集。
- 深度模型的选择没有消融。 只用了 Depth Anything 3,没有比较 UniDepth、Depth Pro 等其他度量深度模型[42]。考虑到「无 GP 深度」是最灾难的消融,深度模型的质量应该是整个系统的敏感参数。
五、结论与展望
把这篇论文压缩成一句话:把时间当成一等公民放进全局 SfM。 具体落成三件事:用稠密匹配器沿时间链式传播轨迹并用多流匹配压住漂移;把回环作为带标签的独立观测,让旋转平均和全局定位可以对它们另眼相看;把度量单目深度连同逐图尺度作为软先验塞进全局定位和 BA,专治多视图几何本身无解的退化。这三件事在消融里都有自己的那一行数字,而且分工清楚:深度管退化和长程尺度,来源标签管视觉混叠,回环管短序列的精度。
从方法论上看,这篇论文和同一团队的 MP-SfM 一脉相承:学习模型只做它们擅长的(匹配、深度、标定),精度和可扩展性交给显式几何优化。论文在相关工作里对前馈模型的评价很直接,「核心权衡是结构性的:学习模型以几何精度、可扩展性和零样本泛化为代价换取鲁棒性和速度」。表 3 的 5 cm 列确实支持这个判断,但前馈模型迭代得非常快,这篇论文比较的 LoGeR、LingBot-Map 都是 2026 年春天的工作,而 VGGT-SLAM 2.0 的代码甚至还没放出来,一年后这个对比怎么样很难说。
给实践者的几条建议:
- 手里是长的手机 / 机器人视频、内参未知、场景有重复结构,VidMap 是目前最值得先试的离线方案;它的无标定结果和有真值标定几乎一样,不用先去标相机。
- 手里是短的、运动良态的、已标定的序列,DPV-SLAM 或 DROID-W 更快而且精度相当,没必要上 VidMap。
- 跑的时候优先打开多流跳数
[1,2,4,8]和粗分辨率关键帧选择,这两个几乎免费;要再快就降点数,1000 个点损失不到 1%。 - 如果你在做自己的 SfM / SLAM 系统,「来源标签 + 来源相关损失」这个想法成本极低,和具体的匹配器、优化器都无关,值得直接抄。
作者在结论里说的未来方向是追上视觉惯性系统的精度,以及在更长的序列上压住长程漂移。我自己更期待的是两点:一是动态场景,二是把这套提取流程和前馈模型结合,让前馈模型给初值、几何优化做精化,这也许是「学习 vs 优化」之争最可能的落点。
六、上手
仓库是 cvg/vidmap,Apache-2.0。前端在 Linux x86-64、Python 3.10、PyTorch 2.14、xFormers 0.0.35 和 NVIDIA GPU 上测试过;需要从源码编译 COLMAP 和 PyCOLMAP(README 标注了最后测试的 COLMAP 提交),要用 GPU 求解器则需 Ceres 2.3 以上加 CUDA 和 cuDSS。
git clone --recursive https://github.com/cvg/vidmap.git && cd vidmap
# 先按 README 从源码装 COLMAP / PyCOLMAP,再装 PyTorch、xFormers
pip install -e .
pip install rerun-sdk   # 可选,可视化
最小示例,两步分别对应论文的「视频提取」和「全局建图」,也可以一条命令跑完:
INPUT_DATA=./assets/example_video.mp4
OUTPUT_DIR=./example_output/

python -m vidmap.frontend "$INPUT_DATA" --output "$OUTPUT_DIR"
python -m vidmap.map --mapper-inputs "$OUTPUT_DIR/mapper_inputs" --output "$OUTPUT_DIR"

# 或者
python -m vidmap.run --input_data "$INPUT_DATA" --output "$OUTPUT_DIR"
--input_data 也可以是一个已抽帧的目录。最终的 COLMAP 模型写在 $OUTPUT_DIR/rec,实际生效的 frontend_config.yaml 和 mapping_config.yaml 也会写到输出目录。首次运行会下载约 9 GB 的模型权重并缓存约 1.2 GB 的编译模型。
配置用 Hydra / OmegaConf,几个和论文概念对应的旋钮:
| 配置项 | 论文里的概念 |
|---|---|
frontend.keyframes.selection.max_normalized_keypoint_drift | 关键帧位移阈值 (默认 0.12) |
frontend.keyframes.matching.coarse_only | 只用低分辨率流场做关键帧选择 |
frontend.tracks.propagation.max_kps | 每张图的轨迹预算 (默认 1200) |
frontend.tracks.propagation.multiflow_hops | 多流窗口里直接匹配的跳数(默认窗口 9、步长 2) |
mapping.mapper.gp.solver_backend.use_cuda / ba.…use_cuda | GP、BA 用 GPU 求解器 |
README 推荐的加速组合:
python -m vidmap.run --input_data "$INPUT_DATA" --output "$OUTPUT_DIR" \
  frontend.tracks.propagation.max_kps=1000 \
  frontend.keyframes.matching.coarse_only=true \
  'frontend.tracks.propagation.multiflow_hops=[1,2,4,8]' \
  mapping.mapper.gp.solver_backend.use_cuda=true \
  mapping.mapper.ba.solver_backend.use_cuda=true
输入支持:无标定和有标定的单目(针孔、带畸变的透视、鱼眼),有标定的多相机 rig,以及作为有标定单目的 360° 全景;无标定 rig 不支持。鱼眼只有 OPENCV_FISHEYE 且前向射线的情况是原生支持,其他情况先去畸变成针孔再建图。可视化有两条路:仓库自带的浏览器查看器 vidmap-viewer.html,以及 Rerun 的求解过程回放(建图时加 --save-playback-trace)。四个基准数据集的下载、准备和评测脚本也都在仓库里(vidmap.datasets.prepare、vidmap.run_for_benchmark、vidmap.evaluate_results),README 报告的复现数字和论文略有出入(LaMAR 全程 W-AUC 90.2 对论文的 88.5),因为用了「晚期主点精化」等后续改动。
参考
- Pataki, Sarlin, Pollefeys. VidMap: Exploiting Temporal Structure for Video-Based Structure-from-Motion. ECCV 2026. arXiv · 代码
- Campos, Elvira, Rodríguez, Montiel, Tardós. ORB-SLAM3: An Accurate Open-Source Library for Visual, Visual-Inertial, and Multimap SLAM. IEEE TRO 2021. arXiv · 代码
- Teed, Deng. DROID-SLAM: Deep Visual SLAM for Monocular, Stereo, and RGB-D Cameras. NeurIPS 2021. arXiv · 代码
- Lipson, Teed, Deng. Deep Patch Visual SLAM. ECCV 2024. arXiv · 代码
- Schönberger, Frahm. Structure-from-Motion Revisited. CVPR 2016. CVF · 代码
- Pan, Baráth, Pollefeys, Schönberger. Global Structure-from-Motion Revisited. ECCV 2024. arXiv · 代码
- Cai, Tung, Wang, Averbuch-Elor, Hariharan, Snavely. Doppelgangers: Learning to Disambiguate Images of Similar Structures. ICCV 2023. arXiv · 代码
- Xiangli, Cai, Chen, Byrne, Snavely. Doppelgangers++: Improved Visual Disambiguation with Geometric 3D Features. CVPR 2025. arXiv
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- Deng, Ti, Xu, Yang, Xie. VGGT-Long: Chunk it, Loop it, Align it — Pushing VGGT's Limits on Kilometer-scale Long RGB Sequences. arXiv 2025. arXiv · 代码
- Zhang et al.. LoGeR: Long-Context Geometric Reconstruction with Hybrid Memory. arXiv 2026. arXiv · 代码
- Chen et al.. LingBot-Map: Geometric Context Transformer for Streaming 3D Reconstruction. arXiv 2026. arXiv · 代码
- Zhao, Liu, Guo, Wang, Liu. ParticleSfM: Exploiting Dense Point Trajectories for Localizing Moving Cameras in the Wild. ECCV 2022. arXiv · 代码
- Smith, Charatan, Tewari, Sitzmann. FlowMap: High-Quality Camera Poses, Intrinsics, and Depth via Gradient Descent. 3DV 2025. arXiv · 代码
- Edstedt, Nordström, Zhang, Bökman, Åstermark, Larsson, Heyden, Kahl, Wadenbäck, Felsberg. RoMa v2: Harder Better Faster Denser Feature Matching. arXiv 2025. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Neoral, Šerých, Matas. MFT: Long-Term Tracking of Every Pixel. WACV 2024. arXiv · 代码
- Lin, Chen, Liew, Chen, Li, Shi, Feng, Kang. Depth Anything 3: Recovering the Visual Space from Any Views. arXiv 2025. arXiv · 代码
- Teed, Deng. RAFT: Recurrent All-Pairs Field Transforms for Optical Flow. ECCV 2020. arXiv · 代码
- Harley, Yang, Sun, Zheng, Raghuraman, Gu, Liang, Chu, Dave, You, Ambrus, Fragkiadaki, Guibas. AllTracker: Efficient Dense Point Tracking at High Resolution. ICCV 2025. arXiv · 项目页
- Karaev, Rocco, Graham, Neverova, Vedaldi, Rupprecht. CoTracker: It is Better to Track Together. ECCV 2024. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE TIM 2023. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. CVPR 2019. arXiv · 代码
- Berton, Masone. MegaLoc: One Retrieval to Place Them All. CVPRW 2025. arXiv · 代码
- Veicht, Sarlin, Lindenberger, Pollefeys. GeoCalib: Learning Single-image Calibration with Geometric Optimization. ECCV 2024. arXiv · 代码
- Sweeney, Sattler, Höllerer, Turk, Pollefeys. Optimizing the Viewing Graph for Structure-from-Motion. ICCV 2015. CVF
- Ding, Kocur, Vávra, Berger Haladová, Yang, Sattler, Kukelova. RePoseD: Efficient Relative Pose Estimation With Known Depth Information. ICCV 2025. arXiv · 代码
- Pataki, Sarlin, Schönberger, Pollefeys. MP-SfM: Monocular Surface Priors for Robust Structure-from-Motion. CVPR 2025. arXiv · 代码
- Yang, Antonante, Tzoumas, Carlone. Graduated Non-Convexity for Robust Spatial Perception: From Non-Minimal Solvers to Global Outlier Rejection. IEEE RA-L 2020. arXiv
- Sarlin, Dusmanu, Schönberger, Speciale, Gruber, Larsson, Miksik, Pollefeys. LaMAR: Benchmarking Localization and Mapping for Augmented Reality. ECCV 2022. arXiv · 项目页
- Blum, Mercurio, O'Reilly, Engelbracht, Dusmanu, Pollefeys, Bauer. CroCoDL: Cross-device Collaborative Dataset for Localization. CVPR 2025. CVF · 代码
- Schöps, Sattler, Pollefeys. BAD SLAM: Bundle Adjusted Direct RGB-D SLAM. CVPR 2019. CVF · 数据集
- Burri, Nikolic, Gohl, Schneider, Rehder, Omari, Achtelik, Siegwart. The EuRoC Micro Aerial Vehicle Datasets. IJRR 2016. 数据集
- Li, Tucker, Cole, Wang, Jin, Ye, Kanazawa, Holynski, Snavely. MegaSaM: Accurate, Fast, and Robust Structure and Motion from Casual Dynamic Videos. CVPR 2025. arXiv · 代码
- Huang, Zhou, Rabeti, Korovko, Ling, Ren, Shen, Gao, Slepichev, Lin, Ren, Xie, Biswas, Leal-Taixé, Fidler. ViPE: Video Pose Engine for 3D Geometric Perception. arXiv 2025. arXiv · 代码
- Li, Zhu, Pollefeys, Barath. DROID-SLAM in the Wild. CVPR 2026. arXiv · 代码
- Murai, Dexheimer, Davison. MASt3R-SLAM: Real-Time Dense SLAM with 3D Reconstruction Priors. CVPR 2025. arXiv · 代码
- Maggio, Carlone. VGGT-SLAM 2.0: Real-time Dense Feed-forward Scene Reconstruction. RSS 2026. arXiv
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPRW 2018. arXiv · 代码
- Piccinelli, Yang, Sakaridis, Segu, Li, Van Gool, Yu. UniDepth: Universal Monocular Metric Depth Estimation. CVPR 2024. arXiv · 代码