· 116 min read
论文解读:π⁴,一次前向完成 4D 几何与运动的统一模型
TL;DR π⁴ 是上海 AI Lab Physical Intelligence Team 的 4D 场景基础模型[1]:输入单图、无序图像集合或视频,不需要相机内参和外参,一次前向同时输出每视角的局部 pointmap、camera-to-world 位姿、序列级度量尺度、稠密 2D/3D 轨迹和运动物体掩码。它没有让运动头直接回归 3D 端点,而是让运动头在图像空间预测对应,再用目标视角的重建 pointmap 把对应「提升」到 3D——可见轨迹因此天然落在重建表面上。几何分支沿用 π³ 的无参考、置换等变形式,加一个 MoGe-3 式稀疏 3D 精化;运动分支在冻结的几何特征上用 Spatial AdaLN 做条件,8 步循环解码。16 项几何基准的平均排名 3.00(Pi3X 3.10、π³ 3.85)第一,Oxford Spires 六条 361–800 帧路线 ATE 0.7337 m(DVLT 1.3885 m),750 帧一次前向 33.99 GiB / 223.7 s(A800)。代码和权重已开源,但仅推理、CC BY-NC 4.0;训练代码与损失实现未发布。
- 论文:π⁴: A Foundation Model for 4D Scene Geometry and Motion,Yifan Wang, Weiguang Zhao, Ni Yang, Haoyu Guo, Junting Dong, Weinan Zhang, Chunhua Shen;上海人工智能实验室 / 上海交通大学 / 浙江大学,2026-11-17。
- 代码:github.com/yyfz/Pi4(仅推理,无训练代码)
- 权重:huggingface.co/yyfz233/Pi4(CC BY-NC 4.0)
- 项目页:yyfz.github.io/pi4
- 前作 / 预备知识:DUSt3R 解读、Foundation4D 解读、RoMa v2 解读。
一、动机:几何模型假设世界不动,运动模型不负责几何
过去两年,前向几何这条线被 DUSt3R、MASt3R、VGGT 推到了「只给图像就出相机位姿和稠密几何」[2, 3, 4]。π³ 又把「参考视角」拿掉,用置换等变的形式让所有输入视角对称[5];MapAnything、Depth Anything 3、VGGT-Ω 继续往度量尺度、任意视角和匹配监督上推[6, 7, 8]。这些模型有一个共同的隐含假设:画面里的东西在两次观测之间不动。一旦前景有人、有车、有水面,几何分支就会把运动物体的位移解释成相机运动或深度变化,重建出「背景和前景各走各的」的鬼影。
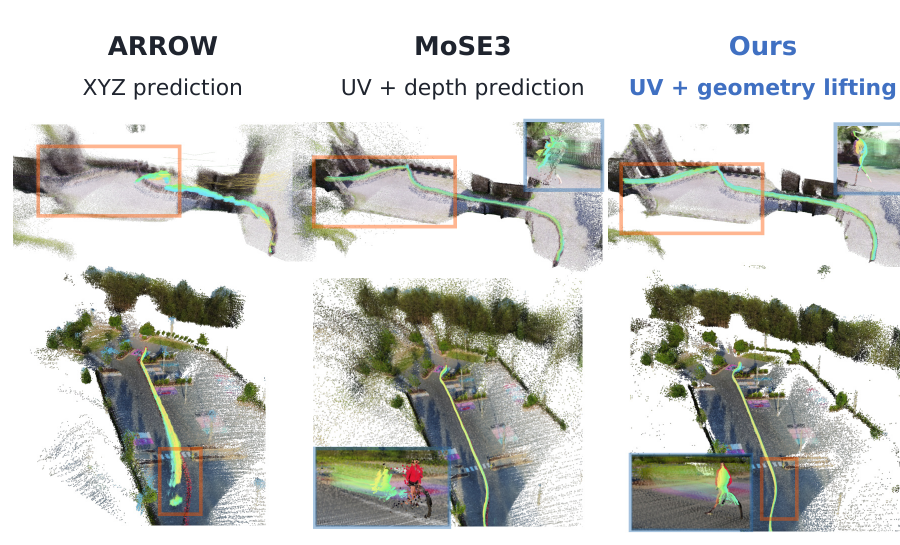
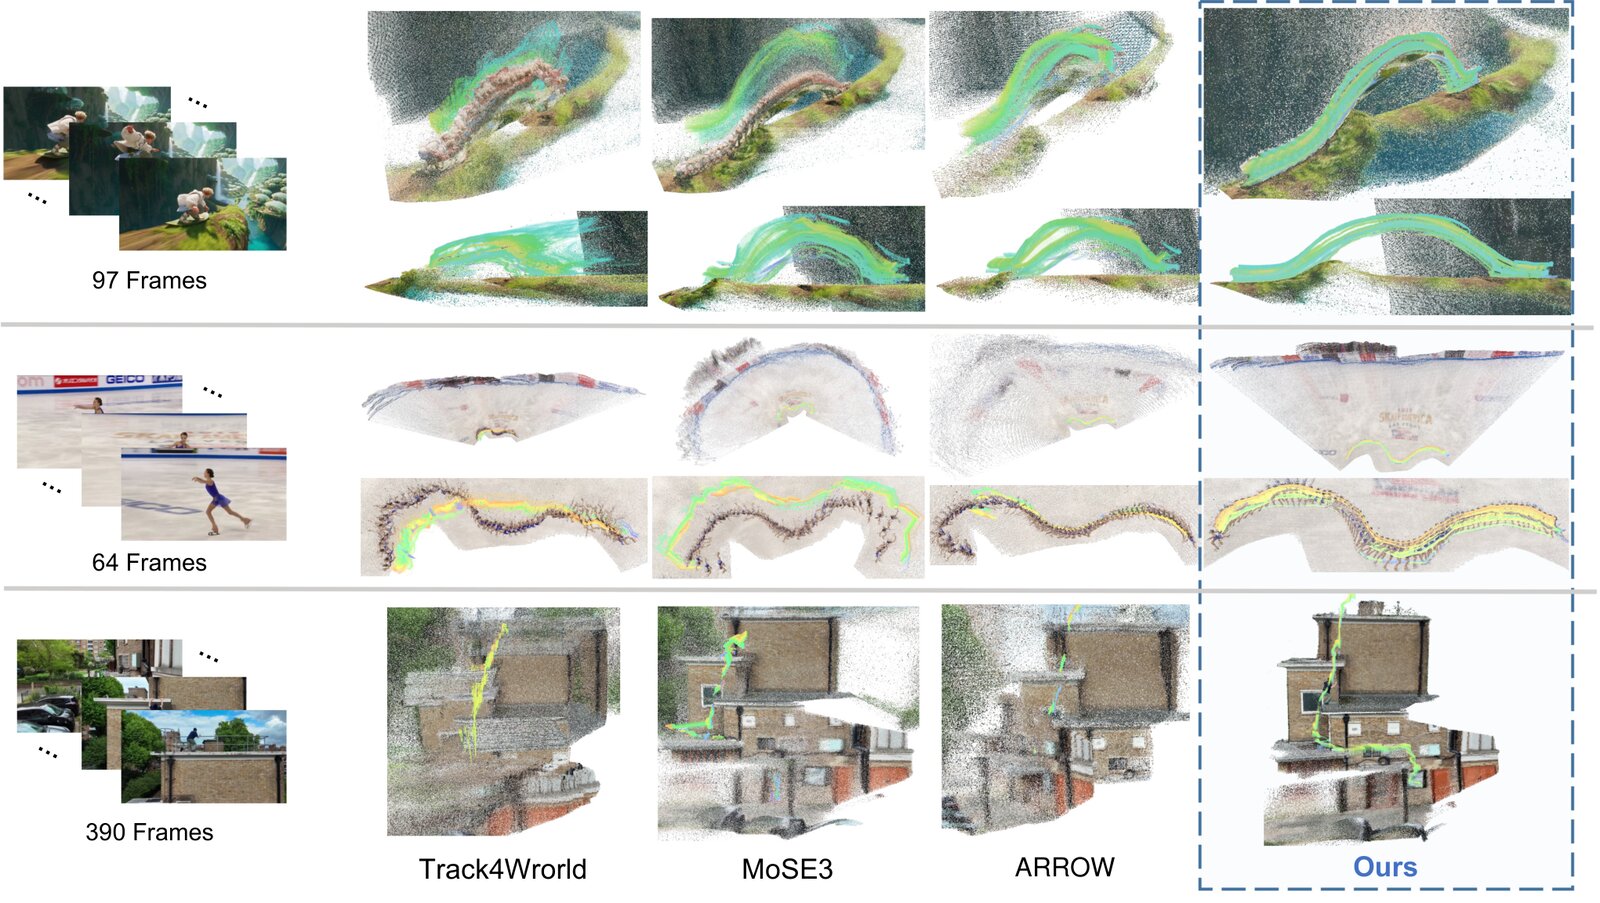
另一条线是点跟踪。TAPIR、CoTracker3 把「查询点在后一帧去哪了」做成 2D 对应[9, 10],CoWTracker 用迭代 warping 替掉相关体,把稠密跟踪的成本降下来[11]。它们能跟上运动,但输出只有 2D 像素坐标;要做 3D 轨迹,得再借一个深度模型和相机位姿,误差在三个模型之间逐级放大。3D 跟踪器试图把这件事合起来:Track4World 做 world-centric 的稠密 3D 跟踪,ARROW 在查询相机坐标系里直接回归每个点的 XYZ,MoSE3 预测每像素的 UV 和深度[12, 13, 14]。直接回归 3D 的问题是,3D 端点误差、相机位姿误差和重建表面误差会耦合在一起:查询视角附近的点还准,相机一走远,坐标基准和几何就分家了。论文 Figure 10 里 ARROW 的长轨迹从重建表面上漂出去,就是这个耦合的直观表现。
π⁴ 的选择是把两件事重新拆开、再用几何把它们粘起来:运动头只在图像空间预测对应,3D 位置交给几何分支的重建表面。一条可见轨迹的 3D 端点,是目标视角 pointmap 在预测对应处的采样值,再经过相机位姿和度量尺度变换得到。这样「轨迹贴着表面」不是损失函数劝出来的,而是参数化的构造性质:只要对应落在图像内,端点就落在重建表面上。几何和运动共享一个 DINOv3 编码器,但解码器分开、运动训练时几何冻结,避免运动梯度把几何带坏。
论文的贡献可以拆成五条:
- 统一架构:共享 DINOv3 编码器 + 两个独立的循环 Transformer 解码器(几何 16 步、运动 8 步),几何分支出 pointmap / 位姿 / 尺度 / 置信度,运动分支出 2D 对应和运动物体掩码;完整系统约 0.5B 参数,Table 2 里几何模型加载参数 343M。
- 按构造提升的 3D 跟踪:运动头只回归图像空间对应,3D 轨迹由目标视角 pointmap 采样得到;可见端点天然在重建表面上,不需要单独的 3D 轨迹头。
- 几何条件的运动解码:运动解码器从几何的初始 token 出发,用 Spatial AdaLN 注入同一视角、同一 patch 的几何特征;几何冻结,运动只学「在已有空间结构上怎么动」。
- 一套面向野外数据的数据流水线:60 个数据集、约 1 万个 scene-level 合成资产、coverage-aware 视角链、natural / counterbias 两套相机分布、序列一致的镜头增强、前景抑制后的视频伪标签,再加 GameRealm 的游戏内几何与轨迹。
- 一组可复用的经验结论:循环解码要配 step conditioning 才在训练后期占优;稀疏 3D 精化必须用有信息的图像特征做条件;相机平移路径要切断点归一化尺度的梯度;相对点监督的权重需要比局部点更大。
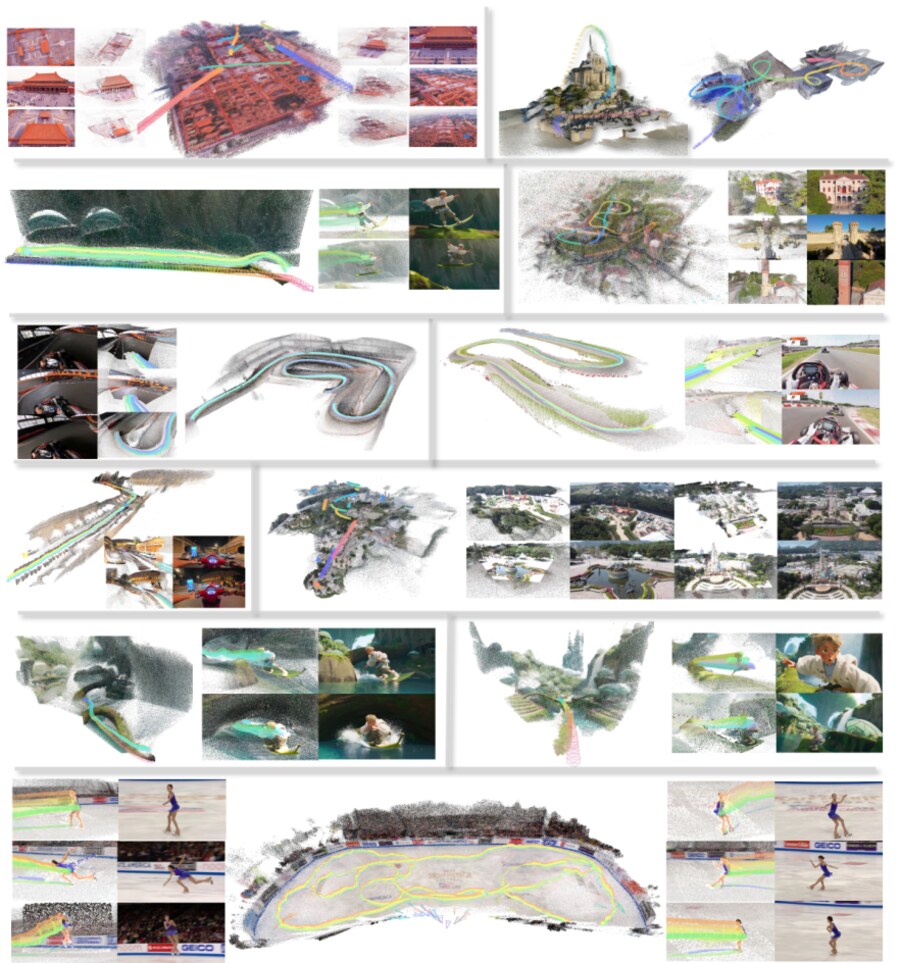
二、核心方法
2.1 问题定义与总体架构
给定 张 RGB 图像 ,图像可以来自单图、无序集合或视频,不提供内参和外参,也不要求时间顺序。π⁴ 要输出两类东西。几何侧:每个视角的局部 pointmap 、camera-to-world 位姿 、逐像素置信度 ,以及一个在所有输入间共享的正标量度量尺度 。运动侧:给定查询视角 ,稠密对应 、可见性与跟踪置信度,以及世界坐标系下的 3D 轨迹 ;另外每个视角有一张与查询无关的运动物体掩码。
关键是「无参考」:模型不指定参考相机,也不规定世界坐标系原点,重排输入只会重排对应的输出。这一点继承自 π³,也是后面能处理无序图像集合、并把长视频一次性喂进去的前提。
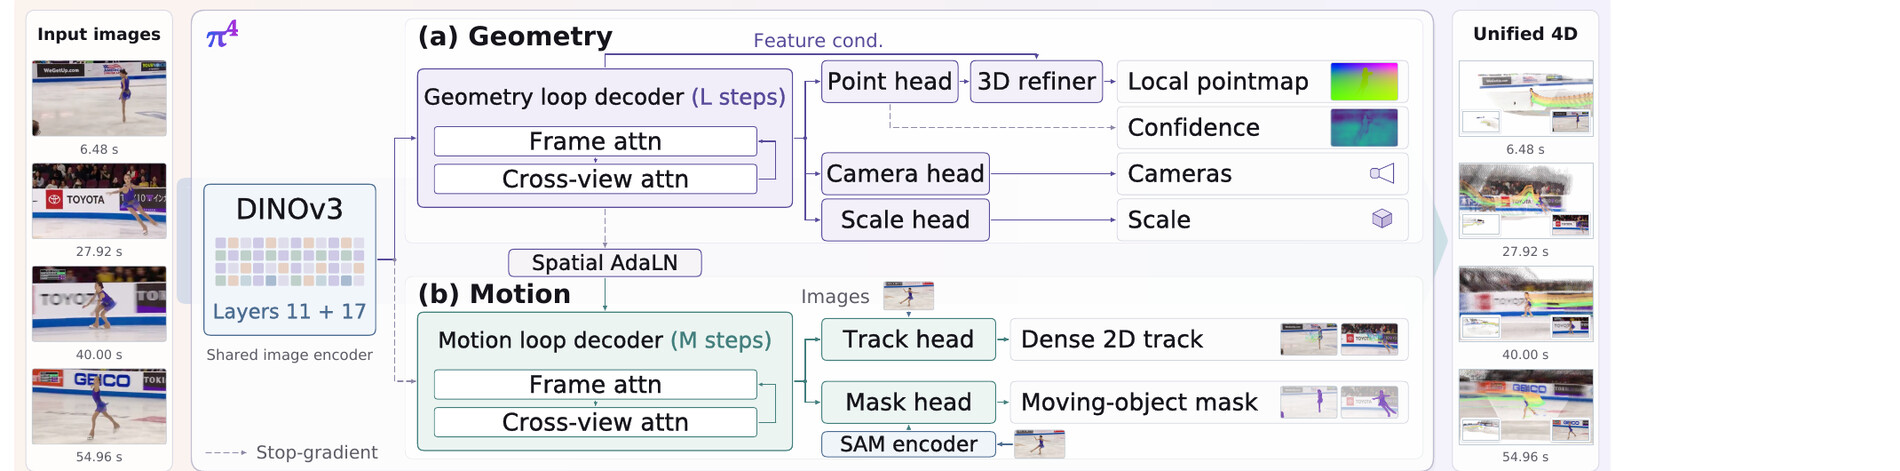
参数账要分清楚:论文说完整几何 + 运动系统约 0.5B 参数(含冻结模块),而 Table 2 为了和几何基线公平比较,只算几何模型加载的 343M 参数。对比对象里 VGGT(1.26B)、π³(959M)、MapAnything(1.23B)、DA3-Giant 1.1(1.36B)、Pi3X(992M)、VGGT-Ω(1.14B)、DVLT(117M)、ARROW(1.32B)、Track4World(1.72B);π⁴ 的 343M 比多数几何基线小 3–4 倍,但不是全场最小——DVLT 只有 117M。
2.2 共享 DINOv3 编码器与循环解码
编码器是 DINOv3[15] 的 ViT:patch 16、宽度 1024、18 个 block、5 个可学习的 prefix/register token。它不是只用最后一层,而是取第 11 层和第 17 层的特征,各自去掉 5 个 prefix token 后按通道拼成 2048 维,再投影回 1024。这个「中间层 + 后层」的组合来自 UFM 的观察:对稠密预测来说,中间层特征的局部性有时比最后一层更有用[16];RoMa v2 也用了同一对层[17]。位置编码是二维轴对齐 RoPE,周期 ,每个轴各占一半通道。
代码:共享 DINOv3 编码器(官方 pi4/models/encoder.py,原文照录)
import math

import torch
from torch import nn

from .layers import Block


class Encoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.patch_embed = nn.Conv2d(3, 1024, 16, stride=16)
        self.prefix_tokens = nn.Parameter(torch.empty(1, 5, 1024))
        self.blocks = nn.ModuleList(
            Block(1024, 16, epsilon=1e-5, scaled=True) for _ in range(18)
        )
        self.norm = nn.LayerNorm(1024, eps=1e-5)
        self.projection = nn.Linear(2048, 1024)
        self.register_buffer("periods", 100 ** (torch.arange(16).float() / 16))

    def forward(self, images):
        features = self.patch_embed(images)
        batch_size, _, height, width = features.shape
        features = torch.cat(
            (
                self.prefix_tokens.expand(batch_size, -1, -1),
                features.flatten(2).transpose(1, 2),
            ),
            dim=1,
        )
        coordinates = torch.meshgrid(
            torch.arange(height, device=images.device).float() + 0.5,
            torch.arange(width, device=images.device).float() + 0.5,
            indexing="ij",
        )
        coordinates = (
            torch.stack(coordinates, dim=-1).flatten(0, 1) / max(height, width) * 2 - 1
        )
        angles = (
            (2 * math.pi * coordinates[:, :, None] / self.periods.float())
            .flatten(1)
            .repeat(1, 2)
        )
        rotary = angles.sin(), angles.cos()
        intermediate = []
        for index, block in enumerate(self.blocks):
            features = block(features, rotary=rotary)
            if index in (11, 17):
                intermediate.append(self.norm(features)[:, 5:])
        return self.projection(torch.cat(intermediate, dim=-1))
几何解码器把每个视角的 patch token 和 5 个 register token 拼在一起,重复 次「先帧内、再跨视角」的注意力:
只处理单张图的 token,带二维位置编码; 把同一 batch 里所有帧的 token 摊平,做一次全局注意力,不再加位置编码。两个 block 在每一步都复用同一套权重——循环解码的全部意义就在这:把「深度」做成网络反复迭代,而不是叠 16 层不同的 Transformer。几何和运动各有一套参数,步内共享、步间共享,但不跨分支共享。
每个循环步还接收一个条件 。论文的文字说它编码「归一化的当前和下一步位置」,官方实现里它落成一张按步索引的 128 维表:每一步一行,过 128 → 64 → 3072 的 MLP 后加 1,再拆成三组 1024 维乘性门控,分别缩放注意力残差、FFN 残差和整个 block 的输出。这样同一套权重在每一步可以做不同强度、不同方向的更新,而不需要把步数写进参数形状。
代码:逐步条件与几何解码器(官方 pi4/models/decoder.py,原文照录)
import torch
from torch import nn

from .layers import Block


class TimeGates(nn.Module):
    def __init__(self, steps):
        super().__init__()
        self.register_buffer("encoding", torch.empty(steps, 128))
        self.proj = nn.Sequential(nn.Linear(128, 64), nn.SiLU(), nn.Linear(64, 3072))

    def forward(self, step, batch_size):
        encoding = self.encoding[step].expand(batch_size, -1).contiguous()
        gates = self.proj(encoding) + 1
        return gates.reshape(batch_size, 3, 1024).permute(1, 0, 2).unsqueeze(2)


class GeometryDecoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.register_tokens = nn.Parameter(torch.empty(1, 1, 5, 1024))
        self.frame_block = Block(1024, 16, normalize=True, scaled=True)
        self.global_block = Block(1024, 16, normalize=True, scaled=True)
        self.readout = Block(1024, 16, normalize=True, scaled=True)
        self.frame_gates = TimeGates(16)
        self.global_gates = TimeGates(16)

    def forward(self, tokens, positions, batch_size, frames):
        initial = torch.cat(
            (
                self.register_tokens.expand(batch_size, frames, -1, -1).reshape(
                    batch_size * frames, 5, 1024
                ),
                tokens,
            ),
            dim=1,
        )
        features = initial
        token_count = features.shape[1]
        for index in range(16):
            features = self.frame_block(
                features.reshape(batch_size * frames, token_count, 1024),
                positions,
                gates=self.frame_gates(index, batch_size * frames),
            )
            features = self.global_block(
                features.reshape(batch_size, frames * token_count, 1024),
                gates=self.global_gates(index, batch_size),
            )
        features = self.readout(
            features.reshape(batch_size * frames, token_count, 1024), positions
        )
        return features, initial
门控在 Block.forward 里的落点很直接:注意力输入先做 LayerNorm,再乘 、加 ;FFN 输入同理用后两组;残差相加后再乘输出门控。
代码:门控与 AdaLN 调制的落点(官方 pi4/models/layers.py,原文节选)
    def forward(
        self, features, positions=None, rotary=None, gates=None, modulation=None
    ):
        attention_scale = feedforward_scale = output_scale = 1
        if gates is not None:
            attention_scale, feedforward_scale, output_scale = gates.to(
                features.dtype
            ).unbind(0)
        attention_input = self.norm1(features)
        if modulation is not None:
            attention_input = (1 + modulation[0]) * attention_input + modulation[1]
        attention_output = self.attn(attention_input, positions, rotary)
        if self.residual_scales is not None:
            attention_output = attention_output * self.residual_scales[0]
        features = features + attention_scale * attention_output
        feedforward_input = self.norm2(features)
        if modulation is not None:
            feedforward_input = (1 + modulation[2]) * feedforward_input + modulation[3]
        feedforward_output = self.mlp(feedforward_input)
        if self.residual_scales is not None:
            feedforward_output = feedforward_output * self.residual_scales[1]
        return output_scale * (features + feedforward_scale * feedforward_output)
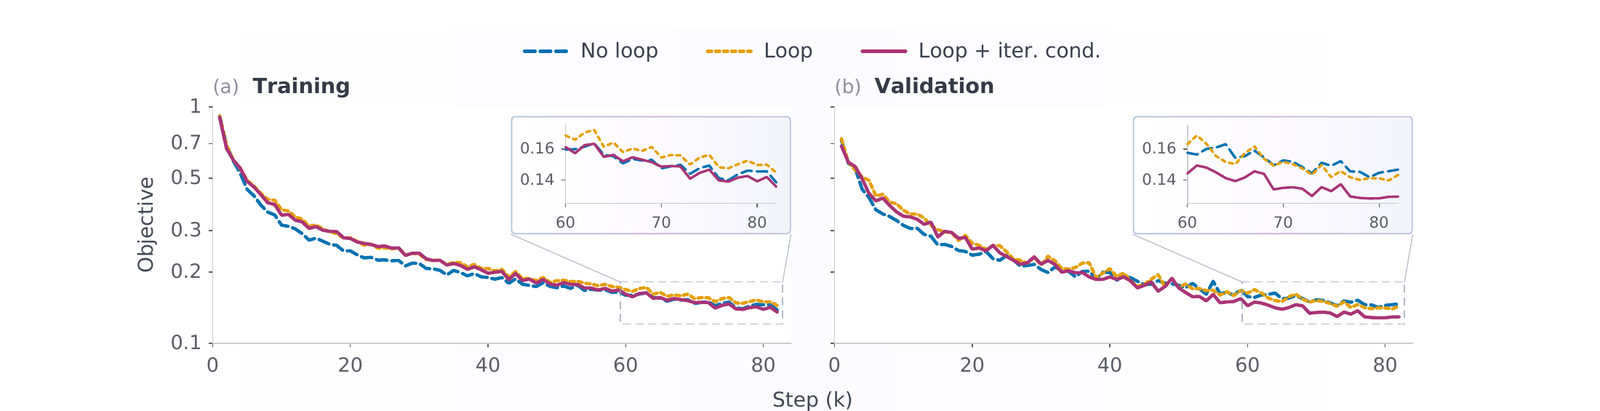
训练时几何循环步数 从 8 到 16 随机采样,评测固定 16;运动分支固定 。步数随机化让同一个模型能适应不同迭代预算,也逼着每一步都学「继续修」而不是「记第几步该干什么」。消融里,给循环解码器加 step signal 后,局部点损失降 2.8%,相机损失降 10.2%;Figure 8 的训练曲线显示,循环结构在训练早期并不占优,到训练后期(图 8 的 60–80k 区间),带步条件的循环模型才在验证目标上稳定低于无循环和纯循环两个版本。
2.3 无参考的几何分支
几何分支的核心表示是局部射线深度点图。对像素 ,网络预测一个未归一化的射线 和沿相机轴的深度 ,再相乘:
这里射线不是单位向量, 也不是欧氏距离,而是相机 轴方向的深度;这样做的好处是射线只表达方向,深度只表达远近,两者的误差不会混在一起。点图头是一个从 patch token 长出来的卷积金字塔:先把 token 摊回 的特征图,再逐级上采样到原分辨率,最后一层输出 3 个通道——前两个是射线 ,第三个是 。置信度头走另一条从同一特征金字塔出发的卷积支路,输出逐像素 logit。
代码:点图头(官方 pi4/models/heads/point.py,原文照录)
class PointHead(nn.Module):
    def __init__(self):
        super().__init__()
        self.points = ConvPyramid((512, 256, 128, 64, 32), 3)
        self.confidence = ConfidenceHead()

    def forward(self, tokens, height, width):
        pyramid = feature_pyramid(tokens.float(), height, width, 5)
        coordinates, prefix = self.points(pyramid)
        logits = self.confidence(prefix, pyramid)[:, 0]
        coordinates = coordinates.permute(0, 2, 3, 1)
        rays, log_depth = coordinates[..., :2], coordinates[..., 2]
        return rays, log_depth, logits, pyramid[0]
相机头不读特殊 token,而是读几何解码器输出的 patch token([:, 5:] 去掉 5 个 prefix),过 2 个带 RoPE 的 Transformer block、2 个残差 MLP,再对所有 token 求平均,回归 12 个数:3 个平移 + 9 个旋转矩阵元素。9 个数不保证正交,所以最后做一次 SVD 正交化,并用行列式把反射修掉:
代码:相机头与 SVD 正交化(官方 pi4/models/heads/camera.py,原文照录)
class CameraHead(nn.Module):
    def __init__(self):
        super().__init__()
        self.projects = nn.Linear(1024, 768)
        self.blocks = nn.ModuleList(Block(768, 12) for _ in range(2))
        self.linear_out = nn.Linear(768, 512)
        self.res_conv = nn.ModuleList(CameraResidual() for _ in range(2))
        self.more_mlps = nn.Sequential(
            nn.Linear(512, 512), nn.ReLU(), nn.Linear(512, 512), nn.ReLU()
        )
        self.pose = nn.Linear(512, 12)

    def forward(self, tokens, positions):
        features = self.projects(tokens.float())
        for block in self.blocks:
            features = block(features, positions)
        features = self.linear_out(features)[:, 5:]
        for block in self.res_conv:
            features = block(features)
        features = self.more_mlps(features.mean(dim=1))
        raw_pose = self.pose(features.float())
        rotation = raw_pose[:, 3:].reshape(-1, 3, 3)
        left, _, right = torch.svd(F.normalize(rotation, dim=-1).transpose(-2, -1))
        determinant = torch.det(right @ left.transpose(-2, -1))
        rotation = torch.cat(
            (right[:, :, :-1], right[:, :, -1:] * determinant[:, None, None]), dim=-1
        ) @ left.transpose(-2, -1)
        pose = torch.zeros(
            raw_pose.shape[0], 4, 4, device=tokens.device, dtype=torch.float32
        )
        pose[:, :3, :3] = rotation
        pose[:, :3, 3] = raw_pose[:, :3]
        pose[:, 3, 3] = 1
        return pose
度量尺度头只产出一个正数:一个可学习的 token 通过 2 个 cross-attention block 读取整个输入集合的所有 patch token,最后一个线性层输出 log 尺度,再取指数,得到 。它是「每个输入集合一个数」,不是逐帧、逐像素的;这也符合「同一段视频的度量单位一致」的假设。
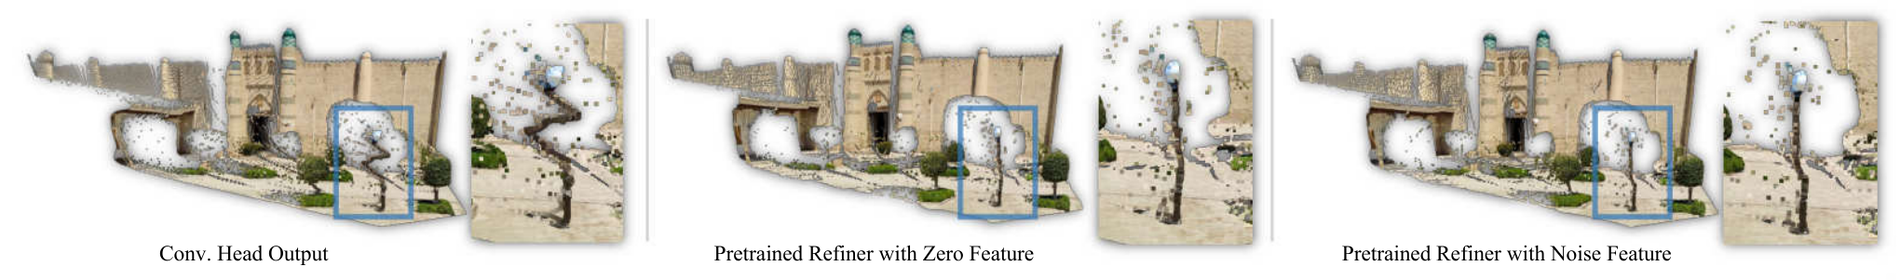
为什么不用一个全局 pointmap 直接端到端?论文的解释是误差类型不同:局部点图错,是表面几何错;全局点图错,可能是表面错,也可能是相机摆放错。把局部点和相机位姿分开监督,网络可以在相机相对关系还不确定时先把局部表面学好;如果只监督全局点,两种误差会混在一个损失里,局部结构反而学不细。这个选择在 Figure 11 的对照里有间接证据:只改精化器的条件特征,局部结构变好但点的全局摆放变差,说明「表面」和「摆放」确实是两个可分离的误差源。
2.4 稀疏 3D 精化
卷积头输出的点图在深度不连续处容易把前后景混在一起。π⁴ 借 MoGe-3 的稀疏 3D U-Net 做后处理[18]:把每个像素看成三维空间里的一个点,坐标是 ,其中 ,只保留有点的体素,做 3 次「稀疏卷积 → 残差更新 log 深度」:
射线 在整个精化过程中不动,只有深度在改,所以精化不会把像素对应的方向改掉。网络是 5 级稀疏 U-Net(32→64→128→256→512),瓶颈处把几何解码器的 1024 维特征投影到 512 维,按每个点的体素坐标采样后拼进去,再逐级上采样、加 skip。这个条件特征是关键:没有它,稀疏 U-Net 只能靠点云自身的邻域把表面磨平,磨得再干净也不知道该往哪摆。
代码:稀疏深度精化的 3 次迭代(官方 pi4/models/refiner.py,原文节选)
    def forward(self, rays, log_depth, feature):
        condition = self.feature_projector(feature.float())
        batch_size, height, width = log_depth.shape
        batch, rows, columns = torch.meshgrid(
            torch.arange(batch_size, device=rays.device),
            torch.arange(height, device=rays.device),
            torch.arange(width, device=rays.device),
            indexing="ij",
        )
        for _ in range(3):
            bins = torch.round(log_depth.float() * 256).long()
            bins = bins - bins.amin(dim=(1, 2), keepdim=True)
            coordinates = (
                torch.stack((batch, rows, columns, bins), dim=-1).reshape(-1, 4).int()
            )
            features = (
                torch.cat((rays, log_depth[..., None]), dim=-1).reshape(-1, 3).float()
            )
            shape = torch.Size(
                (batch_size, height, width, int(bins.max().item()) + 1, 3)
            )
            residual = self.network(features, coordinates, shape, condition)
            log_depth = log_depth + residual.float().reshape_as(log_depth)
        depth = log_depth.exp()[..., None]
        return torch.cat((rays * depth, depth), dim=-1)
消融把条件特征分别换成全零和随机噪声,归一化 XYZ L1 分别变差 8.77% 和 7.47%。Figure 11 的定性图更直观:零特征和噪声特征都能把细结构(蓝色框里的杆子)磨得更连续,但点的位置整体偏了;只有带图像信息的几何特征,才能既修表面又保持摆放。
精化之后,局部点和相机位姿通过度量尺度组装成世界坐标:
置信度分支是单独训练的:几何冻结,用反映重建质量的连续目标做二分类,而不是简单的 valid/invalid 标签。它估的是最终精化后几何的逐像素可靠性,和跟踪置信度不是一回事。
2.5 几何条件的运动解码
运动解码器不从头开始,而是从几何解码器的初始 token 出发——也就是 5 个 register token 加上编码器 patch token、还没经过几何循环的那一版。它重复 8 次和几何分支同样的 frame / cross-view 注意力,但每个 block 额外接收两组调制向量:一组来自同一视角、同一 patch 的几何特征,一组来自当前循环步的时间编码。几何特征先 LayerNorm 再线性到 256,时间编码线性到 256,相加后过 SiLU + 线性到 4096,最后拆成 4 个 1024 维向量,分别做注意力输入的 shift/scale 和 FFN 输入的 shift/scale。这就是 Spatial AdaLN:不是把几何特征拼进 token,而是用它调制每个 token 的归一化参数。
代码:Spatial AdaLN 与运动解码器(官方 pi4/models/decoder.py,原文照录)
class SpatialCondition(nn.Module):
    def __init__(self):
        super().__init__()
        self.geometry = nn.Sequential(nn.LayerNorm(1024), nn.Linear(1024, 256))
        self.time = nn.Linear(64, 256)
        self.output = nn.Sequential(nn.SiLU(), nn.Linear(256, 4096))
        self.register_buffer("time_encoding", torch.empty(8, 64))

    def forward(self, geometry, step):
        encoding = self.time_encoding[step].expand(geometry.shape[0], -1).contiguous()
        return self.output(
            self.geometry(geometry.float()) + self.time(encoding)[:, None]
        ).chunk(4, dim=-1)


class MotionDecoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.frame_block = Block(1024, 16, normalize=True, scaled=True)
        self.global_block = Block(1024, 16, normalize=True, scaled=True)
        self.readout = Block(1024, 16, normalize=True, scaled=True)
        self.frame_condition = SpatialCondition()
        self.global_condition = SpatialCondition()
        self.frame_gates = TimeGates(8)
        self.global_gates = TimeGates(8)

    def forward(self, initial, geometry, positions, batch_size, frames):
        token_count = initial.shape[1]
        features = initial
        for index in range(8):
            frame_geometry = geometry.reshape(batch_size * frames, token_count, 1024)
            features = self.frame_block(
                features.reshape_as(frame_geometry),
                positions,
                gates=self.frame_gates(index, batch_size * frames),
                modulation=self.frame_condition(frame_geometry, index),
            )
            global_geometry = geometry.reshape(batch_size, frames * token_count, 1024)
            features = self.global_block(
                features.reshape_as(global_geometry),
                gates=self.global_gates(index, batch_size),
                modulation=self.global_condition(global_geometry, index),
            )
        return self.readout(
            features.reshape(batch_size * frames, token_count, 1024), positions
).float()运动解码器没有时间位置编码。帧与帧之间的顺序信息不靠「第几帧」的 embedding,而靠内容本身:frame attention 看单帧,cross-view attention 看所有帧的 token,谁和谁像、谁在谁后面,由特征匹配决定。这和无参考几何是同一个哲学:不预设哪一帧是参考、哪一帧在前,输入顺序变了,输出跟着换位置,但对应关系不变。
训练时几何分支完全冻结,运动分支只看 stop-gradient 后的几何特征;论文说这样可以避免运动梯度反过来改变几何表示。消融里,加了几何特征条件后跟踪 EPE 降 7.17 px,在大基线图像对上降 8.10 px。这个数字不算小,说明「几何特征提供的空间上下文」确实在帮运动头判断一个像素该往哪走,而不是只靠局部外观。
2.6 跟踪头与 3D 提升
跟踪头沿用 CoWTracker 的迭代 warping 设计[11],但去掉了时间位置编码,因此可以处理任意顺序的帧。输入是运动解码器上采样后的特征,加上一个浅层 RGB 编码器(4 级 stride-2 卷积 + 转置卷积)给出的 128 通道图像特征;两者拼起来后,跟踪头从零位移开始,迭代 5 次:每次用当前 flow 去 warp 目标帧特征,和查询帧特征、上一轮 hidden state、当前 flow 拼在一起,过跟踪 refine 网络,输出 4 个通道——2 个 flow 增量 + 2 个 information 通道;最后一轮用 3×3 邻域的 convex upsampling 把 flow 和 information 上采样 2 倍,得到半像素精度的对应。为了省显存,跟踪特征和 recurrent state 分块放在 CPU,算的时候再搬回 GPU;查询帧会被重排到序列第一位,算完再用 argsort 还原。
代码:迭代 warping 跟踪头(官方 pi4/models/heads/tracking.py,原文节选)
class TrackingHead(nn.Module):
    def __init__(self):
        super().__init__()
        self.refine_net = TrackingRefinement()
        self.fmap_conv = nn.Conv2d(256, 64, 1)
        self.hidden_conv = nn.Conv2d(128, 64, 1)
        self.warp_linear = nn.Conv2d(194, 64, 1)
        self.refine_transform = nn.Conv2d(96, 64, 1)
        self.upsample_weight = nn.Sequential(
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(), nn.Conv2d(128, 36, 1)
        )
        self.flow_head = nn.Sequential(
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(), nn.Conv2d(128, 4, 1)
        )

    def forward(self, features):
        batch_size, frames, _, height, width = features.shape
        flattened_batch = batch_size * frames
        device = self.fmap_conv.weight.device
        reference = features[:, 0].to(device)
        features = features.flatten(0, 1)
        hidden = torch.empty_like(features)
        flow = torch.zeros(flattened_batch, 2, height, width)
        base = coordinate_grid(1, height, width, device)
        batches = torch.arange(flattened_batch, device=device) // frames
        for start in range(0, flattened_batch, 8):
            stop = min(start + 8, flattened_batch)
            values = features[start:stop].to(device)
            initial = self.hidden_conv(
                torch.cat((reference[batches[start:stop]], values), dim=1)
            )
            hidden[start:stop].copy_(initial.cpu())
        del values, initial
        up_flow = torch.empty(flattened_batch, 2, height * 2, width * 2)
        information = torch.empty_like(up_flow)
        for iteration in range(5):
            inputs = torch.empty_like(features, device=device)
            for start in range(0, flattened_batch, 8):
                stop = min(start + 8, flattened_batch)
                values = features[start:stop].to(device)
                previous = flow[start:stop].to(device)
                sampled = warp(values, base + previous).to(values.dtype)
                projected = self.warp_linear(
                    torch.cat(
                        (
                            reference[batches[start:stop]],
                            sampled,
                            hidden[start:stop].to(device),
                            previous.to(values.dtype),
                        ),
                        dim=1,
                    )
                )
                inputs[start:stop].copy_(projected)
            del values, previous, sampled, projected
            pyramid = self.refine_net.encode(
                inputs.reshape(batch_size, frames, 64, height, width)
            )
            del inputs
            for start in range(0, flattened_batch, 8):
                stop = min(start + 8, flattened_batch)
                refined = self.refine_net.decode(
                    [level[start:stop] for level in pyramid], height, width
                )
                updated = self.refine_transform(
                    torch.cat((refined, hidden[start:stop].to(device)), dim=1)
                )
                hidden[start:stop].copy_(updated.cpu())
                with torch.autocast(device_type=device.type, enabled=False):
                    update = self.flow_head(updated.float())
                    next_flow = flow[start:stop].to(device) + update[:, :2]
                    flow[start:stop].copy_(next_flow.cpu())
                    if iteration == 4:
                        weights = 0.25 * self.upsample_weight(updated.float())
                        coordinates, scores = convex_upsample(
                            next_flow, update[:, 2:], weights
                        )
                        up_flow[start:stop].copy_(coordinates.cpu())
                        information[start:stop].copy_(scores.cpu())
                        del weights, coordinates, scores
                del refined, updated, update, next_flow
            del pyramid
        up_flow = up_flow.reshape(batch_size, frames, 2, height * 2, width * 2)
        up_flow.sub_(up_flow[:, :1].clone())
        up_flow.add_(coordinate_grid(1, height * 2, width * 2, "cpu")[None])
        tracks = up_flow.permute(0, 1, 3, 4, 2).to(device)
        information = information.reshape(
            batch_size, frames, 2, height * 2, width * 2
        ).to(device)
        return tracks, information[:, :, 0], information[:, :, 1]
得到 2D 对应后,3D 轨迹不是另训一个头,而是直接采样目标视角的局部 pointmap,再做位姿和尺度变换:
实现上就是一次 grid_sample:用半像素中心的采样网格,把目标帧的 local_points 在预测对应的位置插值出来,乘相机旋转、加平移、乘序列尺度;落在图像外的对应返回 NaN。可见性单独输出,不用它去「猜」被遮挡点的位置。
代码:3D 提升(官方 pi4/models/pi4.py,原文照录)
    @staticmethod
    def lift_tracks(tracks, local_points, camera_poses, metric_scale):
        batch_size, frames, height, width, _ = local_points.shape
        grid = (tracks + 0.5) * tracks.new_tensor((2 / width, 2 / height)) - 1
        sampled = F.grid_sample(
            local_points.flatten(0, 1).permute(0, 3, 1, 2),
            grid.flatten(0, 1),
            align_corners=False,
        )
        sampled = sampled.permute(0, 2, 3, 1).reshape(
            batch_size, frames, height, width, 3
        )
        world = torch.einsum("btij,bthwj->bthwi", camera_poses[..., :3, :3], sampled)
        world = (world + camera_poses[..., :3, 3][:, :, None, None]) * metric_scale[
            :, None, None, None, None
        ]
        inside = (
            (tracks[..., 0] >= 0)
            & (tracks[..., 0] <= width - 1)
            & (tracks[..., 1] >= 0)
            & (tracks[..., 1] <= height - 1)
        )
        return world.masked_fill(~inside[..., None], float("nan"))
这个设计和 ARROW / MoSE3 的差别,可以用一个二维侧视玩具看清。假设查询帧里有一个点,目标相机在基线上,目标视角看到一条射线;重建出的墙面是一条略有波动的竖线。
把 δ 拖到 0.6、把基线拉到 2.8,再依次切换三个按钮:π⁴ 的「到重建表面」始终是 0.00;MoSE3 的表面错位随 δ 线性涨,但射线偏差始终为 0;ARROW 两者都涨,且基线越大涨得越快。这里要诚实说明玩具和真实模型的差别:π⁴ 的真实 2D 对应也有误差,它只消除了「3D 提升」引入的额外不一致;而且「落在表面上」不等于「落在正确表面上」——重建表面本身错了,轨迹会一致地错在同一个错误表面上。
2.7 运动物体掩码
掩码分支和查询无关:给定运动解码器的特征,它把特征和冻结的 SAM 2 图像编码器(Hiera)在 上提取的粗、中、细三级特征融合,先 1×1 卷积对齐通道,再过一个残差块和两个转置卷积上采样,最后按原分辨率插值回 。SAM 2 的部分全程冻结,训练时只更新投影、融合和上采样层[19]。
代码:掩码头的前向(官方 pi4/models/heads/motion.py,原文节选)
    def forward(self, tokens, images):
        height, width = images.shape[-2:]
        outputs = []
        for frame_tokens, frame_image in zip(tokens.split(1), images.split(1)):
            mean = frame_image.new_tensor((0.485, 0.456, 0.406)).reshape(1, 3, 1, 1)
            deviation = frame_image.new_tensor((0.229, 0.224, 0.225)).reshape(
                1, 3, 1, 1
            )
            rgb = (frame_image.float() * deviation + mean).clamp(0, 1)
            resized = F.interpolate(
                rgb,
                size=(1024, 1024),
                mode="bilinear",
                align_corners=False,
                antialias=True,
            )
            fine, middle, coarse = self.encoder((resized - mean) / deviation)
            motion = (
                self.motion_projection(frame_tokens)
                .transpose(1, 2)
                .reshape(1, 256, height // 16, width // 16)
            )
            motion = F.interpolate(
                motion, size=coarse.shape[-2:], mode="bilinear", align_corners=False
            )
            features = self.fusion(torch.cat((motion, coarse.to(motion.dtype)), dim=1))
            features = features + self.residual(features)
            features = self.output_upscaling[2](
                self.output_upscaling[1](
                    self.output_upscaling[0](features) + self.conv_s1(middle)
                )
            )
            features = self.output_upscaling[4](
                self.output_upscaling[3](features) + self.conv_s0(fine)
            )
            outputs.append(
                F.interpolate(
                    self.output(features).float(),
                    size=(height, width),
                    mode="bilinear",
                    align_corners=False,
                )[:, 0]
            )
return torch.cat(outputs)掩码的语义是序列级物体运动,不是逐帧瞬时运动:一个物体只要在这段序列里动过,它在所有出现的帧里都是正的,包括它暂停的帧。这一点和「光流非零」是两回事,论文在输出定义里专门强调了。掩码预测不依赖查询视角,也不参与几何和跟踪的计算——官方文档明确说 masks 不会 gate geometry or tracking,它只是一个并行输出。
2.8 损失函数
几何分支的监督由几部分组成。所有点和平移都先按序列内有效点的平均范数 归一化,记 ;再用深度加权 L1 拟合一个尺度 (ROE 求解,不加平移)对齐到真值,相机平移乘同一个 。下面 是尺度对齐后的预测, 是归一化后的真值。局部点损失是深度加权 L1:
是逆深度权重,近处点权重大。单靠 L1 不够,论文又加了 SurGe 的 point-gradient matching(PGM)[20]:在局部邻域里比较点的空间梯度,用欧氏惩罚,跳过无效邻域和真值深度不连续处。这样表面的局部朝向也能被监督,而不只是点的绝对位置。
相机监督用相对位姿,而不是绝对位姿:对任意一对相机 ,,损失同时约束旋转角和平移 L1。点也可以变换到对方相机系里比较:
, 是对方视角在真值对应处的点。这个损失把「点」和「位姿」绑在一起:位姿错了,点对不上;点错了,位姿也解释不了。它不需要指定参考帧,适合无参考的设定。
射线损失 用真值内参监督预测的相机局部射线坐标,是尺度无关的平均绝对误差;匹配损失把目标 patch 的相似度做 row-wise softmax,取真值对应的负对数似然:
度量尺度用 MoGe-2 式的独立监督[21],在 空间做平方误差:
总几何损失把粗预测和每一轮精化都算进去,再加相机、射线、匹配、度量四项:
本身是局部点、PGM、相对点、跨视角点一致性和相对 PGM 的加权和。论文只给了符号,没有列具体权重;官方仓库也没有训练代码,所以这一节只能讲到「有哪些项、各自约束什么」,不能给出可复现的数值配方。
有一个实现细节值得单独拎出来:点归一化用的 同时出现在点路径和相机平移路径上。如果相机平移也通过 反传,相机损失就会去改变点的归一化尺度,两个任务互相拉扯。π⁴ 的做法是在相机平移的分母上停梯度:
消融里,切断这条梯度路径让相机损失降 10.9%,局部点损失只涨 0.2%。这个改动很小,但很能说明「共享归一化」在多头模型里会怎样把梯度串线。
另外两条消融也值得记:把相对点损失的权重乘 10,局部点降 5.4%、相机降 2.3%;把编码器学习率设成 做微调,比冻结编码器再降 8.1% 局部点和 4.5% 相机,而 虽然前期降得快,后期反而更差。论文的解释是编码器可以训,但要用比解码器小一个量级的学习率。
运动分支的监督沿用 CoWTracker:迭代坐标回归 + 可见性/置信度的二元交叉熵,外加有真值几何和相机时在静态区域上的对应监督;掩码用二元交叉熵,只在有标注的像素上算,未知标签忽略。几何和 SAM 2 编码器都冻结。
2.9 数据与训练
π⁴ 的数据表有 60 个数据集,按监督类型分三类:原生轨迹(蓝色)、静态 RGB-D 重投影轨迹(绿色)、显式运动物体掩码(橙色)。几何阶段的采样很分散,占比最高的是 OmniWorld(8.28%)、Sketchfab(6.57%)、GameRealm(4.50%)、ScanNet++(3.47%)、Project Aria(3.47%);运动阶段则高度集中:GameRealm 20.53%、GMOS-2K 10.00%。论文给的总体比例是运动阶段 70.2% 跟踪、19.8% 静态几何、10.0% 真实视频的运动掩码。
合成数据部分,论文从 Funes 和 Sketchfab curated 了约 1 万个 scene-level 3D 资产,不是孤立物体,而是建筑、街区、室内这类大场景。相机候选按位置、朝向、距离采样,做可见性和 RGB-D 质量检查,再用「增量覆盖 observable surface」的方式选视角,最后用深度一致的重投影建一张 view-overlap 图,从图里选连通的视角链。这样做的目的不是让每个视角都和某个参考视角重叠,而是让整条链覆盖场景,局部相邻视角有足够共视,远处视角允许只通过中间视角间接连上。
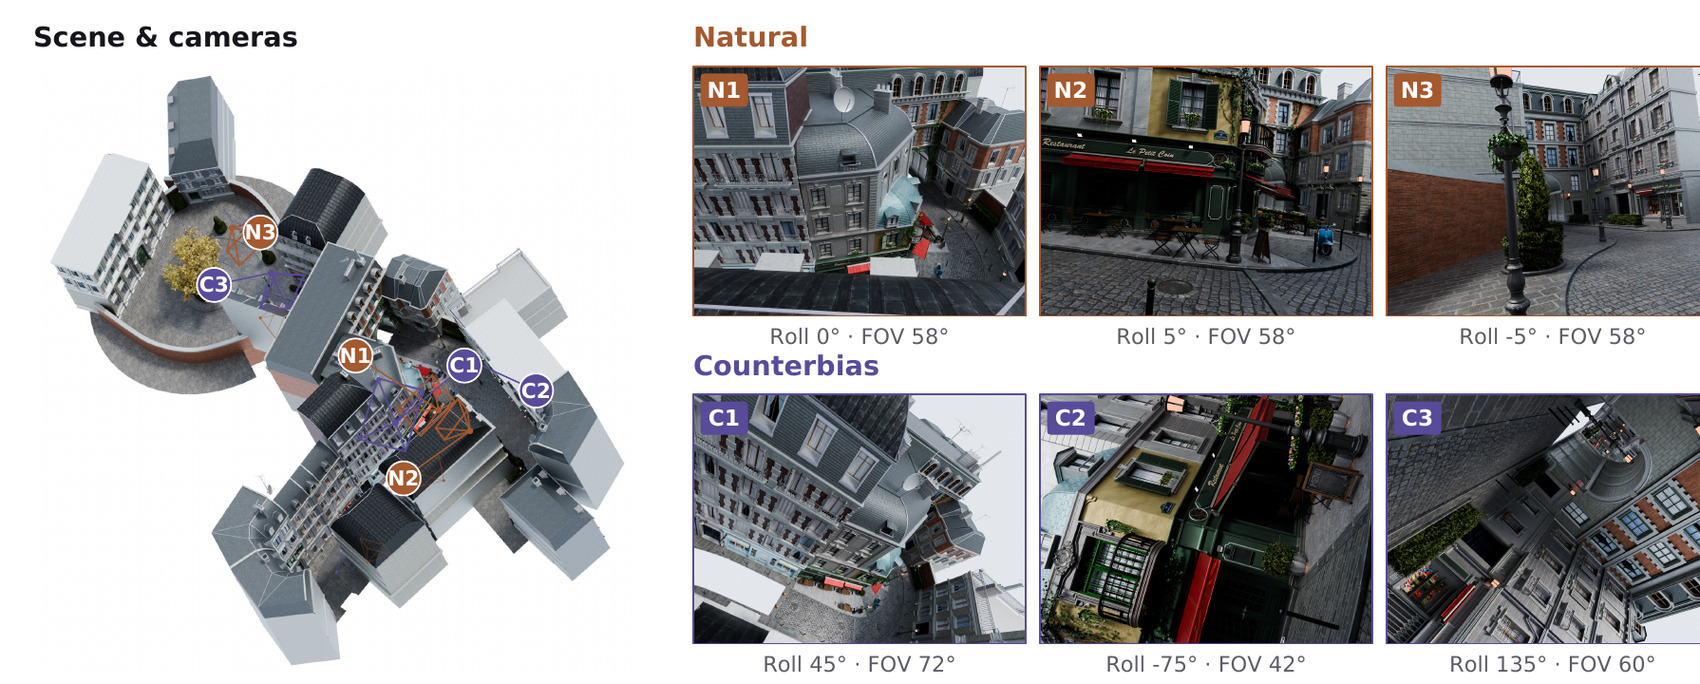
相机分布分两套。自然组用小幅 roll 和共享内参;反偏置组显式扩大 roll 范围、拉大 FOV 差异,roll 可到 ,FOV 在 – 之间。两套相机各自独立采样位置和遮挡关系,不是把同一组视角换个角度渲染。Figure 4 展示了同一个场景里的六个例子:N1–N3 是自然组,C1–C3 是反偏置组。
还有两个数据侧的细节。镜头增强不是简单的 crop-and-resize:每条序列随机选 identity、barrel、blended equidistant(鱼眼式)或 pincushion 四种映射之一,概率分别是 40%、35%、20%、5%,同一序列的所有帧共享同一组参数;增强同时作用在 RGB 和几何监督上,对每个输出像素反查源位置,然后用标定后的射线和相机轴深度重新定义目标点。这样既扩展了视场,又不会把监督变成「先渲染再近似」的二手标签。
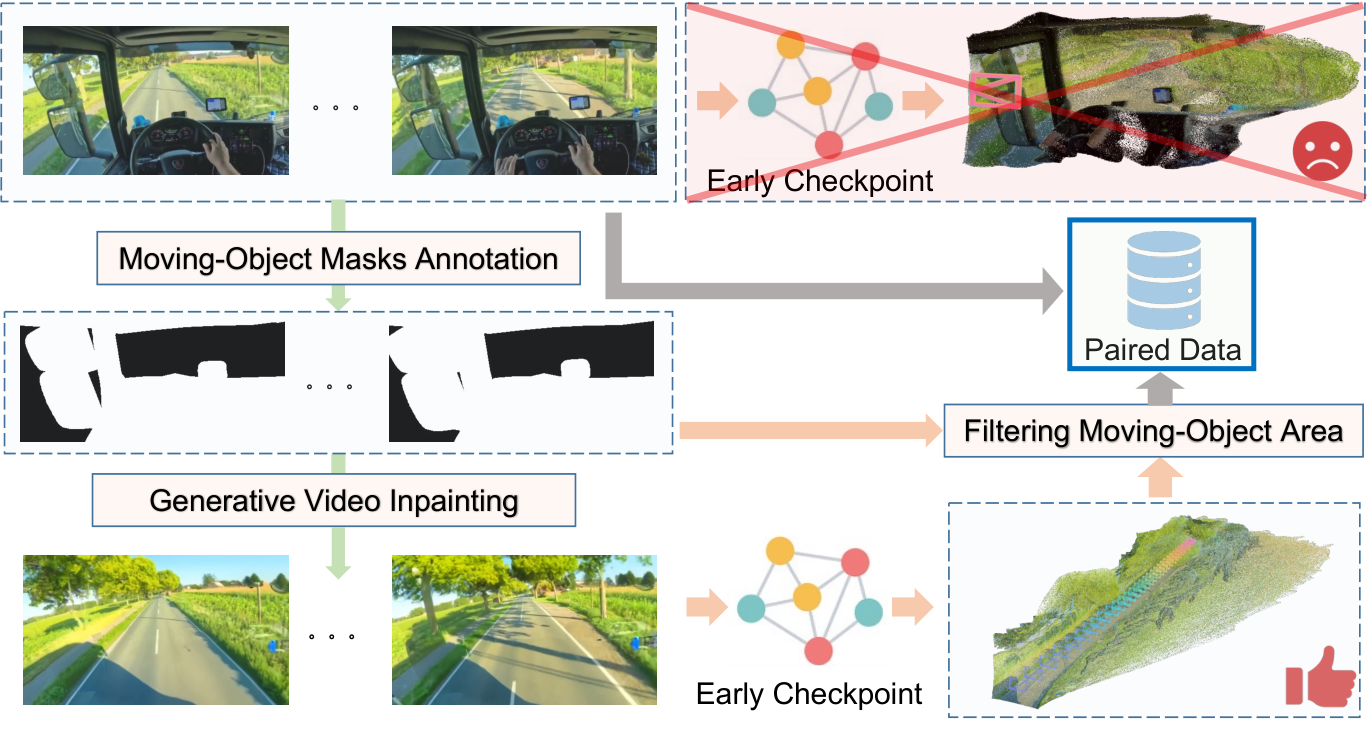
互联网视频的前景抑制是另一条。大运动前景会主导视角、破坏背景重建;π⁴ 先用掩码把前景涂掉,用生成式视频修补把洞补上,让一个早期 checkpoint 在补全后的视频上重建背景,再只保留「原来可见的背景像素」对应的点,把伪标签和原始 RGB 配对。这样伪标签不会落在修补出来的内容上,也不会把修补的纹理当成真值。Figure 5 是这条流水线的示意。
训练分两段。几何阶段在 64 张 A800 上约 30 万次优化器更新,从预训练 DINOv3 编码器开始,早期先训编码器、循环解码器、点/相机/匹配头,后期才引入稀疏 3D 精化和度量尺度,并把互联网视频混进来;运动阶段约 10 万次更新,只训运动解码器、跟踪头和掩码头,几何全程冻结,SAM 2 编码器也冻结,置信度头在几何冻结后单独训练。优化器是 AdamW + BF16 混合精度,图像长边 512,每张 GPU 最多 64 个视角,不做梯度累积;每张 GPU 的 batch 按 个独立样本打包( 是每个样本的视角数)。基础学习率 ,编码器 ,余弦衰减。
训练时的视角数是从单图、2–24 图的短集合、32/48/64 图的长集合里随机采的,短集合占主要概率,长集合保证模型见过大上下文。Figure 9 报告在 64 视角、、BF16、16 步循环、激活重计算的配置下,单次完整更新的峰值显存约 58 GiB(A800 80GB)。这个数字后面会和推理的长序列显存放在一起看:训练最多 64 视角,推理却要一次吃 750 帧,靠的是循环权重共享、跟踪状态放 CPU,以及不做时间分块。
三、实验结果
3.1 评测设置与总体排名
几何评测沿用 π³ / VGGT 的 16 项设置,分四组:单目深度(Sintel、Bonn、KITTI、NYUv2)、视频深度(Sintel、Bonn、KITTI)、相对位姿与轨迹(RealEstate10K、CO3Dv2、Sintel、TUM、ScanNetv2)、多视角重建(7-Scenes、NRGBD、DTU、ETH3D)。单目深度用逐帧中值尺度对齐,视频深度用序列级 scale-and-shift,位姿用相对旋转/平移误差和 AUC,重建用尺度对齐后的 Accuracy / Completion / Normal Consistency。对比对象是 VGGT、π³、MapAnything、DA3-Giant 1.1、Pi3X、VGGT-Ω、DVLT、ARROW、Track4World 九个基线。
Table 2 的总结方式不是「把所有指标拉平求平均」,而是:每个 panel 内先对各个指标排名,再对数据集平均;四个 panel 等权平均得到 Overall。这样单目、视频、位姿、重建各占 1/4,不会因为某个 panel 指标多就权重更大。π⁴ 的 Overall 是 3.00,排第一;Pi3X 3.10 第二,π³ 3.85 第三,DA3 5.53 第四。分组看,π⁴ 的视频深度 2.33、位姿/轨迹 3.00、重建 3.17 都是第一;单目深度 3.50 排第三,前面是 Pi3X 2.57 和 π³ 2.96。这个「三项第一、一项第三」比「总排名第一」更值得记住:π⁴ 的强项是多视角和序列,单目深度并不是它最锋利的刀。
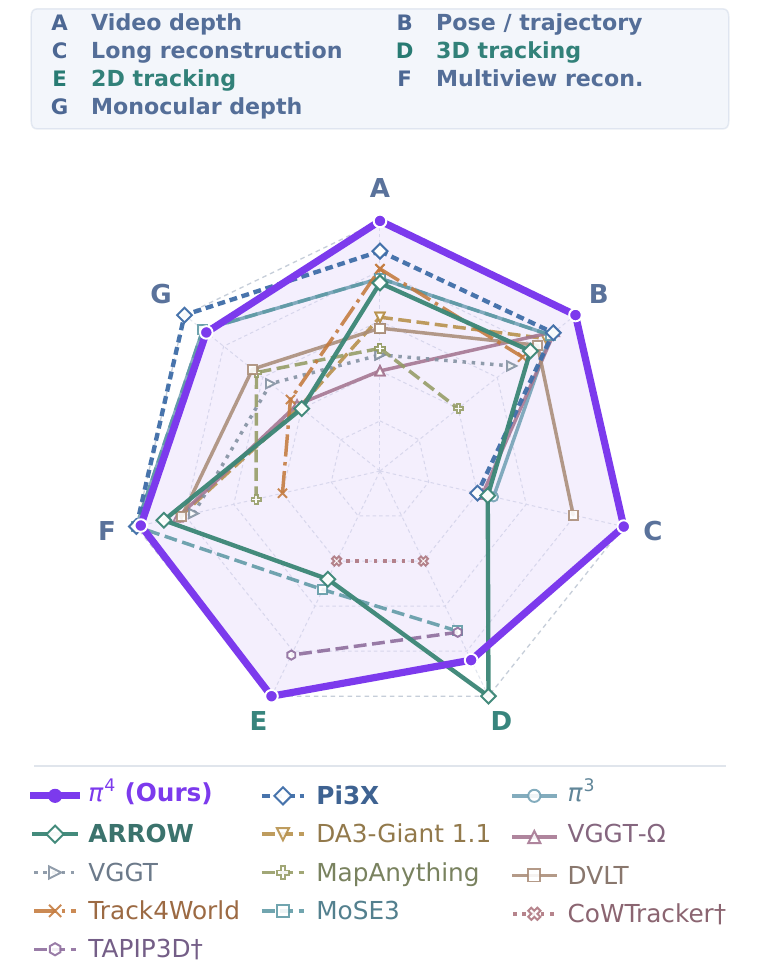
几个具体数字。单目深度上,Sintel 的 AbsRel 从 VGGT 的 .335、π³ 的 .280 降到 .256,SqRel 1.011(π³ 1.280),RMS 3.192(π³ 3.716)。视频深度上,Sintel AbsRel .160(Pi3X .189、Track4World .181), 77.0(Pi3X 73.7)。位姿上,Sintel ATE .0318(VGGT .1671、π³ .0733、ARROW .0621),CO3Dv2 的 A@5 70.3(Pi3X 66.1),但 RealEstate10K 的 R@5 98.5 略低于 Pi3X 的 98.8、A@5 63.8 低于 64.8——不是每个格子都赢。重建上,DTU 的 Accuracy 1.0452 mm(VGGT 1.3095、Pi3X 1.2268),ETH3D 的 Accuracy .1722(VGGT .2713,VGGT-Ω .1733 基本持平)。
度量尺度是单独评的:用点云半径的相对误差,不做尺度拟合或 ICP。π⁴ 的均值 20.11,低于 MapAnything 的 25.10,但高于 Pi3X 的 16.92;分数据集看,7-Scenes 11.05 明显差于 Pi3X 的 5.41,ETH3D 24.83 好于 26.98,NRGBD 24.44 差于 18.37。这个结果说明 π⁴ 的度量尺度「可用但不是最强」,论文也没有把它说成全面领先。
3.2 长序列重建
Oxford Spires[22] 的六条路线每条约 361–800 帧,全部图像一次前向,不切窗口。Table 3 里 π⁴ 六条全完成,ATE 0.7337 m、RRE 2.9298°/100 m、RTE 1.6664 m/100 m、CD 1.1573 m、F1 0.9392;DVLT[23] 六条全完成,但 ATE 1.3885 m、CD 1.5238 m;π³ 和 Pi3X 也能跑完六条,ATE 却到了 10.1852 m 和 10.3502 m;VGGT 0/6,MapAnything 3/6,DA3 2/6,Track4World 2/6。相对 DVLT,π⁴ 的 ATE 降 47.2%,CD 降 24.1%。
| 方法 | 完成路线 | ATE (m) ↓ | RRE (°/100 m) ↓ | RTE (m/100 m) ↓ | CD (m) ↓ | F1@4 m ↑ |
|---|---|---|---|---|---|---|
| VGGT | 0/6 | — | — | — | — | — |
| π³ | 6/6 | 10.1852 | 17.0832 | 11.7017 | 1.9774 | 0.8668 |
| MapAnything | 3/6 | — | — | — | — | — |
| DA3-Giant 1.1 | 2/6 | — | — | — | — | — |
| Pi3X | 6/6 | 10.3502 | 23.8340 | 12.2195 | 3.4667 | 0.7959 |
| VGGT-Ω | 6/6 | 12.1434 | 28.0360 | 15.3298 | 2.4580 | 0.8328 |
| DVLT | 6/6 | 1.3885 | 3.6422 | 2.3218 | 1.5238 | 0.9236 |
| ARROW | 6/6 | 11.1650 | 19.8088 | 12.4884 | 2.2748 | 0.8458 |
| Track4World | 2/6 | — | — | — | — | — |
| π⁴ | 6/6 | 0.7337 | 2.9298 | 1.6664 | 1.1573 | 0.9392 |
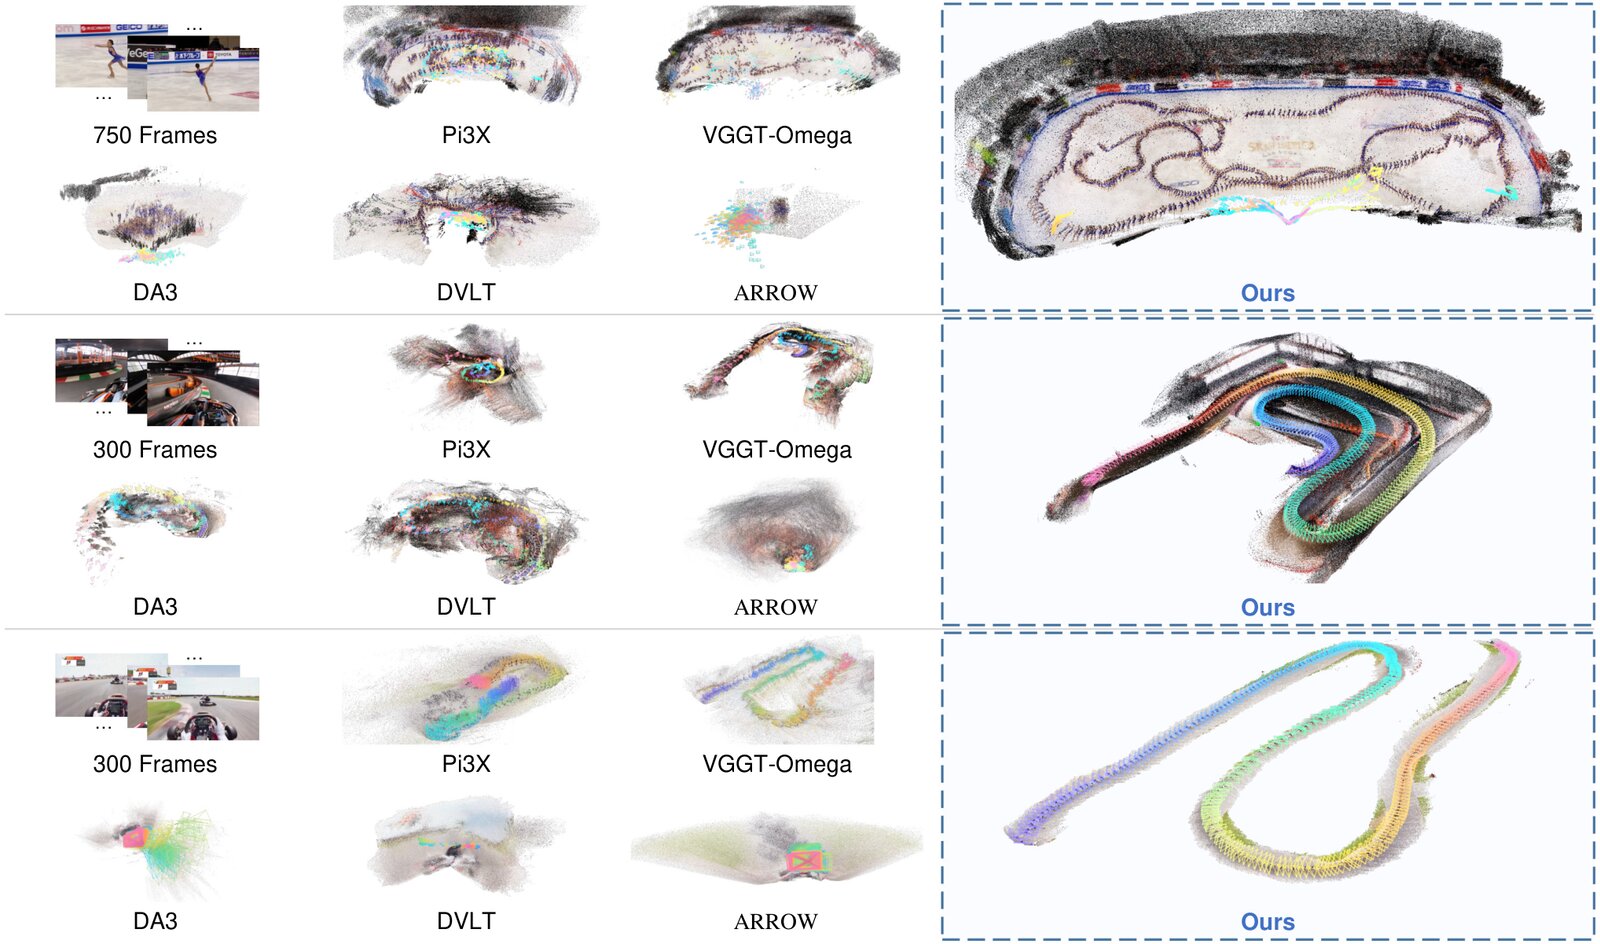
750 帧的花样滑冰是论文和项目页的旗舰 demo:512×288、stride 1、无帧数上限、一次前向,A800 上 33.99 GiB 峰值显存、223.7 秒。必须加 PYTORCH_ALLOC_CONF=expandable_segments:True,否则同一配置的峰值是 50.24 GiB。训练时每张 GPU 最多 64 视角,推理一次 750 帧,这是上下文长度上的外推,不是把训练窗口原样放大。
3.3 2D 与 3D 跟踪
跟踪评测沿用 Track4World 的设置:ADT、PointOdyssey、PStudio 三个数据集,298 个 clip-horizon case,每个 case 平均 16 帧和 50 帧两种设置;另外用 GameRealm[24] 的 45 个 clip(15 个源序列,每个 clip 256 帧)测长序列。指标是 2D/3D 的 APD(average position difference)和 AJ(average Jaccard),越高越好。
| 方法 | 单视角 2D APD | 单视角 2D AJ | 单视角 3D APD | 单视角 3D AJ | 多视角 2D APD | 多视角 2D AJ | 多视角 3D APD | 多视角 3D AJ |
|---|---|---|---|---|---|---|---|---|
| Track4World | 82.73 | 68.48 | 50.81 | 41.71 | 47.72 | 31.07 | 42.81 | 19.92 |
| MoSE3 | 70.23 | 57.41 | 56.47 | 46.97 | 45.48 | 26.17 | 53.55 | 31.29 |
| ARROW | 64.93 | 52.44 | 58.77 | 48.61 | 47.28 | 26.73 | 70.00 | 41.84 |
| CoWTracker | 87.42 | 72.42 | 55.97 | 46.68 | 28.53 | 14.55 | 41.07 | 14.27 |
| TAPIP3D | 76.90 | 61.76 | 55.68 | 44.83 | 57.03 | 32.32 | 61.91 | 29.18 |
| π⁴ | 86.38 | 72.43 | 57.33 | 47.68 | 56.41 | 35.07 | 65.01 | 33.70 |
表注:Track4World 只完成 37/45 条 GameRealm(Long)clip,8 条输出非有限值的 clip 被排除,其他方法均为 45/45;它的长序列项和 Average 覆盖不同,论文因此不对这些项排名。
单视角平均上,π⁴ 的 2D AJ 72.43 只比 CoWTracker 的 72.42 高 0.01,基本是并列;2D APD 86.38 低于 CoWTracker 的 87.42,排第二;3D APD 57.33、3D AJ 47.68 都排在 ARROW 之后(58.77、48.61)。多视角平均上,π⁴ 的 2D AJ 35.07 第一,2D APD 56.41 仅次于 TAPIP3D 的 57.03,3D 两项仍然低于 ARROW。论文的措辞是「competitive」,没有说全面 SOTA;这个结果也提醒我们,「轨迹贴着表面」和「3D 端点 APD 最高」不是同一个目标——前者是几何一致性,后者是逐点坐标精度。ARROW 直接回归 3D,在端点精度上仍有优势;π⁴ 赢在 2D 对应和长轨迹与重建表面的贴合。
3.4 运动物体分割
分割用 SegTrackv2、FBMS Test、YT-VOS19-M 三个数据集,指标是 region similarity 、contour accuracy 和平均 。π⁴ 的平均 是 85.04,排第二;GMOS[25] 87.48 第一,两者差 2.44 个点。单项上,π⁴ 在 SegTrackv2 的 是 83.42,略高于 GMOS 的 82.00;FBMS 的 86.49 低于 GMOS 的 92.45;YT-VOS19-M 的 83.83 也低于 GMOS 的 84.85。换句话说,掩码分支「有竞争力,但不是最强」,论文也没有把它包装成 SOTA。
| 方法 | SegTrackv2 J | SegTrackv2 J&F | FBMS J&F | YT-VOS19-M J&F | 平均 J | 平均 F | 平均 J&F |
|---|---|---|---|---|---|---|---|
| FlowSAM | 77.90 | 80.90 | 81.85 | 53.35 | 71.03 | 73.03 | 72.03 |
| SegAnyMo | 76.30 | 80.85 | 80.55 | 71.95 | 75.17 | 80.40 | 77.78 |
| GeoMotion | 77.30 | 80.80 | 75.50 | 65.55 | 71.73 | 76.17 | 73.95 |
| GMOS | 82.00 | 85.15 | 92.45 | 84.85 | 86.33 | 88.63 | 87.48 |
| GMOS-S | 78.90 | 82.40 | 83.95 | 81.60 | 81.10 | 84.20 | 82.65 |
| π⁴ | 83.42 | 84.80 | 86.49 | 83.83 | 84.91 | 85.18 | 85.04 |
3.5 消融与运行时间
| 设计 | 相对变化 | 读法 |
|---|---|---|
| 循环解码 + step conditioning | 局部点 −2.8%,相机 −10.2% | 相对无 step signal 的循环版本;相机受益更大 |
| 相机平移路径停梯度 | 相机 −10.9%,局部点 +0.2% | 切断点/相机梯度的串线,几乎不伤点 |
| 相对点损失权重 ×10 | 局部点 −5.4%,相机 −2.3% | 跨视角点一致性比单纯加点权重更有效 |
| 编码器微调 | 局部点 −8.1%,相机 −4.5% | 相对冻结编码器; 后期更差 |
| 精化器条件置零 / 噪声 | 归一化 XYZ L1 +8.77% / +7.47% | 没有图像信息,表面磨平但摆放变差 |
| 运动分支加几何条件 | EPE −7.17 px;大基线 −8.10 px | 几何特征提供空间上下文 |
| 编码器层 11+17 | 局部点/相机最好 | 论文比较了多种层组合,没有给逐项数字 |
| 相机头读 patch token | 比 register token 的局部点/相机损失低 | 早期等参数对比,没有给数字 |
运行时间方面,官方 inference guide 在 A800 80GB、512×288、开启跟踪、stride 1、单次前向、25 帧 warm-up 的条件下给了五个点:25 帧 4.13 GiB / 4.1 s,50 帧 5.22 GiB / 8.6 s,75 帧 7.26 GiB / 14.1 s,150 帧 12.03 GiB / 48.7 s,750 帧 33.99 GiB / 223.7 s。显存随帧数接近线性,时间超线性;750 帧的 34 GiB 还是在开了 expandable_segments 之后,默认分配器要 50.24 GiB。
四、局限性
论文自己承认了三条。相机—物体运动歧义:当前景在画面里占主导、背景纹理又弱时,π⁴ 会把运动前景当成静止的,把物体运动解释成相机运动,重建结果和静态背景不一致;数据侧的前景抑制只能减少这种依赖,不能根治。对坐标原点距离敏感:离重建原点越远的相机,位置误差越大,说明位姿精度和坐标表示、绝对平移的数值尺度有关;论文把「如何降低对原点选择和翻译幅度的敏感度」列为开放问题。精度和长序列泛化:π⁴ 并不总能追上传统几何优化方法,尤其是推理序列比训练序列更长时;在长度外推下保持全局一致的相机轨迹和重建仍然很难。
我自己再补几条,括号里标清楚是观察而不是论文结论:
- 总排名是「名次的平均」,不是每个指标都赢。 单目深度 panel 只排第三(3.50),RealEstate10K 的 R@5/A@5 略低于 Pi3X,跟踪的 3D APD/AJ 低于 ARROW,分割平均 J&F 低于 GMOS。π⁴ 的强项是「七类任务都有、且多数在前三」,不是「每一格都第一」。
- 度量尺度不是最强项。 均值 20.11 好于 MapAnything 25.10,但差于 Pi3X 16.92;7-Scenes 上 11.05 对 5.41 的差距不小。论文的度量尺度是「每序列一个标量」,对单图或短序列,这个标量的可观测性本来就弱。
- 3D 轨迹的误差会继承几何误差。 「按构造落在表面上」消除的是轨迹与几何之间的不一致,不是几何本身的误差;如果墙面重建偏了 0.12,轨迹会一致地贴在偏了 0.12 的墙面上。这是参数化的代价,也是为什么 Table 4 的 3D APD 没有全面超过 ARROW。
- 训练不可复现。 官方仓库明确写着「one fixed inference model, not a configurable training framework」,没有损失实现、没有数据采样代码、没有 300k+100k 的训练配置,论文也只给了损失项的符号而没有权重数值。要复现训练,只能从论文文字反推。许可证是 CC BY-NC 4.0,代码和权重都不允许商用。
- 「1000+ 图像」是定性说法。 定量的是 750 帧(33.99 GiB / 223.7 s)和 Oxford Spires 的 6 条 361–800 帧路线;Figure 1 里超过 1000 张图的场景没有对应的精度/显存曲线。训练最多 64 视角,推理到 750 帧已经是 10 倍以上的长度外推,论文自己的局限里也承认长序列泛化仍有挑战。
- 掩码不参与几何和跟踪。 官方文档明确说 moving-object masks do not gate geometry or tracking;这意味着前景运动对几何的影响只能靠数据分布去学,推理时没有一个「把动态区域遮掉再重建」的机制。对动态占主导的场景,这是一个结构性的风险。
- 没有附录。 论文正文到第 19 页就结束,后面是参考文献;损失权重、置信度目标的具体形式、数据采样的实现细节都没有展开。对一篇主打「data and training recipe」的论文来说,这部分信息的缺失比模型结构更影响复现。
五、结论与展望
π⁴ 的故事线其实很短:几何模型回答「表面在哪」,运动模型回答「像素去哪了」,π⁴ 让后者在前者的坐标系里回答。它没有把 3D 跟踪做成一个独立的回归头,而是把「对应」和「提升」拆开:对应留在图像空间,提升交给几何。这个拆分的直接收益是轨迹和重建表面的一致性,以及长序列上不需要额外的 3D 轨迹记忆;代价是 3D 端点精度受几何误差约束,3D APD/AJ 没有全面超过直接回归的 ARROW。
如果要在实际项目里用它,我会这样选:
- 需要无标定、长序列、几何 + 稠密轨迹一起出:π⁴ 是目前最省事的一档,750 帧一次前向,34 GiB 显存,不用切窗口。
- 只需要最强度量尺度:先和 Pi3X 比一下 7-Scenes / NRGBD 的数字,π⁴ 不一定赢。
- 只需要最高 3D 端点精度:ARROW 在 Table 4 的 3D APD/AJ 上仍更高;π⁴ 的优势是长轨迹贴着表面,不是单点坐标。
- 只需要运动物体分割:GMOS 的平均 J&F 仍高 2.4 个点;π⁴ 的掩码是「顺手一起出」的并行输出,不是专门优化的分割器。
- 要商用:不行,CC BY-NC 4.0;要商用得重新训练或找替代。
未来几个方向在论文里已经点出来了:相机—物体运动解耦、对坐标原点不敏感的位姿参数化、更长序列的泛化。我还会加一条:把训练代码和损失权重放出来。π⁴ 的 inference-only 仓库已经把「能跑」做得很好(严格加载、显存表、viewer、导出格式都写清楚了),但「能复现」还差训练那一半。
六、上手
官方仓库是一个固定的推理包,不是可配置的训练框架;文档第一句就写了「This repository contains one fixed inference model, not a configurable training framework」。下面的命令都来自 README / inference guide,已在 A800 80GB、Python 3.11.15、PyTorch 2.12.1 + CUDA 12.6、Triton 3.7.1 上验证过。环境要求 Linux x86-64、支持 BF16 的 NVIDIA GPU、CUDA 12.6 驱动、Git 和 C 编译器(FlexGEMM 和 Triton 运行时编译要用)。
安装命令(Python 3.11 + CUDA 12.6)
conda create -n pi4 python=3.11 -y
conda activate pi4
python -m pip install --upgrade pip
python -m pip install -r requirements-cu126.txt
python -m pip check
python -c "import torch; assert torch.cuda.is_available(), 'CUDA is not available'; print(torch.__version__, torch.version.cuda)"
快速上手是 150 帧的花样滑冰,512×288、stride 1、开启跟踪,一次前向大约 12.03 GiB。跑完用自带 viewer 在浏览器里看重建、相机轨迹和点轨迹;viewer 只需要 Python 标准库和打包好的 Three.js,不需要 GPU。
150 帧快速上手 + 本地 viewer
python example.py examples/figure_skating.mp4 \
  --output outputs/quickstart \
  --query-frame 0 --stride 1 --max-frames 150 --viewer
python viewer/serve.py outputs/quickstart --port 8080
要复现论文/项目页的完整 750 帧 demo,去掉 --max-frames,并加 PYTORCH_ALLOC_CONF=expandable_segments:True:
完整 750 帧、一次前向(需要 40 GB 级显存)
PYTORCH_ALLOC_CONF=expandable_segments:True \
  python example.py examples/figure_skating.mp4 \
  --output outputs/figure_skating_full \
  --query-frame 0 --stride 1 --viewer
python viewer/serve.py outputs/figure_skating_full --port 8080
Python API 更直接:输入 [B,T,3,H,W]、RGB、[0,1],高宽必须是 16 的倍数;跟踪至少两张图,query_frame 可以是标量或 [B] 的整数张量;省略 query_frame 就只出几何。
Python API 最小示例
import torch
from pi4 import Pi4
from pi4.io import load_images

model = Pi4.from_pretrained("yyfz233/Pi4").cuda().eval()
frames, metadata = load_images(
    "examples/figure_skating.mp4", stride=1, max_frames=25, max_size=512
)
images = torch.from_numpy(frames.copy()).permute(0, 3, 1, 2)
images = images.float().div(255).unsqueeze(0).cuda()

prediction = model(images, query_frame=0)
输出键和形状如下。注意 tracks_3d 已经是预测度量世界坐标,local_points 和相机平移还是模型原生尺度;图像外的 3D 轨迹是 NaN;可见性是单独的概率,不用来「猜」遮挡后的位置。
| 输出 | 形状 | 含义 |
|---|---|---|
local_points | [B,T,H,W,3] | 每相机坐标系下的局部 XYZ,原生尺度 |
camera_poses | [B,T,4,4] | camera-to-world 位姿,原生尺度 |
metric_scale | [B] | 序列级正标量,转到预测度量单位 |
confidence | [B,T,H,W] | 几何置信度概率 |
tracks_2d | [B,T,H,W,2] | 每个查询像素在目标帧的 XY,半像素中心 |
tracks_3d | [B,T,H,W,3] | 提升到重建表面的度量世界坐标 |
visibility | [B,T,H,W] | 跟踪可见性概率 |
tracking_confidence | [B,T,H,W] | 跟踪准确度概率,区别于几何置信度 |
dynamic_mask | [B,T,H,W] | 与查询无关的运动物体概率,序列级语义 |
query_frame | [B] | 查询帧索引 |
权重从 yyfz233/Pi4 自动下载并严格加载(strict=True),也可以传本地 model.safetensors 或目录。推理必须用 CUDA,因为稀疏 3D 精化走 FlexGEMM;没有 CPU 回退。官方明确说没有自动 OOM 重试、没有隐藏的时间分块、没有分辨率降级——显存不够就减帧数。代码和权重都是 CC BY-NC 4.0,不能商用。
参考
- Wang, Zhao, Yang, Guo, Dong, Zhang, Shen. π⁴: A Foundation Model for 4D Scene Geometry and Motion. arXiv 2611.23144, 2026. arXiv · 代码
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- Wang, Zhou, Zhu, Chang, Zhou, Li, Chen, Pang, Shen, He. π³: Permutation-Equivariant Visual Geometry Learning. arXiv 2507.13347, 2025. arXiv · 代码
- Keetha, Müller, Schönberger, et al. MapAnything: Universal Feed-Forward Metric 3D Reconstruction. 3DV 2026. arXiv · 代码
- Lin, Chen, Liew, Chen, Li, Shi, Feng, Kang. Depth Anything 3: Recovering the Visual Space from Any Views. arXiv 2511.10647, 2025. arXiv · 代码
- Wang, Chen, Zhang, Karaev, Schönberger, Labatut, Bojanowski, Novotny, Vedaldi, Rupprecht. VGGT-Ω. arXiv 2605.15195, 2026. arXiv
- Doersch, Yang, Vecerik, Gokay, Gupta, Aytar, Carreira, Zisserman. TAPIR: Tracking Any Point with Per-Frame Initialization and Temporal Refinement. ICCV 2023. arXiv · 代码
- Karaev, Makarov, Wang, Neverova, Vedaldi, Rupprecht. CoTracker3: Simpler and Better Point Tracking by Pseudo-Labelling Real Videos. arXiv 2410.11831, 2024. arXiv · 代码
- Lai, Insafutdinov, Sucar, Vedaldi. CoWTracker: Tracking by Warping instead of Correlation. arXiv 2602.04877, 2026. arXiv
- Lu, Xu, Hu, Zhu, Zhao, Yeung, Shan, Liu. Track4World: Feedforward World-Centric Dense 3D Tracking of All Pixels. arXiv 2603.02573, 2026. arXiv
- Fradlin, Schmidt, Piekenbrinck, Knaebel, Garcia, Leibe. ARROW: Arbitrary Reconstruction and Tracking of 4D Observations in the Wild. arXiv 2610.01314, 2026. arXiv
- Cheng, Li, Xia, Cai, Du, Wang. MoSE3: Learning World-Space SE(3) at Every Pixel. NeurIPS 2026. arXiv · 代码
- Siméoni, Vo, Seitzer, et al. DINOv3. arXiv 2508.10104, 2025. arXiv · 代码
- Zhang, Keetha, et al. UFM: A Simple Path towards Unified Dense Correspondence with Flow. NeurIPS 2025. arXiv · 代码
- Edstedt, Nordström, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Kong, Li, Wang, Xu, Yao, Xiang, Yang. MoGe-3: Fine-Detail Monocular Geometry Estimation with Self-Guided Sparse Volumetric Refinement. arXiv 2607.17967, 2026. arXiv
- Ravi, Gabeur, Hu, Hu, et al. SAM 2: Segment Anything in Images and Videos. arXiv 2408.00714, 2024. arXiv · 代码
- Knaebel, Garcia, Schmidt, Fradlin, Nunes, de Geus, Leibe. SurGe: Improved Surface Geometry in Point Maps. NeurIPS 2026. arXiv · 代码
- Wang, Xu, Dong, Deng, Xiang, Lv, Sun, Tong, Yang. MoGe-2: Accurate Monocular Geometry with Metric Scale and Sharp Details. arXiv 2507.02546, 2025. arXiv · 代码
- Tao, Muñoz-Bañón, Zhang, Wang, Fu, Fallon. The Oxford Spires Dataset: Benchmarking Large-Scale LiDAR-Visual Localisation, Reconstruction and Radiance Field Methods. IJRR 2025. arXiv
- Burzio, Fischer, Elflein, Zhou, et al. Déjà View: Looping Transformers for Multi-View 3D Reconstruction. arXiv 2605.30215, 2026. arXiv
- Zhao, Wang, Yang, et al. GameRealm: Grounding Visual Learning in Interactive Games. arXiv 2611.23140, 2026. arXiv · 代码
- Xie, Han, Xie, Zisserman. GMOS: Grounding Moving Object Segmentation in 3D Space and Time. arXiv 2605.30352, 2026. arXiv