· updated Jan 27, 2025 · 13 min read
理解 LSTM 网络【译】
本文是我对大神Christopher Olah的Understanding LSTM Networks的译文。
循环神经网络(Recurrent Neural Networks)
人们并非每时每刻都在大脑一片空白时开始思考。当我们读这篇文章的时候,我们会根据之前学习的知识来理解当前你在阅读的内容。我们不是把原来的知识丢得一干二净来重新学习,我们的记忆有一定的持久性。传统的神经网络做不到这些,这是它的一大缺陷。比如说,可以想象有这样一种情况,我们想知道一部电影的每一帧画面正在发生什么。使用传统的神经网络很难通过理解电影之前的画面来推断以后将要发生的事件。(传统的神经网络不能处理带有时序的样本)循环神经网络(Recurrent Neural Networks)尝试解决了以上问题。这种网络是一种带有循环结构的网络,可以使得信息得以持久保持。
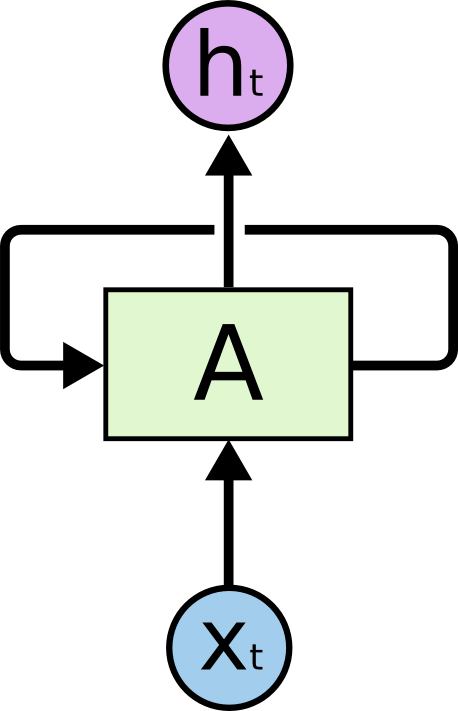
上图是一个 RNN 模块,读取输入,同时输出,这个循环允许信息从网络的当前步骤传递到下一步骤。上述过程把 RNN 的过程讲得有些神秘感。但是,如果我们仔细想想,这也不比一个正常的神经网络难以理解。一个 RNN 可以看成是多个相同网络的拷贝,每一个拷贝都会向后续网络传递信息,下图我们把 RNN 展开。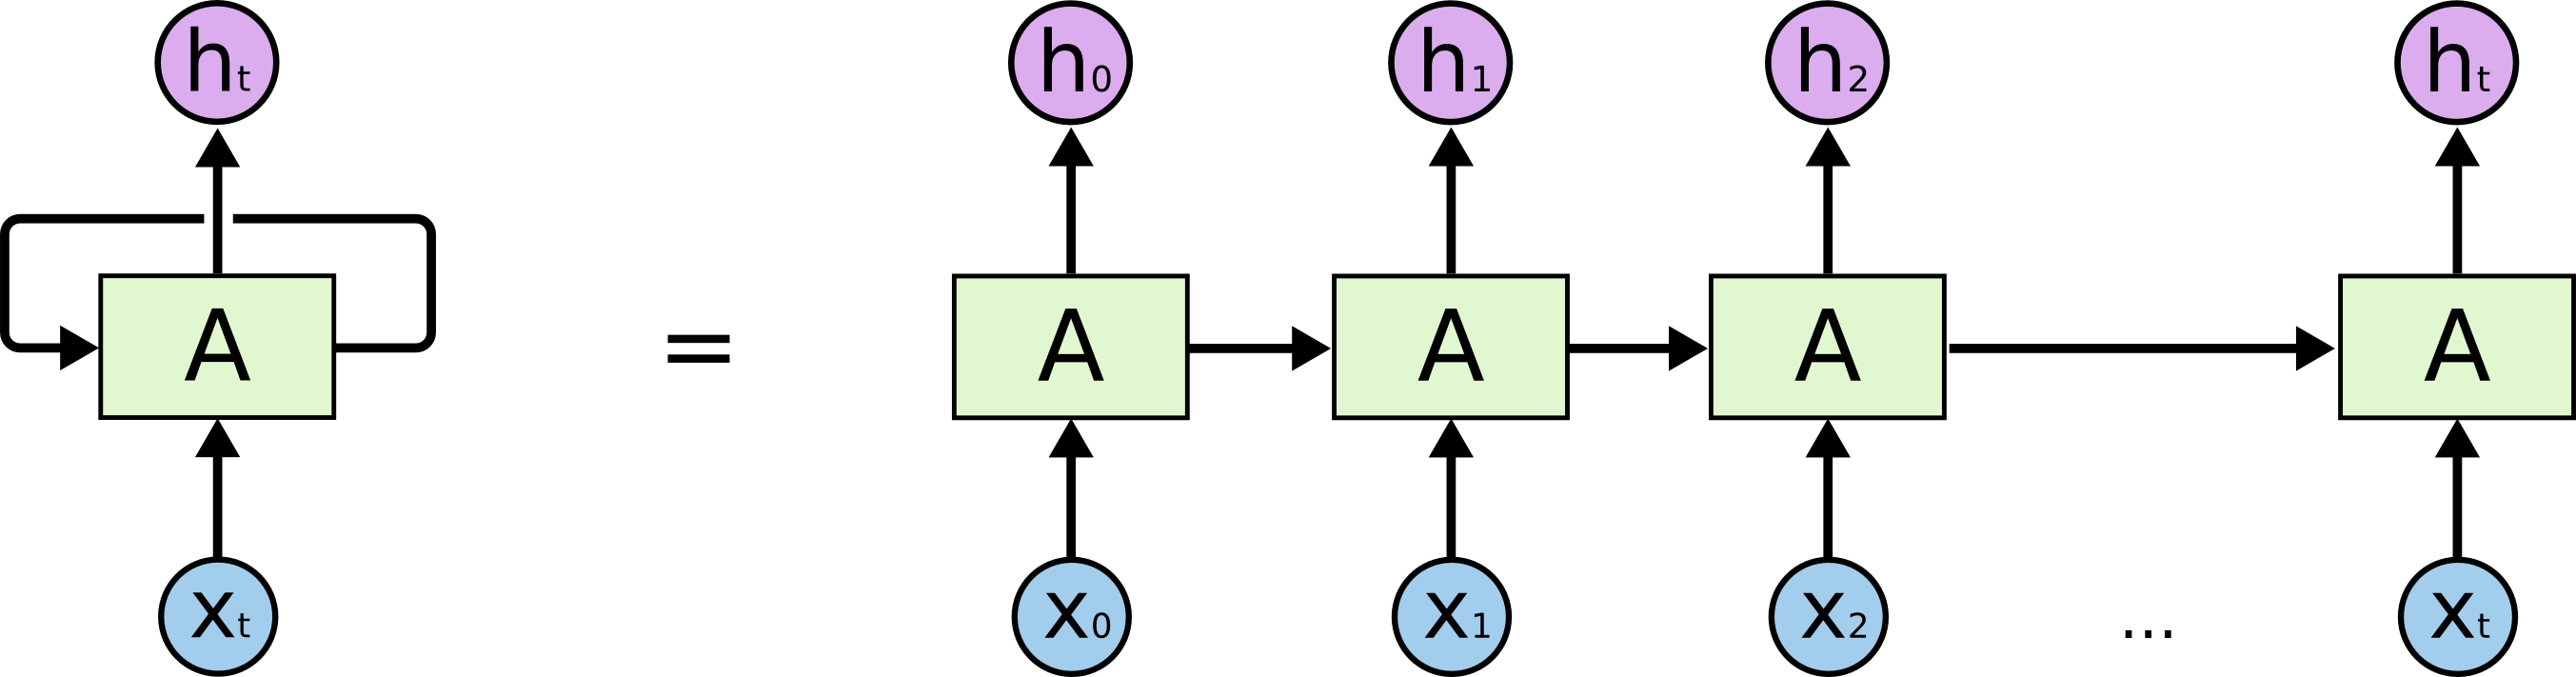 这种链式的特性揭示了 RNN 与序列和列表有关,RNN 是对这些数据最自然的表达。RNN 目前已经被广泛使用!在过去的几年间,RNN 在很多领域都有着出色的表现:语音识别,语言建模,翻译,图像描述……推荐大家阅读大神 Andrej Karpathy 的博文The Unreasonable Effectiveness of Recurrent Neural Networks,来领略下 RNN 的诸多应用,这简直不能太棒!以上的成功案例离不开使用长短期记忆(LSTM: Long Short Term Memory)网络,这是一种特殊的 RNN 网络并且能够应对更多任务,相比于标准的 RNN 网络,它具有更为出色的表现。几乎所有的 RNN 都是基于 LSTM 来实现的,接下来我们讨论下 LSTM 的奥义。
长期依赖(Long-Term Dependencies)问题
RNNs 的要求之一就是它能够连接之前的信息到当前的任务之上,例如利用之前的视频帧来理解当前帧的内容。如果 RNNs 能够做到这一点的话,它将会超级有用。但是它真的可以吗?看情况而定。有时,我们仅仅需要离当前任务最近的几个任务信息。例如,我们有一个语言模型,它的目标是根据当前已有的词语去预测接下来将要出现的词语。如果我们尝试去预测“the clouds are in the sky”中的最后一个单词,我们不需要任何更多的语料,很明显最后一个单词将会是“sky”。在这种情况下,相关信息和当前需要预测词的位置的间隔是非常小的,这时 RNNs 可以去利用过去的信息。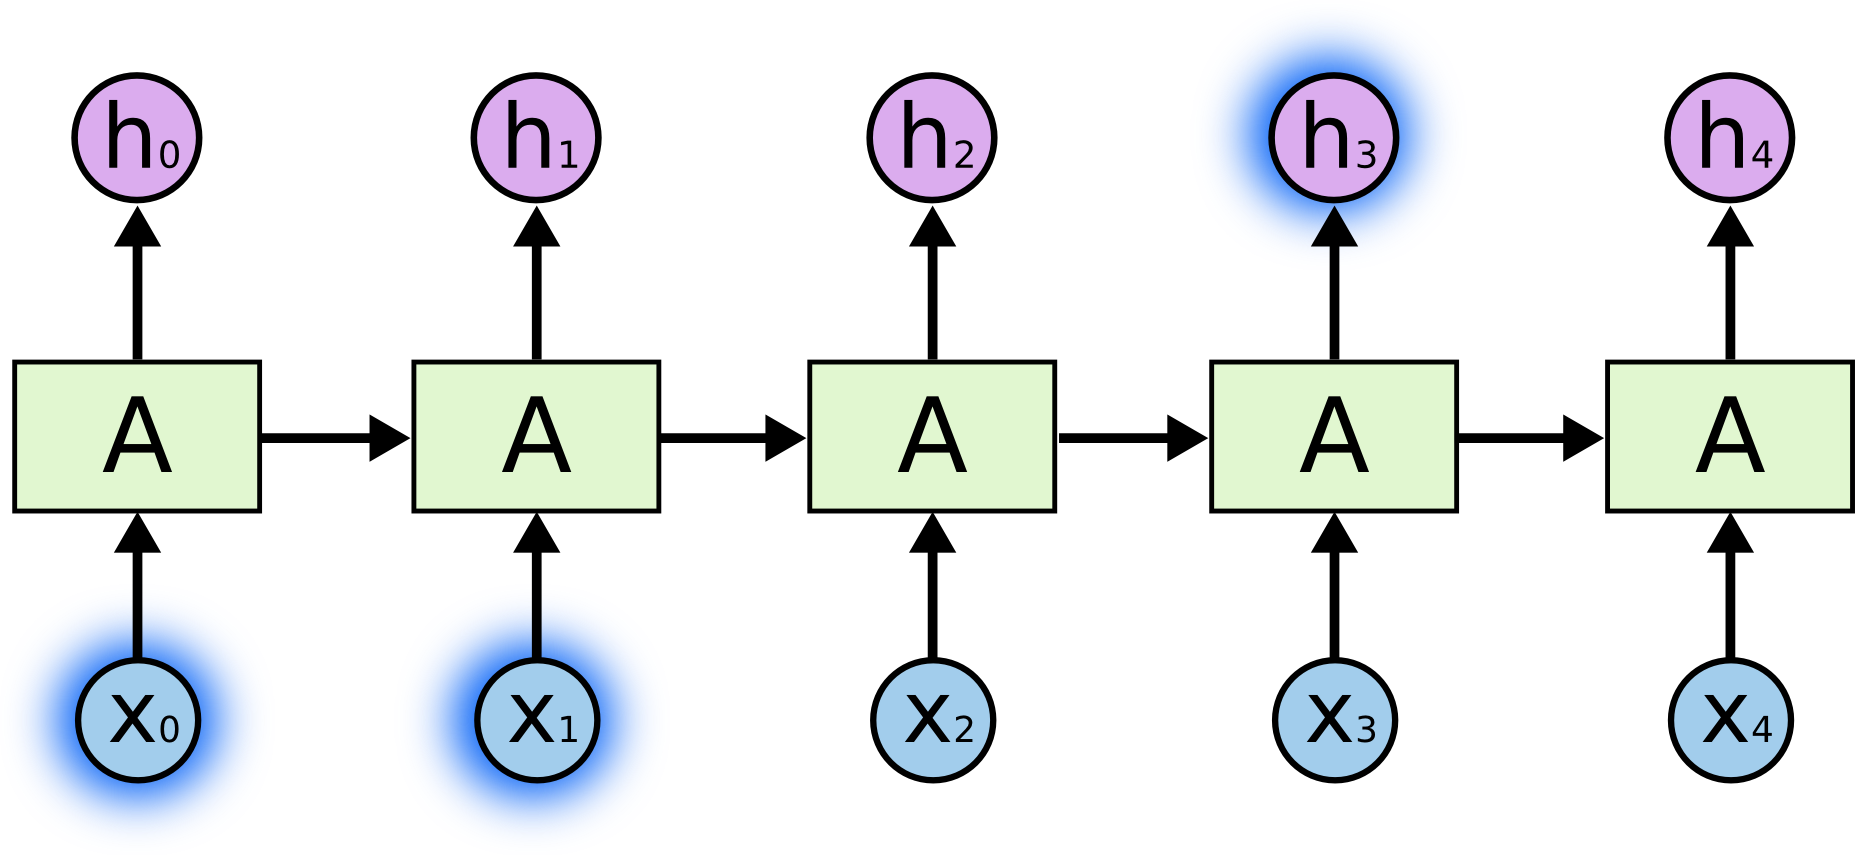 但是也有一种情况是,我们需要更多的信息才能够做预测。例如我们的语言模型需要预测下面句子的最后一个单词“I grew up in France… I speak fluent French.”。从相邻近的几个单词可以推断最后一个单词可能是一种语言,但如果我们想要知道到底是哪种语言的话,我们需要句子最前面的一个单词“France”。这会使得相关信息以及需要预测词的位置的间隔变得很大。遗憾的是,随着间隔的逐渐增大,RNNs 不能够去关联有用的信息。
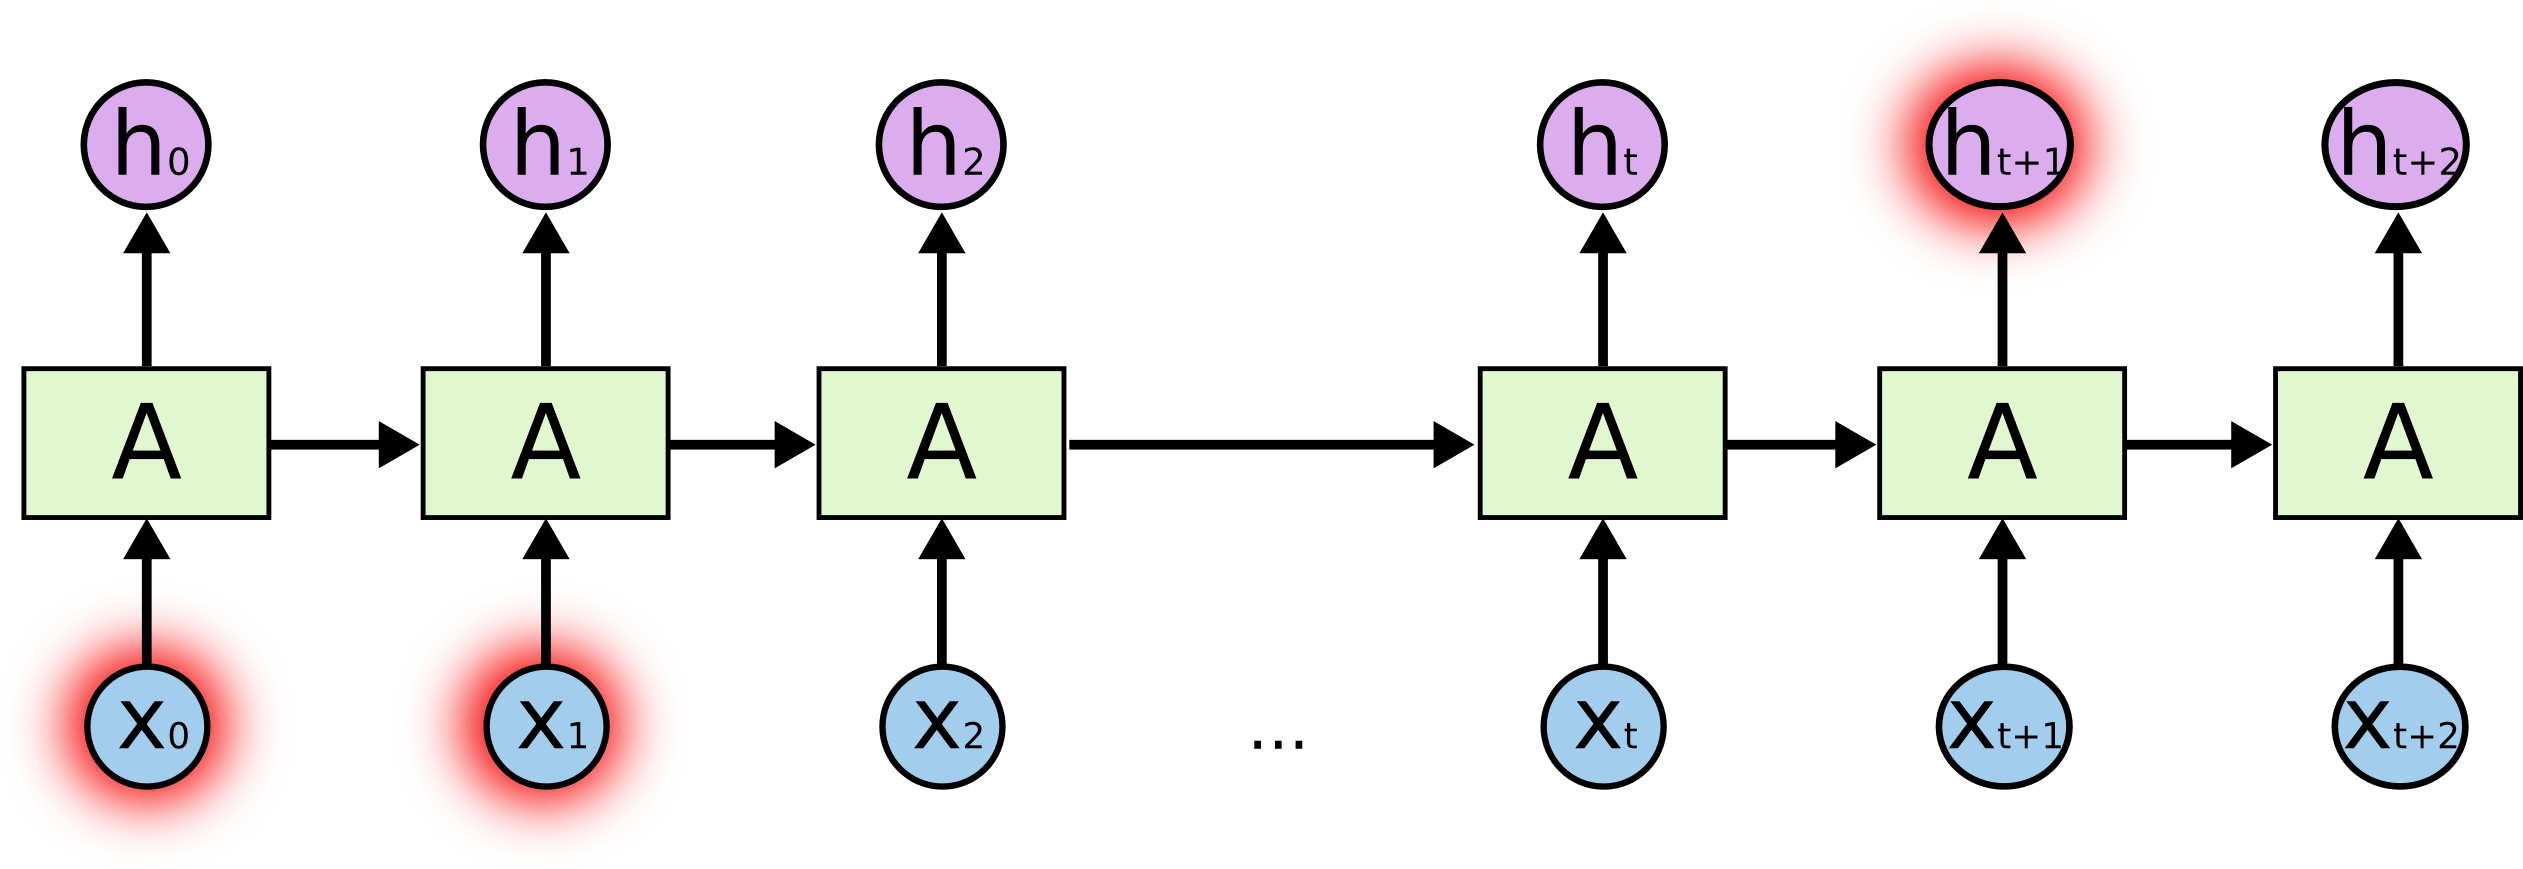 在理论上,RNNs 能够解决长期依赖的问题。人们可以通过仔细选取参数来解决这类问题。但是实际上 RNNs 并不能去解决这个问题。Hochreiter (1991) [German] and Bengio(1994)等人深入研究了该问题为何如此艰难。阿弥陀佛,LSTMs 并没有上述问题。
LSTM 网络
长短期记忆网络——经常被叫做“LSTM”——是 RNN 的这一种特殊的形式,它能够解决长期依赖的问题。LSTM 是由Hochreiter & Schmidhuber (1997)提出,并由很多后来者完善以及推广。LSTM 能够在很多问题上取得优秀的结果,现如今被广泛引用。LSTM 被设计成防止长期依赖问题的发生。在实践中,LSTM 的长期记忆是默认行为,而并非艰苦习得!所有的 RNN 都有链式重复的神经网络模块。在标准的 RNN 中,这些重复的模块仅仅有简单的结构,例如层。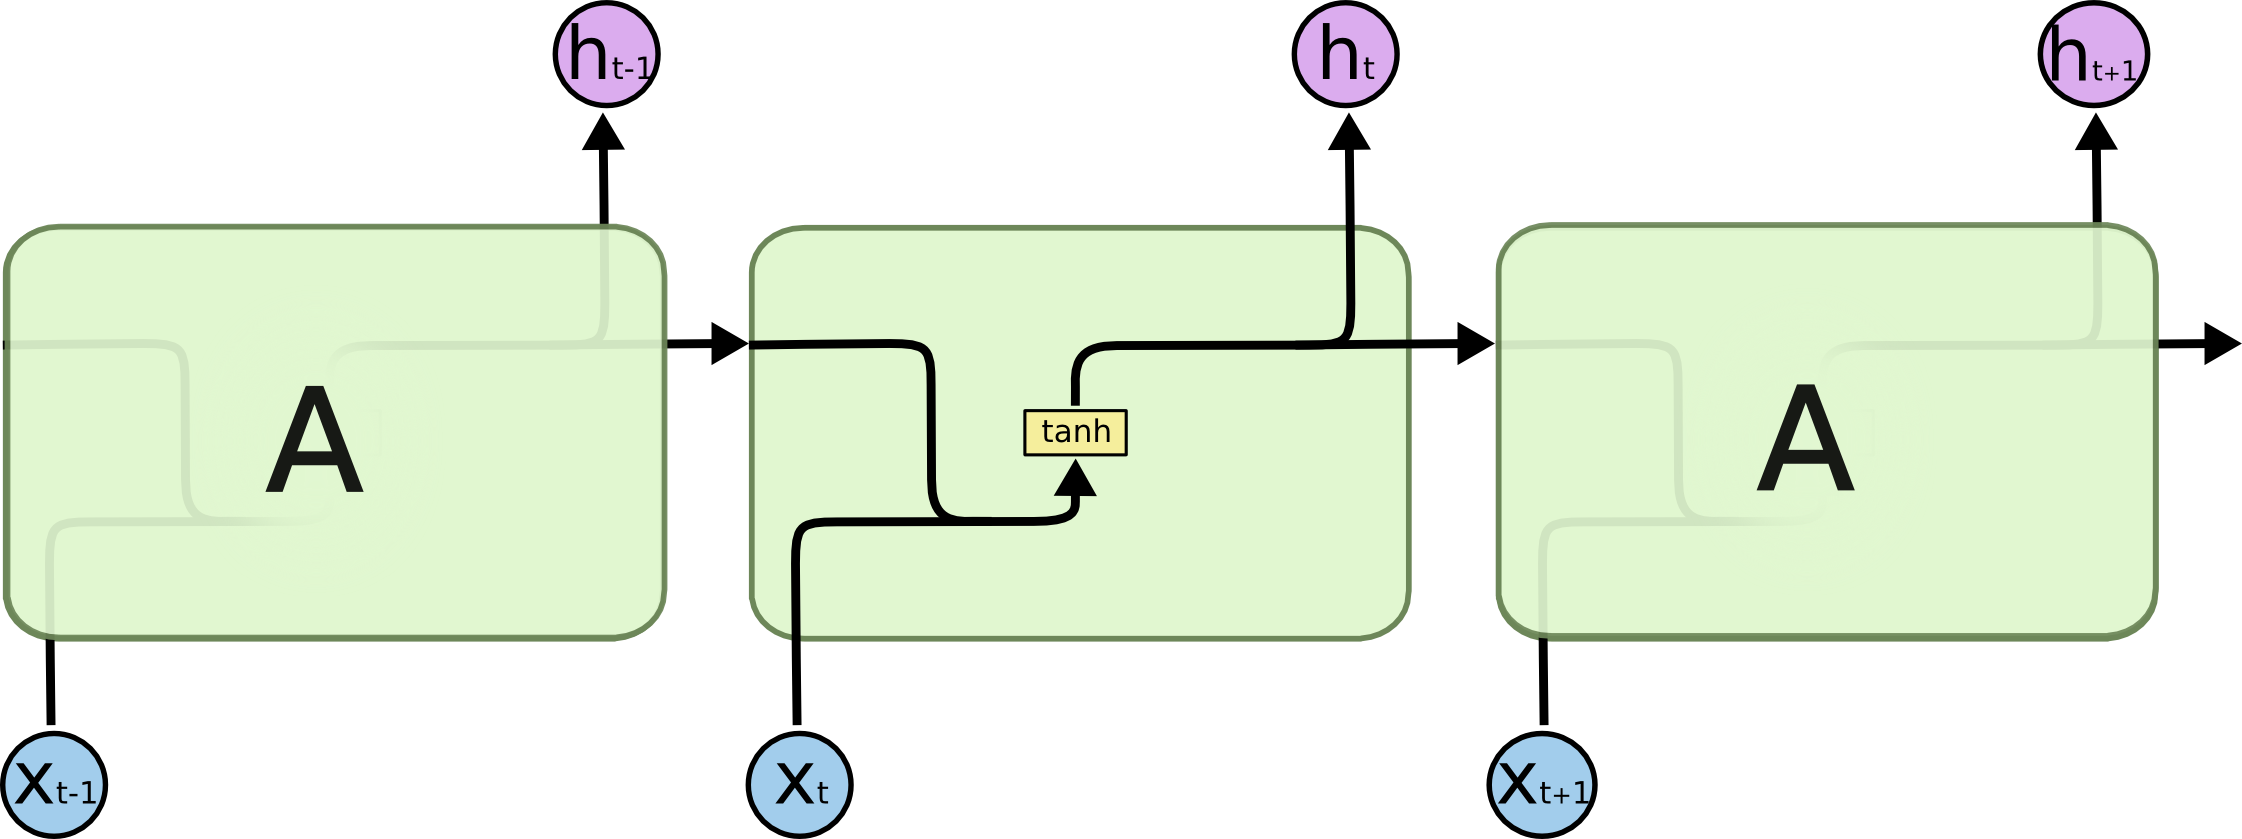 当然,LSTM 中也存在这样的链式结构,但是其中的重复模块就大为不同了。LSTM 的重复的模块中包含 4 种不同的层,它们以一种特殊的结构交错着。
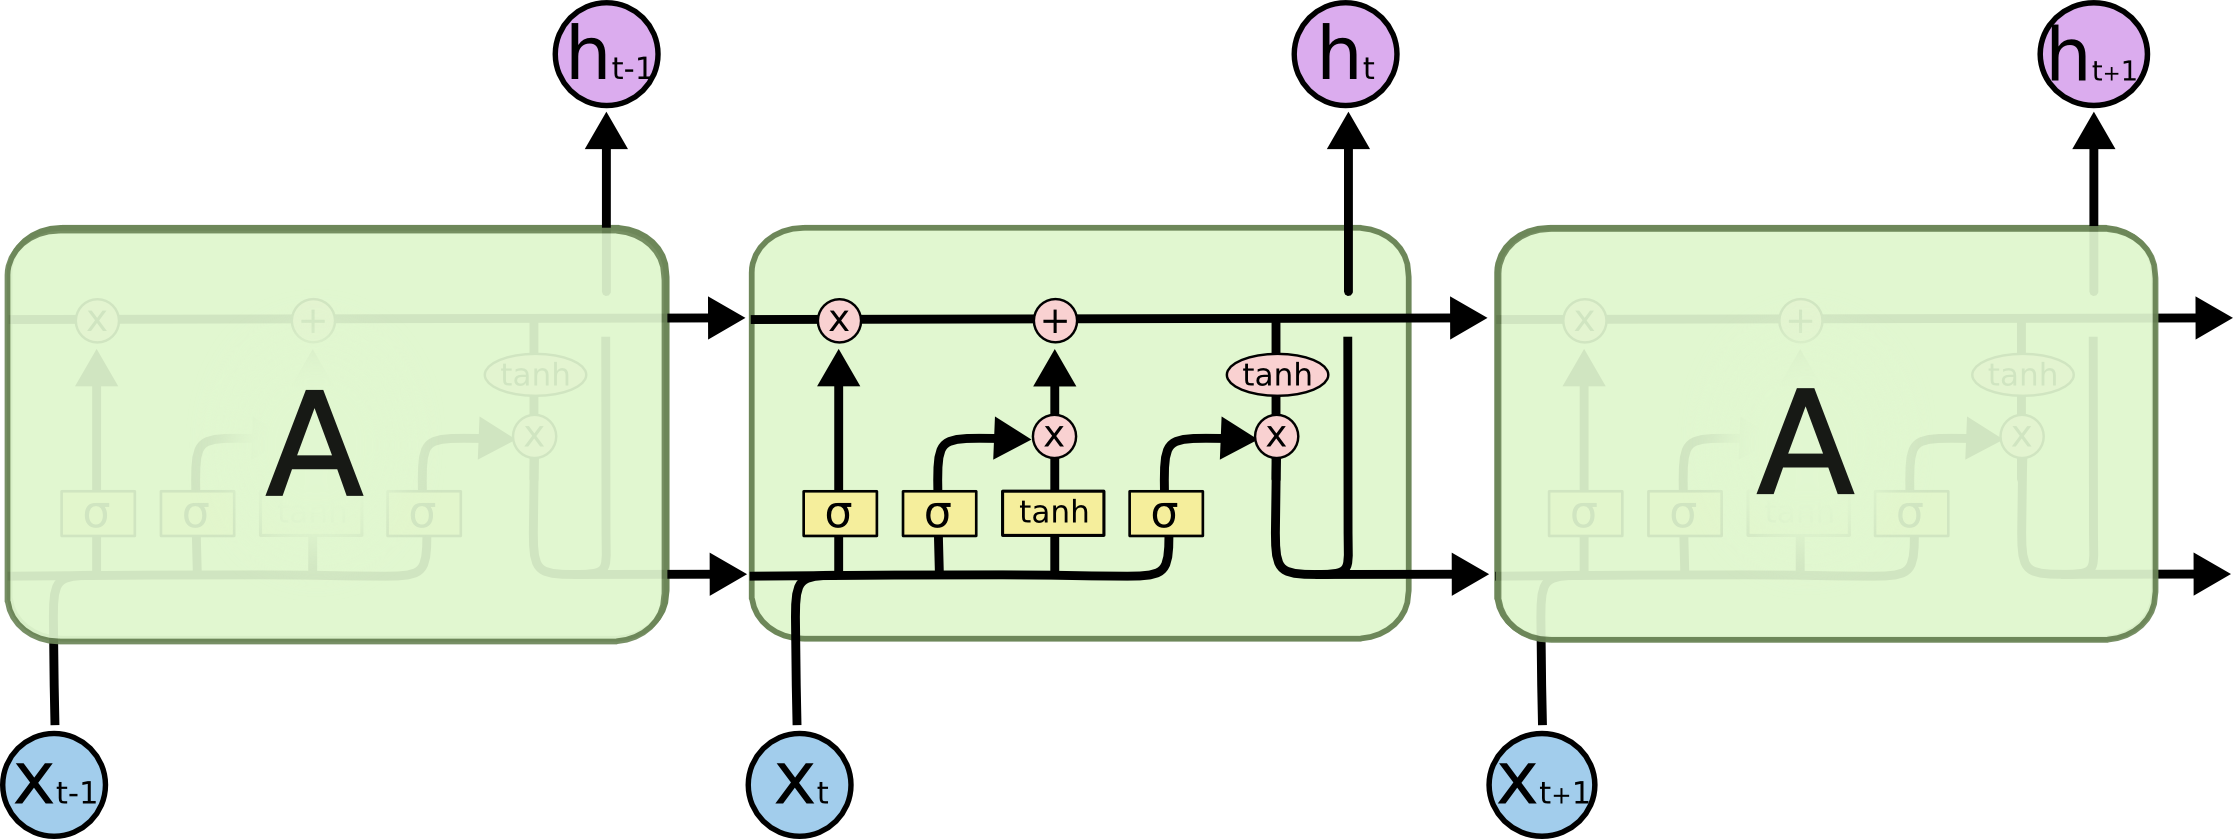 看不懂,不用担心,细节即将展开。接下来,我们会一步步来讲解 LSTM 的网络结构。首先我们先明确几个会经常用到的表示方法。
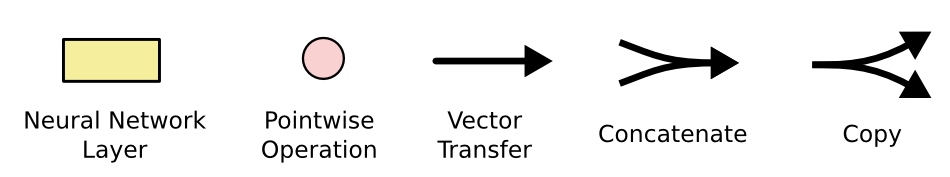 在以上的图示中,每条实线传输着整个向量,从一个节点的输出到其他节点的输入。粉红色的圆圈表示的是逐点操作,例如向量的加法,黄色的方形表示已经学习了的网络层。汇集的线表示串联,分叉的线表示复制操作,这些复制的内容流向不同的位置。
LSTM 背后的核心技术
LSTM 的关键技术在于细胞(cell)状态,也就是图表中最上方水平穿行的直线。细胞状态可以理解成是一种传送带。它仅仅以少量的线性相交,贯穿整个链式结构上方。信息沿着这条传动带很容易保持不变。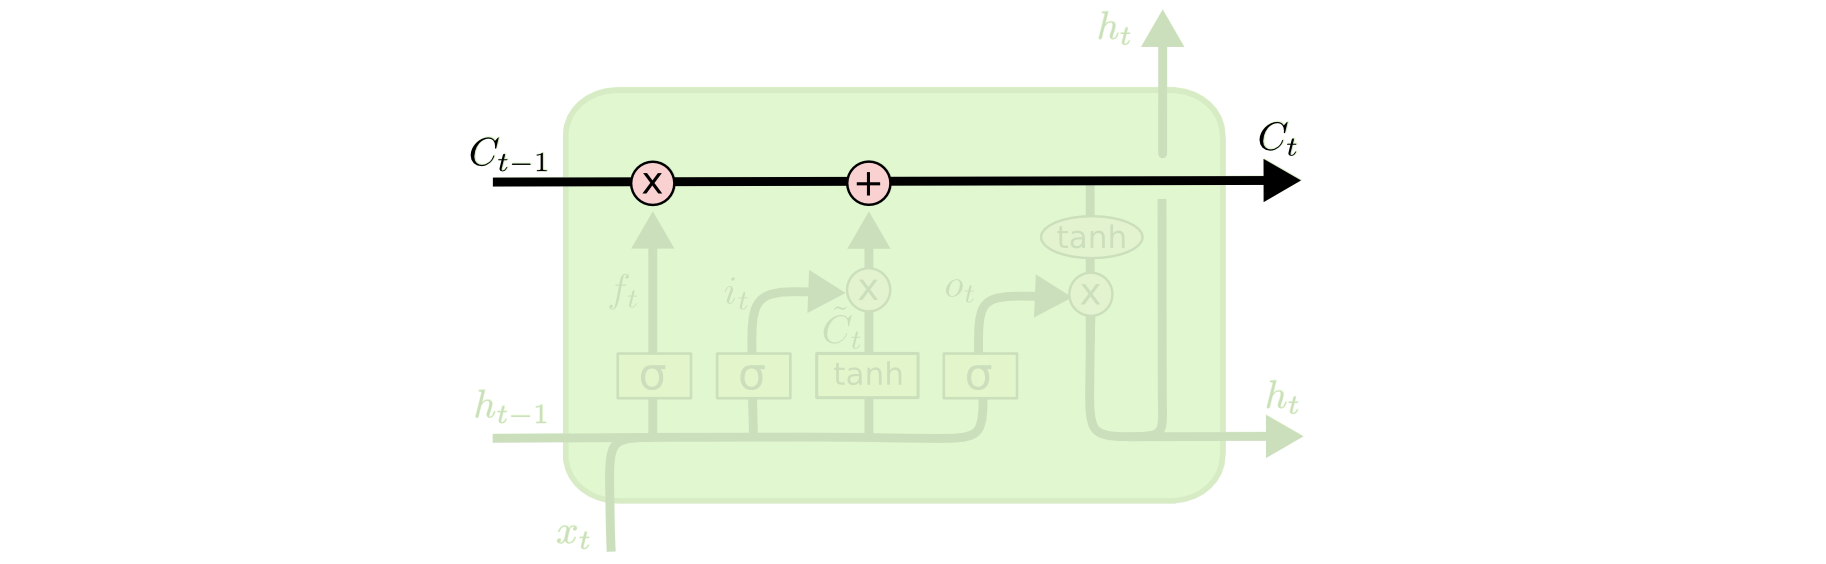 LSTM 有一种能向细胞增加或者移除信息的能力,这种经过精心设计的结构称作门(gates)。所谓的门就是一种让信息选择性通过的方法。它是由一个层和一个逐点乘法单元构成。如下图:
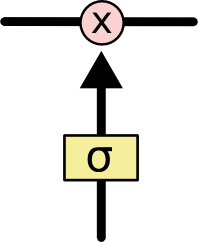
层的输出是-之间的数字,它描述了每个部分可以有多少量能够通过。代表“啥都不能通过”,代表“啥都能通过”!一个 LSTM 有三种这样的门结构,用来保证以及控制细胞状态。
逐步理解 LSTM
LSTM 的第一步是来决定啥信息将要从细胞状态中丢弃。这个决定是由一个叫做“遗忘门”(“forget gate layer”)的层来决定。它的输入是和,输出是一个介于到之间数值,给每个在状态的数值。表示“完全保留”,表示“完全丢弃”。让我们回到之前的语言模型的例子中,我们还是基于以前的词语来预测后续的单词。在这样一个问题中,细胞状态可能会包含当前主语的性别信息,所以正确的介词将会被使用。当我们看到一个新的主语时,我们要遗忘掉旧的主语。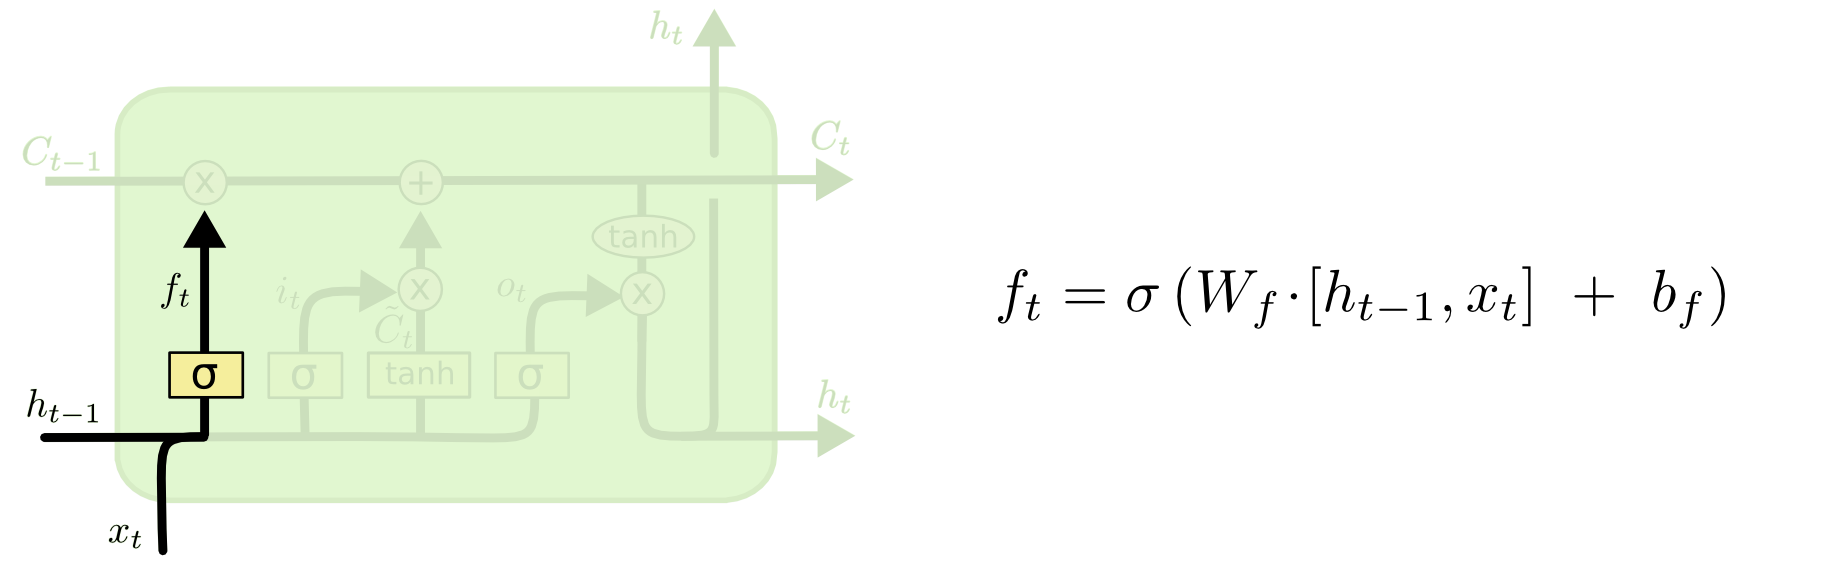
下一步就是决定啥新信息将要存储在细胞状态中。这包括两个方面。第一,一个叫做“输入门层”的层来决定哪些值我们要更新;第二,一个层创造了新的候选值,这个值将会加入到新的状态中去。进一步,我们要把上述两个方面结合起来来更新细胞状态。在我们的语言模型中,我们想要在新的主语对应的细胞状态中加入性别信息,去代替我们遗忘掉的那个旧主语状态。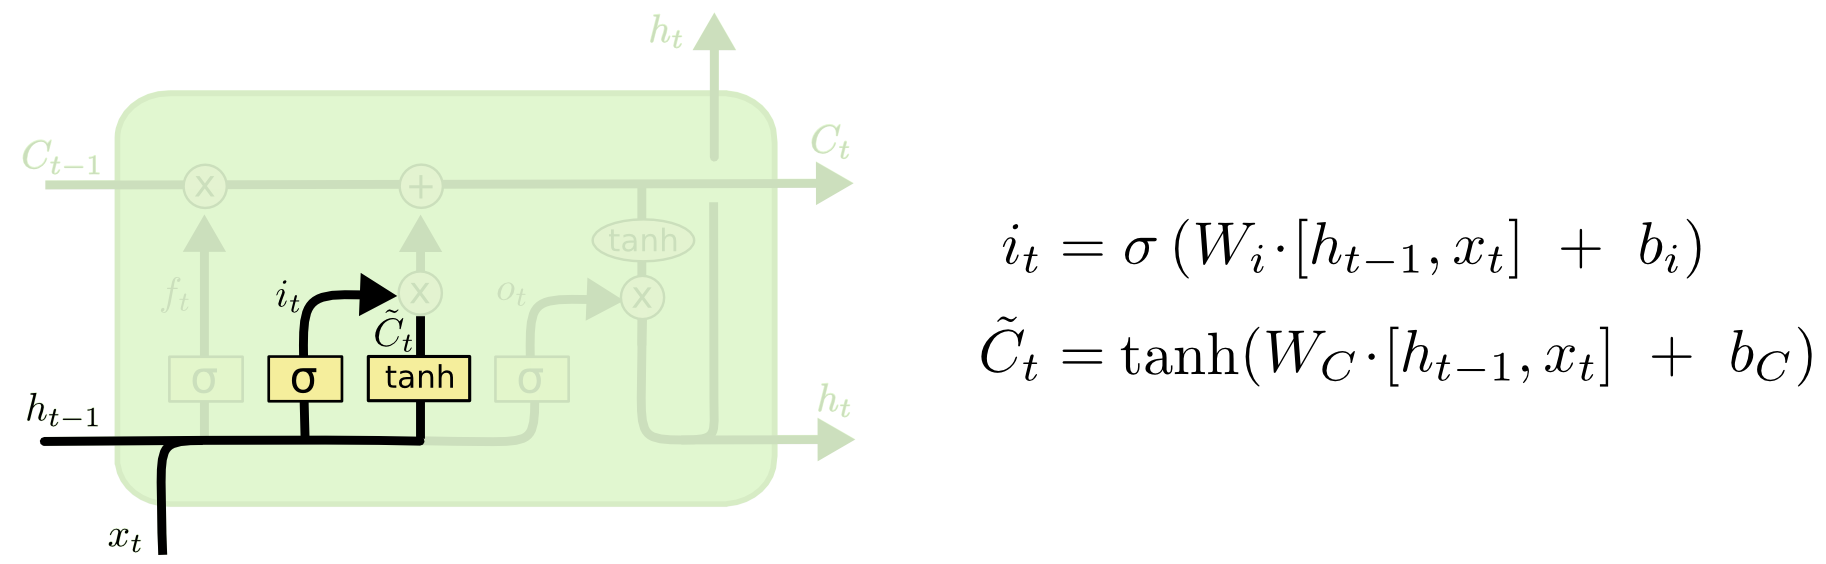
我们现在更新旧的细胞状态,从状态到状态。上述步骤已经详述了具体如何操作,我们现在就开始更新!我们将旧的细胞状态乘以,目的是忘记我们要忘记的旧状态。然后我们加上,这就是我们创造新的候选值,这个值根据我们想要更新每个状态值的程度进行伸缩变化(这就是的意义)。在我们的语言模型中,这就是我们根据最开始确定的目标,丢弃旧主语性别以及增加新主语信息的地方。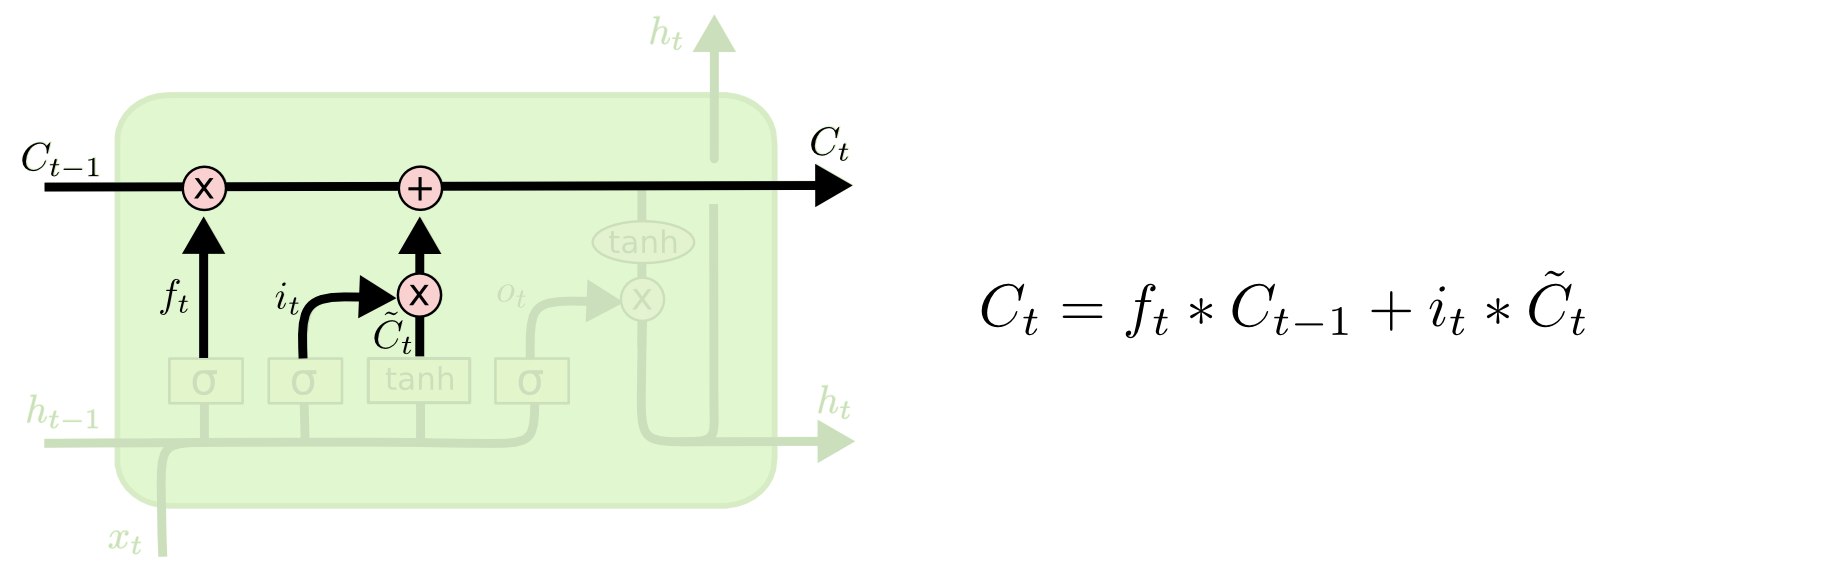
最后一步我们要决定到底输出什么信息。这个输出信息会基于细胞状态,但将会是一个经过过滤后的结果。首先,我们用一个层去决定细胞状态的哪一部分将会被输出。然后,我们将细胞状态通过(将其值规范到到之间)。最后我们将这个值与输出相乘,这样我们仅仅输出我们想要输出的部分。还是对于之前提到的语言模型,因为它只看到了一个主语,它可能会输出一个与动词相关的信息。例如,可能输出这个主语是单数还是复数,所以我们会知道紧跟的动词是何种形式。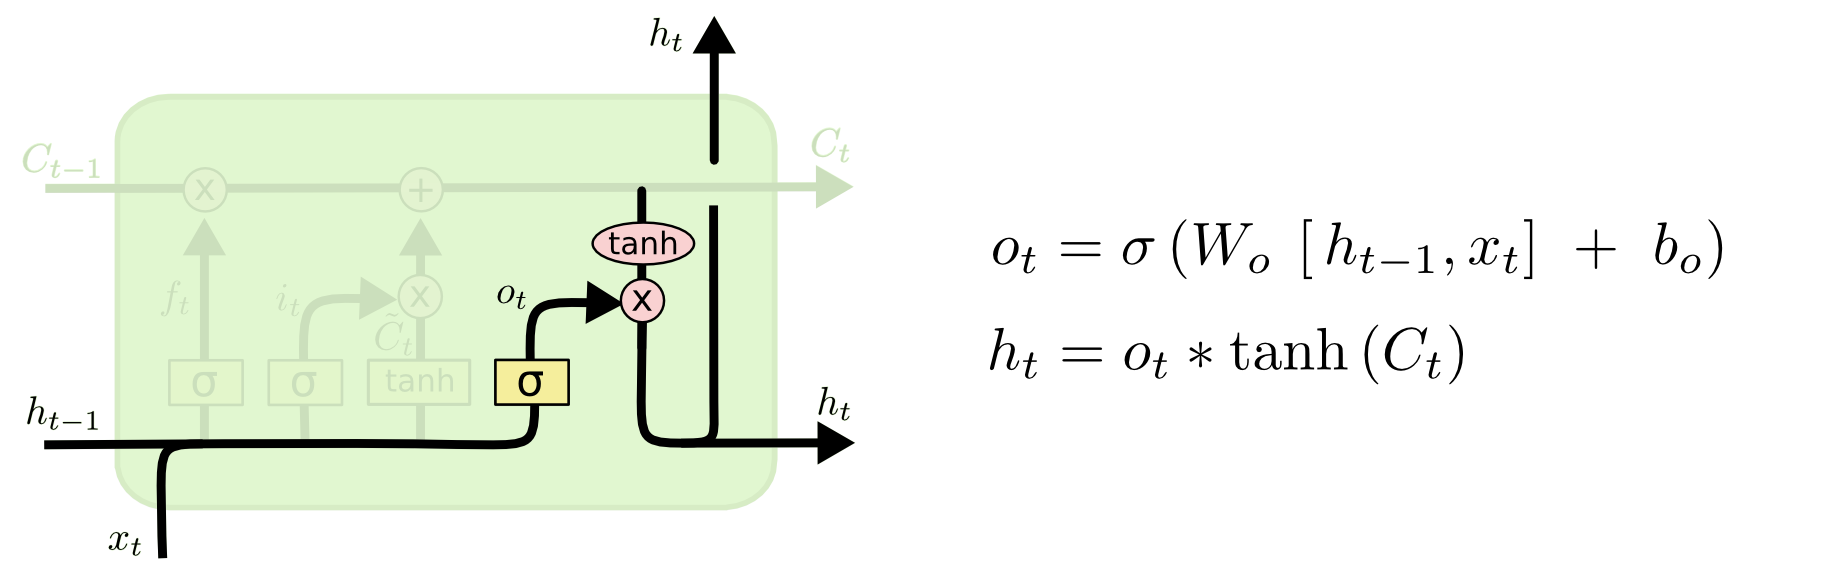 至此,基本的 LSTM 介绍完毕。
LSTM 的变体
我们以上描述的均是最为普通的 LSTM。但是并不是所有的 LSTM 都是以上那个样子。事实上,似乎每一篇涉及 LSTMs 的论文均对其做了细微的修改。其中的差别不大,以下列举几种 LSTM 的变体。
其中之一就是一种特别流行的 LSTM 变体,它由Gers & Schmidhuber (2000)提出,加入一种窥视孔连接(peephole connections)的结构。这使得细胞状态可以作为门层(译者:gate layers: layers & layer)输入。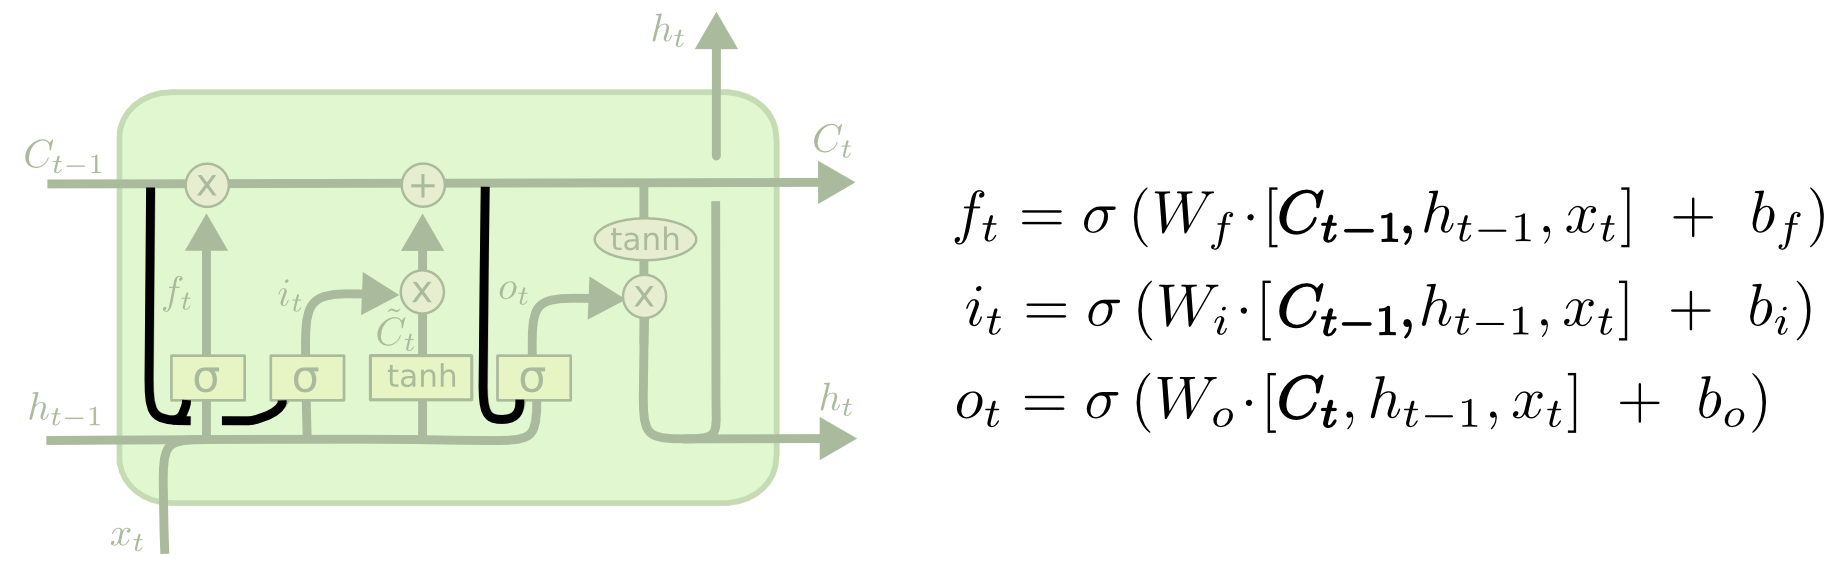 以上的图示为每个门层加入了窥视孔连接,但是也有一些论文并不是所有的门层都加。
另外一种变体是加入了双遗忘门(coupled forget)以及输入门。我们同时考虑了何时遗忘以及应该加入何种新信息,而并非分别考虑。我们仅仅在我们需要就地输入信息的时候才会遗忘,同时我们仅仅在遗忘掉旧的信息的时候才会加入新的信息(译者:此时,表示遗忘旧的细胞状态,同时加入新的输入)。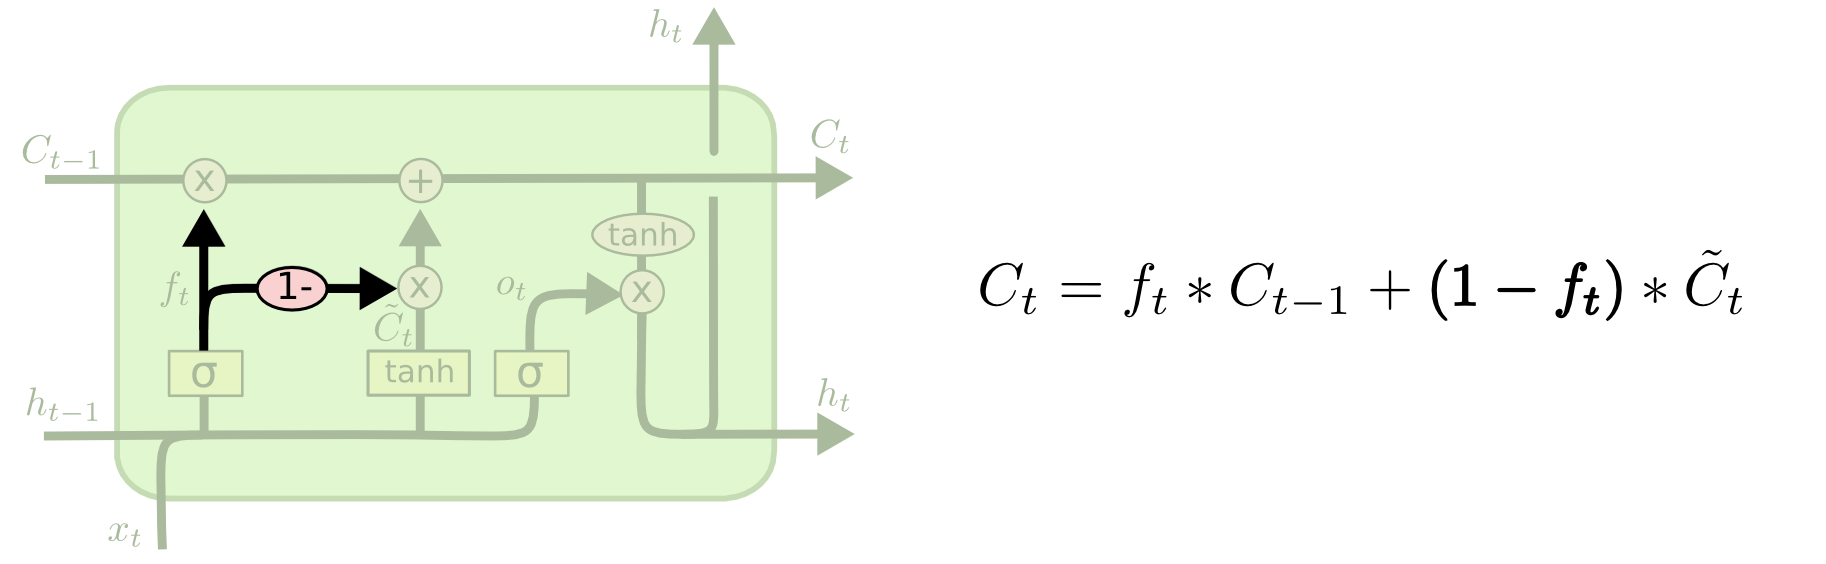
另外一种改动较大的变体是门控循环单元(Gated Recurrent Unit)即 GRU。这个算法由Cho,et al.(2014)提出,它把遗忘门和输入门结合起来构成一个“更新门”(update gate)。与此同时,它还将细胞状态和隐含状态合并起来,当然还有一些其他变化在此不一一赘述。最终的变体比标准的 LSTM 简单,这使得它很受欢迎。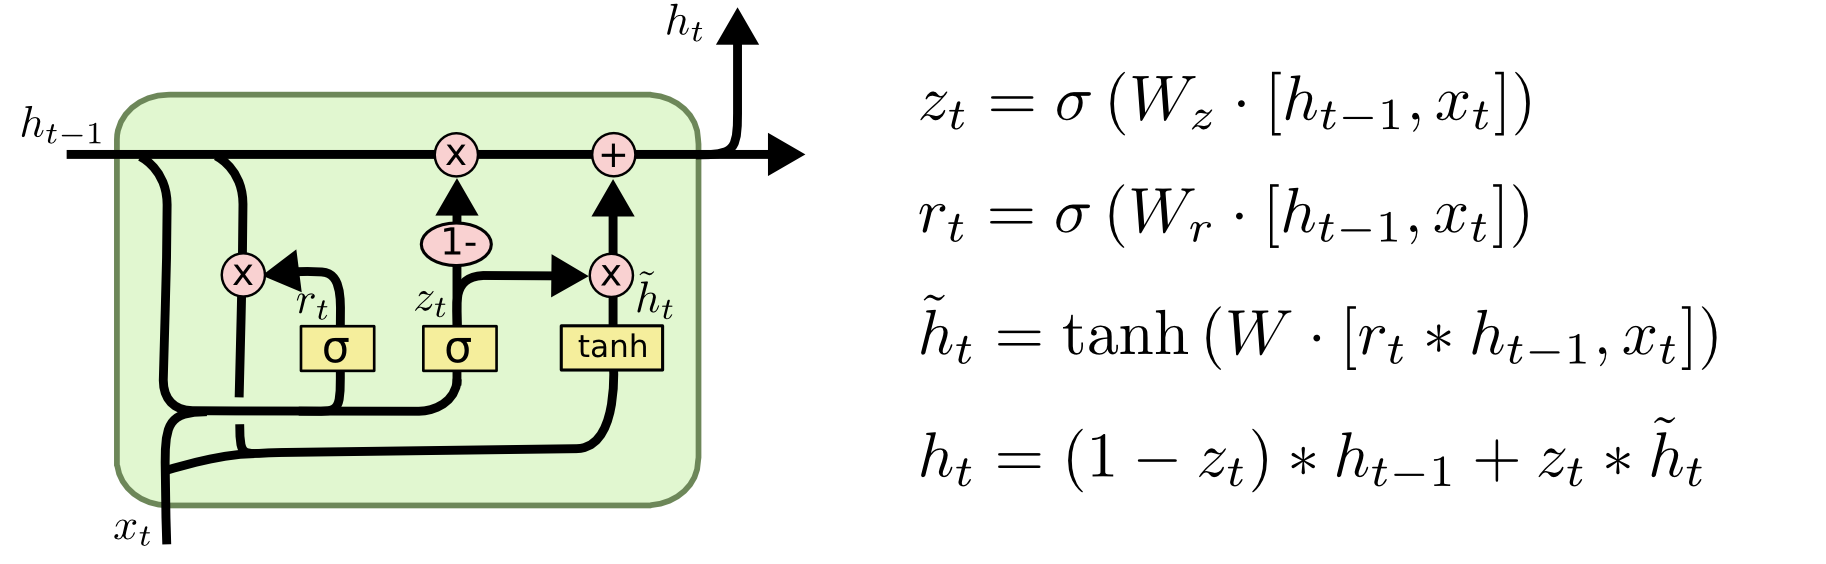
以上均是最近比较劲爆的 LSTM 变体。当然也有很多其他形式的变体,如Yao,et al. (2015)提出的深度门 RNN(Depth Gated RNNs)。还有一些变体用完全不同的方式来解决长期依赖问题,例如Koutnik,et al.(2014)提出的时钟频率驱动 RNN(Clockwork RNNs)。
列举了诸多 LSTM 变体,那么到底哪一种变体是最好的呢?其中的差异真的很重要吗?Greff, et al.(2015)做了一个非常棒的比较,发现这些变体几乎都是一样一样的。Jozefowicz,et al.(2015)测试了上万种 RNN 框架,发现了一些框架在特定任务上会比 LSTM 表现出色。(译者:没有一种算法一统江湖)
结论
以上,我提到了人们利用 RNNs 得到了很多优秀的结果。在本质上说,几乎所有的 RNNs 都使用了 LSTMs。LSTMs 在诸多任务上表现优异。在介绍 LSTMs 的过程中写了很多公式,这让它看起来很吓人。幸运的是,我们在文中通过一步步地探索,让 LSTM 看起来平易近人。LSTMs 是我们完成 RNNs 的重大成果。我们很自然地想:还有没有其他的重大成果?研究员们的共识是:当然有!下一个重大成果就是——注意力。这个观点是让 RNNs 的每一步都能够从更大的数据集中挑选信息。例如,如果你想利用 RNNs 去给一幅图像创造标题来描述它,这就可能会选择图像的一部分作为输入,然后根据这些输入来得到每个单词。事实上,Xu,et al.(2015)就是这么做的——这可能你探究注意力这个领域的起点。还有诸多使用注意力取得的令人激动的研究结果,看起来还有更多需要探索。注意力并非 RNN 唯一令人激动的研究方向。例如,Kalchbrenner, et al. (2015)提出的网格 LSTM(Grid LSTMs)看似非常有前景。Gregor, et al.(2015),Chung, et al.(2015)和Bayer & Osendorfer (2015)等人的研究工作是在生成模型中使用 RNNs,这些工作都看起来非常有趣。过去几年是 RNNs 异常火爆的时期,未来也会有更多更加有意义的成果出现。
致谢
我非常感谢那些帮助我去理解 LSTMs 的大佬们,同时感谢对可视化进行评论并在这篇博文提供反馈的网友们。非常感激谷歌同事们的反馈,尤其感谢Oriol Vinyals,Greg Corrado,Jon Shlens,Luke Vilnis以及Ilya Sutskever。我也由衷感谢很多同事朋友的帮助,包括Dario Amodei和Jacob Steinhardt。值得特别感谢的还有Kyunghyun Cho,这哥们对图表的绘制给了我极大的帮助。在写这篇博文之前,我尝试在我讲授的神经网络课程中利用两系列研讨会的时间来解释 LSTMs。感谢每一位参与者,感谢大家的反馈。