· updated Jan 27, 2025 · 5 min read
降维之 PCA 主成分分析原理
在许多领域的研究与应用中,往往需要对反映事物的多个变量进行大量的观测,收集大量数据以便进行分析寻找规律。多变量大样本无疑会为研究和应用提供了丰富的信息,但也在一定程度上增加了数据采集的工作量,更重要的是在多数情况下,许多变量之间可能存在相关性,从而增加了问题分析的复杂性,同时对分析带来不便。如果分别对每个指标进行分析,分析往往是孤立的,而不是综合的。盲目减少指标会损失很多信息,容易产生错误的结论。
因此需要找到一个合理的方法,在减少需要分析的指标同时,尽量减少原指标包含信息的损失,以达到对所收集数据进行全面分析的目的。由于各变量间存在一定的相关关系,因此有可能用较少的综合指标分别综合存在于各变量中的各类信息。主成分分析与因子分析就属于这类降维的方法。
目的
PCA(Principal Component Analysis)是一种常用的数据分析方法。PCA 通过线性变换将原始数据变换为一组各维度线性无关的表示,可用于提取数据的主要特征分量,常用于高维数据的降维。能够对高维数据降维的算法包括:
- LASSO
- 主成分分析法
- 聚类分析
- 小波分析法
- 线性判别法
- 拉普拉斯特征映射
降维有什么作用
降维有什么作用呢?
- 数据在低维下更容易处理、更容易使用
- 相关特征,特别是重要特征更能在数据中明确地显示出来;如果只有两维或者三维的话,更便于可视化展示
- 去除数据噪声
- 降低算法开销
常见的降维算法有主成分分析(principal component analysis,PCA)、因子分析(Factor Analysis)和独立成分分析(Independent Component Analysis,ICA)。
优化目标
将一组 N 维向量降为 K 维(K 大于 0,小于 N),其目标是选择 K 个单位(模为 1)正交基,使得原始数据变换到这组基上后,各字段两两间协方差为 0,而字段的方差则尽可能大(在正交的约束下,取最大的 K 个方差)。注意:PCA 的变换矩阵是协方差矩阵,K-L 变换的变换矩阵可以有很多种(二阶矩阵、协方差矩阵、总类内离散度矩阵等等)。当 K-L 变换矩阵为协方差矩阵时,等同于 PCA。
PCA 原理
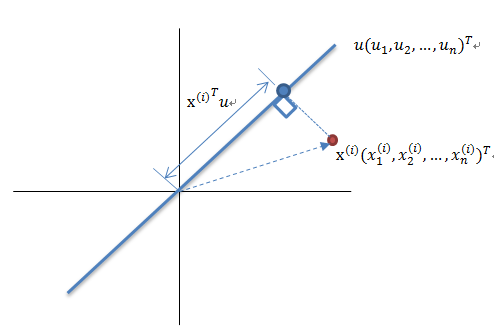
最大化样本点在基上的投影,使得数据点尽量地分离。令第一主成分的方向是,我们的目标就是将样本点在该方向上的投影最大化,即:
其中的。那么优化函数就变成了:
以上式子是个二次型,可以证明是半正定矩阵,所以上式必然有最大值。
优化函数
解释:最大化方差同时最小化协方差(PCA 本质上是将方差最大的方向作为主要特征,并且在各个正交方向上将数据“离相关”)。最大化方差意味着,使得每个样本点在每个维度上与均值有很大差异,就是说非常有个性,有个性才能分辨出来;同时协方差越小的话表明样本之间的互相影响就非常小,如果协方差是 0 的话,表示两个字段完全独立。
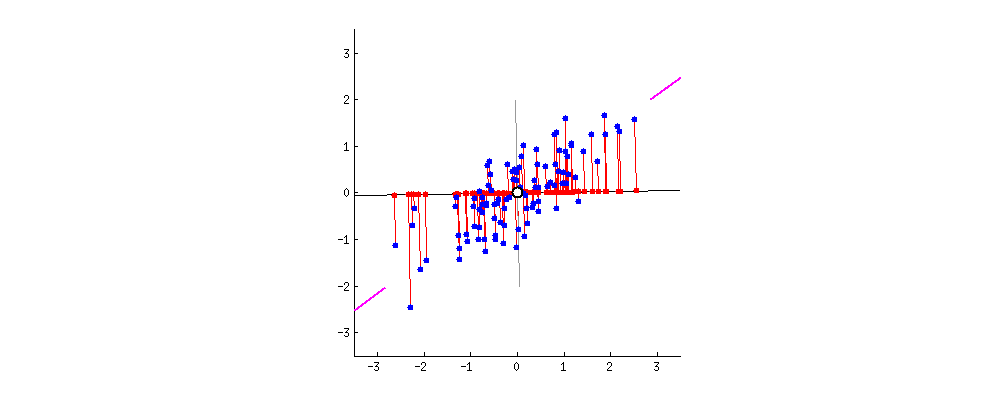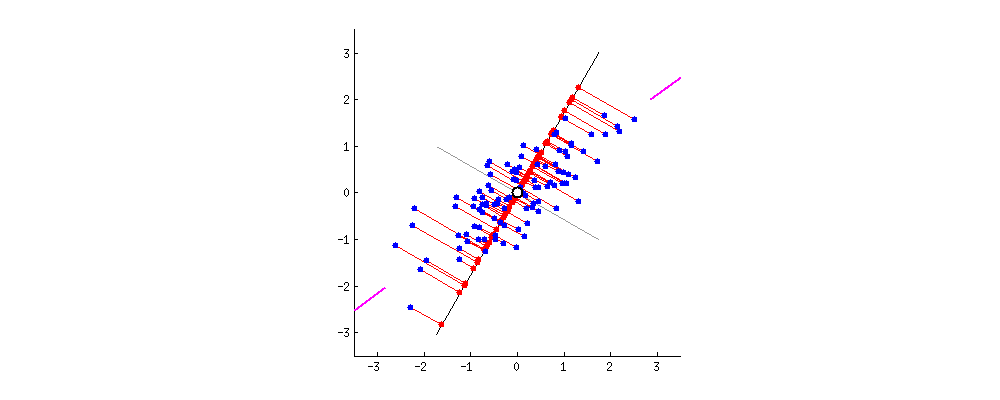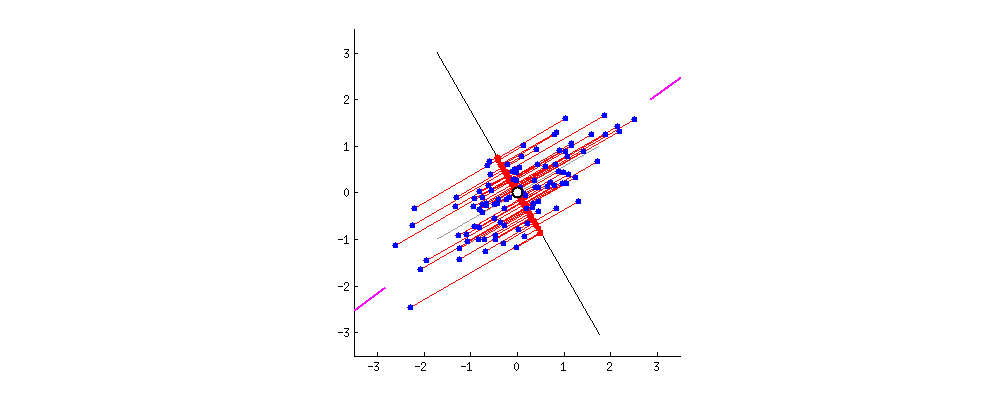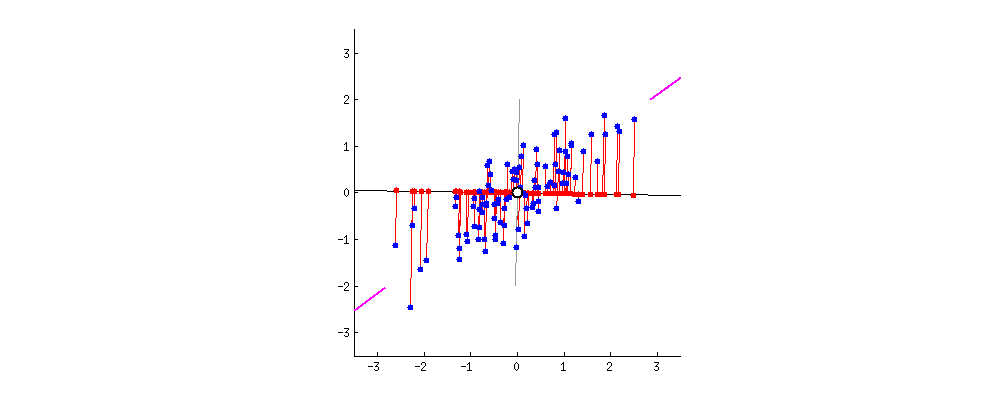
寻找协方差矩阵的特征向量和特征值就等价于拟合一条能保留最大方差的直线或主成分。因为特征向量追踪到了主成分的方向,而最大方差和协方差的轴线表明了数据最容易改变的方向。根据上述推导,我们发现达到优化目标就等价于将协方差矩阵对角化:即除对角线外的其它元素化为 0,并且在对角线上将特征值按大小从上到下排列。协方差矩阵作为实对称矩阵,其主要性质之一就是可以正交对角化,因此就一定可以分解为特征向量和特征值。
具体实施步骤
总结一下 PCA 的算法步骤,设有条维(字段数)数据,我们采用以下步骤对数据降维。
- 将原始数据按列组成行列矩阵 X(行数代表字段数目,一个字段就是取每个样本的该维度的数值;列数代表样本数目)
- 将的每一行(代表一个属性字段)进行零均值化,即减去这一行的均值
- 求出协方差矩阵:
- 求出协方差矩阵的特征值及对应的特征向量
- 将特征向量按对应特征值大小从上到下按行排列成矩阵,取前 k 行组成矩阵 P
- 即为降维到 k 维后的数据
去均值化的目的
下面两幅图是数据做中心化(centering)前后的对比,可以看到其实就是一个平移的过程,平移后所有数据的中心是。
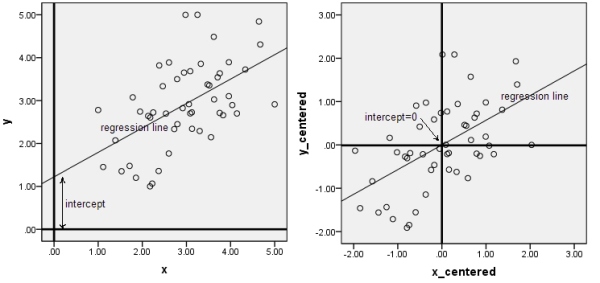
在做 PCA 的时候,我们需要找出矩阵的特征向量,也就是主成分(PC)。比如说找到的第一个特征向量是 a = [1, 2],a 在坐标平面上就是从原点出发到点(1,2)的一个向量。如果没有对数据做中心化,那算出来的第一主成分的方向可能就不是一个可以“描述”(或者说“概括”)数据的方向了。还是看图比较清楚。

黑色线就是第一主成分的方向。只有中心化数据之后,计算得到的方向才能比较好地“概括”原来的数据。
限制
PCA 虽可以很好地解除线性相关,但是对于高阶相关性就没有办法了,对于存在高阶相关性的数据,可以考虑 Kernel PCA,通过 Kernel 函数将非线性相关转为线性相关。