· 80 min read
论文解读:DeDoDe,检测与描述解耦的局部特征匹配
TL;DR DeDoDe 是 Linköping 与 Chalmers 团队在 3DV 2024 的口头报告工作[1]。它盯上了一个被沿用很久的代理任务:学习式检测器要么把关键点定义成描述子的互为最近邻(MNN),要么和描述子联合训练;前者不保证 3D 一致,后者把关键点锁死在某一个描述子上。DeDoDe 把两件事拆开:检测器 直接用大规模 SfM/MVS 重建里的 3D track 监督,先构造平滑的检测先验,再用 top-k 二值目标做半监督的两视图交叉熵,并加一项覆盖正则;描述器 只在检测器给出的关键点上优化双 softmax 的负对数似然。结果是 MegaDepth-1500 AUC@5° 49.4(DeDoDe-B)/ 52.8(DeDoDe-G),比 DISK 的 35.0 高 14.4 / 17.8,DeDoDe-G 在 @5° 上与 LoFTR 打平;MegaDepth-Repeatability-10k 在 0.1% 阈值上 40.1,DISK 只有 18.4;IMC2022 75.8 mAA,超过 SuperGlue 的 72.4 和 SiLK 的 68.5,但仍低于 RoMa 的 88.0。代码与权重已开源(MIT;描述器-G 里的 DINOv2 为 Apache-2.0),README 目前默认加载 v2 检测器权重。
- 论文:DeDoDe: Detect, Don’t Describe — Describe, Don’t Detect for Local Feature Matching,Johan Edstedt、Georg Bökman、Mårten Wadenbäck、Michael Felsberg,Linköping University / Chalmers University of Technology,3DV 2024 Oral,arXiv 2023 年 8 月(v3 2023 年 12 月)。
- 代码:github.com/Parskatt/DeDoDe(MIT;
dedode_descriptor_G用冻结的 DINOv2 ViT-L/14,权重为 Apache-2.0)。后续工作 DeDoDe v2(CVPRW 2024)改进了检测器训练配方,README 目前默认加载 v2 权重。 - 前作/预备知识:站内的 SuperPoint 解读、SuperGlue 解读、RoMa v2 解读、SIFT 与 SURF;DKM 的深度可分离解码器是 DeDoDe 网络结构的直接来源。
一、动机:检测器在优化一个错的代理任务
SfM 的流程可以粗分成检测、匹配、估计三段,检测是第一颗扣子。它在每张图上挑出(最多 K 个)点,这些点必须跨视图对应同一个 3D 点——也就是 3D 一致(3D consistent)——后面的三角化、轨迹、束调整才有意义。问题在于「什么点算好关键点」没有直接真值,于是大家只能用代理任务:传统方法用高斯差分(DoG)的极值、角点、SIFT[2] 的尺度空间极值;学习式方法则用「描述子的互为最近邻」(mutual nearest neighbour,MNN)——一个点如果在另一张图里的最近邻描述子反过来也把它当最近邻,就把它当正样本。
代理任务的好处是容易训练,坏处是它和真正想要的 3D 一致性并不等价。重复纹理(比如一排一样的柱子)可以给出描述子上一一对应、但几何上并不一致的点;无纹理区域里定位很准的点,描述子却未必能匹配上。更麻烦的是,一旦把关键点定义成某个描述子的 MNN,关键点就和这个描述子绑死了:换描述器、换匹配器,检测器得跟着重训。DeDoDe 的出发点就是这两句话:检测,不描述;描述,不检测。
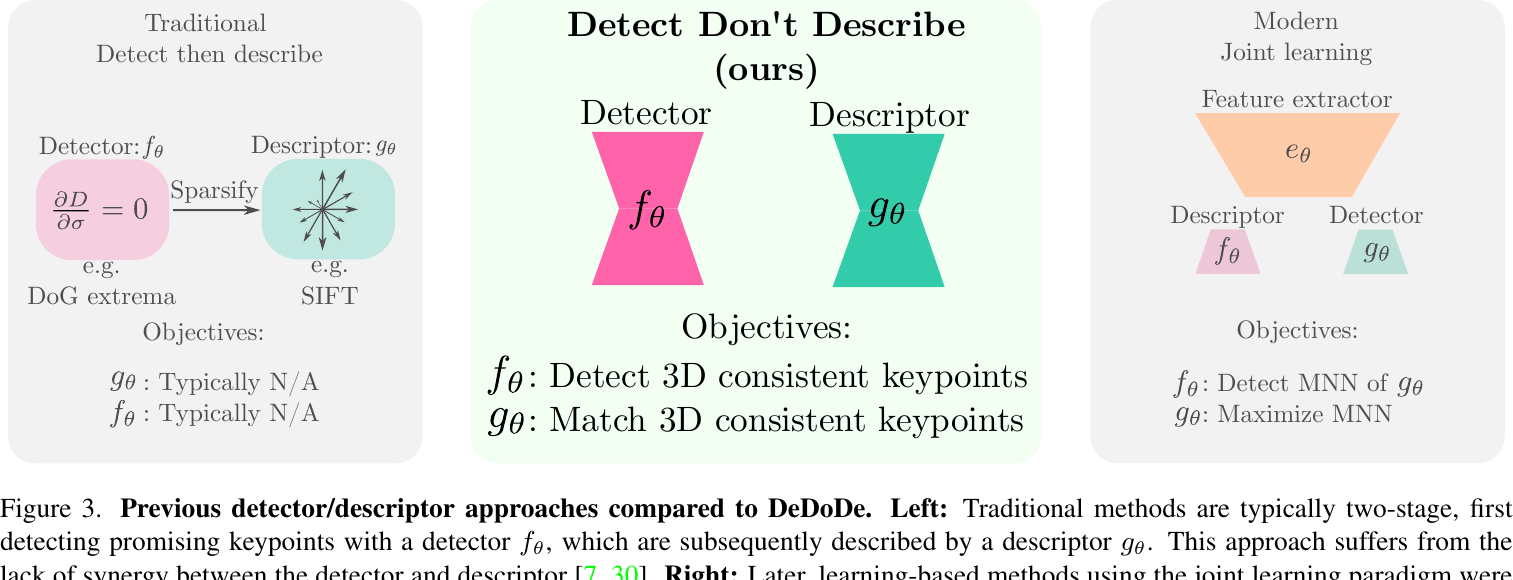
论文把「为什么要解耦」列了三条:
- 兼容性:检测器与描述器无关,可以接任意匹配器。论文第 6.3 节把 DeDoDe 关键点接到 RoMa 的稠密 warp 上,仍能拿到 55.1 AUC@5°,比 DeDoDe 自己的描述器高。
- 解耦收益:两个模块可以分别设计损失,分别做消融。Table 5 和 Table 6 这类实验只有在解耦的前提下才做得出来。
- 性能:解耦之后反而更强:MegaDepth-1500 上 DeDoDe-G 的 52.8 AUC@5° 与 LoFTR 持平,比同类的 DISK 高 17.8。
论文的贡献可以对应到上面这张图:
- 把关键点检测写成一个密度估计问题:要让网络在「成功形成 3D track 的点」上概率高,其余地方概率低;
- 因为 SfM track 太稀疏,提出两视图 top-k 半监督目标,把检测集合从 base detector 的少量点扩展到任意 K 个;
- 提出解耦的描述器训练目标:在 DeDoDe 关键点上最大化双 softmax 的 MNN 似然;
- 在相对位姿、重复性、IMC2022 上给出 SOTA 级结果,并证明检测器可以接不同的匹配器。
二、核心方法
2.1 把关键点检测写成密度估计
设 是图像 上的一个(可以未归一化的)对数密度。数据集是 ,图像 的关键点集合记为 。最直接的目标是最大化对数似然:
这里 是对图像所有像素坐标求和。定义归一化后的检测分布
它就是一个在所有像素上的 softmax。如果关键点有真值,这套写法没有新东西;难点在于「哪些点该被检测」没有标注。论文的回答是:在 SfM 里成功形成 3D track 的点。
2.2 监督信号:SfM 的 3D track
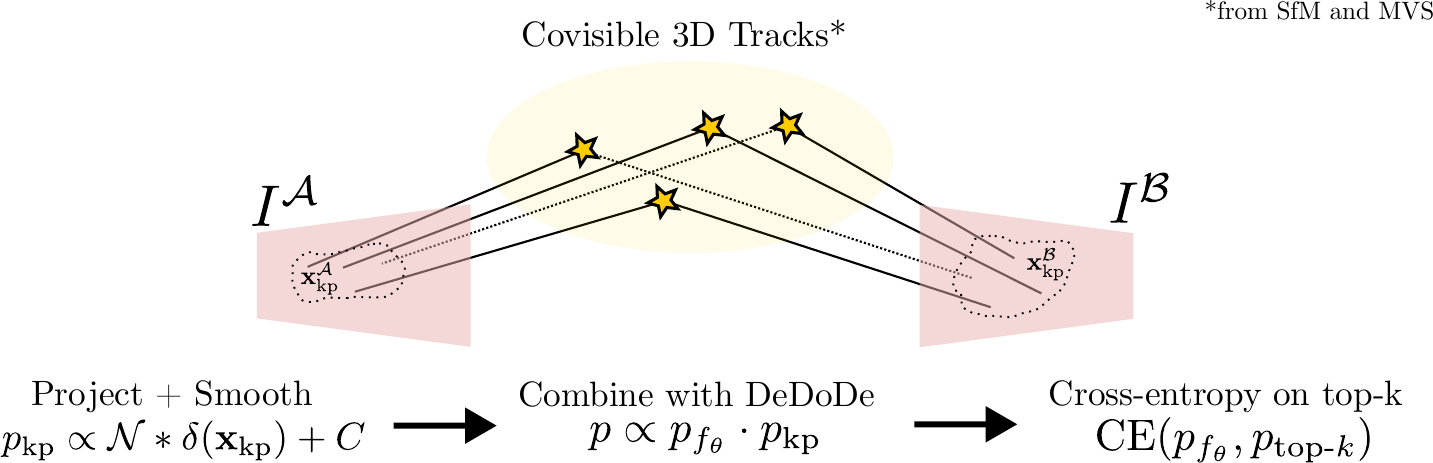
作者用 MegaDepth[3] 的大规模 SfM + MVS 重建。MegaDepth 的 track 由 SIFT 关键点生成,经过筛选后只保留 3D 一致的点,也就是在多个视图里都能对应到同一个 3D 点的轨迹。问题有两层:
- 稀疏:一张图里只有一部分 track 被检测到,base detector 漏掉的点就没有监督;
- 共视:即使一个 3D 点在场景里可见,也不一定在两张图里都被检测到。
论文的做法是取一对图像 ,用 MVS 深度图判断共视区域,然后取两图检测的并集:两图都检测到的 track 用实线表示,只在一张图检测到、但通过深度投影可见的 track 用虚线表示。图 2 就是这一步的示意。
2.3 平滑检测先验:把离散检测变成概率场
检测是离散的格点,直接拿来当监督目标太硬,而且网络无法在相邻像素之间分配概率。论文先做一个两阶段的平滑:
- 在每个检测位置上放一个 Dirac delta ;
- 与高斯核 卷积,再加一个均匀常数 :
然后用深度把 的分布 warp 到 、把 的分布 warp 到 ,两视图相乘:
乘积的含义是「两图都认为这里有 track」:只在一边出现的检测会被另一边压掉,从而把监督集中到真正的 3D 一致点上。 像素, 是一个很小的均匀底。实践中不直接算 ,而是用 的近似,取 :检测位置的 log 概率比均匀底高 50,足以在 top-k 里被选中。
代码:检测平滑先验(keypoint_loss.py,原文照录)
    def compute_detection_img(self, detections, mask, B, H, W, device = "cuda"):
        kernel_size = 5
        X = torch.linspace(-2,2,kernel_size, device = device)
        G = (-X**2 / (2 * (1/2)**2)).exp() # half pixel std
        G = G/G.sum()
        det_smoothing_kernel = G[None, None, None,:]
        det_img = torch.zeros((B,1,H,W), device = device)
        for b in range(B):
            valid_detections = (detections[b][mask[b]]).int()
            det_img[b,0][valid_detections[:,1], valid_detections[:,0]] = 1
        det_img = F.conv2d(det_img, weight = det_smoothing_kernel, padding = (kernel_size//2, 0))
        det_img = F.conv2d(det_img, weight = det_smoothing_kernel.mT, padding = (0, kernel_size//2))
        return det_img
这段代码对应 卷积 :5 个格点、标准差半个像素,先横向卷再纵向卷。注意它只负责把一张图的检测变成密度图;两视图的乘法在下一节的 top-k 目标里完成。
2.4 后验:先验 × 检测器
只用先验当目标有一个明显问题:先验来自 base detector,base detector 漏掉的点就永远没有监督,召回上不去。论文的解法是把先验和模型预测相乘:
直觉上「相乘不能增加检测」,但先验里那个很小的均匀底 起了作用:在模型给出高置信、而先验只有均匀底的位置,乘积仍然会形成峰,于是网络可以检测 base detector 漏掉的点;反过来,先验很强但模型不支持的位置,乘积也不会太高。这一项是 DeDoDe 从「复现 SIFT 检测」走向「超过 base detector」的关键。
2.5 top-k 目标与覆盖正则
有了后验 ,最直接的做法是算 。论文发现这不稳定:如果直接用交叉熵,网络可以把 塌缩成任意单点 ,此时 CE 为 0,不管目标 是什么形状;附录 F 把这件事说得很清楚:交叉熵为 0 当且仅当 ,这个目标有多个退化解;用 KL 散度也一样,最小值同样被 delta 分布取到。
解决办法是把目标二值化:在一个 batch 里取后验最高的 个位置,目标在这 个位置上是均匀的,其余为 0:
这带来两个效果:目标在 个点上平坦,网络无法靠「只押一个点」取巧; 同时控制了监督的稀疏度。 大,目标覆盖更多点、更平,但会包含低置信位置; 小,目标更尖、更依赖先验。论文在 512×512、batch 8 下取 ,相当于每张图 1024 个点(约 0.39% 的像素)。
只有 top-k 还不够。天空、纯色墙面这类区域本来就不可能匹配,网络却可能因为在训练集里见过类似纹理而给出高置信。论文加了一项覆盖正则(coverage loss):把 和 MVS 成功重建的二进制图 都做高斯平滑( 像素),再算交叉熵:
总损失是 。覆盖正则不要求每个像素都检测,而是要求检测的空间分布和可重建区域匹配:在不可匹配区域,网络要学会压低置信。两项的消融在 Table 5:512×512、10k 关键点下,完整模型在 0.1%/0.2%/0.5% 阈值上是 37.1/68.1/84.8;把先验直接当目标降到 34.8/61.3/78.0;去掉覆盖正则降到 29.7/59.4/78.0。覆盖正则的影响更大,尤其在紧阈值 0.1% 上掉了 7.4 个点。
| 设置(512×512,10k keypoints) | 0.1% | 0.2% | 0.5% |
|---|---|---|---|
| I:直接用先验当目标 | 34.8 | 61.3 | 78.0 |
| II:去掉覆盖正则 | 29.7 | 59.4 | 78.0 |
| DeDoDe 完整模型 | 37.1 | 68.1 | 84.8 |
官方代码里的检测损失和论文式 (10) 在形式上不同:论文写的是单视图 ,代码算的是两视图版本——分别对 的 log-softmax 和 的 log-softmax 计算同一个 top-k 目标的交叉熵;这也对应论文结论里说的 two-view objective。目标本身仍然是「模型后验 + 50 × 两图检测」的 top-k 二值化。
代码:top-k 目标与两视图交叉熵(keypoint_loss.py,原文节选)
    def compute_joint_neg_log_likelihood(self, logits_A, logits_B_to_A, detections_A = None, detections_B_to_A = None, mask = None, device = "cuda", dtype = torch.float32, num_matches = None):
        B, K, HW = logits_A.shape
        logits_A, logits_B_to_A = logits_A.to(dtype), logits_B_to_A.to(dtype)
        mask = mask[:,None].expand(B, K, HW).reshape(B, K*HW)
        log_p_B_to_A = self.masked_log_softmax(logits_B_to_A.reshape(B,K*HW), mask = mask)
        log_p_A = self.masked_log_softmax(logits_A.reshape(B,K*HW), mask = mask)
        log_p = log_p_A + log_p_B_to_A
        if detections_A is None:
            detections_A = torch.zeros_like(log_p_A)
        if detections_B_to_A is None:
            detections_B_to_A = torch.zeros_like(log_p_B_to_A)
        detections_A = detections_A.reshape(B, HW)
        detections_A[~mask] = 0
        detections_B_to_A = detections_B_to_A.reshape(B, HW)
        detections_B_to_A[~mask] = 0
        log_p_target = log_p.detach() + 50*detections_A + 50*detections_B_to_A
        num_matches = self.num_matches if num_matches is None else num_matches
        best_k = -(-log_p_target).flatten().kthvalue(k = B * num_matches, dim=-1).values
        p_target = (log_p_target > best_k[..., None]).float().reshape(B,K*HW)/num_matches
        return self.compute_cross_entropy(log_p_A[mask], p_target[mask]) + self.compute_cross_entropy(log_p_B_to_A[mask], p_target[mask])
代码:覆盖正则(keypoint_loss.py,原文照录)
    def compute_matchability(self, keypoint_p, has_depth, B, K, H, W, device = "cuda"):
        smooth_keypoint_p = F.conv2d(keypoint_p.reshape(B,1,H,W), weight = self.smoothing_kernel, padding = (self.smoothing_size//2,0))
        smooth_keypoint_p = F.conv2d(smooth_keypoint_p, weight = self.smoothing_kernel.mT, padding = (0,self.smoothing_size//2))
        log_p_hat = (smooth_keypoint_p+1e-8).log().reshape(B,H*W).log_softmax(dim=-1)
        smooth_has_depth = F.conv2d(has_depth.reshape(B,1,H,W), weight = self.smoothing_kernel, padding = (0,self.smoothing_size//2))
        smooth_has_depth = F.conv2d(smooth_has_depth, weight = self.smoothing_kernel.mT, padding = (self.smoothing_size//2,0)).reshape(B,H*W)
        p = smooth_has_depth/smooth_has_depth.sum(dim=-1,keepdim=True)
        return self.compute_cross_entropy(log_p_hat, p) - self.compute_cross_entropy((p+1e-12).log(), p)
第二段代码里的 smoothing_size = 51 对应论文的 像素:51 个采样点直接铺在像素格上,从 到 跨 50 个像素间隔,标准差 0.5 个采样单位就是 12.5 像素。最后减去的 CE(log p, p) 是目标自身的熵,所以这一项等价于 ,与论文的交叉熵只差一个常数。
2.6 检测网络:VGG-19 + DKM 式解码器
检测器的结构基本沿用 DKM[4],只是把 DKM 的双图相关体去掉,换成单图特征:
- 编码器:ImageNet 预训练的 VGG-19(带 BN),在 stride 1/2/4/8 处取特征,通道数 64/128/256/512。
- 解码器:每个尺度一个深度可分离卷积 refiner(
ConvRefiner),检测器用 8 个隐藏 block,内部维度 64/128/256/512;粗尺度的上下文通过双线性上采样传给下一层,每层的输出是一个「残差 logits + 上下文」的两部分张量。最后把各尺度的 logits 相加并双三次上采样到原分辨率,得到每个像素一个 logit。
用官方代码看会更直观:
代码:多尺度残差解码(dedode_detector.py,原文照录)
    def forward(
        self,
        batch,
    ):
        if "im_A" in batch:
            images = torch.cat((batch["im_A"], batch["im_B"]))
        else:
            images = batch["image"]
        features, sizes = self.encoder(images)
        logits = 0
        context = None
        scales = ["8", "4", "2", "1"]
        for idx, (feature_map, scale) in enumerate(zip(reversed(features), scales)):
            delta_logits, context = self.decoder(feature_map, context = context, scale = scale)
            logits = logits + delta_logits.float() # ensure float (need bf16 doesnt have f.interpolate)
            if idx < len(scales) - 1:
                size = sizes[-(idx+2)]
                logits = F.interpolate(logits, size = size, mode = "bicubic", align_corners = False)
                context = F.interpolate(context.float(), size = size, mode = "bilinear", align_corners = False)
        return {"keypoint_logits" : logits.float()}
logits = logits + delta_logits 是论文说的「每个尺度对稠密关键点 logits 做残差相加」;context 则是从 stride 8 一路带到 stride 1 的跨尺度信息。解码器的每个 block 是 5×5 depthwise conv → BN → ReLU → 1×1 conv,比标准卷积轻很多,这也是 DeDoDe 能在 62.5 ms 内跑完检测器的原因之一。
2.7 推理:top-k,不用 NMS
推理时对整张图的 logits 做 softmax,得到每个像素的概率,然后取 top-K。论文明确说不做非极大值抑制(NMS),这一点跟 SiLK[5] 一致:NMS 会改变检测器的分布,和训练时的目标不一致。官方实现里还有一个论文没细写的细节——increase_coverage=True:先用一个 51 像素的高斯核估计局部密度,把分数除以密度的平方根,再取 top-K。效果是把关键点从高密度区域摊开,近似 NMS 的作用,但不引入硬性的抑制半径。
代码:推理 top-K(dedode_detector.py,原文节选)
    @torch.inference_mode()
    def detect(self, batch, num_keypoints = 10_000):
        self.train(False)
        keypoint_logits = self.forward(batch)["keypoint_logits"]
        B,K,H,W = keypoint_logits.shape
        keypoint_p = keypoint_logits.reshape(B, K*H*W).softmax(dim=-1).reshape(B, K, H*W).sum(dim=1)
        keypoints, confidence = sample_keypoints(keypoint_p.reshape(B,H,W),
                                  use_nms = False, sample_topk = True, num_samples = num_keypoints,
                                  return_scoremap=True, sharpen = False, upsample = False,
                                  increase_coverage=True, remove_borders = self.remove_borders)
        return {"keypoints": keypoints, "confidence": confidence}
2.8 描述器:在给定关键点上做双 softmax
检测器输出一组关键点后,描述器只需要回答「给定这些点,怎么让正确的对应概率最大」。论文沿用 DKM/RoMa 的条件匹配分布:对关键点 和 ,描述子为 ,
两个方向的条件概率相乘,得到一对关键点的匹配似然:
训练目标是它的对数似然:
注意这个目标只在已知关键点上计算,不需要对整张图做稠密预测。训练时用冻结的 DeDoDe 检测器每张图采样 个关键点,再用深度把 的点 warp 到 ,取互为最近邻且距离小于 0.01(归一化坐标)的点对作为正样本。描述子维度 256,训练和推理都用温度 (inv_temp=20);特征做 L2 归一化。官方代码:
代码:描述器 MNN 负对数似然(descriptor_loss.py,原文节选)
    def supervised_loss(self, outputs, batch):
        kpts_A, kpts_B = self.detector.detect(batch, num_keypoints = self.num_keypoints)['keypoints'].clone().chunk(2)
        desc_grid_A, desc_grid_B = outputs["description_grid"].chunk(2)
        desc_A = F.grid_sample(desc_grid_A.float(), kpts_A[:,None], mode = "bilinear", align_corners = False)[:,:,0].mT
        desc_B = F.grid_sample(desc_grid_B.float(), kpts_B[:,None], mode = "bilinear", align_corners = False)[:,:,0].mT
        if "im_A_depth" in batch:
            (mask_A_to_B, kpts_A_to_B), (mask_B_to_A, kpts_B_to_A) = self.warp_from_depth(batch, kpts_A, kpts_B)
        elif "Homog_A_to_B" in batch:
            (mask_A_to_B, kpts_A_to_B), (mask_B_to_A, kpts_B_to_A) = self.warp_from_homog(batch, kpts_A, kpts_B)

        with torch.no_grad():
            D_B = torch.cdist(kpts_A_to_B, kpts_B)
            D_A = torch.cdist(kpts_A, kpts_B_to_A)
            inds = torch.nonzero((D_B == D_B.min(dim=-1, keepdim = True).values)
                                 * (D_A == D_A.min(dim=-2, keepdim = True).values)
                                 * (D_B < 0.01)
                                 * (D_A < 0.01))

        logP_A_B = dual_log_softmax_matcher(desc_A, desc_B,
                                            normalize = self.normalize_descriptions,
                                            inv_temperature = self.inv_temp)
        neg_log_likelihood = -logP_A_B[inds[:,0], inds[:,1], inds[:,2]].mean()
        self.tracked_metrics["neg_log_likelihood"] = (0.99 * self.tracked_metrics.get("neg_log_likelihood", neg_log_likelihood.detach().item()) + 0.01 * neg_log_likelihood.detach().item())
        if np.random.rand() > 0.99:
            print(self.tracked_metrics["neg_log_likelihood"])
        return neg_log_likelihood
代码:双 softmax 匹配分布(utils.py,原文照录)
def dual_log_softmax_matcher(desc_A: tuple['B','N','C'], desc_B: tuple['B','M','C'], inv_temperature = 1, normalize = False):
    B, N, C = desc_A.shape
    if normalize:
        desc_A = desc_A/desc_A.norm(dim=-1,keepdim=True)
        desc_B = desc_B/desc_B.norm(dim=-1,keepdim=True)
        corr = torch.einsum("b n c, b m c -> b n m", desc_A, desc_B) * inv_temperature
    else:
        corr = torch.einsum("b n c, b m c -> b n m", desc_A, desc_B) * inv_temperature
    logP = corr.log_softmax(dim = -2) + corr.log_softmax(dim= -1)
    return logP
dual_log_softmax_matcher 的两项分别是「固定 的点、在 里归一化」和「固定 的点、在 里归一化」;训练时取两者之和作为 log 似然。推理用的 dual_softmax_matcher(无 log)返回两项 softmax 的乘积,再用互为最近邻和阈值筛出匹配。和论文式 (13)–(15) 对照,训练代码里的 logP 就是 。
2.9 更强的描述器-G:冻结的 DINOv2
DeDoDe-B 的描述器是纯 VGG-19 + DKM 解码器,5 个 block,内部维度 32/64/256/512,输出 256 维。DeDoDe-G 在这套结构上再加一路冻结的 DINOv2[6] ViT-L/14 特征:DINOv2 的 patch token 在 stride 14 上给出 1024 维特征,接一个 stride 14 的 ConvRefiner 解码阶段(内部 768 维),再和其它尺度融合。DINOv2 全程 inference_mode,不参与反传;这一路只增加前向开销,不增加训练难度。
代码:冻结的 DINOv2 特征(encoder.py,原文照录)
    def forward(self, x):
        B, C, H, W = x.shape
        if self.dinov2_vitl14[0].device != x.device:
            self.dinov2_vitl14[0] = self.dinov2_vitl14[0].to(x.device).to(self.amp_dtype)
        with torch.inference_mode():
            dinov2_features_16 = self.dinov2_vitl14[0].forward_features(x.to(self.amp_dtype))
            features_16 = dinov2_features_16['x_norm_patchtokens'].permute(0,2,1).reshape(B,1024,H//14, W//14)
        return [features_16.clone()], [(H//14, W//14)] # clone from inference mode to use in autograd
这一路带来的收益是稳定的:Table 1 里 DeDoDe-B 到 DeDoDe-G,AUC@5°/@10°/@20° 从 49.4/65.5/77.7 提到 52.8/69.7/82.0,代价是推理时间从 103.4 ms 提到 160.0 ms(Table 7)。
2.10 训练细节
- 检测器:100,000 步,batch 8,固定 512×512,单张 A100 约 30 小时;AdamW,weight decay ,cosine 学习率,梯度裁剪 0.01。
- 描述器:同样的 100,000 步、batch 8,约 24 小时(解码器 block 更少)。每张图从冻结的 DeDoDe 检测器采 5000 个关键点,温度 。
- 数据:MegaDepth,沿用 DKM 的 train/test 划分;训练时不做水平翻转等增强。描述器-G 因为 DINOv2 的 stride 14,训练分辨率用 560×560。
- 一个值得注意的出入:论文附录 B 写的是编码器学习率 、解码器 ,而官方
experiments/dedode_detector.py和dedode_descriptor-B.py里写的是编码器 、解码器 ,差了一个量级。复现时以代码为准,或者把两边都试一遍。
三、实验结果
3.1 设置
所有 SOTA 实验在 784×784 的分辨率上推理,按 top-k 采样关键点;MegaDepth-1500 是 LoFTR 提出的 1500 对相对位姿测试集,与训练场景不重叠;重复性实验用真值 warp 衡量关键点本身的可重复性,分 10k 和 2k 两种关键点预算;IMC2022[7] 是隐藏测试集,用 30,000 个关键点、MAGSAC++、0.25 像素阈值,评估 mAA@10。
3.2 MegaDepth-1500:追平 LoFTR,但没追上 RoMa
DeDoDe-G 在 Table 1 上是 52.8/69.7/82.0(AUC@5°/@10°/@20°),DeDoDe-B 是 49.4/65.5/77.7。几个对照:
- 比 DISK[8] 的 35.0/51.4/64.9 高 17.8/18.3/17.1;
- 比 SiLK 的 39.9/55.1/66.9 高 12.9/14.6/15.1;
- DeDoDe-G 与 LoFTR[9] 的 52.8/69.2/81.2 在 @5° 打平,@10°、@20° 略高;
- DeDoDe-B 比 SuperGlue[10] 的 49.7/67.1/80.0 略低,DeDoDe-G 全面超过 SuperGlue;
- 稠密匹配器的上限仍然更高:DKM 60.4、RoMa[11] 62.6(@5°)。
论文还把 DeDoDe 关键点接到 RoMa 的稠密 warp 上:DeDoDe + RoMa 是 55.1/71.6/83.5,比 DeDoDe 自己的检测器+描述器高,但比 RoMa 端到端低。作者把这个差距当作检测器的提升空间——以 RoMa 为 oracle,检测器还有约 7 个 AUC@5° 的缺口。
3.3 重复性:多关键点和少关键点是两个世界
重复性实验把「检测器」和「描述器/匹配器」拆开看:用真值 warp 衡量关键点本身的可重复性,阈值 0.1%/0.2%/0.5% 是图像尺寸的百分比。Table 2 是 10k 预算,Table 3 是 2k 预算。几个关键点:
- 紧阈值(0.1%):10k 时 DeDoDe 40.1 远高于 DISK 18.4、SiLK 21.2、ALIKED[12] 19.4;2k 时 DeDoDe 24.3,仍是第一,但优势缩到 2.5(对 DISK* 的 21.8)。
- 松阈值(0.5%):10k 时 DISK 93.0 最高,DeDoDe 80.3;2k 时 DISK 65.7 仍高于 DeDoDe 58.3。说明 DISK 的检测里有一批非常确定的点,但谱系窄;DeDoDe 的检测覆盖了更宽的置信范围。
- 少关键点会伤 DeDoDe:把预算从 10k 降到 2k,DeDoDe 在 0.1% 上从 40.1 掉到 24.3(-15.8),SiLK 从 21.2 掉到 8.2(-13.0);DISK 只从 18.4 掉到 17.0(-1.4)。这和作者列的第 3 条局限一致:DeDoDe 倾向于产生大量潜在关键点,少点设置下会漏掉很多。
3.4 IMC2022:跨数据集的泛化
IMC2022 的测试集是隐藏的、与 MegaDepth 不同分布,更能看出模型是不是只会拟合 MegaDepth 的 3D 统计。DeDoDe-G 拿到 75.8 mAA@10,比 SiLK 的 68.5 高 7.4,比 SuperGlue 的 72.4 高 3.4;但低于 LoFTR 的 78.3 和 RoMa 的 88.0。DeDoDe-B 72.9,略高于 SuperGlue 的 72.4。这个结果比较微妙:DeDoDe 的检测器确实比稀疏检测器泛化得好,但端到端的稠密匹配器仍然更强。作者自己的解释是,IMC2022 的位姿由 MAGSAC++ 从稀疏匹配估计,检测器的定位误差会被放大;这也是他们后面把检测器接到 RoMa 的动机。
3.5 消融与组件互换
Table 5 已经在 2.5 节讲过:先验当目标、去掉覆盖正则都会掉点,覆盖正则的影响更大。Table 6 的组件互换更有意思,可以单独看:
- 好描述器 + 差检测器:SIFT/SIFT 36.5,DISK/DISK 35.0;换成 SIFT 检测 + DeDoDe 描述 41.1,DISK 检测 + DeDoDe 描述 41.5。DeDoDe 描述器本身是有效的,能救回旧检测器。
- 好检测器 + 差描述器:DeDoDe 检测 + SIFT 描述(SIFT*)34.1,DeDoDe 检测 + DISK 描述 33.1,反而比 DeDoDe/DeDoDe-B 的 49.4 低 15–16 个点。原因很直接:DeDoDe 的关键点只有位置,没有尺度/方向;SIFT 和 DISK 的描述器需要局部坐标系,接不上。这是「检测器和描述器可以解耦,但不能随便换」的最好证据。
- DeDoDe/DeDoDe-B vs DeDoDe/DeDoDe-G:描述器换 G,AUC@5° 从 49.4 到 52.8(Table 1),值不值 1.5 倍推理时间取决于应用。
3.6 运行时间与定性结果
Table 7 的推理时间(784×784,单张 A100):
| 方法 | 时间(ms) |
|---|---|
| DeDoDe 仅检测 | 62.5 |
| DeDoDe 检测 + 描述-B | 103.4 |
| DeDoDe 检测 + 描述-G | 160.0 |
| DISK 检测 + 描述(1024×1024) | 170.0 |
论文说「仅检测比 DISK 快约 2.5 倍」是指 62.5 vs 170.0;完整流水线 160.0 vs 170.0 只快一点,而且要提醒 DISK 用的是 1024×1024,DeDoDe 是 784×784,分辨率并不完全对等。
四、局限性
4.1 作者承认的四条
- 依赖 base detector:3D track 来自 SIFT,SIFT 漏掉的稳定点就没有监督。top-k 目标能缓解,但不能完全消除这个依赖。
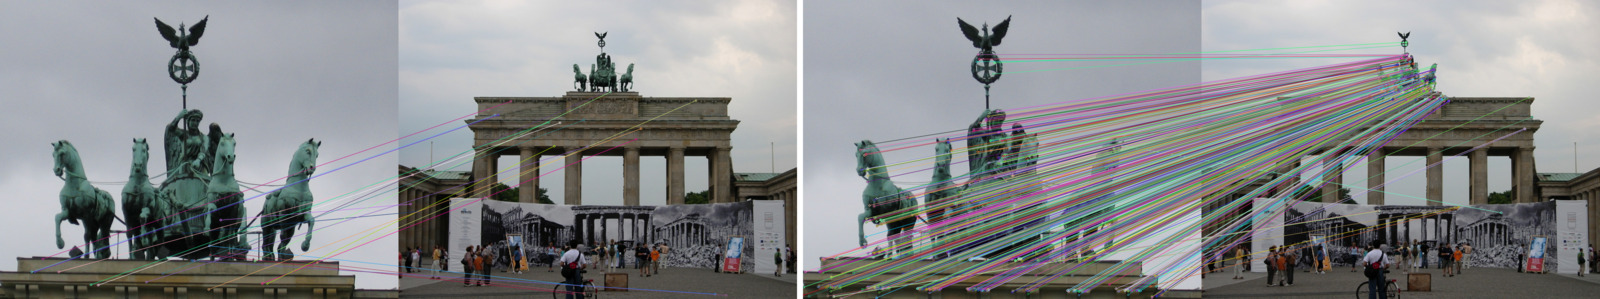
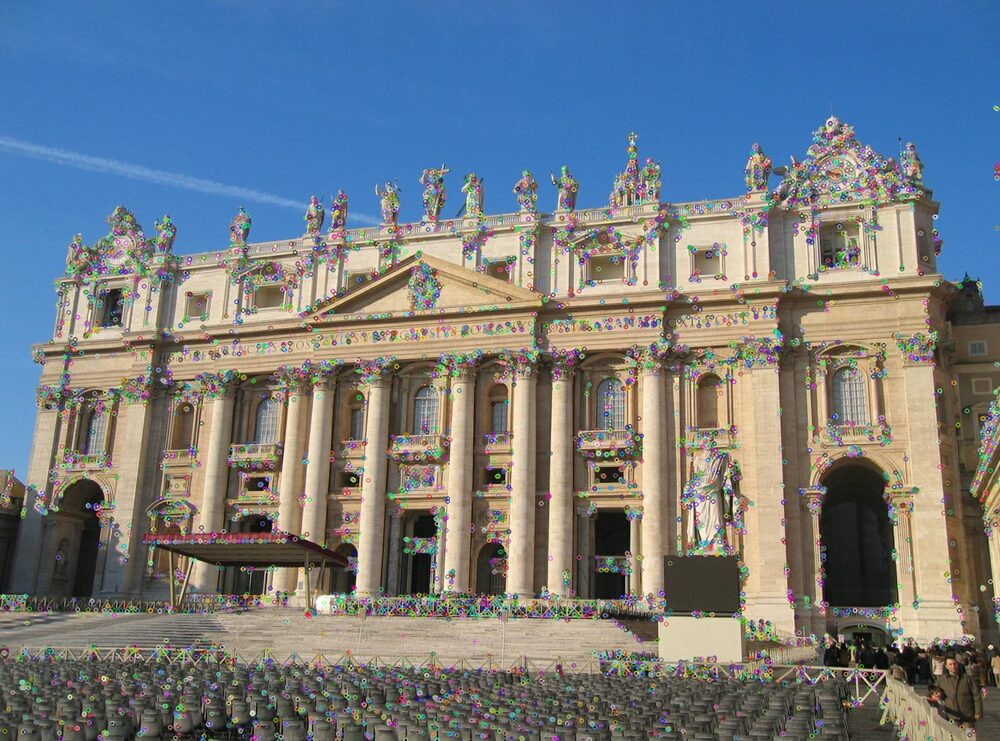
- 没有数据增强:论文明确说没有用常见增强;这会让模型对旋转、尺度变化更敏感。附录 E 显示旋转 180° 仍能匹配,但离群对应明显增多(图 6)。
- 偏向多关键点:DeDoDe 会产生大量潜在关键点;2k 预算下重复性掉得比 DISK 快(Table 3)。
- 只有位置,没有方向/尺度:下游如果需要一个局部坐标系(SIFT、DISK 的描述器),得另接一个方向估计网络,增加计算。
4.2 我自己再补几条
- 只在 MegaDepth 上训练:IMC2022 的 75.8 说明它不是完全过拟合,但和 LoFTR/RoMa 的差距说明跨域仍有空间。训练集里建筑、雕塑占主导,室内和弱纹理场景的表现需要额外验证。
- 解耦不等于随便换:Table 6 的 DeDoDe/SIFT* 34.1 是很好的反例。所谓「descriptor-agnostic」是指检测器不依赖某个描述器的训练目标,不是指任意描述器都能直接接。
- 默认权重和论文不是同一版:README 现在默认下载的是 v2 检测器权重,而论文表 1–6 是 v1 的结果。v2 论文说 IMC2022 从 75.9 提到 78.3 mAA,但当前仓库的
KeyPointLoss里看不到 v2 所述的训练期 NMS;复现实验时要确认权重和训练脚本的版本。 - 推理分辨率不统一:论文的 62.5/103.4/160.0 ms 是 784×784,DISK 的 170.0 ms 是 1024×1024;跨方法比速度要小心。
- 评测协议的细节:重复性用的是真值 warp 和 MVS 有效区域,阈值是图像尺寸的 0.1%–0.5%;这些数字不能直接和别的论文里「像素阈值」的重复性对比。
五、结论与展望
DeDoDe 的故事线很清楚:检测器的监督信号不该来自描述器。用 SfM 的 3D track 直接定义「好关键点」,再用两视图 top-k 目标把稀疏 track 扩成稠密监督,最后用一个独立的描述器在检测器的点上做 MNN 似然——三步都不新,但组合起来第一次让「传统式检测器 + 描述器」在 MegaDepth-1500 上追平 LoFTR,在重复性上超过 DISK/SiLK,在 IMC2022 上超过 SuperGlue。
给实践者的几条建议:
- 需要快:DeDoDe 检测器 + DeDoDe-B,784×784,103 ms 左右;只要关键点不要描述时,62.5 ms。
- 需要准:DeDoDe-G,但要接受 160 ms 和 DINOv2 的显存开销;或者把 DeDoDe 关键点接到 RoMa/LightGlue 这类匹配器上。
- 关键点预算要按场景选:紧阈值、多关键点(10k)是 DeDoDe 的舒适区;少关键点场景(2k 以下)DISK 的确定性检测可能更稳。
- 如果下游需要尺度/方向,先补一个局部坐标系估计,不要直接拿 SIFT/DISK 描述器套。
未来方向也基本写在局限里:更强的 base detector、旋转/尺度增强、给关键点加方向/尺度、把 3D track 监督扩展到更大规模的重建。DeDoDe v2 已经朝「训练期 NMS + 增强 + 更短训练」走了一步,但检测器的上限还远没有到。
六、上手
6.1 安装与最小示例
仓库没有在 README 里写安装命令,但 setup.py 和 requirements.txt 都在;按常规装即可(Python ≥ 3.9,torch ≥ 1.10):
安装命令(Python ≥ 3.9)
pip install -e .README 的最小示例覆盖了检测、描述、匹配三步。权重不传时会自动从 GitHub Releases 下载(检测器默认是 v2 权重,描述器-B/G 是原始权重;G 还会从 Facebook 拉 DINOv2 ViT-L/14):
最小示例(官方 README,原文照录)
from DeDoDe import dedode_detector_L, dedode_descriptor_B, dedode_descriptor_G
from DeDoDe.matchers.dual_softmax_matcher import DualSoftMaxMatcher

# You can either provide weights manually, or not provide any. If none
# are provided we automatically download them. None: We now use v2 detector weights by default.
detector = dedode_detector_L(weights = None)
# Choose either a smaller descriptor,
descriptor = dedode_descriptor_B(weights = None)
# Or a larger one
descriptor = dedode_descriptor_G(weights = None,
                                 dinov2_weights = None) # You can manually load dinov2 weights, or we'll pull from facebook

matcher = DualSoftMaxMatcher()

im_A_path = "assets/im_A.jpg"
im_B_path = "assets/im_B.jpg"
im_A = Image.open(im_A_path)
im_B = Image.open(im_B_path)
W_A, H_A = im_A.size
W_B, H_B = im_B.size


detections_A = detector.detect_from_path(im_A_path, num_keypoints = 10_000)
keypoints_A, P_A = detections_A["keypoints"], detections_A["confidence"]

detections_B = detector.detect_from_path(im_B_path, num_keypoints = 10_000)
keypoints_B, P_B = detections_B["keypoints"], detections_B["confidence"]

description_A = descriptor.describe_keypoints_from_path(im_A_path, keypoints_A)["descriptions"]
description_B = descriptor.describe_keypoints_from_path(im_B_path, keypoints_B)["descriptions"]

matches_A, matches_B, batch_ids = matcher.match(keypoints_A, description_A,
    keypoints_B, description_B,
    P_A = P_A, P_B = P_B,
    normalize = True, inv_temp=20, threshold = 0.1)#Increasing threshold -> fewer matches, fewer outliers

matches_A, matches_B = matcher.to_pixel_coords(matches_A, matches_B, H_A, W_A, H_B, W_B)
6.2 参数与论文概念的对应
num_keypoints=10_000:推理时的 K。论文的重复性实验用 10k,IMC2022 用 30k;少点设置(2k)下 DeDoDe 会掉,详见 3.3。inv_temp=20:双 softmax 的逆温度,对应论文的 ;调高会让分布更尖、匹配更少。threshold=0.1:匹配概率阈值。README 用 0.1,demo/demo_match.py用 0.01;阈值越大匹配越少、离群越少。normalize=True:描述子做 L2 归一化,训练时也是这么做的。detect_from_path(..., H=784, W=784):默认把图 resize 到 784×784;论文的推理分辨率就是 784×784。想保留原分辨率就显式传H、W,但要注意训练/推理分辨率不一致的影响。
6.3 Kornia 一行调用
DeDoDe 已经进 Kornia,适合不想 clone 仓库的场景:
Kornia 调用(官方 README)
from kornia.feature import DeDoDe
dedode = DeDoDe.from_pretrained(detector_weights="L-upright", descriptor_weights="B-upright")
6.4 训练
训练需要 MegaDepth 数据集和 DKM 准备好的场景信息;先跑 data_prep/prep_keypoints.py,再按 experiments/ 里的脚本训练。检测器和描述器是分开训的,描述器要传入已经训好的检测器权重:
数据准备与训练命令(官方 README + experiments 脚本)
# 1) MegaDepth + DKM 场景信息准备好后,生成关键点缓存
python data_prep/prep_keypoints.py

# 2) 训练检测器(100k steps,batch 8,512×512,单卡 A100 约 30 小时)
python experiments/dedode_detector.py

# 3) 训练描述器-B(约 24 小时),需要检测器权重
python experiments/dedode_descriptor-B.py --detector_weights_path dedode_detector_L.pth

# 4) 训练描述器-G(DINOv2 版本,显存更大)
python experiments/dedode_descriptor-G.py --detector_weights_path dedode_detector_L.pth
训练脚本里还能看到论文没写的细节:梯度裁剪 0.01、weight decay 、每个描述器样本 5000 个关键点、描述器-B 的 decoder 只有 5 个 block(检测器是 8 个)。如果只想用预训练模型,demo/ 下的四个脚本分别演示关键点、得分图、DeDoDe-B 匹配和 DeDoDe-G 匹配。
参考
- Edstedt, Bökman, Wadenbäck, Felsberg. DeDoDe: Detect, Don't Describe — Describe, Don't Detect for Local Feature Matching. 3DV 2024. arXiv · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints (SIFT). IJCV 2004. DOI
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Gleize, Wang, Feiszli. SiLK: Simple Learned Keypoints. ICCV 2023. arXiv · 代码
- Oquab, Darcet, Moutakanni, et al. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv · 代码
- Howard, Trulls, Yi, Dane, Jin, et al. Image Matching Challenge 2022. Kaggle / CVPR 2022. 比赛页
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE TIM 2023. arXiv · 代码