· updated Jan 27, 2025 · 22 min read
资料:从 Eigen 向量化谈内存对齐
Eigen 是一个非常常用的矩阵运算库,至少对于 SLAM 的研究者来说不可或缺。然而,向来乖巧的 Eigen 近来却频频闹脾气,把我的程序折腾得死去活来,我却是丈二和尚摸不着头脑。
(本文转发自:知乎@王金戈,已获授权)
缘起
简单说说我经历的灵异事件。我的程序原本在 NVIDIA TX2 上跑得好好的,直到有一天,我打算把它放到服务器上,看看传说中的 RTX 2080 GPU 能不能加速一把。结果悲剧发生了,编译正常,但是一运行就立即 double free。我很是吃惊,怎么能一行代码都没执行就崩了呢。但崩了就是崩了,一定是哪里有 bug,我用 valgrind 检查内存问题,发现种种线索都指向 g2o。g2o 是一个 SLAM 后端优化库,里面封装了大量 SLAM 相关的优化算法,内部使用了 Eigen 进行矩阵运算。阴差阳错之间,我发现关闭 -march=native 这个编译选项后就能正常运行,而这个编译选项其实是告诉编译器当前的处理器支持哪些 SIMD 指令集,Eigen 中又恰好使用了 SSE、AVX 等指令集进行向量化加速。此时,机智的我发现 Eigen 文档中有一章叫做 Alignment issues,里面提到了某些情况下 Eigen 对象可能没有内存对齐,从而导致程序崩溃。现在,证据到齐,基本可以确定我遇到的真实问题了:编译安装 g2o 时,默认没有使用 -march=native,因此里面的 Eigen 代码没有使用向量化加速,所以它们并没有内存对齐。而在我的程序中,启用了向量化加速,所有的 Eigen 对象都是内存对齐的。两个程序链接起来之后,g2o 中未对齐的 Eigen 对象一旦传递到我的代码中,向量化运算的指令就会触发异常。解决方案很简单,要么都用 -march=native,要么都不用。
这件事就这么过去了,但我不能轻易放过它,毕竟花费了那么多时间找 bug。后来我又做了一些深入的探究,这篇文章就来谈谈向量化和内存对齐里面的门道。
什么是向量化运算?
向量化运算就是用 SSE、AVX 等 SIMD(Single Instruction Multiple Data)指令集,实现一条指令对多个操作数的运算,从而提高代码的吞吐量,实现加速效果。SSE 是一个系列,包括从最初的 SSE 到最新的 SSE4.2,支持同时操作 16 bytes 的数据,即 4 个 float 或者 2 个 double。AVX 也是一个系列,它是 SSE 的升级版,支持同时操作 32 bytes 的数据,即 8 个 float 或者 4 个 double。
但向量化运算是有前提的,那就是内存对齐。SSE 的操作数,必须 16 bytes 对齐,而 AVX 的操作数,必须 32 bytes 对齐。也就是说,如果我们有 4 个 float 数,必须把它们放在连续的且首地址为 16 的倍数的内存空间中,才能调用 SSE 的指令进行运算。
举个栗子
为了给没接触过向量化编程的同学一些直观的感受,我写了一个简单的示例程序:
#include <immintrin.h>
#include <iostream>

int main() {

  double input1[4] = {1, 1, 1, 1};
  double input2[4] = {1, 2, 3, 4};
  double result[4];

  std::cout << "address of input1: " << input1 << std::endl;
  std::cout << "address of input2: " << input2 << std::endl;

  __m256d a = _mm256_load_pd(input1);
  __m256d b = _mm256_load_pd(input2);
  __m256d c = _mm256_add_pd(a, b);

  _mm256_store_pd(result, c);

  std::cout << result[0] << " " << result[1] << " " << result[2] << " " << result[3] << std::endl;

  return 0;
}
这段代码使用 AVX 中的向量化加法指令,同时计算 4 对 double 的和。这 4 对数保存在 input1 和 input2 中。_mm256_load_pd 指令用来加载操作数,_mm256_add_pd 指令进行向量化运算,最后,_mm256_store_pd 指令读取运算结果到 result 中。可惜的是,程序运行到第一个 _mm256_load_pd 处就崩溃了。崩溃的原因正是因为输入变量没有内存对齐。我特意打印出了两个输入变量的地址,结果如下:
address of input1: 0x7ffeef431ef0
address of input2: 0x7ffeef431f10
上一节提到了 AVX 要求 32 字节对齐,我们可以把这两个输入变量的地址除以 32,看是否能够整除。结果发现 0x7ffeef431ef0 和 0x7ffeef431f10 都不能整除。当然,其实直接看倒数第二位是否是偶数即可,是偶数就可以被 32 整除,是奇数则不能被 32 整除。
如何让输入变量内存对齐呢?我们知道,对于局部变量来说,它们的内存地址是在编译期确定的,也就是由编译器决定。所以我们只需要告诉编译器,给 input1 和 input2 申请空间时请让首地址 32 字节对齐,这需要通过预编译指令来实现。不同编译器的预编译指令是不一样的,比如 gcc 的语法为 __attribute__((aligned(32))),MSVC 的语法为 __declspec(align(32))。以 gcc 语法为例,做少量修改,就可以得到正确的代码
#include <immintrin.h>
#include <iostream>

int main() {

  __attribute__ ((aligned (32))) double input1[4] = {1, 1, 1, 1};
  __attribute__ ((aligned (32))) double input2[4] = {1, 2, 3, 4};
  __attribute__ ((aligned (32))) double result[4];

  std::cout << "address of input1: " << input1 << std::endl;
  std::cout << "address of input2: " << input2 << std::endl;

  __m256d a = _mm256_load_pd(input1);
  __m256d b = _mm256_load_pd(input2);
  __m256d c = _mm256_add_pd(a, b);

  _mm256_store_pd(result, c);

  std::cout << result[0] << " " << result[1] << " " << result[2] << " " << result[3] << std::endl;

  return 0;
}
输出结果为:
address of input1: 0x7ffc5ca2e640
address of input2: 0x7ffc5ca2e660
2 3 4 5
可以看到,这次的两个地址都是 32 的倍数,而且最终的运算结果也完全正确。
虽然上面的代码正确实现了向量化运算,但实现方式未免过于粗糙。每个变量声明前面都加上一长串预编译指令看起来就不舒服。我们尝试重构一下这段代码。
重构
首先,最容易想到的是,把内存对齐的 double 数组声明成一种自定义数据类型,如下所示:
using aligned_double4 = __attribute__ ((aligned (32))) double[4];

aligned_double4 input1 = {1, 1, 1, 1};
aligned_double4 input2 = {1, 2, 3, 4};
aligned_double4 result;
这样看起来清爽多了。更进一步,如果 4 个 double 是一种经常使用的数据类型的话,我们就可以把它封装为一个 Vector4d 类,这样,用户就完全看不到内存对齐的具体实现了,像下面这样。
#include <immintrin.h>
#include <iostream>

class Vector4d {
  using aligned_double4 = __attribute__ ((aligned (32))) double[4];
public:
  Vector4d() {
  }

  Vector4d(double d1, double d2, double d3, double d4) {
    data[0] = d1;
    data[1] = d2;
    data[2] = d3;
    data[3] = d4;
  }

  aligned_double4 data;
};

Vector4d operator+ (const Vector4d& v1, const Vector4d& v2) {
  __m256d data1 = _mm256_load_pd(v1.data);
  __m256d data2 = _mm256_load_pd(v2.data);
  __m256d data3 = _mm256_add_pd(data1, data2);
  Vector4d result;
  _mm256_store_pd(result.data, data3);
  return result;
}

std::ostream& operator<< (std::ostream& o, const Vector4d& v) {
  o << "(" << v.data[0] << ", " << v.data[1] << ", " << v.data[2] << ", " << v.data[3] << ")";
  return o;
}

int main() {
  Vector4d input1 = {1, 1, 1, 1};
  Vector4d input2 = {1, 2, 3, 4};
  Vector4d result = input1 + input2;

  std::cout << result << std::endl;

  return 0;
}
这段代码实现了 Vector4d 类,并把向量化运算放在了 operator+ 中,主函数变得非常简单。
但不要高兴得太早,这个 Vector4d 其实有着严重的漏洞,如果我们动态创建对象,程序仍然会崩溃,比如这段代码:
int main() {
  Vector4d* input1 = new Vector4d{1, 1, 1, 1};
  Vector4d* input2 = new Vector4d{1, 2, 3, 4};

  std::cout << "address of input1: " << input1->data << std::endl;
  std::cout << "address of input2: " << input2->data << std::endl;

  Vector4d result = *input1 + *input2;

  std::cout << result << std::endl;

  delete input1;
  delete input2;
  return 0;
}
崩溃前的输出为:
address of input1: 0x1ceae70
address of input2: 0x1ceaea0
很诡异吧,似乎刚才我们设置的内存对齐都失效了,这两个输入变量的内存首地址又不是 32 的倍数了。
Heap vs Stack
问题的根源在于不同的对象创建方式。直接声明的对象是存储在栈上的,其内存地址由编译器在编译时确定,因此预编译指令会生效。但用 new 动态创建的对象则存储在堆中,其地址在运行时确定。C++ 的运行时库并不会关心预编译指令声明的对齐方式,我们需要更强有力的手段来确保内存对齐。
C++ 提供的 new 关键字是个好东西,它避免了 C 语言中丑陋的 malloc 操作,但同时也隐藏了实现细节。如果我们翻看 C++ 官方文档,可以发现 new Vector4d 实际上做了两件事情,第一步申请 sizeof(Vector4d) 大小的空间,第二步调用 Vector4d 的构造函数。要想实现内存对齐,我们必须修改第一步申请空间的方式才行。好在第一步其实调用了 operator new 这个函数,我们只需要重写这个函数,就可以实现自定义的内存申请,下面是添加了该函数后的 Vector4d 类。
class Vector4d {
  using aligned_double4 = __attribute__ ((aligned (32))) double[4];
public:
  Vector4d() {
  }

  Vector4d(double d1, double d2, double d3, double d4) {
    data[0] = d1;
    data[1] = d2;
    data[2] = d3;
    data[3] = d4;
  }

  void* operator new (std::size_t count) {
    void* original = ::operator new(count + 32);
    void* aligned = reinterpret_cast<void*>((reinterpret_cast<size_t>(original) & ~size_t(32 - 1)) + 32);
    *(reinterpret_cast<void**>(aligned) - 1) = original;
    return aligned;
  }

  void operator delete (void* ptr) {
    ::operator delete(*(reinterpret_cast<void**>(ptr) - 1));
  }

  aligned_double4 data;
};
operator new 的实现还是有些技巧的,我们来详细解释一下。首先,根据 C++ 标准的规定,operator new 的参数 count 是要开辟的空间的大小。为了保证一定可以得到 count 大小且 32 字节对齐的内存空间,我们把实际申请的内存空间扩大到 count + 32。可以想象,在这 count + 32 字节空间中,一定存在首地址为 32 的倍数的连续 count 字节的空间。所以,第二行代码,我们通过对申请到的原始地址 original 做一些位运算,先找到比 original 小且是 32 的倍数的地址,然后加上 32,就得到了我们想要的对齐后的地址,记作 aligned。接下来,第三行代码很关键,它把原始地址的值保存在了 aligned 地址的前一个位置中,之所以要这样做,是因为我们还需要自定义释放内存的函数 operator delete。毕竟 aligned 地址并非真实申请到的地址,所以在该地址上调用默认的 delete 是会出错的。可以看到,我们在代码中也定义了一个 operator delete,传入的参数正是前面 operator new 返回的对齐的地址。这时候,保存在 aligned 前一个位置的原始地址就非常有用了,我们只需要把它取出来,然后用标准的 delete 释放该内存即可。
为了方便大家理解这段代码,有几个细节需要特地强调一下。::operator new 中的 :: 代表全局命名空间,因此可以调用到标准的 operator new。第三行需要先把 aligned 强制转换为 void** 类型,这是因为我们希望在 aligned 的前一个位置保存一个 void* 类型的地址,既然保存的元素是地址,那么该位置对应的地址就是地址的地址,也就是 void**。
这是一个不大不小的 trick,C++ 的很多内存管理方面的处理经常会有这样的操作。但不知道细心的你是否发现了这里的一个问题:reinterpret_cast<void**>(aligned) - 1 这个地址是否一定在我们申请的空间中呢?换句话说,它是否一定大于 original 呢?之所以存在这个质疑,是因为这里的 -1 其实是对指针减一。要知道,在 64 位计算机中,指针的长度是 8 字节,所以这里得到的地址其实是 reinterpret_cast<size_t>(aligned) - 8。看出这里的区别了吧,对指针减 1 相当于对地址的值减 8。所以仔细想想,如果 original 到 aligned 的距离小于 8 字节的话,这段代码就会对申请的空间以外的内存赋值,可怕吧。
其实没什么可怕的,为什么我敢这样讲,因为 Eigen 就是这样实现的。这样做依赖于现代编译器的一个共识:所有的内存分配都默认 16 字节对齐。这个事实可以解释很多问题,首先,永远不用担心 original 到 aligned 的距离会不会小于 8 了,它会稳定在 16,这足够保存一个指针。其次,为什么我们用 AVX 指令集举例,而不是 SSE?因为 SSE 要求 16 字节对齐,而现代编译器已经默认 16 字节对齐了,那这篇文章就没办法展开了。最后,为什么我的代码在 NVIDIA TX2 上运行正常而在服务器上挂掉了?因为 TX2 中是 ARM 处理器,里面的向量化指令集 NEON 也只要求 16 字节对齐。
还有坑?
如果你以为到这里就圆满结束了,那可是大错特错。还有个天坑没展示给大家,下面的代码中,我的自定义类 Point 包含了一个 Vector4d 的成员,这时候,噩梦又出现了。
class Point {
public:
  Point(Vector4d position) : position(position) {
  }

  Vector4d position;
};

int main() {
  Vector4d* input1 = new Vector4d{1, 1, 1, 1};
  Vector4d* input2 = new Vector4d{1, 2, 3, 4};

  Point* point1 = new Point{*input1};
  Point* point2 = new Point{*input2};

  std::cout << "address of point1: " << point1->position.data << std::endl;
  std::cout << "address of point2: " << point2->position.data << std::endl;

  Vector4d result = point1->position + point2->position;

  std::cout << result << std::endl;

  delete input1;
  delete input2;
  delete point1;
  delete point2;
  return 0;
}
输出的地址又不再是 32 的倍数了,程序戛然而止。我们分析一下为什么会这样。在主函数中,new Point 动态创建了一个 Point 对象。前面提到过,这个过程分为两步,第一步申请 Point 对象所需的空间,即 sizeof(Point) 大小的空间,第二步调用 Point 的构造函数。我们寄希望于第一步申请到的空间恰好让内部的 position 对象对齐,这是不现实的。因为整个过程中并不会调用 Vector4d 的 operator new,调用的只有 Point 的 operator new,而这个函数我们并没有重写。
可惜的是,此处并没有足够优雅的解决方案,唯一的方案是在 Point 类中也添加自定义 operator new,这就需要用户的协助,类库的作者已经无能为力了。不过类库的作者能做的,是尽量让用户更方便地添加 operator new,比如封装为一个宏定义,用户只需要在 Point 类中添加一句宏即可。最后,完整的代码如下。
#include <immintrin.h>
#include <iostream>

#define ALIGNED_OPERATOR_NEW \
  void* operator new (std::size_t count) { \
    void* original = ::operator new(count + 32); \
    void* aligned = reinterpret_cast<void*>((reinterpret_cast<size_t>(original) & ~size_t(32 - 1)) + 32); \
    *(reinterpret_cast<void**>(aligned) - 1) = original; \
    return aligned;\
  } \
  void operator delete (void* ptr) { \
    ::operator delete(*(reinterpret_cast<void**>(ptr) - 1)); \
  }

class Vector4d {
  using aligned_double4 = __attribute__ ((aligned (32))) double[4];
public:
  Vector4d() {
  }

  Vector4d(double d1, double d2, double d3, double d4) {
    data[0] = d1;
    data[1] = d2;
    data[2] = d3;
    data[3] = d4;
  }

  ALIGNED_OPERATOR_NEW

  aligned_double4 data;
};

Vector4d operator+ (const Vector4d& v1, const Vector4d& v2) {
  __m256d data1 = _mm256_load_pd(v1.data);
  __m256d data2 = _mm256_load_pd(v2.data);
  __m256d data3 = _mm256_add_pd(data1, data2);
  Vector4d result;
  _mm256_store_pd(result.data, data3);
  return result;
}

std::ostream& operator<< (std::ostream& o, const Vector4d& v) {
  o << "(" << v.data[0] << ", " << v.data[1] << ", " << v.data[2] << ", " << v.data[3] << ")";
  return o;
}

class Point {
public:
  Point(Vector4d position) : position(position) {
  }

  ALIGNED_OPERATOR_NEW

  Vector4d position;
};

int main() {
  Vector4d* input1 = new Vector4d{1, 1, 1, 1};
  Vector4d* input2 = new Vector4d{1, 2, 3, 4};

  Point* point1 = new Point{*input1};
  Point* point2 = new Point{*input2};

  std::cout << "address of point1: " << point1->position.data << std::endl;
  std::cout << "address of point2: " << point2->position.data << std::endl;

  Vector4d result = point1->position + point2->position;

  std::cout << result << std::endl;

  delete input1;
  delete input2;
  delete point1;
  delete point2;
  return 0;
}
这段代码中,宏定义 ALIGNED_OPERATOR_NEW 包含了 operator new 和 operator delete,它们对所有需要内存对齐的类都适用。因此,无论是需要内存对齐的类,还是包含了这些类的类,都需要添加这个宏。
再谈 Eigen
在 Eigen 官方文档中有这么一页内容:
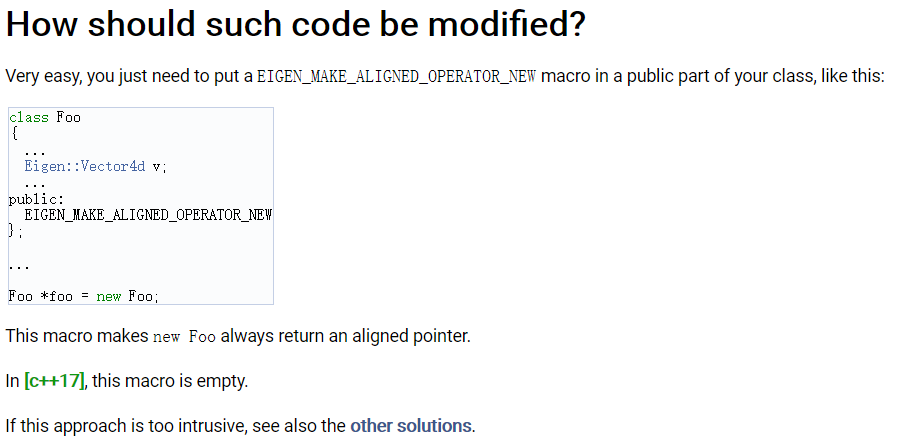
有没有觉得似曾相识?Eigen 对该问题的解决方案与我们不谋而合(EIGEN_MAKE_ALIGNED_OPERATOR_NEW)。这当然不是巧合,事实上,本文的灵感正是来源于 Eigen。但 Eigen 只告诉了我们应该怎么做,没有详细讲解其原理。本文则从问题的提出,到具体的解决方案,一一剖析,希望可以给大家一些更深的理解。
总结
最后做一个简短的总结。对于基本数据类型和自定义类型,我们需要用预编译指令来保证栈内存的对齐,用重写 operator new 的方式保证堆内存对齐。对于嵌套的自定义类型,申请栈内存时会自动保证其内部数据类型的对齐,而申请堆内存时仍然需要重写 operator new。
有一种特殊情况本文并未提到,如果使用 std::vector<Vector4d>,需要传入自定义内存申请器,即 std::vector<Vector4d, AlignedAllocator>,其中 AlignedAllocator 是我们自定义的内存申请器。这是因为,std::vector 中使用了动态申请的空间保存数据,因此默认的 operator new 是无法让其内存对齐的。在无法重写 std::vector 类的 operator new 的情况下,标准库提供了自定义内存申请器的机制,让用户可以以自己的方式申请内存。具体做法本文就不再展开了,理解了前面的内容,这个问题应该很容易解决。