· 93 min read
论文解读:World Model for Robot Learning,世界模型进入机器人学习的路线图
TL;DR 这是一份以机器人学习为中心的世界模型(world model)综述[1]:215 篇参考文献、43 页,把散落在「策略学习、模拟器、机器人视频生成、导航与自动驾驶」四块里的工作收进一张统一的地图。它的核心组织方式是三个问题:世界模型怎么和策略耦合(5 种架构范式:IDM 式解耦、单骨干统一、MoE/MoT 专家化、统一 VLA、latent/符号空间)、怎么替代环境(2 种模拟器用法:强化学习环境、策略评估器)、怎么从视频生成演进(4 个能力阶段:想象监督 → 动作可控 → 结构感知 → 基础模型)。综述的结论很清楚:世界模型不是某一种架构,而是一个从「预测未来」到「支撑行动」的功能谱系;目前没有任何范式在所有基准上占优,长程操作和跨基准泛化是分水岭;真正的瓶颈不是生成得像不像,而是动作因果一致性、物理可执行性和可标准化的评估。配套的 GitHub awesome list 已经 873 星并持续更新,论文里的 41 个策略方法、26 个视频世界模型、27 个数据集/资源都被整理成可检索的条目。
- 论文:World Model for Robot Learning: A Comprehensive Survey,Bohan Hou、Gen Li、Jindou Jia、Tuo An、Xingying Guo 等(前五位共同一作,字母序),Nanyang Technological University / UC Berkeley / Stanford / 东京大学 / 牛津 / Microsoft / ETH Zurich / Princeton / Harvard,2026 年 4 月 30 日。
- 站内相关:可以先看 OpenWAM 解读——那是 2026 年秋季的一个 WAM 实例,正好可以套进本文第四节「单骨干 / MoE-MoT」这条线;基础概念可看 Transformer 交互解读。
一、动机:VLA 之外,为什么需要一张「世界模型」地图
过去三年的机器人策略学习基本沿着一条主线走:RT-2、OpenVLA、π0 这类视觉-语言-动作(VLA)模型把感知、语言理解和控制塞进一个端到端网络,从大规模机器人轨迹里学「看到什么、听到什么,就输出什么动作」[2, 3, 4]。这条路线在泛化性和指令跟随上进步很大,但它的工作方式是反应式的:策略只对当前观测做映射,不显式预测「如果我这样做,世界会变成什么样」。在长程任务、需要时间信用分配、或者误差会逐步累积的接触操作里,这层缺失会要命。
世界模型提供的是另一种结构。它源自认知科学里的「内部模型」(Craik,1943)、控制论里的「好调节器必须是系统的模型」(Conant & Ashby,1970),在机器学习里则有两波高潮:模型强化学习(Ha & Schmidhuber 的 World Models[5])和最近的大规模视频生成[6]。放到具身智能里,它不只是「生成一段好看的未来视频」,而是要成为从语义意图到物理可行行为的预测桥梁:在真正动手之前,先在内部推演动作的后果。
问题在于文献太碎:同样是「世界模型」,有人指 latent dynamics,有人指未来视频预测器,有人指 VLA 里的隐式预测头;它们分别被用在策略骨干、模拟器、数据引擎、评估器这些完全不同的位置。已有综述(例如 Zhang et al. 的机器人操作世界模型综述)覆盖面更宽,但对「世界模型和 VLA 到底是什么关系、在系统里承担什么功能」缺少细粒度的拆解。这篇综述的定位就是补这一刀,贡献有三:
- 以策略为中心的组织方式:重点讲预测模型如何与 VLA 策略耦合,去支撑动作生成、规划、模拟、评估和数据生成;
- 更细的架构与功能分类:把「世界模型当策略」拆成 5 种架构范式,把「世界模型当模拟器」拆成 2 种功能角色;
- 完整的配套盘点:视频世界模型的 4 个能力阶段、3 层评测框架、27 个数据集/资源,以及 6 个公开挑战。
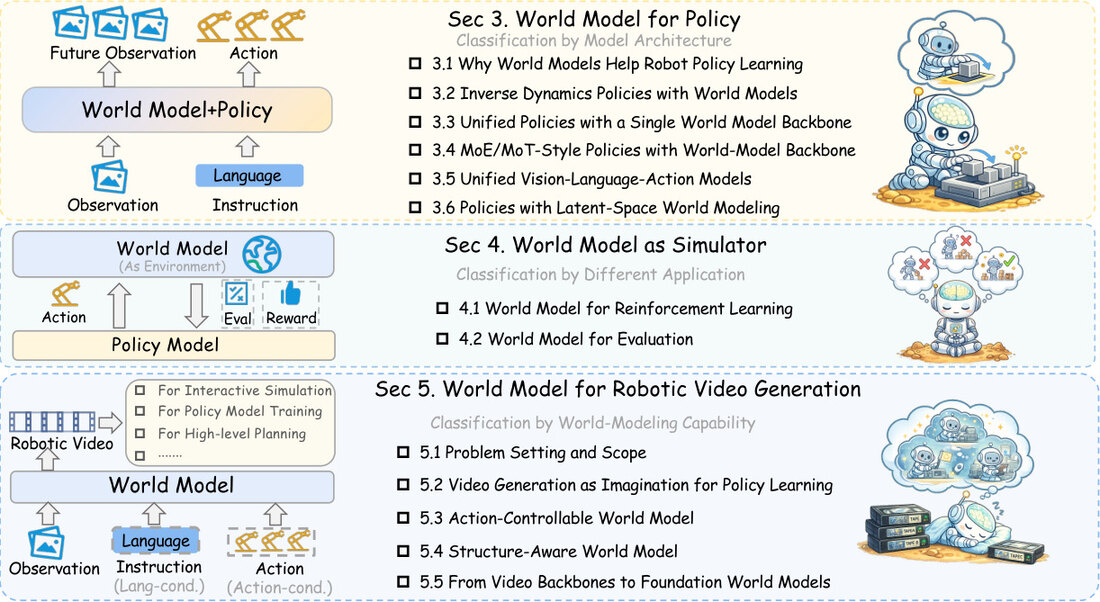
读这篇论文要调整预期:它是一份地图,不是一把锤子。作者没有提出新方法,价值在于把 2023 到 2026 年初的 200 多篇工作按「预测和动作的关系」重新排了一遍,并且明确告诉你每条路线的代价。对刚进入这个方向的人,这是一份很好的索引;对已经在做的人,它的分类和评测框架更适合拿来定位自己的工作。
二、定义:什么样的模型才算世界模型
2.1 功能性定义:能支撑行动的预测,才算世界模型
综述给的是一个功能性定义:世界模型是「智能体-环境动力学的预测模型」,描述机器人或具身系统在动作下如何演化。最标准的形式是一个状态转移模型:
其中 是建模的状态, 是低层物理动作序列, 是高层动作说明(语言指令、目标描述)。作者特意强调两点:
- 动作取广义:低层电机指令和语言指令都算「动作」,前者说怎么动,后者说未来应该被实现成什么样;
- 状态空间不设限: 可以是视觉观测、latent 状态、结构化物理状态,甚至是符号化的谓词/物体关系/因果过程。所以 latent dynamics、视频预测、符号规划模型都可以被收进来。
但真正划界的是行动性(actionable):一个模型不能仅仅因为能生成看起来合理的未来视频就成为世界模型,它必须捕捉「未来如何随机器人相关动作而改变」,并且这种预测要能服务于下游决策。在具身控制里最重要的子类是动作条件世界模型(action-conditioned world model),因为视觉上逼真但动作不一致的未来,对闭环控制几乎没有价值。
据此,作者把「可行动的世界模型」需要的能力拆成三条:预见(foresight)、想象驱动的规划(imagination-driven planning)、数据放大(data amplification)。这三条也对应后面三种完全不同的使用方式。
2.2 视频生成模型:世界模型在视觉观测空间的实例化
因为视觉观测是具身智能体最容易获得、信息最丰富的状态形式,综述里讨论的世界模型绝大多数是视觉世界模型,也就是在图像/视频空间里预测未来:
其中 是当前观测(可以多视角), 是未来帧或视频段。和 latent 状态模型相比,它保留了更丰富的空间、时间和交互细节,但也把问题变难了:除了感知真实感,还要满足时间连贯、动作一致、物理可信、长程稳定。这也是第六节四个能力阶段要逐层解决的问题。
2.3 策略背景:从 Diffusion Policy 到 VLA
为了给后面讨论「耦合」做铺垫,综述用一节回顾了机器人策略:
- 专用视觉运动策略:从观测直接回归动作,或以生成模型(Diffusion Policy[7]、flow matching)建模多模态动作分布。特点是轻量、精度高、泛化有限。
- 通用 VLA:在 VLM 骨干上加动作头,用大规模机器人轨迹联合微调。动作表示分两派——离散 token(RT-2、OpenVLA)把动作量化进语言词表,连续生成(π0 家族)用扩散/流匹配回归动作 chunk。
这节的作用是给第四节埋一个判断标准:世界模型和策略的耦合方式,本质上是在「预测」和「动作」之间选择哪些显式、哪些隐式。
2.4 时间线:两条并行的演化线
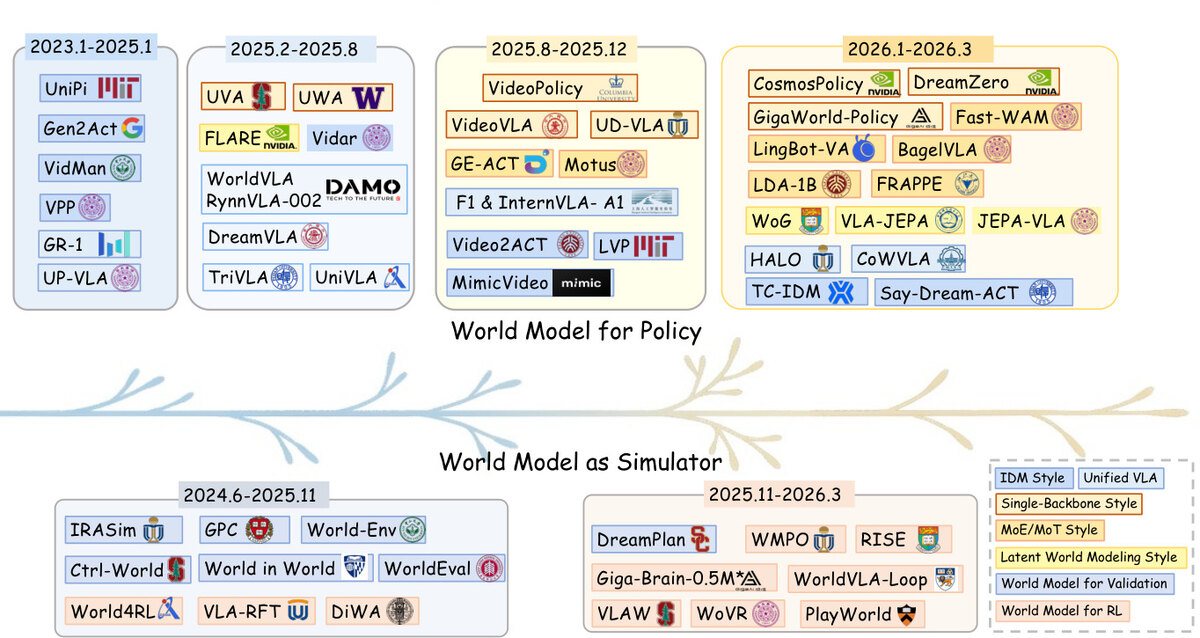
我自己的读法是:这张图最值得看的不是「谁新谁旧」,而是两个箭头——策略侧的箭头是预测越来越内化(从显式渲染视频,到 latent,到隐式预测头),模拟器侧的箭头是模拟器越来越像真的环境(从排序验证,到 RL 训练场,再到和策略一起进化)。两条箭头在 2025 年底之后开始交汇,出现了「训练时当模拟器、推理时只留策略」这类混合设计。
三、一个概率视角:四种查询,同一个联合分布
综述最漂亮的一个观察在 3.1 节。与其把策略模型、世界模型、逆动力学模型当成四种不同的东西,不如写出它们共同想建模的联合分布:
然后,四种范式只是对这个联合分布做不同的边缘化或条件化:
这个视角解释了两件事。第一,为什么世界模型和策略可以自然耦合:策略可以把世界模型生成的未来观测当作中间隐变量,逆动力学解码器再从预测的未来里恢复动作——两者本来就在同一个分布里。第二,为什么不同设计的推理代价和误差特性差那么多:策略把未来观测积分掉,推理最便宜但丢掉了显式的未来结构;可控世界模型把动作作为条件,rollout 最准但必须知道候选动作;IDM 把未来观测作为条件,动作恢复最直接,但前提是未来已经被生成出来(或已经观测到)。
下面这个部件把四种查询画在同一张图上。点按钮切换,看哪些变量是输入、哪些被积分掉、哪些是输出:
这个部件的意义不是玩概念:它解释了后面所有架构的差异来源。单骨干方法是把「联合分布」用一个网络一次参数化;IDM 式解耦是先查询被动世界模型、再查询逆动力学模型;训练时当模拟器则是在联合分布的样本上做策略优化。看到一个新方法时,先问它查询的是哪个条件概率,很多设计选择就顺了。
四、世界模型当策略:五条架构路线
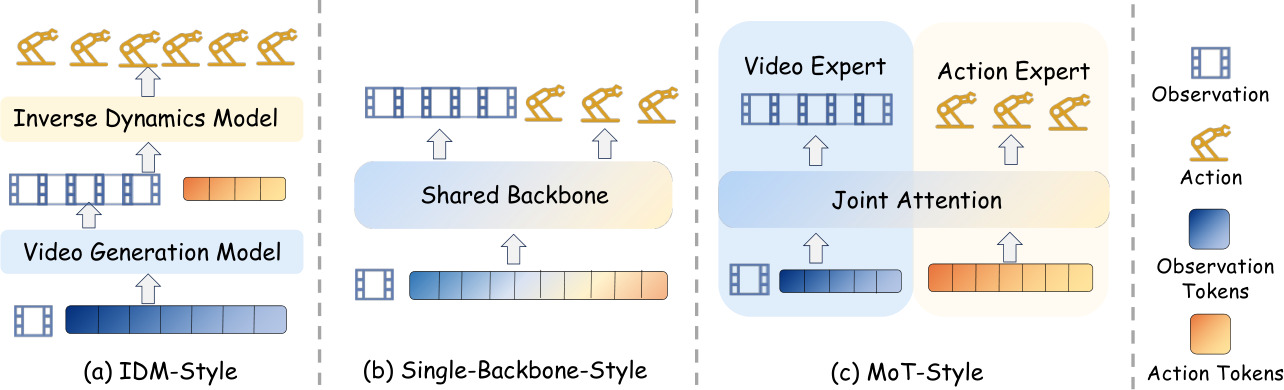
这是综述最长的一节(Sec 3),也是最值得读的一节。作者按「预测生成和动作生成怎么交互」把 41 个代表性方法排成五条路线,从最松的「先预测后动作」到最紧的「同一个生成过程」。Figure 3 给了三条典型架构的示意图:
4.1 IDM 式解耦:先预测未来,再反推动作
最早也最直观的路线:世界模型和策略是两个模块。世界模型先根据当前观测和任务指令生成未来观测序列(或它的 latent 表示):
然后一个独立的逆动力学策略从「当前观测 + 预测未来」恢复动作:
UniPi 是这条线的早期代表[8]:用文本条件视频模型生成未来轨迹,再用逆动力学从相邻帧里推出动作。Video Language Planning 把视频生成当作长程规划器[9];VidMan、Vidar 用 masked inverse dynamics 强调动作相关区域[10, 11];Gen2Act 干脆用人类视频生成来指导机器人执行[12];VPP、Video2Act 则不再解码像素,而是从预训练视频扩散模型的 latent 里抽控制相关特征,接一个单独的动作头[13, 14];MimicVideo 进一步把「未来」压缩成部分去噪的 latent visual plan[15];Say-Dream-ACT 把生成的视频计划当成 in-context 的视觉提示,而不是显式的反推目标[16]。
这条线的演进方向很清晰:预测出来的未来从「原始像素 rollout」逐步变成「latent / 结构化 / 执行友好」的中间表示,但世界模型和策略始终保持架构解耦。优点是模块化、视频先验可复用、未来可解释;代价是性能被生成未来的保真度和可控性卡住,而且视觉上合理、动作上不一致的未来会沿着逆动力学一路放大误差。
4.2 单骨干统一:把视频和动作塞进同一个生成过程
更紧的一步是只用一个生成骨干,同时建模未来视觉演化和未来动作。令 是未来视觉和动作表示的拼接,共享骨干 在条件 和去噪步 下预测:
其中 可以是扩散噪声、flow matching 的速度场,或者离散去噪的 masked token。UVA 学一个联合视频-动作 latent 空间[17];UWA 把视频扩散和动作扩散塞进同一个 Transformer,用模态专属时间步,并在推理时通过时间步控制把视觉未来边缘化掉[18];VideoVLA 直接把预训练视频 DiT 扩成 Video-Action DiT[19];VideoPolicy 把视频生成当作策略本体,动作只是加在上面的轻量接口[20]。
这条线上最值得细看的是「推理时视觉分支留多少」这个设计维度:
- Cosmos Policy 把动作、未来状态和 value 编码成原扩散序列里的额外「latent 帧」,直接复用预训练视频扩散架构;直接策略模式只用动作输出,规划模式才用未来状态和 value 给候选轨迹排序[21]。
- DreamZero 用自回归 flow-matching 的 video-action DiT,做 chunk 级的联合去噪,而不是自由发散的长程 rollout,从而限制误差累积[22]。
- GigaWorld-Policy 是更「动作中心」的变体:联合优化未来动作预测和动作条件下的未来视频生成,但用因果设计让视觉分支在推理时变成可选项[23]。
和 IDM 式相比,单骨干的优点是耦合紧、参数共享、部署时可以跳过视觉解码;代价是训练成本高,而且视频预测和动作生成的时间频率、表示尺度、优化目标并不天然一致——这正是下一条路线要解决的问题。
4.3 MoE/MoT 专家化:保留专家,但让专家深度交互
如果视频预测和动作生成的需求不同,为什么要强行共享全部参数?MoE/MoT 路线的答案是:保留视频、动作、甚至语言/场景理解的专门专家,但让它们通过共享注意力、交叉注意力或交错自回归序列反复交互。第 层的更新可以写成
其中 是 joint attention / cross-attention / shared-attention 这类逐层融合算子。Motu 用 Mixture-of-Transformers 给理解、视频生成、动作各配一个专家[24];LingBot-VA 把视频和动作 token 交错成一条自回归序列,用双流 MoT 加共享注意力,把想象出的未来状态当作动作精化的上下文[25];BagelVLA 把语言规划、视觉预测和动作生成交错在一个执行循环里,并用单步去噪的 Residual Flow Guidance 让视觉预测变得可用[26];DiT4DiT 用视频分支的中间去噪特征指导动作预测[27]。
这条线上有一个特别值得注意的「反例」——Fast-WAM。它同样采用共享注意力的 MoT 骨干,但论文的结论是:主要收益可能来自训练时的视频联合训练,而不是推理时真的去想象未来[28]。这直接引出了综述反复强调的一个问题:视频分支到底是「输出」,还是「预测性的 latent 过程」?如果是后者,推理时剪掉它是合理的工程选择。
4.4 统一 VLA:把预测内化进多模态策略
另一条路不引入显式的视频世界模型,而是在统一 VLA 的多模态骨干内部,用未来预测目标把「世界知识」内化进去。Figure 4 对比了 MLLM 路线的两种内化方式:
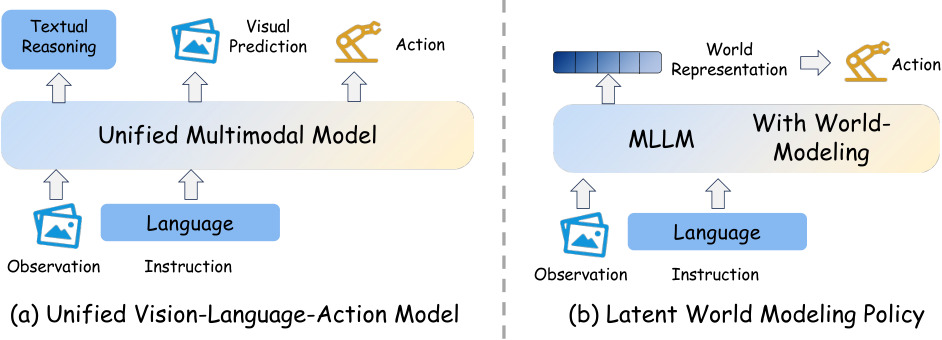
具体有三个子类:
- 显式未来状态预测:GR-1 在单个 GPT 式 Transformer 里联合预测动作和未来图像[29];UP-VLA 用未来图像预测同时提升动作生成和视觉泛化[30];WorldVLA 把动作和图像的理解/生成统一进一个自回归框架,但未来图像主要作为联合训练信号,而不是推理时必须输出[31]。
- 隐式或 latent 未来:DreamVLA 预测动态、空间、语义三类结构化世界知识来支撑逆动力学[32];UniVLA 在原生多模态 tokenization 上做后训练,让模型从大规模视频里吸收因果动力学[33]。
- 多专家/多系统统一模型:F1 在 MoT 里把未来视觉状态作为规划目标[34];InternVLA-A1 加轻量 latent visual foresight,联合优化预测和动作[35]。
和前面几类相比,统一 VLA 的边界更模糊:它不要求有独立的「世界模型模块」,只要求未来导向的预测目标被内化进同一个多模态策略。这也是它最容易落地的地方——不用改 VLA 的接口,只加训练目标。
4.5 Latent-space 与符号:不生成像素的世界模型
最后一条路彻底放弃显式图像/视频生成,只在表示空间里做预测。FLARE 是早期代表:把动作去噪网络的 hidden feature 与未来观测的 latent embedding 对齐,让策略隐式地「预期」未来[36]。VLA-JEPA 用 JEPA 式预训练目标,关键是无泄漏的状态预测:未来帧只用来产生 latent 监督目标,逼模型学动作相关的状态转移,而不是走像素变化的捷径[37]。JEPA-VLA 换了个角度:不额外加预测头,而是论证视频 JEPA(如 V-JEPA 2[38])学到的预测性 embedding 本身就是比静态视觉特征更好的策略先验[39]。WoG 则把世界建模搬进「条件空间」:不预测未来图像或通用 latent,而是学习对精确控制最有用的紧凑未来条件[40]。
再往外还有符号/规划器面向的世界模型:把世界抽象成谓词、物体关系、affordance 或因果过程,预测它们的转移,再交给符号规划器产生技能序列。这条线不追求视觉保真,但追求长程组合性和可解释性,是综述特意保留的补充视角。
4.6 五条路线怎么选
把 Sec 3 的 41 个方法压成一张表,差别一目了然:
| 范式 | 预测与动作怎么耦合 | 代表方法 | 取舍 |
|---|---|---|---|
| IDM 式解耦 | 世界模型出未来(像素或 latent),逆动力学再反推动作;推理通常要显式预测 | UniPi、VidMan、Vidar、Gen2Act、VPP、MimicVideo、Say-Dream-ACT | 模块化、可解释、视频先验可复用;误差串联,依赖生成保真度 |
| 单骨干统一 | 视频和动作 token 进同一个生成骨干联合去噪;推理可跳过视觉分支 | UVA、UWA、VideoVLA、VideoPolicy、Cosmos Policy、DreamZero、GigaWorld-Policy | 耦合紧、参数共享、部署可剪枝;训练贵,两种模态频率不一致 |
| MoE/MoT 专家化 | 视频/动作/语言保留专家参数,逐层用共享注意力交互;推理可选是否 rollout | Motus、LingBot-VA、BagelVLA、DiT4DiT、Fast-WAM | 保留模态专长、易扩展;架构复杂、通信开销 |
| 统一 VLA | 在 VLA 内部用未来图像或 latent 预测目标内化世界知识;推理以训练期预测为主 | GR-1、UP-VLA、WorldVLA、DreamVLA、UniVLA、F1、InternVLA-A1 | 不改 VLA 接口、易落地;视觉预测弱、监督间接 |
| Latent/符号 | 只在表征或符号空间预测未来,不做像素生成 | FLARE、VLA-JEPA、JEPA-VLA、WoG | 高效、避开像素冗余;依赖好的 latent / 抽象 |
下面这个部件把三条主线的分类做成可切换的浏览器:可以按「当策略用 / 当模拟器用 / 视频世界模型」三种视角切换,看每组范式的定义、代表方法和取舍。
这张表读完,我的三个判断是:
- 耦合深度不是单调的进步。解耦有解耦的好处(模块化、可解释、每个组件可以单独升级),统一有统一的好处(信息路径短、部署可以剪枝)。综述没有宣布谁赢,而是把「推理时未来生成还是否活跃」单独列成一列——这比按年份排序有用得多。
- 视频骨干是否优于 VLM 骨干,仍是一个开放的经验问题。综述明确写了这一点:当前结果只能说明视频预训练提供了「有希望的归纳偏置」,还不能算架构定论。MoE/MoT 和单骨干路线的很多收益,可能来自联合训练而非推理时真的「想象」。
- 最容易被忽略的是数据侧。五条路线里,IDM 式和 latent 式对数据的要求最低(前者可以复用现成视频模型,后者不需要视频解码),统一 VLA 和 MoE/MoT 则需要大规模「视频+动作」配对数据。这直接决定了实验室能不能复现。
五、世界模型当模拟器:从「想象里训练」到「想象里评估」
第二节说过,世界模型的第二种用法是当交互式模拟器:给定当前观测、任务指令和候选动作,模型可以 rollout 未来状态、给出反馈信号,支撑下游决策。这比「当策略」更直接——它试图让世界模型代替环境本身。
这个方向对机器人特别有吸引力,因为传统真机强化学习慢、贵、难重置、还有安全风险;而纯模仿学习受演示质量限制,学不会从失败里恢复。用学出来的模拟器替代真实交互,就能在想象里做策略改进。综述把这条线拆成两个功能:当 RL 环境和当评估器(Figure 5)。
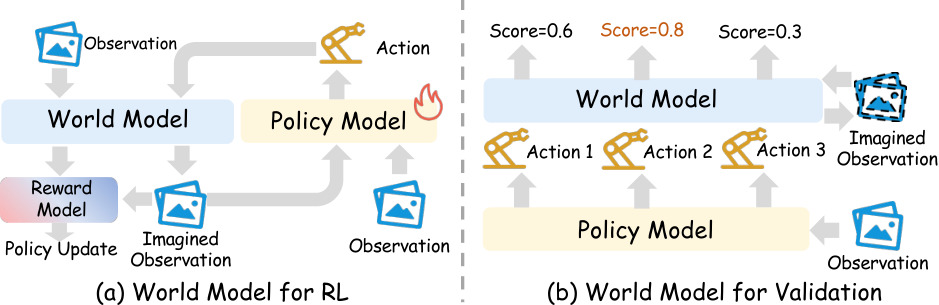
5.1 当强化学习环境:从「在模型里 RL」到「模型和策略一起进化」
形式上看,这类方法优化的是
也就是让策略 在世界模型 里采样轨迹、拿想象奖励,再用 GRPO 一类的策略梯度更新。综述把发展分成两级:
第一级:把世界模型当成固定的学习环境。 World-Env 给模拟器加了连续奖励预测和动作终止预测[41];VLA-RFT 用可控世界模拟器里验证过的奖励做 VLA 的强化微调[42];WMPO 强调像素级想象加 on-policy GRPO[43]。这一级的共同点是:世界模型是训练场,训练完就结束。
第二级:承认模拟器本身不完美,必须和策略一起改进。 World-VLA-Loop 联合预测未来观测和奖励,并用策略的失败 rollout 反过来精化模拟器[44];VLAW 走迭代修复路线,在「真实数据改模拟器」和「合成数据改策略」之间交替[45];WoVR 把模拟器可靠性当成核心瓶颈,引入可控动作条件视频建模、关键帧初始化的 rollout,以及显式的世界模型-策略共同演化:
策略的 rollout 用来改世界模型,改进后的世界模型又产生更好的想象数据给策略[46]。
这条演化线的核心信息是:在想象里做 RL,效果上限等于模拟器的可靠性。当模拟器会被策略「钻空子」时,继续加大 RL 只会放大模型漏洞;所以第二级方法把「模拟器保真度/动作跟随精度/rollout 稳定性」本身变成了优化目标。
5.2 当评估器:先想象后果,再决定动作
评估器用法的目标不是改进策略,而是在执行前判断「哪个候选动作/策略/checkpoint 更可能成功」。综述列了四种形态:
- 候选动作排序:GPC 在部署时给冻结的生成式策略接一个动作条件世界模型,用预测性 look-ahead 对候选动作排序和精化[47];IRASim 模拟多条候选轨迹,选预测价值最高的[48];World-in-World 把候选计划在想象里做闭环规划、由 revision policy 评估并修订后再执行[49]。
- 模型预测控制(MPC):TD-MPC2 在 latent 空间里做 MPC[50];LeWorldModel 用更简单、更快的端到端 JEPA 形式做 latent 预测和规划[51]。MPC 把世界模型从「动作的被动裁判」变成「连续控制优化的主动地图」。
- 策略评估器:WorldEval 研究「世界模型能否作为真实世界策略评估的可扩展代理」——在想象里给不同策略甚至同一策略的不同 checkpoint 排序,同时兼做安全检测器[52];WorldArena 把策略评估明确列为世界模型的核心下游功能之一[53];WorldGym 把学出来的模型当成交互环境做蒙特卡洛评估,检验估计出的策略价值和成功率是否与真实世界一致[54]。
- 反馈头:World-Env、VLA-RFT、World-VLA-Loop、WoVR 都给模拟器接上奖励/终止/进度预测头,把想象 rollout 转成评估信号。
这部分最值得记住的警告来自 WoVR 和 Ctrl-World:幻觉和长程误差不只降低画质,还会直接污染评估信号。一个评估器只有在「想象出的未来忠实保留候选动作的因果后果」时才有用;视觉真实感既不充分也不必要。对做评测的人来说,这意味着「世界模型当 benchmark」这条路目前还不能替代真机,只能当预筛和诊断。
六、机器人视频世界模型:四个能力阶段
第五节是「当策略」和「当模拟器」两条功能线;第六节换了一个视角,专门看机器人视频世界模型本身的能力演进。这里的核心对象是:给定当前观测、任务说明和(可选的)动作序列,预测未来的视觉演化。和通用视频生成比,它多了四个硬要求:时间连贯、动作一致、物理可信、长程稳定。
综述把它分成四个能力阶段(Figure 6):
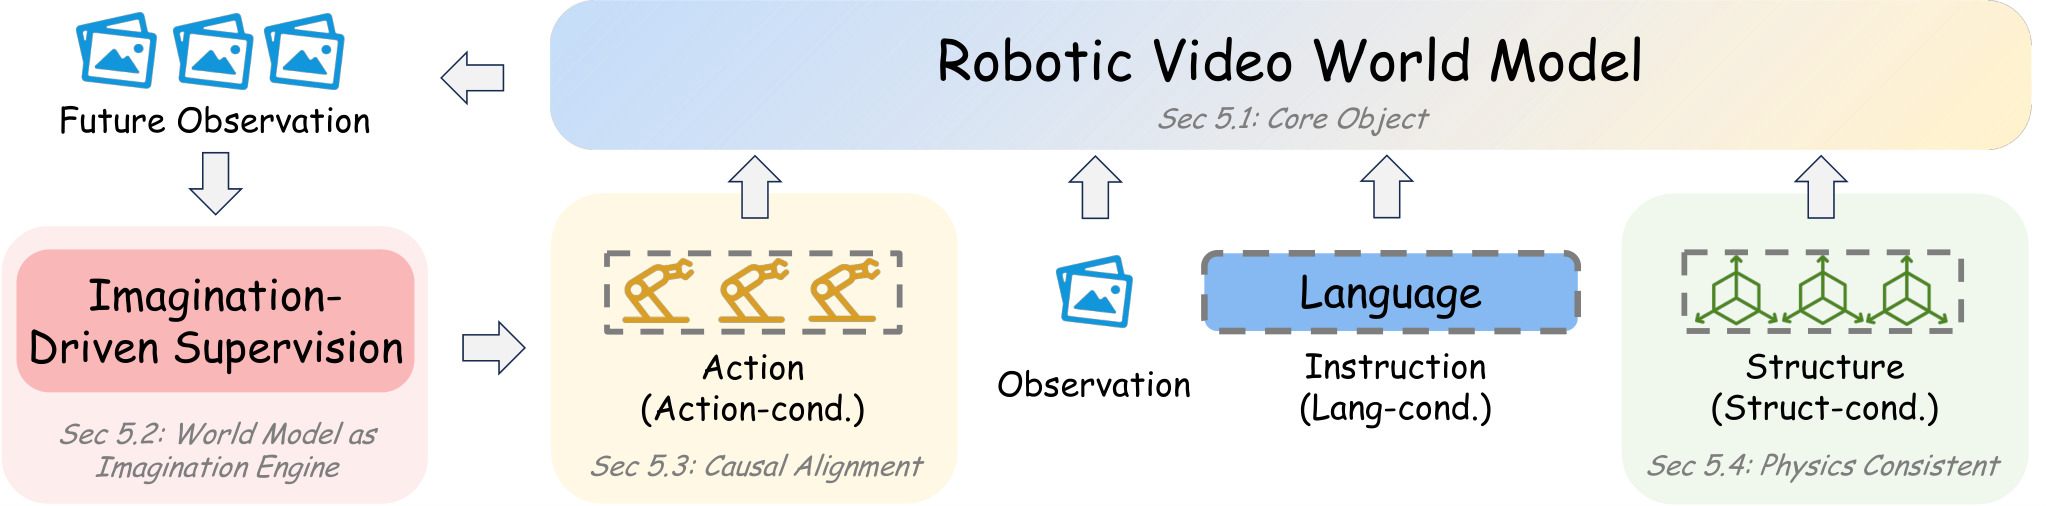
| 阶段与核心问题 | 代表工作 | 关键进展与仍缺什么 |
|---|---|---|
| ① 想象监督:生成的未来能当额外监督或规划吗? | UniPi、DreamGen、Say-Dream-ACT | 把视频生成变成策略监督、视觉规划、数据放大;但生成不保证跟随动作,物理一致性弱 |
| ② 动作可控:生成的未来是否忠实跟随给定动作? | IRASim、Ctrl-World、EnerVerse-AC | 帧级动作条件、多视角 joint 预测、记忆式长程生成;强动作条件难训,长程稳定性不足 |
| ③ 结构感知:能否保持接触关系和场景结构? | Mask2IV、TesserAct、RoboVIP | mask 轨迹、4D RGB-D-N、视觉身份提示;结构标注贵,跨本体/视角泛化难 |
| ④ 基础模型:能否成为可复用的交互式世界接口? | DreamDojo、WoW、Cosmos Predict 2.5、GigaWorld-0、ABot-PhysWorld | 大规模骨干 + 动作/物理对齐 + 数据引擎;训练推理成本高,动作对齐仍是瓶颈 |
展开说一下每个阶段的代表思路:
① 想象监督。 这一阶段的视频模型主要当「想象引擎」:用强生成先验合成未来执行,再转成动作监督或视觉规划。UniPi 和 DreamGen 是典型——后者把强视频生成器适配到目标本体,合成神经轨迹,再通过 latent action 或逆动力学恢复动作,核心论点是更强的视频世界模型不仅能正则化策略,还能产出提升泛化的合成经验[55]。
② 动作可控。 一旦要让未来「跟随动作」,关键就变成 action conditioning 有多强。IRASim 把操作形式化成 trajectory-to-video,在每个 transformer block 里做帧级动作条件[48];Ctrl-World 把可控性推进到 policy-in-the-loop:联合多视角预测、帧级动作控制、基于记忆的长程生成,让预测未来既能支撑策略评估,也能指导策略改进[56];EnerVerse-AC 把世界模型做成动作条件的多视角生成器,既能当数据引擎又能当推理评估器[57]。
③ 结构感知。 只给低维动作不够,接触关系、几何、视角一致性需要额外的结构先验。Mask2IV 先预测 actor 和 object 的交互轨迹,再以轨迹为条件生成视频[58];TesserAct 把表征空间从 2D 视频扩到 RGB、深度、法向的 4D 世界模型[59];RoboVIP 用视觉身份提示引导多视角视频扩散,把生成视频当可扩展的数据增强[60]。
④ 基础模型。 最新一波把机器人视频世界模型当成通用交互式预测器:DreamDojo 在大规模人类第一视角视频上预训练,用连续 latent action 桥接无标注人类交互和机器人控制,再对目标本体后训练,支持长程实时 rollout、策略评估和基于模型的规划[61];WoW 强调物理直觉不能只靠被动视频,要用大量机器人交互轨迹训练生成式世界模型,并把生成 rollout、逆动力学和 critique 耦合起来闭环[62];Cosmos Predict 2.5 和 GigaWorld-0 代表「可复用世界骨干」和「数据引擎」两种平台化路线[63, 64];ABot-PhysWorld 则把「物理对齐」当成世界基础模型的核心指标[65]。
四个阶段看下来,综述对瓶颈的判断很清楚:问题已经不是「生成得像不像」,而是「未来是否和动作因果对齐、是否在长程上物理/运动学自洽、是否跨视角和跨本体一致、是否稳定到能支撑真实策略改进」。视频生成对机器人的价值,最终取决于它能不能把未来预测变成一个可控、可交互、可执行的接口。
七、跳出操作:导航与自动驾驶
虽然综述以操作为主,但它用一节把导航和自动驾驶也接了进来,因为这两块是「世界模型当预测性规划基底」最自然的场景。
导航的难点是严重的部分可观测:智能体必须对还没看到的空间做推理。世界模型在这里的作用是想象动作条件下的未来观测、构造未来感知的规划状态,或者从想象轨迹里推出价值信号。Pathdreamer 为未访问的室内视角生成合理的 360° RGB、深度和语义观测,并证明「用想象观测做规划」能显著缩小与「用真实未来观测做规划」的差距[66];Navigation World Models 直接把可控视频生成定义成导航世界模型,让候选动作 rollout 出的自我中心未来进入在线规划[67]。核心结论是:导航里世界模型的价值不在视觉真实感,而在于把看不见的未来结构变成可用于规划、轨迹排序和价值估计的形式。
自动驾驶的要求更苛刻:长程预测、多智能体交互、结构化几何、安全关键规划。综述把它归成两条互补路线:
- 结构化预测状态:OccWorld 在 3D 占用空间里做世界建模,把自车运动和场景演化表示成规划友好的形式[68];
- 生成式世界模型:GAIA-1 把驾驶世界建模成视频、文本、动作 token 上的多模态序列建模[69];Drive-WM 生成可控的多视角未来视频,用想象出的多未来 rollout 加图像奖励来挑选更安全的轨迹[70]。
更近的工作把两者往规划端推:DriveWorld-VLA 用 latent 世界状态作为规划器的决策状态,让动作条件的想象在不做昂贵像素 rollout 的情况下指导控制[71]。共同直觉是:安全驾驶不仅需要识别当前场景,还需要推理它在自车行为和周围交通动力学下会如何演化。
八、怎么评测、用什么数据、现在什么水平
8.1 三层评测框架
在机器人里评测世界模型,和评视频生成模型是两件事。视频生成的指标(FVD、PSNR 之类)衡量的是「像不像」;而世界模型的价值取决于它能不能生成动作条件一致、物理可信、对下游决策有用的未来。综述把现有评测整理成三层:
| 层级 | 回答的问题 | 代表基准 | 能看到什么 / 局限 |
|---|---|---|---|
| 开环预测质量 | 给定观测和动作/指令,未来是否语义正确、时间连贯、动作响应? | RBench[72]、EWMBench[73] | 容易规模化和标准化;但不在闭环里,结果要谨慎解读 |
| 闭环任务效用 | 把世界模型放进规划/评估/策略回路,是否提升决策质量? | WorldArena、WorldEval、WorldGym、World-in-World | 更贴近具身智能;但协议复杂、误差会累积 |
| 物理解释诊断 | 哪些具体性质决定 rollout 可用? | WorldSimBench[74]、WM-ABench[75] | 能定位失败模式(动作敏感、物理一致、可执行);不直接给任务成功率 |
三层的关系是「筛子」:开环筛掉明显不可用的模型,闭环筛掉决策无用的模型,诊断告诉你为什么失败。综述反复强调一个反直觉的点:视觉真实感既不是必要条件也不是充分条件。WorldEval 和 WorldArena 的实验都显示,一个模型可以在画质上很漂亮,却在策略排序、动作跟随和闭环控制上不及格;反过来,视觉保真度一般的 latent 模型也可能对规划有用。
8.2 数据集:27 个资源,短板在「失败」和「物理信号」
Table 3 和 Table 4 盘点了 27 个数据集/资源,按五个维度比较:跨本体覆盖、动作监督、观测/3D 支持、语言条件、多模态/接触信号;再按六种能力排:通用轨迹预训练、长程建模、跨本体扩展、人类先验、接触/物理、合成/配方。
不用逐行背,记住三类代表就够了:
| 资源 | 类型 | 对世界模型训练的意义 / 短板 |
|---|---|---|
| OXE[76] | 真机、跨本体聚合 | 提供多平台动作条件转移覆盖;异质、噪声大,长程结构弱 |
| DROID[77] | 真机、in-the-wild | 场景和视角多样,接近真实部署;单平台为主,动作频率低 |
| AgiBot World[78] | 真机、大规模 | 长程、多任务、双手机器人数据;单一本体生态,跨本体迁移有限 |
| UMI[79] | 手持夹具、robot-free | 低成本采集人类操作轨迹,场景多样;无机器人执行,动作需重定向 |
| RoboTwin 2.0[80] | 仿真、强域随机 | 可规模化、可控变化、带动作;sim-to-real 差距,物理真实性受限 |
作者点出的核心缺口是:失败恢复、对决策敏感的变化、稠密的物理接地监督,这三类数据远比「大规模成功演示」稀缺。这解释了为什么很多世界模型在「演示分布内」看起来不错,一到接触丰富、需要纠错的场景就崩。
8.3 结果:没有单一范式统治,长程是分水岭
综述用两张表汇总了标准基准上的数字。LIBERO[81] 四套件(Spatial / Object / Goal / Long 的平均成功率)上,头部方法已经挤在 97 到 98.5 之间:
| 方法 | 范式 | LIBERO 平均 |
|---|---|---|
| Cosmos Policy | 单骨干 | 98.5 |
| LingBot-VA | MoE/MoT | 98.5 |
| Say-Dream-ACT | IDM 解耦 | 98.1 |
| Motus | MoE/MoT | 97.7 |
| RynnVLA-002(WorldVLA) | MoE/MoT | 97.4 |
| VLA-JEPA | Latent | 97.2 |
| JEPA-VLA | Latent | 96.4 |
| F1 | 统一 VLA | 95.7 |
| MimicVideo | IDM 解耦 | 93.9 |
RoboTwin 2.0 更能拉开差距(RT-A 是简单/非随机环境,RT-B 是强随机环境):
| 方法 | 范式 | RT-A | RT-B |
|---|---|---|---|
| LingBot-VA | MoE/MoT | 92.9 | 91.6 |
| InternVLA-A1 | 统一 VLA | 89.4 | 87.0 |
| Motus | MoE/MoT | 88.7 | 87.0 |
| HALO | 统一 VLA | 80.5 | 26.4 |
| BagelVLA | MoE/MoT | 75.3 | 20.9 |
| JEPA-VLA | Latent | 73.5 | 17.7 |
| Vidar | IDM 解耦 | 65.8 | 17.5 |
| FRAPPE | MoE/MoT | 57.5 | 25.5 |
| Video2Act | IDM 解耦 | 54.6 | 54.1 |
下面这个部件把表格做成可切换的条形图,按范式着色。注意 RoboTwin 从 RT-A 切到 RT-B 时,很多方法会断崖式下跌——这正是综述说的「benchmark 依赖」:
从两张表和部件里能读出三个结论:
- 世界模型在标准操作基准上已经有很强的实用价值。 LIBERO 头部 98.5,已经饱和;RoboTwin 头部 92.9,远超两年前的 VLA 基线。
- 高性能不只属于一种范式。 IDM 解耦、单骨干、MoE/MoT、统一 VLA、latent 都出过 97+ 的结果,说明必须生成逼真视频并不是有效世界模型的必要条件——这可能是整份综述最值钱的一句话。
- 长程和跨基准泛化仍是分水岭。 LIBERO 的 Goal/Long 两个套件普遍比 Spatial/Object 低;RoboTwin 一换随机化设置,非 MoE/MoT 的方法大面积掉分。作者也承认,当前结果对本体、动作空间、任务构成、评测协议都很敏感,跨平台表格不能当严格排行榜看。
九、六个开放挑战
综述最后一节列了六个挑战,我逐条翻译并补一句自己的理解:
- 因果条件缺口(causal conditioning gaps)。 很多世界模型的未来预测受历史上下文和任务意图的影响,远大于受「即将执行的机器人动作」的影响。结果是未来看着合理,却不是这个动作的后果。WorldVLA 用隐式统一训练把未来状态预测和动作生成耦合起来,试图缩小这个错位[31]。我的理解:这是世界模型用于闭环控制的第一道坎,也是「生成质量高但控制没用」的根因。
- 效率瓶颈。 世界模型策略比 VLA 重得多:要么联合预测视频和动作,要么需要先微调再学策略。参数高效适配(轻量 adapter)能缓解;推理侧对扩散视频的迭代去噪延迟很高,MimicVideo、LingBot-VA 用部分去噪缓解[15, 25];更彻底的是 latent 世界模型(LeWorldModel)[51],或者像 Fast-WAM 那样「训练时用世界模型、推理时去掉」[28]。
- 多模态感知瓶颈。 当前世界模型主要靠视觉和本体感知,抓不住摩擦、刚度、接触稳定性这些不可观测量。触觉和力反馈是提供真实交互信号的关键,但触觉高频、低维,和视觉高维特征做联合 latent 优化时很容易被视觉淹没,频率和维度的对齐是硬问题。
- 经典控制融合。 世界模型可以作为 MPC 的前向动力学,但 MPC 需要反复 rollout,算力开销限制了大模型在动态环境里的实时部署。更远的问题是:怎么把神经网络的表达能力,和 Lyapunov 稳定性、鲁棒控制这些形式化保证结合起来。综述认为这是走向自适应的开放世界系统的关键。
- 符号结构整合。 像素 rollout 的长程误差会毁掉规划可靠性;符号世界模型把世界抽象成物体、关系、谓词、占用图,做离散或规则化的状态转移,长程更稳,但需要合适的抽象和感知落地。混合「学习到的感知表示 + 符号结构」是作者看好的方向。
- 评估指标开放问题。 没有公认的评测指标。视觉保真度既非必要也非充分,真正需要的是功能导向的指标:任务成功率、策略排序保真度、可执行性诊断。现实是各 benchmark 协议割裂,比较仍然困难。
十、我的观察:这份综述的价值和边界
读完 43 页,我的评价是:它是一份很好的「地图」,但不是一篇「裁判书」。优点前面已经说了,这里补几条批评和使用建议,供你判断要不要把它当参考基准:
- 分类边界是重叠的。 作者自己也承认「类别不是严格互斥」:InternVLA-A1 既是统一 VLA 又有 MoT 结构,Fast-WAM 既是 MoE/MoT 又接近「训练时世界模型」。这在实际读论文时会造成归类困难。我的建议是把它当多标签看:一个方法可以同时是「单骨干 + 统一 VLA + latent 辅助」。
- 表格不是排行榜。 Table 5 和 6 里混了不同协议、不同数据、不同动作空间的结果,作者明确说 RoboTwin[80] 和 CALVIN[82]、SIMPLER[83] 这类结果「不适合严格排序」。所以看到「谁第一」时,要回到原始论文核对设置。
- 对每个方法的描述是「索引级」的。 215 篇文献、43 页,平均每个方法只有一两句话,很多关键设计(动作表示、训练目标、数据配比)需要点进原文。它适合帮你找到该读哪篇,不适合替代读论文。
- 缺三类系统性对比。 一是真实机器人上的成功率/鲁棒性元分析;二是训练/推理成本、延迟、显存这些部署指标的横向表;三是安全性、可解释性、数据许可证这些工程落地问题。综述对这些只在文字里带过。
- 时间窗口很短。 时间线覆盖到 2026 年 3 月 31 日,而领域几乎每月都在变。这篇 2026 年 4 月底的 v1,到 10 月已经有大量新工作(比如站内写过的 OpenWAM)。好在作者把awesome list 当成活文档维护——读综述建立框架,之后靠仓库跟进,这是正确的用法。
- 一个我觉得值得单独拎出来的细节:RoboTwin 上 Video2Act(IDM 解耦)从 RT-A 的 54.6 到 RT-B 的 54.1 几乎不掉,而 HALO 从 80.5 掉到 26.4。这说明「域随机化下的稳定性」和「干净环境下的峰值」是两个不同的能力维度;只看单一 benchmark 的均值会严重误判。这也是综述三层评测框架存在的意义。
十一、结论与上手
把整份综述压成一句话:世界模型不是「给机器人加一个视频生成器」,而是给「从预测到行动」这条链路提供结构——它可以内化进策略(5 种架构路线),可以替代环境(RL 模拟器 / 评估器),也可以作为视频生成能力逐级演进(4 个阶段);而所有这些用法能否落地,最终取决于动作因果一致性、物理可执行性和评估的可信度。
如果你只想带走三件事:
- 先问「查询的是哪个条件概率」。策略、被动世界模型、可控世界模型、IDM 是同一个联合分布的四种查询;一个新方法的设计选择、推理成本和误差来源,基本都能从这个视角解释。
- 不要用「生成得像不像」评判世界模型。开环看动作响应和物理一致性,闭环看策略排序和任务效用,诊断看失败模式;三层结合才靠谱。
- 耦合深度没有标准答案。解耦好维护、统一好部署、专家化好扩展;当前证据不支持「某一种架构必然更好」,反而支持「数据规模和任务分布决定上限」。
上手:怎么用这份综述和配套仓库
这是一篇综述,没有官方代码;可交付的「上手」就是资源本身:
- Awesome World Models for Robotic Policy Learning(873 星)把论文、代码、项目页、模型、基准和数据集按综述结构整理成 164 个条目,分五大块:World Model as Policy(IDM / 单骨干 / MoE-MoT / 统一 VLA / Latent)、World Model as Simulator(RL / Evaluation)、World Model for Video Generation、Benchmarks、Datasets。每个条目都带 arXiv、GitHub、Website 徽章,适合当检索索引。
- 项目页 有可交互的分类面板和一条会持续更新的时间线(目前覆盖到 2026 年 3 月 31 日),比 PDF 里的静态图 2 更适合看演进。
- 阅读路径建议:做策略/算法 → 先读第三节(概率视角)+ 第四节五条路线 + 第 8.3 节结果;做视频生成 → 第五节(四阶段)+ 第六节(视频世界模型);做评测/数据 → 第七节 + 第八节;做系统/部署 → 第五节的效率部分 + 第八节。
仓库本身没有声明开源许可证,引用时请按论文的 BibTeX 和原论文作者要求处理;论文里的代码链接都指向各方法自己的仓库,许可证各不相同,用之前逐个确认。
参考
- Hou, Li, Jia, An, Guo, et al.. World Model for Robot Learning: A Comprehensive Survey. arXiv 2605.00080, 2026. arXiv · 资源列表
- Brohan, Brown, Carbajal, et al.. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv 2307.15818, 2023. arXiv
- Kim, Pertsch, Karamcheti, et al.. OpenVLA: An Open-Source Vision-Language-Action Model. arXiv 2406.09246, 2024. arXiv
- Black, Brown, Driess, et al.. $π_0$: A Vision-Language-Action Flow Model for General Robot Control. arXiv 2410.24164, 2024. arXiv
- Ha, Schmidhuber. World Models. arXiv 1803.10122, 2018. arXiv
- Yang, Teng, Zheng, et al.. CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer. arXiv 2408.06072, 2024. arXiv
- Chi, Xu, Feng, et al.. Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. arXiv 2303.04137, 2023. arXiv
- Du, Yang, Dai, et al.. Learning Universal Policies via Text-Guided Video Generation. arXiv 2302.00111, 2023. arXiv
- Du, Yang, Florence, et al.. Video Language Planning. arXiv 2310.10625, 2023. arXiv
- Wen, Lin, Zhu, et al.. VidMan: Exploiting Implicit Dynamics from Video Diffusion Model for Effective Robot Manipulation. arXiv 2411.09153, 2024. arXiv
- Feng, Tan, Mao, et al.. Vidar: Embodied Video Diffusion Model for Generalist Manipulation. arXiv 2507.12898, 2025. arXiv
- Bharadhwaj, Dwibedi, Gupta, et al.. Gen2Act: Human Video Generation in Novel Scenarios enables Generalizable Robot Manipulation. arXiv 2409.16283, 2024. arXiv
- Hu, Guo, Wang, et al.. Video Prediction Policy: A Generalist Robot Policy with Predictive Visual Representations. arXiv 2412.14803, 2024. arXiv
- Jia, Liu, Liu, et al.. Video2Act: A Dual-System Video Diffusion Policy with Robotic Spatio-Motional Modeling. arXiv 2512.03044, 2025. arXiv
- Pai, Achenbach, Montesinos, et al.. mimic-video: Video-Action Models for Generalizable Robot Control Beyond VLAs. arXiv 2512.15692, 2025. arXiv
- Gu, Cai, Wang, et al.. Say, Dream, and Act: Learning Video World Models for Instruction-Driven Robot Manipulation. arXiv 2602.10717, 2026. arXiv
- Li, Gao, Sadigh, et al.. Unified Video Action Model. arXiv 2503.00200, 2025. arXiv
- Zhu, Yu, Feng, et al.. Unified World Models: Coupling Video and Action Diffusion for Pretraining on Large Robotic Datasets. arXiv 2504.02792, 2025. arXiv
- Shen, Wei, Du, et al.. VideoVLA: Video Generators Can Be Generalizable Robot Manipulators. arXiv 2512.06963, 2025. arXiv
- Liang, Tokmakov, Liu, et al.. Video Generators are Robot Policies. arXiv 2508.00795, 2025. arXiv
- Kim, Gao, Lin, et al.. Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning. arXiv 2601.16163, 2026. arXiv
- Ye, Ge, Zheng, et al.. World Action Models are Zero-shot Policies. arXiv 2602.15922, 2026. arXiv
- Ye, Wang, Ni, et al.. GigaWorld-Policy: An Efficient Action-Centered World--Action Model. arXiv 2603.17240, 2026. arXiv
- Bi, Tan, Xie, et al.. Motus: A Unified Latent Action World Model. arXiv 2512.13030, 2025. arXiv
- Li, Zhang, Luo, et al.. Causal World Modeling for Robot Control. arXiv 2601.21998, 2026. arXiv
- Hu, Zhang, Luo, et al.. BagelVLA: Enhancing Long-Horizon Manipulation via Interleaved Vision-Language-Action Generation. arXiv 2602.09849, 2026. arXiv
- Ma, Zheng, Wang, et al.. DiT4DiT: Jointly Modeling Video Dynamics and Actions for Generalizable Robot Control. arXiv 2603.10448, 2026. arXiv
- Yuan, Dong, Liu, et al.. Fast-WAM: Do World Action Models Need Test-time Future Imagination?. arXiv 2603.16666, 2026. arXiv
- Wu, Jing, Cheang, et al.. Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation. arXiv 2312.13139, 2023. arXiv
- Zhang, Guo, Hu, et al.. UP-VLA: A Unified Understanding and Prediction Model for Embodied Agent. arXiv 2501.18867, 2025. arXiv
- Cen, Huang, Yuan, et al.. RynnVLA-002: A Unified Vision-Language-Action and World Model. arXiv 2511.17502, 2025. arXiv
- Zhang, Liu, Qi, et al.. DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge. arXiv 2507.04447, 2025. arXiv
- Bu, Yang, Cai, et al.. UniVLA: Learning to Act Anywhere with Task-centric Latent Actions. arXiv 2505.06111, 2025. arXiv
- Lv, Kong, Li, et al.. F1: A Vision-Language-Action Model Bridging Understanding and Generation to Actions. arXiv 2509.06951, 2025. arXiv
- Cai, Cai, Cao, et al.. InternVLA-A1: Unifying Understanding, Generation and Action for Robotic Manipulation. arXiv 2601.02456, 2026. arXiv
- Zheng, Wang, Reed, et al.. FLARE: Robot Learning with Implicit World Modeling. arXiv 2505.15659, 2025. arXiv
- Sun, Zhang, Qi, et al.. VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model. arXiv 2602.10098, 2026. arXiv
- Assran, Bardes, Fan, et al.. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning. arXiv 2506.09985, 2025. arXiv
- Miao, Feng, Wu, et al.. JEPA-VLA: Video Predictive Embedding is Needed for VLA Models. arXiv 2602.11832, 2026. arXiv
- Su, Chen, Shi, et al.. World Guidance: World Modeling in Condition Space for Action Generation. arXiv 2602.22010, 2026. arXiv
- Xiao, Yang, Chang, et al.. World-Env: Leveraging World Model as a Virtual Environment for VLA Post-Training. arXiv 2509.24948, 2025. arXiv
- Li, Ding, Suo, et al.. VLA-RFT: Vision-Language-Action Reinforcement Fine-tuning with Verified Rewards in World Simulators. arXiv 2510.00406, 2025. arXiv
- Zhu, Yan, Hong, et al.. WMPO: World Model-based Policy Optimization for Vision-Language-Action Models. arXiv 2511.09515, 2025. arXiv
- Liu, Bai, Ci, et al.. World-VLA-Loop: Closed-Loop Learning of Video World Model and VLA Policy. arXiv 2602.06508, 2026. arXiv
- Guo, Lee, Shi, et al.. VLAW: Iterative Co-Improvement of Vision-Language-Action Policy and World Model. arXiv 2602.12063, 2026. arXiv
- Jiang, Zhou, Jiang, et al.. WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL. arXiv 2602.13977, 2026. arXiv
- Qi, Yin, Zhu, et al.. Inference-Time Enhancement of Generative Robot Policies via Predictive World Modeling. arXiv 2502.00622, 2025. arXiv
- Zhu, Wu, Guo, et al.. IRASim: A Fine-Grained World Model for Robot Manipulation. arXiv 2406.14540, 2024. arXiv
- Zhang, Jiang, Dai, et al.. World-in-World: World Models in a Closed-Loop World. arXiv 2510.18135, 2025. arXiv
- Hansen, Su, Wang. TD-MPC2: Scalable, Robust World Models for Continuous Control. arXiv 2310.16828, 2023. arXiv
- Maes, Lidec, Scieur, et al.. LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels. arXiv 2603.19312, 2026. arXiv
- Li, Zhu, Wen, et al.. WorldEval: World Model as Real-World Robot Policies Evaluator. arXiv 2505.19017, 2025. arXiv
- Shang, Li, Ma, et al.. WorldArena: A Unified Benchmark for Evaluating Perception and Functional Utility of Embodied World Models. arXiv 2602.08971, 2026. arXiv
- Quevedo, Sharma, Sun, et al.. WorldGym: World Model as An Environment for Policy Evaluation. arXiv 2506.00613, 2025. arXiv
- Jang, Ye, Lin, et al.. DreamGen: Unlocking Generalization in Robot Learning through Video World Models. arXiv 2505.12705, 2025. arXiv
- Guo, Shi, Chen, et al.. Ctrl-World: A Controllable Generative World Model for Robot Manipulation. arXiv 2510.10125, 2025. arXiv
- Jiang, Chen, Huang, et al.. EnerVerse-AC: Envisioning Embodied Environments with Action Condition. arXiv 2505.09723, 2025. arXiv
- Li, Zhao, Yang. Mask2IV: Interaction-Centric Video Generation via Mask Trajectories. arXiv 2510.03135, 2025. arXiv
- Zhen, Sun, Zhang, et al.. TesserAct: Learning 4D Embodied World Models. arXiv 2504.20995, 2025. arXiv
- Wang, Zhang, Zhang, et al.. RoboVIP: Multi-View Video Generation with Visual Identity Prompting Augments Robot Manipulation. arXiv 2601.05241, 2026. arXiv
- Gao, Liang, Zheng, et al.. DreamDojo: A Generalist Robot World Model from Large-Scale Human Videos. arXiv 2602.06949, 2026. arXiv
- Chi, Jia, Fan, et al.. WoW: Towards a World omniscient World model Through Embodied Interaction. arXiv 2509.22642, 2025. arXiv
- NVIDIA, :, Ali, et al.. World Simulation with Video Foundation Models for Physical AI. arXiv 2511.00062, 2025. arXiv
- Team, Ye, Wang, et al.. GigaWorld-0: World Models as Data Engine to Empower Embodied AI. arXiv 2511.19861, 2025. arXiv
- Chen, Chen, Huo, et al.. ABot-PhysWorld: Interactive World Foundation Model for Robotic Manipulation with Physics Alignment. arXiv 2603.23376, 2026. arXiv
- Koh, Lee, Yang, et al.. Pathdreamer: A World Model for Indoor Navigation. arXiv 2105.08756, 2021. arXiv
- Bar, Zhou, Tran, et al.. Navigation World Models. arXiv 2412.03572, 2024. arXiv
- Zheng, Chen, Huang, et al.. OccWorld: Learning a 3D Occupancy World Model for Autonomous Driving. arXiv 2311.16038, 2023. arXiv
- Hu, Russell, Yeo, et al.. GAIA-1: A Generative World Model for Autonomous Driving. arXiv 2309.17080, 2023. arXiv
- Wang, He, Fan, et al.. Driving into the Future: Multiview Visual Forecasting and Planning with World Model for Autonomous Driving. arXiv 2311.17918, 2023. arXiv
- jia, Liu, Song, et al.. DriveWorld-VLA: Unified Latent-Space World Modeling with Vision-Language-Action for Autonomous Driving. arXiv 2602.06521, 2026. arXiv
- Deng, Pan, Zhang, et al.. Rethinking Video Generation Model for the Embodied World. arXiv 2601.15282, 2026. arXiv
- Yue, Huang, Liao, et al.. EWMBench: Evaluating Scene, Motion, and Semantic Quality in Embodied World Models. arXiv 2505.09694, 2025. arXiv
- Qin, Shi, Yu, et al.. WorldSimBench: Towards Video Generation Models as World Simulators. arXiv 2410.18072, 2024. arXiv
- Gao, Pi, Liu, et al.. Do Vision-Language Models Have Internal World Models? Towards an Atomic Evaluation. arXiv 2506.21876, 2025. arXiv
- Collaboration, O'Neill, Rehman, et al.. Open X-Embodiment: Robotic Learning Datasets and RT-X Models. arXiv 2310.08864, 2023. arXiv
- Khazatsky, Pertsch, Nair, et al.. DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset. arXiv 2403.12945, 2024. arXiv
- Contributors, Bu, Cai, et al.. AgiBot World Colosseo: A Large-scale Manipulation Platform for Scalable and Intelligent Embodied Systems. arXiv 2503.06669, 2025. arXiv
- Chi, Xu, Pan, et al.. Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots. arXiv 2402.10329, 2024. arXiv
- Chen, Chen, Chen, et al.. RoboTwin 2.0: A Scalable Data Generator and Benchmark with Strong Domain Randomization for Robust Bimanual Robotic Manipulation. arXiv 2506.18088, 2025. arXiv
- Liu, Zhu, Gao, et al.. LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning. arXiv 2306.03310, 2023. arXiv
- Mees, Hermann, Rosete-Beas, et al.. CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks. arXiv 2112.03227, 2021. arXiv
- Li, Hsu, Gu, et al.. Evaluating Real-World Robot Manipulation Policies in Simulation. arXiv 2405.05941, 2024. arXiv