· updated Jan 27, 2025 · 8 min read
资料:SLAM 草稿
ECCV 2018 视觉定位综述
以下是今年 ECCV 上几位大牛介绍 SLAM 技术的 tutorial pdfs,涉及基于特征点以及基于学习的 SLAM 算法介绍,并在最后探究了 SLAM 领域的主要问题以及未来的发展趋势。
- Feature-based vs. Learned Approaches
- Current State of Feature-based Localization
- Learning-based Localization
- Failure Cases of Feature-based and Learning-based Methods
- Long-term Localization: Towards Higher-level Scene Understanding
- Open Problems of Learning-based Methods
整理还未完备,先祭出这几本书&博客,方便随时查看。
教程
- slambook
- slambook code
- OpenCV3.0
- SLAM 前世今生
- g2o GitHub
- g2o details
- g2o 译文
- 深入理解图优化与 g2o:g2o 篇
- 深入理解图优化与 g2o:g2o 篇 code
- 白巧克力亦唯心的博客
- Graph SLAM 学习
g2o漫谈
g2o 里面有各种各样的求解器,而它的顶点、边的类型多种多样。通过自定义顶点和边,事实上,只要一个优化问题能够表达成图,就可以用 g2o 去求解它。常见的,比如 bundle adjustment,ICP,数据拟合等。g2o 是一个 C++ 项目,其中矩阵数据结构多来自 Eigen。
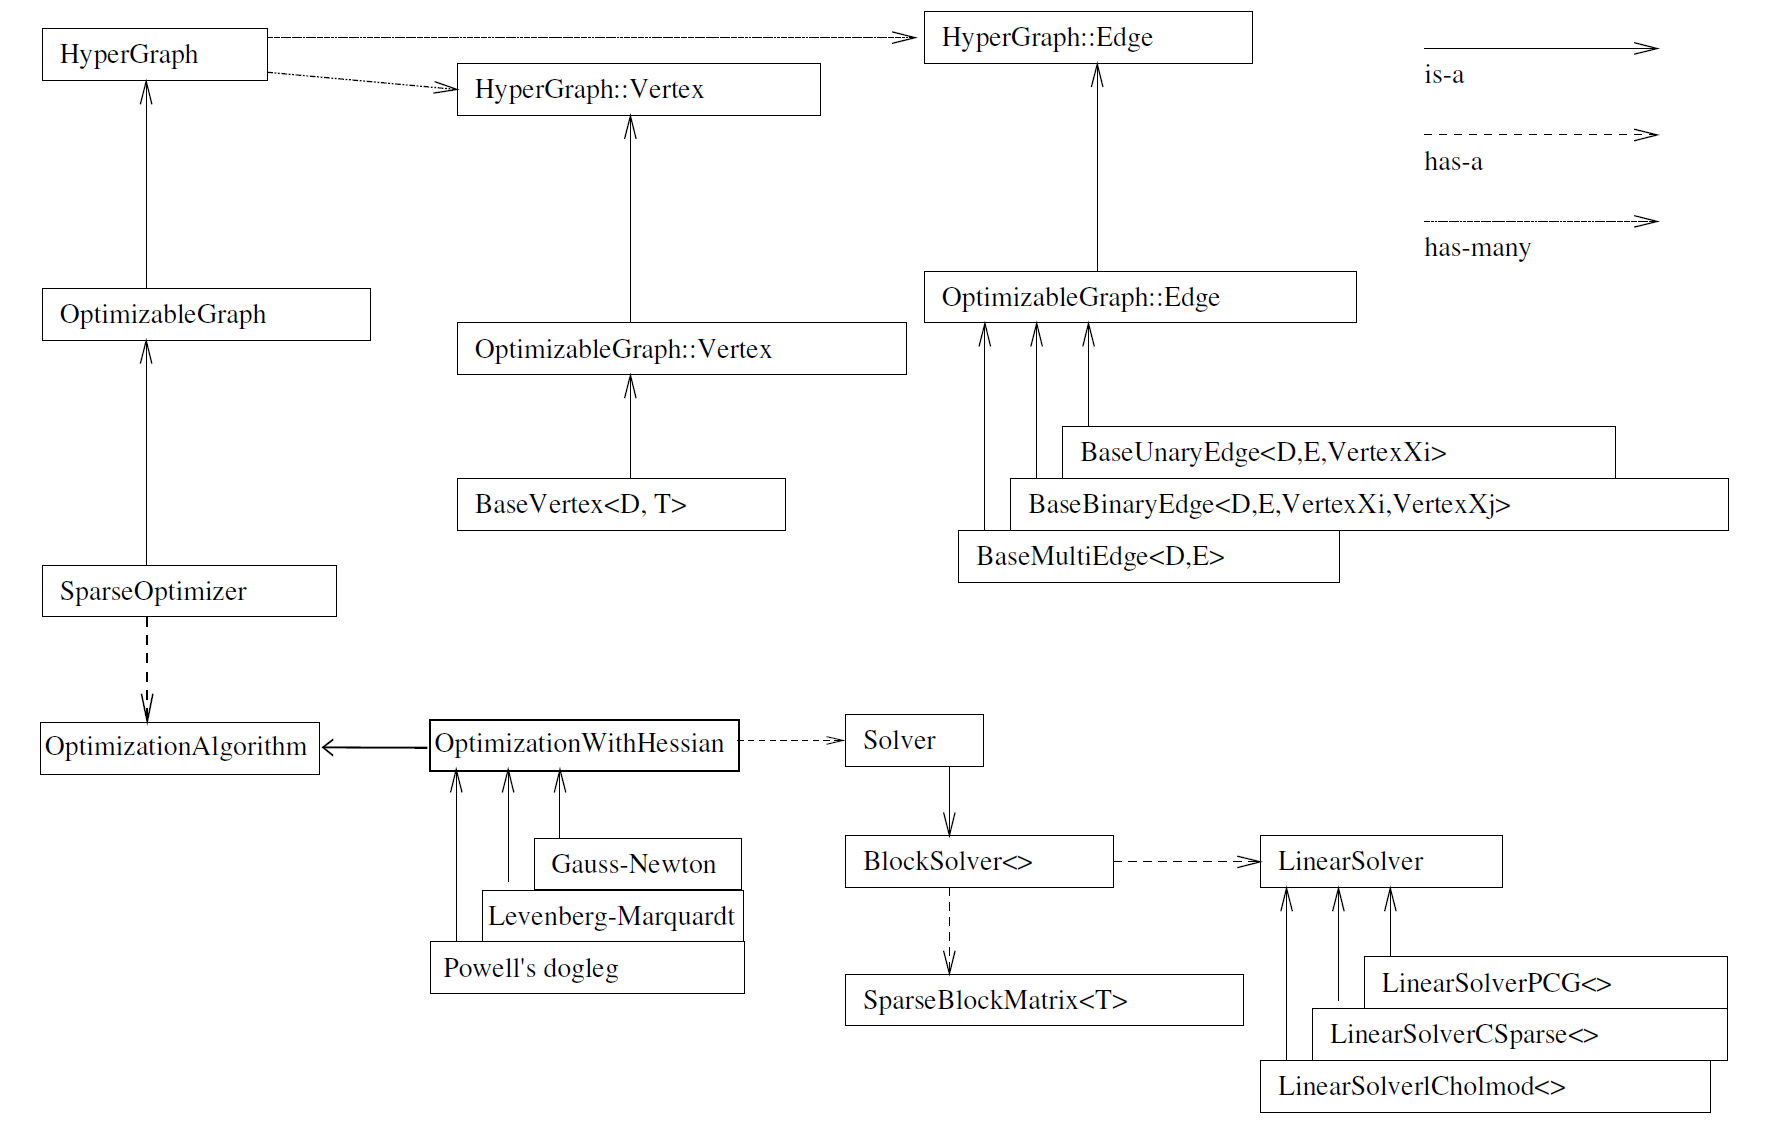
先看上部分,SparseOptimizer 是我们需要维护的东西,是一个 Optimizable Graph,也是一个 Hyper Graph。一个 SparseOptimizer 含有很多个顶点(继承自 Base Vertex)和多条边(继承自 BaseUnaryEdge,BaseBinaryEdge 或 BaseMultiEdge)。这些 Base Vertex 和 Base Edge 都是抽象的基类,而实际用的顶点和边,都是它们的派生类。
我们用 SparseOptimizer.addVertex 和 SparseOptimizer.addEdge 向图中添加顶点和边,然后调用 SparseOptimizer.optimize 来优化。
在优化前,需要指定我们用的求解器和迭代算法。从图下半部分来看,一个 SparseOptimization 拥有一个 Optimization Algorithm,继承自 Gauss-Newton,Levenberg-Marquardt,Powell’s dogleg 三者之一,同时拥有一个 Solver,含有两个部分。一个是 SparseBlockMatrix,用于计算稀疏的雅可比和海塞;一个用于计算 ,需要一个线性方程的求解器。而这个求解器,可以从 PCG,CSparse,Cholmod 三者选一。则一共三个步骤:
- 选择一个线性方程求解器,从 PCG, CSparse, Cholmod 中选
- 选择一个 BlockSolver
- 选择一个迭代策略,从 GN, LM, Dogleg 中选
BlockSolver,块求解器
块求解器是包含线性求解器的存在,之所以是包含,是因为块求解器会构建好线性求解器所需要的矩阵块(也就是和,),之后给线性求解器让它进行运算,边的 jacobian 也就是在这个时候发挥了自己的光和热。
这里再记录下一个比较容易混淆的问题,也就是在初始化块求解器的时候的参数问题。大部分的例程在初始化块求解器的时候都会使用如下的程序代码:
std::unique_ptr<g2o::BlockSolver_6_3::LinearSolverType> linearSolver = g2o::make_unique<g2o::LinearSolverCholmod<g2o::BlockSolver_6_3::PoseMatrixType>>();其中的 BlockSolver_6_3 有两个参数,分别是 6 和 3,在定义的时候可以看到这是一个模板的重命名(模板类的重命名只能用 using)
template<int p, int l>
using BlockSolverPL = BlockSolver< BlockSolverTraits<p, l> >;其中p 代表 pose 的维度,l 表示 landmark 的维度,且这里都表示的是增量的维度。
g2o 的顶点(Vertex)
g2o::BaseVertex< D, T >其中int D, typename T
首先记录一下定义模板的两个参数 D 和 T,两个类型分别是 int 和 typename 的类型,D 表示的是维度,g2o 源码里面是这个注释的:
static const int Dimension = D; //< dimension of the estimate (minimal) in the manifold space可以看到这个 D 并非是顶点(更确切地说是状态变量)的维度,而是其在流形空间(manifold)的最小表示,这里一定要区别开;之后是 T,源码里面也给出了 T 的作用:
typedef T EstimateType;
EstimateType _estimate;
可以看到,这里 T 就是顶点(状态变量)的类型。在顶点的继承中,这两个参数是直接面向我们的,所以务必要定义妥当。
g2o 的边(Edge)
g2o::BaseBinaryEdge< D, E, VertexXi, VertexXj >其中int D, typename E
首先还是介绍这两个参数,还是从源码上来看:
static const int Dimension = D;
typedef E Measurement;
typedef Eigen::Matrix<number_t, D, 1, Eigen::ColMajor> ErrorVector;
可以看到,D 决定了误差的维度,从映射的角度讲,三维情况下就是 2 维的,二维的情况下是 1 维的;然后 E 是 measurement 的类型,也就是测量值是什么类型的,这里 E 就是什么类型的(一般都是 Eigen::VectorN 表示的,N 是自然数)。
typename VertexXi,typename VertexXj
这两个参数就是边连接的两个顶点的类型,这里特别注意一下,这两个必须一定是顶点的类型,也就是继承自BaseVertex等基础类的类!不是顶点的数据类!例如必须是VertexSE3Expmap而不是VertexSE3Expmap的数据类型类SE3Quat。原因的话源码里面也很清楚,因为后面会用到一系列顶点的维度等等的属性,这些属性是数据类型类里面没有的。
_jacobianOplusXi,_jacobianOplusXj
在成员函数linearizeOplus()(线性化函数)中维护着这两个量,_jacobianOplusXi和_jacobianOplusXj就是所谓的雅可比矩阵,如果是二元边的话二者都有;若为一元边,只有_jacobianOplusXi。
这两个变量本质上是 Eigen::Matrix 类型的,具体定义在这里:
typedef typename Eigen::Matrix<number_t, D, Di, D==1?Eigen::RowMajor:Eigen::ColMajor>::AlignedMapType JacobianXiOplusType;
typedef typename Eigen::Matrix<number_t, D, Dj, D==1?Eigen::RowMajor:Eigen::ColMajor>::AlignedMapType JacobianXjOplusType;
JacobianXiOplusType _jacobianOplusXi;
JacobianXjOplusType _jacobianOplusXj;